Einführung
MiniMax H3 Referenz-zu-Video erzeugt eine Einstellung aus ein bis neun Referenzbildern und einem Prompt, der sie nummeriert anspricht – als Picture 1, Picture 2 und so weiter. Zurück kommen 4 bis 15 ganze Sekunden in 768p oder 2k in einem von sechs Seitenverhältnissen, mit gleichzeitig erzeugtem Ton. Zu den Bildern können bis zu drei Referenzvideos und bis zu drei Referenz-Audioclips kommen, jeweils höchstens 15 Sekunden insgesamt.
Modus nach dem Ausgangsmaterial wählen
| Ausgangsmaterial | Modus |
|---|---|
| eine geschriebene Szene oder ein Skript | MiniMax H3 Text-zu-Video |
| ein freigegebenes Startbild | MiniMax H3 Bild-zu-Video |
| ein bis neun Referenzbilder | MiniMax H3 Referenz-zu-Video |
Wichtige Funktionen und Highlights
Bis zu neun nummerierte Bildplätze
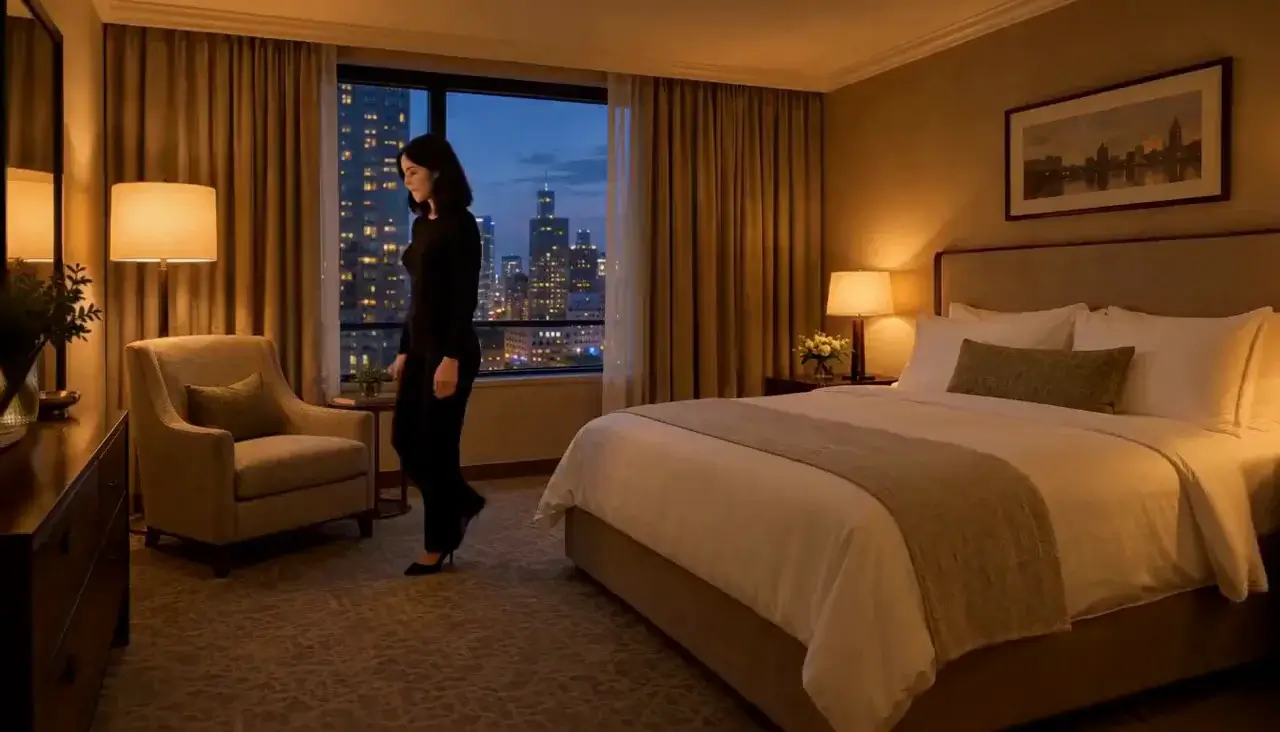
reference_image_urls nimmt ein bis neun Bilder an, und der Prompt spricht sie nach Position an. Ein Bild kann das Gesicht tragen, ein zweites die Garderobe, ein drittes den Raum. Das Beispiel zur Figurenkontinuität macht genau das: Es hält die Frau aus Bild 1 im Outfit aus Bild 2 im Hotelzimmer aus Bild 3.
Ein neuer Winkel auf ein bestehendes Set
Referenzen halten eine Produktion konsistent, wenn die Kamera an eine neue Position wandert. Das Beispiel red-dress-theatre-three-angles fixiert mit drei Stills Darstellerin, Kleid und Bühne und verlangt dann einen dritten Kamerawinkel, damit die neue Position nicht unbemerkt zu einer neuen Produktion wird. Erzeugt wurde es im Format 3:4 über fünf Sekunden.
Bewegung und Ton kommen aus dem Prompt
Bewegung und Audio lassen sich schreiben oder als Referenz mitgeben. Das Beispiel voice-and-room sendet zwei Bilder, die Darstellerin und das Bühnenlicht, und beschreibt die Club-Akustik in Worten: warmer Hall und ein Murmeln aus dem Publikum. Ein Referenzvideo bringt Bewegung mit und wird als <Video 1> angesprochen; Referenzaudio gibt eine Stimme oder einen Klang vor. Die ersten fünf Referenzbilder sind inklusive, jedes weitere kostet einen Aufpreis; Sekunden aus Referenzvideos haben einen eigenen, niedrigeren Sekundenpreis als Ausgabesekunden, Referenzaudio ist kostenlos. Die Live-Schätzung zeigt das alles vor dem Absenden.
Request-Parameter
| Parameter | Pflicht | Beschreibung |
|---|---|---|
prompt | Ja | Nennen Sie jede Referenz per Nummer – <Picture 1>, <Picture 2> –, sagen Sie, welche Aufgabe sie hat, und schreiben Sie dann Bewegung und Ton. mindestens 1 Zeichen · höchstens 7000 Zeichen |
reference_image_urls | Ja | Ein bis neun Bilder. Die ersten fünf sind im Preis enthalten, jedes weitere kostet extra. mindestens 1 Einträge · höchstens 9 Einträge |
reference_video_urls | Nein | Bis zu drei Referenzvideos, je 2 bis 15 Sekunden und insgesamt 15 Sekunden, für Bewegung, Kameraführung oder eine Figur in Bewegung. mindestens 1 Einträge · höchstens 3 Einträge |
reference_audio_urls | Nein | Bis zu drei Referenz-Audioclips, WAV oder MP3, je 2 bis 15 Sekunden und insgesamt 15 Sekunden, für eine Stimme oder einen Klang, dem der Clip folgen soll. mindestens 1 Einträge · höchstens 3 Einträge |
aspect_ratio | Nein | 16:9, 9:16, 1:1, 4:3, 3:4 oder 21:9. 21:9 ergibt das anamorphe Breitbild. |
resolution | Nein | 768p oder 2k, beide nativ. Entwerfen Sie in 768p, liefern Sie in 2k aus. |
duration_seconds | Nein | Ganze Sekunden, 4 bis 15. Vier Sekunden gibt es nur bei 768p. |
Preis
Referenzbilder: Die ersten fünf sind inklusive, jedes weitere kostet extra. Sekunden aus Referenzvideos haben einen eigenen Sekundenpreis, niedriger als bei Ausgabesekunden; jeder Clip wird auf volle Sekunden aufgerundet, insgesamt höchstens 15 Sekunden. Referenzaudio ist kostenlos.
| Spezifikation | Preis |
|---|---|
| $0.037 / Sekunde |
| $0.058 / Sekunde |
Anwendungsfälle
Eine wiederkehrende Figur über mehrere Einstellungen halten
Verwenden Sie für jede Einstellung einer Sequenz denselben Referenzsatz und ändern Sie im Prompt nur die Zeilen zu Handlung und Ort. Der Endpunkt nimmt keinen Seed an; es sind die Referenzen, die die Identität von Take zu Take stabil halten – Text allein würde driften.
Eine Darstellerin in einen bestimmten Raum setzen
Kombinieren Sie ein Porträt mit einem separaten Bild des Raums und beschreiben Sie, was dort geschieht. In voice-and-room beugt sich die Darstellerin zum Mikrofon, spricht eine Zeile und lächelt; das zweite Bild liefert das Bühnenlicht, der Prompt den Raumklang.
Kleidungsstück oder Requisite in Bewegung halten
Geben Sie einem Kleidungsstück oder Objekt einen eigenen Platz, statt darauf zu hoffen, dass es in einem Porträt überlebt. Das Beispiel red-dress schreibt dann, was das Kleid in Bewegung tut – der Schlitz öffnet sich mit jedem Schritt Richtung Proszenium –, weil Schnitt und Farbe bereits durch eine Referenz festgelegt sind.
Prompt-Leitfaden und Praxistipps
Jedem Bild genau eine Aufgabe zuweisen
Beginnen Sie den Prompt mit der Zuordnung, wie character-continuity es tut: „Keep the woman from Picture 1 and the black lace slip from Picture 2, in the hotel room from Picture 3.“ Danach folgt die Handlung. Drei oder vier Bilder mit klar getrennten Aufgaben funktionieren besser als neun, die sich überschneiden; zeigen mehrere Bilder dasselbe Motiv, mittelt das Modell sie, statt eines auszuwählen.
Nur schreiben, was die Referenzen nicht liefern
Sind Identität, Garderobe und Ort durch Bilder abgedeckt, verwenden Sie den Prompt für Bewegung, Kamera und Ton: „She sits on the arm of the chair, crosses her legs and looks up at camera. Slow handheld drift, warm lamp, quiet room tone.“ Wer das Gesicht noch einmal in Worten beschreibt, gibt dem Modell eine zweite Beschreibung, die womöglich nicht zum Bild passt.
Klein entwerfen, dann liefern
Die Dauer reicht von 4 bis 15 Sekunden, und 4 Sekunden gibt es nur in 768p. Entwerfen Sie mit dem Referenzsatz, den Sie behalten wollen, in niedrigerer Auflösung und wiederholen Sie dann in 2k. Driftet ein Take, tauschen Sie jeweils nur eine Referenz oder eine Anweisung aus, damit erkennbar bleibt, welche Änderung den Unterschied gemacht hat.
API-Schnellstart
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "minimax/h3/reference-to-video",
  "input": {
    "aspect_ratio": "16:9",
    "duration_seconds": 5,
    "enable_prompt_expansion": false,
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise",
    "reference_image_urls": [
      "https://example.com/reference.png"
    ],
    "resolution": "768p"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Authentifizierung, vollständiges Schema, Polling und Fehlerbehandlung stehen in der API-Referenz.