Bei einer wiederkehrenden erwachsenen Figur beginnen Sie mit Bild-zu-Video, sobald Gesicht, Kleidung und Anfangseinstellung freigegeben sind. Beginnen Sie mit Text-zu-Video, wenn Sie die Figur noch besetzen oder die Szene erkunden. Ein Bild gibt einen konkreten Anfang vor; bei einem Textprompt erfindet das Modell ihn. Keine Eingabe garantiert, dass das Gesicht bei Bewegung stabil bleibt.
Der folgende Vergleich verwendet MiniMax H3, weil SpicyAPI beide Aufgaben zu denselben Preisen pro Sekunde anbietet. Entscheidend ist somit, was Sie schon haben und was korrigiert werden muss, nicht ein Preisvorteil eines Weges. Die Beispielprompts verwenden eine vollständig bekleidete, fiktive erwachsene Person.
Dieselbe Familie, zwei verschiedene Eingaben
| Aktuelle Spezifikation von MiniMax H3 | Text-zu-Video | Bild-zu-Video |
|---|---|---|
| Erforderliche Eingabe | prompt | prompt und image_url |
| Dauer | 5–15 ganze Sekunden | 4–15 ganze Sekunden; 2k erfordert mindestens 5 |
| Auflösungen | 768p, 2k | 768p, 2k |
| Bildformat | aspect_ratio: 16:9, 9:16, 1:1, 4:3, 3:4, 21:9 | Vom Anfangsbild bestimmt; kein Feld für das Seitenverhältnis |
| Optionales Schlussbild | Nicht verfügbar | last_image_url |
| Seed | Nicht verfügbar | Nicht verfügbar |
Einzelheiten zu jeder Aufgabe finden Sie auf den Seiten für Text-zu-Video und Bild-zu-Video.
Beide Aufgaben erzeugen Ton zusammen mit dem Video. Beschreiben Sie den Ton im Prompt, auch wenn es nur Regen und Raumton sind; ein Bild kann nicht vorgeben, welche Tonspur zur Szene gehört.
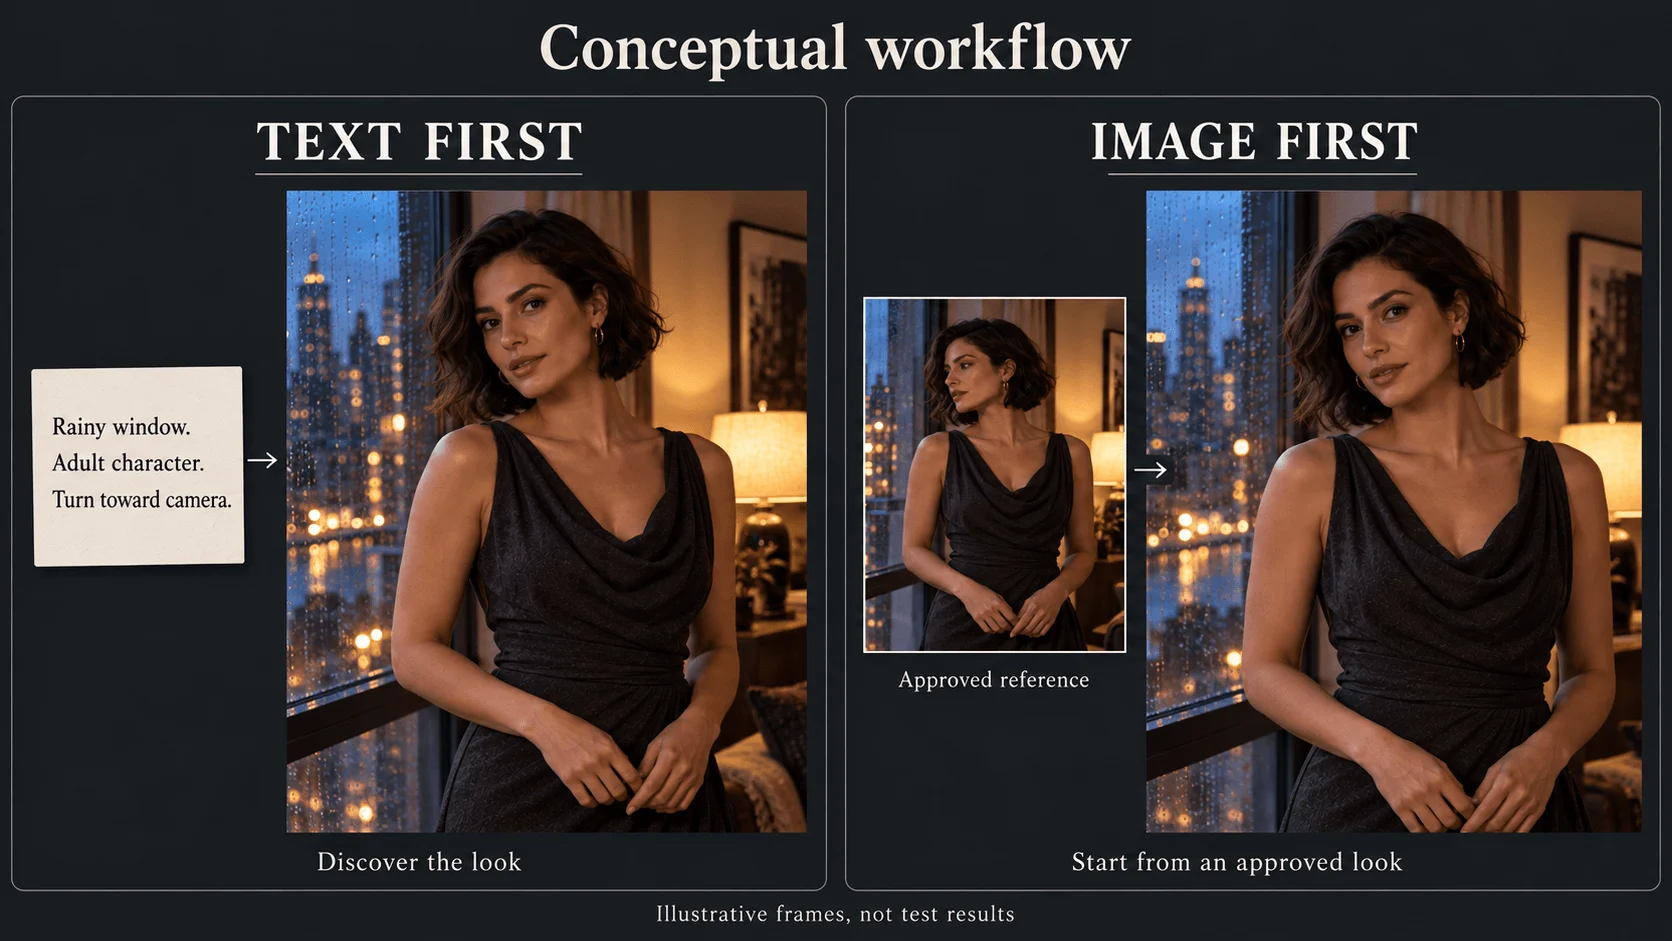
Mit Text entdecken Sie das Aussehen; ein Bild liefert einen freigegebenen Anfangslook. Illustrationen, keine MiniMax-Ausgaben.
Was das für NSFW-Creator bedeutet
In unseren Tests vom September 2026 akzeptierten beide H3-Aufgaben Anfragen für Inhalte für Erwachsene bis zur stärksten von uns geprüften Stufe: Text-zu-Video anhand einer schriftlichen Beschreibung und Bild-zu-Video anhand KI-generierter Anfangsbilder. Beide werden als uneingeschränkt geführt. Der Weg ändert daher nicht, was erlaubt ist, sondern wie viel Kontrolle Sie haben.
Akzeptanz und Identität sind getrennte Fragen. Ein Modell kann das Motiv akzeptieren und dennoch das Gesicht mitten in einer Drehung verändern. Wählen Sie den Weg deshalb nach der Einstellung und beurteilen Sie das Ergebnis danach, ob die Figur erkennbar bleibt.
MiniMax H3 Spicy ist eine separate Bild-zu-Video-Familie, nicht der Bildeingabemodus des gewöhnlichen H3. Bei 768p kostet sie aktuell $0.084 pro Sekunde, gegenüber $0.037 für gewöhnliches H3 bei 768p. Vergleichen Sie diesen höheren Preis nicht mit gewöhnlichem H3 Text-zu-Video, um den Unterschied als „Bild-zu-Video-Aufschlag“ zu bezeichnen. Ebenso ist H3 LoRA eine separate Familie für kompatible LoRA-Gewichte, kein Schalter in diesen beiden Formularen.
Weg A: die Einstellung aus Text entdecken
Nutzen Sie diesen Weg für eine neue fiktive Figur oder einen eigenständigen Teaser, wenn das genaue Gesicht noch nicht feststeht. Die Beispielbeschreibung umfasst eine Handlung: Mara, 30 Jahre alt, dreht sich von einem regennassen Fenster zum Betrachter. Ihr anthrazitfarbenes Abendkleid bleibt an; die Kamera bleibt still.
- Öffnen Sie MiniMax H3 Text-zu-Video.
- Stellen Sie im Formular Aspect ratio auf 9:16, Resolution auf 768p und Duration auf 5.
- Fügen Sie den folgenden Einstellungsprompt unter Prompt ein und prüfen Sie die Kostenschätzung vor dem Start.
Vertical medium shot of Mara, a fictional 30-year-old woman with a short dark bob, wearing a charcoal evening dress beside a rain-streaked window. Cool window light illuminates her face; a warm lamp glows behind her. She begins looking toward the window, slowly turns her head toward the camera, then holds eye contact. Her face and upper body stay in frame. Static camera. The dress remains unchanged. Audio: soft rain against the glass and quiet room tone, no speech or music.
Wählen Sie diesen Weg, wenn: die Figur noch offen ist, Sie Aussehen und Schauplätze erkunden möchten oder ein einzelner Clip die ganze Aufgabe ist. Wählen Sie einen anderen Weg, wenn: Gesicht oder Kleidung schon feststehen; nutzen Sie Weg B.
Beurteilen Sie das erste Ergebnis als Besetzung plus Inszenierung. Ist das Gesicht ansprechend, unterscheidet sich aber von einer etablierten Figur, hat die reine Texteingabe dieses etablierte Gesicht nicht geliefert. Derselbe Name und dieselbe Haarbeschreibung machen eine neue Generierung nicht zu einer Identitätsreferenz.
Sobald Sie einen Look freigeben, speichern Sie ihn, bevor Sie den Prompt ändern. “Keep everything, only change the lamp” ist bei dieser Aufgabe weiterhin eine neue Generierung, keine lokale Bildbearbeitung. Wenn die Lampe wichtig ist, bereiten Sie ein freigegebenes Anfangsbild mit der richtigen Lampe vor und wechseln Sie zum zweiten Weg.
Weg B: einen freigegebenen Anfang animieren
Nutzen Sie Bild-zu-Video, wenn das Publikum Mara bereits erkennt oder die Einstellung zu einem freigegebenen Kampagnenbild passen muss. Das Bild sollte den Beginn der Handlung zeigen und nicht bloß Ihr bestes Porträt der Figur sein.
Bereiten Sie für die Drehung am Fenster eine vertikale Halbnahe vor: Der Kopf ist zum Fenster geneigt, genug vom Gesicht ist zur Prüfung sichtbar und um die Schultern bleibt Platz. Eine eng beschnittene Gesichtsnahaufnahme eignet sich schlecht für eine große Drehung weg und zurück. Ändern Sie zuerst den Bildaufbau, statt den Bewegungsprompt gleichzeitig Bildausschnitt, Identität und Handlung lösen zu lassen.
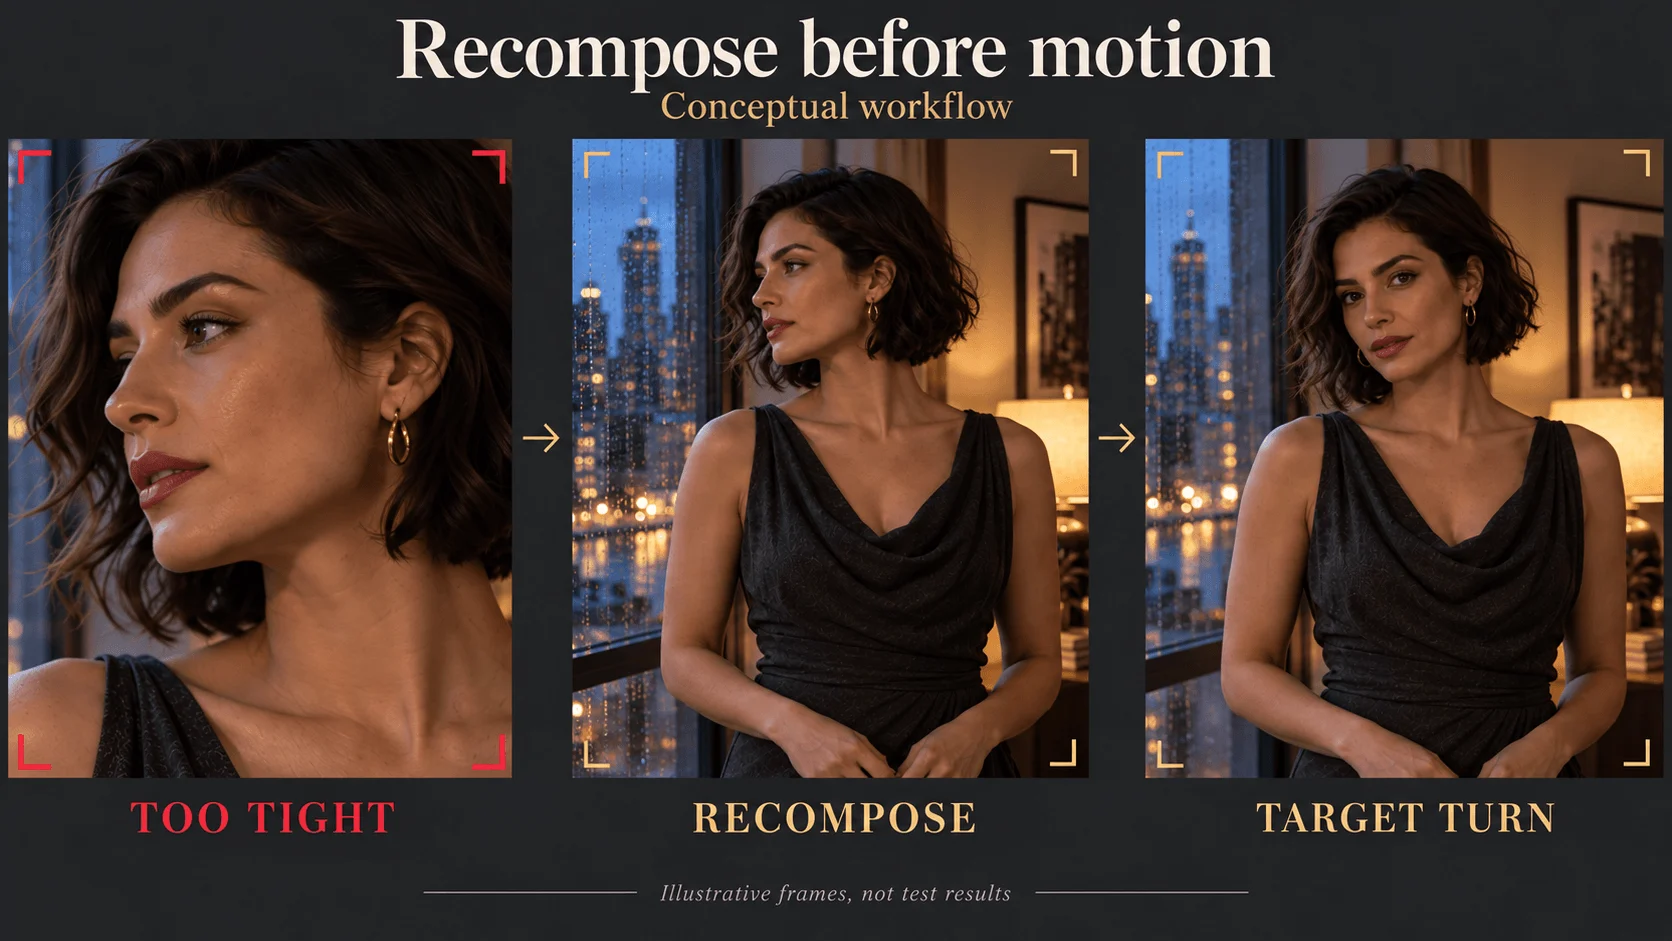
Beheben Sie einen zu engen Bildausschnitt, bevor Sie Bewegung anfordern.
- Öffnen Sie MiniMax H3 Bild-zu-Video.
- Fügen Sie das freigegebene vertikale Anfangsbild unter Input image hinzu. Jede Seite muss 256–5.760 Pixel messen, das Verhältnis zwischen 2:5 und 5:2 liegen und die Datei kleiner als 10 MB sein (das Playground-Limit).
- Stellen Sie Resolution auf 768p und Duration auf 5. Das Bild bestimmt das Verhältnis; diese Aufgabe hat kein Feld Aspect ratio.
- Fügen Sie den folgenden Bewegungsprompt unter Prompt ein. Lassen Sie Closing frame für die erste einfache Drehung leer.
She slowly turns her head from the window toward the camera, then holds direct eye contact. Her shoulders stay relaxed. The camera remains fixed. Audio: soft rain against the glass and quiet room tone, no speech or music.
Das Bild zeigt bereits Gesicht, Kleid und Raum. Der Prompt beschreibt daher nur, was sich ändert.
Prüfen Sie den Anfang, die Mitte und das abschließende Verharren. Ein passendes erstes Bild kann spätere Gesichtsänderungen verdecken. Zeigt die Drehung eine schwache Seitenansicht, versuchen Sie einen Anfangswinkel, der mehr vom relevanten Gesicht zeigt, oder fordern Sie eine kleinere Drehung. Ist direkter Blickkontakt entscheidend, behalten Sie dieses Ende bei, statt die Bewegung so weit zu reduzieren, dass die Figur kaum noch handelt.
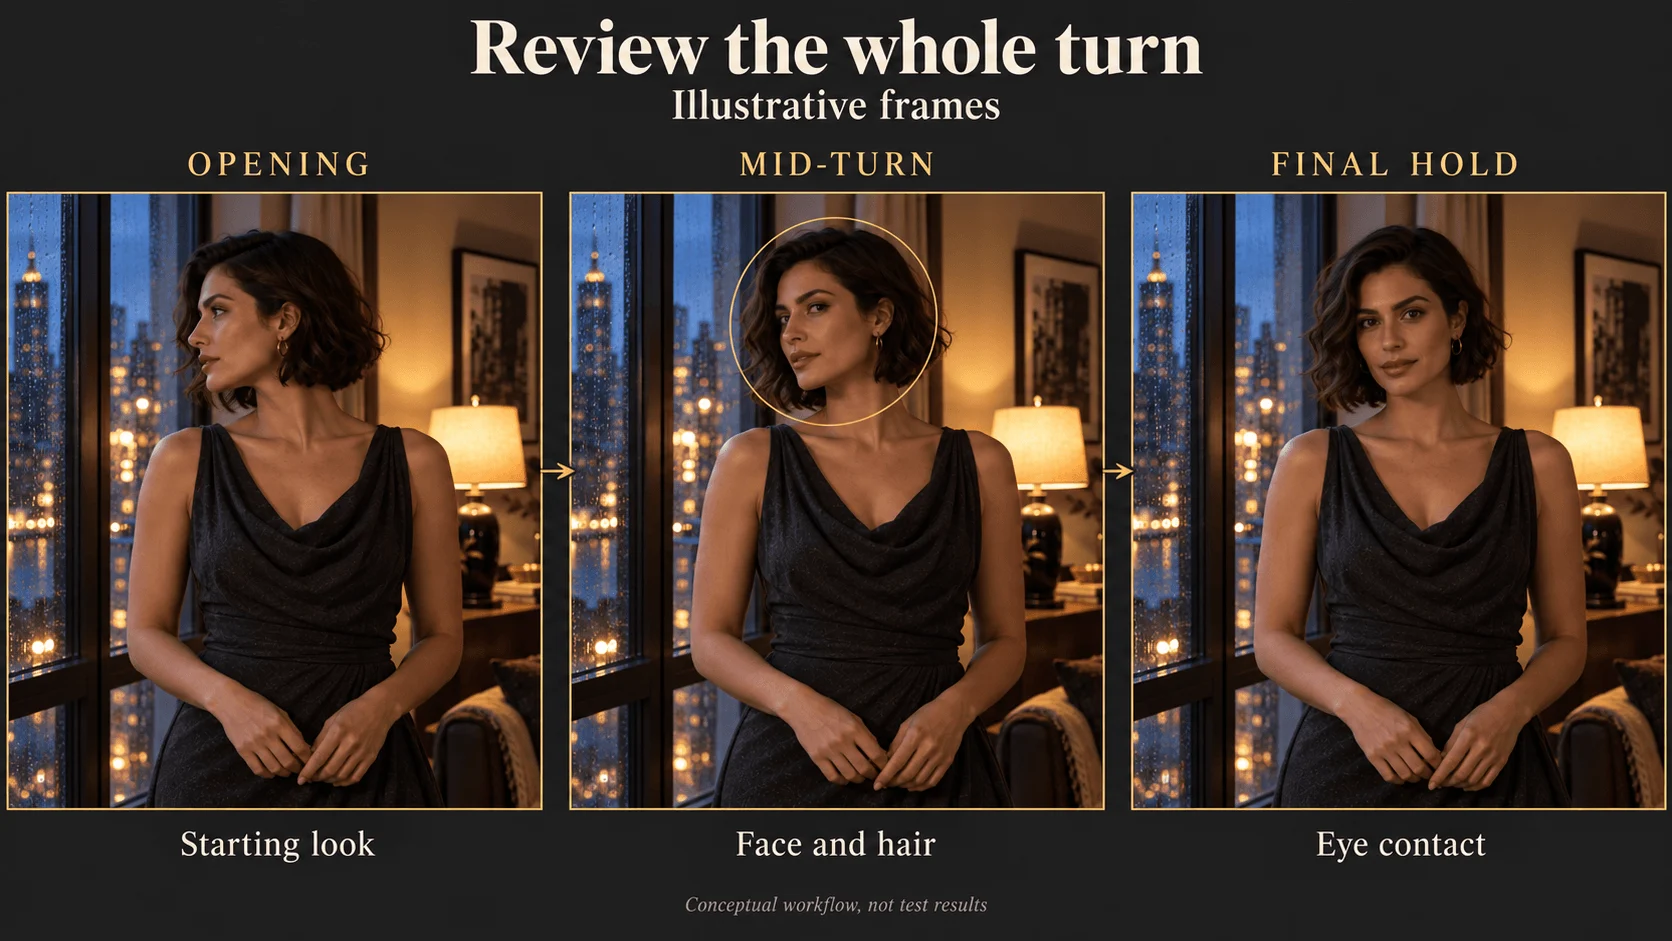
Prüfen Sie Anfang, Drehung und abschließendes Verharren als getrennte Abnahmekriterien.
Wählen Sie diesen Weg, wenn: die Figur wiederkehrt, die Einstellung einem freigegebenen Bild entsprechen muss oder Gesicht und Kleidung bereits feststehen. Wählen Sie einen anderen Weg, wenn: Sie den Look noch finden müssen, denn ein Bild übernimmt auch seine Schwachstellen.
Das optionale Schlussbild (last_image_url in der API) ist nützlich, wenn auch der abschließende Bildaufbau freigegeben ist. Bereiten Sie es mit derselben Figur, Kleidung und Beleuchtung vor und fordern Sie eine Handlung, die beide Bilder plausibel verbindet. Es begrenzt das Ziel; es liefert nicht jede zwischenliegende Handposition und garantiert keinen korrekten Übergang.
Was fünf Sekunden kosten
Die aktuellen Preise des gewöhnlichen H3 sind für beide Aufgaben gleich:
| Auflösung | USD pro Sekunde | Generierung von fünf Sekunden |
|---|---|---|
| 768p | $0.037 | $0.185 |
| 2k | $0.058 | $0.290 |
Die Bilderstellung kommt hinzu. Haben Sie bereits ein freigegebenes Standbild, kostet die Vorbereitung möglicherweise fast nichts. Wenn Sie zunächst viele Standbilder generieren und verwerfen, zählen Sie diese Ausgaben mit. Beispiel 768p: Drei Text-zu-Video-Versuche kosten $0.555, ein Bild-zu-Video-Versuch $0.185 plus das Bild. Der Bildweg gewinnt also nur, wenn das freigegebene Standbild weniger als $0.37 kostet. Gelingen beide beim ersten Versuch, ist Text-zu-Video günstiger, weil beim Bildweg die Standbildkosten hinzukommen.
Ein Entwurf bei 768p und die Fertigstellung bei 2k sind das günstige Muster. Der 2k-Lauf ist jedoch eine neue Aufnahme, keine Hochskalierung des Entwurfs: H3 bietet keinen seed, daher liefert selbst eine identische Anfrage eine andere Bewegung. Muss die akzeptierte Bewegung exakt erhalten bleiben, nutzen Sie eine separate Hochskalierungsaufgabe. Familien mit seed, etwa H3 Spicy Bild-zu-Video oder Seedance 2.5, ermöglichen besser reproduzierbare Wiederholungen einer Anfrage.
Den frühesten sichtbaren Fehler beheben
| Was Sie sehen | Nächster Schritt |
|---|---|
| Falsches Kleid im Anfangsbild | Standbild korrigieren, bevor Sie erneut Video generieren |
| Anfangs korrektes Gesicht, anderes Gesicht während der Drehung | Drehung verkleinern oder einen aussagekräftigeren Anfangswinkel vorbereiten |
| Gutes Porträt, aber zu wenig Raum für die Geste | Anfangsbild erweitern oder neu komponieren |
| Kamera fährt trotz Vorgabe einer festen Kamera näher heran | Konkurrierende Kameraanweisungen entfernen und einen Bewegungsbefehl beibehalten |
| Die gewünschte Drehung wird nicht abgeschlossen | Nebenhandlungen entfernen oder mehr Dauer erlauben |
| Sie haben ein Figurenporträt, benötigen aber einen neuen Raum und eine neue Pose | Neuen Anfang vorbereiten oder die separate Referenz-zu-Video-Aufgabe verwenden |
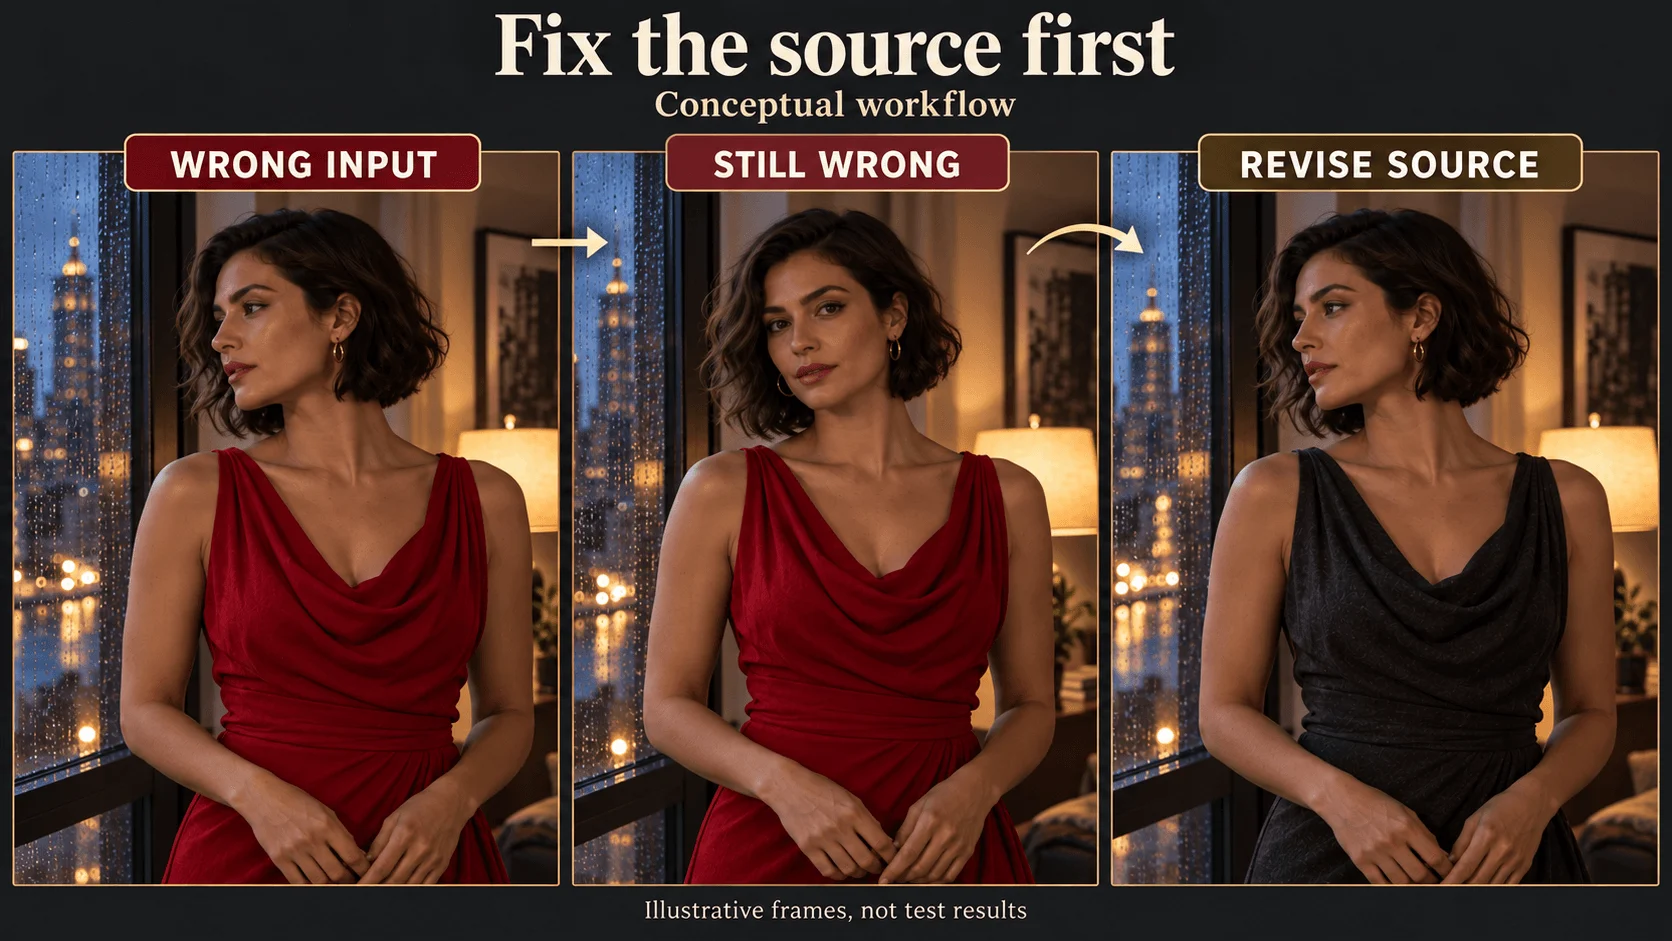
Ist die Kleidung am Anfang falsch, korrigieren Sie die Quelle vor einem weiteren Bewegungsversuch.
Eine Identitätsreferenz und ein Anfangsbild sind verschiedene Materialien. Soll Mara an einem Tisch sitzen, laden Sie ihr Fensterporträt nicht als tatsächlichen Anfang hoch und erwarten Sie, dass es nur als Gesichtsreferenz dient. H3 Referenz-zu-Video ist eine separate Aufgabe für ein bis neun Referenzbilder; prüfen Sie ihre zusätzlichen Eingaben und die Kostenschätzung gesondert.
Aus der API ausführen
Wenn ein Playground-Lauf richtig aussieht, funktioniert dieselbe Anfrage auch aus Code. Dies ist das Text-zu-Video-Beispiel; für Bild-zu-Video ändern Sie das Modell zu minimax/h3/image-to-video, entfernen aspect_ratio und ergänzen image_url.
import os
import uuid

import requests

response = requests.post(
    "https://api.spicyapi.ai/api/v1/jobs/createTask",
    headers={
        "Authorization": f"Bearer {os.environ['SPICY_API_KEY']}",
        "Idempotency-Key": str(uuid.uuid4()),  # new key for each new request
    },
    json={
        "model": "minimax/h3/text-to-video",
        "input": {
            "prompt": "Vertical medium shot of Mara, a fictional 30-year-old woman with a short dark bob, wearing a charcoal evening dress beside a rain-streaked window. She slowly turns her head toward the camera, then holds eye contact. Static camera. Audio: soft rain, quiet room tone.",
            "aspect_ratio": "9:16",
            "resolution": "768p",
            "duration_seconds": 5,
        },
    },
)
print(response.json())
Felder, Ergebnisse und Fehler finden Sie in der API-Referenz.
Oder lassen Sie einen Agent die Aufgabe ausführen. Ein Agent kann denselben Aufruf über die CLI, den MCP-Server oder den Agent Skill machen. Alle drei lesen das aktuelle Modellschema. CLI und MCP zeigen den Preis und bitten vor der Aufgabenerstellung um Bestätigung.
# CLI
npx @spicyapi/cli tasks create --model minimax/h3/text-to-video \
  --input-json '{"prompt": "Mara turns from a rain-streaked window toward the camera and holds eye contact. Static camera. Audio: soft rain.", "aspect_ratio": "9:16", "resolution": "768p", "duration_seconds": 5}' --wait

# MCP server: the command your assistant's MCP config runs
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
Eine Szene länger als 15 Sekunden machen
Eine H3-Anfrage ist auf 15 Sekunden begrenzt, und es gibt keine Verlängerungsaufgabe. Geben Sie den Clip frei, entnehmen Sie sein Schlussbild und verwenden Sie es als Anfangsbild der nächsten Bild-zu-Video-Einstellung. Jeder Prompt beschreibt dann nur, was als Nächstes geschieht. So übernimmt das nächste Anfangsbild den Look der vorigen Einstellung, statt die Figur jedes Mal per Text neu zu besetzen.
Welchen Weg Sie wählen sollten
Für eine wöchentliche Figurenserie geben Sie für jede Einstellung ein Anfangsbild frei und animieren es. Bei einem neuen Schauplatz ohne festgelegte Besetzung beginnen Sie mit Text und betrachten das Ergebnis als Erkundung. Wechseln Sie, sobald Gesicht und Bildaufbau zu Anforderungen werden, die erhalten bleiben sollen.