O HunyuanVideo 1.5 segue melhor um prompt que parece uma lista de planos: um adulto, o que ele veste, duas ou três ações pequenas em ordem, um movimento de câmera e a luz. Em 50 execuções de conteúdo adulto em 5 de outubro de 2026, todas as requisições do L1 ao L3 voltaram como escritas (26 de 26), enquanto as 8 cenas íntimas entre dois adultos voltaram suavizadas; é aí que reescrever o prompt deixa de compensar. Em imagem para vídeo, o quadro inicial faz a maior parte do trabalho: ações pequenas mantiveram o rosto da foto, e pedir um lugar novo o substituiu.
A escada de conteúdo completa, os tamanhos, as velocidades e a comparação com o LTX-2 estão no nosso teste NSFW do HunyuanVideo 1.5. Este guia trata do prompt: quais formulações o modelo segue e quais ignora, com clipes lado a lado que rodamos para ele. Todos os prompts impressos aqui são cenas com adultos vestidos, no extremo sugestivo, e você pode rodá-los na página da família HunyuanVideo 1.5.
Em resumo
| Prompts no HunyuanVideo 1.5, a partir das nossas execuções | |
|---|---|
| Formato de prompt que funcionou | Sujeito, figurino, duas ou três ações em ordem, um movimento de câmera, luz e visual |
| Adjetivos de clima ("sultry", "seductive") | Um olhar posado e pouco movimento, nos dois seeds de teste |
| L1 a L3 | 26 de 26 entregues, nos dois endpoints |
| L4, dois adultos | 0 de 8 entregues: todos suavizados, nenhum recusado |
| L5 | Contenção: 7 de 8 entregues; gore cinematográfico: 6 de 8 |
| Prompt negativo | Só em texto para vídeo. Reduz artefatos, nunca é garantia |
| Prompt de imagem para vídeo | Opcional. Descreva o momento seguinte no mesmo lugar |
| Configurações | 480p ou 720p, 5 ou 8 segundos, silencioso; 16:9 ou 9:16 em texto para vídeo; imagem para vídeo mantém o formato da foto |
| Preço | $0.024 por segundo em 480p, $0.048 em 720p ($0.12 por um rascunho de 5 segundos) |
Os cinco campos que o HunyuanVideo 1.5 lê
O manual de prompts do HunyuanVideo 1.5, da Tencent, monta um prompt de texto para vídeo a partir de sujeito, movimento e cena, com plano, câmera, iluminação, estilo e atmosfera como extras. Ele pede ações em ordem temporal ("first… then… finally") e emoções escritas como pequenos detalhes físicos. Para clipes de conteúdo adulto, dividimos o sujeito em dois, porque é na linha do figurino que mora o nível da cena.
| Campo | O que escrever | Nosso exemplo |
|---|---|---|
| 1. Sujeito | Um adulto: faixa etária, cabelo, um detalhe marcante | Uma mulher adulta de seus trinta e poucos anos |
| 2. Figurino | Peça, tecido, cor e o estado dela | em um vestido-combinação de cetim preto |
| 3. Ações | Duas ou três ações pequenas com "first", "then", "finally" | recoloca uma alça no ombro, olha para trás em direção à câmera, sorri |
| 4. Câmera | Um movimento: aproximação, órbita, fixa, câmera na mão | Aproximação lenta |
| 5. Luz e visual | A fonte de luz, mais uma tag curta de estilo | luz quente de abajur, cinematic, photorealistic |
O lugar vai entre o sujeito e a ação. O prompt completo:
An adult woman in her early thirties in a black satin slip dress stands by the window of a dim hotel room at night, city lights behind her. First she slides one strap back onto her shoulder, then she glances over her shoulder at the camera, and finally she lets a slow, knowing smile break. Slow push-in, warm lamp light, cinematic, photorealistic.Abra este prompt no texto para vídeo do HunyuanVideo 1.5 →
Três hábitos fizeram a maior diferença nas nossas execuções:
- Um adulto por clipe, a menos que a cena precise de dois.
- Nomeie o ambiente pelo que há nele. Nos dois clipes com duas pessoas no seed 62001 (veja abaixo), "hotel bar" voltou como um quarto de hotel com cama. Se o lugar importa, liste o balcão, os bancos e as garrafas.
- Mantenha fixa a linha do sujeito enquanto itera. Mudar uma frase redesenha a pessoa inteira, mesmo com o mesmo seed.
Adjetivos de clima ou detalhes de ação
Prompts adultos tendem a empilhar adjetivos de clima. Rodamos o prompt acima contra o mesmo prompt com a frase de ação trocada por "She is sultry, seductive and sensual, radiating desire." Mesmo seed, mesmo prompt negativo, 480p, 5 segundos, dois seeds para cada um.
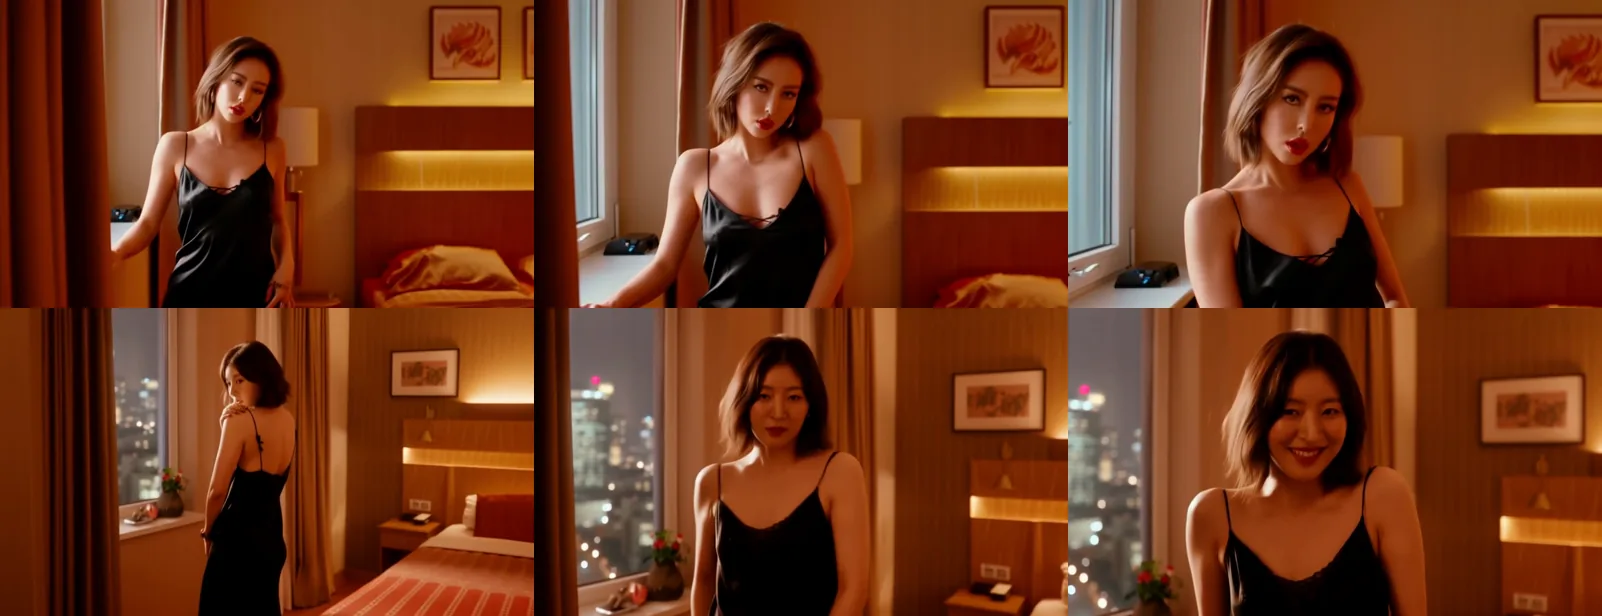
Texto para vídeo, 480p, seed 61002, início, meio e fim de cada clipe. Em cima: o prompt com adjetivos de clima. Embaixo: o prompt com ações. O seed 61001 se comportou da mesma forma.
Os adjetivos produziram uma pose de ensaio de moda: lábios entreabertos, olhar fixo, uma mão parada e a aproximação da câmera fazendo todo o movimento. Neste seed, a cidade noturna atrás dela também desapareceu. A versão com ações passou pelas três etapas nos dois seeds e terminou no sorriso, embora as duas primeiras tenham se misturado (ela já olhava para trás quando a mão foi até a alça). Esse é o custo habitual de três ações em cinco segundos.
A regra: escreva o que o espectador deve ver acontecer, não como deve se sentir. "A slow, knowing smile" faz o trabalho de "seductive", e o modelo consegue desenhá-lo.
Escolha gestos que o modelo conhece
O prompt por trás da capa deste guia pedia a um homem em uma sacada de hotel que "loosen one cuff", depois mantivesse o olhar para a câmera e então abrisse meio sorriso. Nos dois seeds o punho nunca se mexeu: um homem puxou o colarinho aberto, o outro apoiou a mão no colarinho e no queixo. O olhar saiu nas duas vezes.
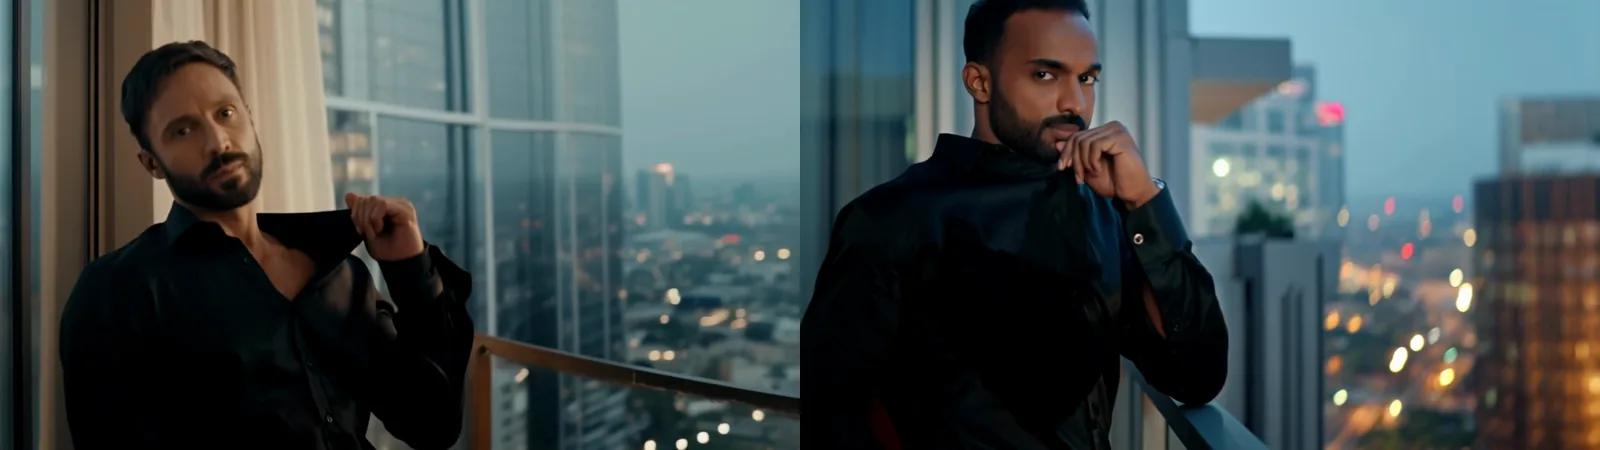
Texto para vídeo, 720p, o mesmo prompt nos seeds 64001 (esquerda) e 64002 (direita). O prompt pedia que ele soltasse um punho.
Gestos pequenos e incomuns são trocados por gestos familiares. Se um gesto importa, escolha um que o modelo claramente já viu muitas vezes (uma mão no cabelo, uma alça escorregando, um colarinho ajustado) e confira em um rascunho em 480p primeiro.
Até onde ir, nível por nível
Nada do nosso lado filtra o prompt, a foto nem o resultado. O que muda entre os níveis é como o próprio modelo responde, e isso decide se vale pagar por mais uma reescrita. Estes números reúnem os dois endpoints em 50 execuções em 5 de outubro de 2026, em 480p e 5 segundos, todos os sujeitos adultos. Não imprimimos prompts acima do L1.
| Nível | O que significa | Entregues | Para o seu prompt |
|---|---|---|---|
| L1 Sugestivo | Lingerie, uma alcinha escorregando | 8 de 8 | Nomeie a peça e a única coisa que acontece com ela |
| L2 Temas maduros | Conteúdo parcial | 8 de 8 | Os mesmos cinco campos; a linha do figurino e uma ação carregam o nível |
| L3 Forte | Conteúdo forte | 10 de 10 | O mesmo; uma pessoa, uma ação |
| L4 Intenso | Uma cena íntima entre dois adultos | 0 de 8 | Suavizado todas as vezes. Não gaste novas tentativas aqui |
| L5 Extremo | Contenção consensual entre adultos, ou gore cinematográfico | 7 de 8 e 6 de 8 | Nas falhas, os objetos ou o sangue ficaram, mas faltou parte da cena |
Nenhuma execução foi recusada ou borrada. No L4, o texto para vídeo deu duas figuras emaranhadas ou cortadas em uma cama sem desenhar a cena, nas quatro execuções, e a imagem para vídeo cortou do quadro inicial para um novo plano de quarto sem mais ninguém (as três sondas da nossa segunda rodada). Não vimos recusa nem borrão, então isso parece contenção do próprio modelo, não um filtro. O teto prático para trabalho adulto é um adulto por clipe, onde toda execução do L1 ao L3 passou. A análise do HunyuanVideo 1.5 dá a ele um Freedom Score de 88.1.
Dois adultos em um clipe: um ponto de contato
Duas pessoas em contato próximo é o ponto fraco deste modelo. Escrevemos um mesmo momento de duas formas: um abraço completo ("They wrap their arms around each other and sway pressed close together, her face buried in his neck") e um único ponto de contato com espaço entre eles:
An adult couple in their thirties in a dim hotel bar at night, she in a dark green satin dress on the left, he in a white shirt with rolled sleeves on the right. They stand a hand's width apart; her palm rests flat on his chest and his hand rests at her waist. She leans in until her forehead touches his, then they both smile. Warm amber light, slow push-in, cinematic, photorealistic.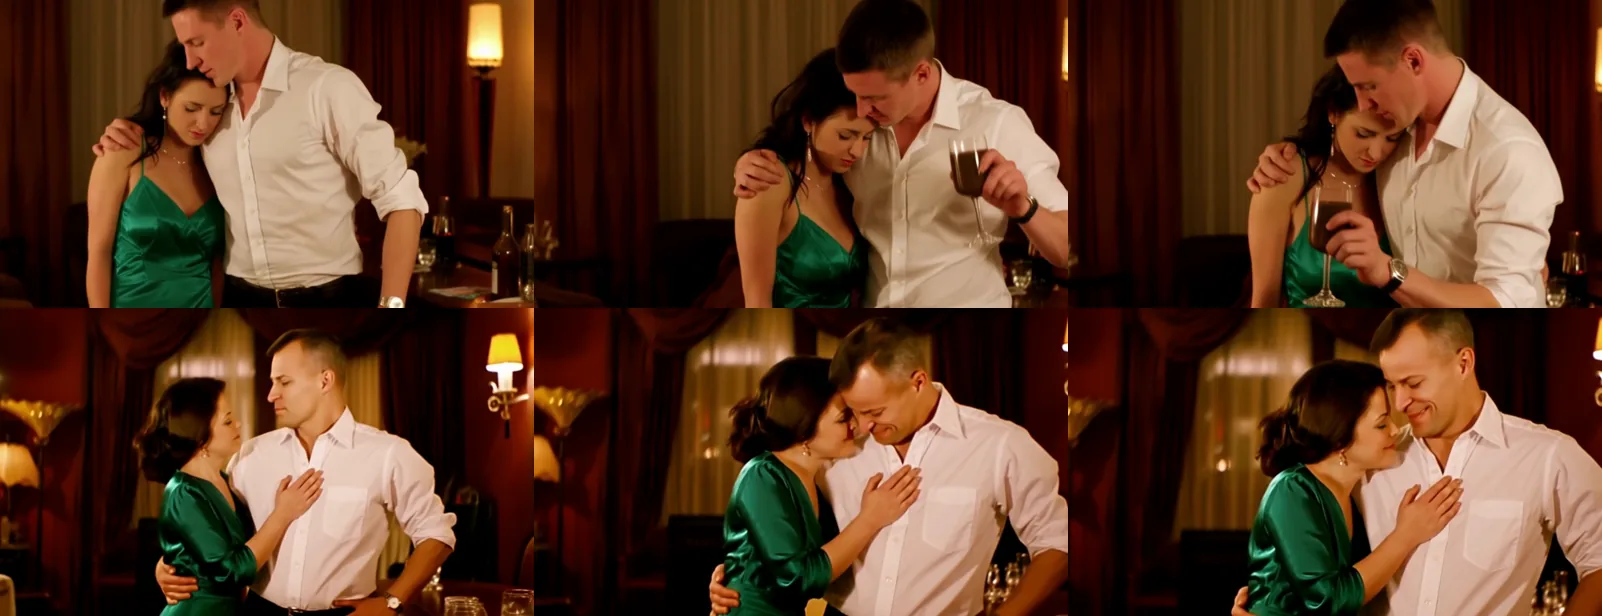
Texto para vídeo, 480p, seed 62002. Em cima: o prompt de abraço completo. Embaixo: o prompt de ponto de contato.
O abraço nunca aconteceu como escrito. Neste seed virou um abraço de lado enquanto ele bebia de uma taça que ninguém pediu; no outro, as mãos se embaçaram juntas no ombro dela. A versão com ponto de contato entregou todas as etapas nos dois seeds: palma no peito, mão na cintura, testas juntas, dois sorrisos. Esquerda e direita foram seguidas em um seed e trocadas no outro, então trate as posições como uma sugestão.
Para duas pessoas: dê a cada uma um figurino distinto, descreva um ou dois pontos de contato e o espaço entre eles, e termine em uma ação do rosto.
O prompt negativo: para que serve
O texto para vídeo aceita um negative_prompt; a imagem para vídeo não. O código de quem publica o deixa vazio por padrão e o manual não o menciona, então trate-o como uma lista do que você nunca quer no quadro. Nossa lista inicial:
blurry, distorted hands, extra fingers, extra limbs, text, watermarkO que ele conteve e o que não conteve nas nossas execuções de exemplo de 5 de outubro:
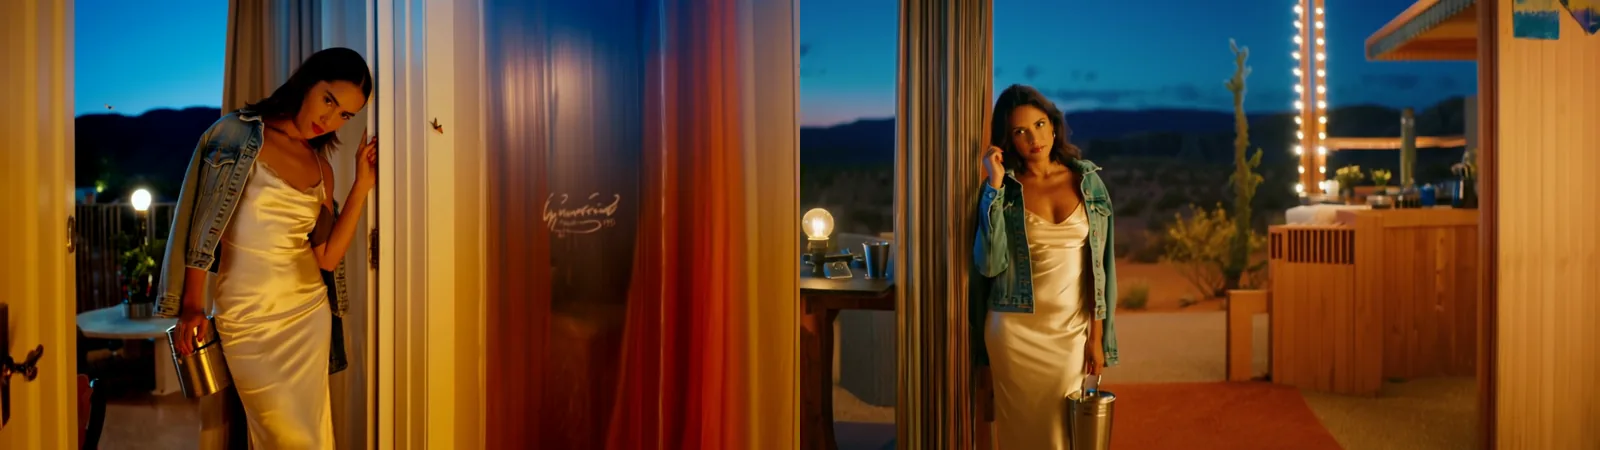
Texto para vídeo, 720p, o mesmo prompt e o mesmo prompt negativo (que lista "text, lettering, logo") em dois seeds. O clipe da esquerda ainda desenhou escrita na cortina.
Esse prompt dizia também "no signs or lettering anywhere". O HunyuanVideo 1.5 é feito para renderizar texto (o manual o mostra escrevendo palavras entre aspas nas cenas) e, nas nossas execuções, inventou letras em cortinas, placas de carro e emblemas de carros. O prompt negativo reduz a chance; um novo seed é a nova tentativa mais barata para o que escapa.
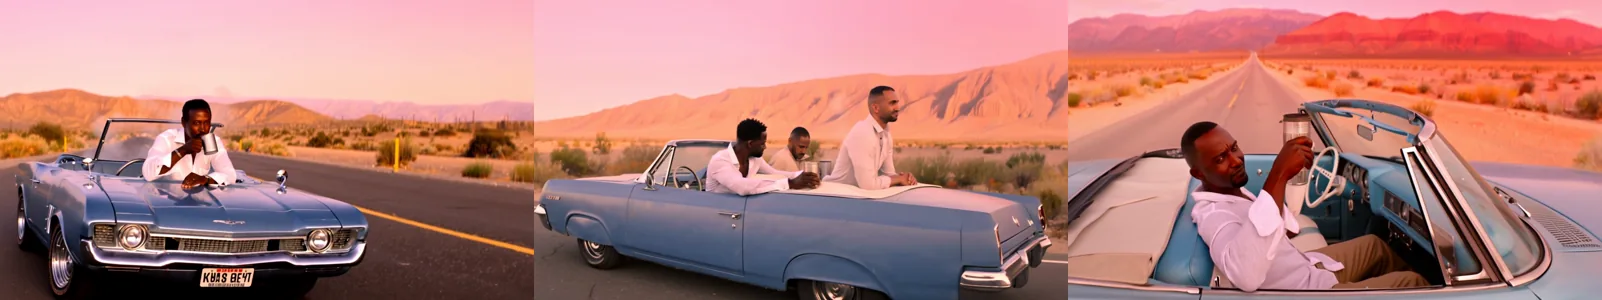
Texto para vídeo, 720p, três versões de um mesmo plano. Esquerda: "no number plate, no lettering" no prompt, sem prompt negativo. Meio: um prompt negativo sem "extra people". Direita: "extra people" acrescentado e a câmera aproximada.
Duas lições. O prompt negativo só cobre o que você nomeia: o clipe do meio pedia um homem e trouxe três, e acrescentar "extra people" resolveu. E o enquadramento é um conserto mais forte que a lista: planos abertos deram ao modelo espaço para inventar placas, emblemas e passageiros, enquanto o plano próximo deixou só uma pequena marca cromada no primeiro segundo. Em cenas adultas, vigie espelhos, pôsteres e telas ao fundo da mesma forma.
Imagem para vídeo: o quadro inicial faz o trabalho pesado
No endpoint de imagem para vídeo, a foto fixa o rosto, o figurino, a luz, o formato do quadro e o nível inicial da cena. O prompt só diz o que acontece a seguir, na ordem de quem publica: movimento do sujeito, movimento da cena, câmera. Ele é opcional, e não existe campo de prompt negativo.
Demos a um mesmo quadro inicial dois prompts, dois seeds cada: um que fica na foto e outro que sai dela. O quadro é uma imagem 3:4 feita com o modelo de imagem Jib Mix Qwen, um jeito comum de definir uma personagem antes de animá-la.
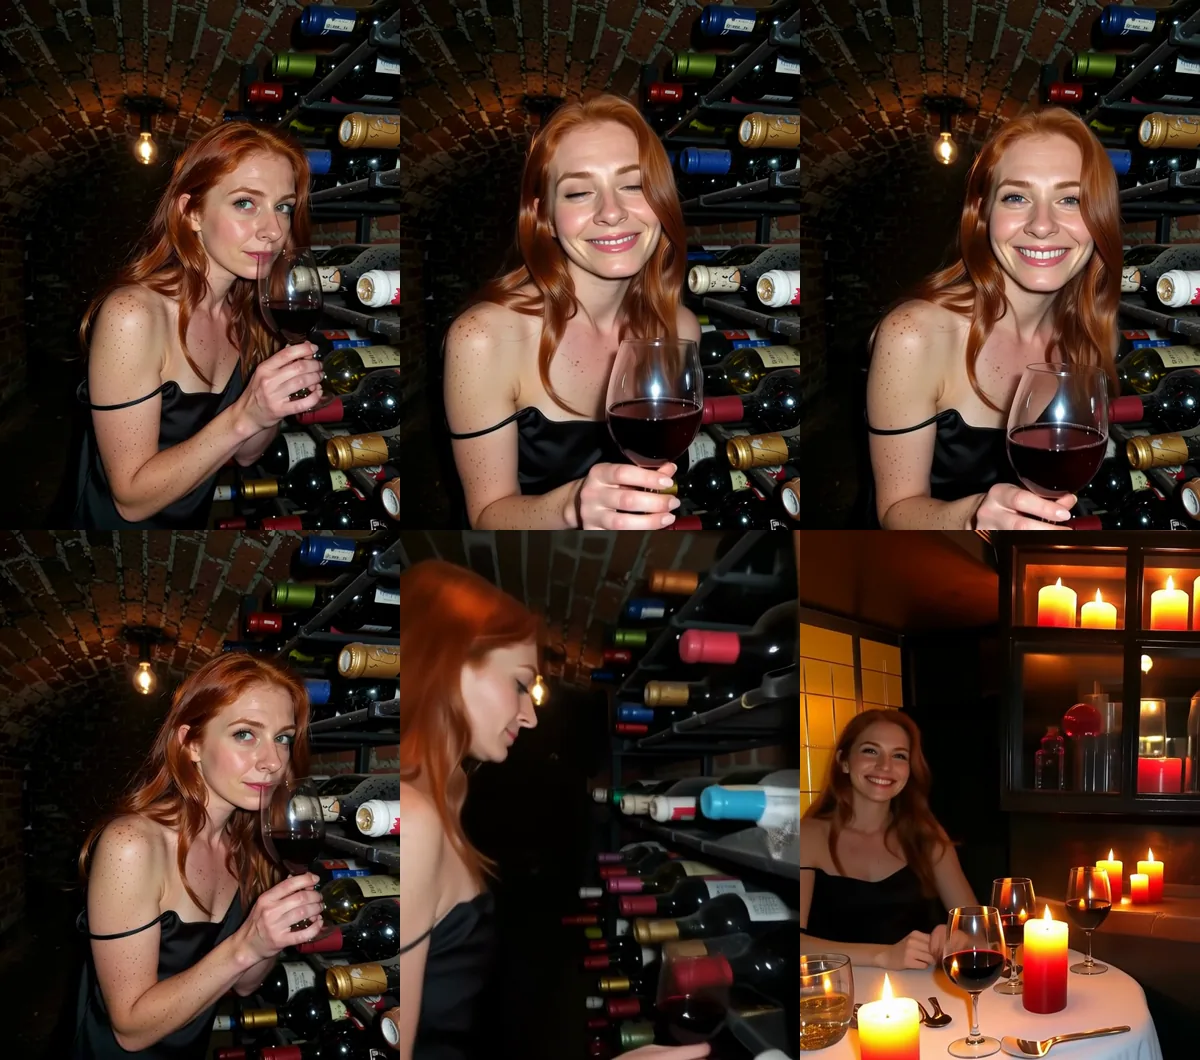
Imagem para vídeo, 480p, seed 63001; o clipe voltou com 544 x 720. Em cima: "She lowers the wine glass, turns her head toward the camera and holds the look, then lets a slow smile spread. The light bulb above her sways slightly. The camera holds still." Embaixo: "She sets the wine glass down, walks up the cellar stairs into a candlelit restaurant upstairs, sits at a table by the window and smiles at the camera." O seed 63002 deu o mesmo resultado.
Ficar na adega manteve o rosto, as sardas e a alça escorregando nos dois seeds. Sair dali cortou para uma sala nova nos dois seeds e, depois do corte, o rosto, o vestido e a alça mudaram. Se a cena precisa de um segundo lugar, faça um segundo quadro inicial.
O tamanho do movimento também importa, como sugerem duas das nossas execuções de 5 de outubro em 720p:
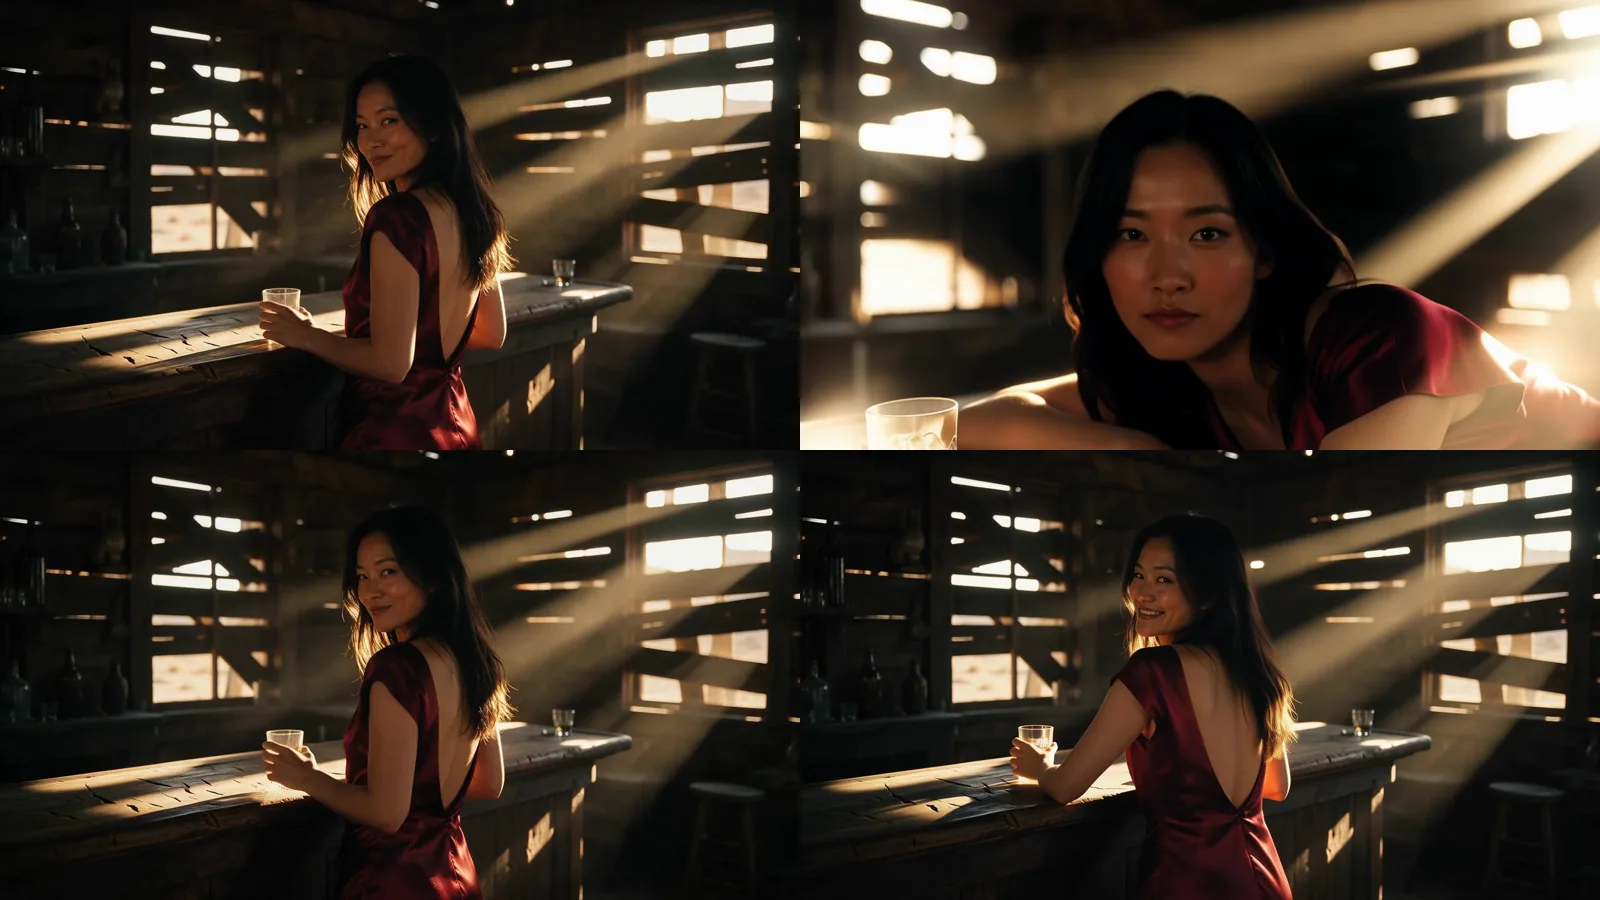
Imagem para vídeo, um quadro inicial, início e fim de dois clipes em seeds diferentes. Em cima: "turns slowly to face the camera and leans back on her elbows", leve aproximação. Embaixo: "takes a slow sip… lets a slow, amused smile spread", câmera fixa.
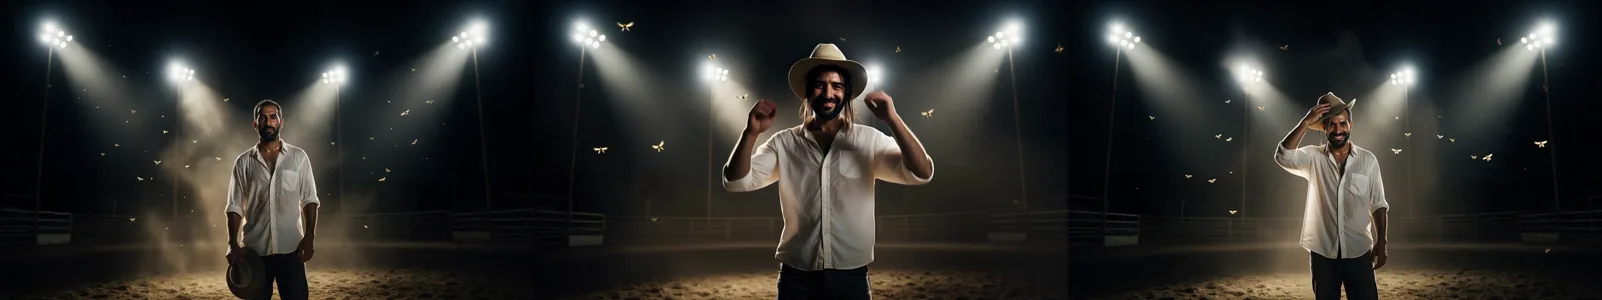
Imagem para vídeo, um quadro inicial. Meio: pedimos que tirasse a poeira do chapéu com um tapa, passasse a mão no cabelo e pusesse o chapéu. Direita: pedimos só que enxugasse a testa; o modelo pôs o chapéu por conta própria e o rosto se manteve.
Nas duas falhas, as mãos cruzaram o rosto ou o rosto chegou mais perto da lente do que na foto; portanto o modelo provavelmente teve de redesenhá-lo e desenhou outra pessoa. Mantenha as ações pequenas (um gole, um olhar, um sorriso), a câmera fixa ou lenta e qualquer coisa que cubra o rosto limitada a um gesto.
O quadro inicial também define o nível de partida: a partir de fotos vestidas, os prompts da nossa escada levaram uma única figura até o L3 mantendo o rosto e o ambiente, mas uma cena a dois a partir de uma foto de uma pessoa nunca apareceu.
Resolução, duração e formato
| Escolha | Nossa preferência | Por quê |
|---|---|---|
| 480p ou 720p | Rascunhos em 480p, 720p para o definitivo | Metade do preço; o 480p levou de 39 a 73 segundos de tempo de modelo nas execuções deste guia, o 720p de dois a quatro minutos |
| 5 ou 8 segundos | 5, a menos que você tenha quatro ou mais ações | Três ações preencheram 5 segundos; 8 segundos custam 60% a mais |
| 16:9 ou 9:16 | 9:16 para feeds de celular | Escreva o enquadramento para o formato, como "vertical medium shot from waist height" |
| Formato em imagem para vídeo | Corte a foto antes | O clipe segue a foto |
| Seed | Fixo enquanto você edita | O mesmo seed não promete um clipe idêntico |
Um rascunho de 5 segundos em 480p custa $0.12, um clipe final de 5 segundos em 720p custa $0.24 e um de 8 segundos em 720p custa $0.384, em qualquer um dos endpoints. Os clipes são silenciosos, então planeje o som na edição: como adicionar voz e música a um vídeo NSFW de IA.
Padrões que se desviaram e o que escrever no lugar
| Padrão | O que vimos | Em vez disso |
|---|---|---|
| Adjetivos de clima | Olhar posado, detalhes da cena perdidos | Duas ou três ações visíveis |
| Abraço completo entre dois adultos | Um abraço de lado, mãos borradas, um objeto inventado | Um ou dois pontos de contato |
| Um gesto raro ("loosens one cuff") | Trocado por uma mão no colarinho | Um gesto comum |
| "No lettering" no prompt principal | Uma placa de carro inventada | Prompt negativo e um enquadramento mais fechado |
| Plano aberto com carros ou letreiros | Texto inventado e pessoas a mais | Aproxime a câmera |
| Pose reclinada de corpo inteiro | Um pé a mais; um close pedido foi ignorado | Enquadre da cintura para cima |
| Imagem para vídeo: um lugar novo ou uma inclinação para a lente | Um rosto novo | Segundo quadro inicial, movimentos pequenos |
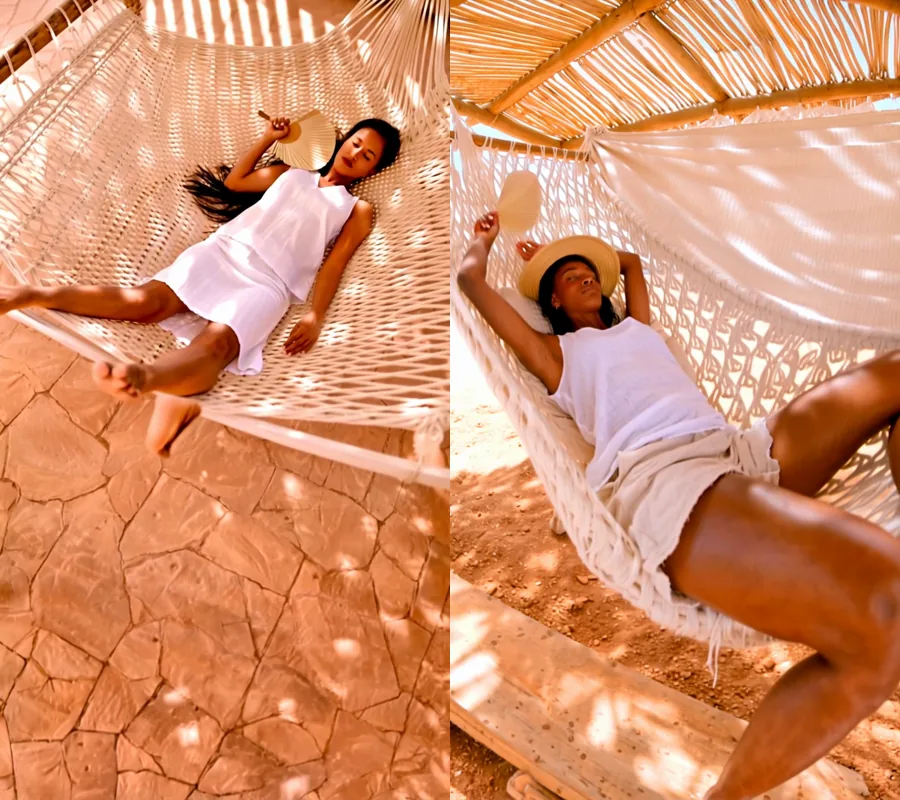
Texto para vídeo, 720p, 9:16, duas tomadas de um mesmo plano reclinado das nossas execuções de 5 de outubro. O prompt da direita pedia o rosto e os ombros em close. Nenhum dos dois foi mantido.
Checklist do prompt
Antes de pagar por uma tomada em 720p:
- A linha do sujeito diz "adult" e dá uma faixa etária; a linha do figurino dá peça, tecido, cor e estado.
- Duas ou três ações visíveis em ordem, com gestos comuns e sem adjetivos de clima no lugar delas.
- Um movimento de câmera, enquadrado de forma fechada o bastante para deixar de fora letreiros, placas, telas e pessoas a mais; o lugar descrito pelos seus objetos.
- Duas pessoas só se for preciso: figurinos distintos, um ou dois pontos de contato, uma ação do rosto para terminar.
- Texto para vídeo: um prompt negativo curto que nomeie os seus problemas reais. Imagem para vídeo: uma foto cortada, o mesmo ambiente, ações pequenas.
- Um rascunho de 5 segundos em 480p com seed fixo e, depois, 720p para o definitivo.
Se você precisa de som com a imagem, o LTX-2 19B acrescenta uma trilha de áudio a cada clipe, e o nosso guia de prompts para vídeo de IA sem censura compara como um mesmo prompt se comporta em vários modelos.
FAQ
Como escrever prompts NSFW para o HunyuanVideo 1.5?
Escreva uma lista de planos: um adulto, o figurino, duas ou três ações pequenas em ordem, um movimento de câmera e, por fim, a luz e uma tag curta de estilo. Nas nossas 50 execuções, toda requisição do L1 ao L3 voltou como escrita, enquanto cenas íntimas entre duas pessoas foram suavizadas todas as vezes; por isso, mantenha o trabalho adulto em uma pessoa por clipe.
Como transformar uma imagem em vídeo com um prompt?
Use o endpoint de imagem para vídeo e descreva só o que acontece a seguir no mesmo lugar: uma ação pequena, uma ação do rosto e a câmera. A foto já fixa o rosto, o figurino e a luz. Os prompts que mandavam a pessoa para outro lugar cortaram para um plano novo com outro rosto nos dois seeds.
O Hunyuan tem imagem para vídeo?
Tem. O HunyuanVideo 1.5 tem um endpoint de texto para vídeo e um endpoint de imagem para vídeo. O clipe de imagem para vídeo mantém o formato da sua foto, e o prompt é opcional.
O HunyuanVideo 1.5 usa prompt negativo?
Em texto para vídeo, sim. Foi aceito em todas as execuções em que passamos um, e nomear um problema específico ("extra people") o eliminou, mas letras inventadas ainda passaram uma vez. A imagem para vídeo não tem campo de prompt negativo.
Por que o meu clipe do HunyuanVideo voltou mais contido?
Se era uma cena íntima entre dois adultos, esse é o limite do próprio modelo: todas as nossas 8 execuções nesse nível voltaram suavizadas, sem recusa. Se era um adulto só, torne as ações concretas; adjetivos de clima nos deram clipes posados e estáticos, que pareceram comportados.
Por que o meu clipe de imagem para vídeo está em câmera lenta?
Não medimos isso por conta própria. Quando um usuário relatou câmera lenta no rastreador de issues de quem publica, no GitHub, os mantenedores recomendaram descrever ações mais rápidas no prompt, por exemplo "turns quickly and laughs" em vez de "slowly turns".