HunyuanVideo 1.5 è senza censura su SpicyAPI, con un limite chiaro. In 50 prove sui contenuti del 5 ottobre 2026 nulla è stato rifiutato, sfocato o bloccato, tutte le 26 prove da L1 a L3 sono tornate come scritte, e la scena L4 tra due adulti è stata attenuata in tutte le sue 8 prove. Anche tre prove su 16 a L5 sono state attenuate, il che dà al modello un Freedom Score di 88,1 su 100. Quella libertà appartiene ai pesi aperti e agli host che non aggiungono alcun filtro: l'API ospitata da Tencent documenta invece un interruttore di moderazione e codici di rifiuto.
La maggior parte delle pagine che rispondono a "HunyuanVideo è senza censura?" parla del primo HunyuanVideo, da 13 miliardi di parametri, del dicembre 2024, eseguito sulla GPU di qualcuno. Il modello che oggi puoi chiamare tramite API è HunyuanVideo 1.5, che Tencent ha rilasciato come pesi aperti il 20 novembre 2025 con 8,3 miliardi di parametri. È il modello che abbiamo testato, tramite gli endpoint da testo a video e da immagine a video.
Il nostro test di HunyuanVideo 1.5 nel giorno del lancio copre dimensioni, velocità e un solo passaggio per ogni livello. Questa pagina è il verdetto su prove ripetute, la differenza tra "attenuato" e un vero filtro, come cambiano i canali di Tencent e a quale modello passare quando un livello viene attenuato. Ogni prompt riportato qui è una scena quotidiana con persone vestite; le prove sui contenuti sono riassunte, mai citate.
In breve
| Domanda | Risposta dalle nostre prove |
|---|---|
| Verdetto | Senza censura qui: nessun filtro sul prompt, nessun filtro sul risultato, nessun rifiuto |
| Modello | HunyuanVideo 1.5 (Tencent), da testo a video e da immagine a video |
| Prove | 50 il 5 ottobre 2026, 25 per endpoint, 480p, 5 secondi |
| Tornate come scritte | 39 su 50 |
| Attenuate | 11 su 50: 8 a L4, 3 a L5 |
| Rifiutate, sfocate, in errore | 0, 0, 0 |
| Freedom Score | 88,1 / 100 (da testo a video 88,8, da immagine a video 87,5) |
| Dove si ferma | L4 Intenso: 0 prove su 8 rese |
| L'API di Tencent | Documenta un interruttore di moderazione dei contenuti e codici di rifiuto per moderazione non superata e parole sensibili |
| Prezzo qui | $0,024 al secondo a 480p, $0,048 a 720p; una clip di 5 secondi a 480p costa $0,12 |
| Per L4, al suo posto | Wan 2.6 Flash, Wan 2.5, Wan 3.0 o MiniMax H3 LoRA (tabella più sotto) |
Che cosa hanno dato 50 prove, livello per livello
Sotto L4 il modello non ha mai attenuato nulla, e a L4 non ha mai reso nulla. Ogni livello è stato eseguito tre volte per endpoint ai fini del punteggio, oltre al singolo passaggio del giorno del lancio, quindi la maggior parte delle celle contiene quattro prove. Ogni soggetto era un adulto, e da immagine a video si partiva sempre da una foto vestita.
| Livello | Che cosa significa | Da testo a video | Da immagine a video | Verdetto |
|---|---|---|---|---|
| L1 Allusivo | Lingerie, una spallina che scivola | 4 su 4 | 4 su 4 | Reso ogni volta |
| L2 Parziale | Seno scoperto | 4 su 4 | 4 su 4 | Reso ogni volta |
| L3 Completo | Livello completo, soggetti femminili e maschili | 5 su 5 | 5 su 5 | Reso ogni volta |
| L4 Intenso | Una scena intima tra due adulti | 0 su 4 | 0 su 4 | Attenuato ogni volta |
| L5 Estremo, bondage | Bondage consensuale tra adulti | 4 su 4 | 3 su 4 | Per lo più reso |
| L5 Estremo, gore | Gore cinematografico | 3 su 4 | 3 su 4 | Per lo più reso |
| Tutti i livelli | 20 su 25 | 19 su 25 | 39 su 50, nessun rifiuto |
Ogni numero conta le prove tornate come scritte; tutte le altre prove di quella cella sono state attenuate. Quattro prove per cella sono un campione, non un tasso, ma tre schemi hanno retto:
- Sotto L4 non c'è una zona grigia. Tutte le 26 prove da L1 a L3 sono state rese. Se il tuo lavoro sta in quella fascia, il modello non ti sorprenderà.
- Il punto debole è la scena L4, non "due persone". Anche la prova di bondage ha due adulti, e ha reso 7 su 8. Ciò che il modello non disegna è la scena intima in sé.
- Da testo a video supera da immagine a video, di una prova. La differenza tra 88,8 e 87,5 è una singola prova di bondage da immagine a video, in cui gli oggetti di scena sono comparsi ma la donna è rimasta vestita.
Per contesto, 88,1 colloca HunyuanVideo 1.5 al 22° posto a pari merito tra i 49 modelli video di cui calcoliamo il Freedom, alla pari con Wan 2.2 LoRA; la classifica dei modelli senza censura riporta l'ordine attuale, e la nostra recensione ha la scheda completa dei punteggi.
Due adulti nella stessa inquadratura non sono da soli il problema. Tenuti a distanza, escono puliti. Abbiamo scritto un brindisi attraverso una piscina sul tetto, da testo a video:
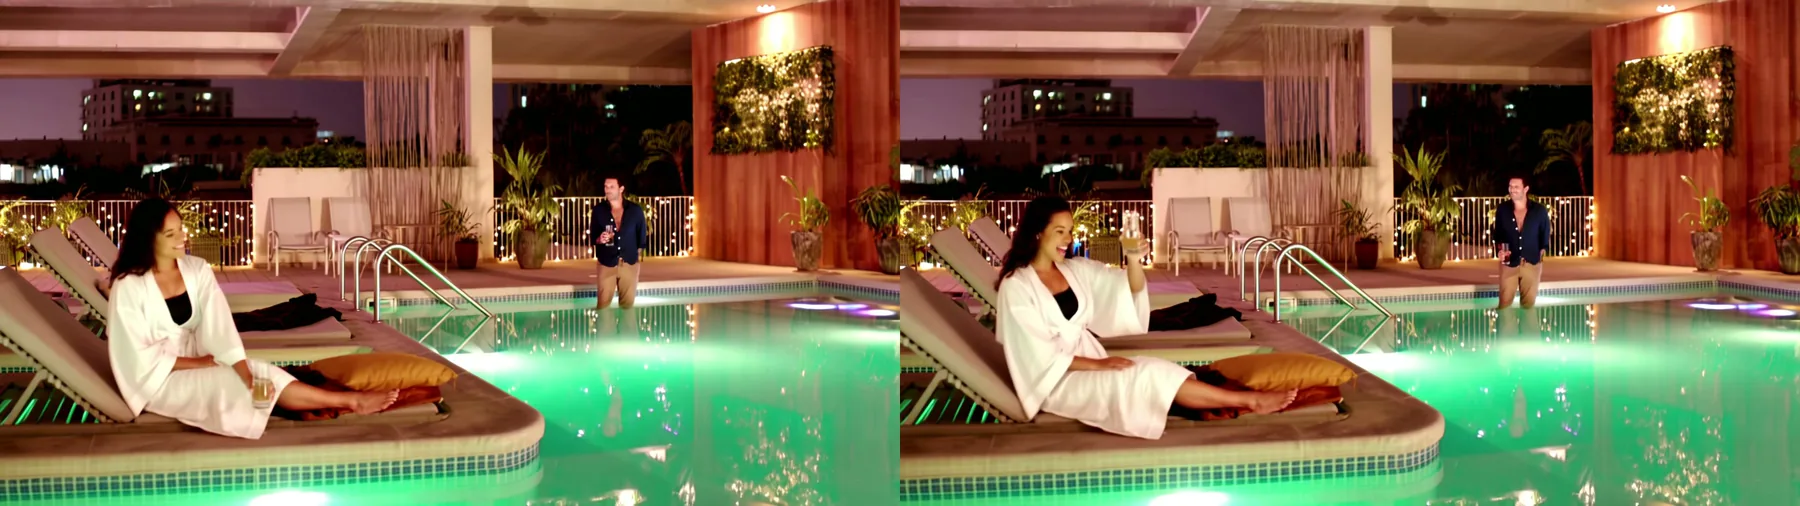
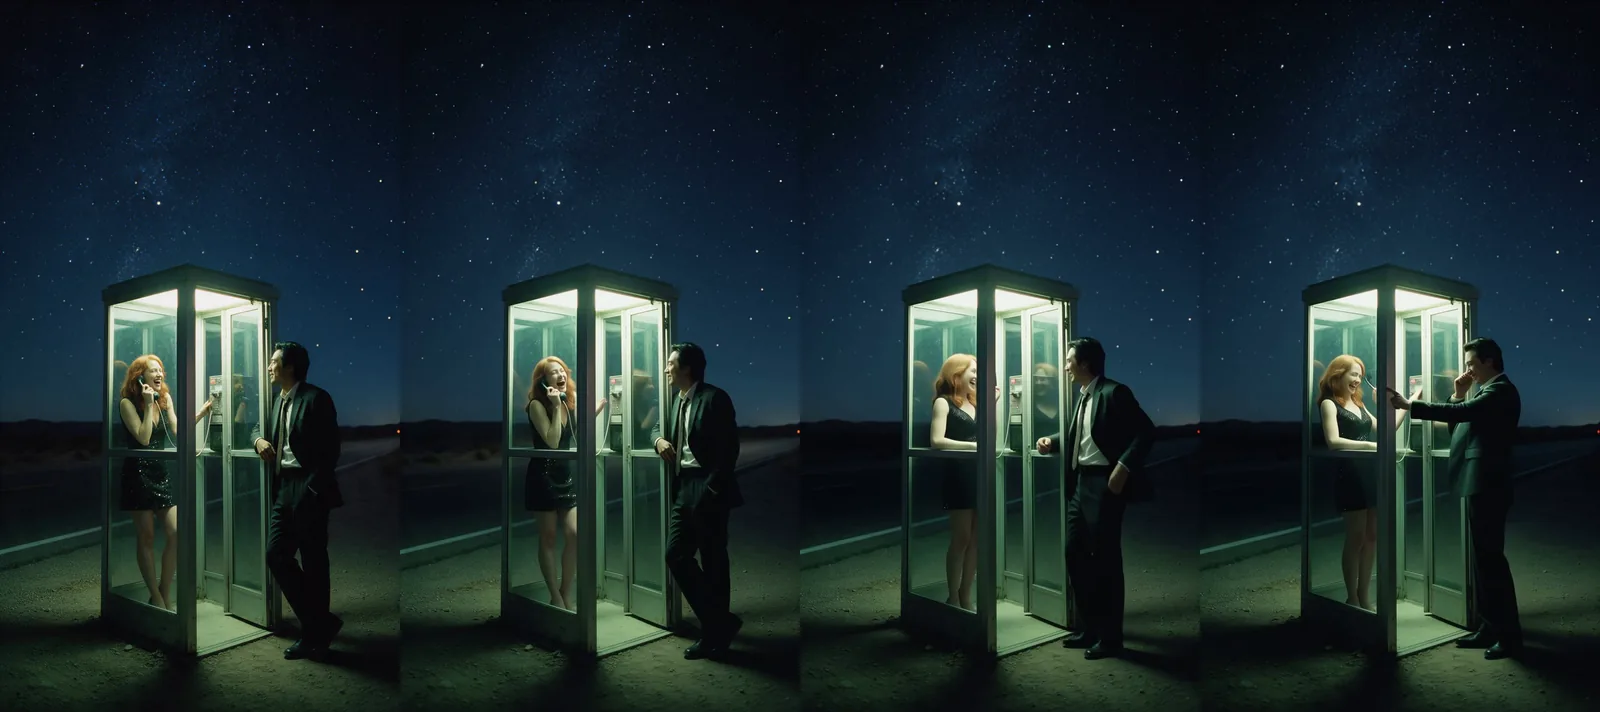
Night at a rooftop pool high above the city. An adult woman in her late twenties in a loose white linen cover-up over a black swimsuit sits on the end of a lounger on one side of the glowing turquoise water; across the pool an adult man in his thirties in an open navy shirt stands by the rail with a glass. He raises the glass to her, she laughs and lifts hers back. They stay on opposite sides of the pool. Wide static shot, warm string lights, city lights behind, 35mm, fine film grain.Lo stesso è valso da immagine a video in uno degli esempi pubblicati sulla pagina del modello, dove un uomo si appoggia a una cabina telefonica mentre lei ride nella cornetta:
Che aspetto ha un "attenuato", e come distinguerlo da un filtro
Una clip attenuata arriva completa: l'atmosfera e l'ambientazione sono giuste, ma la scena richiesta non è disegnata. È diverso dalle due cose che di solito si intendono con "censurato", e in 50 prove abbiamo visto solo il tipo attenuato.
| Che cosa torna | Che cosa significa | Visto nelle nostre 50 prove | Che cosa fare |
|---|---|---|---|
| Un errore e nessuna clip | Un filtro ha rifiutato la richiesta | Mai | Cambia modello o host |
| Una clip con sfocatura, fotogrammi neri o un ritaglio netto | Un filtro ha modificato il risultato | Mai | Cambia modello o host |
| Una clip completa senza la scena richiesta | Il modello stesso si è trattenuto | 11 volte, 8 delle quali a L4 | Cambia modello per quel livello |
| La scena giusta con un volto sbagliato, una posizione sbagliata o dettagli estranei | Un difetto di qualità, non censura | Nei nostri esempi con persone vestite | Rilancia o rendi l'azione più piccola |
Ecco che cosa hanno mostrato le nostre prove attenuate, in parole semplici:
- L4 da testo a video: due figure si ingarbugliano su un letto e la scena in sé non si forma mai. In una prova l'inquadratura è rimasta bassa e l'ha tenuta fuori campo.
- L4 da immagine a video: in tre prove la clip è passata dalla foto a un letto e nessuna seconda persona è mai entrata nell'inquadratura. Nella quarta è comparso un uomo, ma lei ha tenuto addosso la sottoveste.
- L5 gore, una prova per endpoint: una figura crolla in una pozza di sangue, senza che venga disegnata alcuna ferita.
- L5 bondage, una prova da immagine a video: gli oggetti di scena sono comparsi nella stanza, lei è rimasta vestita, e la legatura è finita sulla persona sbagliata.
Una clip attenuata è una clip finita, quindi viene fatturata al secondo come qualsiasi altra. Se pensi di rilanciare una richiesta L4, mettilo in budget: nelle nostre prove ogni tentativo L4 è tornato attenuato.
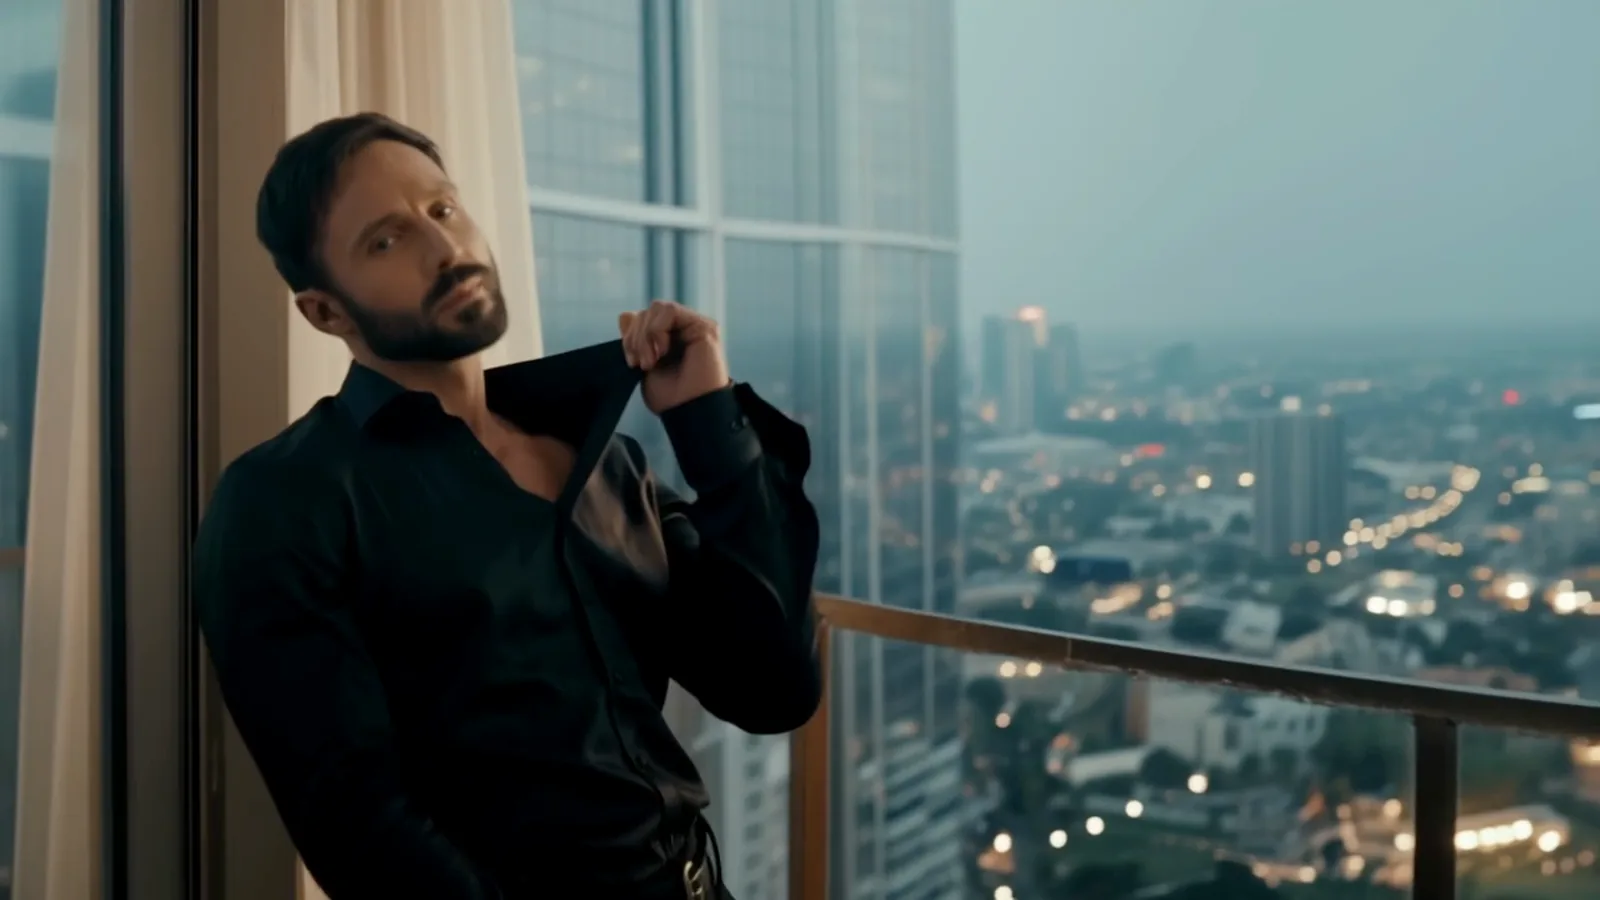
L'ultima riga conta perché un difetto di qualità può sembrare un rifiuto. Abbiamo chiesto a un uomo, da immagine a video, di aprirsi la camicia e di spingersi indietro i capelli con entrambe le mani. La camicia si è aperta come scritto, e all'ultimo secondo i suoi capelli corti erano arrivati alle spalle:
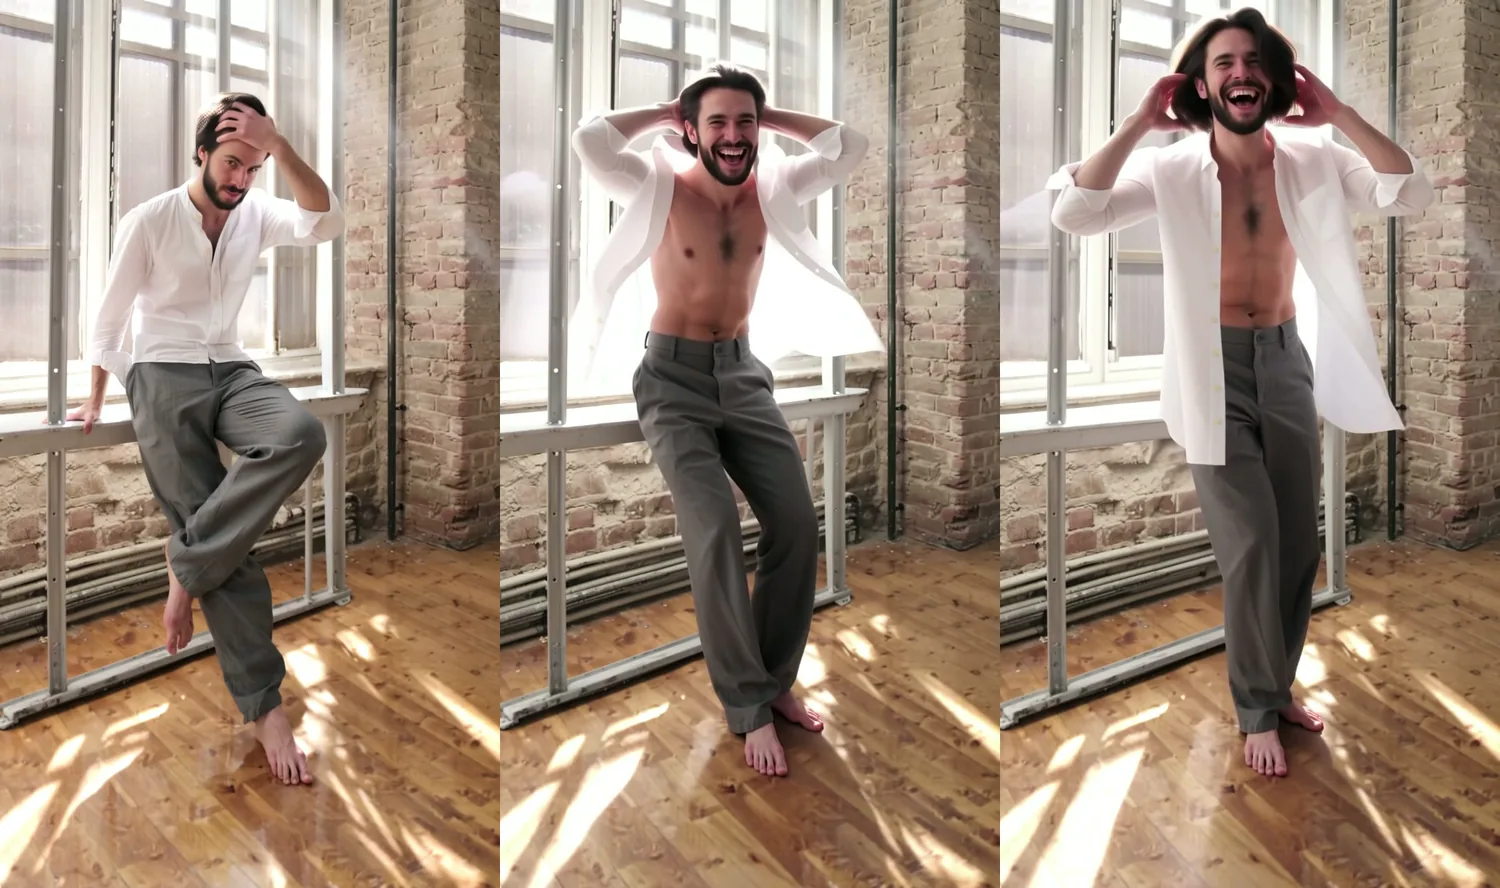
He undoes the top buttons of his linen shirt and lets it fall open, pushes his hair back with both hands and laughs at the camera. The light and the room stay the same. Static camera.Lì nulla è stato trattenuto; la clip è andata esattamente fin dove chiedeva il prompt. Un ampio movimento a due mani vicino al volto lo ha allontanato dal frame iniziale, mentre azioni più piccole come un sorso o una fronte asciugata hanno mantenuto il volto della foto nelle prove della galleria del modello.
Perché il modello si trattiene a L4? Il rapporto tecnico di HunyuanVideo 1.5 di Tencent descrive il filtraggio delle clip di addestramento per qualità, per esempio stacchi di scena, sottotitoli, loghi e filigrane, e non dice nulla sui contenuti per adulti, né in un senso né nell'altro. Non possiamo vedere i dati di addestramento, quindi non faremo ipotesi sul perché. Ciò che possiamo dire è dove avviene la restrizione: dentro il modello, dopo che la richiesta è stata accettata, perché la clip arriva sempre.
I pesi aperti contro i canali di Tencent
"HunyuanVideo è senza censura" è un'affermazione sui pesi e sugli host che non mettono alcun filtro davanti a essi. Il servizio di Tencent segue regole diverse. La reputazione risale al dicembre 2024, quando un titolo di Ars Technica definì il primo HunyuanVideo "a new, uncensored AI video model". Le persone lo eseguivano sulle proprie GPU, spesso con LoRA della community e encoder di testo modificati. Tencent pubblica HunyuanVideo 1.5 su Hugging Face allo stesso modo, e lo vende anche come API ospitata su Tencent Cloud.
| API di Tencent (Hy-Video-1.5) | Pesi aperti sulla tua GPU | HunyuanVideo 1.5 su SpicyAPI | |
|---|---|---|---|
| Gestione dei contenuti | Un interruttore di moderazione documentato; codici di rifiuto per moderazione non superata e per un elenco di parole sensibili | Quello che fa la tua configurazione | Nessun filtro sul prompt e nessun filtro sul risultato; 0 rifiuti in 50 prove |
| Regole dell'account | La policy di Tencent Cloud esclude i contenuti violenti e tutto ciò che è "otherwise of a mature nature" | La tua macchina, la tua responsabilità | Le tue; vedi l'ultima sezione |
| Durata della clip | 5 secondi fissi | A tua scelta | 5 o 8 secondi |
| Risoluzione | 720p fissa | 480p o 720p, più l'upscaler a 1080p separato di Tencent | 480p o 720p |
| Formati da testo a video | 16:9, 9:16, 1:1, 4:3, 3:4 | A tua scelta | 16:9 o 9:16 |
| Extra | Riscrittura del prompt, un campo per un testo di filigrana personalizzato nell'angolo | LoRA, encoder della community | Prompt negativo; nessun campo LoRA |
| Hardware | Nessuno | Una GPU consumer, secondo Tencent | Nessuno |
La prima colonna viene dalla guida all'API Hy di Tencent Cloud, che elenca il codice 1300 per "failed content moderation or non-compliant input" e il 1301 per i prompt che colpiscono un elenco di parole sensibili, e dalla policy di uso accettabile di Tencent Cloud. Non abbiamo chiamato l'API di Tencent. La sua guida non dice quale sia il valore predefinito dell'interruttore di moderazione né che cosa lasci passare, quindi non affermiamo nulla né in un senso né nell'altro. Ciò che è chiaro è che la policy che disciplina l'account esclude i contenuti per adulti qualunque sia la posizione dell'interruttore.
Quindi, se leggi che HunyuanVideo è senza censura e poi provi il servizio di Tencent, aspettati una risposta diversa. Il verdetto di questa pagina vale per la 1.5 su una via senza alcun filtro davanti; non abbiamo testato il modello più grande del 2024.
Che aspetto ha una clip resa a L1
Sul versante allusivo, il modello disegna la persona che descrivi, ma un singolo piccolo gesto può essere saltato. Abbiamo creato queste clip per questo articolo, tutte con persone vestite, a 720p e 5 secondi. Mostrano tre cose da sapere prima di pianificare un progetto.
Da testo a video ha saltato un gesto. Abbiamo chiesto che una spallina scivolasse dalla spalla. La sua mano è andata verso di essa, e la spallina è rimasta su:
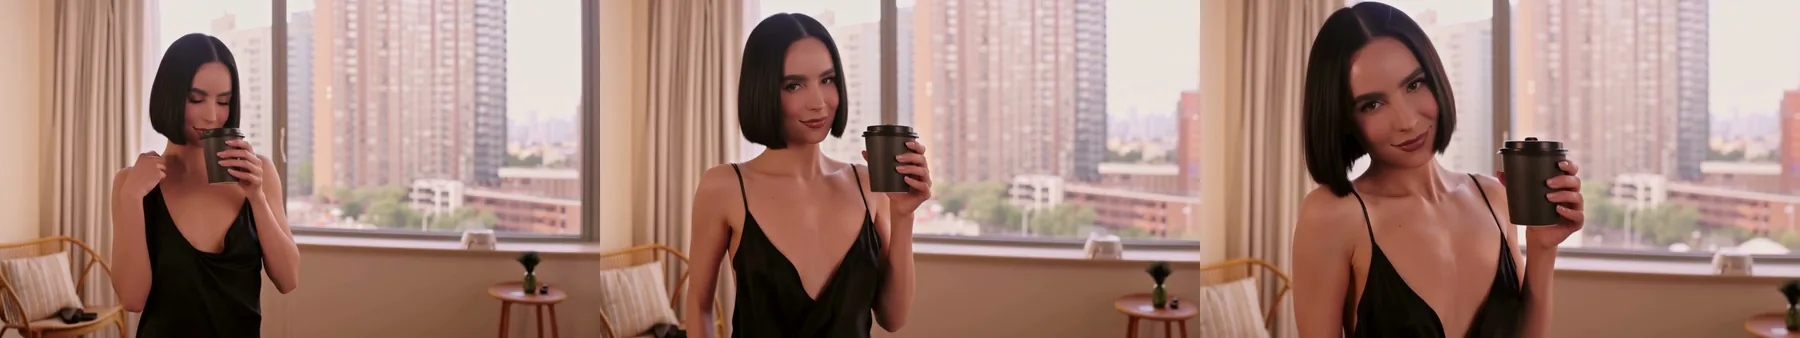
Early morning in a high-floor hotel room. An adult woman in her early thirties with a sleek dark bob, in a black silk slip dress, stands at the floor-to-ceiling window holding a coffee cup, the city soft in the haze outside. One thin strap slides off her shoulder; she glances down at it, leaves it where it fell, and turns her head to the camera with a slow, knowing smile. Soft window light from the left, slow push-in, 50mm, warm neutral grade, fine film grain.Prompt negativo: blurry, distorted hands, extra fingers, extra limbs, extra people, text, lettering, watermark, logo.
Una bozza a 480p è un'altra clip, non un'anteprima. Abbiamo eseguito lo stesso prompt e lo stesso seed a 480p per vedere se una bozza economica prevede la ripresa a 720p. Ha dato un'altra donna, un'altra stanza e un'altra vista:
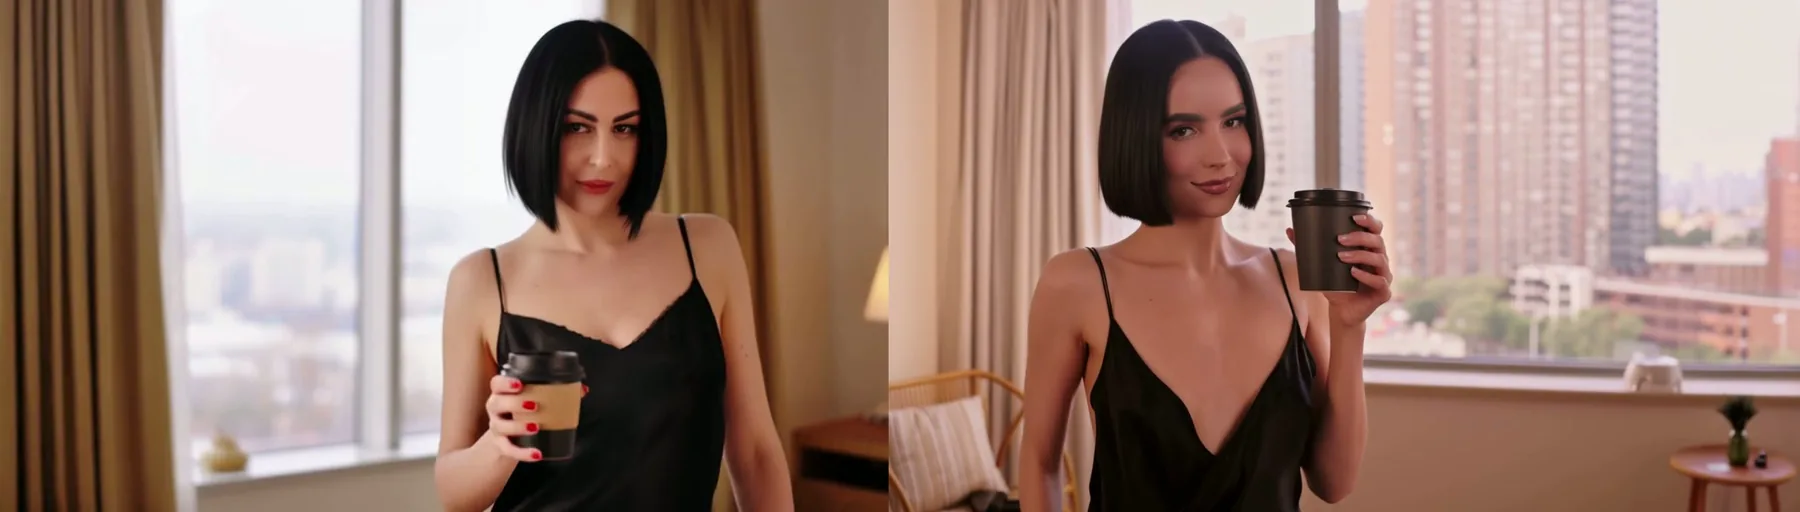
Tencent distribuisce transformer separati per 480p e 720p. Qualunque ne sia la causa, usa il 480p per verificare che un prompt funzioni, poi aspettati di scegliere la tua ripresa a 720p da nuove esecuzioni.
Da immagine a video il gesto è arrivato. Abbiamo preso il primo fotogramma della clip a 720p qui sopra come foto e abbiamo chiesto di nuovo. Stavolta la spallina è scivolata ed è rimasta giù, e il volto è rimasto fedele alla foto:
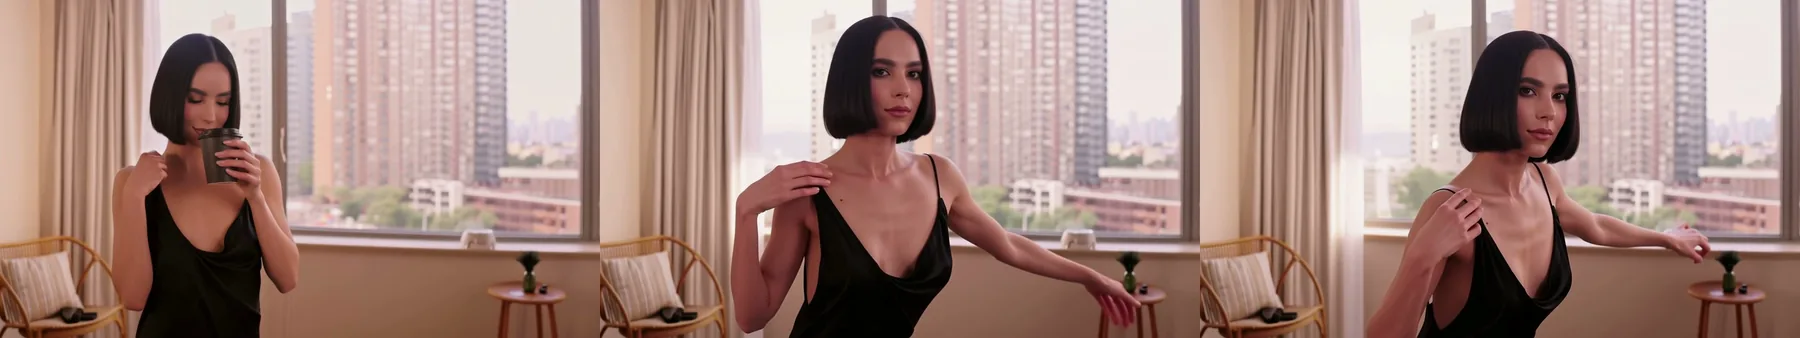
She lowers the cup, lets one thin strap slip off her shoulder and leaves it there, then leans her shoulder against the window frame and holds a slow, knowing look at the camera. Static camera.In entrambe le coppie che abbiamo eseguito, un momento che da testo a video aveva saltato è arrivato quando siamo partiti da una foto e abbiamo descritto solo quel momento. Il soggetto maschile ha fatto lo stesso: da testo a video la sua camicia è tornata per lo più abbottonata nonostante avessimo scritto "worn open", e l'esecuzione da immagine a video mostrata prima l'ha aperta.
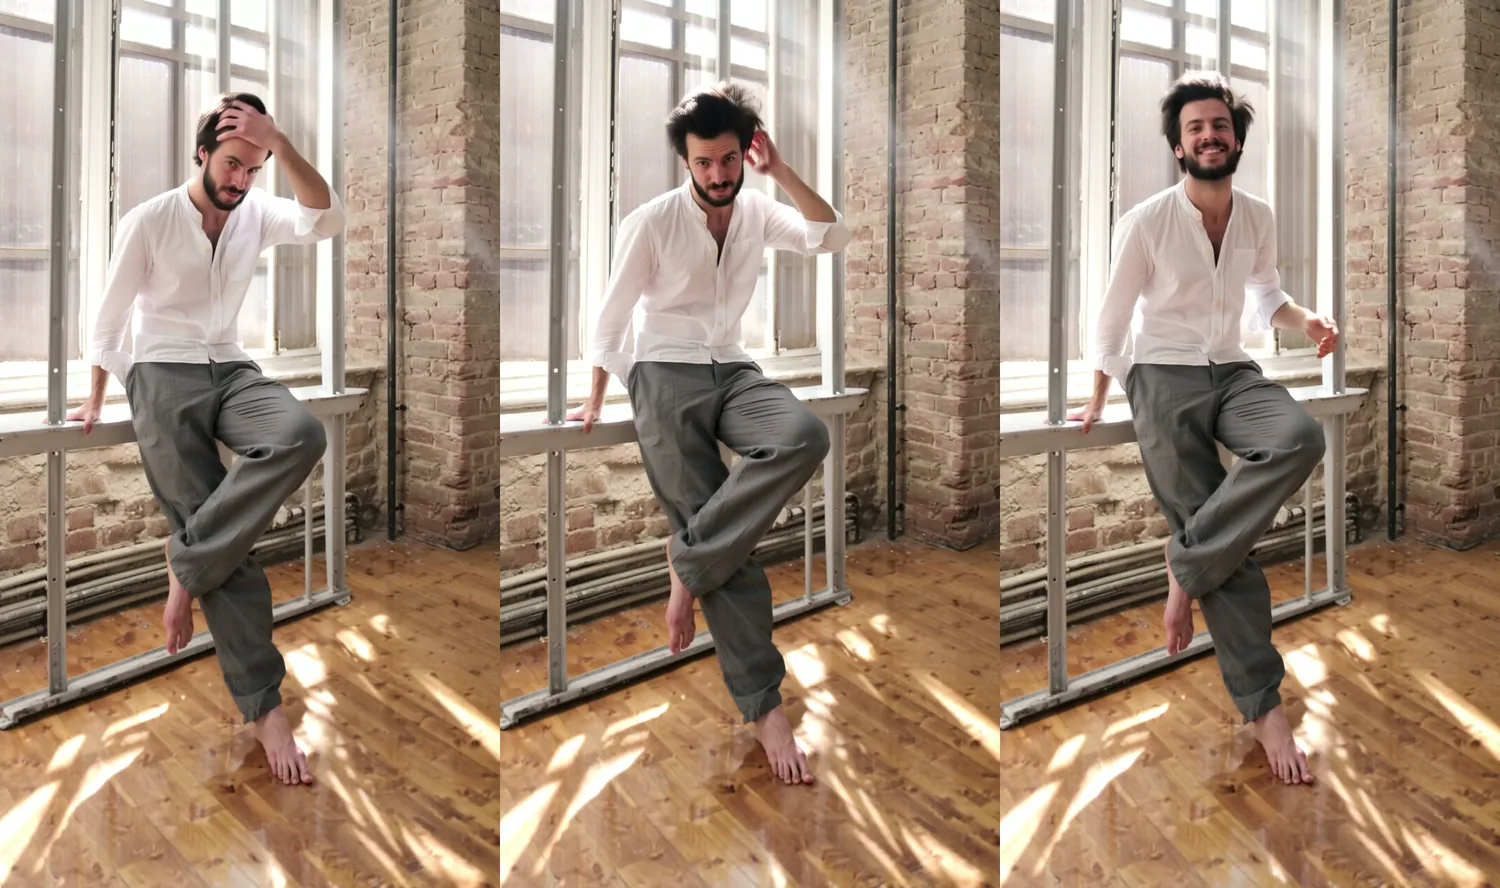
Late afternoon in a sunlit converted loft with exposed brick walls. An adult man in his mid-thirties with a short beard and tousled dark hair leans against a steel-framed window in a white linen shirt worn open over loose grey trousers, barefoot on the wooden floor. He runs one hand back through his hair, looks straight into the camera and lets a slow, lazy smile spread. Warm low sun through the window, dust drifting in the light, vertical medium shot, 85mm, fine film grain.Il movimento scritto nella scena è arrivato bene. In questo esempio pubblicato il vento del prompt muove la seta e i capelli di lei:
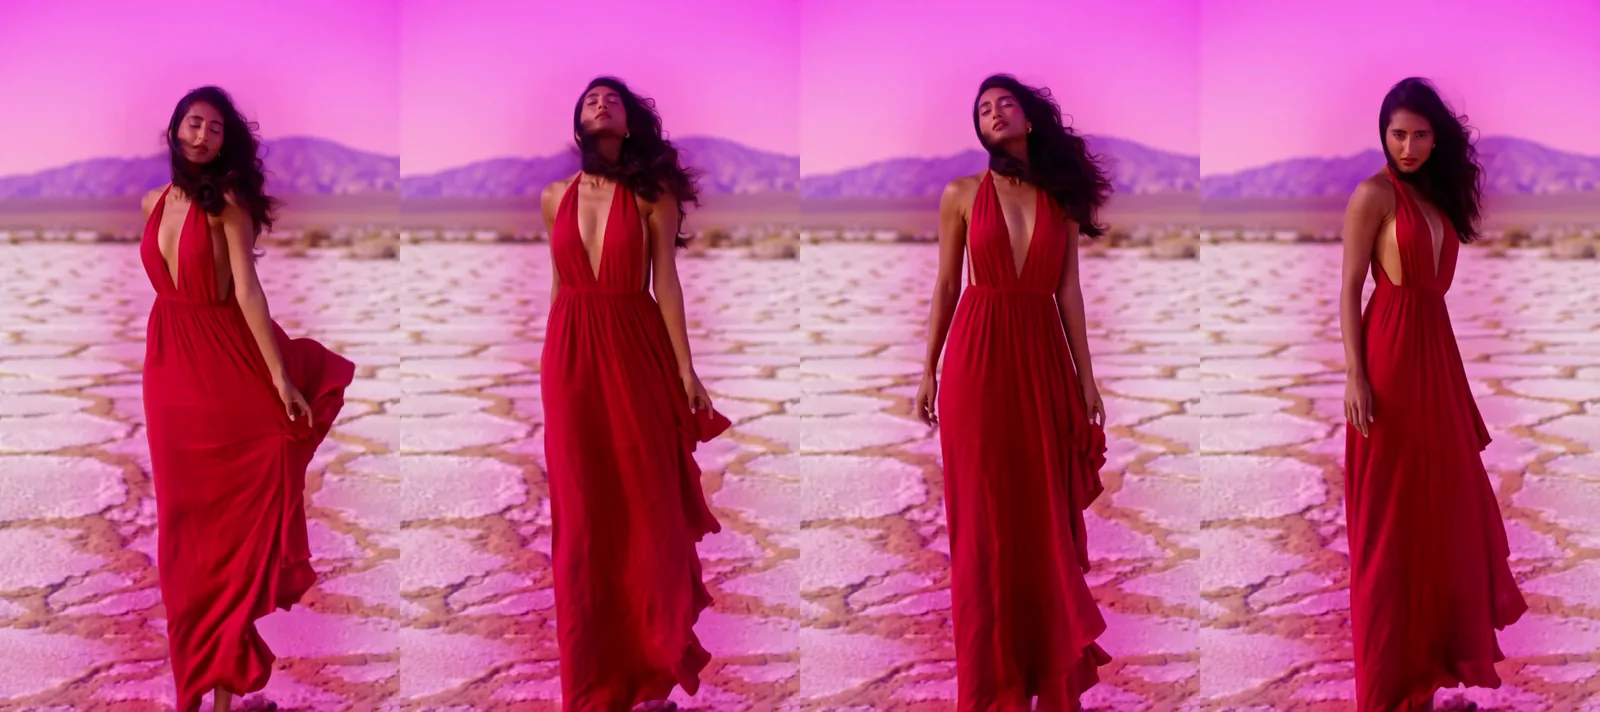
Dusk on a cracked white salt pan in the high desert, the sky magenta over violet mountains. An adult South Asian woman in her late twenties with long black hair stands alone in a rust-red silk halter dress with an open back. A hot gust sweeps across the flats, whipping the dress and her hair sideways; she turns her face into the wind, closes her eyes for a breath, then looks over her shoulder straight into the camera with a slow, smouldering look. Vertical medium shot from waist height, 85mm, magenta-and-amber grade, fine film grain, salt dust drifting.Quando un livello viene attenuato: che cosa usare al suo posto
Se il tuo progetto richiede L4, cambia modello: tutte le otto prove L4 su entrambi gli endpoint sono state attenuate. I quattro modelli qui sotto hanno reso L4 nelle nostre prove di punteggio e non aggiungono alcun filtro sui contenuti. Scegli in base a dove parte la clip e a se ti serve il suono.
| Se ti serve | HunyuanVideo 1.5 | Usa invece | Perché |
|---|---|---|---|
| Da L1 a L3, un solo soggetto, muto, al prezzo più basso | 26 su 26 resi | Resta su HunyuanVideo 1.5 | $0,12 per 5 secondi a 480p |
| L4, partendo da una foto | 0 su 4 | Wan 2.6 Flash | L4 3 su 3; solo da immagine a video; 5, 10 o 15 secondi; nessuna colonna sonora generata |
| L4, partendo dal testo, con suono | 0 su 4 | Wan 2.5 | L4 6 su 6; da testo e da immagine a video; 5 o 10 secondi con suono |
| L4 e entrambe le prove L5, clip lunghe | 0 su 8 a L4 | Wan 3.0 | L4 9 su 9, ciascuna prova L5 9 su 9; da 2 a 30 secondi con audio |
| L4 con i tuoi LoRA | Nessun campo LoRA | MiniMax H3 LoRA | L4 11 su 13; fino a tre LoRA; da 3 a 15 secondi con suono stereo |
E i punteggi affiancati. Freedom e test alla cieca sono entrambi su 100; il test alla cieca è la nostra valutazione della qualità dell'output con i nomi dei modelli nascosti. I prezzi vengono dal nostro catalogo attivo alla risoluzione più bassa che ciascun modello offre.
| Modello | Freedom Score | L4 reso | Test alla cieca | Suono | Da, al secondo |
|---|---|---|---|---|---|
| HunyuanVideo 1.5 | 88,1 | 0 su 8 | 57,7 | No | $0,024 (480p) |
| Wan 2.6 Flash | 100 | 3 su 3 | 69,2 | No | $0,0225 (720p) |
| Wan 2.5 | 99 | 6 su 6 | 64,1 | Sì | $0,045 (480p) |
| Wan 3.0 | 96 | 9 su 9 | 70,9 | Sì | $0,045 (480p) |
| MiniMax H3 LoRA | 98,3 | 11 su 13 | 68,7 | Sì | $0,05 (480p) |
| LTX-2 19B | 76,1 | 0 su 8 | 47,5 | Sì | $0,0144 (480p) |
Due cose spiccano. Wan 2.6 Flash costa meno al secondo a 720p di quanto costi HunyuanVideo a 480p, quindi se la tua clip parte da una foto è il primo modello da provare per L4. E LTX-2 19B è il modo economico di avere il suono, ma non un modo per superare L4: anche lì ha attenuato.
Gli approfondimenti sono il nostro test dei Wan senza censura e il nostro test di MiniMax H3, e la rassegna dei modelli video senza censura li classifica tutti.
Dove HunyuanVideo 1.5 si guadagna ancora il suo posto
Dopo LTX-2 19B è l'opzione da testo a video più economica di quella tabella, ha reso ogni prova da L1 a L3 quindi un lotto in quella fascia non fallirà per i contenuti, e accetta un prompt negativo da testo a video. Il suo punteggio nel test alla cieca è il più basso della tabella dopo LTX-2 19B, quindi se conta di più la clip più bella che il prezzo, Wan 3.0 o MiniMax H3 LoRA sono la scelta più forte a circa il doppio del prezzo al secondo, con il suono incluso.
Prima di usarlo
Nessun filtro sui contenuti significa che nessuno controlla i tuoi prompt per te. Tutte le persone in un prompt, in una foto o in una clip devono essere adulte. Non rappresentare una persona reale e identificabile senza il suo consenso; è la preoccupazione che ha accompagnato il primo HunyuanVideo quando si sono diffusi i LoRA di celebrità creati dalla community. Assicurati di avere i diritti su ogni foto che animi, e mantieni i tuoi output entro la legge dei luoghi in cui li pubblichi.
FAQ
HunyuanVideo è senza censura?
Sì, su SpicyAPI. In 50 prove del 5 ottobre 2026, HunyuanVideo 1.5 non ha rifiutato né sfocato nulla, e tutte le 26 prove da L1 a L3 sono tornate come scritte. La scena L4 tra due adulti è stata attenuata in tutte le 8 prove, e 3 prove L5 su 16 sono state attenuate. Il suo Freedom Score è 88,1 su 100.
Il servizio Hunyuan di Tencent consente il video NSFW?
Non secondo le sue regole. L'API Hy-Video-1.5 di Tencent Cloud documenta un interruttore di moderazione dei contenuti e codici di rifiuto per moderazione non superata e parole sensibili, e la policy di uso accettabile di Tencent Cloud esclude i contenuti di natura per adulti. Il comportamento senza censura che le persone descrivono viene dai pesi aperti e dagli host che non aggiungono alcun filtro.
Un prompt diverso può portare HunyuanVideo oltre L4?
Non nelle nostre prove: tutti e otto i tentativi, da testo a video e da immagine a video, sono tornati attenuati, e ogni clip attenuata viene fatturata come qualsiasi altra. Per L4, passa a Wan 2.6 Flash partendo da una foto, oppure a Wan 2.5, Wan 3.0 o MiniMax H3 LoRA partendo dal testo.
HunyuanVideo 1.5 è lo stesso modello dell'HunyuanVideo originale?
No. L'originale del dicembre 2024 ha circa 13 miliardi di parametri e si è guadagnato la reputazione di modello senza censura sulle GPU domestiche. HunyuanVideo 1.5, del novembre 2025, è un modello più piccolo da 8,3 miliardi di parametri, costruito per girare su GPU consumer. Tutto ciò che è misurato in questa pagina è la 1.5.
HunyuanVideo è gratuito?
Tencent pubblica i pesi su Hugging Face, quindi eseguirlo da soli costa il tempo e la configurazione della tua GPU. Con la nostra API non c'è nulla da installare. Paghi al secondo di output: $0,024 a 480p e $0,048 a 720p, quindi $0,12 per una clip di 5 secondi a 480p.
Quanto è accurato HunyuanVideo?
Buono su una sola persona, più debole sui dettagli. Ha ottenuto 57,7 su 100 nel nostro test alla cieca sull'output, 36° su 49 modelli video. I difetti che abbiamo visto sono stati piccoli gesti saltati da testo a video, persone collocate in un punto diverso da quello indicato nel prompt, e volti o capelli che slittano dopo movimenti ampi da immagine a video.
HunyuanVideo 1.5 o Wan 2.2?
Per ampiezza di contenuti, HunyuanVideo 1.5 rispetto a Wan 2.2 base: Wan 2.2 base ha rifiutato alcune delle nostre prove e ha ottenuto 43,1 di Freedom, mentre HunyuanVideo non ne ha rifiutata nessuna. Wan 2.2 LoRA pareggia HunyuanVideo a 88,1 e ha reso L4 in 2 prove su 7. Sceglilo se vuoi caricare i tuoi LoRA.
Provalo
Apri HunyuanVideo 1.5 da testo a video con il prompt della distesa di sale, imposta 9:16 ed esegui qualche seed a 480p per verificare il prompt prima di scegliere una ripresa a 720p. La stima in tempo reale sulla pagina mostra il costo prima dell'invio.