Ir al contenido principal

daVinci-MagiHuman API

sand-ai/davinci-magihuman/image-to-video

La función de imagen a video de daVinci-MagiHuman anima tu foto en un clip de 5 a 10 segundos y le da movimiento y voz: pon la frase entre comillas en el prompt o adjunta tu propio audio. 256p, 720p o 1080p, en 16:9 o 9:16.

Desde $0.024/s

Playground

Entrada

Imagen a video
211/5000
Describe qué pasa después de la foto: lo que hace la persona y, entre comillas, lo que dice. Con audio_url definido, omite las palabras y describe el ánimo, el movimiento y la luz. mínimo 3 caracteres · máximo 5000 caracteres
1/1

Arrastra archivos o enlaces multimedia, pega o selecciona · 1 archivo · Máx. 10 MB · JPG · PNG · WEBP

  • 1
1 / 1 archivos
El cuadro inicial. Un enlace público y descargable directamente; el clip parte de esta foto.
0/1

Suelta un audio o elige un archivo · 1 archivo · Máx. 90 MB · MP3 · WAV

0 / 1 archivos
Opcional. Un enlace público a un archivo de habla o canción; el video se genera en sincronía con él en lugar de inventar una voz. Nuestra prueba usó una grabación de 5 segundos para un clip de 5 segundos.
16:9 (por defecto) o 9:16. Nuestras pruebas de imagen a video usaron 16:9. El formato no cambia el precio.
afecta al precio
256p, 720p (por defecto) o 1080p. Los niveles superiores cuestan más por segundo. El modelo renderiza en tamaño reducido y su propia etapa de superresolución produce los niveles superiores; nuestras pruebas a 720p salieron alrededor de 1358 x 678.
Duraciónafecta al precio
De 5 a 10 segundos, por defecto 5, cobrados por segundo. no menor que 5 · no mayor que 10
Seed
Entero opcional. El mismo seed con las mismas entradas da resultados parecidos, no garantizados idénticos. no menor que 0 · no mayor que 2147483647
Filtro de seguridadDesactivado

SpicyAPI no ejecuta ningún filtro de seguridad en este modelo. Tu prompt y tus medios llegan al modelo tal como los escribes, y el propio modelo decide el resultado.

Comprobando tu cuenta antes de habilitar el envío y el cálculo de precios.

Salida

Listo para una nueva ejecución
Resultado de ejemplo

¿No está el modelo que buscas?

Dinos cuál añadir y para qué lo usarías. Las solicitudes llegan directamente al equipo que decide los próximos modelos.

API DE VIDEO HABLADO

La API de daVinci-MagiHuman de un vistazo

Un solo modelo de 15B que genera la imagen y la voz a la vez: una persona que habla a cámara, desde texto o una foto, de 5 a 10 segundos y hasta 1080p.

Parámetros
15B
Un solo modelo genera la imagen y la banda sonora juntas. Los pesos son abiertos bajo Apache 2.0.
Duración del clip
5 a 10 s
Elige una duración de 5 a 10 segundos; por defecto son 5. Nuestros clips salieron a 25 fps.
Resolución máxima
1080p
256p, 720p (por defecto) o 1080p. El modelo renderiza en tamaño reducido y su propia etapa de superresolución genera los niveles superiores; los tamaños salen cercanos al nominal, como unos 1904 x 1088 a 1080p.
Formatos
2
Horizontal 16:9 (por defecto) o vertical 9:16, en ambos endpoints. El sonido y el formato no cambian el precio.
Tu propio audio
Opcional
Envía un archivo de habla o canción como audio_url y el video se genera en sincronía con él, en lugar de inventar una voz.
Idiomas de habla
6
Chino (mandarín y cantonés), inglés, japonés, coreano, alemán y francés, según lista el editor. Nosotros probamos inglés.

Resultados

Lo que puedes crear con daVinci-MagiHuman

  • Texto a video

    Una frase, dicha en el balcón

    Un prompt con una frase entre comillas dio un clip de 1080p de una mujer con melena corta platino en un balcón nocturno, con las luces de la ciudad desenfocadas detrás. Salió alrededor de 1904 x 1088 a 25 fps, 5.0 segundos, con sonido, y nuestra transcripción de la banda sonora coincidió palabra por palabra con la frase. El procesamiento tomó unos 3 min 53 s.

    Texto a video, 1080p, 16:9, cinco segundos, con la frase entre comillas dicha en la banda sonora.

  • Retrato

    Un clip vertical con una risa y una frase

    Con el formato en 9:16, un hombre con pecas y pelo pelirrojo en una calle mojada con neones se ríe y dice su frase. A 720p salió alrededor de 726 x 1270, 5.0 segundos, y la transcripción coincidió palabra por palabra. El procesamiento tomó cerca de un minuto. Escribimos "looks straight into the camera" en lugar de pedir una selfie.

    Texto a video en vertical, 9:16 a 720p, cinco segundos, con la frase entre comillas dicha en la banda sonora.

  • Imagen a video

    Una foto que gira y habla

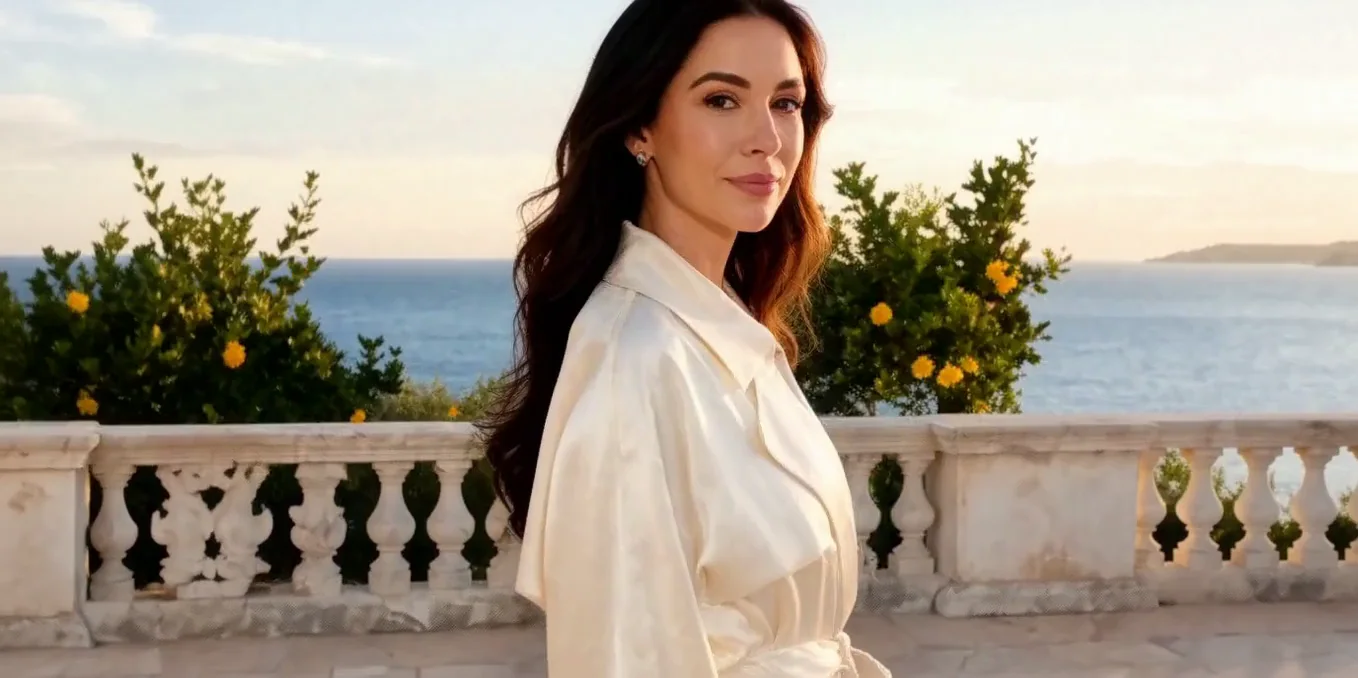
    A partir de un cuadro inicial y un prompt, sin archivo de audio, ella gira desde el mar, se pone el pelo detrás de la oreja y dice la frase. La transcripción coincidió palabra por palabra. A 720p salió alrededor de 1358 x 678, 5.0 segundos, tras unos 1 min 45 s.

    Imagen a video sin archivo de audio, 16:9 a 720p, cinco segundos, con la frase entre comillas dicha en la banda sonora.

  • Tu propio audio

    Un retrato que sigue tu grabación

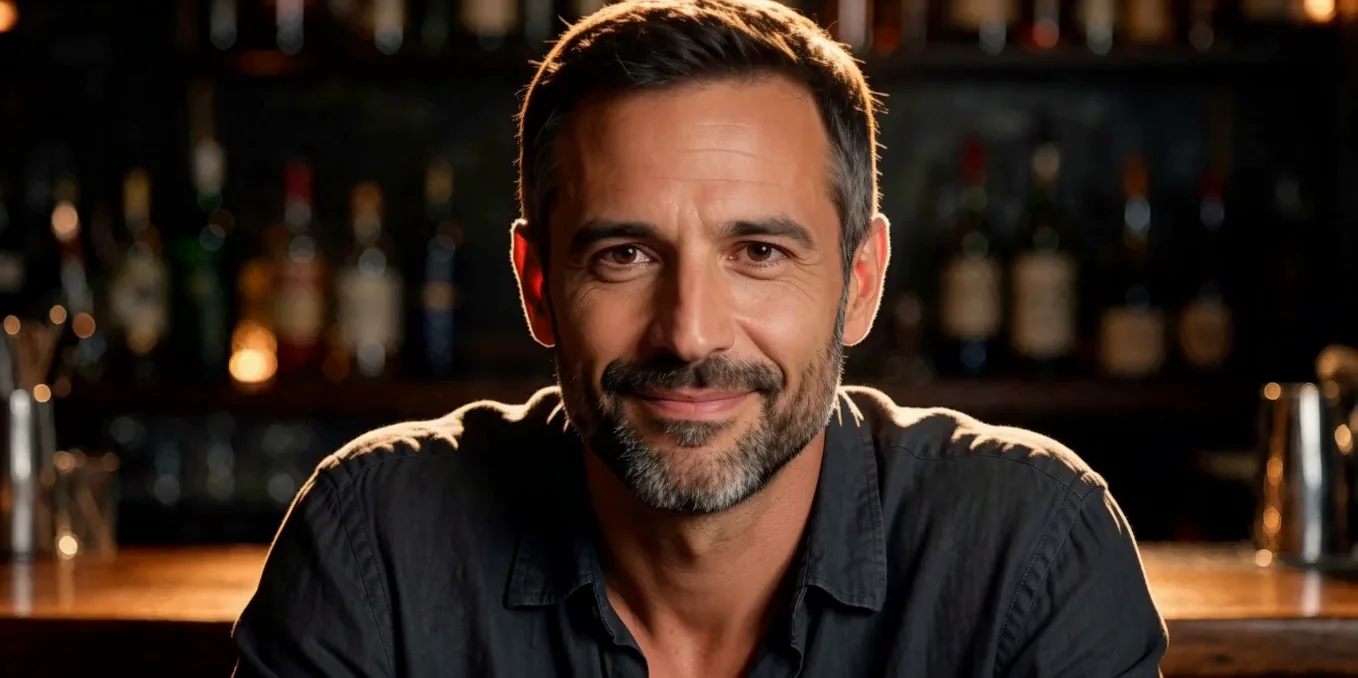
    Con un clip hablado de 5 segundos como audio_url, los labios siguieron el audio suministrado, con una media sonrisa y un movimiento de cejas, y el rostro se mantuvo cerca del retrato de entrada. A 720p salió alrededor de 1358 x 678, 5.0 segundos, tras unos 3 min 7 s.

    Imagen a video con un clip hablado de 5 segundos como audio_url, 16:9 a 720p, cinco segundos.

Antes de correrlo

Lo que conviene saber antes de usar daVinci-MagiHuman

Todos los modos
Los clips duran de 5 a 10 segundos, a 256p, 720p o 1080p, en 16:9 o 9:16. Los tamaños salen cercanos a los nominales, no exactos: 720p en 16:9 dio alrededor de 1358 x 678 y 1080p dio alrededor de 1904 x 1088. Probamos habla en inglés y no probamos canto. Lo que puede mostrar un clip depende de tu prompt y de nuestra política de uso.
Texto a video
La persona y la escena salen de tus palabras, así que describe el encuadre; una solicitud de selfie con teléfono puso un teléfono en el encuadre en una prueba extra. No probamos audio_url en este endpoint.
Imagen a video
Se requiere un cuadro inicial y el clip parte de él. Todas nuestras pruebas de imagen a video usaron 16:9. Con audio_url probamos una grabación de 5 segundos en un clip de 5 segundos, y no probamos una grabación más corta o más larga que el clip.

Casos de uso

Qué construir con la API de daVinci-MagiHuman

  • Clips hablados breves

    Una persona dice una frase a cámara en 5 a 10 segundos: una introducción, un adelanto, un saludo, con la voz generada automáticamente.

  • Clips verticales para el móvil

    Elige 9:16 para feeds e historias. Nuestra prueba vertical a 720p salió alrededor de 726 x 1270.

  • Un retrato que habla con tu grabación

    Parte de una foto y añade un archivo de habla como audio_url; los labios siguen tu audio y el rostro se mantiene fiel a la foto.

  • Pruebas de personaje y diálogo

    Prueba cómo se ve y suena un personaje con una foto de cuadro inicial y una frase corta entre comillas, antes de armar una pieza más larga. Probamos inglés; el editor enumera otros cinco idiomas.

Prompts

Ejemplos de prompts de daVinci-MagiHuman para copiar

Pega uno tal cual en el playground y luego cambia una sola cosa a la vez.

  • Texto a video

    Quién, dónde, la frase entre comillas y luego la luz

    Resultado de este prompt

    Close-up at night on a hotel balcony, city lights blurred behind. A woman in her thirties with a short platinum bob and a black slip dress leans on the rail, looks into the camera with a sly smile and says softly: "You really thought I'd leave without saying goodbye?" Warm practical light, shallow depth of field.

    Por qué funciona. La persona y el lugar van primero, la frase va entre comillas con cómo se dice, y la luz cierra el prompt. Nuestra transcripción coincidió con la frase palabra por palabra.

    Probar este prompt
  • Texto a video

    Di hacia dónde van los ojos

    Resultado de este prompt

    Vertical medium close-up on a rainy neon-lit street at night. A man in his late twenties with freckles, short ginger hair and a wet denim jacket looks straight into the camera, laughs and says: "Okay, I'm lost, but honestly? Best night of the trip." Rain drips from his hair, pink and blue sign reflections on the wet pavement behind him. Handheld, eye level.

    Por qué funciona. "Looks straight into the camera" fijó el encuadre. En una prueba extra, pedir una selfie con teléfono puso un teléfono en el encuadre en su lugar.

    Probar este prompt
  • Imagen a video

    Dale a la foto un momento siguiente

    Resultado de este prompt

    On a sunlit stone terrace above the sea, she turns from the view to the camera, tucks her hair behind her ear and says warmly: "Stay for one more sunset. The boat can wait." Gentle sea breeze, soft golden light.

    Por qué funciona. El prompt dice lo que ella hace después de la foto: gira hacia la cámara, se pone el pelo detrás de la oreja y habla. Ocurrieron las tres cosas y la transcripción coincidió.

    Este modo parte de tu propia imagen: agrégala en el playground antes de correrlo.

    Probar este prompt
  • Imagen a video

    Con tu propia voz, dirige el ánimo y la luz

    Resultado de este prompt

    Leaning on the bar, he speaks low and teasing, a slow half smile and a raised eyebrow, warm amber light.

    Por qué funciona. Las palabras vienen de la grabación que envías, así que el prompt solo fija el ánimo, el movimiento y la luz. Los labios siguieron el audio, con una media sonrisa y un movimiento de cejas.

    Este modo parte de tu propia imagen: agrégala en el playground antes de correrlo.

    Probar este prompt

Comparar

daVinci-MagiHuman frente a modelos similares: cuál elegir

ModeloModosDesdeContenidoElígelo si
OmniHuman 2.0Avatar parlante$0.108 / segundo de salidaCon filtro — Este modelo rechaza sin rodeos las solicitudes que superan sus propios límites. Es un resultado medido, no supuesto; los modelos que no hemos medido no llevan ninguna etiqueta.Ya tienes la grabación de voz y un retrato, y quieres un clip más largo, de hasta 300 segundos, guiado por ese audio. Elige daVinci-MagiHuman en cambio cuando quieres que el modelo diga una frase que escribes entre comillas, o necesitas un clip de 9:16.
Kling Avatar 2.0Avatar parlante$0.051 / segundo de salidaCon filtro — Este modelo rechaza sin rodeos las solicitudes que superan sus propios límites. Es un resultado medido, no supuesto; los modelos que no hemos medido no llevan ninguna etiqueta.Tienes un retrato y tu propio audio, y quieres un clip guiado por ese audio, la misma idea que OmniHuman 2.0. Elige daVinci-MagiHuman en cambio cuando quieres que el modelo diga una frase que escribes entre comillas.

Precios

Precios de la API de daVinci-MagiHuman

Un clip de 5 segundos cuesta desde $0.12 en 256p y desde $0.36 en 1080p.

El playground muestra el costo exacto de tu configuración antes de correrla. Las tareas fallidas o vencidas normalmente no se cobran. Algunos modelos cobran los rechazos de contenido según lo indicado en su página; consulta esas condiciones antes de enviar.

Ver todos los niveles de precio

Primeros pasos

Cómo usar la API de daVinci-MagiHuman en tres pasos

  1. Paso 1

    Pon la frase entre comillas

    El modelo dice lo que va entre comillas. Indica quién habla y cómo (en voz baja, con calidez, riendo) y luego la frase misma. Nuestras tres frases entre comillas tuvieron de 8 a 10 palabras para un clip de 5 segundos, y cada una salió palabra por palabra.

  2. Paso 2

    Describe el encuadre, no un dispositivo

    En una prueba extra de 9:16, al pedir una selfie con el teléfono, apareció un teléfono en el encuadre mirando a cámara desde atrás. Escribe "looks straight into the camera" y el tamaño del plano ("vertical medium close-up") en su lugar.

  3. Paso 3

    Trae tu propia voz con audio_url

    Con un archivo de habla o canción adjunto, el prompt ya no necesita las palabras. Describe el ánimo, el movimiento y la luz, y los labios siguen la grabación. En nuestra prueba, una grabación de 5 segundos coincidió con un clip de 5 segundos.

La referencia de parámetros y los ejemplos de código están en las pestañas API y Readme, arriba en esta página.

Por qué SpicyAPI

Por qué usar daVinci-MagiHuman en SpicyAPI

  • Sin filtro de nuestra parte

    No agregamos ningún filtro de contenido propio. Lo que el modelo genera es lo que recibes.

  • Probado, no supuesto

    Los niveles de contenido salen de generaciones reales que corrimos y revisamos, con la fecha de la prueba en la página.

  • Pagas por resultado, en dólares

    Sin suscripción ni créditos. Las tareas fallidas o vencidas normalmente no se cobran. Algunos modelos cobran los rechazos de contenido según lo indicado en su página; consulta esas condiciones antes de enviar.

  • Una clave para todos los modelos

    Una clave de API y un saldo cubren los modelos de imagen, video, audio y chat, para que explores más modelos desde la misma cuenta.

FAQ

Preguntas frecuentes de la API de daVinci-MagiHuman

Acerca de daVinci-MagiHuman

daVinci-MagiHuman pone el modelo abierto de 15 mil millones de parámetros de Sand.ai y SII-GAIR detrás de una sola API: texto a video e imagen a video con la imagen y la voz generadas juntas, de 5 a 10 segundos a 256p, 720p o 1080p, en 16:9 o 9:16, con la opción de traer tu propio audio. Se cobra por segundo de la duración solicitada, y las solicitudes fallidas no se cobran.

Modelos relacionados y tareas siguientes