Introduzione
Kling 2.6 Immagine in video prende un fotogramma iniziale e un prompt che descrive cosa succede dopo, e restituisce una clip fissa a 1080p di 5 o 10 secondi. Non c'è nemmeno campo aspect_ratio: l'output assume la forma della tua immagine sorgente. generate_audio è opzionale: attivalo per dialogo o suono ambientale generati con il movimento.
Scegli una modalità di Kling 2.6 in base al materiale di partenza
| Cosa hai all'inizio | Modalità |
|---|---|
| una scena scritta | Kling 2.6 Testo in video |
| un'immagine iniziale approvata | Kling 2.6 Immagine in video |
| una clip guida e una foto del personaggio | Kling 2.6 Motion Control |
Caratteristiche principali
Il fotogramma iniziale ancora l'intera clip
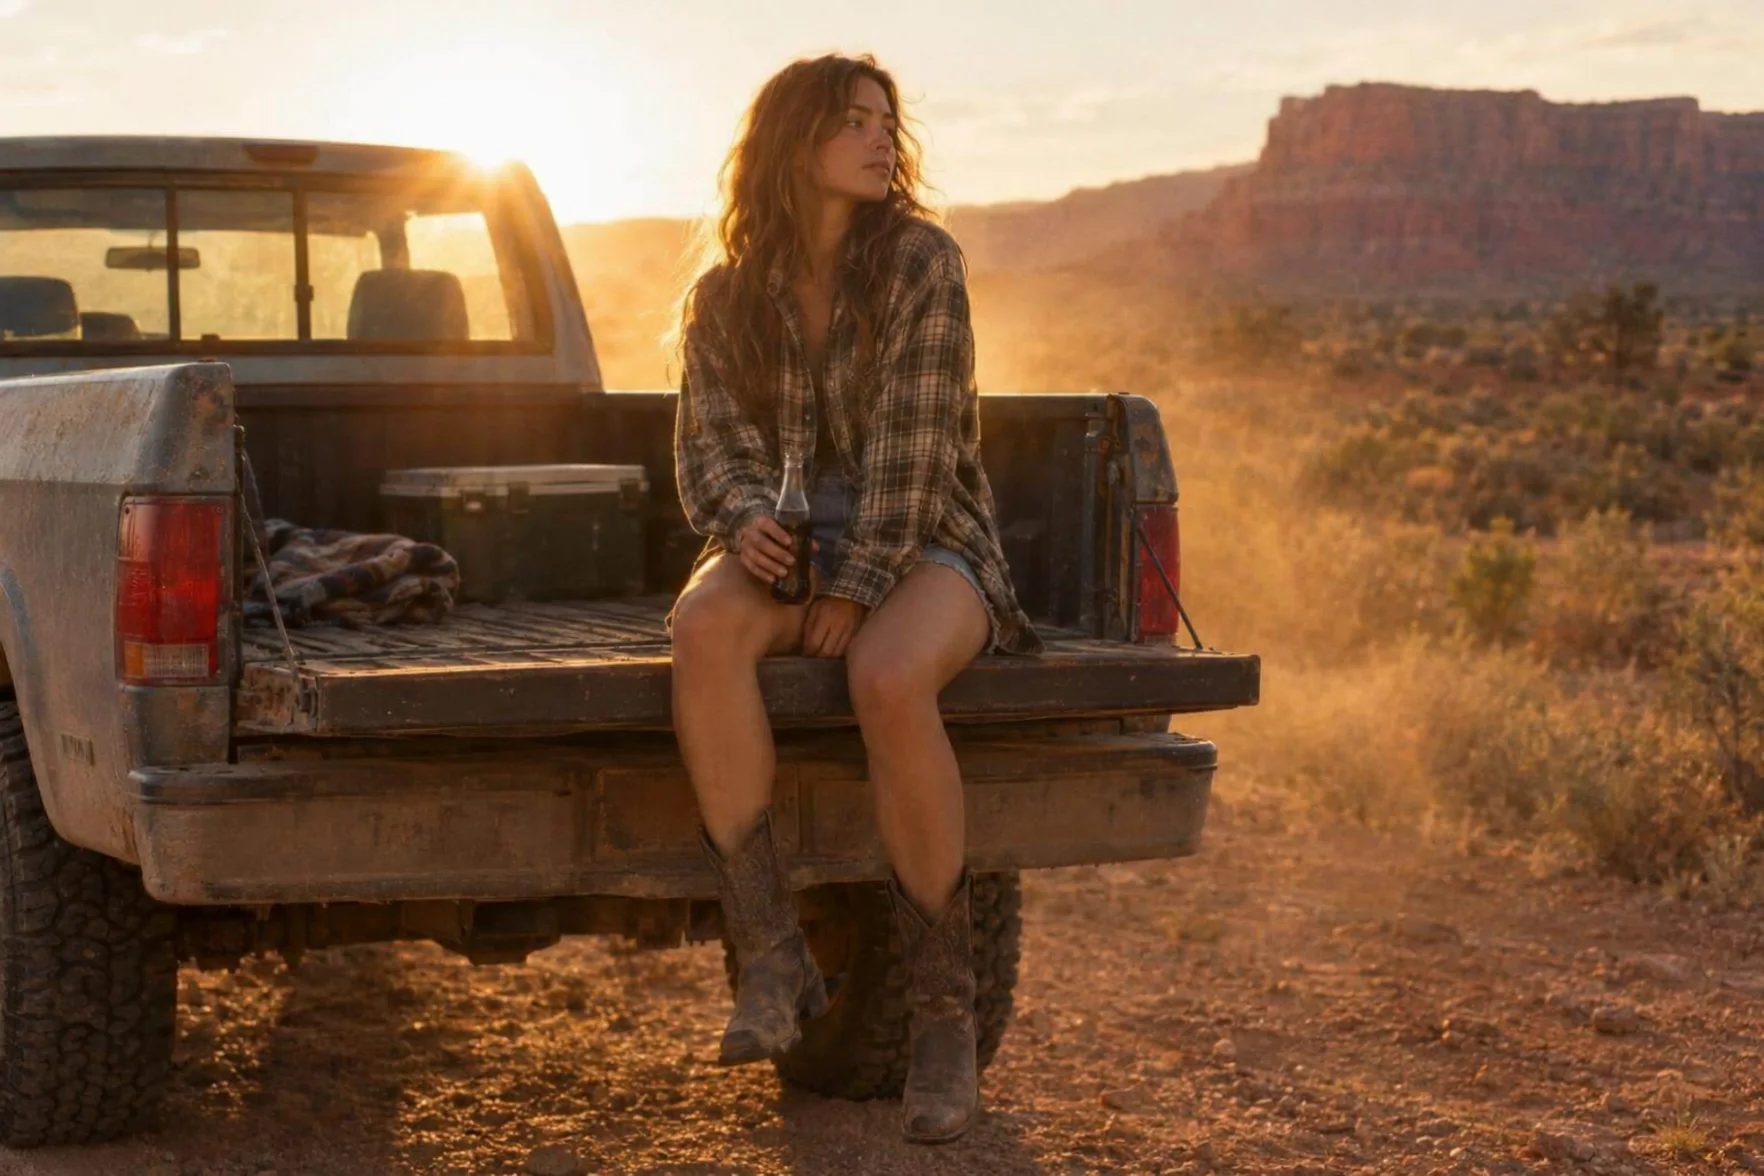
Nel nostro test, la camicia a quadri di una donna, il pickup e l'ambientazione desertica del fotogramma iniziale sono rimasti per tutta la clip; il prompt ha fornito solo il gesto, il girarsi verso il sole e la battuta parlata. Nel nostro test al portellone, una singola foto con camicia a quadri è diventata una clip al tramonto con una battuta parlata, vento del deserto e un camion di passaggio, tutto senza dover ridescrivere l'abbigliamento o l'ambientazione già fissati dalla foto.
L'audio, quando lo chiedi, segue l'azione
Con generate_audio attivo, il nostro test ha restituito vento del deserto, grilli e un camion di passaggio sincronizzati con il momento in cui lei parla, anche se il mix è risultato più basso dell'immagine, il che vale una nuova esecuzione se hai bisogno che l'audio sia più presente.
Parametri della richiesta
| Parametro | Obbligatorio | Nota |
|---|---|---|
prompt | Sì | Descrivi solo ciò che accade dopo il fotogramma: l'azione, il movimento di camera e, se attivi l'audio, il dialogo o il suono ambientale. almeno 1 caratteri · al massimo 2500 caratteri |
image_url | Sì | Fotogramma iniziale. La persona, l'abito e l'ambientazione in questa immagine restano per tutta la clip. |
negative_prompt | No | Ciò che non deve comparire: una seconda persona, sottotitoli, un oggetto di scena che il modello continua a riportare dentro. Scrivi un semplice elenco invece di frasi negative. al massimo 2500 caratteri |
generate_audio | No | Disattivato di default. Attivalo per una colonna sonora generata resa con l'immagine; costa di più al secondo. Predefinito: |
duration_seconds | No | 5 o 10 secondi: nessun altro valore è accettato. Determina il prezzo. |
guidance_scale | No | Quanto la clip segue alla lettera il prompt, da 0 a 1 a passi di 0,01; predefinito 0,5. |
Prezzi
Fatturato al secondo di output; attivare l'audio costa di più al secondo.
| Specifiche | Prezzo |
|---|---|
| $0.069 / secondo |
| $0.138 / secondo |
Casi d’uso
Trasformare un'istantanea approvata in un momento sonorizzato
Anima un personaggio, un prodotto o una location che hai già bloccato in una foto, e aggiungi una breve battuta parlata o un suono ambientale invece di descrivere un'intera scena da zero.
Clip social a formato fisso
1080p, 5 o 10 secondi, è una forma prevedibile e pronta da pubblicare quando non ti serve regolare risoluzione o durata per ogni clip. Questo formato fisso rende inoltre questo endpoint un modo rapido per trasformare un lotto di foto approvate di prodotto o personaggio in una serie di clip dello stesso formato per un feed.
Rimettere in scena la stessa foto con battute diverse
Poiché il fotogramma iniziale ancora l'aspetto, puoi far passare una stessa immagine approvata attraverso più prompt - una battuta diversa, un gesto diverso - mantenendo persona, abbigliamento e ambientazione identici in ogni versione.
Consigli avanzati
Descrivi il momento successivo, non l'intera scena
Poiché il fotogramma già stabilisce l'aspetto, il prompt deve solo fornire il movimento, la camera e, se generate_audio è attivo, il dialogo o il suono ambientale che vuoi. Ridescrivere l'abbigliamento o l'ambientazione che la foto mostra già spreca parole che il modello potrebbe dedicare all'azione.
Solo JPEG o PNG
Il campo immagine di questo endpoint non accetta altri formati. Converti la tua immagine sorgente in JPEG o PNG prima di caricarla. una sorgente WEBP o HEIC fallisce ancora prima che il job inizi.
Se il mix audio risulta troppo basso, dillo nel prompt
Il nostro test nel deserto ha restituito vento, grilli e camion tutti sincronizzati con il momento in cui lei parla, ma mixati più bassi dell'immagine. Se il suono ambientale deve risultare forte quanto il dialogo, dillo esplicitamente nel prompt invece di dare per scontato un mix equilibrato di default.
Avvio rapido dell’API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "kling/2.6/image-to-video",
  "input": {
    "duration_seconds": 5,
    "generate_audio": false,
    "image_url": "https://example.com/reference.png",
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Nel riferimento dell’API trovi autenticazione, schema completo, polling e gestione degli errori.