Przejdź do treści głównej

Tekst na obraz na Z-Image Base, niezdestylowanym modelu Z-Image z 6 miliardami parametrów od zespołu Tongyi-MAI firmy Alibaba, z maksymalnie trzema twoimi LoRA na żądanie. Prompty zdaniami, dziewięć proporcji obrazu, JPEG, PNG lub WebP i brak filtra na promptach, wagach i wynikach.

Od $0.014/obraz

Obszar roboczy

Wejście

Tekst na obraz
406/5000
Najlepiej działają pełne zdania: temat, ubiór, miejsce, światło i obiektyw. Frazę wyzwalającą LoRA umieść na początku. Do 5000 znaków; nie ma promptu negatywnego. od 1 znaków · do 5000 znaków
Dziewięć kształtów o powierzchni około jednego megapiksela, od 21:9 (1536 x 640) do 9:21; domyślnie 1:1. Proporcje zmieniają kształt, nie cenę.
Stylowe LoRA1/3

Mikkoani

Do trzech wpisów {path, scale} wytrenowanych na Z-Image Base; scale od 0 do 4, 1 jest neutralne. LoRA do Turbo nie są kompatybilne. Użyj publicznego bezpośredniego linku do pliku .safetensors. do 3 elementów
Format wyjściowy
JPEGPNGWebP
Domyślnie JPEG, ewentualnie PNG lub WebP. Format nie zmienia ceny.
Seed
Pozwala porównywać serię obrazów, gdy zmieniasz po jednej LoRA albo jednym zdaniu. Nie gwarantuje identycznych pikseli przy każdym uruchomieniu. nie mniej niż 0 · nie więcej niż 2147483647
Filtr bezpieczeństwaWyłączony

SpicyAPI nie uruchamia przy tym modelu żadnego filtra bezpieczeństwa. Twój prompt i media trafiają do modelu w takiej postaci, w jakiej je zapisałeś, a o tym, co wraca, decyduje sam model.

Sprawdzamy twoje konto, zanim odblokujemy wysyłkę i wycenę.

Wyjście

Gotowe do nowego uruchomienia
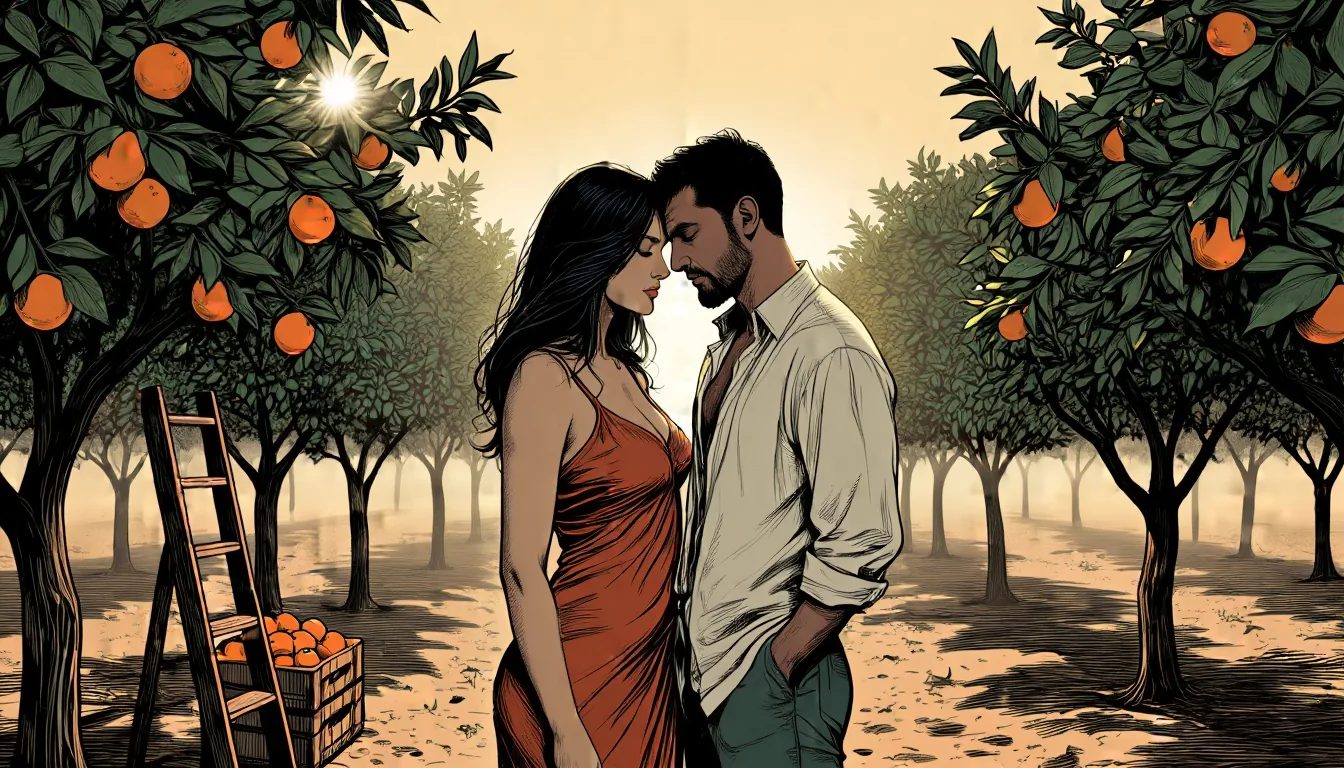
orange-grove-sunriseWynik przykładowy

Powiązane modele i kolejne zadania

Brakuje modelu, którego potrzebujesz?

Napisz, co dodać i do czego chcesz tego użyć. Zgłoszenia trafiają do osób, które decydują o kolejności wdrożeń.

Uruchamiaj LoRA zrobione pod Z-Image Base i zmieniaj styl zdjęć pokrętłem strength

Z-Image Base LoRA uruchamia Z-Image Base, bazowy model o 6 miliardach parametrów od Tongyi-MAI z Alibaby, z maksymalnie trzema LoRA w trybach tekst na obraz i obraz na obraz. Base to niezdestylowany model, na którym trenuje społeczność, więc jest wolniejszy niż Turbo: tekst na obraz zajmował od 9,8 do 56,7 sekundy, z medianą 32,8, a edycje od 4,9 do 41,7, z medianą 16,8. Nic nie filtruje ani promptu, ani obrazu, choć sam model bazowy słabo rysuje poziom Bardzo silny z naszego testu treści i właśnie po to istnieją LoRA.

Otwórz playground
Uruchamiaj LoRA zrobione pod Z-Image Base i zmieniaj styl zdjęć pokrętłem strength
LoRA na żądanie
Do 3, każda {path, scale}; plik musi być wytrenowany na Z-Image Base, nie na Turbo
Strength edycji
Od 0 do 1, domyślnie 0.7; około 0.6 zmieniało styl z LoRA, 0.75 przestawiało scenę
Rozmiary
9 proporcji obrazu do 1536 na bok; edycje przyjmują 1k lub 1.5k na dłuższym boku i zachowują proporcje źródła
Szybkość
Tekst na obraz: mediana 32,8 s w 36 przebiegach; edycja: mediana 16,8 s w 28 przebiegach
Cena
Rozliczane za obraz po jednej stałej stawce; rozmiar, obraz źródłowy i liczba LoRA jej nie zmieniają
Niedostępne
Kroki, guidance i prompt negatywny; endpoint nie ma takich pól
Właściwy model bazowy
LoRA z niewłaściwego modelu zawodzi bez błęduLoRA wytrenowana na Z-Image Turbo, załadowana na Base, rozbiła obraz w szum i pseudotekst. LoRA do Pony i plik oznaczony jako Z-Image, zapisany w innym formacie kluczy, załadowały się i niczego nie zmieniły. Używaj plików wytrenowanych na Base i najpierw uruchom parę z plikiem i bez.
Limity edycji
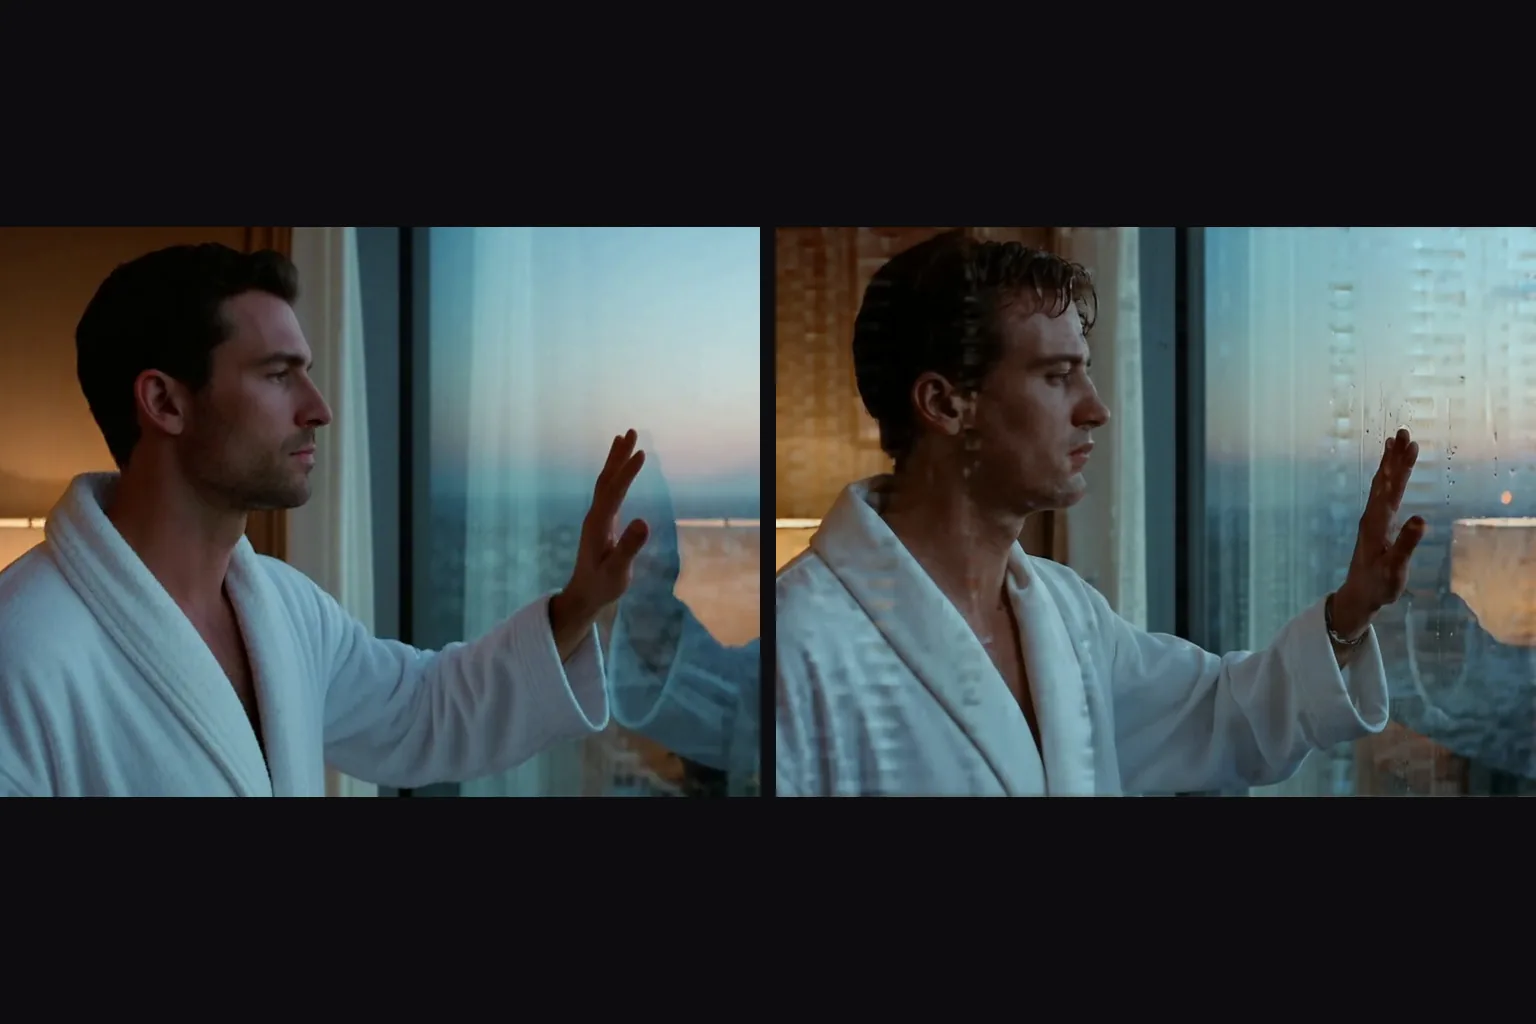
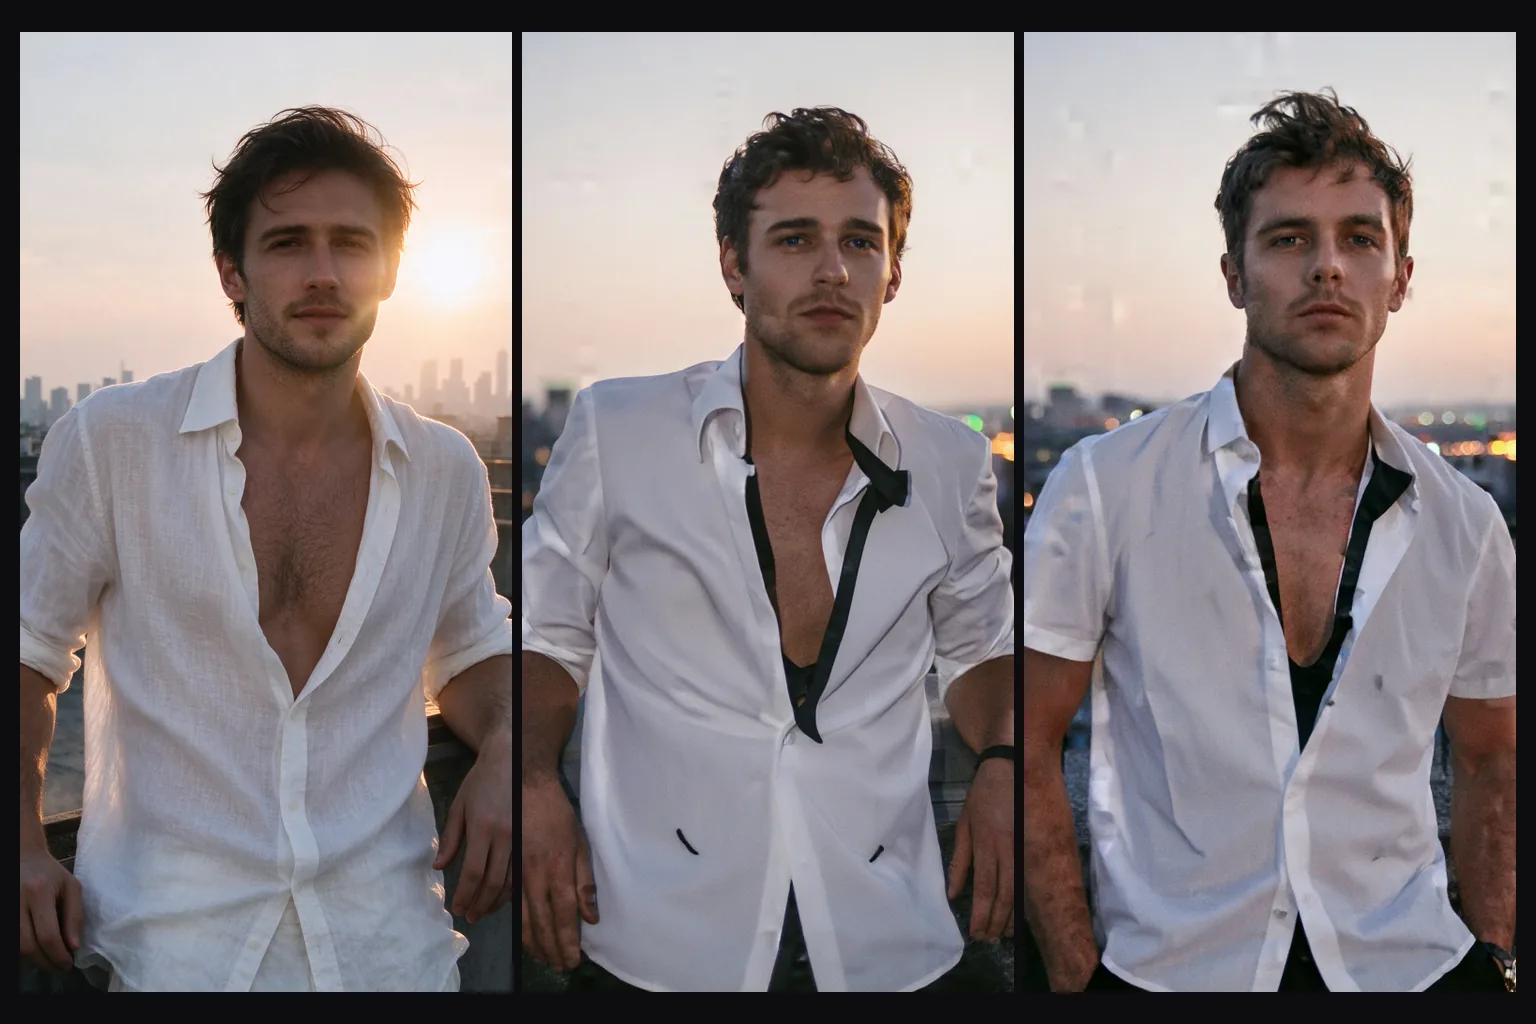
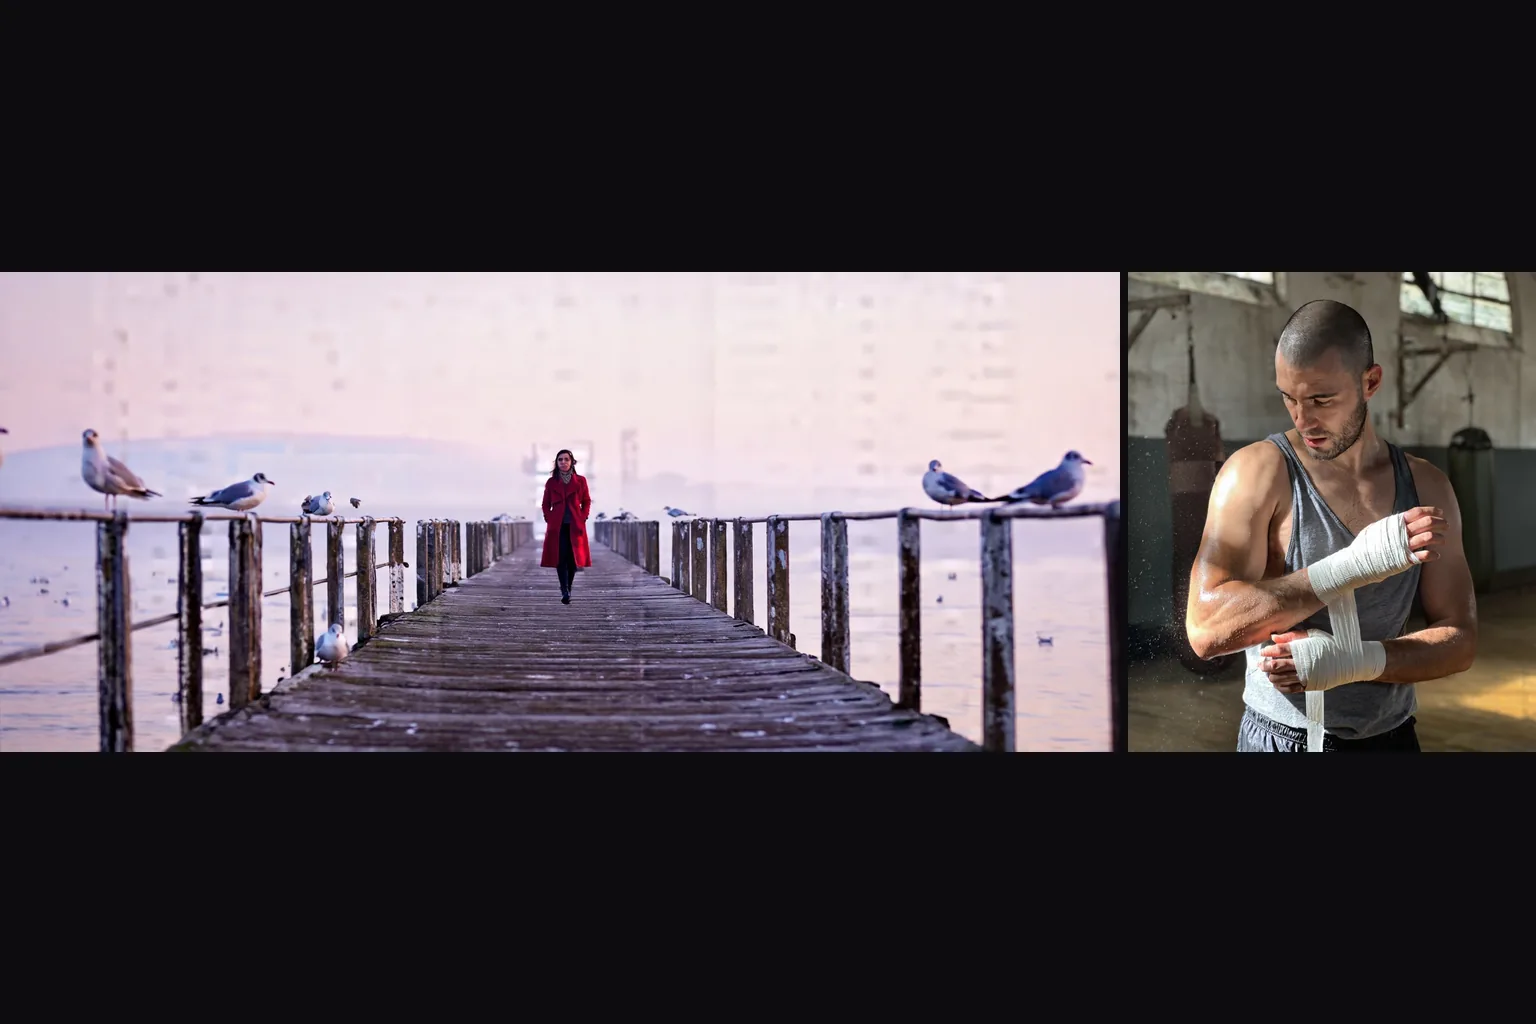
Edycje rysują kadr od nowa i nie wykonują poleceńBez LoRA prośba o czerń i biel przy strength 0.65 i 0.8 pozostała w kolorze, a prośba o smoking przy 0.7 i 0.8 niewiele zmieniła. Opisz cały obraz, który chcesz uzyskać, a gdy chcesz zmienić wygląd, użyj LoRA stylu.
Uczciwe ograniczenie
Jeden poziom treści wychodzi złagodzonyPrzed modelem nie stoi żaden filtr treści, a na obu endpointach nasz pięciostopniowy test treści wygenerował wszystkie poziomy poza Bardzo silnym, włącznie z Maksymalnym. Bardzo silny wrócił złagodzony w trzech próbach: sam model bazowy nie rysuje go przekonująco, i właśnie do tego służą LoRA wytrenowane pod to zadanie.

Praca z Z-Image Base LoRA

Prompty do zdjęć pisz zwykłymi zdaniami

Prompty do zdjęć pisz zwykłymi zdaniami

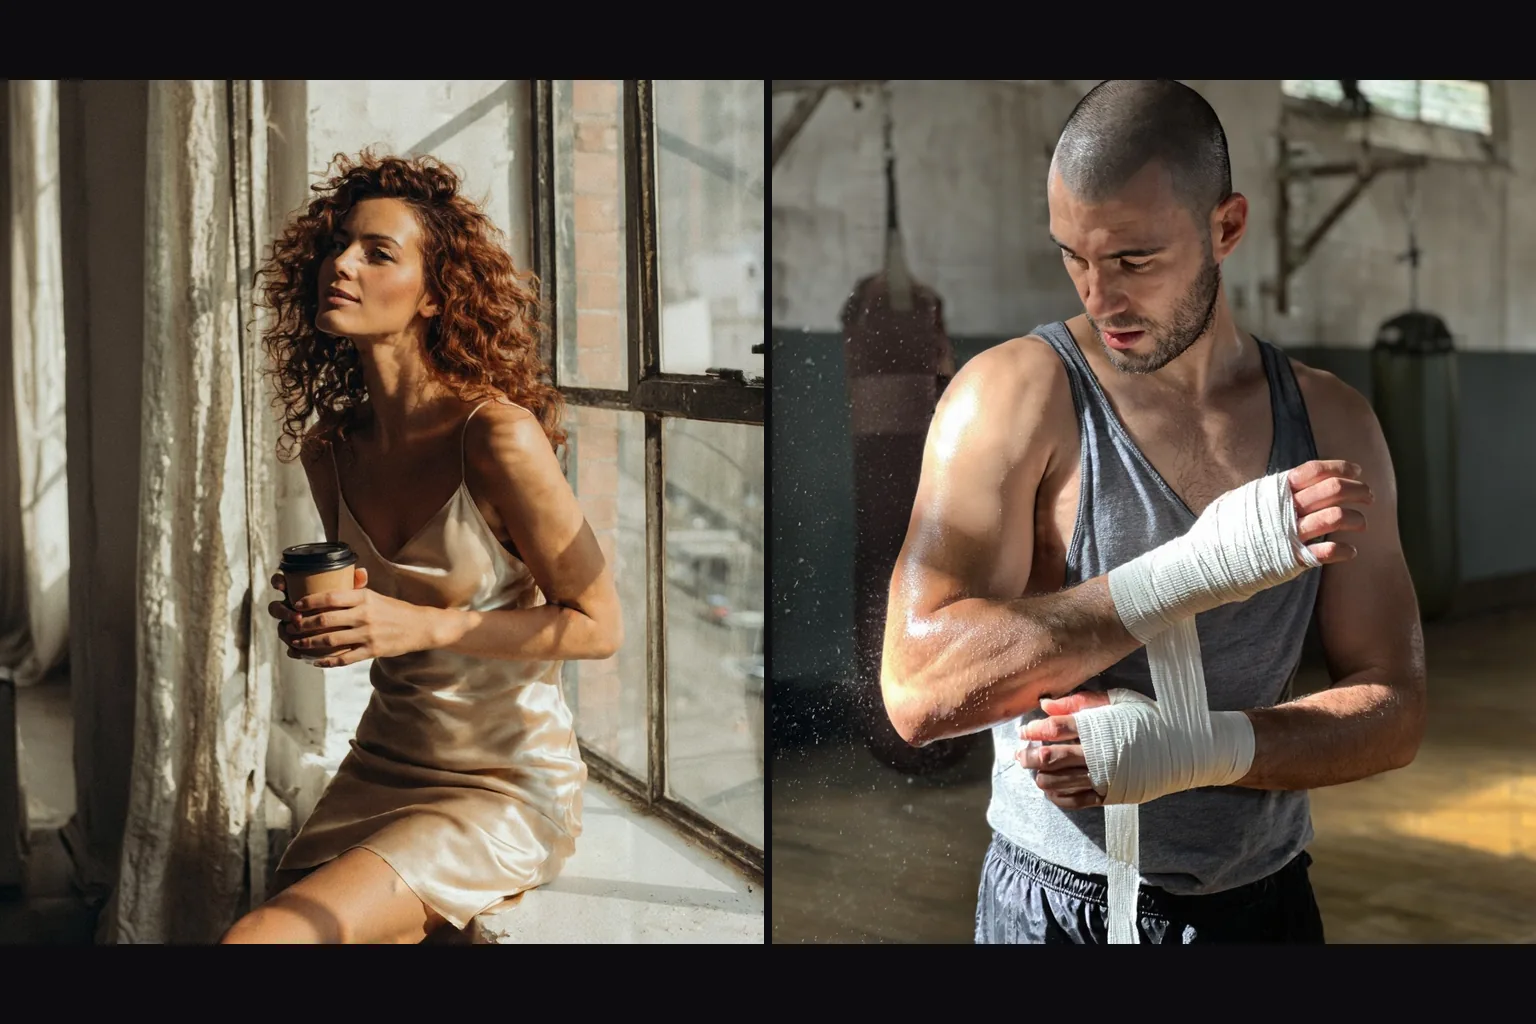
Wierność promptowi jest wysoka, więc opisuj fotografię tak, jak instruowałbyś fotografa: temat, ubranie, miejsce, światło, ziarno. Nasze portrety w loftcie i na siłowni powstały z jednego zdania każdy. Ten sam kształt zdania, z podmienionym tylko tematem, niesie całą serię.

Używaj LoRA wytrenowanych na Base

Używaj LoRA wytrenowanych na Base

LoRA wytrenowana na Z-Image Base działała przy 0.5 i przy 1. LoRA ilustracji mikkoani włącza się swoją frazą „mature illustration with muted color and complex linework” na początku promptu, a sama fraza, bez pliku, już przesuwała prompt fotograficzny w stronę ilustracji.

  • Wybierz strength, zanim przepiszesz prompt

    W edycji strength decyduje, ile zostaje ze źródła. W naszej drabince 0.3 i 0.5 zostawiały obraz prawie bez zmian, a 0.6 zmieniało go nieznacznie. Przy 0.7 treść zaczynała się zmieniać przy zachowanej kompozycji, 0.75 zmieniało pozę i przestawiało scenę, zachowując światło i paletę, a 0.85 dawało nowy obraz. Z LoRA stylu 0.6 zmieniało styl całego kadru i dokładnie zachowywało kompozycję.

  • Spodziewaj się zmiany stylu, nie poleceń

    Model edycji rysuje kadr od nowa na podstawie twojego opisu. „Make it black and white” pozostało w kolorze przy 0.65 i 0.8 w naszym teście, co pokazuje prawy obraz. Do zmiany medium użyj LoRA stylu, a dla innej sceny opisz ją w całości.

  • Pilnuj rozmiarów

    Tekst na obraz oferuje dziewięć proporcji, od 1024×1024 dla 1:1 do 1536×640 dla 21:9, a każda wróciła dokładnie w żądanym rozmiarze. W edycji 1k i 1.5k ustalają dłuższy bok, a proporcje źródła są zachowane: zdjęcie 2:3 w 1k wróciło jako 680×1024, a zdjęcie 16:9 w 1.5k jako 1536×856.

Kto używa Z-Image Base LoRA

  • Stonowana ilustracja pełna kreski z tekstu

    Ilustratorzy i concept artyści

    Stonowana ilustracja pełna kreski z tekstu

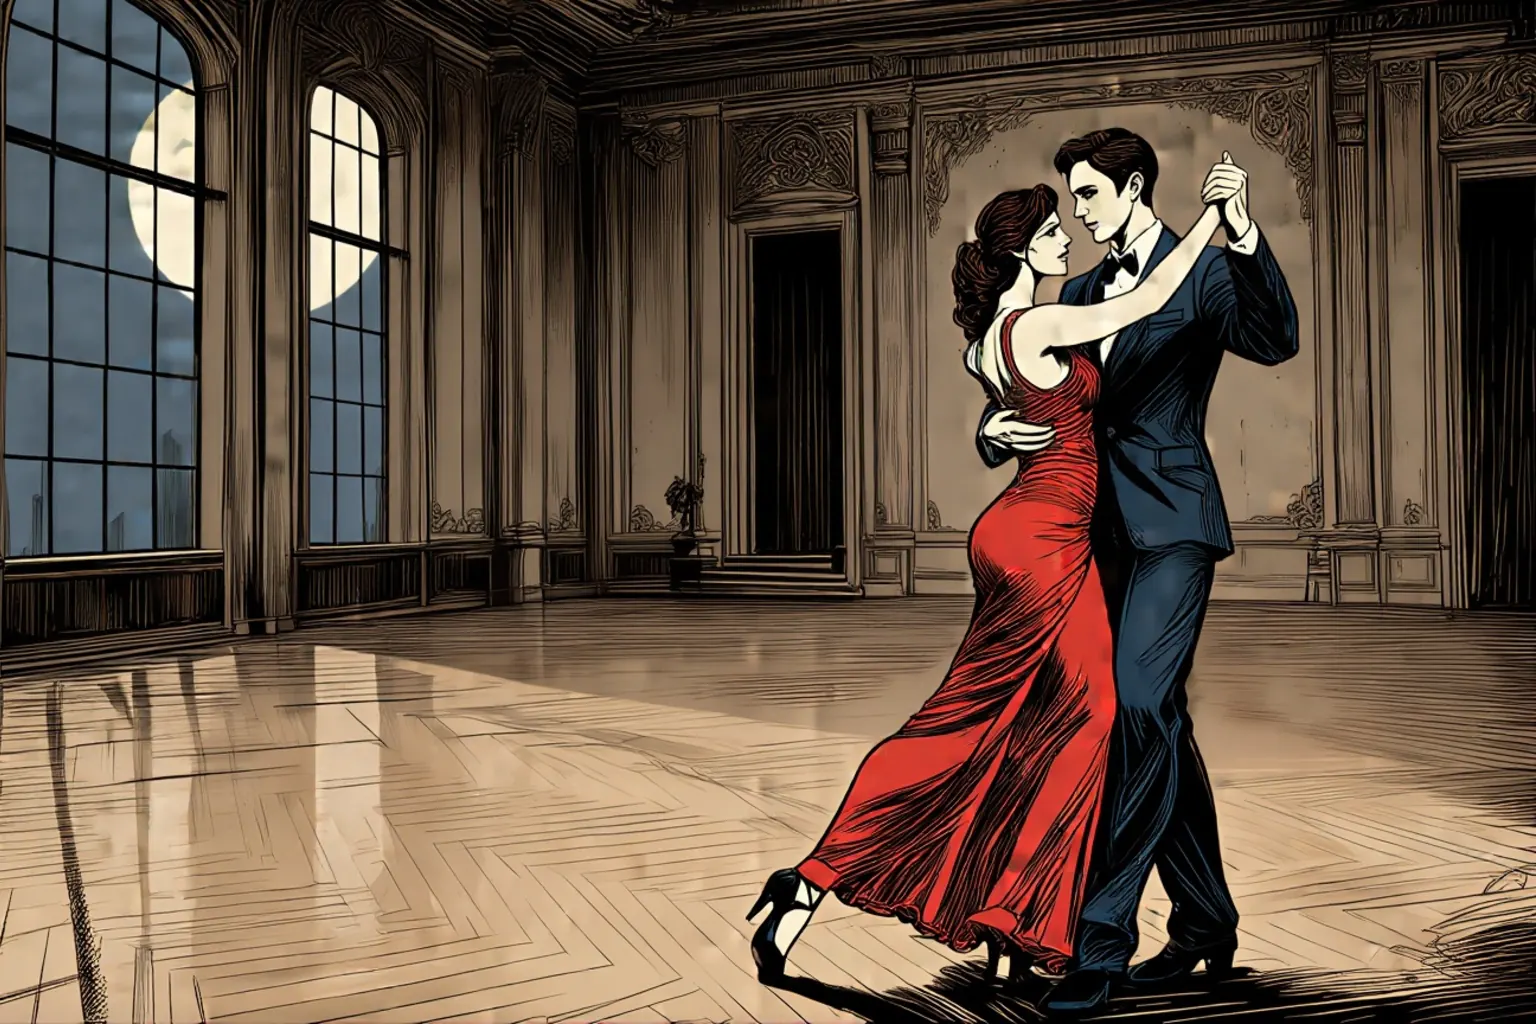
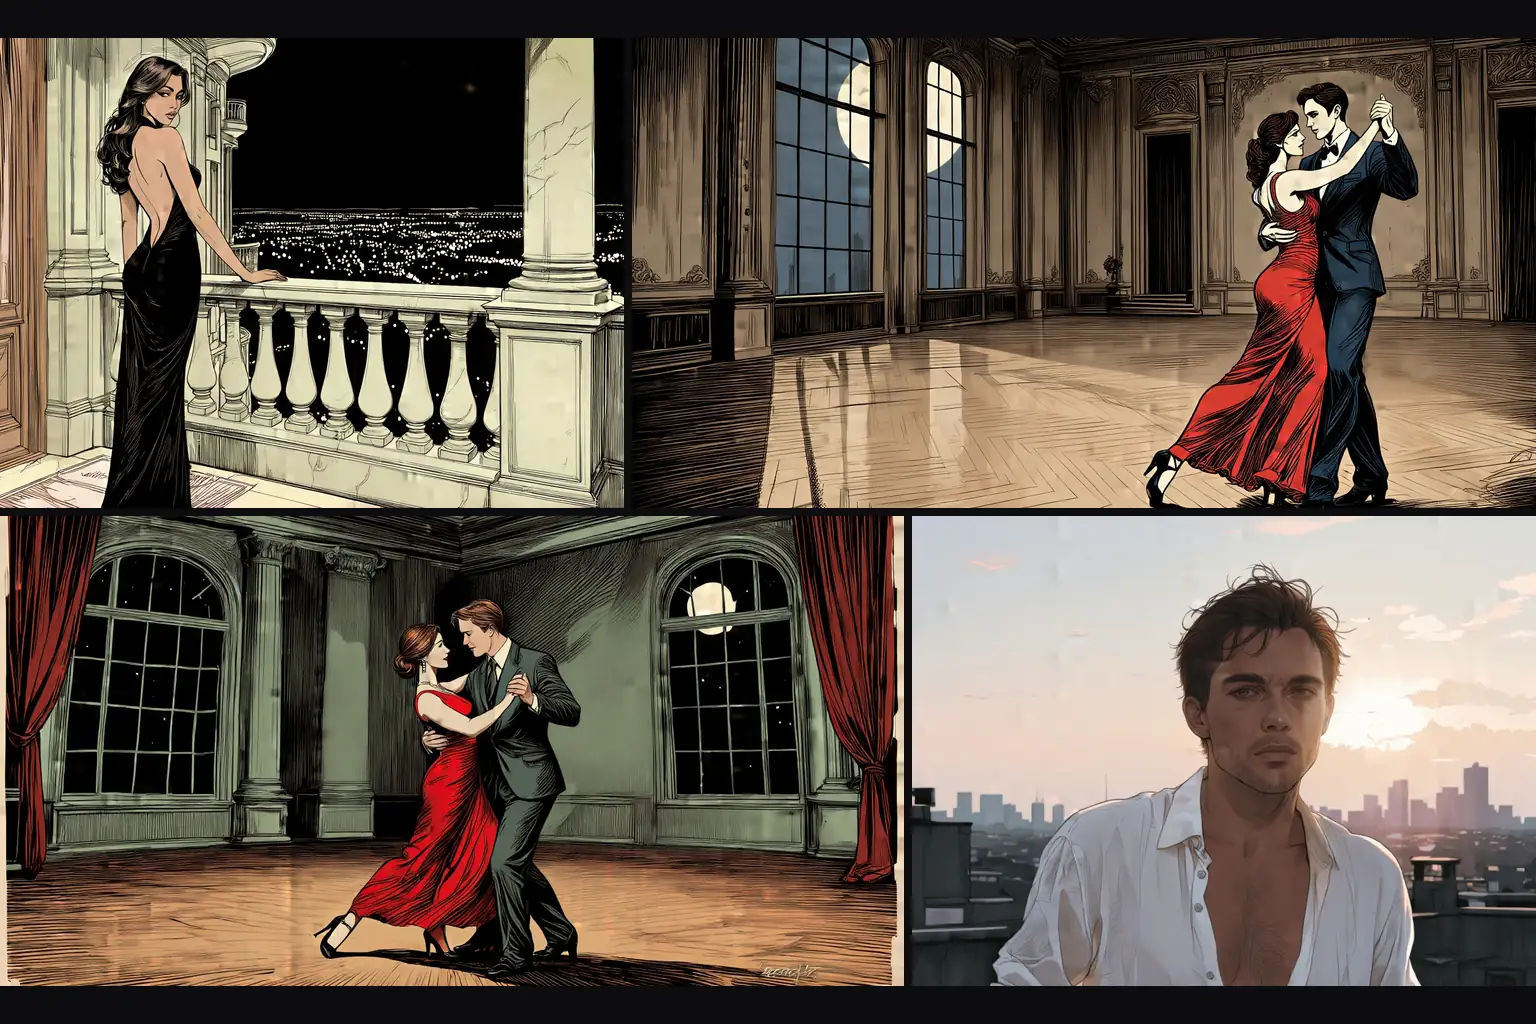
    Z LoRA mikkoani przy 1 nasze prompty o tańcu w sali balowej, balkonie nocą i parze w sali oświetlonej księżycem wróciły jako stonowana, tuszowa ilustracja. Frazę trzymaj na początku, a scenę pisz zdaniami.

  • Zdjęcie zamienione w ilustrację

    Fotografowie i retuszerzy

    Zdjęcie zamienione w ilustrację

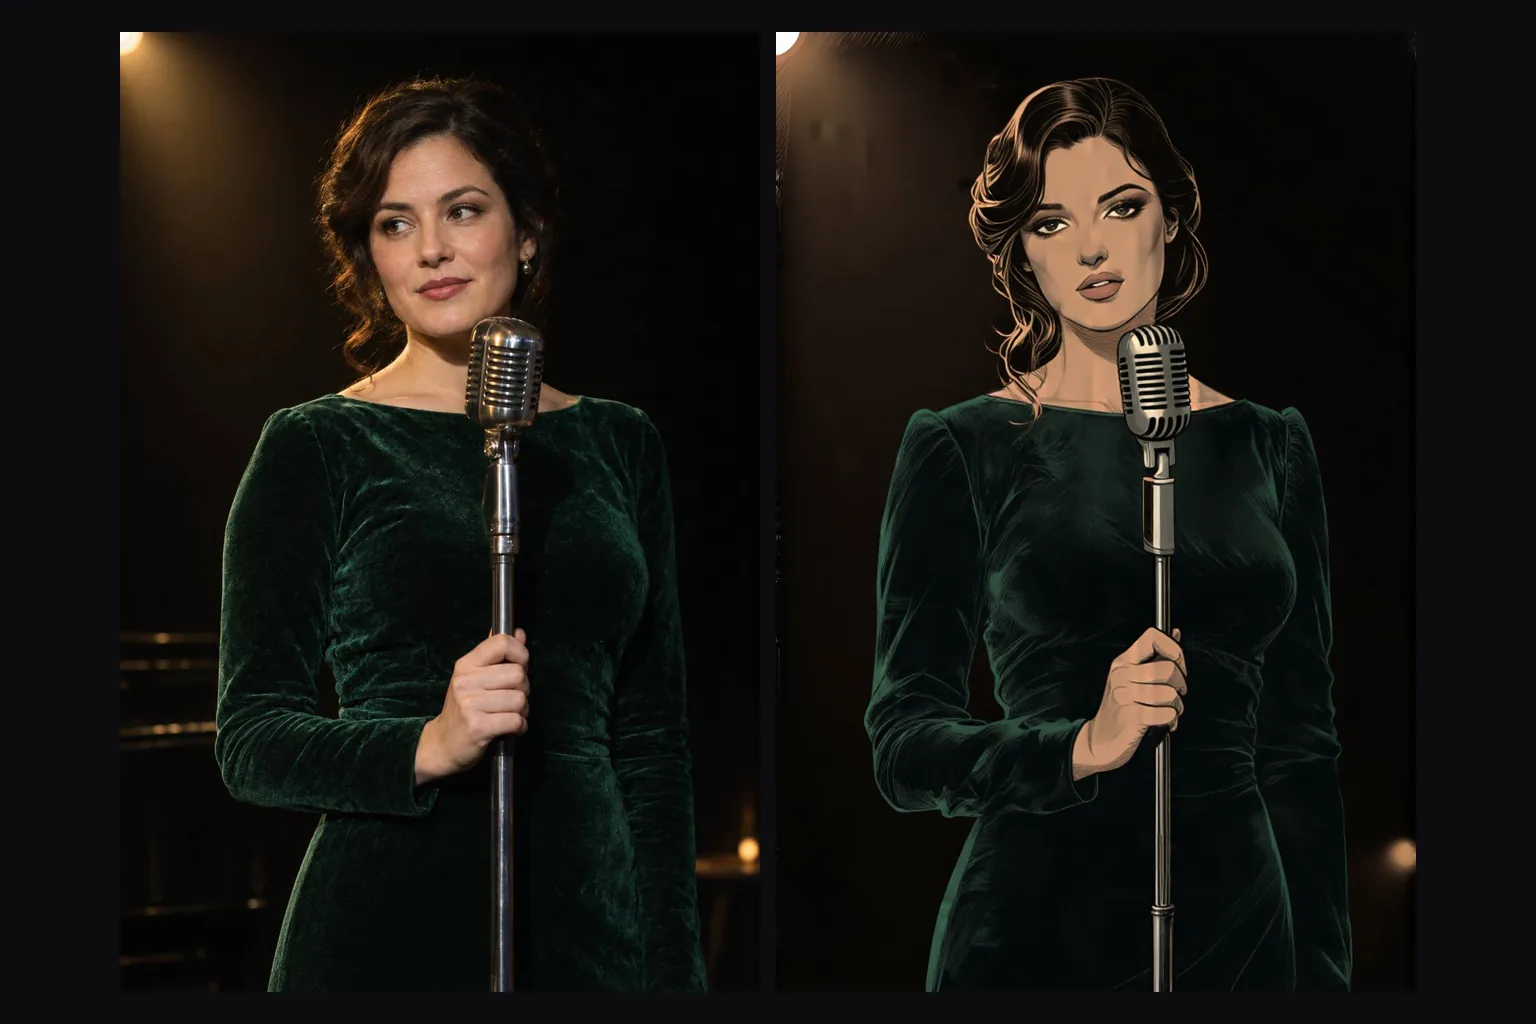
    Po lewej zdjęcie źródłowe piosenkarki w zielonej aksamitnej sukni, po prawej edycja z LoRA mikkoani przy strength 0.6. Poza, mikrofon i kadr zostały na miejscu, a rendering stał się rysowany.

  • Wybór, jak daleko sięga wariacja

    Zespoły social media i kampanii

    Wybór, jak daleko sięga wariacja

    Nasz portret na dachu przeszedł edycję bez LoRA z prośbą o smoking przy 0.7 i 0.8. Zmienił się niewiele, a kompozycja została. Używaj strength jako pokrętła wariacji, a mocniejsze wartości zostaw na chwile, gdy chcesz mieć inny kadr.

  • Szerokie sceny 21:9 w 1536 pikselach

    Twórcy kinowych kadrów i tapet

    Szerokie sceny 21:9 w 1536 pikselach

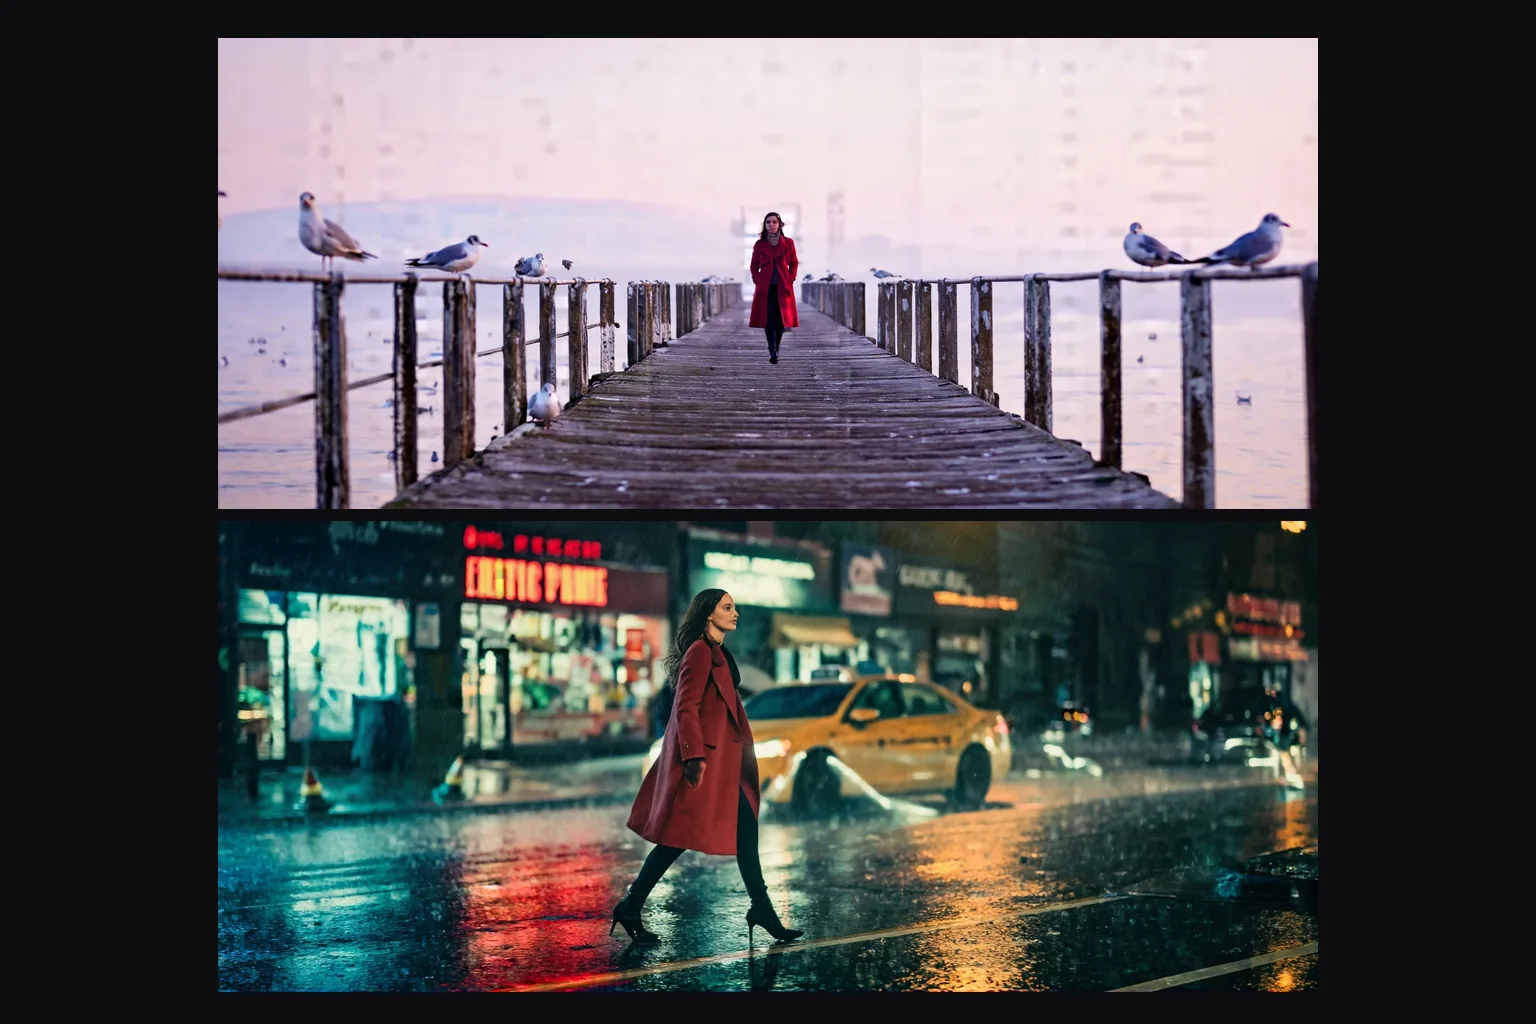
    Kobieta w czerwonym płaszczu na mglistym molo o świcie i na deszczowej neonowej ulicy powstała ze zwykłych zdań w 21:9 (1536×640), bez żadnej LoRA. Szerokie proporcje są częścią promptu, a nie późniejszym przycięciem.

Od pierwszego promptu do gotowej edycji z Z-Image Base LoRA

  1. Zacznij od promptu ze zwykłych zdań

    Najpierw uruchom tekst na obraz bez LoRA, w proporcjach, w których opublikujesz obraz, żeby zobaczyć, co daje model bazowy.

  2. Dodaj LoRA wytrenowaną na Base

    Skopiuj bezpośredni link do pobrania pliku .safetensors i uruchom z plikiem i bez niego na tym samym seedzie.

  3. Sprawdź scale

    Wypróbuj 0.5 i 1 i zostaw wartość, przy której wygląd się układa, nie przejmując postaci.

  4. Edytuj z drabinką strength

    Wyślij obraz źródłowy z tablicą loras i zacznij od 0.6; użyj 0.7 i 0.75, gdy chcesz przestawić scenę.

  5. Opisz cały wynik

    Model rysuje cały kadr od nowa, więc napisz cały obraz, a nie tylko zmianę.

Prompty do Z-Image Base LoRA, które warto skopiować

  • Zdjęcie ze zwykłych zdań

    Bez LoRA; proporcje portretowe 2:3.

    A photograph of a woman in her thirties with curly auburn hair, wearing a champagne satin slip dress, sitting on a windowsill in a sunlit loft, holding a coffee cup with both hands, golden hour light on her face, soft film grain.
  • Stonowana ilustracja

    Z LoRA mikkoani przy scale 1 i proporcjach 16:9; fraza zostaje na początku.

    mature illustration with muted color and complex linework. A woman in her thirties in a red evening dress and a man in his thirties in a dark suit dance close in an empty ballroom at night, moonlight through tall windows, long shadows on the parquet floor.
  • Zdjęcie w rysowaną kreskę

    Dla endpointu edycji z LoRA mikkoani przy scale 1 i strength 0.6. Opisz cały obraz, a nie tylko zmianę.

    mature illustration with muted color and complex linework. A woman with wavy dark hair in a green velvet dress sings into a vintage microphone on a dark stage, warm spotlight from above.

Więcej pytań o Z-Image Base LoRA

Używaj go jako laboratorium modelu bazowego

Zacznij od promptu ze zwykłych zdań, dodaj LoRA wytrenowaną na Base i potwierdź ją parą z plikiem i bez.

W edycji podnoś strength od 0.6 i opisuj cały wynik. Jeśli plik niczego nie zmienia albo psuje obraz, był trenowany pod inny model.