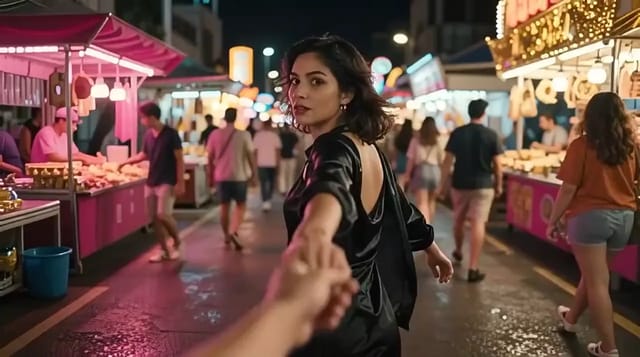
Dwie kobiety szepczą w korytarzu jazzowego baru
- Model
- Seedance 2.5
- Zadanie
- Tekst na wideo
- Rozdzielczość
- 720p
- Czas trwania
- 5 s
- Proporcje
- 16:9
Wynik
PromptENZnaki: 442
Warm, clearly lit close two-shot. Two adult women stand very close in the amber glow of a jazz bar's back hallway, one in a black velvet slip, the other in an open white shirt. One leans in and whispers something against the other's ear; the other closes her eyes and breaks into a wide laugh, then they rest their foreheads together. Handheld 35mm, warm practical lights, shallow focus, muffled saxophone, a whispered line and soft laughter.Napisany po angielsku, dokładnie w takiej formie, w jakiej go wysłaliśmy.
Uruchom ten przykład
Sprawdzanie ceny…
Otwiera Playground ze wszystkimi ustawieniami już uzupełnionymi i pokazuje dokładną cenę przed uruchomieniem.
Ten sam model, zaczynając od tego promptu. Pozostałe ustawienia mają wartości domyślne.
Dlaczego ten prompt działa
Klip pokazany na tej stronie, wraz z żądaniem: pięć sekund w 720p, 16:9, z dźwiękiem. Sformułowanie celowo przekazuje bliskość przez szept i stykające się czoła, co przechodzi tam, gdzie sformułowanie o pocałunku by nie przeszło.
Użyte ustawienia
| Ustawienie | Wartość | Co robi |
|---|---|---|
| resolution | 720p | 480p, 720p lub 1080p, domyślnie 720p; wartość ta wprost zasila rozliczaną wielkość. Iteruj prompty w 480p albo 720p, a próg podnieś dopiero dla finalnego ujęcia. Wybrany próg jest progiem, w którym model renderuje – nie ma na wierzchu żadnego kroku z upscalingiem ani poprawianiem obrazu. |
| aspect_ratio | 16:9 | Domyślnie `adaptive`, co pozwala modelowi wybrać kadr na podstawie promptu: napisz „vertical short-form”, a zwykle dostaniesz kompozycję pionową. Blokuj kształt jawnie tylko wtedy, gdy wymaga tego miejsce publikacji (9:16 do feedów, 16:9 do poziomu, 21:9 do panoramy); poza tym adaptive komponuje zwykle naturalniej. Bez wpływu na rozliczenie. |
| generate_audio | true | Domyślnie włączone. Tworzy własną ścieżkę dźwiękową zsynchronizowaną z obrazem – głos, tło pomieszczenia, efekty ruchu. Wyłączaj je zawsze, gdy montaż przyniesie własną muzykę albo narrację: nie dopuszczasz do zderzenia wygenerowanej ścieżki z tą, którą dołożysz później. |
| duration_seconds | 5 | Od 4 do 30 sekund, domyślnie 5. Sufit 30 sekund to najistotniejsza zmiana w tej generacji: całe ujęcie mieści się w jednym żądaniu, zamiast powstawać z łączenia kadrów zamykających. Długość skaluje rozliczaną wielkość liniowo, więc potwierdź ruch i tempo na 5 sekundach, zanim pójdziesz w długość. |
Więcej promptów Seedance 2.5
Wszystkie prompty Seedance 2.5
Romans na innych modelach
Romans
 Podgląd rozmyty