
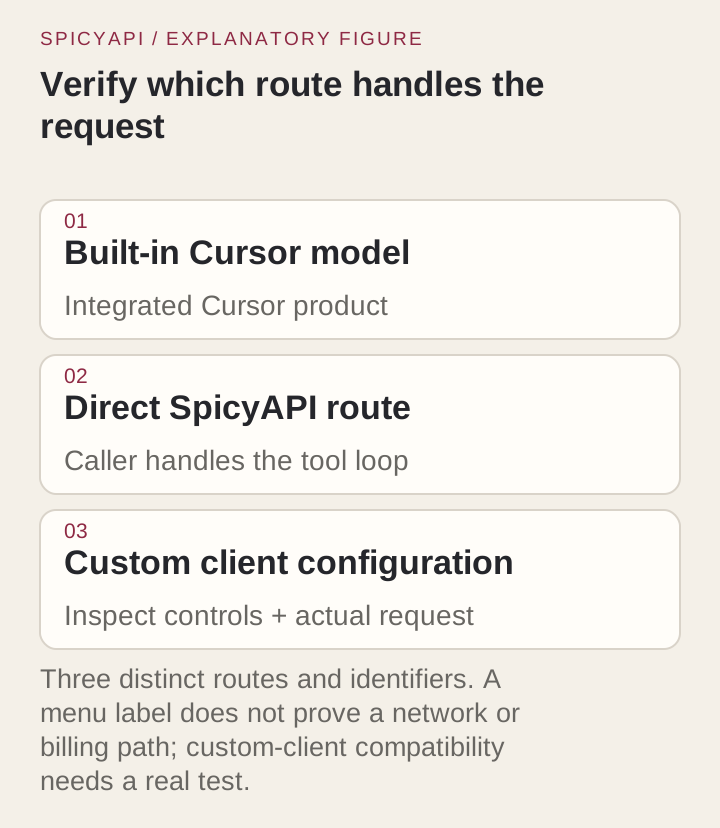
Quieres que Grok corrija código en Cursor, pero elegir un modelo integrado y apuntar una clave a una API externa son configuraciones distintas. Usa el Grok 4.6 integrado de Cursor por su integración documentada con el agente, o llama a SpicyAPI directamente cuando tu aplicación necesite gestionar las solicitudes, las herramientas y el uso. Para usar una clave de SpicyAPI dentro de Cursor, abre Cursor Settings → Models y comprueba si existe una opción para sustituir la base URL. Los valores de configuración y la alternativa que siguen te permiten elegir el camino correcto antes de comprar uso.
Dos rutas de Grok con contratos distintos
La documentación de Grok 4.6 de Cursor indica grok-4.6, una ventana de contexto de 256k y cuatro niveles de esfuerzo: low, medium, high y xhigh, con high como valor predeterminado. La integración incorporada tiene acceso a las herramientas de agente de Cursor.
La página del modelo en SpicyAPI identifica xai/grok-4.6/chat. El nombre documentado para solicitudes Chat Completions compatibles con OpenAI es xai/grok-4.6, enviado a https://api.spicyapi.ai/v1/chat/completions. Esta ruta acepta partes de texto e imagen, tiene un límite de entrada de 500,000 tokens y ofrece sus propios controles de solicitud. Su esquema actual no acepta partes de archivo ni de PDF. Una definición de herramienta es una entrada para el modelo; quien llama debe aportar el bucle de ejecución.
| Decisión | Grok integrado en Cursor | Grok directo con SpicyAPI |
|---|---|---|
| Identificador de selección en la superficie correspondiente | grok-4.6 en la documentación de Cursor | xai/grok-4.6 en una solicitud Chat Completions; endpoint del catálogo xai/grok-4.6/chat |
| ¿Quién construye y gestiona el flujo de programación? | El producto integrado de Cursor | Tu aplicación o un cliente compatible verificado |
| Ventana de entrada | 256k tokens | 500,000 tokens |
| Ediciones de archivos y pruebas | Cursor gestiona las herramientas del agente | Quien llama ejecuta las herramientas y aplica las ediciones |
El límite de 500,000 tokens de la API no amplía la ventana de 256k de Cursor. Para corregir código, envía los archivos clave, el fallo y las pruebas en lugar de todo el repositorio.
Pruébalo primero en Playground
- Abre Grok 4.6 y cambia a Playground.
- En el cuadro de mensajes pega la pregunta siguiente, elige la opción de razonamiento Low y pulsa Run model:
> A delivery-window parser must accept a local time HH:MM from 00:00 through 23:59. The current function returns true for any string matching two digits, a colon and two digits. Explain which inputs it accepts incorrectly, and propose a small correction.
- Comprueba si la respuesta rechaza 24:00 y 12:60. Si lo hace, la misma pregunta está lista para ejecutarse desde la API o desde tu editor.
Usa la ruta integrada cuando esa sea la tarea
- Abre el selector de modelos y elige explícitamente Grok 4.6 si tu cuenta lo ofrece. Usa una selección explícita en lugar de Auto cuando quieras este modelo en concreto; vuelve a comprobarlo en un chat nuevo.
- Elige el esfuerzo según la tarea; el valor predeterminado documentado del modelo es
high. El plan Start, solo para India, fija Grok enmediumsin modo Fast. - Abre el proyecto desechable del parser que aparece más abajo y pide una corrección limitada a
is-time.mjs. - Revisa el diff aplicado y el resultado real de las pruebas. Una explicación correcta sin una edición aplicada es un resultado distinto de una tarea de agente completada.
La selección integrada no requiere una base URL ni una clave de SpicyAPI. Al presupuestar, ten en cuenta la asignación de tu plan actual y el ajuste Fast; la promoción de lanzamiento del artículo de presentación ha terminado.
Conecta tu clave o elige la API directa
La ayuda de claves de API de Cursor documenta Cursor Settings → Models → proveedor → clave → Save para OpenAI, Anthropic, Google, Azure y AWS Bedrock. No documenta un endpoint personalizado para Grok 4.6.
- Abre Cursor Settings → Models y busca una opción para sustituir la base URL de OpenAI y otra para añadir un modelo personalizado.
- Si ambos controles están disponibles, introduce
https://api.spicyapi.ai/v1como base URL, tu clave de SpicyAPI como clave del proveedor yxai/grok-4.6como modelo personalizado. Guarda la configuración. - Selecciona ese modelo personalizado en un chat nuevo y envía la pequeña pregunta del parser que aparece más abajo. Comprueba que la solicitud aparece en tus logs de SpicyAPI antes de enviar una tarea mayor.
- Si los controles no existen o la verificación rechaza el modelo, usa el Grok integrado para el agente de Cursor o ejecuta el ejemplo de la API directa. Pegar una clave de SpicyAPI en un campo de clave de proveedor no basta por sí solo.
Las claves propias cubren el chat, no la finalización con Tab. Las solicitudes BYOK siguen pasando por el backend de Cursor para construir el prompt, y la promesa de retención cero de Cursor no se aplica a ellas. Los cargos del proveedor y cualquier tarifa de cliente del plan de organización son aparte.
Mantén separados los tres identificadores
| Valor de configuración | Valor directo de SpicyAPI | Uso |
|---|---|---|
| Base URL | https://api.spicyapi.ai/v1 | Para un cliente que añade /chat/completions |
| Endpoint completo | https://api.spicyapi.ai/v1/chat/completions | Para curl o para quien envía la URL completa |
| Modelo de la solicitud | xai/grok-4.6 | Valor en el cuerpo JSON |
| Tarea del catálogo | xai/grok-4.6/chat | El listado de tareas del modelo, no el nombre del selector integrado de Cursor |
Mantén diferenciados la base URL y el endpoint completo. Poner el endpoint completo en un campo de base URL puede producir /chat/completions/chat/completions cuando el cliente añade su propia ruta. Un error de «unknown model» exige revisar el valor del modelo; cambiar el prompt o el esfuerzo no corregirá el destino.
Empieza con una solicitud directa que tenga un solo propósito
Primero envía una solicitud directa para comprobar la clave y el modelo antes de investigar el IDE.
Este ejemplo crea una solicitud de revisión de código facturable cuando lo ejecutas. Usa la clave de tu entorno. max_tokens: 4000 limita solo la respuesta visible; los tokens de razonamiento se facturan como salida y ese tope no los limita. reasoning_effort: low reduce el trabajo de razonamiento, pero no fija un techo de gasto.
: "${SPICY_API_KEY:?Set SPICY_API_KEY first}"
curl --no-buffer --fail-with-body --dump-header response-headers.txt \
  https://api.spicyapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "xai/grok-4.6",
    "messages": [
      {"role": "system", "content": "Review only the code shown. Explain the smallest correction and its acceptance cases. Do not claim that you executed anything."},
      {"role": "user", "content": "A delivery-window parser must accept a local time HH:MM from 00:00 through 23:59. The current function returns true for any string matching two digits, a colon and two digits. Explain which inputs it accepts incorrectly, and propose a small correction."}
    ],
    "reasoning_effort": "low",
    "max_tokens": 4000,
    "stream": true,
    "stream_options": {"include_usage": true}
  }'
Lee las piezas choices[].delta.content del stream para obtener la corrección y el último chunk usage para el recuento de tokens; la documentación describe el formato del stream.
Si la llamada directa falla, corrige primero su clave, su modelo o el campo rechazado antes de añadir el IDE. Esos errores persistirán dentro de un cliente personalizado.
Deja que un Agent prepare la llamada
Para revisiones de código repetidas, pide a tu Agent de programación que use el Skill de SpicyAPI: “Read xai/grok-4.6/chat, then adapt the example to my input; show the request before running it.” La consulta con CLI es spicyapi models get xai/grok-4.6/chat --json; la consulta con MCP es spicyapi_model_get con model: "xai/grok-4.6/chat". Las llamadas de chat usan un cliente compatible o la API de chat; los comandos de tareas multimedia no generan respuestas de chat.
Haz ejecutable el caso de programación
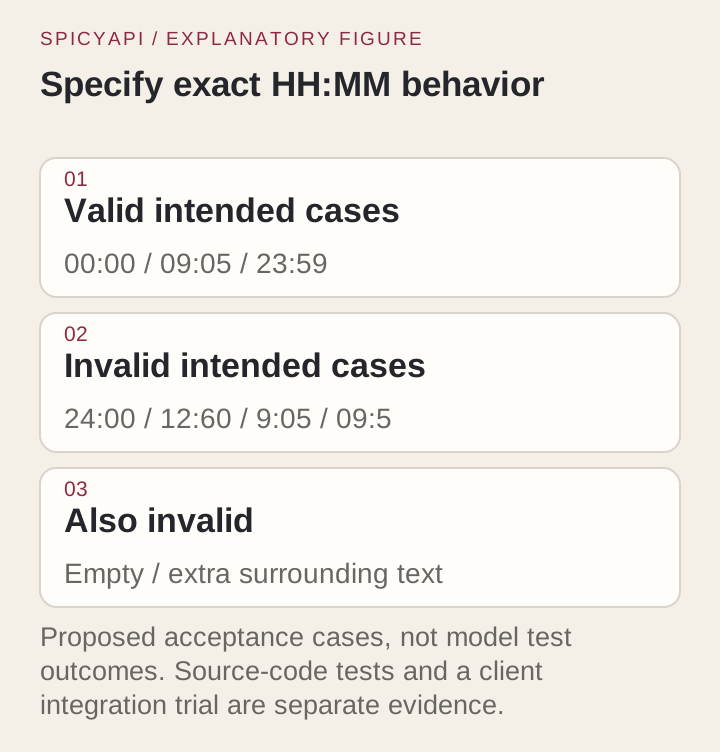
El requisito es deliberadamente estrecho: aceptar exactamente HH:MM, horas 00–23 y minutos 00–59, sin espacios alrededor. Empieza con este is-time.mjs con errores:
export function isTime(value) {
  return typeof value === 'string' && /^\d{2}:\d{2}$/.test(value);
}
Guarda los casos de aceptación como is-time.test.mjs:
import assert from 'node:assert/strict';
import test from 'node:test';
import { isTime } from './is-time.mjs';

const cases = [
  ['00:00', true], ['09:05', true], ['23:59', true],
  ['24:00', false], ['12:60', false], ['99:99', false],
  ['9:05', false], ['09:5', false], ['', false],
  ['09:05x', false], [' 09:05 ', false], ['09:05\n', false],
  [null, false], [905, false],
];
for (const [value, expected] of cases) {
  test(JSON.stringify(value), () => assert.equal(isTime(value), expected));
}
Ejecuta node --test is-time.test.mjs. La función inicial falla tres casos: acepta 24:00, 12:60 y 99:99. Conserva los casos de espacios, salto de línea final y valores que no son cadenas para evitar que una corrección posterior amplíe el formato. Pide al agente de programación:
Correct only is-time.mjs to satisfy the supplied tests. Preserve exactly two digits, reject surrounding whitespace, and return false for non-string input. Do not add a date library or change the tests. Run the tests if your tools permit, and report the actual result.
Una solución posible es:
export function isTime(value) {
  if (typeof value !== 'string' || value.length !== 5) return false;
  return /^(?:[01]\d|2[0-3]):[0-5]\d$/.test(value);
}
La comprobación de rango rechaza horas y minutos fuera de rango; las comprobaciones de tipo y longitud mantienen explícito el formato de cinco caracteres. Esta solución supera los catorce casos. Pide al agente que produzca su propia corrección, ejecuta las mismas pruebas sobre ese parche y lee el diff: una corrección de una sola función no debería tocar la configuración, el formato en otras partes ni las dependencias, y no debería añadir una biblioteca de fechas para una hora de cinco caracteres.
Verifica primero la ruta de texto plano de un cliente personalizado
Envía la misma pregunta del parser a través del cliente personalizado. Si no aparece ninguna tarea del proveedor, revisa el modelo seleccionado y el destino de la solicitud; puede que el cliente siga usando su ruta integrada o falle antes de enviar nada.
Cuando el texto plano funcione, añade streaming y después herramientas sin cambiar los demás ajustes.
Usa streaming para razonamientos largos
Usa stream: true con esfuerzo high o xhigh y con salidas largas (el ejemplo ya lo hace); una respuesta sin streaming que tarde más de unos 100 segundos puede cortarse, y una solicitud cortada que no devuelve respuesta no se cobra. Una respuesta final normal termina con finish_reason: stop; tool_calls significa que tu aplicación tiene un paso siguiente, y length significa que la respuesta se truncó, aunque el código parezca plausible. Si un stream directo termina pero el IDE se queda parado, revisa cómo el IDE gestiona los eventos antes de cambiar de modelo. Detalles: documentación de texto y streaming.
El soporte de herramientas requiere un llamador que las ejecute
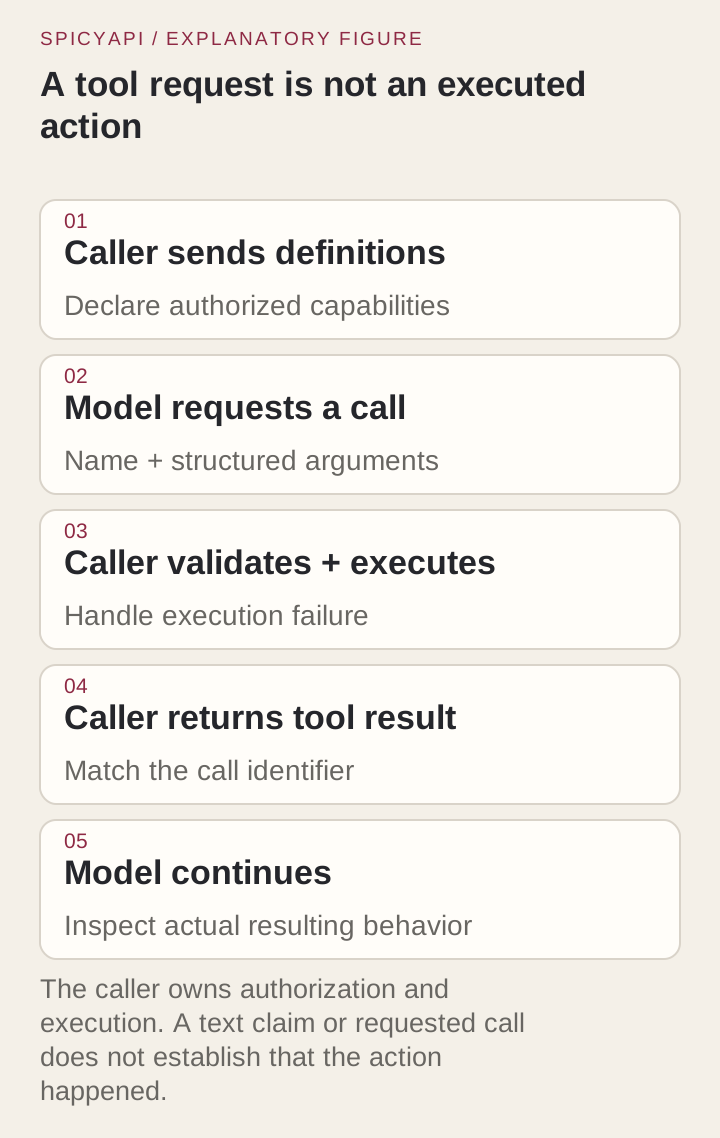
La API acepta hasta 128 tools, tool_choice y parallel_tool_calls (booleano, true por defecto). Tu aplicación debe aportar las implementaciones de las herramientas.
Un bucle de herramientas debe validar los argumentos solicitados, ejecutar una operación permitida, añadir su resultado real como mensaje de herramienta y volver a llamar al modelo. Una respuesta de texto por sí sola no puede aplicar el parche ni ejecutar Node.
Por ejemplo, después de que el asistente solicite una función inofensiva get_acceptance_cases, quien llama devuelve su resultado real con el ID correspondiente:
[
  {"role":"assistant","content":null,"tool_calls":[{"id":"call_example","type":"function","function":{"name":"get_acceptance_cases","arguments":"{}"}}]},
  {"role":"tool","tool_call_id":"call_example","content":"00:00 pass; 23:59 pass; 24:00 fail; 12:60 fail; surrounding whitespace fail"}
]
Añade el mensaje real del asistente y el resultado de la herramienta a la conversación original; el JSON anterior muestra su forma. Valida el nombre de la función y los argumentos antes de despachar, y acota el alcance de archivos, los turnos de herramientas y el gasto.
Para este caso, deja que la primera herramienta devuelva los casos de aceptación. Después añade una herramienta de edición de archivos limitada a is-time.mjs y un comando de pruebas limitado a node --test is-time.test.mjs.
Haz coincidir cada resultado de herramienta con su tool_call_id, aunque los resultados lleguen en otro orden. Para esta tarea de un solo archivo, parallel_tool_calls: false puede simplificar tu propio arnés.
Si el chat funciona pero las herramientas fallan en un cliente personalizado, revisa el campo rechazado o el esquema de la herramienta antes de cambiar el modelo.
Mantén el contexto del repositorio relevante para la corrección
El parser necesita su función, la especificación y las pruebas, no una aplicación entera. Para un error real, incluye el fallo, los archivos clave y los puntos de llamada afectados. Pide la información que falte antes de aceptar un refactor amplio.
La ruta directa acepta hasta 256 mensajes; los tokens y el número de mensajes son límites distintos. Las respuestas anteriores, los resultados de herramientas y las imágenes también ocupan contexto. En sesiones largas, conserva el código fuente actual y el resultado real de las pruebas junto con un resumen conciso de las decisiones. Un IDE personalizado puede resumir u omitir archivos seleccionados, de modo que una ventana de API mayor no puede reparar el contexto que el cliente nunca envió.
Trata las entradas de imagen y de archivo como capacidades distintas
La ruta alojada acepta partes de texto e image_url; no acepta partes de PDF ni de archivo. Para un error visual de la interfaz, combina una captura accesible mediante URL con la especificación. Por ejemplo, una pantalla que muestre 24:00 puede ilustrar el estado de entrada no válida del parser. El caso textual en sí no necesita imagen.
Para una especificación en PDF, extrae el texto relevante en local y revisa el orden de las tablas y las notas al pie antes de enviarlo. Eso es un flujo de extracción, no una entrada nativa de PDF. Si un IDE personalizado no puede reenviar una imagen o añade un campo de archivo no admitido, usa la solicitud directa admitida o su equivalente en texto.
Elige el esfuerzo y los topes de salida según el trabajo
La API directa acepta low, medium, high y xhigh; el valor predeterminado es high y no se acepta none. Usa low de forma explícita para la pequeña solicitud del parser. Sube el esfuerzo para una corrección más difícil cuando el ajuste inferior no supere sus casos de aceptación.
Si el IDE oculta los controles de esfuerzo, el modo que seleccione puede diferir de tu solicitud directa. Compara el parche real y el uso, no lo exhaustiva que parezca la explicación.
max_tokens vale 4,096 por defecto y acepta hasta 450,000 tokens de respuesta visible. Mantenlo bajo para un parche de una sola función. El razonamiento puede hacer que la salida facturada sea muchas veces más larga que ese parche, sobre todo con el esfuerzo high predeterminado. Usa un esfuerzo menor para correcciones rutinarias, presupuesta a partir de usage y fija límites diarios y totales de gasto por clave de API, además de presupuestos diarios y mensuales del workspace, para los bucles de agente; este endpoint Chat Completions no tiene un tope de presupuesto por llamada.
Deja la temperatura y top-p con sus valores predeterminados mientras comparas los ajustes de esfuerzo.
Lee los precios por token sin mezclar las categorías de facturación
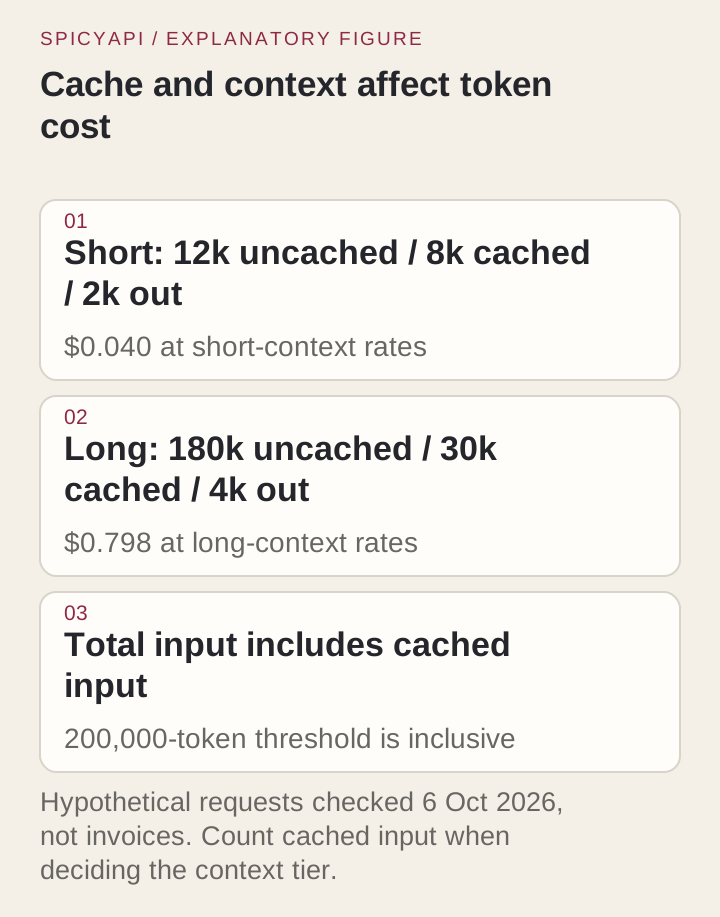
Las tarifas de SpicyAPI son $2.00 por entrada sin caché, $0.50 por entrada en caché y $6.00 por salida por millón de tokens. A partir de 200,000 tokens de entrada en total, incluida la entrada en caché, toda la solicitud usa $4.00, $1.00 y $12.00 respectivamente. Son precios de catálogo para el cliente, no el registro de un nuevo cargo del cliente.
Para una solicitud directa hipotética con 12,000 tokens de entrada sin caché, 8,000 tokens de entrada en caché y 2,000 tokens de salida facturados, la aritmética del catálogo es:
Uncached input: 12,000 / 1,000,000 × $2.00 = $0.0240
Cached input:    8,000 / 1,000,000 × $0.50 = $0.0040
Output:         2,000 / 1,000,000 × $6.00 = $0.0120
Total: $0.0400
La entrada total de ese ejemplo es 20,000, no 12,000. Si el campo usage informa de la entrada total y de un subconjunto en caché, no factures dos veces los tokens en caché: resta el subconjunto en caché para obtener la entrada sin caché. Usa las categorías reales de la respuesta y el registro de la plataforma al conciliar una solicitud real.
Una ilustración de contexto largo con 180,000 de entrada sin caché, 30,000 de entrada en caché y 4,000 de salida facturada suma 210,000 de entrada. Su aritmética es $0.720 + $0.030 + $0.048 = $0.798 con las tarifas largas. El umbral se aplica a las categorías completas de la solicitud, no solo a la parte que supera 200,000. Reducir el contexto innecesario puede, por tanto, cambiar tanto la cantidad de tokens como el nivel aplicable.
Son recuentos de tokens supuestos. Presupuesta sin ahorro de caché hasta que usage informe de un acierto; la liquidación usa el uso medido, incluida la salida de razonamiento.
Compara con cuidado un precio de Cursor con un precio directo
La página Models and Pricing de Cursor indica para Grok 4.6 tarifas estándar de $2 de entrada, $0.50 de entrada en caché y $6 de salida por millón de tokens; las tarifas Fast son $4, $1 y $12. Fast está activado por defecto en los planes Pro que cumplen los requisitos, así que revisa el selector antes de empezar una tarea larga. El Grok integrado consume del pool Models de Cursor y de la asignación de tu plan. Las asignaciones de la suscripción, la selección de velocidad y las condiciones específicas de cada cuenta influyen en lo que paga un usuario; las tarifas listadas no son una predicción de la factura mensual.
Con los mismos 12,000 tokens de entrada sin caché, 8,000 de entrada en caché y 2,000 de salida, Cursor estándar suma $0.040, Fast $0.080 y la API directa $0.040, lo mismo que Cursor estándar con estas tarifas listadas. Estos cálculos comparan tarifas por token declaradas con un uso igual artificial; no demuestran que ambos productos hagan el mismo trabajo. Las sesiones reales de agente pueden consumir cantidades de tokens distintas.
Un agente integrado puede hacer varias llamadas para leer archivos, aplicar un parche y volver a ejecutar las pruebas. Compara el gasto total de la corrección completada, no una sola tarifa por token.
La ayuda de claves de API de Cursor indica un recargo adicional de $0.25 por millón de tokens para BYOK en Teams y Enterprise, contando una sola vez la entrada, la salida y la entrada en caché. El ejemplo de 22,000 tokens añade $0.0055 al cargo del proveedor. El BYOK individual no tiene esa tarifa por token del plan de organización; la tarifa no demuestra que se admita un modelo personalizado concreto.
En tu primera tarea, anota el gasto total y si la corrección aplicada supera sus pruebas.
«Other Models» en la vista de uso de Cursor es un pool de facturación, no una prueba de que la solicitud fuera a un proveedor externo. Usa el registro de tareas del proveedor para identificar una llamada directa.
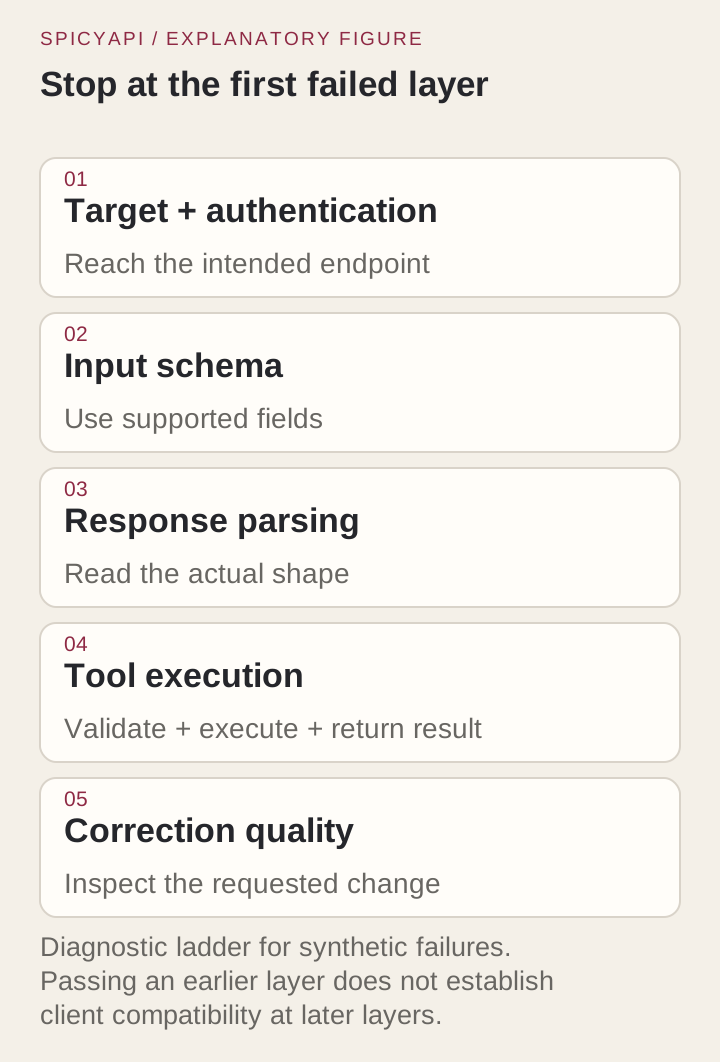
Diagnostica los fallos en el orden en que se hacen observables
- Destino o clave: revisa un 401, un modelo desconocido o una ruta duplicada antes de cambiar el esfuerzo.
- Campo rechazado: quita los parámetros o las partes de contenido no admitidos y vuelve a añadir capacidades de una en una.
- IU vacía o detenida: compara la respuesta directa con el parser del cliente, el motivo de finalización y la marca de finalización.
- Sin ejecución de herramientas: revisa el despacho de herramientas y los permisos de quien llama.
- Parche incorrecto: revisa el caso de aceptación fallido y los archivos realmente modificados.
Haz que el siguiente cambio aborde la capa que falló; alargar el prompt no corregirá un parámetro rechazado.
Usa un segundo caso para dejar al descubierto errores de conversación
Cuando el parser estricto pase, cambia un requisito: permitir espacios al principio y al final, pero mantener componentes horarios de dos dígitos. Los casos nuevos distinguen 09:05 , que ahora debe pasar, de 9:05, que sigue fallando. Aplica trim() después de la comprobación de tipo y antes de la comprobación existente de longitud y rango; mantén por separado las pruebas de ambas versiones.
Envía el código fuente corregido y el requisito cambiado en el turno siguiente: un ID de solicitud no proporciona memoria de conversación. Si el parche nuevo acepta 9:05 o edita la función antigua, las pruebas de seguimiento dejan ese error al descubierto.
Elige la ruta que corresponda a la evidencia que necesitas
Elige Cursor integrado para ediciones integradas y ejecución de pruebas. Elige la API directa para tu propio bucle de herramientas y controles de uso. Usa la configuración con clave propia para el chat cuando su comprobación de conexión tenga éxito; Cursor integrado sigue siendo la opción directa para las ediciones de archivos y las pruebas integradas.
Para este parser, limita la corrección a la función y ejecuta los catorce tests sobre el parche aplicado.





