
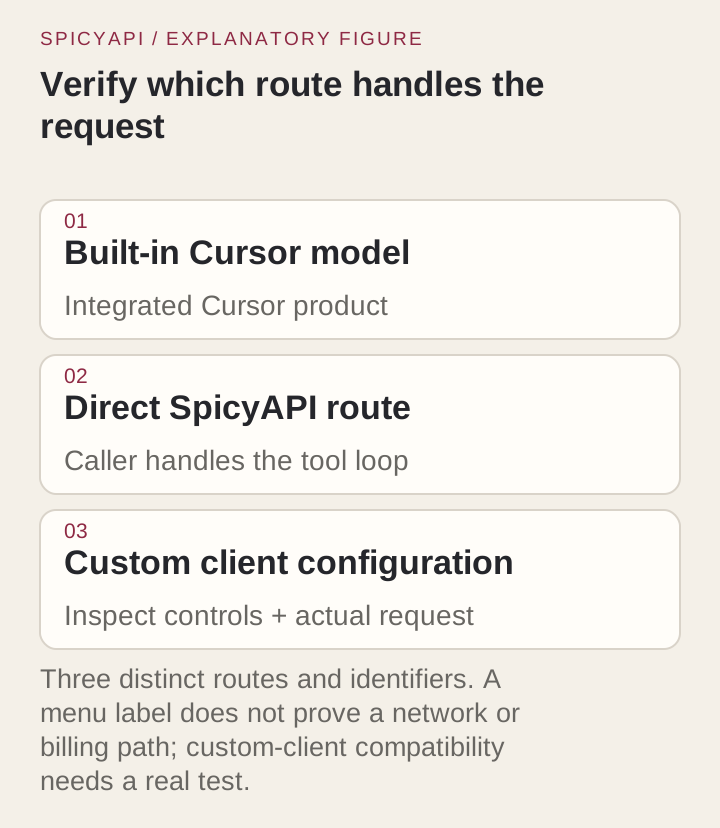
Você quer que o Grok corrija código no Cursor, mas escolher um modelo integrado e apontar uma chave para uma API externa são configurações diferentes. Use o Grok 4.6 integrado do Cursor pela integração documentada com o agente, ou chame o SpicyAPI diretamente quando seu aplicativo precisar gerenciar as requisições, as ferramentas e o uso. Para usar uma chave do SpicyAPI dentro do Cursor, abra Cursor Settings → Models e verifique se existe uma substituição personalizada de base URL. Os valores de configuração e a alternativa abaixo ajudam você a escolher o caminho certo antes de comprar uso.
Duas rotas do Grok com contratos diferentes
A documentação do Grok 4.6 do Cursor lista grok-4.6, uma janela de contexto de 256k e quatro níveis de esforço: low, medium, high e xhigh, com high como padrão. A integração nativa tem acesso às ferramentas de agente do Cursor.
A página do modelo no SpicyAPI identifica xai/grok-4.6/chat. O nome documentado para requisições Chat Completions compatíveis com OpenAI é xai/grok-4.6, enviado para https://api.spicyapi.ai/v1/chat/completions. Essa rota aceita partes de texto e imagem, tem limite de entrada de 500,000 tokens e expõe controles de requisição próprios. O esquema atual não aceita partes de arquivo nem de PDF. Uma definição de ferramenta é uma entrada para o modelo; quem chama precisa fornecer o laço de execução.
| Decisão | Grok integrado ao Cursor | Grok direto pelo SpicyAPI |
|---|---|---|
| Identificador de seleção na superfície em questão | grok-4.6 na documentação do Cursor | xai/grok-4.6 em uma requisição Chat Completions; endpoint do catálogo xai/grok-4.6/chat |
| Quem monta e gerencia o fluxo de programação? | O produto integrado do Cursor | Seu aplicativo ou um cliente compatível verificado |
| Janela de entrada | 256k tokens | 500,000 tokens |
| Edições de arquivos e testes | O Cursor gerencia as ferramentas do agente | Quem chama executa as ferramentas e aplica as edições |
O limite de 500,000 tokens da API não amplia a janela de 256k do Cursor. Para corrigir código, envie os arquivos que o definem, a falha e os testes, em vez do repositório inteiro.
Teste primeiro no Playground
- Abra o Grok 4.6 e mude para o Playground.
- Na caixa de mensagem, cole a pergunta abaixo, escolha a opção de raciocínio Low e clique em Run model:
> A delivery-window parser must accept a local time HH:MM from 00:00 through 23:59. The current function returns true for any string matching two digits, a colon and two digits. Explain which inputs it accepts incorrectly, and propose a small correction.
- Verifique se a resposta rejeita 24:00 e 12:60. Se rejeitar, a mesma pergunta está pronta para ser executada pela API ou pelo seu editor.
Use a rota integrada quando essa for a tarefa
- Abra o seletor de modelos e escolha explicitamente Grok 4.6, se sua conta o oferecer. Use uma seleção explícita em vez de Auto quando quiser este modelo em particular; confirme de novo em um chat novo.
- Escolha o esforço conforme a tarefa; o padrão documentado do modelo é
high. O plano Start, exclusivo da Índia, fixa o Grok emmediumsem o modo Fast. - Abra o projeto descartável do parser abaixo e peça uma correção limitada a
is-time.mjs. - Inspecione o diff aplicado e o resultado real dos testes. Uma explicação correta sem uma edição aplicada é um resultado diferente de uma tarefa de agente concluída.
A seleção integrada não exige base URL nem chave do SpicyAPI. Ao orçar, considere a franquia do seu plano atual e a configuração Fast; a promoção de lançamento do artigo de lançamento terminou.
Conecte sua chave ou escolha a API direta
A ajuda sobre chaves de API do Cursor documenta Cursor Settings → Models → provedor → chave → Save para OpenAI, Anthropic, Google, Azure e AWS Bedrock. Ela não documenta um endpoint personalizado para o Grok 4.6.
- Abra Cursor Settings → Models e procure uma substituição de base URL da OpenAI e uma opção para adicionar um modelo personalizado.
- Se os dois controles estiverem disponíveis, informe
https://api.spicyapi.ai/v1como base URL, sua chave do SpicyAPI como chave do provedor exai/grok-4.6como modelo personalizado. Salve a configuração. - Selecione esse modelo personalizado em um chat novo e envie a pequena pergunta do parser abaixo. Confirme que a requisição aparece nos seus logs do SpicyAPI antes de enviar uma tarefa maior.
- Se os controles não existirem ou a verificação rejeitar o modelo, use o Grok integrado para o agente do Cursor ou execute o exemplo da API direta. Colar uma chave do SpicyAPI em um campo de chave de provedor não basta por si só.
Chaves próprias cobrem o chat, não o preenchimento com Tab. As requisições BYOK ainda passam pelo backend do Cursor para a montagem do prompt, e a promessa de retenção zero do Cursor não se aplica a elas. As cobranças do provedor e qualquer taxa de cliente do plano de organização são separadas.
Mantenha os três identificadores separados
| Valor de configuração | Valor direto do SpicyAPI | Uso |
|---|---|---|
| Base URL | https://api.spicyapi.ai/v1 | Para um cliente que acrescenta /chat/completions |
| Endpoint completo | https://api.spicyapi.ai/v1/chat/completions | Para curl ou para quem envia a URL completa |
| Modelo da requisição | xai/grok-4.6 | Valor no corpo JSON |
| Tarefa do catálogo | xai/grok-4.6/chat | A entrada da lista de tarefas do modelo, e não o nome do seletor integrado do Cursor |
Mantenha a base URL e o endpoint completo distintos. Colocar o endpoint completo em um campo de base pode produzir /chat/completions/chat/completions quando o cliente acrescenta o próprio caminho. Um erro de “unknown model” exige verificar o valor do modelo; mudar o prompt ou o esforço não corrige o destino.
Comece com uma requisição direta que tenha um único propósito
Primeiro envie uma requisição direta para verificar a chave e o modelo, antes de investigar o IDE.
Este exemplo cria uma requisição de revisão de código cobrada quando você o executa. Ele usa a chave do seu ambiente. max_tokens: 4000 limita apenas a resposta visível; os tokens de raciocínio são cobrados como saída e esse teto não os limita. reasoning_effort: low reduz o trabalho de raciocínio, mas não define um teto fixo de gasto.
: "${SPICY_API_KEY:?Set SPICY_API_KEY first}"
curl --no-buffer --fail-with-body --dump-header response-headers.txt \
  https://api.spicyapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "xai/grok-4.6",
    "messages": [
      {"role": "system", "content": "Review only the code shown. Explain the smallest correction and its acceptance cases. Do not claim that you executed anything."},
      {"role": "user", "content": "A delivery-window parser must accept a local time HH:MM from 00:00 through 23:59. The current function returns true for any string matching two digits, a colon and two digits. Explain which inputs it accepts incorrectly, and propose a small correction."}
    ],
    "reasoning_effort": "low",
    "max_tokens": 4000,
    "stream": true,
    "stream_options": {"include_usage": true}
  }'
Leia os trechos choices[].delta.content do stream para obter a correção e o último chunk usage para a contagem de tokens; a documentação descreve o formato do stream.
Se a chamada direta falhar, corrija primeiro a chave, o modelo ou o campo rejeitado antes de adicionar o IDE. Esses erros vão persistir dentro de um cliente personalizado.
Deixe um Agent preparar a chamada
Para revisões de código repetidas, peça ao seu Agent de programação que use o Skill do SpicyAPI: “Read xai/grok-4.6/chat, then adapt the example to my input; show the request before running it.” A consulta pela CLI é spicyapi models get xai/grok-4.6/chat --json; a consulta pelo MCP é spicyapi_model_get com model: "xai/grok-4.6/chat". As chamadas de chat usam um cliente compatível ou a API de chat; os comandos de tarefas de mídia não geram respostas de chat.
Torne o caso de programação executável
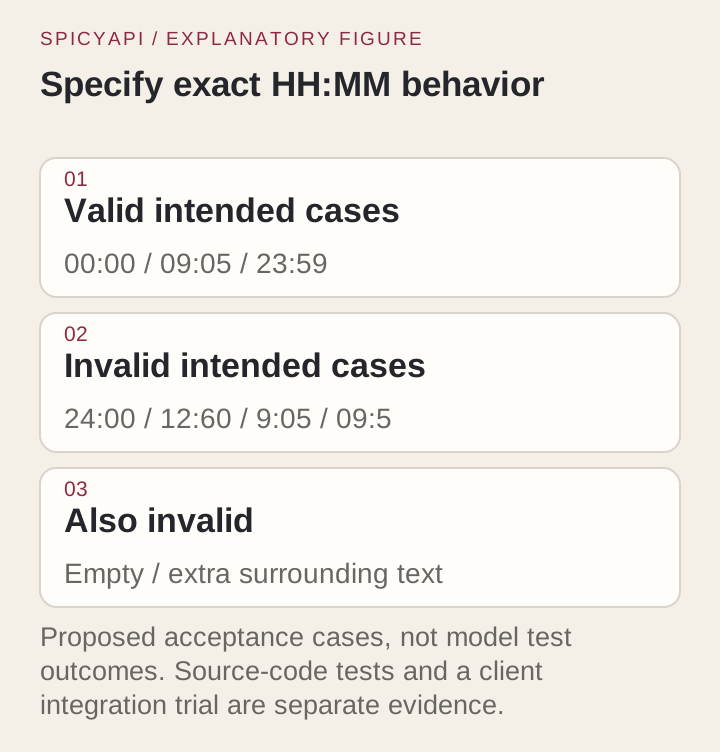
O requisito é deliberadamente estreito: aceitar exatamente HH:MM, horas 00–23 e minutos 00–59, sem espaços ao redor. Comece com este is-time.mjs com defeito:
export function isTime(value) {
  return typeof value === 'string' && /^\d{2}:\d{2}$/.test(value);
}
Salve os casos de aceitação como is-time.test.mjs:
import assert from 'node:assert/strict';
import test from 'node:test';
import { isTime } from './is-time.mjs';

const cases = [
  ['00:00', true], ['09:05', true], ['23:59', true],
  ['24:00', false], ['12:60', false], ['99:99', false],
  ['9:05', false], ['09:5', false], ['', false],
  ['09:05x', false], [' 09:05 ', false], ['09:05\n', false],
  [null, false], [905, false],
];
for (const [value, expected] of cases) {
  test(JSON.stringify(value), () => assert.equal(isTime(value), expected));
}
Execute node --test is-time.test.mjs. A função inicial falha em três casos: ela aceita 24:00, 12:60 e 99:99. Mantenha os casos de espaços, de quebra de linha final e de valores que não são strings, para evitar que uma correção posterior amplie o formato. Peça ao agente de programação:
Correct only is-time.mjs to satisfy the supplied tests. Preserve exactly two digits, reject surrounding whitespace, and return false for non-string input. Do not add a date library or change the tests. Run the tests if your tools permit, and report the actual result.
Uma solução possível é:
export function isTime(value) {
  if (typeof value !== 'string' || value.length !== 5) return false;
  return /^(?:[01]\d|2[0-3]):[0-5]\d$/.test(value);
}
A verificação de intervalo rejeita horas e minutos fora do intervalo; as verificações de tipo e de tamanho mantêm explícito o formato de cinco caracteres. Essa solução passa nos quatorze casos. Peça ao agente que produza a própria correção, execute os mesmos testes nesse patch e leia o diff: uma correção de uma única função não deve mexer em configuração, em formatação de outros pontos nem em dependências, e não deve adicionar uma biblioteca de datas para um horário de cinco caracteres.
Verifique primeiro o caminho de texto simples de um cliente personalizado
Envie a mesma pergunta do parser pelo cliente personalizado. Se nenhuma tarefa aparecer no provedor, verifique o modelo selecionado e o destino da requisição; o cliente pode ainda estar usando a rota integrada ou falhando antes de enviar.
Quando o texto simples funcionar, adicione streaming e depois ferramentas, sem mudar as demais configurações.
Use streaming para raciocínios longos
Use stream: true com esforço high ou xhigh e para saídas longas (o exemplo já faz isso); uma resposta sem streaming que leve mais de cerca de 100 segundos pode ser cortada, e uma requisição cortada que não devolve resposta não é cobrada. Uma resposta final normal termina com finish_reason: stop; tool_calls significa que seu aplicativo tem um próximo passo, e length significa que a resposta foi truncada, mesmo que o código pareça plausível. Se um stream direto terminar, mas o IDE travar, verifique o tratamento de eventos do IDE antes de trocar de modelo. Detalhes: documentação de texto e streaming.
O suporte a ferramentas exige quem chama executar as ferramentas
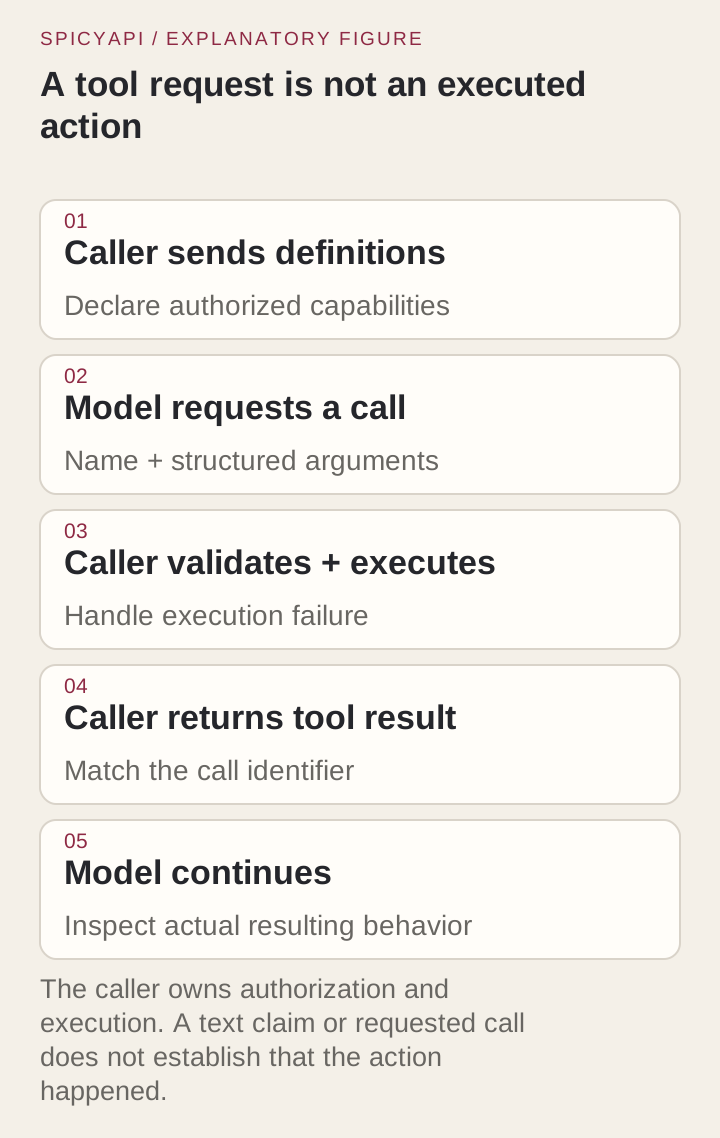
A API aceita até 128 tools, tool_choice e parallel_tool_calls (booleano, true por padrão). Seu aplicativo precisa fornecer as implementações das ferramentas.
Um laço de ferramentas precisa validar os argumentos solicitados, executar uma operação permitida, anexar o resultado real como mensagem de ferramenta e chamar o modelo de novo. Uma resposta em texto sozinha não aplica o patch nem executa o Node.
Por exemplo, depois que o assistente solicita uma função inofensiva get_acceptance_cases, quem chama devolve o resultado real com o ID correspondente:
[
  {"role":"assistant","content":null,"tool_calls":[{"id":"call_example","type":"function","function":{"name":"get_acceptance_cases","arguments":"{}"}}]},
  {"role":"tool","tool_call_id":"call_example","content":"00:00 pass; 23:59 pass; 24:00 fail; 12:60 fail; surrounding whitespace fail"}
]
Anexe a mensagem real do assistente e o resultado da ferramenta à conversa original; o JSON acima mostra o formato deles. Valide o nome da função e os argumentos antes do despacho, e limite o escopo de arquivos, os turnos de ferramentas e o gasto.
Para este caso, deixe a primeira ferramenta devolver os casos de aceitação. Depois adicione uma ferramenta de edição de arquivo limitada a is-time.mjs e um comando de teste limitado a node --test is-time.test.mjs.
Associe cada resultado de ferramenta ao seu tool_call_id, mesmo quando os resultados chegarem fora de ordem. Para esta tarefa de um único arquivo, parallel_tool_calls: false pode simplificar seu próprio harness.
Se o chat funcionar, mas as ferramentas falharem em um cliente personalizado, inspecione o campo rejeitado ou o esquema da ferramenta antes de trocar o modelo.
Mantenha o contexto do repositório relevante para a correção
O parser precisa da função, da especificação e dos testes, não de um aplicativo inteiro. Para um bug real, inclua a falha, os arquivos que o definem e os pontos de chamada afetados. Peça as informações que faltam antes de aceitar uma refatoração ampla.
A rota direta aceita até 256 mensagens; tokens e número de mensagens são limites separados. Respostas anteriores, resultados de ferramentas e imagens também ocupam contexto. Em sessões longas, preserve o código-fonte atual e o resultado real dos testes junto com um resumo conciso das decisões. Um IDE personalizado pode resumir ou omitir arquivos selecionados, então uma janela de API maior não repara um contexto que o cliente nunca enviou.
Trate entradas de imagem e de arquivo como capacidades diferentes
A rota hospedada aceita partes de texto e image_url; não aceita partes de PDF nem de arquivo. Para um bug visual de interface, combine uma captura de tela acessível por URL com a especificação. Por exemplo, uma tela mostrando 24:00 pode ilustrar o estado de entrada inválida do parser. O caso em texto não precisa de imagem.
Para uma especificação em PDF, extraia o texto relevante localmente e confira a ordem das tabelas e as notas de rodapé antes de enviar. Isso é um fluxo de extração, não uma entrada nativa de PDF. Se um IDE personalizado não conseguir encaminhar uma imagem ou acrescentar um campo de arquivo não suportado, use a requisição direta suportada ou o equivalente em texto.
Escolha o esforço e os tetos de saída conforme o trabalho
A API direta aceita low, medium, high e xhigh; o padrão é high, e none não é aceito. Use low explicitamente para a pequena requisição do parser. Aumente o esforço para uma correção mais difícil quando a configuração mais baixa não passar nos casos de aceitação.
Se o IDE esconder os controles de esforço, o modo que ele seleciona pode diferir da sua requisição direta. Compare o patch real e o uso, não o quanto a explicação parece minuciosa.
max_tokens tem padrão 4,096 e aceita até 450,000 tokens de resposta visível. Mantenha-o baixo para um patch de uma função. O raciocínio pode tornar a saída cobrada muitas vezes maior que esse patch, principalmente com o esforço high padrão. Use esforço menor em correções de rotina, faça o orçamento a partir de usage e defina limites diários e totais de gasto por chave de API, além de orçamentos diários e mensais do workspace, para laços de agente; este endpoint Chat Completions não tem teto de cotação por chamada.
Deixe temperature e top-p nos valores padrão enquanto compara as configurações de esforço.
Leia os preços de tokens mantendo as categorias de cobrança
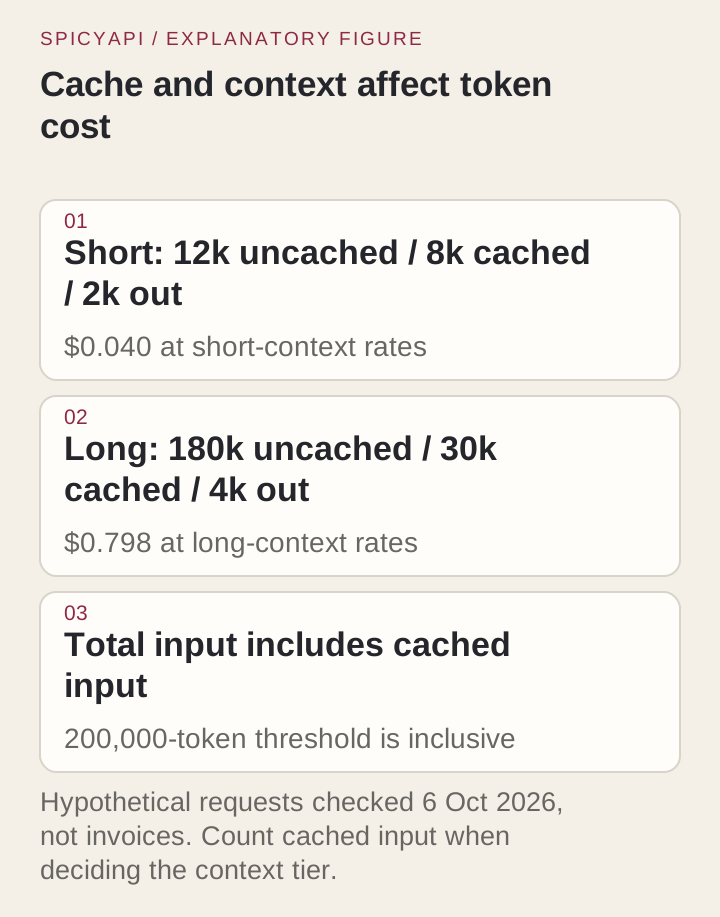
As tarifas do SpicyAPI são $2.00 por entrada sem cache, $0.50 por entrada em cache e $6.00 por saída por milhão de tokens. Com 200,000 tokens de entrada no total ou mais, incluindo a entrada em cache, a requisição inteira usa $4.00, $1.00 e $12.00, respectivamente. São preços de catálogo para o cliente, não o registro de uma nova cobrança do cliente.
Para uma requisição direta hipotética com 12,000 tokens de entrada sem cache, 8,000 tokens de entrada em cache e 2,000 tokens de saída cobrados, a aritmética do catálogo é:
Uncached input: 12,000 / 1,000,000 × $2.00 = $0.0240
Cached input:    8,000 / 1,000,000 × $0.50 = $0.0040
Output:         2,000 / 1,000,000 × $6.00 = $0.0120
Total: $0.0400
A entrada total nesse exemplo é 20,000, não 12,000. Se o campo usage informar a entrada total e um subconjunto em cache, não cobre os tokens em cache duas vezes: subtraia o subconjunto em cache para obter a entrada sem cache. Ao conciliar uma requisição real, use as categorias reais da resposta e o registro da plataforma.
Um exemplo de contexto longo com 180,000 de entrada sem cache, 30,000 de entrada em cache e 4,000 de saída cobrada soma 210,000 de entrada. A aritmética é $0.720 + $0.030 + $0.048 = $0.798 nas tarifas long. O limiar se aplica às categorias completas da requisição, não apenas à parte acima de 200,000. Reduzir contexto desnecessário pode, portanto, mudar tanto a quantidade de tokens quanto a faixa aplicável.
Essas são contagens de tokens presumidas. Faça o orçamento sem economia de cache até o usage informar um acerto; o acerto de contas usa o uso medido, incluindo a saída de raciocínio.
Compare com cuidado um preço do Cursor com um preço direto
A página Models and Pricing do Cursor lista para o Grok 4.6 tarifas padrão de $2 de entrada, $0.50 de entrada em cache e $6 de saída por milhão de tokens; as tarifas Fast são $4, $1 e $12. O Fast vem ativado por padrão nos planos Pro elegíveis, então verifique o seletor antes de começar uma tarefa longa. O Grok integrado consome do pool Models do Cursor e da franquia do seu plano. As franquias da assinatura, a escolha de velocidade e os termos específicos da conta afetam o que um usuário paga; as tarifas listadas não são uma previsão da fatura mensal.
Para os mesmos 12,000 tokens de entrada sem cache, 8,000 em cache e 2,000 de saída, o Cursor padrão soma $0.040, o Fast $0.080 e a API direta $0.040, o mesmo que o Cursor padrão com essas tarifas listadas. Esses cálculos comparam tarifas por token declaradas sob um uso igual artificial; não mostram que os dois produtos fazem o mesmo trabalho. Sessões reais de agente podem consumir quantidades de tokens diferentes.
Um agente integrado pode fazer várias chamadas para ler arquivos, aplicar um patch e executar os testes de novo. Compare o gasto total da correção concluída, não uma única tarifa por token.
A ajuda sobre chaves de API do Cursor lista um adicional de $0.25 por milhão de tokens para BYOK em Teams e Enterprise, contando entrada, saída e entrada em cache uma vez cada. O exemplo de 22,000 tokens soma $0.0055 à cobrança do provedor. O BYOK individual não tem essa taxa por token do plano de organização; a taxa não prova que um modelo personalizado específico seja suportado.
Na sua primeira tarefa, registre o gasto total e se a correção aplicada passa nos testes.
“Other Models” na tela de uso do Cursor é um pool de cobrança, não prova de que a requisição foi para um provedor externo. Use o registro de tarefas do provedor para identificar uma chamada direta.
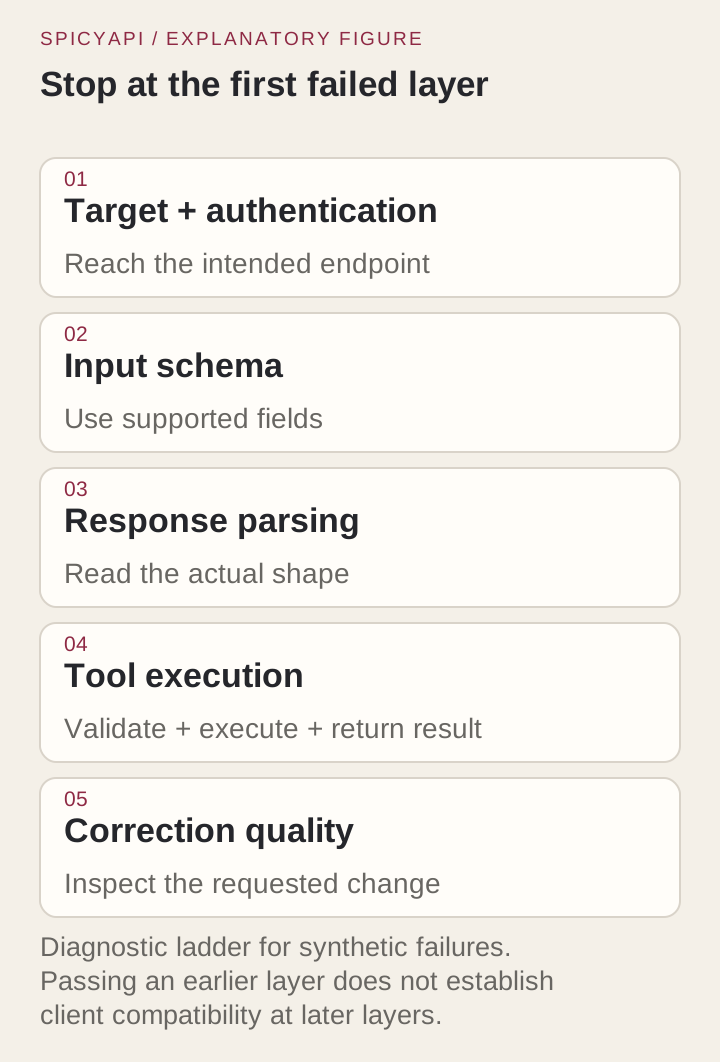
Diagnostique as falhas na ordem em que elas se tornam observáveis
- Destino ou chave: examine um 401, um modelo desconhecido ou um caminho duplicado antes de mudar o esforço.
- Campo rejeitado: remova parâmetros ou partes de conteúdo não suportados e adicione as capacidades uma de cada vez.
- Interface vazia ou travada: compare a resposta direta com o parser do cliente, o motivo de término e o marcador de conclusão.
- Nenhuma execução de ferramenta: examine o despacho de ferramentas de quem chama e as permissões.
- Patch incorreto: verifique o caso de aceitação que falhou e os arquivos realmente alterados.
Faça a próxima mudança tratar a camada que falhou; aumentar o prompt não corrige um parâmetro rejeitado.
Use um segundo caso para expor erros de conversa
Depois que o parser estrito passar, mude um requisito: permitir espaços no início e no fim, mas manter componentes de horário com dois dígitos. Os novos casos distinguem 09:05 , que agora deve passar, de 9:05, que continua falhando. Aplique trim() depois da verificação de tipo e antes da verificação existente de tamanho e intervalo; mantenha separados os testes das duas versões.
Envie o código-fonte corrigido e o requisito alterado no turno seguinte: um ID de requisição não fornece memória de conversa. Se o novo patch aceitar 9:05 ou editar a função antiga, os testes seguintes expõem esse erro.
Escolha a rota que corresponde à evidência de que você precisa
Escolha o Cursor integrado para edições integradas e execução de testes. Escolha a API direta para o seu próprio laço de ferramentas e controles de uso. Use a configuração com chave própria para o chat quando a verificação de conexão for bem-sucedida; o Cursor integrado continua sendo a escolha direta para edições de arquivos e testes integrados.
Para este parser, limite a correção à função e execute os catorze testes no patch aplicado.





