
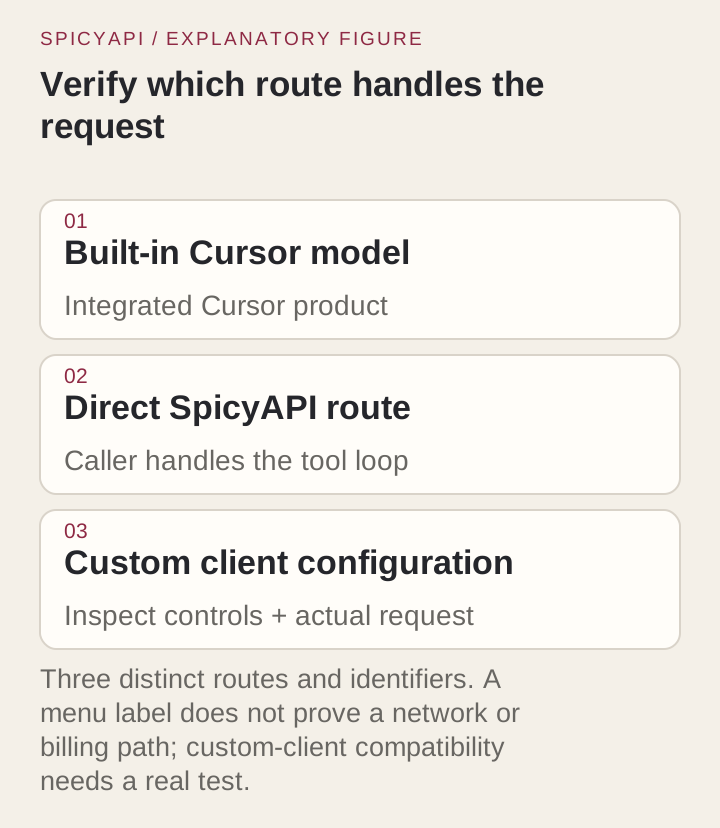
Vuoi che Grok corregga il codice in Cursor, ma scegliere un modello integrato e puntare una chiave verso un'API esterna sono due configurazioni diverse. Usa il Grok 4.6 integrato di Cursor per la sua integrazione con l'agent documentata, oppure chiama direttamente SpicyAPI quando la tua applicazione deve gestire richieste, strumenti e consumi. Per usare una chiave SpicyAPI dentro Cursor, apri Cursor Settings → Models e controlla se esiste un override della base URL personalizzato. I valori di configurazione e l'alternativa qui sotto ti permettono di scegliere la strada giusta prima di acquistare consumi.
Due percorsi Grok con contratti diversi
La documentazione di Grok 4.6 di Cursor indica grok-4.6, una finestra di contesto da 256k e quattro livelli di effort: low, medium, high e xhigh, con high come predefinito. L'integrazione nativa ha accesso agli strumenti agent di Cursor.
La pagina del modello SpicyAPI identifica xai/grok-4.6/chat. Il nome documentato per le richieste Chat Completions compatibili con OpenAI è xai/grok-4.6, inviato a https://api.spicyapi.ai/v1/chat/completions. Questo percorso accetta parti di testo e immagine, ha un limite di input di 500,000 token ed espone controlli di richiesta propri. Il suo schema attuale non accetta parti file o PDF. La definizione di uno strumento è un input per il modello; chi chiama deve fornire il ciclo di esecuzione.
| Decisione | Grok integrato in Cursor | Grok diretto con SpicyAPI |
|---|---|---|
| Identificatore di selezione nell'interfaccia pertinente | grok-4.6 nella documentazione di Cursor | xai/grok-4.6 in una richiesta Chat Completions; endpoint del catalogo xai/grok-4.6/chat |
| Chi costruisce e gestisce il flusso di programmazione? | Il prodotto integrato di Cursor | La tua applicazione o un client compatibile verificato |
| Finestra di input | 256k token | 500,000 token |
| Modifiche ai file e test | Cursor gestisce gli strumenti dell'agent | Il tuo chiamante esegue gli strumenti e applica le modifiche |
Il limite API di 500,000 token non amplia la finestra da 256k di Cursor. Per correggere del codice, invia i file che lo definiscono, l'errore e i test, non l'intero repository.
Prova prima nel Playground
- Apri Grok 4.6 e passa al Playground.
- Nella casella dei messaggi incolla la domanda qui sotto, scegli l'opzione di reasoning Low e premi Run model:
> A delivery-window parser must accept a local time HH:MM from 00:00 through 23:59. The current function returns true for any string matching two digits, a colon and two digits. Explain which inputs it accepts incorrectly, and propose a small correction.
- Controlla se la risposta rifiuta 24:00 e 12:60. Se lo fa, la stessa domanda è pronta per essere eseguita dall'API o dal tuo editor.
Usa il percorso integrato quando è questo il compito
- Apri il selettore dei modelli e scegli esplicitamente Grok 4.6 se il tuo account lo offre. Usa una selezione esplicita al posto di Auto quando vuoi proprio questo modello; ricontrollala in una nuova chat.
- Scegli l'effort adatto al compito; il valore predefinito documentato del modello è
high. Il piano Start, solo per l'India, fissa Grok sumediumsenza modalità Fast. - Apri il progetto parser usa e getta qui sotto e chiedi una correzione limitata a
is-time.mjs. - Controlla il diff applicato e l'effettivo risultato dei test. Una spiegazione corretta senza una modifica applicata è un esito diverso da un compito dell'agent completato.
La selezione integrata non richiede una base URL né una chiave SpicyAPI. Quando fai il budget, considera la quota del tuo piano attuale e l'impostazione Fast; la promozione introduttiva dell'articolo di lancio è terminata.
Collega la tua chiave o scegli l'API diretta
La guida alle chiavi API di Cursor documenta Cursor Settings → Models → provider → chiave → Save per OpenAI, Anthropic, Google, Azure e AWS Bedrock. Non documenta un endpoint personalizzato per Grok 4.6.
- Apri Cursor Settings → Models e cerca un override della base URL di OpenAI e un'opzione per aggiungere un modello personalizzato.
- Se entrambi i controlli sono disponibili, inserisci
https://api.spicyapi.ai/v1come base URL, la tua chiave SpicyAPI come chiave del provider exai/grok-4.6come modello personalizzato. Salva la configurazione. - Seleziona quel modello personalizzato in una nuova chat e invia la piccola domanda sul parser qui sotto. Controlla che la richiesta compaia nei tuoi log SpicyAPI prima di inviare un compito più grande.
- Se i controlli mancano o la verifica rifiuta il modello, usa il Grok integrato per l'agent di Cursor oppure esegui l'esempio con l'API diretta. Incollare una chiave SpicyAPI in un campo chiave del provider non basta da solo.
Le chiavi personali coprono la chat, non il completamento con Tab. Le richieste BYOK passano comunque dal backend di Cursor per la costruzione del prompt, e la promessa di zero retention di Cursor non vale per esse. Gli addebiti del provider e l'eventuale commissione client del piano organizzazione sono separati.
Tieni separati i tre identificatori
| Valore di configurazione | Valore SpicyAPI diretto | Uso |
|---|---|---|
| Base URL | https://api.spicyapi.ai/v1 | Per un client che aggiunge /chat/completions |
| Endpoint completo | https://api.spicyapi.ai/v1/chat/completions | Per curl o per un chiamante che invia l'URL completo |
| Modello della richiesta | xai/grok-4.6 | Valore nel corpo JSON |
| Task del catalogo | xai/grok-4.6/chat | La voce dell'elenco dei task del modello, non il nome nel selettore integrato di Cursor |
Tieni distinti la base URL e l'endpoint completo. Mettere l'endpoint completo in un campo base può produrre /chat/completions/chat/completions quando il client aggiunge il proprio percorso. Un errore «unknown model» richiede di controllare il valore del modello; cambiare il prompt o l'effort non ripara la destinazione.
Parti da una richiesta diretta con un solo scopo
Invia prima una richiesta diretta per verificare chiave e modello, prima di risolvere problemi dell'IDE.
Questo esempio crea una richiesta di revisione del codice a pagamento quando lo esegui. Usa la chiave del tuo ambiente. max_tokens: 4000 limita solo la risposta visibile; i token di reasoning sono fatturati come output e questo tetto non li limita. reasoning_effort: low riduce il lavoro di reasoning ma non fissa un tetto di spesa.
: "${SPICY_API_KEY:?Set SPICY_API_KEY first}"
curl --no-buffer --fail-with-body --dump-header response-headers.txt \
  https://api.spicyapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "xai/grok-4.6",
    "messages": [
      {"role": "system", "content": "Review only the code shown. Explain the smallest correction and its acceptance cases. Do not claim that you executed anything."},
      {"role": "user", "content": "A delivery-window parser must accept a local time HH:MM from 00:00 through 23:59. The current function returns true for any string matching two digits, a colon and two digits. Explain which inputs it accepts incorrectly, and propose a small correction."}
    ],
    "reasoning_effort": "low",
    "max_tokens": 4000,
    "stream": true,
    "stream_options": {"include_usage": true}
  }'
Leggi i frammenti choices[].delta.content dello stream per la correzione e l'ultimo chunk usage per il conteggio dei token; la documentazione descrive il formato dello stream.
Se la chiamata diretta fallisce, correggi prima chiave, modello o campo rifiutato, poi aggiungi l'IDE. Quegli errori persisteranno anche in un client personalizzato.
Lascia che un Agent prepari la chiamata
Per revisioni di codice ripetute, chiedi al tuo Agent di programmazione di usare lo Skill SpicyAPI: “Read xai/grok-4.6/chat, then adapt the example to my input; show the request before running it.” La consultazione con la CLI è spicyapi models get xai/grok-4.6/chat --json; quella con il MCP è spicyapi_model_get con model: "xai/grok-4.6/chat". Le chiamate di chat usano un client compatibile o l'API di chat; i comandi dei task media non generano risposte di chat.
Rendi eseguibile il caso di programmazione
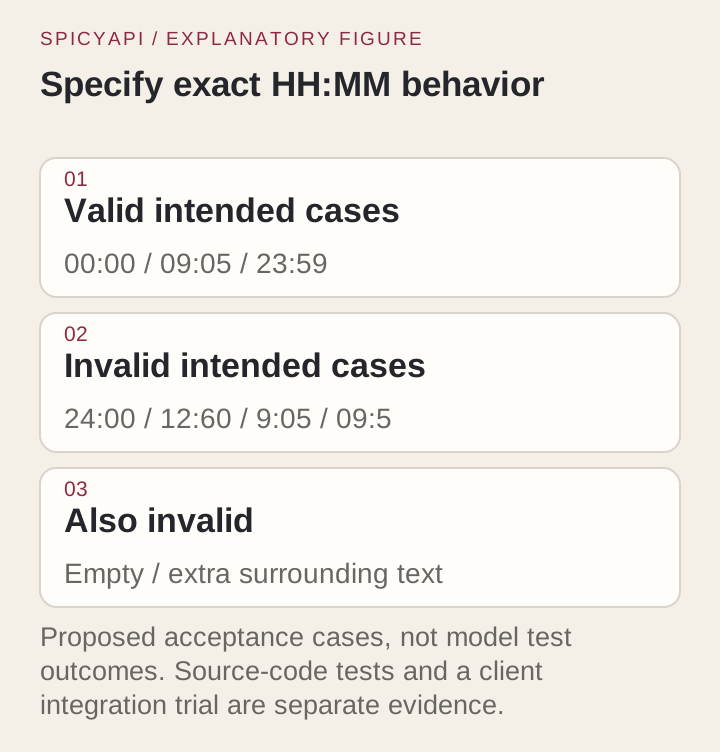
Il requisito è volutamente ristretto: accettare esattamente HH:MM, ore 00–23 e minuti 00–59, senza spazi attorno. Parti da questo is-time.mjs difettoso:
export function isTime(value) {
  return typeof value === 'string' && /^\d{2}:\d{2}$/.test(value);
}
Salva i casi di accettazione come is-time.test.mjs:
import assert from 'node:assert/strict';
import test from 'node:test';
import { isTime } from './is-time.mjs';

const cases = [
  ['00:00', true], ['09:05', true], ['23:59', true],
  ['24:00', false], ['12:60', false], ['99:99', false],
  ['9:05', false], ['09:5', false], ['', false],
  ['09:05x', false], [' 09:05 ', false], ['09:05\n', false],
  [null, false], [905, false],
];
for (const [value, expected] of cases) {
  test(JSON.stringify(value), () => assert.equal(isTime(value), expected));
}
Esegui node --test is-time.test.mjs. La funzione iniziale fallisce tre casi: accetta 24:00, 12:60 e 99:99. Mantieni i casi con spazi, a capo finale e valori non stringa, per evitare che una correzione successiva allarghi il formato. Chiedi all'agent di programmazione:
Correct only is-time.mjs to satisfy the supplied tests. Preserve exactly two digits, reject surrounding whitespace, and return false for non-string input. Do not add a date library or change the tests. Run the tests if your tools permit, and report the actual result.
Una possibile soluzione è:
export function isTime(value) {
  if (typeof value !== 'string' || value.length !== 5) return false;
  return /^(?:[01]\d|2[0-3]):[0-5]\d$/.test(value);
}
Il controllo dell'intervallo rifiuta ore e minuti fuori range; i controlli di tipo e lunghezza mantengono esplicito il formato di cinque caratteri. Questa soluzione supera tutti i quattordici casi. Chiedi all'agent di produrre la sua correzione, esegui gli stessi test su quella patch e leggi il diff: una correzione di una sola funzione non dovrebbe toccare configurazione, formattazione altrove o dipendenze, e non dovrebbe aggiungere una libreria di date per un orario di cinque caratteri.
Verifica prima il percorso in solo testo di un client personalizzato
Invia la stessa domanda sul parser tramite il client personalizzato. Se non compare alcun task del provider, controlla il modello selezionato e la destinazione della richiesta; il client potrebbe usare ancora il suo percorso integrato o fallire prima di inviare qualcosa.
Quando il solo testo funziona, aggiungi lo streaming e poi gli strumenti senza cambiare le altre impostazioni.
Usa lo streaming per i reasoning lunghi
Usa stream: true per effort high o xhigh e per output lunghi (l'esempio lo fa già); una risposta non in streaming che impiega più di circa 100 secondi può essere interrotta, e una richiesta interrotta che non restituisce alcuna risposta non viene addebitata. Una risposta finale normale termina con finish_reason: stop; tool_calls significa che la tua app ha un passo successivo, e length significa che la risposta è stata troncata, anche se il codice sembra plausibile. Se uno stream diretto si completa ma l'IDE si blocca, controlla la gestione degli eventi dell'IDE prima di cambiare modello. Dettagli: documentazione su testo e streaming.
Il supporto agli strumenti richiede un chiamante che li esegua
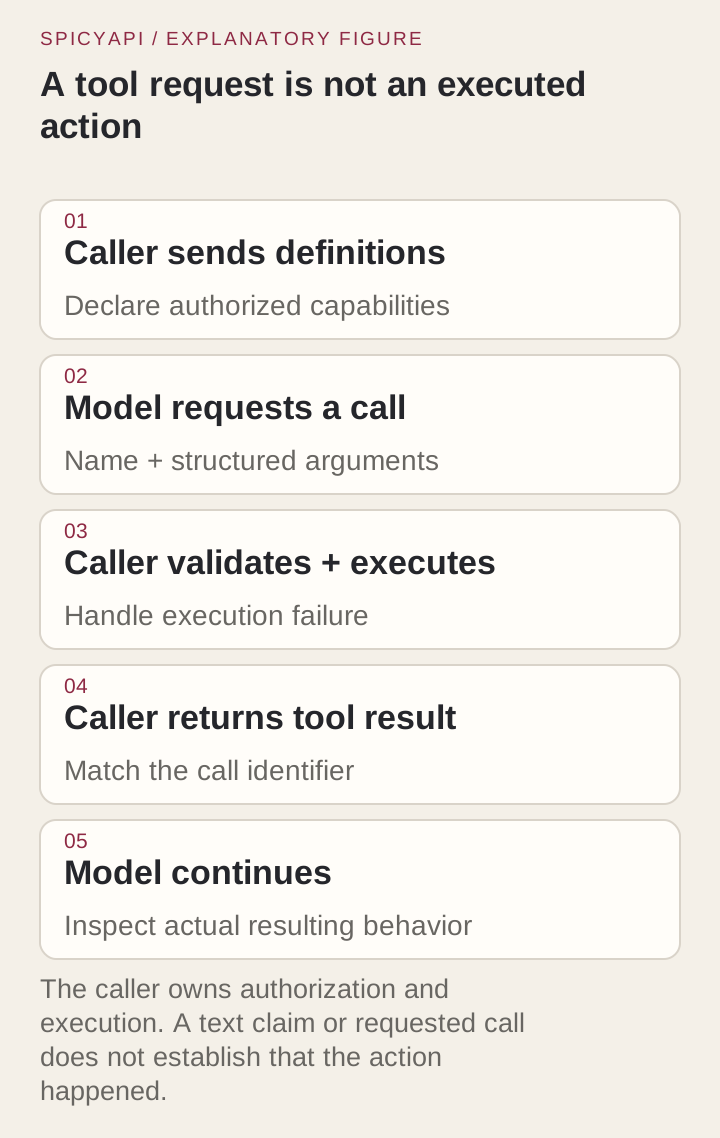
L'API accetta fino a 128 tools, tool_choice e parallel_tool_calls (booleano, true per impostazione predefinita). La tua applicazione deve fornire le implementazioni degli strumenti.
Un ciclo di strumenti deve validare gli argomenti richiesti, eseguire un'operazione consentita, aggiungere il suo risultato effettivo come messaggio di strumento e richiamare il modello. Una risposta testuale da sola non può applicare la patch né eseguire Node.
Per esempio, dopo che l'assistente richiede una funzione innocua get_acceptance_cases, il chiamante restituisce il suo risultato effettivo con l'ID corrispondente:
[
  {"role":"assistant","content":null,"tool_calls":[{"id":"call_example","type":"function","function":{"name":"get_acceptance_cases","arguments":"{}"}}]},
  {"role":"tool","tool_call_id":"call_example","content":"00:00 pass; 23:59 pass; 24:00 fail; 12:60 fail; surrounding whitespace fail"}
]
Aggiungi il messaggio effettivo dell'assistente e il risultato dello strumento alla conversazione originale; il JSON qui sopra mostra la loro forma. Valida nome della funzione e argomenti prima dell'esecuzione, e limita l'ambito dei file, i turni di strumenti e la spesa.
Per questo caso, lascia che il primo strumento restituisca i casi di accettazione. Poi aggiungi uno strumento di modifica file limitato a is-time.mjs e un comando di test limitato a node --test is-time.test.mjs.
Associa ogni risultato di strumento al suo tool_call_id, anche quando i risultati arrivano in ordine diverso. Per questo compito su un solo file, parallel_tool_calls: false può semplificare il tuo harness.
Se la chat funziona ma gli strumenti falliscono in un client personalizzato, controlla il campo rifiutato o lo schema dello strumento prima di cambiare modello.
Mantieni il contesto del repository pertinente alla correzione
Il parser ha bisogno della sua funzione, della specifica e dei test, non di un'intera applicazione. Per un bug reale, includi l'errore, i file che lo definiscono e i punti di chiamata coinvolti. Chiedi le informazioni mancanti prima di accettare un refactoring ampio.
Il percorso diretto accetta fino a 256 messaggi; token e numero di messaggi sono limiti separati. Anche le risposte precedenti, i risultati degli strumenti e le immagini occupano contesto. Nelle sessioni lunghe, conserva il sorgente attuale e l'effettivo esito dei test insieme a un riepilogo conciso delle decisioni. Un IDE personalizzato può riassumere o omettere file selezionati, quindi una finestra API più grande non può riparare un contesto che il client non ha mai inviato.
Tratta gli input immagine e file come capacità diverse
Il percorso ospitato accetta parti di testo e image_url; non accetta parti PDF o file. Per un bug visivo dell'interfaccia, abbina a una specifica uno screenshot raggiungibile tramite URL. Per esempio, una schermata che mostra 24:00 può illustrare lo stato di input non valido del parser. Il caso testuale in sé non richiede un'immagine.
Per una specifica in PDF, estrai il testo rilevante in locale e controlla l'ordine delle tabelle e le note a piè di pagina prima di inviarlo. È un flusso di estrazione, non un input PDF nativo. Se un IDE personalizzato non riesce a inoltrare un'immagine o aggiunge un campo file non supportato, usa la richiesta diretta supportata o il suo equivalente testuale.
Scegli effort e tetti di output in base al lavoro
L'API diretta accetta low, medium, high e xhigh; il valore predefinito è high e none non è accettato. Usa low in modo esplicito per la piccola richiesta sul parser. Aumenta l'effort per una correzione più difficile quando l'impostazione più bassa non supera i suoi casi di accettazione.
Se l'IDE nasconde i controlli dell'effort, la modalità che seleziona può differire dalla tua richiesta diretta. Confronta la patch effettiva e il consumo, non la minuziosità apparente della spiegazione.
max_tokens ha come predefinito 4,096 e accetta fino a 450,000 token di risposta visibile. Tienilo basso per una patch di una sola funzione. Il reasoning può rendere l'output fatturato molte volte più lungo di quella patch, soprattutto con l'effort high predefinito. Usa un effort più basso per le correzioni di routine, fai il budget in base a usage e imposta limiti di spesa giornalieri e totali per chiave API, oltre a budget giornalieri e mensili del workspace, per i cicli di agent; questo endpoint Chat Completions non ha un tetto di preventivo per chiamata.
Lascia temperature e top-p ai valori predefiniti mentre confronti le impostazioni di effort.
Leggi i prezzi dei token mantenendo intatte le categorie di fatturazione
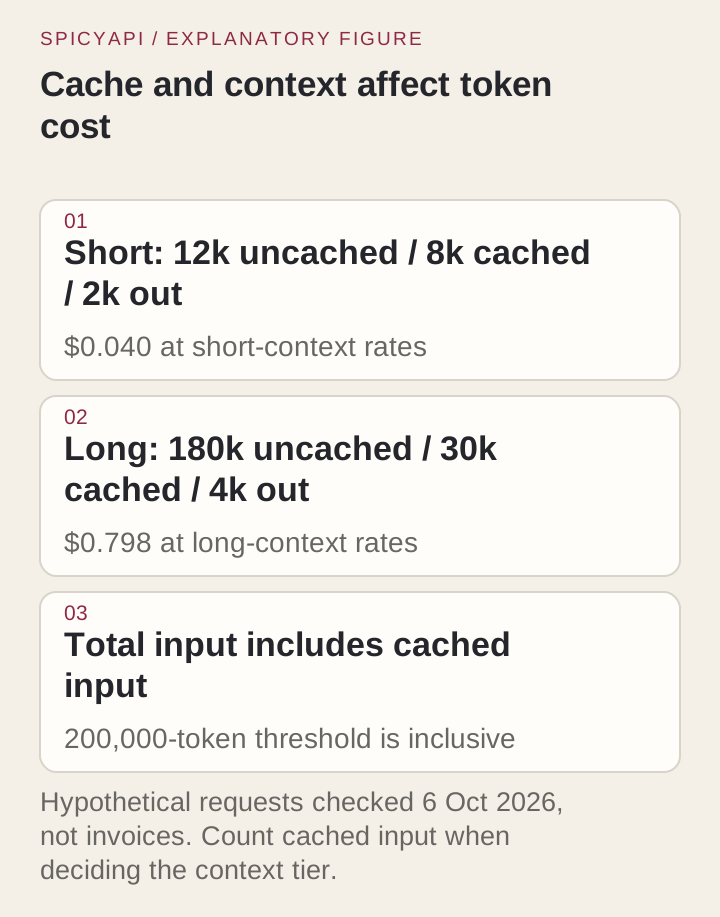
Le tariffe SpicyAPI sono $2.00 per input non in cache, $0.50 per input in cache e $6.00 per output per milione di token. A 200,000 token di input totali o più, input in cache incluso, l'intera richiesta usa rispettivamente $4.00, $1.00 e $12.00. Sono prezzi di catalogo rivolti al cliente, non la registrazione di un nuovo addebito del client.
Per una richiesta diretta ipotetica con 12,000 token di input non in cache, 8,000 token di input in cache e 2,000 token di output fatturati, l'aritmetica del catalogo è:
Uncached input: 12,000 / 1,000,000 × $2.00 = $0.0240
Cached input:    8,000 / 1,000,000 × $0.50 = $0.0040
Output:         2,000 / 1,000,000 × $6.00 = $0.0120
Total: $0.0400
L'input totale in quell'esempio è 20,000, non 12,000. Se il campo usage riporta l'input totale e un sottoinsieme in cache, non fatturare due volte i token in cache: sottrai il sottoinsieme in cache per ottenere l'input non in cache. Usa le categorie effettive della risposta e il registro della piattaforma quando riconcili una richiesta reale.
Un esempio a contesto lungo con 180,000 di input non in cache, 30,000 di input in cache e 4,000 di output fatturato somma 210,000 di input. La sua aritmetica è $0.720 + $0.030 + $0.048 = $0.798 alle tariffe long. La soglia si applica alle categorie complete della richiesta, non solo alla parte oltre 200,000. Ridurre il contesto superfluo può quindi cambiare sia la quantità di token sia lo scaglione applicabile.
Questi sono conteggi di token ipotizzati. Fai il budget senza risparmio di cache finché usage non riporta un hit; la liquidazione usa il consumo misurato, compreso l'output di reasoning.
Confronta con attenzione un prezzo Cursor e un prezzo diretto
La pagina Models and Pricing di Cursor indica per Grok 4.6 tariffe standard di $2 di input, $0.50 di input in cache e $6 di output per milione di token; le tariffe Fast sono $4, $1 e $12. Fast è attivo per impostazione predefinita sui piani Pro idonei, quindi controlla il selettore prima di avviare un compito lungo. Il Grok integrato attinge al pool Models di Cursor e alla quota del tuo piano. Le quote dell'abbonamento, la scelta della velocità e le condizioni specifiche dell'account influiscono su ciò che paga un utente; le tariffe elencate non sono una previsione di una fattura mensile.
Per gli stessi 12,000 token di input non in cache, 8,000 di input in cache e 2,000 di output, Cursor standard totalizza $0.040, Fast $0.080 e l'API diretta $0.040, lo stesso di Cursor standard a queste tariffe elencate. Questi calcoli confrontano tariffe per token dichiarate con un consumo uguale artificiale; non dimostrano che i due prodotti svolgano lo stesso lavoro. Le sessioni reali di agent possono consumare quantità di token diverse.
Un agent integrato può fare più chiamate per leggere file, applicare una patch e rieseguire i test. Confronta la spesa totale della correzione completata, non una singola tariffa per token.
La guida alle chiavi API di Cursor indica un supplemento di $0.25 per milione di token per BYOK Teams ed Enterprise, contando input, output e input in cache una sola volta. L'esempio da 22,000 token aggiunge $0.0055 all'addebito del provider. Il BYOK individuale non ha questa commissione per token del piano organizzazione; la commissione non dimostra che un particolare modello personalizzato sia supportato.
Per il tuo primo compito, registra la spesa totale e se la correzione applicata supera i suoi test.
«Other Models» nella vista di utilizzo di Cursor è un pool di fatturazione, non la prova che la richiesta sia andata a un provider esterno. Usa il registro dei task del provider per identificare una chiamata diretta.
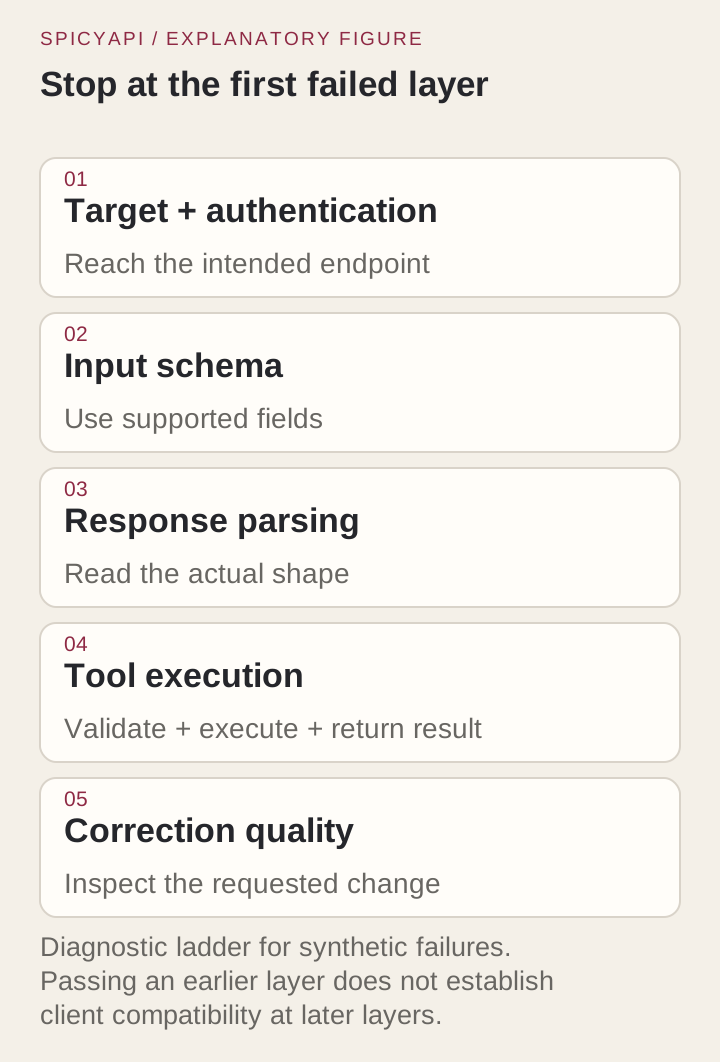
Diagnostica i guasti nell'ordine in cui diventano osservabili
- Destinazione o chiave: controlla un 401, un modello sconosciuto o un percorso duplicato prima di cambiare l'effort.
- Campo rifiutato: rimuovi i parametri o le parti di contenuto non supportati, poi aggiungi le capacità una alla volta.
- UI vuota o ferma: confronta la risposta diretta con il parser del client, il motivo di fine e il marcatore di completamento.
- Nessuna esecuzione di strumenti: controlla il dispatch degli strumenti del chiamante e i permessi.
- Patch errata: controlla il caso di accettazione fallito e i file effettivamente modificati.
Fai in modo che la modifica successiva riguardi il livello che ha fallito; allungare il prompt non risolve un parametro rifiutato.
Usa un secondo caso per far emergere gli errori di conversazione
Dopo che il parser rigoroso ha superato i test, cambia un requisito: consentire spazi iniziali e finali, ma mantenere componenti orarie a due cifre. I nuovi casi distinguono 09:05 , che ora deve passare, da 9:05, che continua a fallire. Applica trim() dopo il controllo del tipo e prima del controllo esistente di lunghezza e intervallo; tieni separati i test delle due versioni.
Invia il sorgente corretto e il requisito modificato nel turno successivo: un ID di richiesta non fornisce memoria della conversazione. Se la nuova patch accetta 9:05 o modifica la vecchia funzione, i test successivi fanno emergere l'errore.
Scegli il percorso che corrisponde alle prove di cui hai bisogno
Scegli Cursor integrato per modifiche integrate ed esecuzione dei test. Scegli l'API diretta per il tuo ciclo di strumenti e per il controllo dei consumi. Usa la configurazione con chiave personale per la chat quando il suo controllo di connessione riesce; Cursor integrato resta la scelta più diretta per modifiche ai file e test integrati.
Per questo parser, limita la correzione alla funzione ed esegui tutti e quattordici i test sulla patch applicata.





