
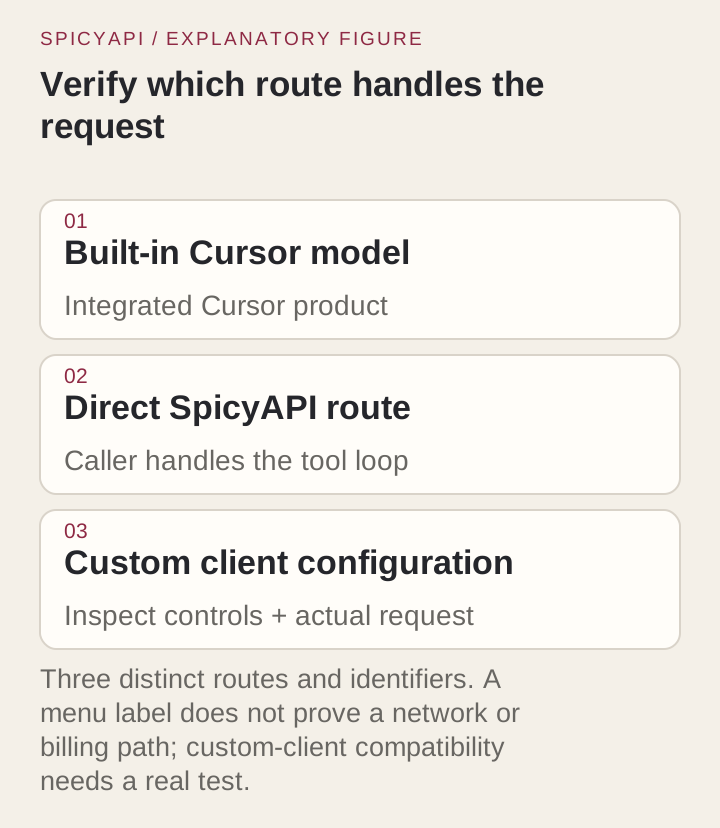
Chcesz, żeby Grok poprawiał kod w Cursorze, ale wybór wbudowanego modelu i klucz skierowany do zewnętrznego API to dwie różne konfiguracje. Użyj wbudowanego Grok 4.6 w Cursorze, jeśli zależy Ci na udokumentowanej integracji z agentem, albo wywołuj SpicyAPI bezpośrednio, gdy Twoja aplikacja ma sama zarządzać żądaniami, narzędziami i zużyciem. Aby użyć klucza SpicyAPI w Cursorze, otwórz Cursor Settings → Models i sprawdź, czy jest dostępne własne nadpisanie base URL. Poniższe wartości konfiguracji i rozwiązanie zapasowe pozwolą Ci wybrać właściwą drogę, zanim kupisz zużycie.
Dwie ścieżki Grok z różnymi kontraktami
Dokumentacja Grok 4.6 w Cursorze podaje grok-4.6, okno kontekstu 256k i cztery poziomy effort: low, medium, high i xhigh, z domyślnym high. Wbudowana integracja ma dostęp do narzędzi agenta Cursora.
Strona modelu SpicyAPI wskazuje xai/grok-4.6/chat. Udokumentowana nazwa w żądaniu Chat Completions zgodnym z OpenAI to xai/grok-4.6, wysyłana na https://api.spicyapi.ai/v1/chat/completions. Ta ścieżka przyjmuje części tekstowe i obrazowe, ma limit wejścia 500,000 tokenów i udostępnia własne parametry żądania. Jej obecny schemat nie przyjmuje części plikowych ani PDF. Definicja narzędzia jest danymi wejściowymi dla modelu; pętlę wykonania musi zapewnić wywołujący.
| Decyzja | Wbudowany Grok w Cursorze | Bezpośredni Grok przez SpicyAPI |
|---|---|---|
| Identyfikator wyboru w danym interfejsie | grok-4.6 w dokumentacji Cursora | xai/grok-4.6 w żądaniu Chat Completions; endpoint katalogowy xai/grok-4.6/chat |
| Kto buduje i prowadzi przepływ kodowania? | Zintegrowany produkt Cursora | Twoja aplikacja lub zweryfikowany zgodny klient |
| Okno wejściowe | 256k tokenów | 500,000 tokenów |
| Edycje plików i testy | Cursor zarządza narzędziami agenta | Twój wywołujący wykonuje narzędzia i stosuje edycje |
Limit API 500,000 tokenów nie powiększa okna 256k w Cursorze. Przy poprawianiu kodu wyślij pliki definiujące problem, opis błędu i testy, a nie całe repozytorium.
Najpierw wypróbuj w Playground
- Otwórz Grok 4.6 i przełącz na Playground.
- W polu wiadomości wklej poniższe pytanie, wybierz opcję rozumowania Low i kliknij Run model:
> A delivery-window parser must accept a local time HH:MM from 00:00 through 23:59. The current function returns true for any string matching two digits, a colon and two digits. Explain which inputs it accepts incorrectly, and propose a small correction.
- Sprawdź, czy odpowiedź odrzuca 24:00 i 12:60. Jeśli tak, to samo pytanie jest gotowe do uruchomienia z API lub z edytora.
Użyj ścieżki wbudowanej, gdy właśnie tego potrzebujesz
- Otwórz selektor modeli i wybierz jawnie Grok 4.6, jeśli Twoje konto go oferuje. Gdy zależy Ci na tym konkretnym modelu, użyj jawnego wyboru zamiast Auto; sprawdź go ponownie w nowym czacie.
- Wybierz effort odpowiedni do zadania; udokumentowana wartość domyślna modelu to
high. Dostępny tylko w Indiach plan Start ustala Grok namediumbez trybu Fast. - Otwórz jednorazowy projekt parsera opisany niżej i poproś o poprawkę ograniczoną do
is-time.mjs. - Sprawdź zastosowany diff i rzeczywisty wynik testów. Poprawne wyjaśnienie bez zastosowanej edycji to inny rezultat niż ukończone zadanie agenta.
Wybór wbudowany nie wymaga base URL ani klucza SpicyAPI. Planując budżet, uwzględnij limit swojego bieżącego planu i ustawienie Fast; promocja wprowadzająca z artykułu o premierze już się skończyła.
Podłącz własny klucz albo wybierz bezpośrednie API
Pomoc o kluczach API Cursora opisuje Cursor Settings → Models → dostawca → klucz → Save dla OpenAI, Anthropic, Google, Azure i AWS Bedrock. Nie dokumentuje własnego endpointu dla Grok 4.6.
- Otwórz Cursor Settings → Models i poszukaj nadpisania base URL dla OpenAI oraz opcji dodania własnego modelu.
- Jeśli oba elementy są dostępne, wpisz
https://api.spicyapi.ai/v1jako base URL, swój klucz SpicyAPI jako klucz dostawcy ixai/grok-4.6jako własny model. Zapisz konfigurację. - Wybierz ten własny model w nowym czacie i wyślij małe pytanie o parser podane niżej. Zanim wyślesz większe zadanie, sprawdź, czy żądanie pojawia się w Twoich logach SpicyAPI.
- Jeśli tych elementów nie ma albo weryfikacja odrzuca model, użyj wbudowanego Grok dla agenta Cursora lub uruchom przykład z bezpośrednim API. Samo wklejenie klucza SpicyAPI w pole klucza dostawcy nie wystarczy.
Własne klucze obejmują czat, nie uzupełnianie Tab. Żądania BYOK nadal przechodzą przez backend Cursora, który buduje prompt, a obietnica zero retention Cursora ich nie obejmuje. Opłaty dostawcy i ewentualna opłata klienta w planie organizacji są osobne.
Trzymaj trzy identyfikatory osobno
| Wartość konfiguracji | Wartość bezpośredniego SpicyAPI | Zastosowanie |
|---|---|---|
| Base URL | https://api.spicyapi.ai/v1 | Dla klienta, który sam dopisuje /chat/completions |
| Pełny endpoint | https://api.spicyapi.ai/v1/chat/completions | Dla curl lub wywołującego, który wysyła pełny URL |
| Model w żądaniu | xai/grok-4.6 | Wartość w treści JSON |
| Zadanie katalogowe | xai/grok-4.6/chat | Pozycja na liście zadań modelu, a nie nazwa z wbudowanego selektora Cursora |
Trzymaj base URL i pełny endpoint osobno. Wstawienie pełnego endpointu do pola base może dać /chat/completions/chat/completions, gdy klient dopisze własną ścieżkę. Błąd „unknown model” oznacza, że trzeba sprawdzić wartość modelu; zmiana promptu lub effort nie naprawi celu.
Zacznij od bezpośredniego żądania z jednym celem
Najpierw wyślij jedno bezpośrednie żądanie, by sprawdzić klucz i model, zanim zaczniesz diagnozować IDE.
Ten przykład tworzy jedno płatne żądanie przeglądu kodu po uruchomieniu. Używa klucza z Twojego środowiska. max_tokens: 4000 ogranicza tylko widoczną odpowiedź; tokeny rozumowania są rozliczane jako wyjście i ten limit ich nie obejmuje. reasoning_effort: low zmniejsza nakład rozumowania, ale nie ustala sztywnego limitu wydatków.
: "${SPICY_API_KEY:?Set SPICY_API_KEY first}"
curl --no-buffer --fail-with-body --dump-header response-headers.txt \
  https://api.spicyapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "xai/grok-4.6",
    "messages": [
      {"role": "system", "content": "Review only the code shown. Explain the smallest correction and its acceptance cases. Do not claim that you executed anything."},
      {"role": "user", "content": "A delivery-window parser must accept a local time HH:MM from 00:00 through 23:59. The current function returns true for any string matching two digits, a colon and two digits. Explain which inputs it accepts incorrectly, and propose a small correction."}
    ],
    "reasoning_effort": "low",
    "max_tokens": 4000,
    "stream": true,
    "stream_options": {"include_usage": true}
  }'
Poprawkę odczytasz z fragmentów choices[].delta.content w strumieniu, a liczbę tokenów z ostatniego chunka usage; format strumienia opisuje dokumentacja.
Jeśli bezpośrednie wywołanie zawodzi, napraw najpierw jego klucz, model lub odrzucone pole, zanim dodasz IDE. Te błędy utrzymają się także we własnym kliencie.
Pozwól Agentowi przygotować wywołanie
Przy powtarzanych przeglądach kodu poproś swojego Agenta do kodowania o użycie SpicyAPI Skill: “Read xai/grok-4.6/chat, then adapt the example to my input; show the request before running it.” Sprawdzenie przez CLI to spicyapi models get xai/grok-4.6/chat --json; przez MCP to spicyapi_model_get z model: "xai/grok-4.6/chat". Wywołania czatu używają zgodnego klienta lub API czatu; polecenia zadań medialnych nie generują odpowiedzi czatu.
Zrób z przykładu kodowania test, który da się uruchomić
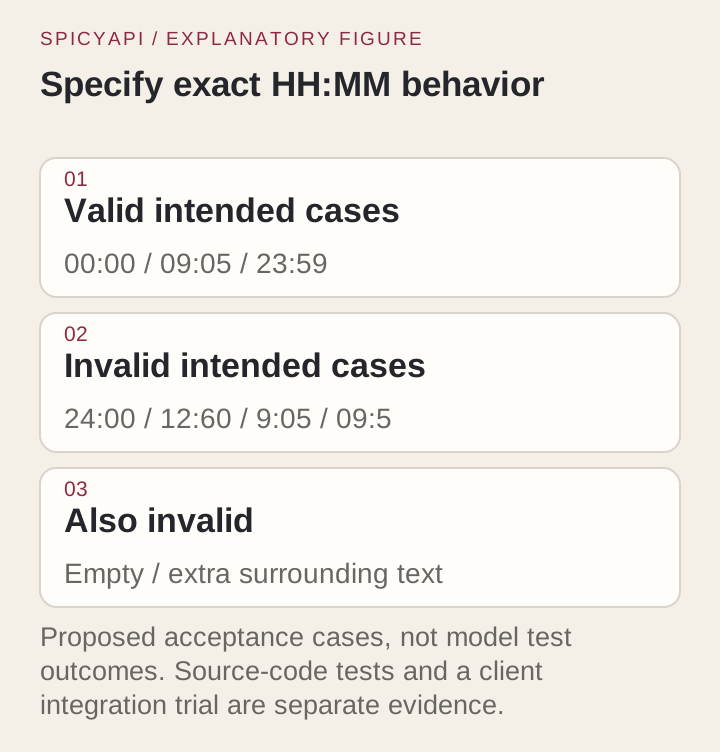
Wymaganie jest celowo wąskie: przyjmować dokładnie HH:MM, godziny 00–23 i minuty 00–59, bez otaczających spacji. Zacznij od tego błędnego is-time.mjs:
export function isTime(value) {
  return typeof value === 'string' && /^\d{2}:\d{2}$/.test(value);
}
Zapisz przypadki akceptacji jako is-time.test.mjs:
import assert from 'node:assert/strict';
import test from 'node:test';
import { isTime } from './is-time.mjs';

const cases = [
  ['00:00', true], ['09:05', true], ['23:59', true],
  ['24:00', false], ['12:60', false], ['99:99', false],
  ['9:05', false], ['09:5', false], ['', false],
  ['09:05x', false], [' 09:05 ', false], ['09:05\n', false],
  [null, false], [905, false],
];
for (const [value, expected] of cases) {
  test(JSON.stringify(value), () => assert.equal(isTime(value), expected));
}
Uruchom node --test is-time.test.mjs. Początkowa funkcja nie przechodzi trzech przypadków: przyjmuje 24:00, 12:60 i 99:99. Zachowaj przypadki ze spacjami, końcowym znakiem nowej linii i wartościami niebędącymi tekstem, aby późniejsza poprawka nie poszerzyła formatu. Poproś agenta do kodowania:
Correct only is-time.mjs to satisfy the supplied tests. Preserve exactly two digits, reject surrounding whitespace, and return false for non-string input. Do not add a date library or change the tests. Run the tests if your tools permit, and report the actual result.
Jedno z możliwych rozwiązań:
export function isTime(value) {
  if (typeof value !== 'string' || value.length !== 5) return false;
  return /^(?:[01]\d|2[0-3]):[0-5]\d$/.test(value);
}
Sprawdzenie zakresu odrzuca godziny i minuty spoza zakresu; sprawdzenie typu i długości jawnie utrzymuje format pięciu znaków. To rozwiązanie przechodzi wszystkie czternaście przypadków. Poproś agenta o jego własną poprawkę, uruchom te same testy na tej łatce i przeczytaj diff: poprawka jednej funkcji nie powinna ruszać konfiguracji, formatowania w innych miejscach ani zależności i nie powinna dodawać biblioteki dat dla godziny z pięciu znaków.
Najpierw sprawdź ścieżkę czystego tekstu we własnym kliencie
Wyślij to samo pytanie o parser przez własnego klienta. Jeśli u dostawcy nie pojawia się żadne zadanie, sprawdź wybrany model i cel żądania; klient może nadal używać wbudowanej ścieżki albo zawodzić, zanim cokolwiek wyśle.
Gdy czysty tekst działa, dodaj streaming, a potem narzędzia, nie zmieniając pozostałych ustawień.
Używaj streamingu przy długim rozumowaniu
Używaj stream: true przy effort high lub xhigh i dla długich wyników (przykład już to robi); odpowiedź bez streamingu, która trwa dłużej niż około 100 sekund, może zostać przerwana, a przerwane żądanie, które nie zwróciło odpowiedzi, nie jest rozliczane. Normalna odpowiedź końcowa kończy się finish_reason: stop; tool_calls oznacza, że Twoja aplikacja ma kolejny krok, a length oznacza, że odpowiedź została ucięta, nawet jeśli kod wygląda wiarygodnie. Jeśli bezpośredni strumień się kończy, ale IDE się zawiesza, sprawdź obsługę zdarzeń w IDE, zanim zmienisz model. Szczegóły: dokumentacja tekstu i streamingu.
Obsługa narzędzi wymaga wywołującego, który je wykonuje
API przyjmuje do 128 tools, tool_choice i parallel_tool_calls (wartość logiczna, domyślnie true). Implementacje narzędzi musi dostarczyć Twoja aplikacja.
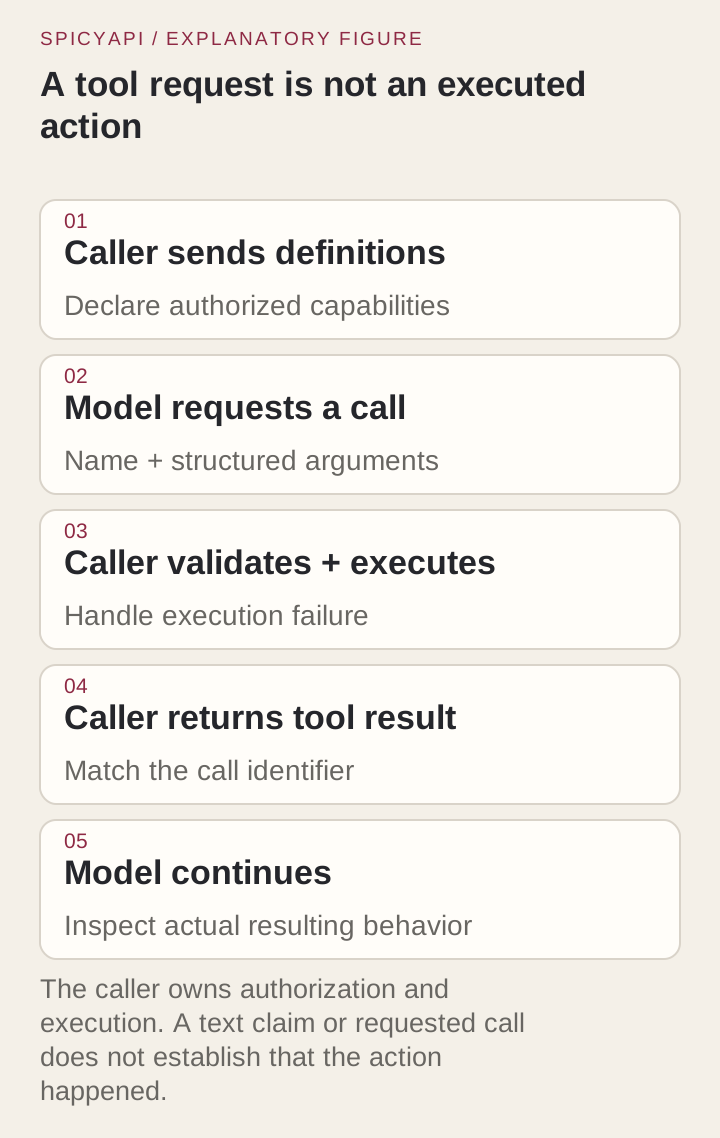
Pętla narzędzi musi zwalidować żądane argumenty, wykonać dozwoloną operację, dołączyć jej rzeczywisty wynik jako wiadomość narzędzia i ponownie wywołać model. Sama odpowiedź tekstowa nie może zastosować łatki ani uruchomić Node.
Na przykład po tym, jak asystent zażąda niegroźnej funkcji get_acceptance_cases, wywołujący zwraca jej rzeczywisty wynik z pasującym ID:
[
  {"role":"assistant","content":null,"tool_calls":[{"id":"call_example","type":"function","function":{"name":"get_acceptance_cases","arguments":"{}"}}]},
  {"role":"tool","tool_call_id":"call_example","content":"00:00 pass; 23:59 pass; 24:00 fail; 12:60 fail; surrounding whitespace fail"}
]
Dołącz rzeczywistą wiadomość asystenta i wynik narzędzia do oryginalnej rozmowy; powyższy JSON pokazuje ich kształt. Zwaliduj nazwę funkcji i argumenty przed wykonaniem oraz ogranicz zakres plików, liczbę tur narzędzi i wydatki.
W tym przykładzie niech pierwsze narzędzie zwraca przypadki akceptacji. Potem dodaj narzędzie edycji pliku ograniczone do is-time.mjs i polecenie testowe ograniczone do node --test is-time.test.mjs.
Dopasuj każdy wynik narzędzia do jego tool_call_id, nawet gdy wyniki przychodzą w innej kolejności. Przy tym zadaniu na jednym pliku parallel_tool_calls: false może uprościć Twój własny harness.
Jeśli czat działa, ale narzędzia zawodzą we własnym kliencie, sprawdź odrzucone pole lub schemat narzędzia, zanim zmienisz model.
Ogranicz kontekst repozytorium do tego, co dotyczy poprawki
Parser potrzebuje swojej funkcji, specyfikacji i testów, a nie całej aplikacji. Przy prawdziwym błędzie dołącz opis awarii, pliki definiujące problem i dotknięte miejsca wywołań. Poproś o brakujące informacje, zanim zaakceptujesz szeroki refaktoring.
Ścieżka bezpośrednia przyjmuje do 256 wiadomości; tokeny i liczba wiadomości to osobne limity. Wcześniejsze odpowiedzi, wyniki narzędzi i obrazy też zajmują kontekst. W długich sesjach zachowaj aktualny kod źródłowy i rzeczywisty wynik testów obok zwięzłego podsumowania decyzji. Własne IDE może streszczać lub pomijać wybrane pliki, więc większe okno API nie naprawi kontekstu, którego klient nigdy nie wysłał.
Traktuj obrazy i pliki jako różne możliwości
Ścieżka hostowana przyjmuje części tekstowe i image_url; nie przyjmuje części PDF ani plikowych. Przy wizualnym błędzie interfejsu połącz zrzut ekranu dostępny pod adresem URL ze specyfikacją. Na przykład ekran pokazujący 24:00 może zilustrować stan nieprawidłowego wejścia parsera. Sam tekstowy przykład nie wymaga obrazu.
Dla specyfikacji w PDF wyodrębnij istotny tekst lokalnie i sprawdź kolejność tabel oraz przypisy, zanim go wyślesz. To przepływ z wyodrębnianiem, a nie natywne wejście PDF. Jeśli własne IDE nie potrafi przekazać obrazu albo dodaje nieobsługiwane pole pliku, użyj obsługiwanego żądania bezpośredniego lub jego odpowiednika tekstowego.
Dobierz effort i limity wyjścia do pracy
Bezpośrednie API przyjmuje low, medium, high i xhigh; domyślna to high, a none nie jest akceptowane. Do małego żądania o parser użyj jawnie low. Podnieś effort przy trudniejszej poprawce, gdy niższe ustawienie nie spełnia jej przypadków akceptacji.
Jeśli IDE ukrywa sterowanie effort, jego wybrany tryb może różnić się od Twojego żądania bezpośredniego. Porównuj rzeczywistą łatkę i zużycie, a nie pozorną dokładność wyjaśnienia.
max_tokens domyślnie wynosi 4,096 i przyjmuje do 450,000 tokenów widocznej odpowiedzi. Dla łatki jednej funkcji utrzymuj małą wartość. Rozumowanie może sprawić, że rozliczane wyjście będzie wielokrotnie dłuższe niż ta łatka, zwłaszcza przy domyślnym effort high. Do rutynowych poprawek używaj niższego effort, planuj budżet na podstawie usage i ustaw dzienne oraz łączne limity wydatków dla klucza API, a także dzienne i miesięczne budżety workspace dla pętli agentów; ten endpoint Chat Completions nie ma limitu wyceny na wywołanie.
Zostaw temperature i top-p przy wartościach domyślnych, gdy porównujesz ustawienia effort.
Czytaj ceny tokenów z zachowaniem kategorii rozliczeniowych
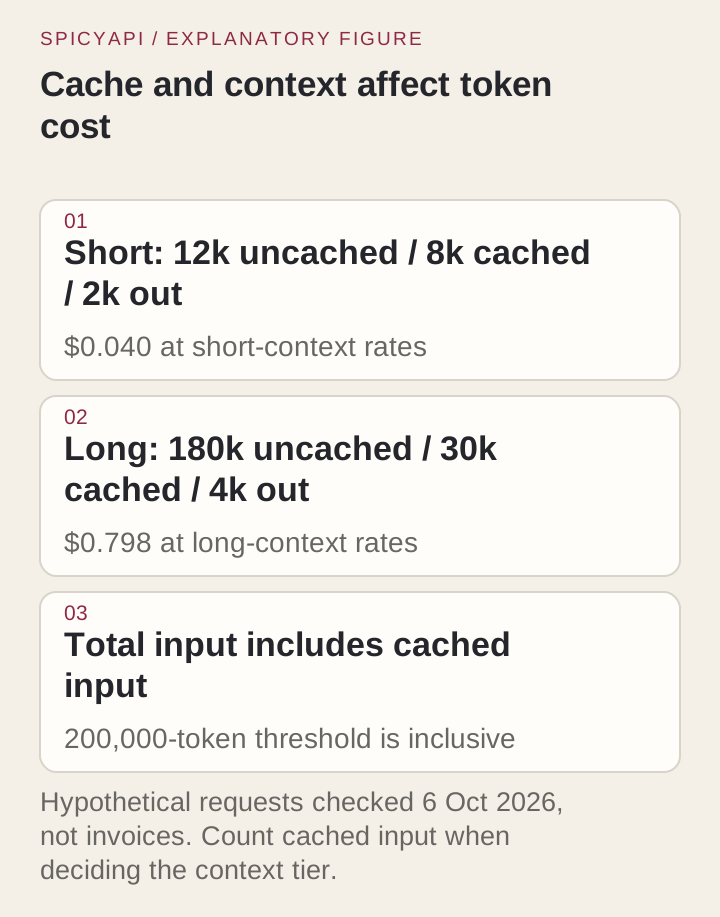
Stawki SpicyAPI to $2.00 za wejście bez cache, $0.50 za wejście z cache i $6.00 za wyjście na milion tokenów. Przy 200,000 tokenów wejścia łącznie lub więcej, wliczając wejście z cache, całe żądanie jest rozliczane odpowiednio po $4.00, $1.00 i $12.00. To ceny katalogowe dla klienta, a nie zapis nowej opłaty klienta.
Dla hipotetycznego bezpośredniego żądania z 12,000 tokenów wejścia bez cache, 8,000 tokenów wejścia z cache i 2,000 rozliczanych tokenów wyjścia rachunek katalogowy wygląda tak:
Uncached input: 12,000 / 1,000,000 × $2.00 = $0.0240
Cached input:    8,000 / 1,000,000 × $0.50 = $0.0040
Output:         2,000 / 1,000,000 × $6.00 = $0.0120
Total: $0.0400
Całkowite wejście w tym przykładzie to 20,000, a nie 12,000. Jeśli pole usage podaje całkowite wejście i podzbiór z cache, nie rozliczaj tokenów z cache dwa razy: odejmij podzbiór z cache, aby otrzymać wejście bez cache. Przy uzgadnianiu prawdziwego żądania używaj rzeczywistych kategorii z odpowiedzi i zapisu platformy.
Przykład z długim kontekstem, 180,000 wejścia bez cache, 30,000 wejścia z cache i 4,000 rozliczanego wyjścia, daje łącznie 210,000 wejścia. Rachunek to $0.720 + $0.030 + $0.048 = $0.798 według stawek long. Próg dotyczy pełnych kategorii żądania, a nie tylko części powyżej 200,000. Ograniczenie zbędnego kontekstu może więc zmienić zarówno liczbę tokenów, jak i obowiązujący przedział.
To założone liczby tokenów. Planuj budżet bez oszczędności z cache, dopóki usage nie zgłosi trafienia; rozliczenie opiera się na zmierzonym zużyciu, w tym na wyjściu rozumowania.
Ostrożnie porównuj cenę w Cursorze z ceną bezpośrednią
Strona Models and Pricing Cursora podaje dla Grok 4.6 stawki standardowe $2 za wejście, $0.50 za wejście z cache i $6 za wyjście na milion tokenów; stawki Fast to $4, $1 i $12. Fast jest domyślnie włączony w kwalifikujących się planach Pro, więc sprawdź selektor, zanim zaczniesz długie zadanie. Wbudowany Grok czerpie z puli Models Cursora i limitu Twojego planu. Limity subskrypcji, wybór szybkości i warunki konkretnego konta wpływają na to, ile płaci użytkownik; podane stawki nie są prognozą miesięcznego rachunku.
Dla tych samych 12,000 tokenów wejścia bez cache, 8,000 z cache i 2,000 wyjścia Cursor standard daje łącznie $0.040, Fast $0.080, a bezpośrednie API $0.040, czyli tyle samo co Cursor standard przy tych podanych stawkach. Te obliczenia porównują deklarowane stawki za token przy sztucznie równym zużyciu; nie pokazują, że oba produkty wykonują tę samą pracę. Rzeczywiste sesje agenta mogą zużywać inne liczby tokenów.
Zintegrowany agent może wykonać kilka wywołań, by odczytać pliki, zastosować łatkę i ponownie uruchomić testy. Porównuj łączny koszt ukończonej poprawki, a nie jedną stawkę za token.
Pomoc o kluczach API Cursora podaje dodatkowe $0.25 za milion tokenów dla BYOK w Teams i Enterprise, przy czym wejście, wyjście i wejście z cache liczone jest raz. Przykład z 22,000 tokenów dodaje $0.0055 do opłaty dostawcy. Indywidualny BYOK nie ma takiej opłaty za tokeny w planie organizacji; opłata nie dowodzi obsługi konkretnego własnego modelu.
Przy pierwszym zadaniu zapisz łączny koszt i to, czy zastosowana poprawka przechodzi swoje testy.
„Other Models” w widoku zużycia Cursora to pula rozliczeniowa, a nie dowód, że żądanie poszło do zewnętrznego dostawcy. Aby rozpoznać wywołanie bezpośrednie, użyj zapisu zadania u dostawcy.
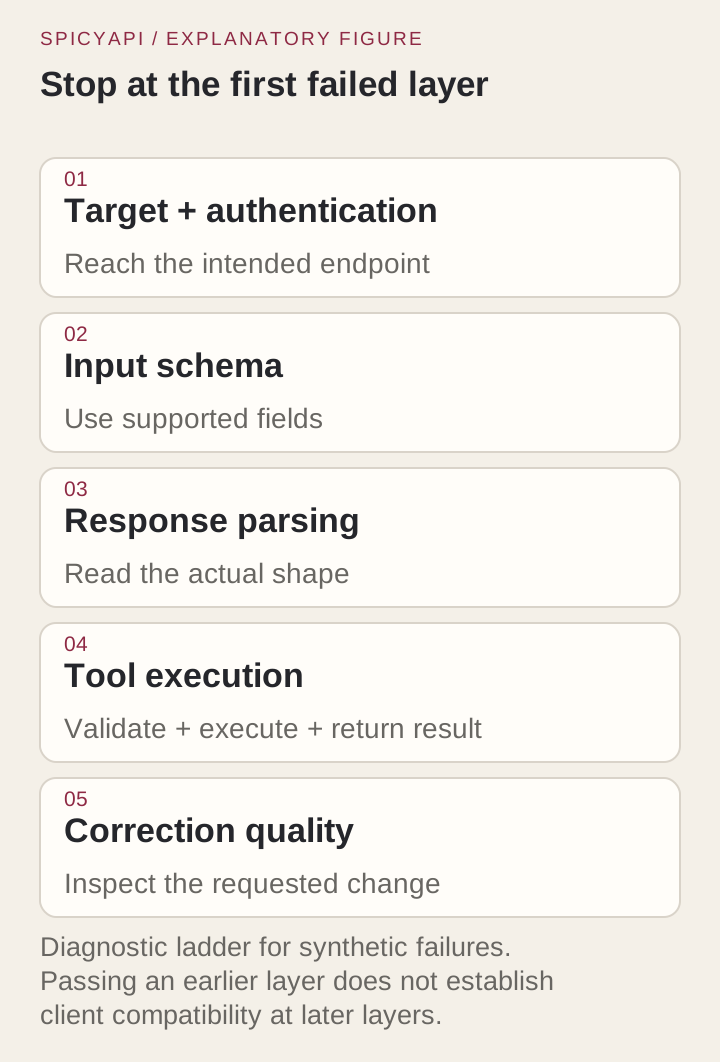
Diagnozuj błędy w kolejności, w jakiej stają się widoczne
- Cel lub klucz: sprawdź błąd 401, nieznany model lub zduplikowaną ścieżkę, zanim zmienisz effort.
- Odrzucone pole: usuń nieobsługiwane parametry lub części treści, a potem dodawaj możliwości po jednej.
- Pusty lub zawieszony interfejs: porównaj odpowiedź bezpośrednią z parserem klienta, powodem zakończenia i znacznikiem końca.
- Brak wykonania narzędzi: sprawdź dispatch narzędzi po stronie wywołującego i uprawnienia.
- Błędna łatka: sprawdź nieudany przypadek akceptacji i faktycznie zmienione pliki.
Niech następna zmiana dotyczy warstwy, która zawiodła; dłuższy prompt nie naprawi odrzuconego parametru.
Drugi przykład ujawni błędy w rozmowie
Gdy ścisły parser przechodzi, zmień jedno wymaganie: dopuść spacje na początku i na końcu, ale zachowaj dwucyfrowe składniki czasu. Nowe przypadki odróżniają 09:05 , które teraz ma przejść, od 9:05, które nadal ma się nie powieść. Zastosuj trim() po sprawdzeniu typu i przed istniejącym sprawdzeniem długości i zakresu; testy obu wersji trzymaj osobno.
Wyślij poprawiony kod źródłowy i zmienione wymaganie w następnej turze: ID żądania nie zapewnia pamięci rozmowy. Jeśli nowa łatka przyjmuje 9:05 albo edytuje starą funkcję, testy następcze ujawnią ten błąd.
Wybierz ścieżkę zgodną z dowodami, których potrzebujesz
Wybierz wbudowany Cursor do zintegrowanych edycji i uruchamiania testów. Wybierz bezpośrednie API dla własnej pętli narzędzi i kontroli zużycia. Konfiguracji z własnym kluczem używaj do czatu, gdy jej sprawdzenie połączenia się powiedzie; wbudowany Cursor pozostaje prostym wyborem dla zintegrowanych edycji plików i testów.
W tym parserze ogranicz poprawkę do funkcji i uruchom wszystkie czternaście testów na zastosowanej łatce.





