
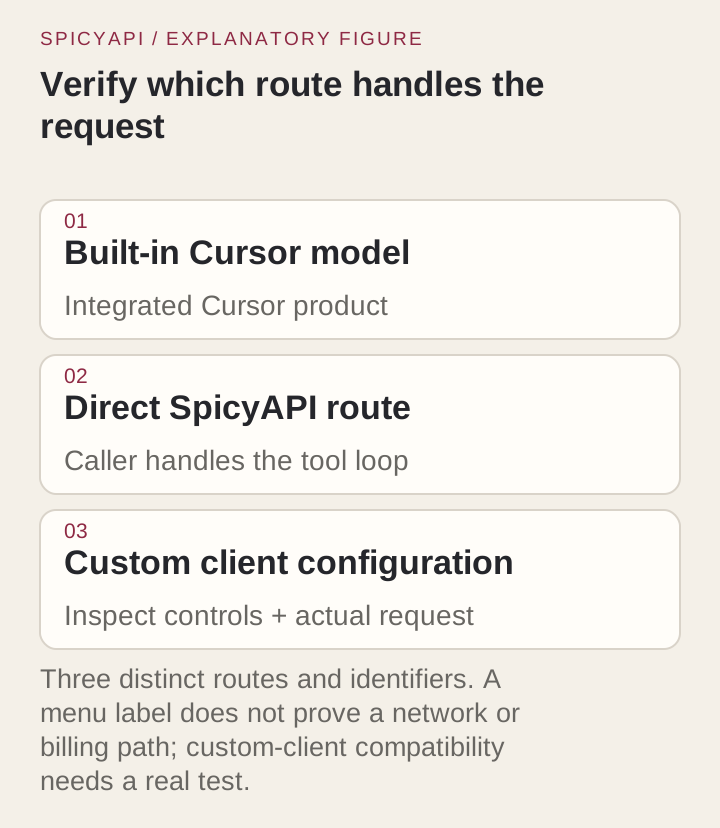
Sie möchten, dass Grok Code in Cursor repariert, doch eine integrierte Modellauswahl und ein auf eine externe API gerichteter Schlüssel sind zwei verschiedene Setups. Nutzen Sie das in Cursor integrierte Grok 4.6 für die dokumentierte Agent-Integration, oder rufen Sie SpicyAPI direkt auf, wenn Ihre Anwendung Anfragen, Tools und Nutzung selbst steuern soll. Für einen SpicyAPI-Schlüssel in Cursor öffnen Sie Cursor Settings → Models und prüfen, ob es eine benutzerdefinierte Base-URL-Überschreibung gibt. Mit den folgenden Einrichtungswerten und dem Fallback entscheiden Sie sich für den richtigen Weg, bevor Sie Guthaben kaufen.
Zwei Grok-Wege mit unterschiedlichen Verträgen
Cursors Dokumentation zu Grok 4.6 nennt grok-4.6, ein Kontextfenster von 256k und vier Effort-Stufen: low, medium, high und xhigh, wobei high der Standard ist. Die integrierte Anbindung hat Zugriff auf die Agent-Tools von Cursor.
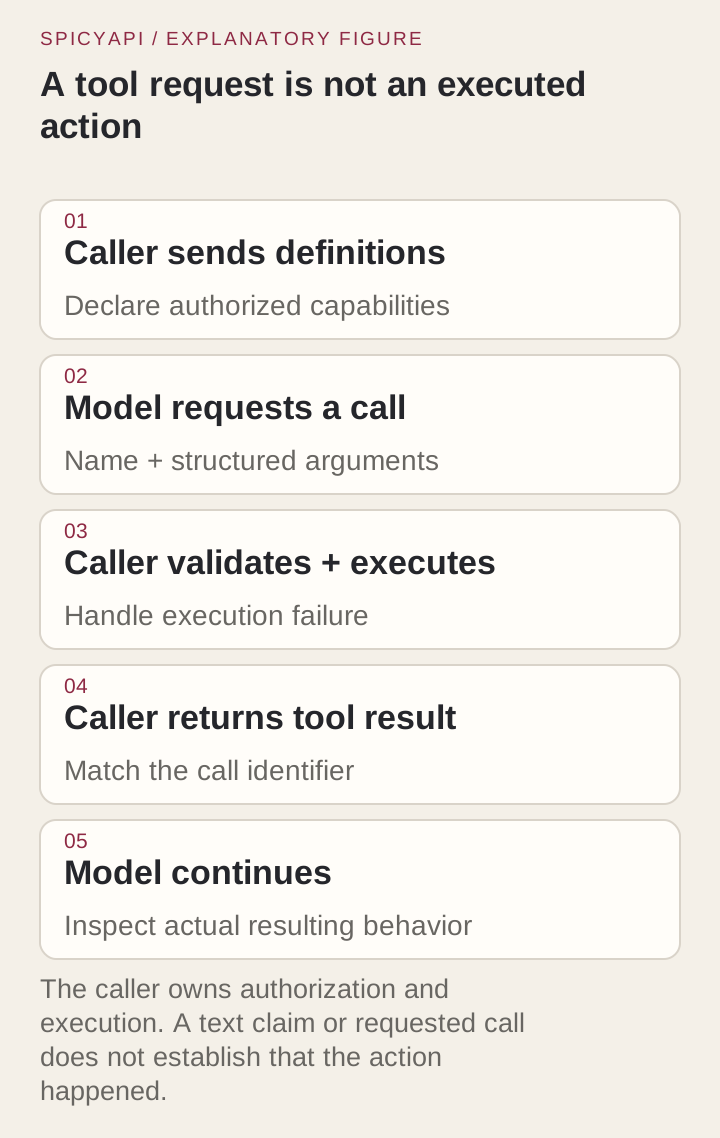
Die SpicyAPI-Modellseite führt xai/grok-4.6/chat. Der dokumentierte, OpenAI-kompatible Modellname für Chat-Completions-Anfragen lautet xai/grok-4.6 und wird an https://api.spicyapi.ai/v1/chat/completions gesendet. Diese Route akzeptiert Text- und Bildteile, hat ein Eingabelimit von 500,000 Tokens und bietet eigene Anfrageparameter. Das aktuelle Schema akzeptiert keine Datei- oder PDF-Teile. Eine Tool-Definition ist eine Eingabe für das Modell; die Ausführungsschleife muss der Aufrufer bereitstellen.
| Entscheidung | Integriertes Cursor-Grok | Direktes SpicyAPI-Grok |
|---|---|---|
| Auswahlkennung in der jeweiligen Oberfläche | grok-4.6 in Cursors Dokumentation | xai/grok-4.6 in einer Chat-Completions-Anfrage; Katalog-Endpunkt xai/grok-4.6/chat |
| Wer baut den Coding-Workflow auf und steuert ihn? | Cursors integriertes Produkt | Ihre Anwendung oder ein geprüfter kompatibler Client |
| Eingabefenster | 256k Tokens | 500,000 Tokens |
| Dateiänderungen und Tests | Cursor steuert die Agent-Tools | Ihr Aufrufer führt Tools aus und wendet Änderungen an |
Das API-Limit von 500,000 Tokens vergrößert Cursors 256k-Fenster nicht. Senden Sie für eine Code-Korrektur die maßgeblichen Dateien, den Fehler und die Tests statt des gesamten Repositorys.
Zuerst im Playground ausprobieren
- Öffnen Sie Grok 4.6 und wechseln Sie zum Playground.
- Fügen Sie im Nachrichtenfeld die folgende Frage ein, wählen Sie die Reasoning-Option Low und klicken Sie auf Run model:
> A delivery-window parser must accept a local time HH:MM from 00:00 through 23:59. The current function returns true for any string matching two digits, a colon and two digits. Explain which inputs it accepts incorrectly, and propose a small correction.
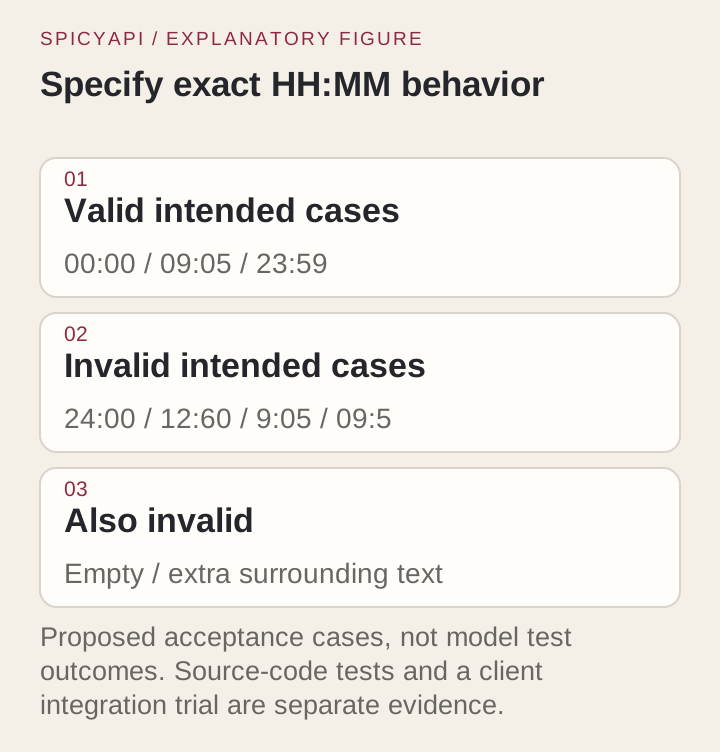
- Prüfen Sie, ob die Antwort 24:00 und 12:60 ablehnt. Falls ja, ist dieselbe Frage bereit für die API oder Ihren Editor.
Den integrierten Weg nutzen, wenn das die Aufgabe ist
- Öffnen Sie die Modellauswahl und wählen Sie ausdrücklich Grok 4.6, falls Ihr Konto es anbietet. Verwenden Sie eine explizite Auswahl statt Auto, wenn Sie genau dieses Modell möchten; prüfen Sie sie in einem neuen Chat erneut.
- Wählen Sie den Effort passend zur Aufgabe; der dokumentierte Modellstandard ist
high. Der nur in Indien verfügbare Start-Tarif legt Grok ohne Fast-Modus aufmediumfest. - Öffnen Sie das unten beschriebene Wegwerf-Parser-Projekt und bitten Sie um eine Korrektur, die auf
is-time.mjsbeschränkt ist. - Prüfen Sie den angewendeten Diff und das tatsächliche Testergebnis. Eine korrekte Erklärung ohne angewendete Änderung ist ein anderes Ergebnis als eine abgeschlossene Agent-Aufgabe.
Die integrierte Auswahl benötigt weder eine SpicyAPI-Base-URL noch einen Schlüssel. Planen Sie mit dem Kontingent Ihres aktuellen Tarifs und der Fast-Einstellung; die Einführungsaktion im Launch-Artikel ist beendet.
Eigenen Schlüssel verbinden oder die direkte API wählen
Cursors Hilfe zu API-Schlüsseln dokumentiert Cursor Settings → Models → Anbieter → Schlüssel → Save für OpenAI, Anthropic, Google, Azure und AWS Bedrock. Einen benutzerdefinierten Endpunkt für Grok 4.6 dokumentiert sie nicht.
- Öffnen Sie Cursor Settings → Models und suchen Sie nach einer OpenAI-Base-URL-Überschreibung und einer Option zum Hinzufügen eines benutzerdefinierten Modells.
- Sind beide Steuerelemente vorhanden, tragen Sie
https://api.spicyapi.ai/v1als Base-URL, Ihren SpicyAPI-Schlüssel als Anbieterschlüssel undxai/grok-4.6als benutzerdefiniertes Modell ein. Speichern Sie die Konfiguration. - Wählen Sie dieses benutzerdefinierte Modell in einem neuen Chat aus und senden Sie die kleine Parser-Frage unten. Prüfen Sie, ob die Anfrage in Ihren SpicyAPI-Logs erscheint, bevor Sie eine größere Aufgabe senden.
- Fehlen die Steuerelemente oder lehnt die Verifizierung das Modell ab, verwenden Sie das integrierte Grok für Cursors Agent oder führen Sie das Beispiel für die direkte API aus. Einen SpicyAPI-Schlüssel nur in ein Anbieterschlüssel-Feld einzufügen, genügt nicht.
Eigene Schlüssel gelten für den Chat, nicht für die Tab-Vervollständigung. BYOK-Anfragen laufen weiterhin über Cursors Backend, das den Prompt zusammenstellt, und Cursors Zero-Retention-Zusage gilt für sie nicht. Anbietergebühren und eine eventuelle Client-Gebühr des Organisationstarifs kommen separat hinzu.
Die drei Kennungen auseinanderhalten
| Konfigurationswert | Direkter SpicyAPI-Wert | Verwendung |
|---|---|---|
| Base-URL | https://api.spicyapi.ai/v1 | Für einen Client, der /chat/completions selbst anhängt |
| Vollständiger Endpunkt | https://api.spicyapi.ai/v1/chat/completions | Für curl oder einen Aufrufer, der die komplette URL sendet |
| Anfragemodell | xai/grok-4.6 | Wert im JSON-Body |
| Katalog-Task | xai/grok-4.6/chat | Der Eintrag der Modell-Tasks, nicht der Auswahlname im integrierten Cursor-Picker |
Halten Sie Base-URL und vollständigen Endpunkt getrennt. Wenn Sie den vollständigen Endpunkt in ein Base-Feld eintragen, kann /chat/completions/chat/completions entstehen, falls der Client seinen eigenen Pfad anhängt. Ein „unknown model“-Fehler verlangt, den Modellwert zu prüfen; ein anderer Prompt oder Effort repariert das Ziel nicht.
Mit einer direkten Anfrage mit nur einem Zweck beginnen
Senden Sie zuerst eine direkte Anfrage, um Schlüssel und Modell zu prüfen, bevor Sie die IDE untersuchen.
Dieses Beispiel erzeugt beim Ausführen eine kostenpflichtige Code-Review-Anfrage. Es verwendet den Schlüssel aus Ihrer Umgebung. max_tokens: 4000 begrenzt nur die sichtbare Antwort; Reasoning-Tokens werden als Output berechnet und von diesem Limit nicht erfasst. reasoning_effort: low verringert den Reasoning-Aufwand, setzt aber keine feste Kostenobergrenze.
: "${SPICY_API_KEY:?Set SPICY_API_KEY first}"
curl --no-buffer --fail-with-body --dump-header response-headers.txt \
  https://api.spicyapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "xai/grok-4.6",
    "messages": [
      {"role": "system", "content": "Review only the code shown. Explain the smallest correction and its acceptance cases. Do not claim that you executed anything."},
      {"role": "user", "content": "A delivery-window parser must accept a local time HH:MM from 00:00 through 23:59. The current function returns true for any string matching two digits, a colon and two digits. Explain which inputs it accepts incorrectly, and propose a small correction."}
    ],
    "reasoning_effort": "low",
    "max_tokens": 4000,
    "stream": true,
    "stream_options": {"include_usage": true}
  }'
Lesen Sie die Korrektur aus den choices[].delta.content-Teilen des Streams und die Token-Zahlen aus dem letzten usage-Chunk; das Streamformat beschreibt die Dokumentation.
Schlägt der direkte Aufruf fehl, beheben Sie zuerst Schlüssel, Modell oder das abgelehnte Feld, bevor Sie die IDE hinzunehmen. Diese Fehler bleiben auch in einem benutzerdefinierten Client bestehen.
Einen Agent den Aufruf vorbereiten lassen
Für wiederholte Code-Reviews bitten Sie Ihren Coding-Agent, den SpicyAPI Skill zu verwenden: “Read xai/grok-4.6/chat, then adapt the example to my input; show the request before running it.” Die CLI-Abfrage lautet spicyapi models get xai/grok-4.6/chat --json; die MCP-Abfrage ist spicyapi_model_get mit model: "xai/grok-4.6/chat". Chat-Aufrufe nutzen einen kompatiblen Client oder die Chat-API; die Media-Task-Befehle erzeugen keine Chat-Antworten.
Das Coding-Beispiel ausführbar machen
Die Anforderung ist bewusst eng gefasst: genau HH:MM akzeptieren, Stunden 00–23 und Minuten 00–59, ohne umgebende Leerzeichen. Beginnen Sie mit dieser fehlerhaften is-time.mjs:
export function isTime(value) {
  return typeof value === 'string' && /^\d{2}:\d{2}$/.test(value);
}
Speichern Sie die Akzeptanzfälle als is-time.test.mjs:
import assert from 'node:assert/strict';
import test from 'node:test';
import { isTime } from './is-time.mjs';

const cases = [
  ['00:00', true], ['09:05', true], ['23:59', true],
  ['24:00', false], ['12:60', false], ['99:99', false],
  ['9:05', false], ['09:5', false], ['', false],
  ['09:05x', false], [' 09:05 ', false], ['09:05\n', false],
  [null, false], [905, false],
];
for (const [value, expected] of cases) {
  test(JSON.stringify(value), () => assert.equal(isTime(value), expected));
}
Führen Sie node --test is-time.test.mjs aus. Die ursprüngliche Funktion scheitert an drei Fällen: Sie akzeptiert 24:00, 12:60 und 99:99. Behalten Sie die Fälle für Leerzeichen, abschließenden Zeilenumbruch und Nicht-Strings bei, damit eine spätere Korrektur das Format nicht aufweicht. Bitten Sie den Coding-Agent:
Correct only is-time.mjs to satisfy the supplied tests. Preserve exactly two digits, reject surrounding whitespace, and return false for non-string input. Do not add a date library or change the tests. Run the tests if your tools permit, and report the actual result.
Eine mögliche Lösung:
export function isTime(value) {
  if (typeof value !== 'string' || value.length !== 5) return false;
  return /^(?:[01]\d|2[0-3]):[0-5]\d$/.test(value);
}
Die Bereichsprüfung weist Stunden und Minuten außerhalb des Bereichs zurück; die Typ- und Längenprüfung hält das Fünf-Zeichen-Format explizit. Diese Lösung besteht alle vierzehn Fälle. Lassen Sie den Agent seine eigene Korrektur erzeugen, führen Sie dieselben Tests auf diesem Patch aus und lesen Sie den Diff: Eine Ein-Funktions-Korrektur sollte weder Konfiguration noch Formatierung an anderer Stelle oder Abhängigkeiten anfassen und für eine Uhrzeit aus fünf Zeichen keine Datumsbibliothek hinzufügen.
Zuerst den Nur-Text-Pfad eines benutzerdefinierten Clients prüfen
Senden Sie dieselbe Parser-Frage über den benutzerdefinierten Client. Erscheint kein Anbieter-Task, prüfen Sie das gewählte Modell und das Anfrageziel; der Client nutzt möglicherweise weiterhin seine integrierte Route oder scheitert, bevor er etwas sendet.
Sobald reiner Text funktioniert, fügen Sie Streaming und danach Tools hinzu, ohne die übrigen Einstellungen zu ändern.
Streaming für langes Reasoning nutzen
Verwenden Sie stream: true für high- oder xhigh-Effort und lange Ausgaben (das Beispiel tut das bereits); eine nicht gestreamte Antwort, die länger als etwa 100 Sekunden braucht, kann abgebrochen werden, und eine abgebrochene Anfrage ohne Antwort wird nicht berechnet. Eine normale Endantwort endet mit finish_reason: stop; tool_calls bedeutet, dass Ihre App den nächsten Schritt ausführen muss, und length bedeutet, dass die Antwort abgeschnitten wurde, auch wenn der Code plausibel aussieht. Schließt ein direkter Stream ab, die IDE hängt aber, prüfen Sie die Event-Verarbeitung der IDE, bevor Sie das Modell wechseln. Details: Dokumentation zu Text und Streaming.
Tool-Unterstützung braucht einen Aufrufer, der Tools ausführt
Die API akzeptiert bis zu 128 tools, tool_choice und parallel_tool_calls (Boolean, Standard true). Die Tool-Implementierungen muss Ihre Anwendung liefern.
Eine Tool-Schleife muss die angeforderten Argumente validieren, eine erlaubte Operation ausführen, ihr tatsächliches Ergebnis als Tool-Nachricht anhängen und das Modell erneut aufrufen. Eine reine Textantwort kann weder den Patch anwenden noch Node ausführen.
Beispiel: Nachdem der Assistant eine harmlose Funktion get_acceptance_cases angefordert hat, liefert der Aufrufer ihr tatsächliches Ergebnis mit der passenden ID zurück:
[
  {"role":"assistant","content":null,"tool_calls":[{"id":"call_example","type":"function","function":{"name":"get_acceptance_cases","arguments":"{}"}}]},
  {"role":"tool","tool_call_id":"call_example","content":"00:00 pass; 23:59 pass; 24:00 fail; 12:60 fail; surrounding whitespace fail"}
]
Hängen Sie die tatsächliche Assistant-Nachricht und das Tool-Ergebnis an die ursprüngliche Unterhaltung an; das JSON oben zeigt nur ihre Form. Validieren Sie Funktionsnamen und Argumente vor dem Dispatch und begrenzen Sie Dateiumfang, Tool-Runden und Ausgaben.
Lassen Sie für dieses Beispiel das erste Tool die Akzeptanzfälle zurückgeben. Fügen Sie danach ein Datei-Edit-Tool hinzu, das auf is-time.mjs beschränkt ist, und einen Testbefehl, der auf node --test is-time.test.mjs beschränkt ist.
Ordnen Sie jedes Tool-Ergebnis seiner tool_call_id zu, auch wenn Ergebnisse in anderer Reihenfolge eintreffen. Für diese Ein-Datei-Aufgabe kann parallel_tool_calls: false Ihr eigenes Harness vereinfachen.
Funktioniert der Chat, aber Tools scheitern in einem benutzerdefinierten Client, untersuchen Sie das abgelehnte Feld oder das Tool-Schema, bevor Sie das Modell ändern.
Repository-Kontext auf die Korrektur beschränken
Der Parser braucht seine Funktion, die Spezifikation und die Tests, nicht eine ganze Anwendung. Nehmen Sie bei einem echten Fehler den Fehlerbericht, die maßgeblichen Dateien und die betroffenen Aufrufstellen auf. Fragen Sie nach fehlenden Informationen, bevor Sie ein breites Refactoring akzeptieren.
Die direkte Route akzeptiert bis zu 256 Nachrichten; Tokens und Nachrichtenanzahl sind getrennte Limits. Auch frühere Antworten, Tool-Ergebnisse und Bilder belegen Kontext. Bewahren Sie in langen Sitzungen den aktuellen Quellcode und das tatsächliche Testergebnis zusammen mit einer knappen Zusammenfassung der Entscheidungen auf. Eine benutzerdefinierte IDE kann ausgewählte Dateien zusammenfassen oder weglassen, sodass ein größeres API-Fenster Kontext nicht ersetzen kann, den der Client nie gesendet hat.
Bild- und Dateieingaben als verschiedene Fähigkeiten behandeln
Die gehostete Route akzeptiert Text- und image_url-Teile; PDF- oder Datei-Teile akzeptiert sie nicht. Kombinieren Sie bei einem visuellen UI-Fehler einen abrufbaren Screenshot mit der Spezifikation. Ein Bildschirm, der 24:00 zeigt, kann zum Beispiel den ungültigen Eingabezustand des Parsers veranschaulichen. Das Text-Beispiel selbst braucht kein Bild.
Extrahieren Sie für eine PDF-Spezifikation den relevanten Text lokal und prüfen Sie Tabellenreihenfolge und Fußnoten, bevor Sie ihn senden. Das ist ein Extraktions-Workflow, keine native PDF-Eingabe. Kann eine benutzerdefinierte IDE kein Bild weiterleiten oder fügt sie ein nicht unterstütztes Dateifeld hinzu, nutzen Sie die unterstützte direkte Anfrage oder ihr Text-Äquivalent.
Effort und Ausgabelimits an die Arbeit anpassen
Die direkte API akzeptiert low, medium, high und xhigh; der Standard ist high, und none wird nicht akzeptiert. Verwenden Sie für die kleine Parser-Anfrage ausdrücklich low. Erhöhen Sie den Effort für eine schwierigere Korrektur, wenn die niedrigere Stufe ihre Akzeptanzfälle verfehlt.
Blendet die IDE die Effort-Steuerung aus, kann ihr gewählter Modus von Ihrer direkten Anfrage abweichen. Vergleichen Sie den tatsächlichen Patch und die Nutzung statt der scheinbaren Gründlichkeit der Erklärung.
max_tokens hat den Standardwert 4,096 und akzeptiert bis zu 450,000 Tokens für die sichtbare Antwort. Halten Sie den Wert für einen Ein-Funktions-Patch klein. Reasoning kann die berechnete Ausgabe um ein Vielfaches länger machen als diesen Patch, besonders bei dem Standard-Effort high. Nutzen Sie für Routinekorrekturen niedrigeren Effort, planen Sie anhand von usage und setzen Sie für Agent-Schleifen Tages- und Gesamtlimits pro API-Schlüssel sowie Tages- und Monatsbudgets pro Workspace; dieser Chat-Completions-Endpunkt hat keine Preisangebots-Obergrenze pro Aufruf.
Lassen Sie Temperature und Top-p bei den Standardwerten, solange Sie Effort-Einstellungen vergleichen.
Token-Preise mit intakten Abrechnungskategorien lesen
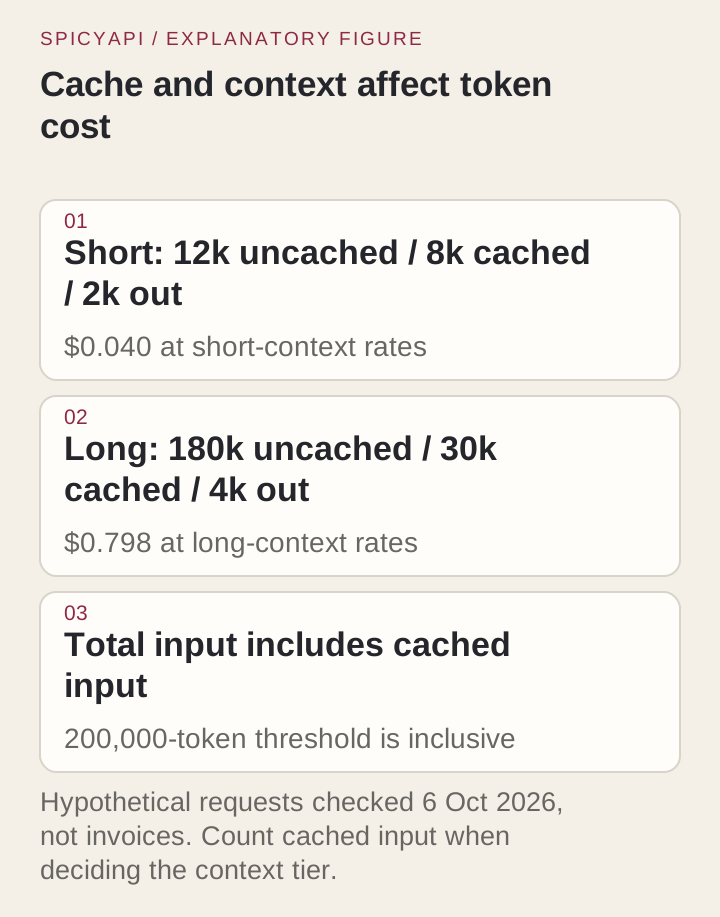
Die SpicyAPI-Preise betragen $2.00 für nicht gecachten Input, $0.50 für gecachten Input und $6.00 für Output pro Million Tokens. Bei 200,000 Input-Tokens insgesamt oder mehr, gecachten Input eingeschlossen, gelten für die gesamte Anfrage $4.00, $1.00 bzw. $12.00. Das sind kundenseitige Katalogpreise, keine Aufzeichnung einer neuen Client-Gebühr.
Für eine hypothetische direkte Anfrage mit 12,000 nicht gecachten Input-Tokens, 8,000 gecachten Input-Tokens und 2,000 berechneten Output-Tokens lautet die Katalogrechnung:
Uncached input: 12,000 / 1,000,000 × $2.00 = $0.0240
Cached input:    8,000 / 1,000,000 × $0.50 = $0.0040
Output:         2,000 / 1,000,000 × $6.00 = $0.0120
Total: $0.0400
Der gesamte Input in diesem Beispiel beträgt 20,000, nicht 12,000. Meldet das Feld usage den gesamten Input und eine gecachte Teilmenge, berechnen Sie die gecachten Tokens nicht doppelt: Ziehen Sie die gecachte Teilmenge ab, um den nicht gecachten Input zu erhalten. Verwenden Sie beim Abgleich einer echten Anfrage die tatsächlichen Kategorien der Antwort und den Datensatz der Plattform.
Ein Beispiel mit langem Kontext, 180,000 nicht gecachten Input-Tokens, 30,000 gecachten Input-Tokens und 4,000 berechneten Output-Tokens, ergibt 210,000 Input insgesamt. Die Rechnung lautet $0.720 + $0.030 + $0.048 = $0.798 zu den Long-Preisen. Die Schwelle gilt für die vollständigen Kategorien der Anfrage, nicht nur für den Anteil über 200,000. Unnötigen Kontext zu reduzieren kann daher sowohl die Token-Menge als auch den anwendbaren Tarif verändern.
Das sind angenommene Token-Zahlen. Kalkulieren Sie ohne Cache-Ersparnis, bis usage einen Treffer meldet; abgerechnet wird nach der gemessenen Nutzung, einschließlich Reasoning-Output.
Einen Cursor-Preis sorgfältig mit einem direkten Preis vergleichen
Cursors Seite Models and Pricing nennt für Grok 4.6 Standardpreise von $2 Input, $0.50 gecachter Input und $6 Output pro Million Tokens; die Fast-Preise betragen $4, $1 und $12. Fast ist bei berechtigten Pro-Tarifen standardmäßig aktiviert, prüfen Sie daher den Selektor, bevor Sie eine lange Aufgabe starten. Das integrierte Grok zieht aus dem Cursor-Models-Pool und dem Kontingent Ihres Tarifs. Abo-Kontingente, Geschwindigkeitswahl und kontospezifische Bedingungen beeinflussen, was ein Nutzer zahlt; die aufgeführten Preise sind keine Prognose einer Monatsrechnung.
Für dieselben 12,000 nicht gecachten Input-, 8,000 gecachten Input- und 2,000 Output-Tokens kostet Cursor Standard insgesamt $0.040, Fast $0.080 und die direkte API $0.040, also dasselbe wie Cursor Standard bei diesen aufgeführten Preisen. Diese Rechnungen vergleichen angegebene Token-Preise bei künstlich gleicher Nutzung; sie zeigen nicht, dass beide Produkte dieselbe Arbeit leisten. Tatsächliche Agent-Sitzungen können andere Token-Mengen verbrauchen.
Ein integrierter Agent kann mehrere Aufrufe machen, um Dateien zu lesen, einen Patch anzuwenden und Tests erneut auszuführen. Vergleichen Sie die Gesamtkosten der abgeschlossenen Korrektur, nicht einen einzelnen Token-Preis.
Cursors Hilfe zu API-Schlüsseln nennt für Teams und Enterprise BYOK einen Zuschlag von $0.25 pro Million Tokens, wobei Input, Output und gecachter Input je einmal gezählt werden. Das Beispiel mit 22,000 Tokens fügt der Anbietergebühr $0.0055 hinzu. Individuelles BYOK hat keine solche Token-Gebühr für Organisationstarife; die Gebühr belegt nicht, dass ein bestimmtes benutzerdefiniertes Modell unterstützt wird.
Notieren Sie bei Ihrer ersten Aufgabe die Gesamtkosten und ob die angewendete Korrektur ihre Tests besteht.
„Other Models“ in Cursors Nutzungsansicht ist ein Abrechnungspool, kein Beleg dafür, dass die Anfrage an einen externen Anbieter ging. Identifizieren Sie einen direkten Aufruf anhand des Task-Datensatzes des Anbieters.
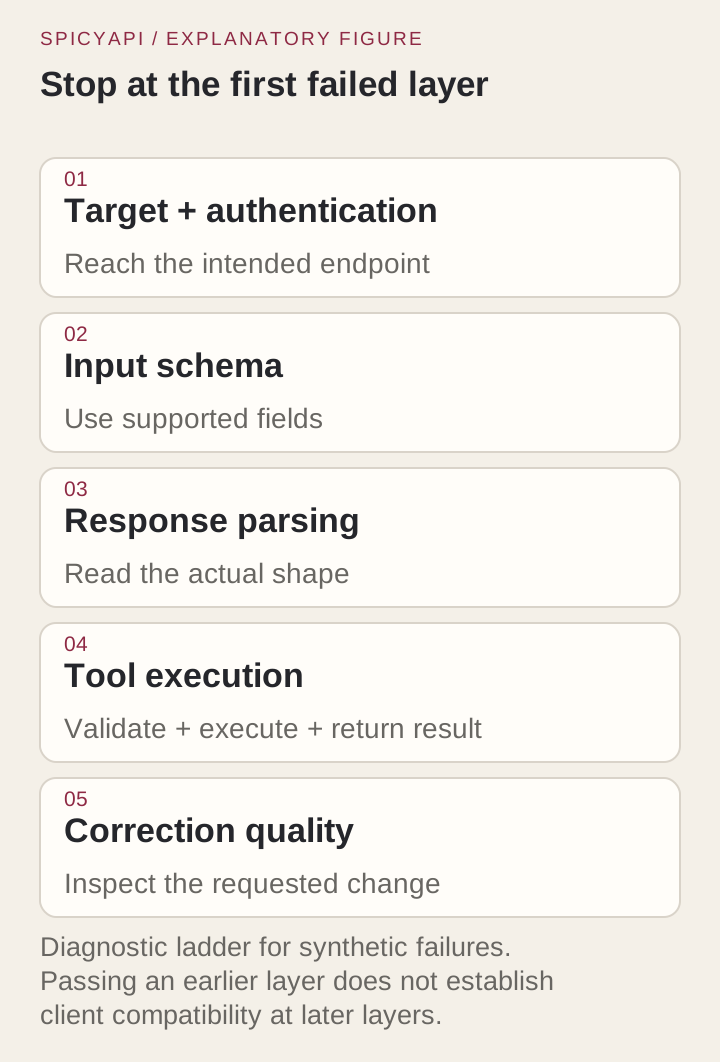
Fehler in der Reihenfolge diagnostizieren, in der sie sichtbar werden
- Ziel oder Schlüssel: Prüfen Sie einen 401-Fehler, ein unbekanntes Modell oder einen doppelten Pfad, bevor Sie den Effort ändern.
- Abgelehntes Feld: Entfernen Sie nicht unterstützte Parameter oder Inhaltsteile und fügen Sie Fähigkeiten dann einzeln wieder hinzu.
- Leere oder hängende Oberfläche: Vergleichen Sie die direkte Antwort mit dem Parser des Clients, dem Finish-Reason und der Abschlussmarkierung.
- Keine Tool-Ausführung: Prüfen Sie Tool-Dispatch und Berechtigungen des Aufrufers.
- Falscher Patch: Prüfen Sie den fehlgeschlagenen Akzeptanzfall und die tatsächlich geänderten Dateien.
Lassen Sie die nächste Änderung die fehlgeschlagene Ebene betreffen; ein längerer Prompt behebt keinen abgelehnten Parameter.
Mit einem zweiten Beispiel Fehler in der Unterhaltung aufdecken
Ändern Sie, nachdem der strikte Parser besteht, eine Anforderung: Führende und nachgestellte Leerzeichen erlauben, aber zweistellige Zeitkomponenten beibehalten. Die neuen Fälle unterscheiden 09:05 , das nun bestehen soll, von 9:05, das weiterhin scheitert. Wenden Sie trim() nach der Typprüfung und vor der bestehenden Längen-/Bereichsprüfung an; halten Sie die Tests beider Fassungen getrennt.
Senden Sie den korrigierten Quellcode und die geänderte Anforderung im nächsten Turn: Eine Request-ID liefert kein Unterhaltungsgedächtnis. Akzeptiert der neue Patch 9:05 oder ändert er die alte Funktion, decken die Folgetests diesen Fehler auf.
Die Route wählen, die zu den benötigten Belegen passt
Wählen Sie integriertes Cursor für integrierte Änderungen und Testausführung. Wählen Sie die direkte API für Ihre eigene Tool-Schleife und Nutzungskontrollen. Nutzen Sie die Einrichtung mit eigenem Schlüssel für den Chat, wenn ihre Verbindungsprüfung erfolgreich ist; integriertes Cursor bleibt die naheliegende Wahl für integrierte Dateiänderungen und Tests.
Halten Sie die Korrektur für diesen Parser auf die Funktion beschränkt und führen Sie alle vierzehn Tests auf dem angewendeten Patch aus.





