
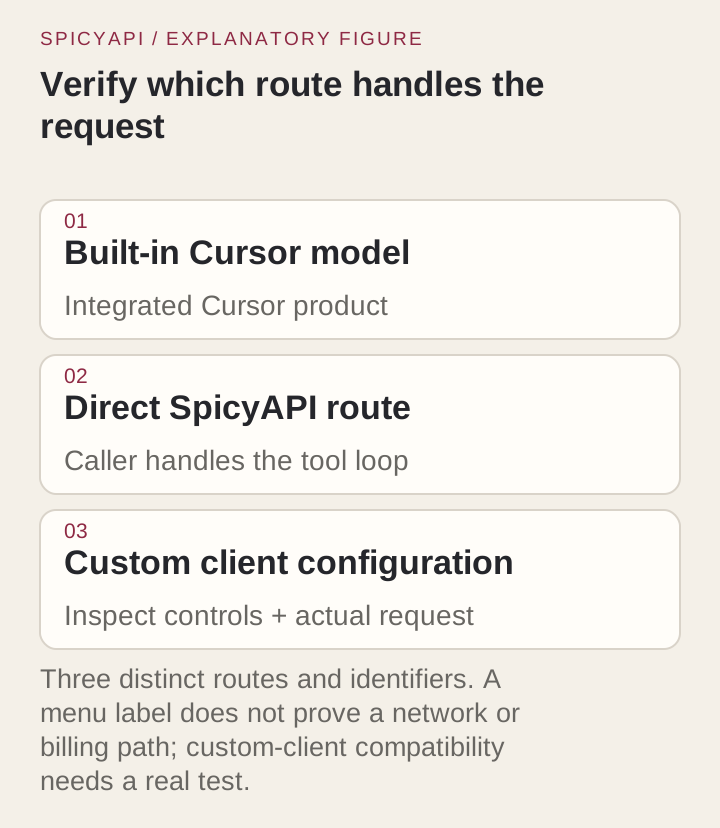
Vous voulez que Grok corrige du code dans Cursor, mais choisir un modèle intégré et pointer une clé vers une API externe sont deux configurations différentes. Utilisez le Grok 4.6 intégré à Cursor pour son intégration d'agent documentée, ou appelez SpicyAPI directement lorsque votre application doit gérer elle-même les requêtes, les outils et la consommation. Pour utiliser une clé SpicyAPI dans Cursor, ouvrez Cursor Settings → Models et vérifiez s'il existe un remplacement de base URL personnalisé. Les valeurs de configuration et la solution de repli ci-dessous vous permettent de choisir la bonne voie avant d'acheter de la consommation.
Deux voies Grok aux contrats différents
La documentation Grok 4.6 de Cursor indique grok-4.6, une fenêtre de contexte de 256k et quatre niveaux d'effort : low, medium, high et xhigh, high étant la valeur par défaut. L'intégration native a accès aux outils d'agent de Cursor.
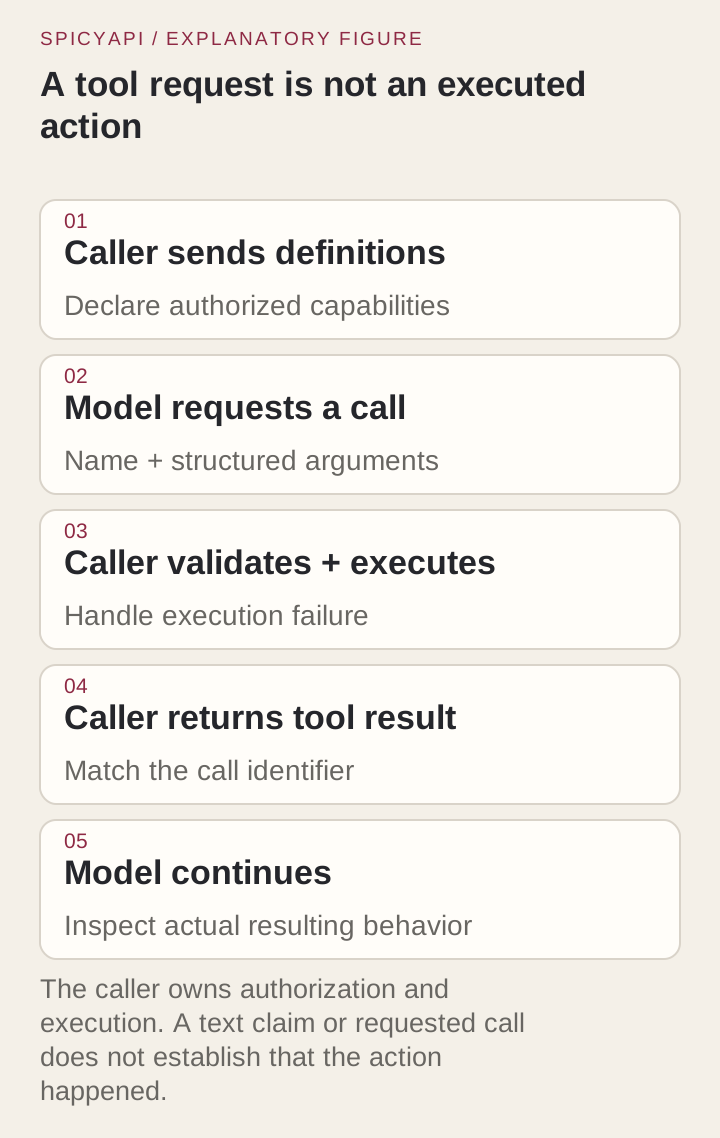
La page du modèle SpicyAPI identifie xai/grok-4.6/chat. Le nom documenté pour les requêtes Chat Completions compatibles OpenAI est xai/grok-4.6, envoyé à https://api.spicyapi.ai/v1/chat/completions. Cette voie accepte des parties texte et image, a une limite d'entrée de 500,000 tokens et expose ses propres paramètres de requête. Son schéma actuel n'accepte pas les parties fichier ou PDF. Une définition d'outil est une entrée pour le modèle ; l'appelant doit fournir la boucle d'exécution.
| Décision | Grok intégré à Cursor | Grok direct via SpicyAPI |
|---|---|---|
| Identifiant de sélection dans l'interface concernée | grok-4.6 dans la documentation de Cursor | xai/grok-4.6 dans une requête Chat Completions ; endpoint du catalogue xai/grok-4.6/chat |
| Qui construit et pilote le workflow de programmation ? | Le produit intégré de Cursor | Votre application ou un client compatible vérifié |
| Fenêtre d'entrée | 256k tokens | 500,000 tokens |
| Modifications de fichiers et tests | Cursor gère les outils de l'agent | Votre appelant exécute les outils et applique les modifications |
La limite API de 500,000 tokens n'agrandit pas la fenêtre de 256k de Cursor. Pour corriger du code, envoyez les fichiers de référence, l'échec et les tests plutôt que tout le dépôt.
Essayez d'abord dans Playground
- Ouvrez Grok 4.6 et passez à Playground.
- Dans la zone de message, collez la question ci-dessous, choisissez l'option de raisonnement Low et cliquez sur Run model :
> A delivery-window parser must accept a local time HH:MM from 00:00 through 23:59. The current function returns true for any string matching two digits, a colon and two digits. Explain which inputs it accepts incorrectly, and propose a small correction.
- Vérifiez si la réponse rejette 24:00 et 12:60. Si c'est le cas, la même question est prête à être exécutée depuis l'API ou depuis votre éditeur.
Utilisez la voie intégrée quand c'est la tâche à accomplir
- Ouvrez le sélecteur de modèle et choisissez explicitement Grok 4.6 si votre compte le propose. Préférez une sélection explicite à Auto quand vous voulez précisément ce modèle ; vérifiez-la à nouveau dans une nouvelle conversation.
- Choisissez l'effort selon la tâche ; la valeur par défaut documentée du modèle est
high. Le forfait Start, réservé à l'Inde, fixe Grok àmediumsans mode Fast. - Ouvrez le projet d'analyseur jetable ci-dessous et demandez une correction limitée à
is-time.mjs. - Examinez le diff appliqué et le résultat réel des tests. Une explication correcte sans modification appliquée n'est pas la même chose qu'une tâche d'agent terminée.
La sélection intégrée ne nécessite ni base URL ni clé SpicyAPI. Pour votre budget, tenez compte du quota de votre forfait actuel et du réglage Fast ; la promotion de lancement de l'article d'annonce est terminée.
Connectez votre clé ou choisissez l'API directe
L'aide sur les clés d'API de Cursor documente Cursor Settings → Models → fournisseur → clé → Save pour OpenAI, Anthropic, Google, Azure et AWS Bedrock. Elle ne documente pas d'endpoint personnalisé pour Grok 4.6.
- Ouvrez Cursor Settings → Models et cherchez un remplacement de base URL OpenAI et une option pour ajouter un modèle personnalisé.
- Si les deux contrôles sont disponibles, saisissez
https://api.spicyapi.ai/v1comme base URL, votre clé SpicyAPI comme clé du fournisseur etxai/grok-4.6comme modèle personnalisé. Enregistrez la configuration. - Sélectionnez ce modèle personnalisé dans une nouvelle conversation et envoyez la petite question sur l'analyseur ci-dessous. Vérifiez que la requête apparaît dans vos journaux SpicyAPI avant d'envoyer une tâche plus importante.
- Si les contrôles sont absents ou si la vérification rejette le modèle, utilisez Grok intégré pour l'agent de Cursor, ou exécutez l'exemple d'API directe. Coller une clé SpicyAPI dans un champ de clé de fournisseur ne suffit pas à lui seul.
Les clés personnelles couvrent le chat, pas la complétion Tab. Les requêtes BYOK passent toujours par le backend de Cursor pour la construction du prompt, et la promesse de rétention zéro de Cursor ne s'y applique pas. Les frais du fournisseur et les éventuels frais client du forfait d'organisation sont distincts.
Gardez les trois identifiants séparés
| Valeur de configuration | Valeur SpicyAPI directe | Usage |
|---|---|---|
| Base URL | https://api.spicyapi.ai/v1 | Pour un client qui ajoute /chat/completions |
| Endpoint complet | https://api.spicyapi.ai/v1/chat/completions | Pour curl ou un appelant qui envoie l'URL complète |
| Modèle de la requête | xai/grok-4.6 | Valeur dans le corps JSON |
| Tâche du catalogue | xai/grok-4.6/chat | L'entrée de la liste des tâches de modèle, et non le nom du sélecteur intégré de Cursor |
Gardez la base URL et l'endpoint complet distincts. Mettre l'endpoint complet dans un champ de base URL peut produire /chat/completions/chat/completions lorsque le client ajoute son propre chemin. Une erreur « unknown model » impose de vérifier la valeur du modèle ; changer le prompt ou l'effort ne réparera pas la cible.
Commencez par une requête directe avec un seul objectif
Envoyez d'abord une requête directe pour vérifier la clé et le modèle avant de dépanner l'IDE.
Cet exemple crée une requête de revue de code facturable lorsque vous l'exécutez. Il utilise la clé de votre environnement. max_tokens: 4000 limite uniquement la réponse visible ; les tokens de raisonnement sont facturés comme sortie et ce plafond ne les limite pas. reasoning_effort: low réduit le travail de raisonnement mais ne fixe pas de plafond de dépenses.
: "${SPICY_API_KEY:?Set SPICY_API_KEY first}"
curl --no-buffer --fail-with-body --dump-header response-headers.txt \
  https://api.spicyapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "xai/grok-4.6",
    "messages": [
      {"role": "system", "content": "Review only the code shown. Explain the smallest correction and its acceptance cases. Do not claim that you executed anything."},
      {"role": "user", "content": "A delivery-window parser must accept a local time HH:MM from 00:00 through 23:59. The current function returns true for any string matching two digits, a colon and two digits. Explain which inputs it accepts incorrectly, and propose a small correction."}
    ],
    "reasoning_effort": "low",
    "max_tokens": 4000,
    "stream": true,
    "stream_options": {"include_usage": true}
  }'
Lisez les fragments choices[].delta.content du flux pour la correction et le dernier chunk usage pour le décompte de tokens ; la documentation décrit le format du flux.
Si l'appel direct échoue, corrigez d'abord sa clé, son modèle ou le champ rejeté avant d'ajouter l'IDE. Ces erreurs persisteront dans un client personnalisé.
Laissez un Agent préparer l'appel
Pour des revues de code répétées, demandez à votre Agent de programmation d'utiliser le Skill SpicyAPI : “Read xai/grok-4.6/chat, then adapt the example to my input; show the request before running it.” La consultation avec la CLI est spicyapi models get xai/grok-4.6/chat --json ; celle avec le MCP est spicyapi_model_get avec model: "xai/grok-4.6/chat". Les appels de chat utilisent un client compatible ou l'API de chat ; les commandes de tâches média ne génèrent pas de réponses de chat.
Rendez le cas de programmation exécutable
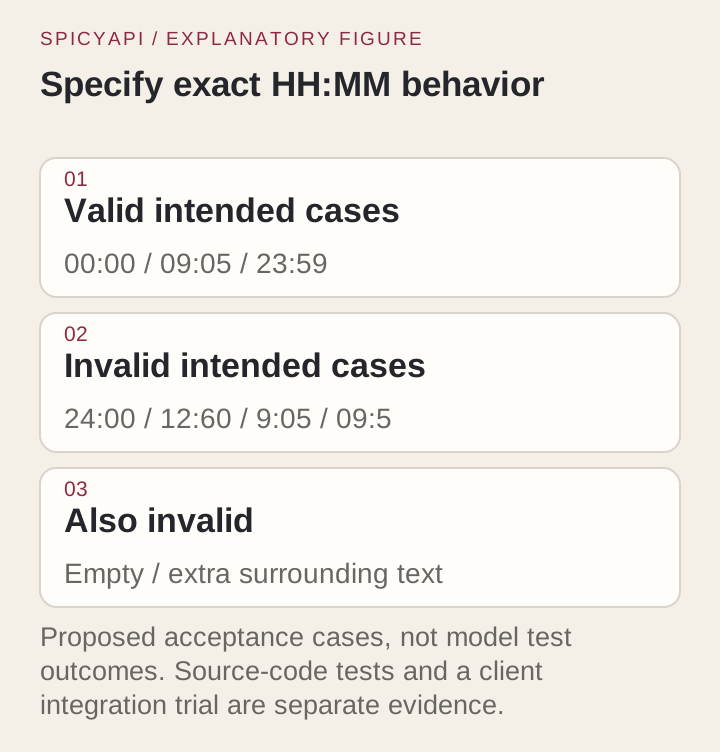
L'exigence est volontairement étroite : accepter exactement HH:MM, heures 00–23 et minutes 00–59, sans espaces autour. Commencez avec ce is-time.mjs défectueux :
export function isTime(value) {
  return typeof value === 'string' && /^\d{2}:\d{2}$/.test(value);
}
Enregistrez les cas d'acceptation sous le nom is-time.test.mjs :
import assert from 'node:assert/strict';
import test from 'node:test';
import { isTime } from './is-time.mjs';

const cases = [
  ['00:00', true], ['09:05', true], ['23:59', true],
  ['24:00', false], ['12:60', false], ['99:99', false],
  ['9:05', false], ['09:5', false], ['', false],
  ['09:05x', false], [' 09:05 ', false], ['09:05\n', false],
  [null, false], [905, false],
];
for (const [value, expected] of cases) {
  test(JSON.stringify(value), () => assert.equal(isTime(value), expected));
}
Exécutez node --test is-time.test.mjs. La fonction initiale échoue sur trois cas : elle accepte 24:00, 12:60 et 99:99. Conservez les cas d'espaces, de saut de ligne final et de valeurs non textuelles pour éviter qu'une correction ultérieure n'élargisse le format. Demandez à l'agent de programmation :
Correct only is-time.mjs to satisfy the supplied tests. Preserve exactly two digits, reject surrounding whitespace, and return false for non-string input. Do not add a date library or change the tests. Run the tests if your tools permit, and report the actual result.
Une solution possible :
export function isTime(value) {
  if (typeof value !== 'string' || value.length !== 5) return false;
  return /^(?:[01]\d|2[0-3]):[0-5]\d$/.test(value);
}
Le contrôle de plage rejette les heures et minutes hors limites ; les contrôles de type et de longueur gardent explicite le format à cinq caractères. Cette solution réussit les quatorze cas. Demandez à l'agent de produire sa propre correction, exécutez les mêmes tests sur ce patch et lisez le diff : une correction d'une seule fonction ne doit toucher ni la configuration, ni la mise en forme ailleurs, ni les dépendances, et ne doit pas ajouter de bibliothèque de dates pour une heure de cinq caractères.
Vérifiez d'abord le chemin en texte brut d'un client personnalisé
Envoyez la même question sur l'analyseur via le client personnalisé. Si aucune tâche n'apparaît chez le fournisseur, vérifiez le modèle sélectionné et la cible de la requête ; le client peut encore utiliser sa voie intégrée ou échouer avant d'envoyer quoi que ce soit.
Une fois le texte brut opérationnel, ajoutez le streaming puis les outils sans modifier les autres réglages.
Utilisez le streaming pour les raisonnements longs
Utilisez stream: true pour un effort high ou xhigh et pour les sorties longues (l'exemple le fait déjà) ; une réponse sans streaming qui prend plus d'environ 100 secondes peut être coupée, et une requête coupée qui ne renvoie aucune réponse n'est pas facturée. Une réponse finale normale se termine par finish_reason: stop ; tool_calls signifie que votre application a une étape suivante, et length signifie que la réponse a été tronquée, même si le code paraît plausible. Si un flux direct se termine mais que l'IDE se bloque, vérifiez la gestion des événements de l'IDE avant de changer de modèle. Détails : documentation sur le texte et le streaming.
La prise en charge des outils exige un appelant qui les exécute
L'API accepte jusqu'à 128 tools, tool_choice et parallel_tool_calls (booléen, true par défaut). Votre application doit fournir les implémentations des outils.
Une boucle d'outils doit valider les arguments demandés, exécuter une opération autorisée, ajouter son résultat réel comme message d'outil, puis rappeler le modèle. Une réponse textuelle seule ne peut ni appliquer le patch ni exécuter Node.
Par exemple, après que l'assistant a demandé une fonction inoffensive get_acceptance_cases, l'appelant renvoie son résultat réel avec l'ID correspondant :
[
  {"role":"assistant","content":null,"tool_calls":[{"id":"call_example","type":"function","function":{"name":"get_acceptance_cases","arguments":"{}"}}]},
  {"role":"tool","tool_call_id":"call_example","content":"00:00 pass; 23:59 pass; 24:00 fail; 12:60 fail; surrounding whitespace fail"}
]
Ajoutez le message réel de l'assistant et le résultat de l'outil à la conversation d'origine ; le JSON ci-dessus en montre la forme. Validez le nom de la fonction et les arguments avant l'exécution, et bornez le périmètre des fichiers, les tours d'outils et les dépenses.
Pour ce cas, laissez le premier outil renvoyer les cas d'acceptation. Ajoutez ensuite un outil de modification de fichier limité à is-time.mjs et une commande de test limitée à node --test is-time.test.mjs.
Associez chaque résultat d'outil à son tool_call_id, même lorsque les résultats arrivent dans le désordre. Pour cette tâche à un seul fichier, parallel_tool_calls: false peut simplifier votre propre harnais.
Si le chat fonctionne mais que les outils échouent dans un client personnalisé, examinez le champ rejeté ou le schéma de l'outil avant de changer de modèle.
Gardez le contexte du dépôt pertinent pour la correction
L'analyseur a besoin de sa fonction, de la spécification et des tests, pas d'une application entière. Pour un vrai bug, incluez l'échec, les fichiers de référence et les sites d'appel concernés. Demandez les informations manquantes avant d'accepter un refactoring étendu.
La voie directe accepte jusqu'à 256 messages ; les tokens et le nombre de messages sont des limites distinctes. Les réponses précédentes, les résultats d'outils et les images occupent aussi du contexte. Pour les longues sessions, conservez le code source actuel et le résultat réel des tests avec un résumé concis des décisions. Un IDE personnalisé peut résumer ou omettre certains fichiers sélectionnés : une fenêtre d'API plus grande ne peut donc pas réparer un contexte que le client n'a jamais envoyé.
Traitez les entrées image et fichier comme des capacités différentes
La voie hébergée accepte les parties texte et image_url ; elle n'accepte ni les parties PDF ni les parties fichier. Pour un bug visuel d'interface, associez une capture récupérable par URL à la spécification. Par exemple, un écran affichant 24:00 peut illustrer l'état d'entrée invalide de l'analyseur. Le cas textuel lui-même n'a pas besoin d'image.
Pour une spécification en PDF, extrayez le texte pertinent en local et vérifiez l'ordre des tableaux et les notes de bas de page avant de l'envoyer. C'est un workflow d'extraction, pas une entrée PDF native. Si un IDE personnalisé ne peut pas transmettre une image ou ajoute un champ de fichier non pris en charge, utilisez la requête directe prise en charge ou son équivalent texte.
Choisissez l'effort et les plafonds de sortie selon le travail
L'API directe accepte low, medium, high et xhigh ; la valeur par défaut est high, et none n'est pas accepté. Utilisez explicitement low pour la petite requête sur l'analyseur. Augmentez l'effort pour une correction plus difficile lorsque le réglage inférieur manque ses cas d'acceptation.
Si l'IDE masque les contrôles d'effort, le mode qu'il sélectionne peut différer de votre requête directe. Comparez le patch réel et la consommation plutôt que le sérieux apparent de l'explication.
max_tokens vaut 4,096 par défaut et accepte jusqu'à 450,000 tokens de réponse visible. Gardez une valeur faible pour un patch d'une seule fonction. Le raisonnement peut rendre la sortie facturée plusieurs fois plus longue que ce patch, surtout avec l'effort high par défaut. Utilisez un effort plus faible pour les corrections courantes, budgétez à partir de usage et définissez des plafonds de dépense quotidiens et totaux par clé d'API, ainsi que des budgets quotidiens et mensuels par workspace, pour les boucles d'agent ; cet endpoint Chat Completions n'a pas de plafond de devis par appel.
Laissez la température et top-p à leurs valeurs par défaut pendant que vous comparez les réglages d'effort.
Lisez les prix des tokens en conservant les catégories de facturation
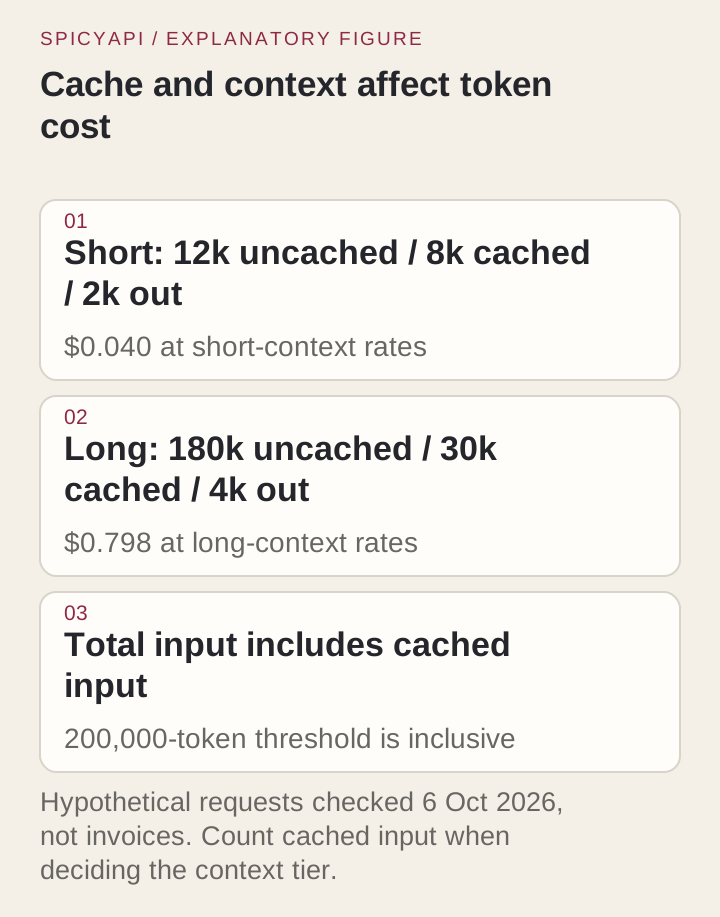
Les tarifs SpicyAPI sont de $2.00 pour l'entrée non mise en cache, $0.50 pour l'entrée en cache et $6.00 pour la sortie par million de tokens. À partir de 200,000 tokens d'entrée au total, entrée en cache comprise, toute la requête utilise respectivement $4.00, $1.00 et $12.00. Ce sont des prix de catalogue destinés aux clients, pas l'enregistrement d'un nouveau frais client.
Pour une requête directe hypothétique avec 12,000 tokens d'entrée non mis en cache, 8,000 tokens d'entrée en cache et 2,000 tokens de sortie facturés, le calcul du catalogue est :
Uncached input: 12,000 / 1,000,000 × $2.00 = $0.0240
Cached input:    8,000 / 1,000,000 × $0.50 = $0.0040
Output:         2,000 / 1,000,000 × $6.00 = $0.0120
Total: $0.0400
L'entrée totale de cet exemple est de 20,000, et non de 12,000. Si le champ usage indique l'entrée totale et un sous-ensemble en cache, ne facturez pas deux fois les tokens en cache : soustrayez le sous-ensemble en cache pour obtenir l'entrée non mise en cache. Utilisez les catégories réelles de la réponse et l'enregistrement de la plateforme pour rapprocher une vraie requête.
Un exemple à long contexte avec 180,000 d'entrée non mise en cache, 30,000 d'entrée en cache et 4,000 de sortie facturée totalise 210,000 d'entrée. Son calcul est $0.720 + $0.030 + $0.048 = $0.798 aux tarifs longs. Le seuil s'applique aux catégories complètes de la requête, pas seulement à la part au-delà de 200,000. Réduire le contexte inutile peut donc changer à la fois la quantité de tokens et le palier applicable.
Ce sont des nombres de tokens supposés. Budgétez sans économie de cache tant que usage ne signale pas de succès ; le règlement utilise la consommation mesurée, y compris la sortie de raisonnement.
Comparez avec prudence un prix Cursor et un prix direct
La page Models and Pricing de Cursor indique pour Grok 4.6 des tarifs standard de $2 d'entrée, $0.50 d'entrée en cache et $6 de sortie par million de tokens ; les tarifs Fast sont de $4, $1 et $12. Fast est activé par défaut sur les forfaits Pro éligibles, vérifiez donc le sélecteur avant de lancer une longue tâche. Le Grok intégré puise dans le pool Models de Cursor et dans le quota de votre forfait. Les quotas d'abonnement, le choix de vitesse et les conditions propres au compte influent sur ce que paie un utilisateur ; les tarifs affichés ne prédisent pas une facture mensuelle.
Pour les mêmes 12,000 tokens d'entrée non mis en cache, 8,000 d'entrée en cache et 2,000 de sortie, Cursor standard totalise $0.040, Fast $0.080 et l'API directe $0.040, soit autant que Cursor standard à ces tarifs affichés. Ces calculs comparent des tarifs par token déclarés pour une consommation égale artificielle ; ils ne montrent pas que les deux produits accomplissent le même travail. Les sessions d'agent réelles peuvent consommer des quantités de tokens différentes.
Un agent intégré peut effectuer plusieurs appels pour lire des fichiers, appliquer un patch et relancer les tests. Comparez la dépense totale de la correction terminée, et non un seul tarif par token.
L'aide sur les clés d'API de Cursor indique un supplément de $0.25 par million de tokens pour le BYOK Teams et Enterprise, l'entrée, la sortie et l'entrée en cache étant comptées une fois. L'exemple de 22,000 tokens ajoute $0.0055 aux frais du fournisseur. Le BYOK individuel n'a pas ce frais par token du forfait d'organisation ; ce frais ne prouve pas qu'un modèle personnalisé particulier soit pris en charge.
Pour votre première tâche, notez la dépense totale et si la correction appliquée réussit ses tests.
« Other Models » dans la vue d'utilisation de Cursor est un pool de facturation, pas la preuve que la requête est allée chez un fournisseur externe. Utilisez l'enregistrement de tâche du fournisseur pour identifier un appel direct.
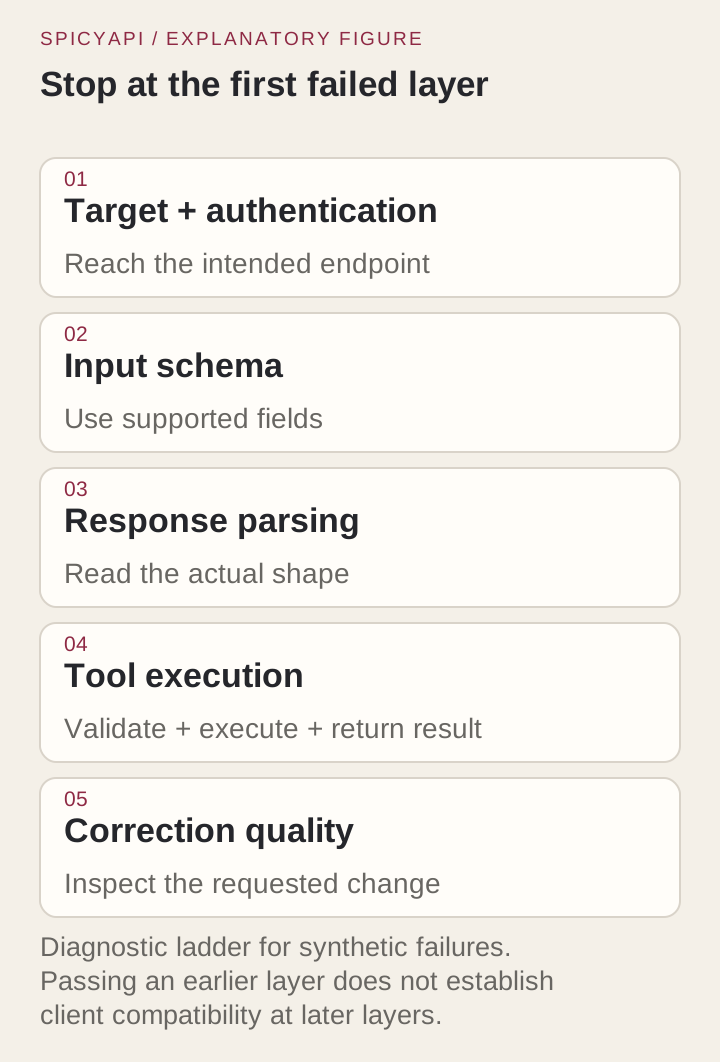
Diagnostiquez les échecs dans l'ordre où ils deviennent observables
- Cible ou clé : examinez une erreur 401, un modèle inconnu ou un chemin dupliqué avant de changer l'effort.
- Champ rejeté : retirez les paramètres ou parties de contenu non pris en charge, puis ajoutez les capacités une par une.
- Interface vide ou bloquée : comparez la réponse directe avec l'analyseur du client, le motif de fin et le marqueur de fin.
- Aucune exécution d'outil : examinez l'exécution des outils par l'appelant et ses autorisations.
- Patch incorrect : vérifiez le cas d'acceptation en échec et les fichiers réellement modifiés.
Faites en sorte que la modification suivante traite la couche en échec ; allonger le prompt ne réparera pas un paramètre rejeté.
Utilisez un second cas pour révéler les erreurs de conversation
Une fois l'analyseur strict validé, changez une exigence : autoriser les espaces au début et à la fin, mais conserver des composantes horaires à deux chiffres. Les nouveaux cas distinguent 09:05 , qui doit désormais réussir, de 9:05, qui échoue toujours. Appliquez trim() après le contrôle de type et avant le contrôle existant de longueur et de plage ; gardez séparés les tests des deux versions.
Envoyez le code source corrigé et l'exigence modifiée au tour suivant : un ID de requête ne fournit pas de mémoire de conversation. Si le nouveau patch accepte 9:05 ou modifie l'ancienne fonction, les tests de suivi révèlent cette erreur.
Choisissez la voie qui correspond aux preuves dont vous avez besoin
Choisissez Cursor intégré pour les modifications intégrées et l'exécution des tests. Choisissez l'API directe pour votre propre boucle d'outils et vos contrôles de consommation. Utilisez la configuration avec clé personnelle pour le chat lorsque sa vérification de connexion réussit ; Cursor intégré reste le choix direct pour les modifications de fichiers et les tests intégrés.
Pour cet analyseur, limitez la correction à la fonction et exécutez les quatorze tests sur le patch appliqué.





