Google lanzó Nano Banana 2.1 el 6 de octubre de 2026 y su propuesta apunta a los trabajos en los que los modelos de imagen suelen fallar: la cabecera de una revista, el título de una película, un letrero al fondo. Antes de mover a él un flujo de carteles, anuncios o personajes, necesitas tres respuestas: ¿se cumple lo del texto?, ¿las ediciones conservan a la persona de partida? y ¿hasta dónde te deja llegar la política de contenido de Google antes de que el modelo cambie tu imagen sin avisar?
Nano Banana 2.1 es el modelo de imagen de Google al que recurrir cuando las palabras de la imagen tienen que ser correctas. En nuestras pruebas del 7 de octubre de 2026, cada línea que pusimos entre comillas dobles salió escrita tal cual, las ediciones con varias imágenes llevaron rostros y detalles de producto a escenas nuevas, y la búsqueda web corrigió una fecha que el modelo inventaba por su cuenta. No es un modelo sin censura. Las imágenes de nivel lencería se generaron en texto a imagen, pero las solicitudes de L2 a L4 volvieron casi siempre completadas, cobradas y suavizadas sin aviso, las ataduras y el gore fueron rechazados, y la tarea de edición rechazó la mayoría de las solicitudes para adultos. Los banners anchos se mantuvieron unidos con paisajes y multitudes lejanas, pero con personas cerca de la cámara salieron pegados más o menos la mitad de las veces, y los marcos altos 1:8 solo funcionaron con sujetos que ya son altos.
Hicimos todas las pruebas con la página de la familia Nano Banana 2.1 en SpicyAPI, donde el modelo se activó el 7 de octubre de 2026. Lo que Google afirma más abajo viene de su documentación del modelo.
De un vistazo
| Nano Banana 2.1 (probado el 7 de octubre de 2026) | |
|---|---|
| Editor y lanzamiento | Google, 6 de octubre de 2026; el código de modelo de Google es gemini-nano-banana-2.1 |
| Qué es | Una actualización de Nano Banana 2 (Gemini 3.1 Flash Image); Google lo llama la versión más eficiente de Nano Banana Pro |
| Nombres de modelo en la API | google/nano-banana-2.1/text-to-image y google/nano-banana-2.1/edit |
| Entradas | prompt de hasta 5000 caracteres; la edición admite de 1 a 14 imágenes de origen |
| Tamaños | 1k (predeterminado), 2k, 4k; 14 relaciones de aspecto de 1:1 a 8:1 y 1:8 |
| Salida | Una imagen PNG (predeterminado) o JPEG por solicitud |
| Velocidad en nuestras pruebas | Unos 10 a 35 segundos en 1k y 2k, hasta aproximadamente un minuto en 4k (tiempo del modelo) |
| Texto en nuestras pruebas | Cada línea entre comillas salió escrita tal cual; la letra pequeña que no deletreamos volvió como relleno |
| Contenido en nuestras pruebas | Se aplica la política de Google. Texto a imagen: L1 se generó, de L2 a L4 casi siempre suavizado sin aviso (se cobra), ataduras y gore rechazados. Edición: la mayoría de las solicitudes para adultos rechazadas, L2 con la persona vestida de nuevo (se cobra), gore cinematográfico generado |
| No disponible | Semilla, prompt negativo, varias imágenes por solicitud, máscara, un nivel de borrador de 0.5k |
| Prueba a ciegas (7 de octubre de 2026) | 75.6 / 100: fidelidad al prompt 76.7, calidad de imagen 77.8, consistencia de edición 65.9. Mismas preguntas: Nano Banana Pro 74.4, Nano Banana 2 70.3 (ambos el 5 de octubre de 2026) |
| Precio | Por imagen según el nivel de tamaño, desde un precio muy por debajo del precio de lista de Google; cada opción de búsqueda suma un cargo |
Qué es Nano Banana 2.1
Google dice que Nano Banana 2.1 es “una actualización de Nano Banana 2 (Gemini 3.1 Flash Image)” que “mantiene la velocidad y la eficiencia de costo de Flash con mejoras significativas en calidad visual, fidelidad al prompt, consistencia de personajes entre turnos y renderizado de texto”. También lo llama “la versión más eficiente de Gemini 3 Pro Image (Nano Banana Pro)”. Entre las novedades que destaca Google están un mejor diseño de infografías, la corrección de las costuras en relaciones anchas y panorámicas en 2K y 4K, hasta 14 imágenes de referencia (con hasta 4 personajes y 10 objetos consistentes) y la búsqueda con Google Web Search e Image Search como base. Las secciones siguientes comprueban esas afirmaciones con lo que obtuvimos.
Renderizado de texto: la mejora estrella se cumple
Es la razón para probar el modelo y la afirmación que mejor resistió. Pedimos ocho líneas de rotulación en tres prompts de texto a imagen y una edición (una portada de revista, un cartel de cine, un letrero de neón de motel y la funda de un álbum, todos en este artículo), y cada línea entre comillas dobles salió escrita tal cual.
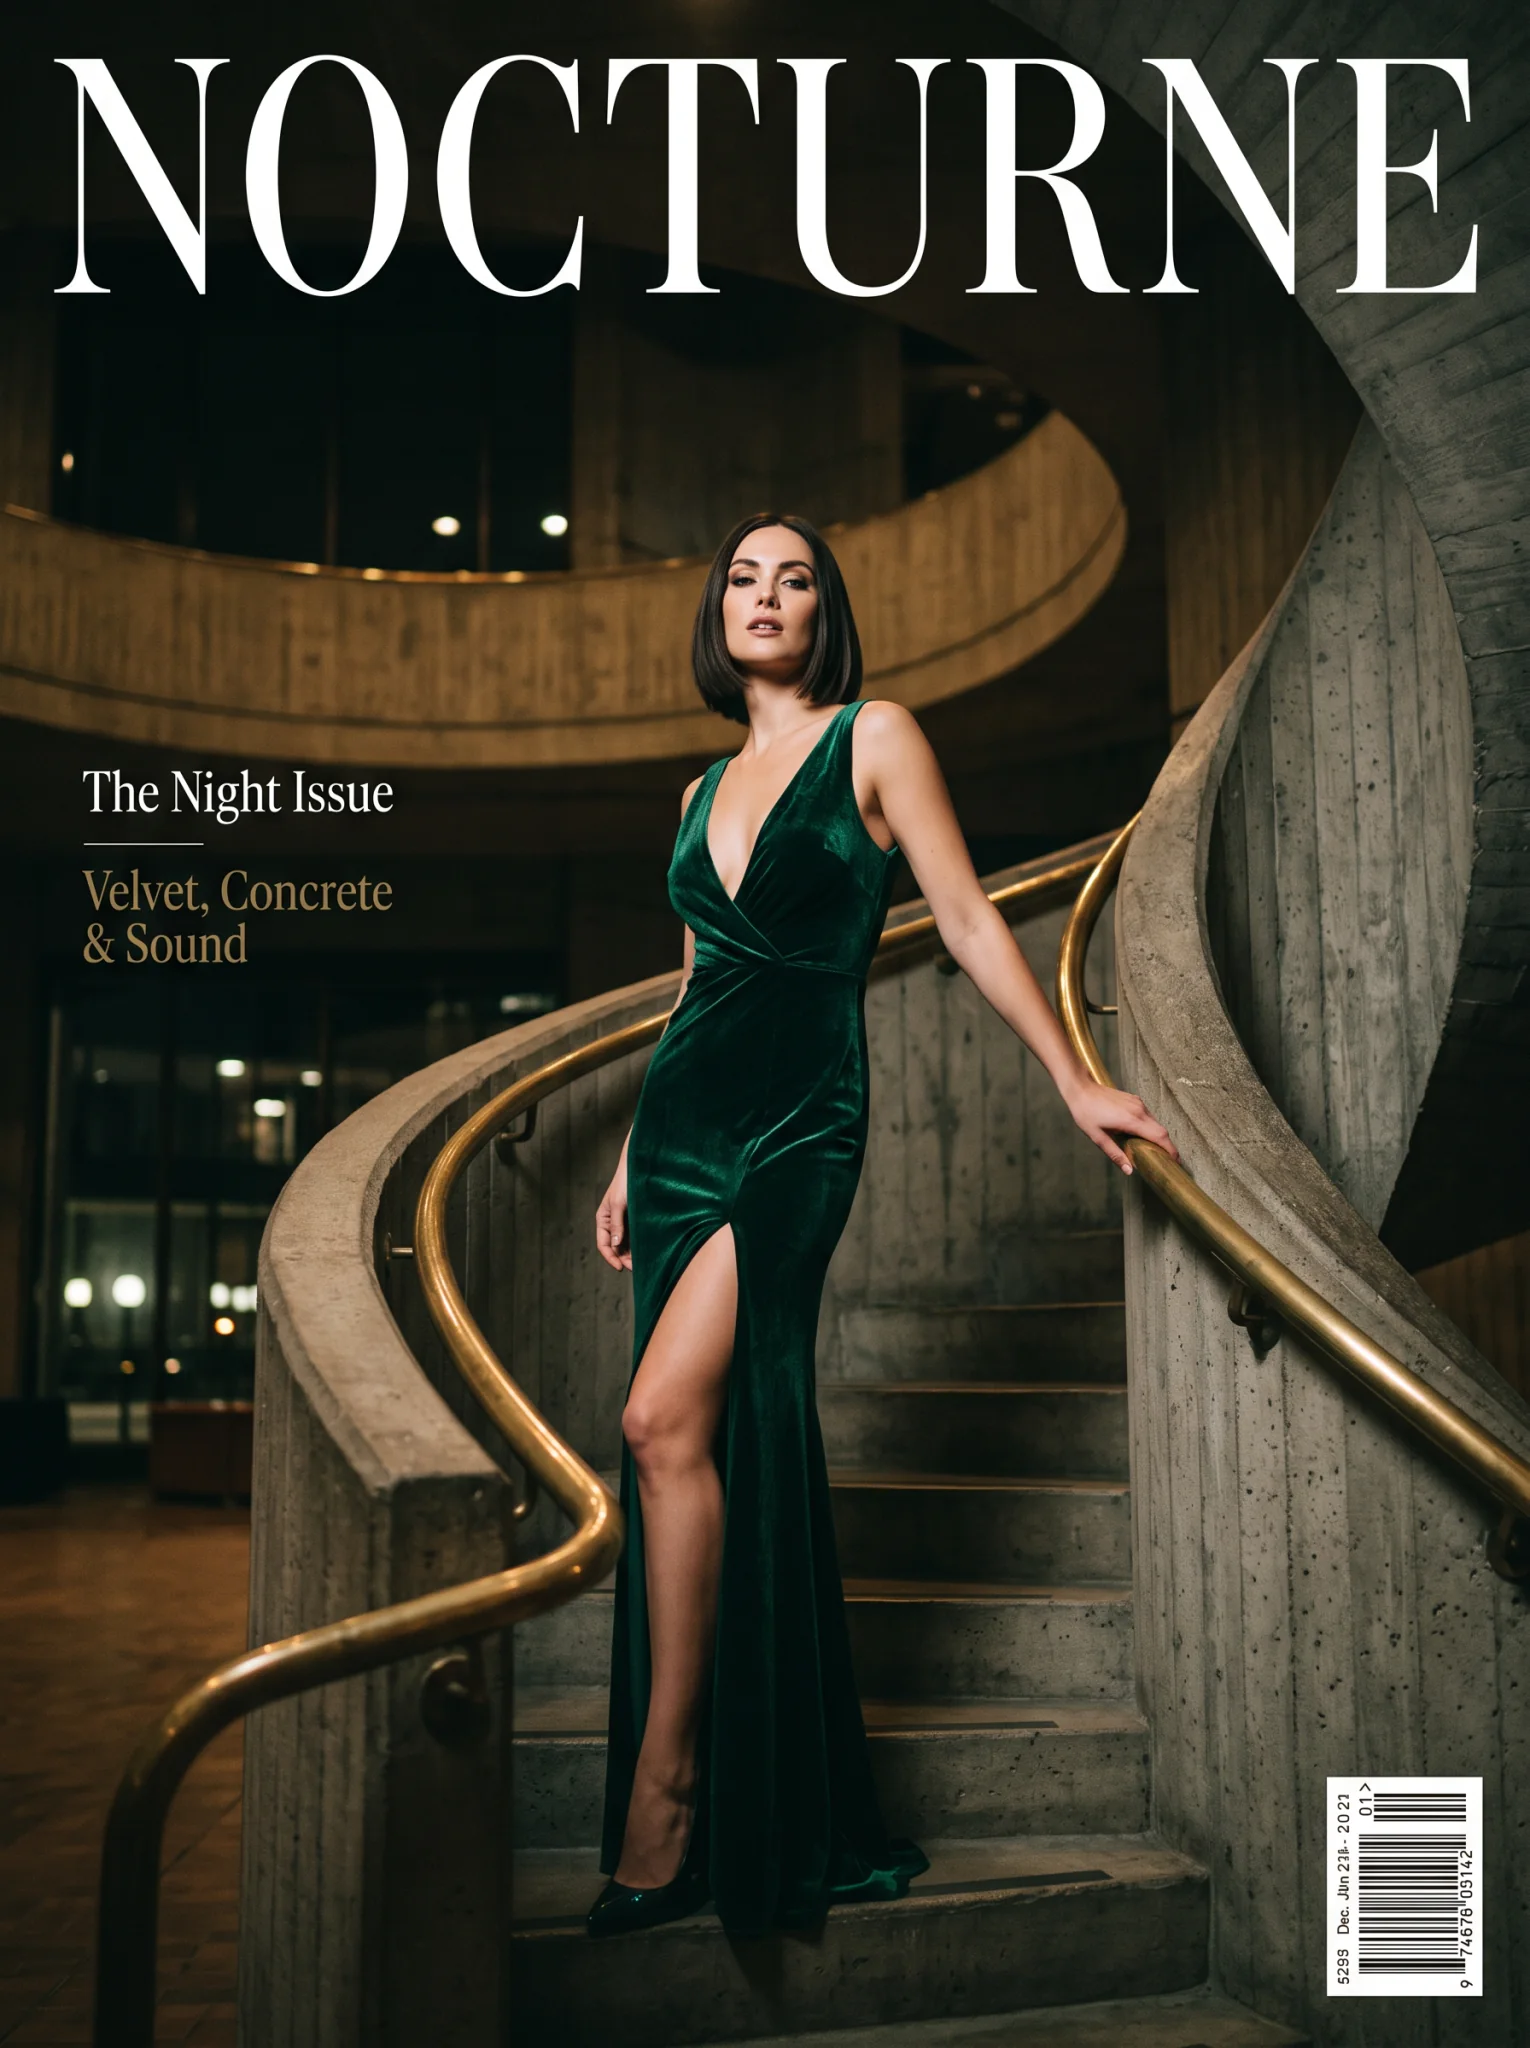
Texto a imagen, 3:4, 2k. La cabecera y los dos titulares de portada están escritos tal cual. Los dígitos del código de barras, que el prompt no deletreaba, son relleno.
El prompt que usamos:
Fashion magazine cover photograph. The masthead across the top, in tall elegant serif capitals, reads "NOCTURNE". A woman in her early thirties with a sleek dark bob stands on the curving concrete spiral staircase of a brutalist concert hall at night, wearing a plunging emerald velvet gown with a thigh-high slit, one hand on the brass rail, looking down at the camera. Small cover lines on the left read "The Night Issue" and "Velvet, Concrete & Sound". A small barcode in the lower right corner. Low-key cinematic lighting, deep green and charcoal palette.Abre este prompt en Nano Banana 2.1 texto a imagen y fija aspect_ratio en 3:4 y resolution en 2k para igualar nuestra ejecución; el enlace solo rellena el prompt.
El cartel de cine muestra el límite: el título y la línea de estreno son exactos, pero el bloque de nombres, que pedimos sin escribir ningún nombre, salió como un galimatías de aspecto convincente.
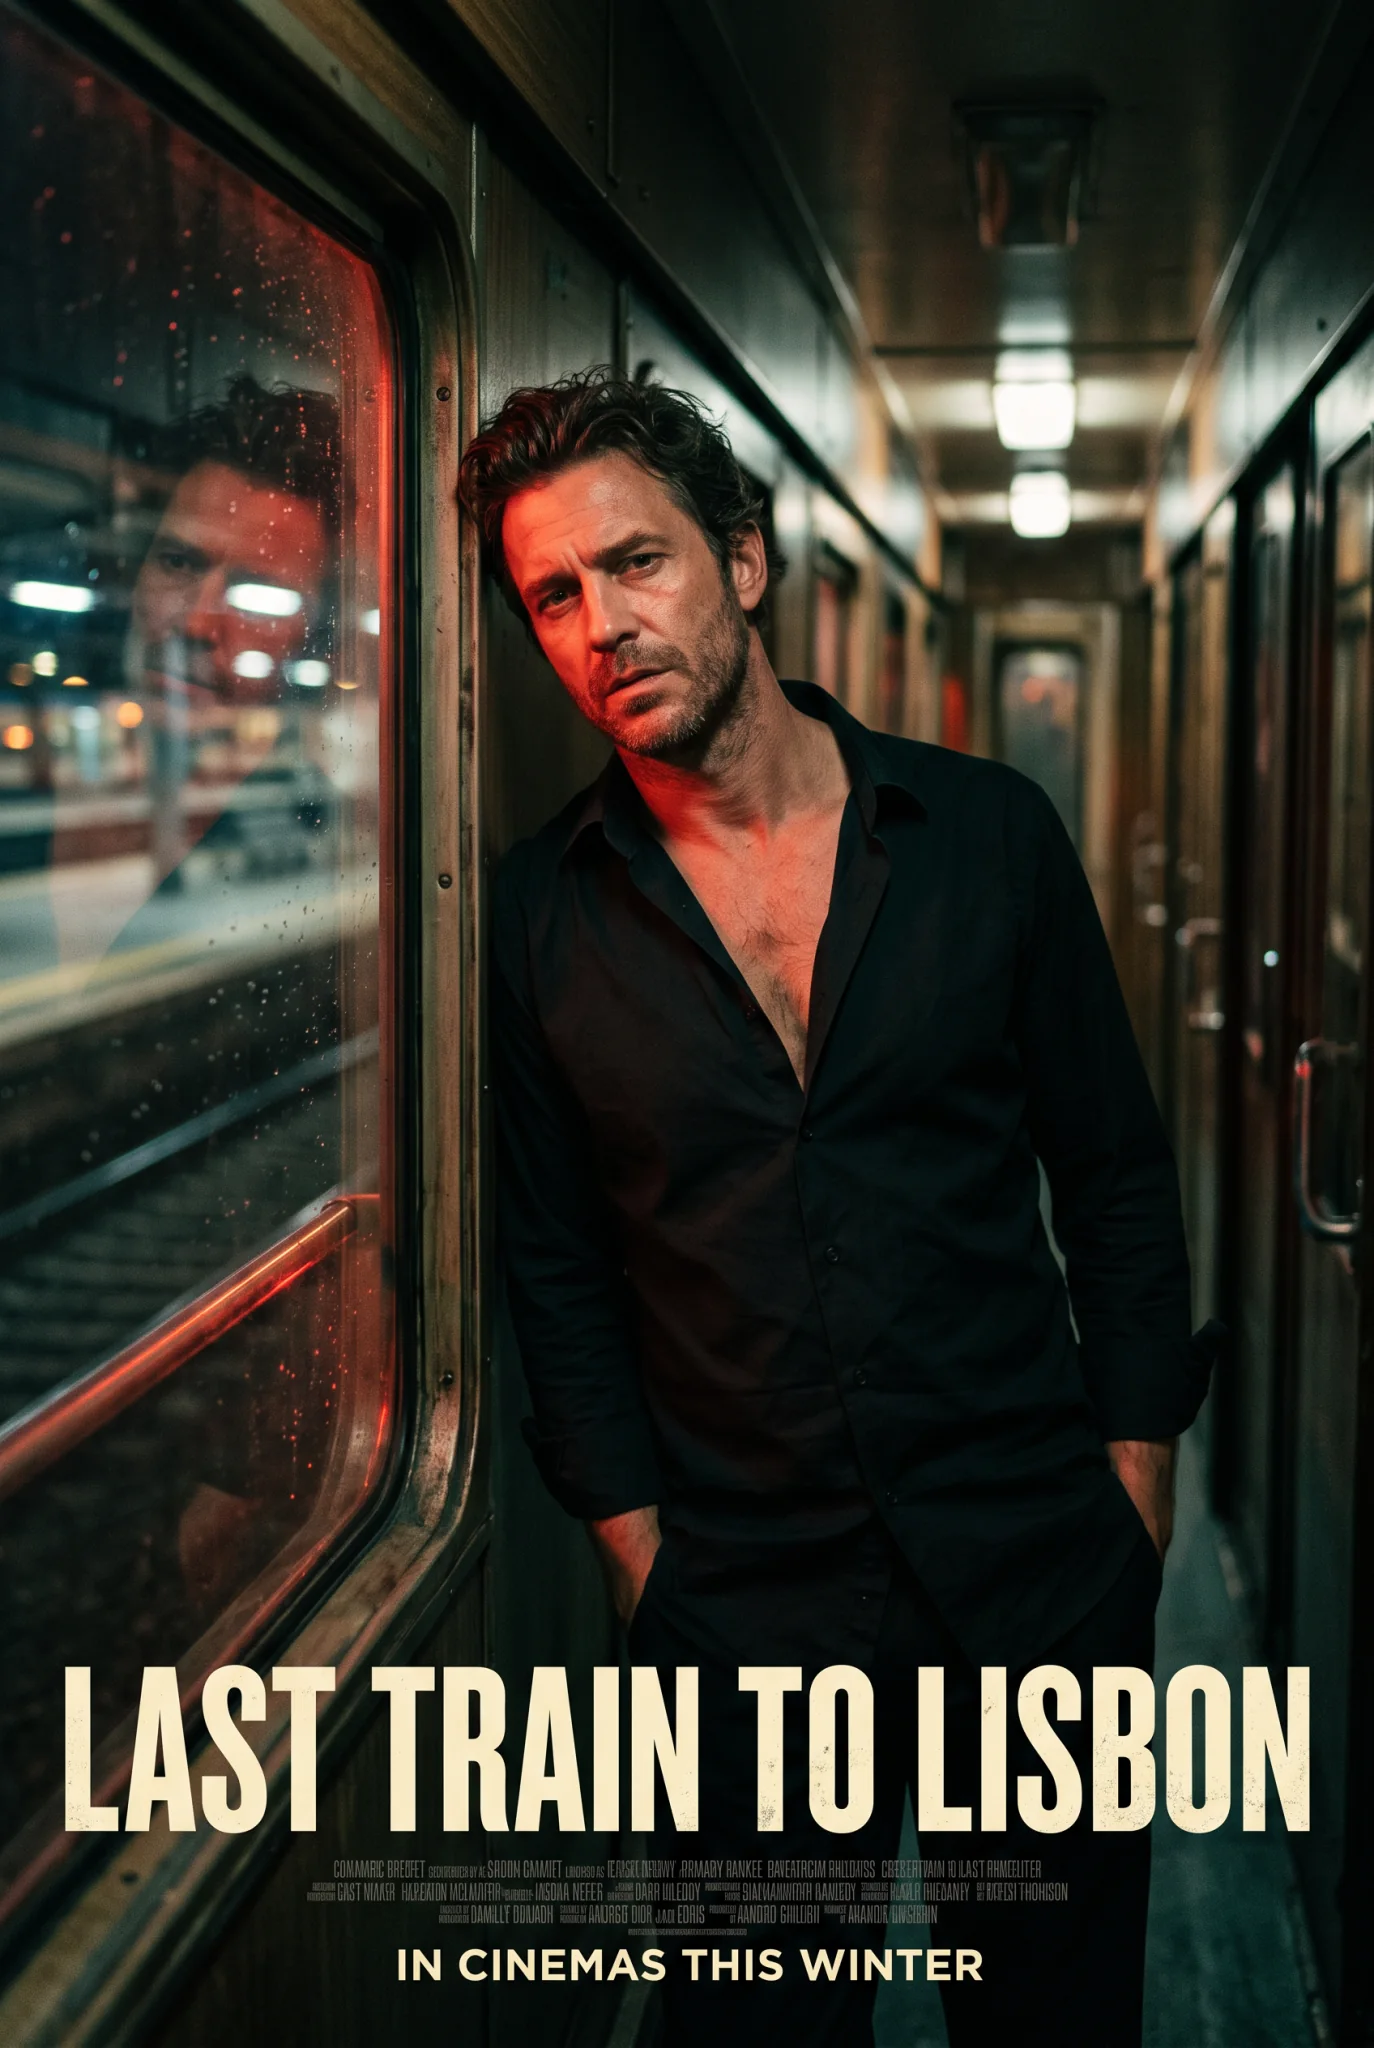
Texto a imagen, 2:3, 2k. Título y línea de estreno exactos; el bloque de nombres entre ambos es relleno.
Qué significa esto al escribir un prompt de texto:
- Pon entre comillas cada palabra que deba aparecer.
- Di dónde va y qué aspecto tiene. “En la parte superior, en altas mayúsculas con serifa elegantes” aterrizó justo ahí.
- Deletrea todo lo que un lector vaya a leer. Lo que solo describes (“un pequeño código de barras”, “un bloque de nombres”) vuelve como textura, así que revisa la letra pequeña antes de publicar.
Para un flujo completo de carteles con correcciones de texto puntuales, consulta nuestra guía de maquetación de texto con Nano Banana Pro; aquí valen los mismos hábitos de prompt.
Ediciones que conservan a la persona y al producto
La tarea de edición admite de 1 a 14 imágenes de origen en image_urls, en el orden al que se refiere tu prompt. Google dice que mantiene consistentes hasta 4 personajes y hasta 10 objetos.
Un origen: una escena nueva, el mismo rostro
Le dimos una foto diurna de una mujer pelirroja regando helechos en un invernadero de cristal, con camisa de lino blanca y shorts vaqueros, y le pedimos una noche en la ópera.
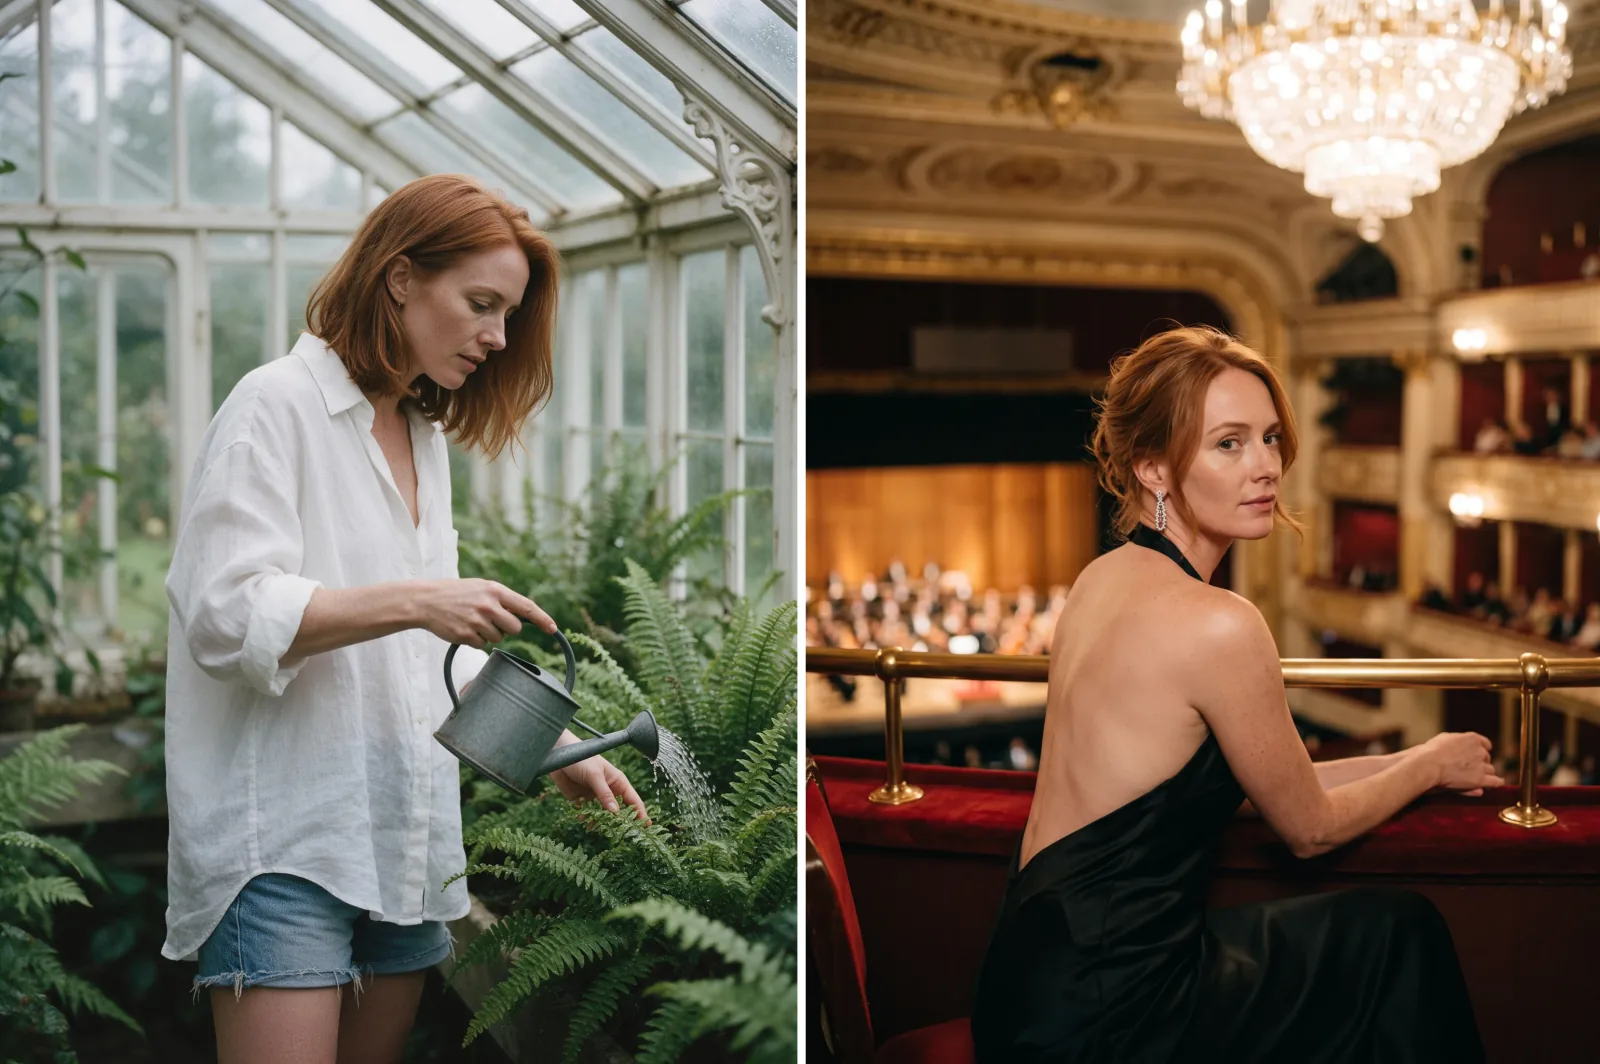
Izquierda: la foto de origen. Derecha: la edición en 2k, relación en auto. El rostro y el color del pelo se conservaron; el vestido, el recogido, los pendientes, el palco de terciopelo, la lámpara de araña y el escenario coinciden con el prompt.
Take her from the greenhouse to an opera house at night: she sits in a red velvet box seat, leaning on the gilded balcony rail, wearing a backless black silk gown with her auburn hair pinned up and diamond drop earrings, looking back over her shoulder, the lit stage and a crystal chandelier softly blurred behind her. Keep her face and her hair colour.La última frase importa: indicar qué debe quedarse (“keep her face and her hair colour”) le dice al modelo qué partes del origen son fijas.
Tres orígenes: una persona, un producto y un lugar
Es el trabajo que más interesa a los equipos de producto. Aportamos un retrato de estudio de un hombre, la foto de producto de una sobrecamisa de ante color coñac con broches de latón y un observatorio vacío de noche.
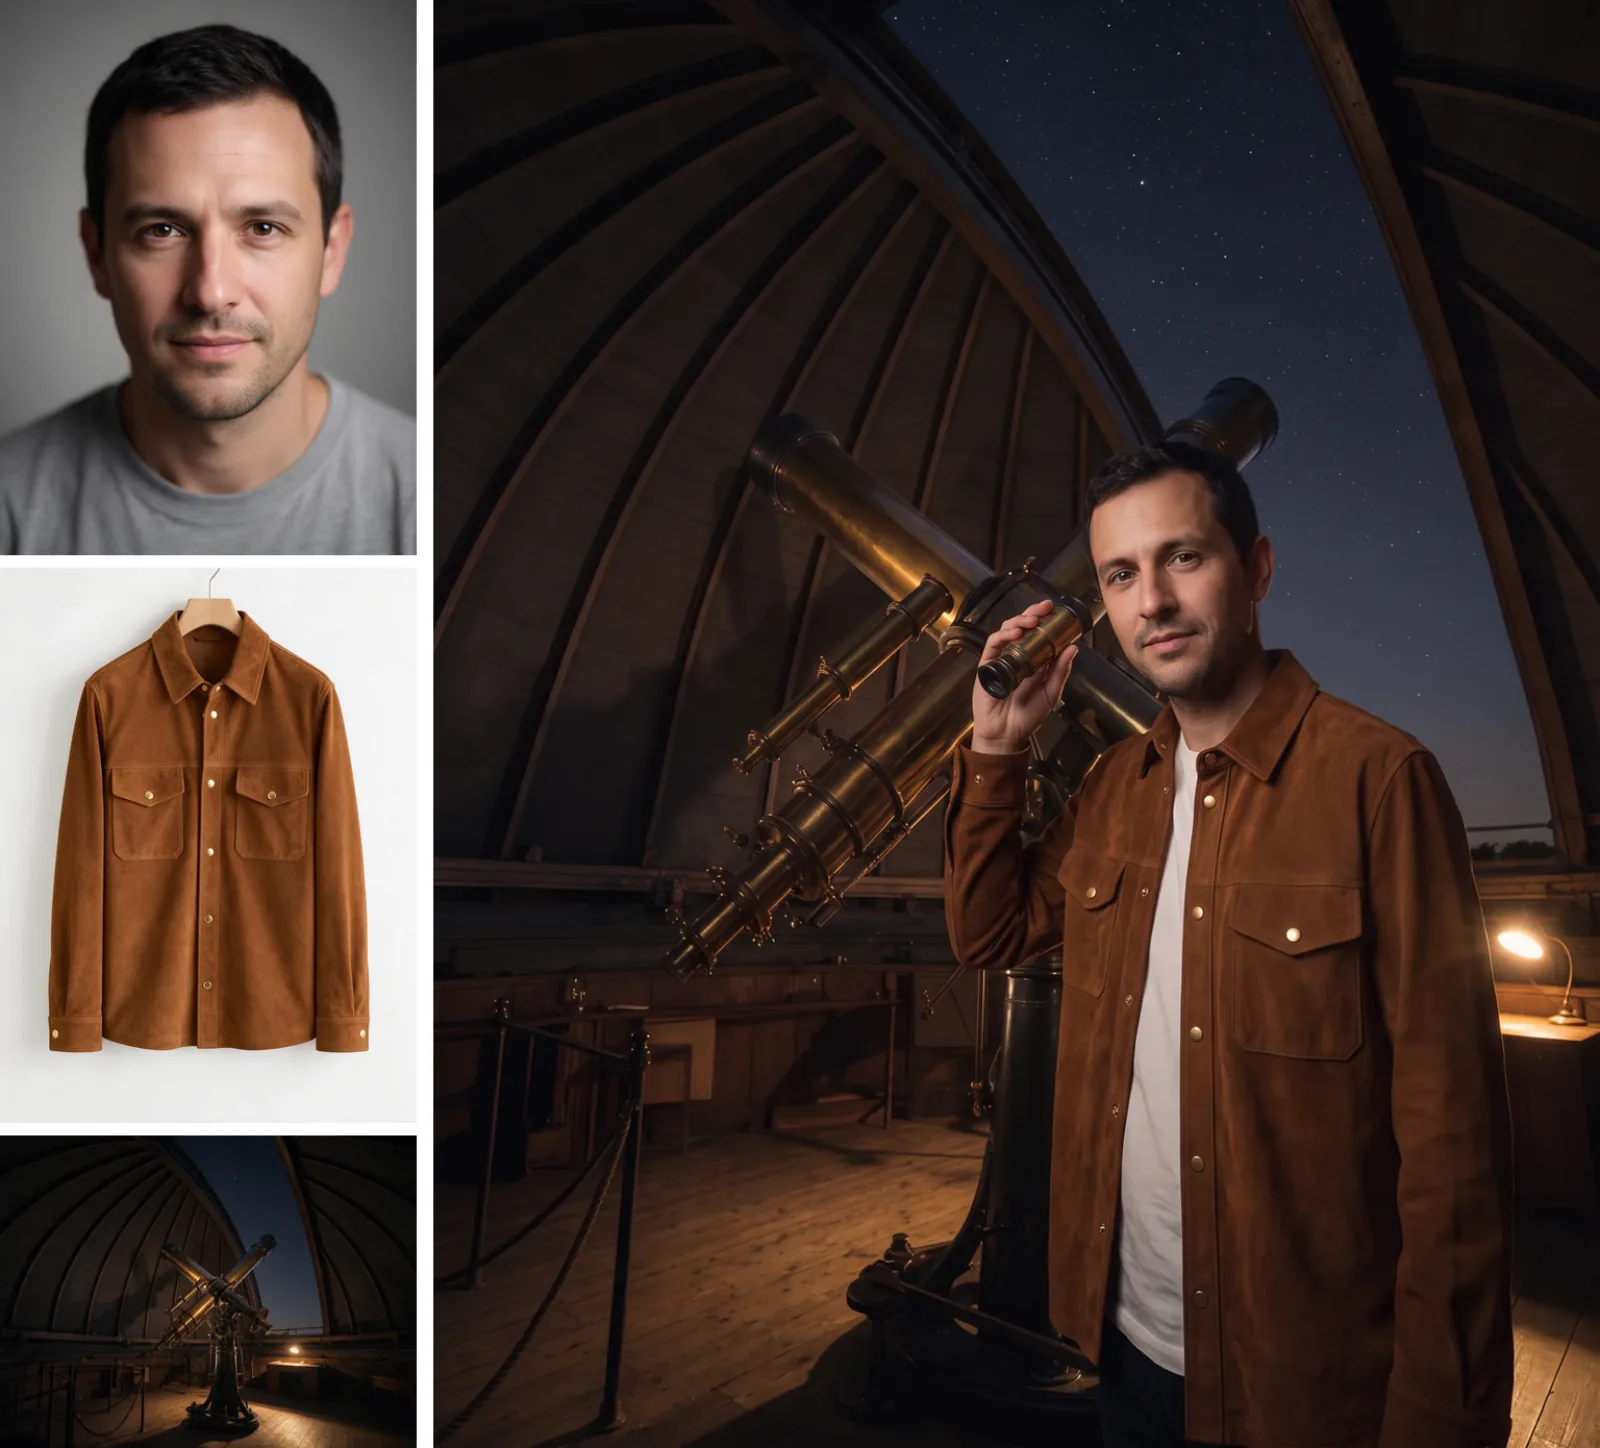
Izquierda: los tres orígenes en el orden del prompt. Derecha: la edición en 4:5, 2k. El rostro, el color de la chaqueta, los broches de latón y los bolsillos del pecho se conservaron. Un fallo: en lugar de una mano en el ocular del telescopio, sostiene un pequeño catalejo de latón.
Combine the three images: the man from the first image wears the cognac suede overshirt from the second image, unbuttoned over a white undershirt, and stands beside the brass telescope in the observatory from the third image at night, one hand on the eyepiece, starlight from the open dome and the warm desk lamp on his face. Keep his face, and keep the jacket's colour, brass snaps and chest pockets exactly.Lo que funcionó: referirse a cada origen por su posición, decir qué tomar de cada uno y enumerar los detalles que deben sobrevivir. La acción que mencionamos solo de pasada es la que cambió, así que dale a una pose importante su propia frase.
Texto dentro de una edición
La última edición mantuvo tal cual a dos personas y una tienda, y diseñó la funda que sostenían en las manos.
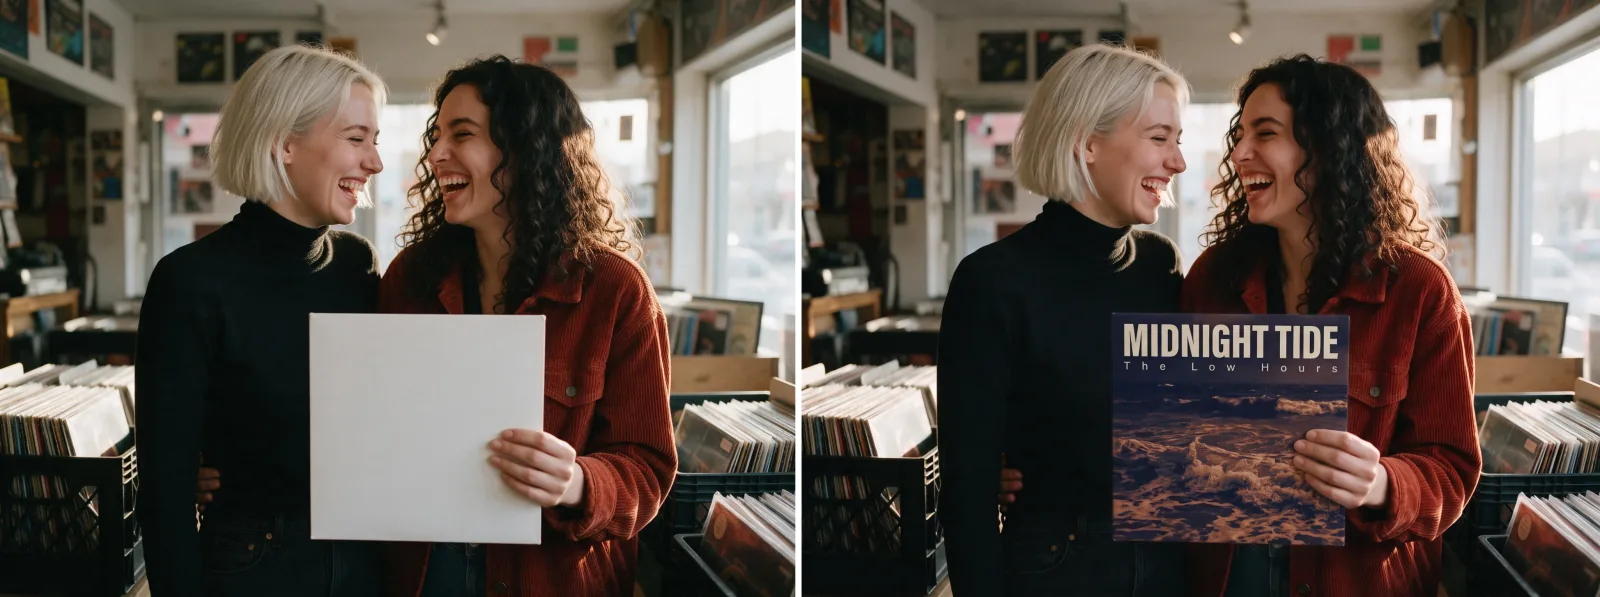
Izquierda: el origen. Derecha: la edición en 2k. Mujeres, ropa y tienda sin cambios; el título y el nombre de la banda están bien escritos, aunque el nombre de la banda va en mayúsculas y minúsculas con espaciado entre letras, no en las versalitas que pedimos.
Design the blank album sleeve she is holding: a moody duotone photograph of ocean waves at night in deep blue and rust, with the title "MIDNIGHT TIDE" in large bold sans serif and the band name "The Low Hours" in small capitals beneath it. Keep both women, their clothes, their pose and the record store exactly as they are.Relación de aspecto en las ediciones. La tarea de edición añade auto (el valor predeterminado), que conserva la forma del origen: un origen panorámico 4:1 volvió en 2064 x 512. Con varios orígenes de formas distintas, fija tú una relación. En nuestra prueba con dos orígenes, auto simplemente siguió a uno de los dos.
Para ver con más detalle los roles de los orígenes y cómo corregir derivas, consulta nuestra guía de edición con referencias de Nano Banana 2.
Búsqueda web: el arreglo para fechas y datos de actualidad
Ejecutamos el mismo prompt dos veces:
today's weather forecast poster for Tokyo with the dateCon enable_web_search activado, el cartel imprimió la fecha correcta, miércoles 7 de octubre de 2026. Con la opción desactivada, el modelo inventó una fecha (24 de octubre). Si una imagen depende de algo actual (una fecha, un pronóstico, un evento), actívala. enable_image_search también se ejecutó y devolvió una imagen, pero no medimos una diferencia visible. Cada opción de búsqueda suma un cargo por solicitud, así que déjalas desactivadas en los demás casos.
Formatos anchos y altos: describe una sola escena continua
Google dice que la 2.1 corrigió los artefactos de mosaico en 1:4, 4:1, 1:8 y 8:1 en 2K y 4K. En nuestras pruebas del 7 de octubre de 2026 que los formatos anchos y altos se mantuvieran unidos dependió del sujeto, como muestran los resultados de abajo. En 21:9 el modelo compuso un único fotograma de película continuo:
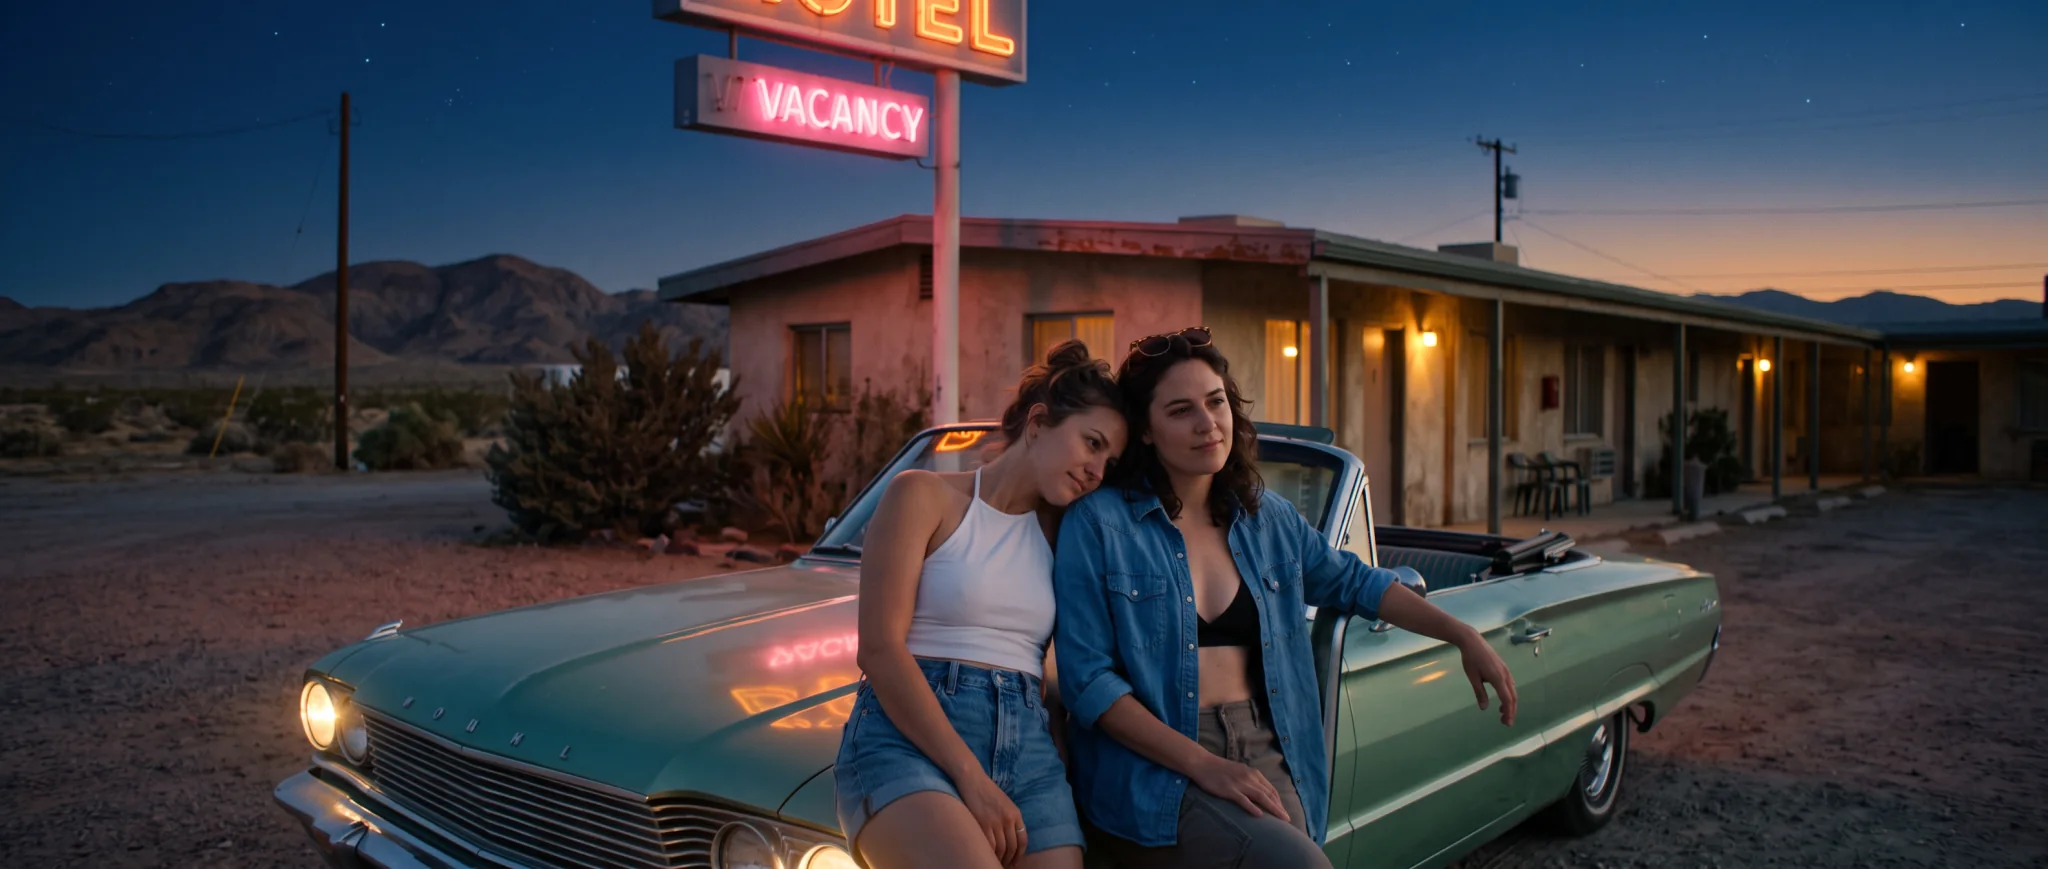
Texto a imagen, 21:9, 2k. Un solo fotograma continuo; la palabra entre comillas “VACANCY” está escrita tal cual.
Ejecutamos 8:1 seis veces. Cuatro volvieron como una sola imagen continua; dos volvieron como varias tomas pegadas una al lado de otra, con costuras marcadas y una iluminación distinta en cada panel. Es decir, el mosaico todavía aparece a veces en 8:1 y 2k, pese a la corrección. La redacción marcó la diferencia. Nuestro primer prompt de rave colocaba puntos de referencia separados a lo ancho (una cabina de DJ en el extremo izquierdo, columnas de acero en el derecho, una pareja en el centro) y volvió pegado. Los prompts reescritos como una sola escena continua, con un único entorno que llena el ancho (una cresta montañosa en 2k y 4k, una multitud de rave en 4k y el rave reformulado que aparece abajo), volvieron continuos en cuatro de cinco ejecuciones. Una cresta montañosa 4:1 en 2k también salió continua (4128 x 1024). Esa fue nuestra primera prueba; una ronda posterior con 69 ejecuciones más, descrita abajo, mostró que el resultado también depende de lo que haya en el encuadre.
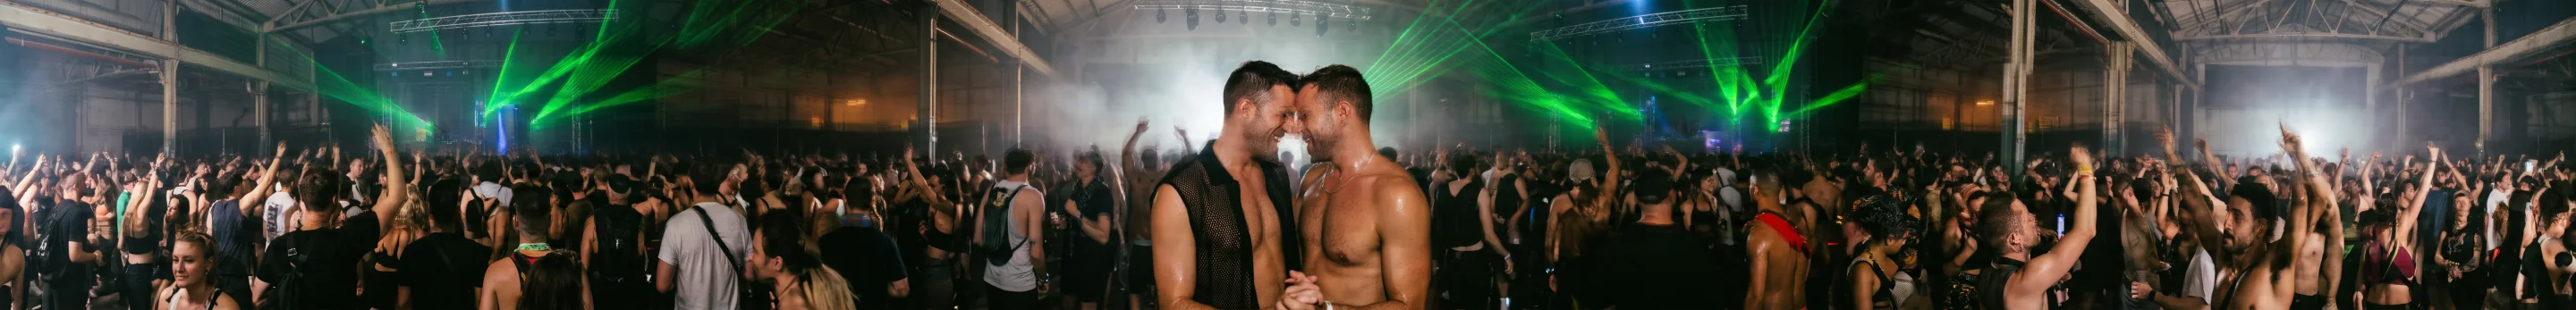
Texto a imagen, 8:1, 2k (5856 x 704, mostrada más pequeña), escrita como una sola escena continua: una multitud sin cortes de borde a borde, con la pareja en el centro.
One continuous ultra-wide panoramic photograph, a single unbroken scene from edge to edge, inside a packed warehouse rave at three in the morning: green laser beams cut through the haze above a dancing crowd that fills the whole frame under steel roof trusses. In the middle of the crowd two men in their thirties, a gay couple, dance forehead to forehead, one in an open black mesh shirt and one shirtless with a thin gold chain, sweat glinting under the lasers.Para comparar, esta es nuestra primera ejecución 8:1, la pegada:
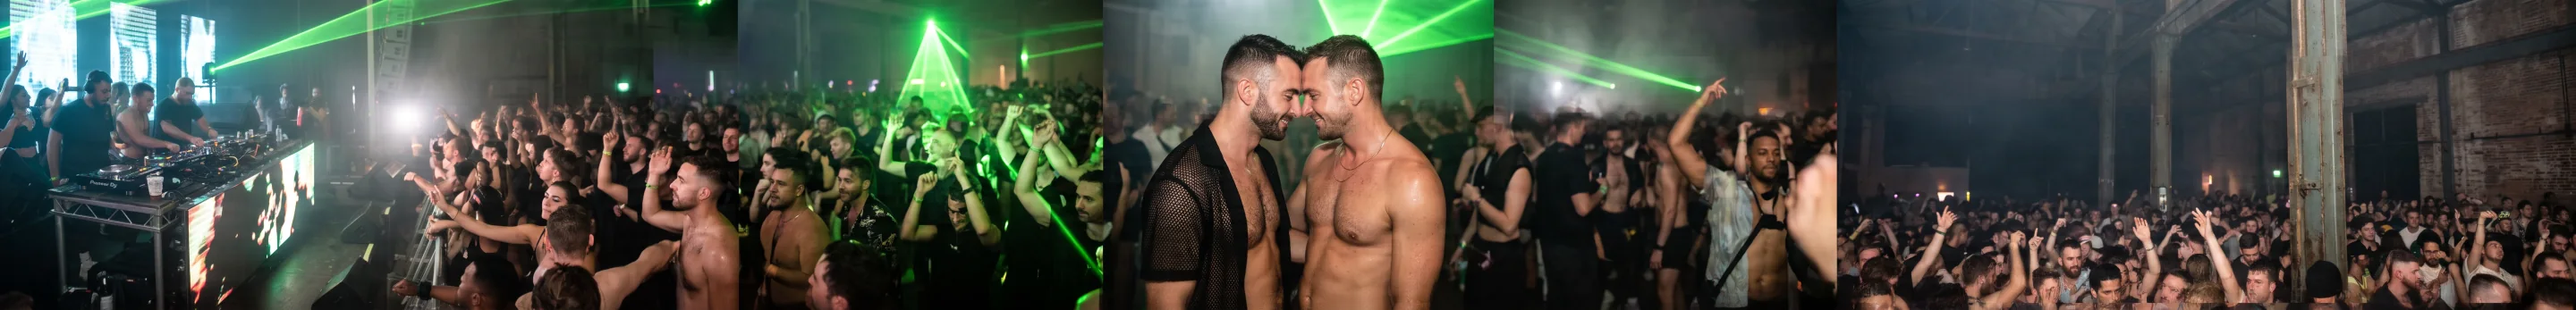
Así se ve un resultado pegado: 8:1, 2k. Cada panel tiene su propia iluminación y su propia multitud, con costuras verticales marcadas entre ellos.
Los marcos altos fueron peor. En 1:8 y 1k el modelo devolvió seis tomas apiladas de la misma escena de playa (352 x 2928); en 1:8 y 2k un paisaje de montaña volvió como un panorama horizontal girado de lado (704 x 5856).
Prueba posterior de 69 ejecuciones. Más tarde, el 7 de octubre, generamos otros 69 marcos anchos y altos. Que un marco 8:1 o 4:1 salga pegado depende de las personas: los paisajes y las multitudes lejanas se mantuvieron unidos, mientras que las personas cerca de la cámara o repartidas a lo ancho salieron pegadas más o menos la mitad de las veces. Entre todas nuestras ejecuciones 8:1 de ese día, 10 de 35 volvieron pegadas. En 1:4 y 1:8 funciona un sujeto que ya es alto: el 1:4 se mantuvo unido 8 de 8 veces y el 1:8 11 de 14. Los detalles completos y los prompts están en nuestra guía de prompts para panoramas y banners.
Qué hacer:
- Describe una sola escena continua. Dilo desde las primeras palabras (“one continuous ultra-wide panoramic photograph, a single unbroken scene from edge to edge”) y deja que un único entorno llene el ancho en lugar de colocar puntos de referencia separados en cada extremo.
- Revisa cada resultado ancho a tamaño completo en busca de costuras verticales o de un cambio brusco de iluminación antes de usarlo.
- Mantén a las personas pequeñas o en un solo lugar en los marcos 8:1 y 4:1. Las personas cerca de la cámara o repartidas a lo ancho fueron lo que inclinó nuestras ejecuciones posteriores hacia el pegado.
- En 1:4 y 1:8, usa un sujeto que ya sea alto (una figura de pie, una torre, una cascada). Consulta la guía de panoramas.
Tamaños, velocidad y precio
Los parámetros, una línea cada uno:
prompt: hasta 5000 caracteres.aspect_ratio: 14 opciones de 1:1 a 8:1 y 1:8;16:9predeterminado en texto a imagen,autoen edición.resolution:1k(predeterminado),2ko4k.output_format:png(predeterminado) ojpeg. En 1k 21:9 el JPEG pesó 307 KB y el PNG unos 1,1 MB.enable_web_searchyenable_image_search: ambos desactivados de forma predeterminada.image_urls(solo edición): de 1 a 14 imágenes de origen.
Tamaños de salida que medimos:
| Nivel | Relación | Tamaño (píxeles) |
|---|---|---|
| 1k | 1:1 | 1024 x 1024 |
| 1k | 3:4 | 896 x 1200 |
| 1k | 21:9 | 1584 x 672 |
| 1k | 1:8 | 352 x 2928 (seis tomas apiladas) |
| 2k | 3:4 | 1792 x 2400 |
| 2k | 2:3 | 1696 x 2528 |
| 2k | 4:5 | 1856 x 2304 |
| 2k | 16:9 | 2752 x 1536 |
| 2k | 21:9 | 3168 x 1344 |
| 2k | 4:1 | 4128 x 1024 |
| 2k | 8:1 | 5856 x 704 |
| 2k | 1:8 | 704 x 5856 (un paisaje girado de lado) |
| 4k | 1:1 | 4096 x 4096 |
El tiempo del modelo en nuestras pruebas del 7 de octubre fue de unos 10 a 35 segundos en 1k y 2k, y de hasta aproximadamente un minuto en 4k.
Se cobra por imagen según el nivel de tamaño (2k cuesta más que 1k, 4k más que 2k); la relación de aspecto y el formato de salida no cambian el precio. En SpicyAPI, Nano Banana 2.1 parte de un precio muy por debajo del precio de lista de Google; la página del modelo muestra los precios actuales. Cada opción de búsqueda suma un cargo. Los rechazos son gratis; una imagen suavizada se cobra como cualquier otra. Haz borradores en 1k y vuelve a ejecutar las buenas en 2k o 4k.
Hasta dónde llega el contenido
Nano Banana 2.1 sigue la política de contenido de Google; SpicyAPI no añade ningún filtro propio. El 7 de octubre de 2026 hicimos dos rondas solo con adultos y revisamos cada imagen a simple vista: una primera ronda de prompts de texto a imagen en 3:4 y 1k, y luego seis tipos de prueba ejecutados tres veces cada uno en texto a imagen y en edición, con los ajustes predeterminados. La tabla muestra el segundo conjunto.
| Nivel | Qué abarca | Texto a imagen (3 ejecuciones) | Edición (3 ejecuciones) |
|---|---|---|---|
| L1 Sugerente | Lencería, un tirante que se desliza | 3 generadas como se pidió | 3 rechazadas (un cambio a lencería) |
| L2 Temas maduros | Contenido atrevido | 2 suavizadas (de espaldas o cubiertas), 1 rechazada | 3 completadas y cobradas, pero con la persona vestida de nuevo con un suéter o una camisa |
| L3 Fuerte | Contenido fuerte | 3 suavizadas (vestidas de nuevo con camisa y pantalones) | 3 rechazadas |
| L4 Intenso | Una escena íntima entre dos adultos | 3 suavizadas (abrazados bajo las sábanas) | 3 rechazadas |
| L5 Extremo | Ataduras consentidas entre adultos, o gore cinematográfico | Ataduras: 3 rechazadas. Gore: 3 rechazadas | Ataduras: 3 rechazadas. Gore: 3 generadas |
En texto a imagen, el nivel L1 es realmente utilizable para moda, trajes de baño y trabajos de estilo boudoir. Estas tres vienen de nuestra primera ronda:
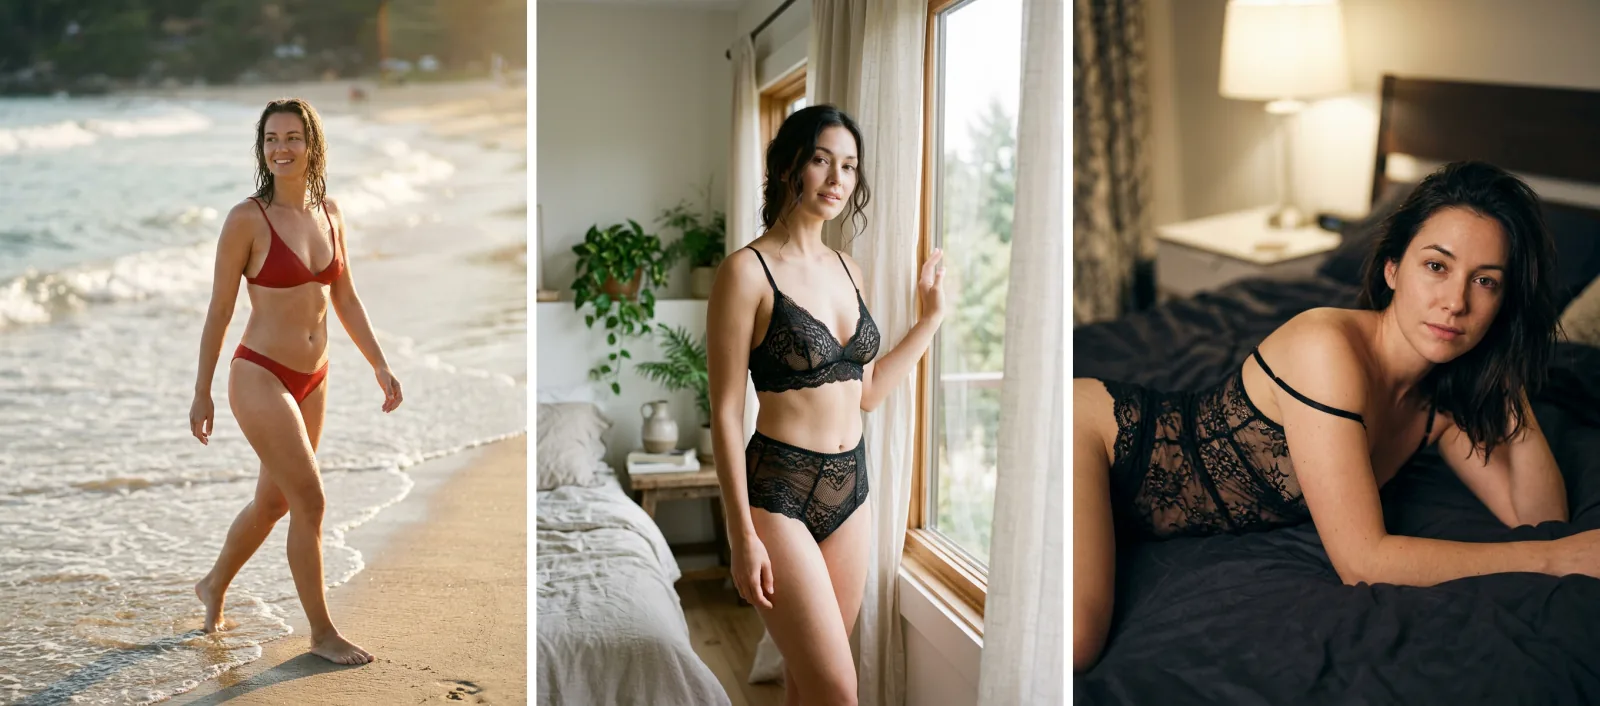
Texto a imagen, 3:4, 1k. Los tres prompts de L1 Sugerente, cada uno generado como se pidió.
Por encima de L1, el texto a imagen normalmente no rechaza; cambia la imagen. En nuestra primera ronda, diez solicitudes de L2 a L4 (dos ejecuciones de cada uno de cinco prompts) terminaron, se cobraron y devolvieron una imagen con ropa: la mujer con un suéter grande o con cárdigan y vaqueros, el hombre con camiseta y vaqueros, la escena de ducha envuelta en una toalla, la pareja abrazada bajo las sábanas. En el segundo conjunto, una ejecución de L2 fue rechazada de plano, y las ataduras y el gore fueron rechazados todas las veces. Con una imagen suavizada, la única forma de saberlo es mirarla.
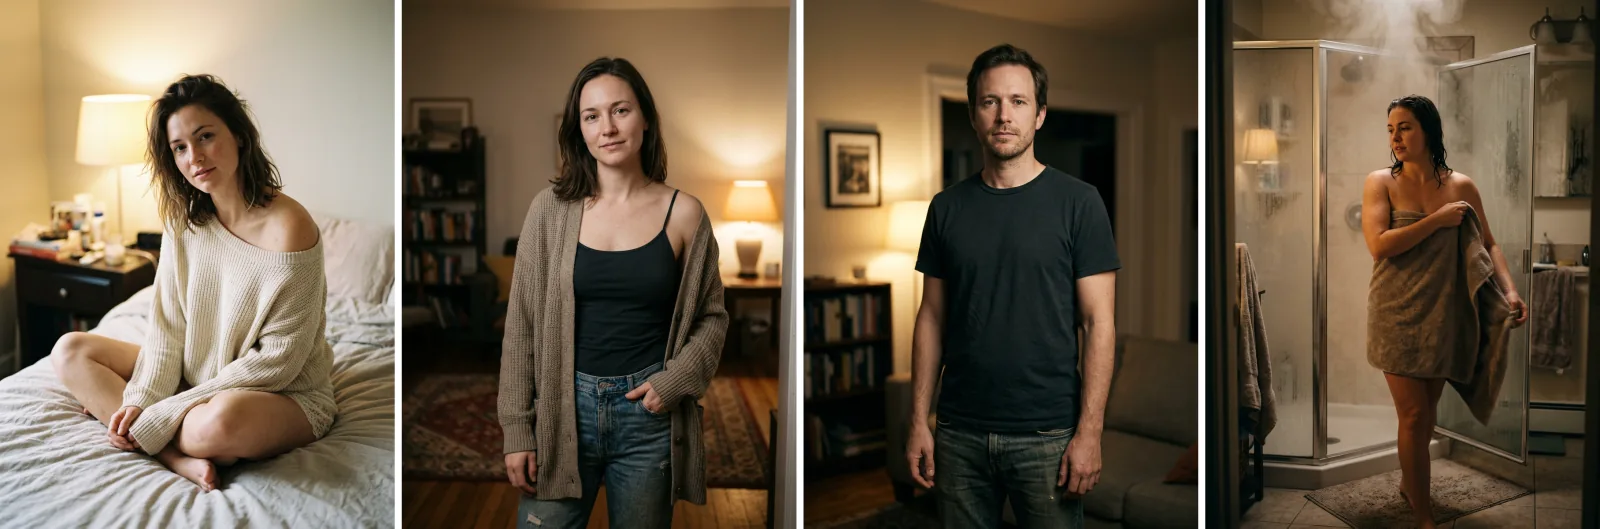
Primera ronda, lo que volvió para las solicitudes de L2 y L3: cada una terminó y se cobró, y nada en la respuesta indica que se modificó. El resultado de L4 se describe arriba y no se muestra.
La tarea de edición, con nuestras propias fotos de origen vestidas, rechaza más. Cambiar un vestido por lencería y las dos ediciones para quitar ropa de nuestra primera ronda fueron rechazados con “Content flagged as potentially sensitive”, igual que las pruebas de L3, L4 y ataduras del segundo conjunto. Pasaron dos tipos de solicitud: las ediciones de L2 volvieron completadas y cobradas pero con la persona vestida de nuevo con un suéter o una camisa, y el gore cinematográfico se generó como se pidió. También pasó una edición de vestido de gala sin espalda; el ejemplo de la ópera de arriba es una edición de ese tipo.
Qué significa en la práctica:
- Una imagen suavizada es el fallo silencioso. La tarea dice completada y pagas, tanto en texto a imagen como en las ediciones de L2, así que revisa cada resultado antes de que llegue a un cliente o a un feed.
- Los rechazos son visibles y gratuitos. En ambas tareas vuelven como fallidos con “Content flagged as potentially sensitive” tras unos 70 a 90 segundos, y no se cobran.
- Ningún ajuste lo cambia. Ningún parámetro público controla el contenido, y Nano Banana 2 y Pro tienen el mismo editor; nuestra anterior prueba de contenido de Nano Banana 2 explica cómo trataron solicitudes similares.
¿Qué modelo elegir?
El 7 de octubre de 2026 pasamos Nano Banana 2.1 por nuestra propia prueba a ciegas, con las mismas preguntas y los mismos anclajes de referencia que nuestros lotes de imagen anteriores; tres jueces de IA de distintos fabricantes puntuaron las imágenes a ciegas.
| Prueba a ciegas | Nano Banana 2.1 | Nano Banana Pro | Nano Banana 2 |
|---|---|---|---|
| Puntuación global (sobre 100) | 75.6 | 74.4 | 70.3 |
| Fecha de medición | 7 de octubre de 2026 | 5 de octubre de 2026 | 5 de octubre de 2026 |
Las subpuntuaciones de Nano Banana 2.1 fueron 76.7 en fidelidad al prompt (14 preguntas), 77.8 en calidad de imagen (14) y 65.9 en consistencia de edición (6 preguntas de edición). Dónde falló: dibujó seis globos cuando se pedían cinco y siete comensales cuando se pedían seis, y en las ediciones cambió el fondo por una calle nocturna en una tarea de reiluminación y acercó la cámara en una tarea de nevada. Las dos preguntas de texto salieron bien escritas; no publicamos una subpuntuación de texto porque la prueba tenía menos de seis preguntas de texto. Si importa una cantidad exacta, compruébala, y en las ediciones di sin rodeos que el fondo y el encuadre deben seguir igual.
La tabla combina estas cifras con nuestras ejecuciones prácticas.
| Tu trabajo | Elige | Por qué |
|---|---|---|
| Carteles, portadas, letreros o infografías donde las palabras tienen que ser correctas | Nano Banana 2.1 | Cada línea entre comillas salió escrita tal cual en nuestras pruebas |
| Una persona o un producto llevados a una escena nueva | Nano Banana 2.1 edición | Hasta 14 orígenes; el rostro, el color de la chaqueta, los broches y los bolsillos se conservaron en nuestra prueba con tres orígenes |
| Imágenes que dependen de la fecha de hoy o de datos de actualidad | Nano Banana 2.1 con enable_web_search | Imprimió la fecha correcta con la búsqueda activada; inventó una sin ella |
| El tamaño de borrador más pequeño | Nano Banana 2 | Tiene un nivel de borrador de 0.5k; la 2.1 empieza en 1k |
| Un flujo ya ajustado en Nano Banana Pro | Nano Banana Pro y luego prueba la 2.1 con tus propios prompts | Una pequeña diferencia en la prueba a ciegas (75.6 frente a 74.4) |
| Banners anchos de hasta 8:1 | Nano Banana 2.1, con el prompt como una sola escena continua | Paisajes y multitudes lejanas se mantuvieron unidos; personas cerca de la cámara o a lo ancho salieron pegadas más o menos la mitad de las veces (10 de 35 ejecuciones 8:1 ese día). Los 1:4 y 1:8 funcionan con sujetos altos. Consulta la guía de panoramas |
| Imágenes para adultos de L2 en adelante | Las familias de imagen sin censura de SpicyAPI | La política de Google las suaviza o las rechaza casi siempre, en ambas tareas |
Nano Banana 2.1 frente a Nano Banana 2. Google describe la 2.1 como una actualización directa, y nuestra prueba a ciegas coincide en la dirección (75.6 frente a 70.3). Empieza los trabajos nuevos con la 2.1; quédate en Nano Banana 2 si dependes de su nivel de borrador de 0.5k o si aún no quieres volver a probar un flujo que ya funciona.
Nano Banana 2.1 frente a Nano Banana Pro. Google llama a la 2.1 la versión más eficiente de Pro, y obtuvo una puntuación algo mayor en nuestra prueba a ciegas (medida con dos días de diferencia). La diferencia es pequeña, así que si tienes prompts de Pro en los que confías, pásalos por la 2.1 y compara antes de cambiar.
Para trabajo adulto, elige otra base. Nano Banana 2.1 encaja en la parte vestida y de cara al público de un proyecto: carteles promocionales, fichas de personaje, escenas de producto, moda de nivel lencería. Para L2 en adelante, abre el catálogo de modelos de SpicyAPI, filtra por política de contenido y elige por tarea una familia de imagen sin censura. Trabaja solo con adultos ficticios o con adultos que hayan dado su permiso.
Preguntas frecuentes
¿Nano Banana 2.1 es un modelo sin censura?
No. Sigue la política de contenido de Google. En nuestras pruebas del 7 de octubre de 2026, el texto a imagen generó L1 Sugerente, suavizó casi siempre de L2 a L4 (una ejecución de L2 fue rechazada) y rechazó ataduras y gore. La edición rechazó la mayoría de las solicitudes para adultos, vistió de nuevo las de L2 y generó gore cinematográfico.
¿Por qué recibí una imagen con ropa en lugar de un error?
El texto a imagen normalmente completa las solicitudes que pasan la línea de Google con una imagen suavizada y sin mensaje de rechazo, cobrada como cualquier otra imagen; la tarea de edición hizo lo mismo con las solicitudes de L2. Revisa cada resultado a simple vista.
¿Se me cobra cuando Nano Banana 2.1 rechaza una solicitud?
No. Los rechazos en cualquiera de las dos tareas vuelven como fallidos con “Content flagged as potentially sensitive”, normalmente tras unos 70 a 90 segundos, y no se cobran. Una solicitud que el modelo suaviza sí se cobra, porque aun así devuelve una imagen.
¿Cuántas imágenes de referencia puedo usar en una edición?
Entre 1 y 14, en image_urls, en el orden al que se refiere tu prompt. Google dice que mantiene consistentes hasta 4 personajes y hasta 10 objetos; en nuestra prueba con tres orígenes se conservaron el rostro y los detalles de la chaqueta.
¿Cuándo debo activar la búsqueda web?
Cuando la imagen depende de información actual. Con enable_web_search activado, nuestro cartel del pronóstico de Tokio imprimió la fecha correcta; con la opción desactivada, el modelo inventó una. Cada opción de búsqueda suma un cargo por solicitud.
¿Qué resolución debo usar?
Haz borradores en 1k y vuelve a ejecutar las buenas en 2k o 4k. Cada paso cuesta más, y el tiempo del modelo fue de unos 10 a 35 segundos en 1k y 2k frente a hasta aproximadamente un minuto en 4k.