Google wydał Nano Banana 2.1 6 października 2026 roku, a jego zapowiedź celuje w zadania, przy których modele obrazu zwykle zawodzą: winieta magazynu, tytuł filmu, szyld w tle. Zanim przeniesiesz na niego potok plakatów, reklam lub postaci, potrzebujesz trzech odpowiedzi: czy obietnica dotycząca tekstu się sprawdza, czy edycje zachowują osobę, od której zaczynasz, i jak daleko pozwala zajść polityka treści Google, zanim model po cichu zmieni twój obraz?
Nano Banana 2.1 to model obrazu Google, po który warto sięgnąć, gdy słowa na obrazie muszą się zgadzać. W naszych testach z 7 października 2026 roku każda linia ujęta w podwójny cudzysłów wyszła napisana tak, jak podano, edycje z wielu obrazów przeniosły twarze i szczegóły produktu do nowych scen, a wyszukiwanie w sieci poprawiło datę, którą model w przeciwnym razie zmyślał. To nie jest model bez cenzury. Obrazy na poziomie bielizny zostały oddane w tekst na obraz, ale żądania od L2 do L4 wracały w większości ukończone, rozliczone i po cichu złagodzone, skrępowanie i gore zostały odrzucone, a zadanie edycji odrzuciło większość żądań dla dorosłych. Szerokie banery trzymały się w całości przy pejzażach i dalekich tłumach, ale przy ludziach blisko kamery wracały zszyte mniej więcej co drugi raz, a wysokie kadry 1:8 działały tylko dla motywów, które same są wysokie.
Wszystkie testy przeprowadziliśmy przez stronę rodziny Nano Banana 2.1 w SpicyAPI, gdzie model ruszył 7 października 2026 roku. Deklaracje samego Google przytoczone poniżej pochodzą z jego dokumentacji modelu.
W skrócie
| Nano Banana 2.1 (test z 7 października 2026) | |
|---|---|
| Wydawca i premiera | Google, 6 października 2026; kod modelu Google to gemini-nano-banana-2.1 |
| Czym jest | Aktualizacją Nano Banana 2 (Gemini 3.1 Flash Image); Google nazywa go bardziej efektywnym odpowiednikiem Nano Banana Pro |
| Nazwy modeli w API | google/nano-banana-2.1/text-to-image i google/nano-banana-2.1/edit |
| Wejścia | prompt do 5000 znaków; edycja przyjmuje od 1 do 14 obrazów źródłowych |
| Rozmiary | 1k (domyślnie), 2k, 4k; 14 proporcji od 1:1 do 8:1 i 1:8 |
| Wyjście | Jeden obraz PNG (domyślnie) lub JPEG na żądanie |
| Szybkość w naszych testach | Około 10–35 sekund w 1k i 2k, do około minuty w 4k (czas modelu) |
| Tekst w naszych testach | Każda linia w cudzysłowie wyszła napisana tak, jak podano; drobny druk, którego nie wpisaliśmy, wrócił jako wypełniacz |
| Treści w naszych testach | Obowiązuje polityka Google. Tekst na obraz: L1 oddany, L2–L4 w większości złagodzone bez ostrzeżenia (rozliczone), skrępowanie i gore odrzucone. Edycja: większość żądań dla dorosłych odrzucona, L2 z osobą ponownie ubraną (rozliczone), filmowy gore oddany |
| Niedostępne | Seed, prompt negatywny, kilka obrazów na żądanie, maska, poziom szkicu 0.5k |
| Ślepy test (7 października 2026) | 75.6 / 100: zgodność z promptem 76.7, jakość obrazu 77.8, spójność edycji 65.9. Te same pytania: Nano Banana Pro 74.4, Nano Banana 2 70.3 (oba 5 października 2026) |
| Cena | Za obraz według poziomu rozmiaru, od ceny wyraźnie niższej niż cennik samego Google; każda opcja wyszukiwania dolicza opłatę |
Czym jest Nano Banana 2.1
Google mówi, że Nano Banana 2.1 to „aktualizacja Nano Banana 2 (Gemini 3.1 Flash Image)”, która „zachowuje szybkość i efektywność kosztową Flash, przynosząc istotną poprawę jakości wizualnej, zgodności z promptem, spójności postaci między turami i renderowania tekstu”. Nazywa go też „bardziej efektywnym odpowiednikiem Gemini 3 Pro Image (Nano Banana Pro)”. Do kluczowych nowości Google zalicza lepszy układ infografik, usunięte szwy przy szerokich i panoramicznych proporcjach w 2K i 4K, do 14 obrazów referencyjnych (z zachowaniem spójności do 4 postaci i 10 obiektów) oraz oparcie na Google Web Search i Image Search. Poniższe sekcje sprawdzają te deklaracje na tym, co wróciło.
Renderowanie tekstu: główna poprawa się sprawdza
To powód, by wypróbować model, i deklaracja, która sprawdziła się najlepiej. Poprosiliśmy o osiem linii napisów w trzech promptach tekst na obraz i jednej edycji (okładka magazynu, plakat filmowy, neon motelu i okładka albumu, wszystkie pokazane w tym artykule), a każda linia w podwójnym cudzysłowie wyszła napisana tak, jak podano.
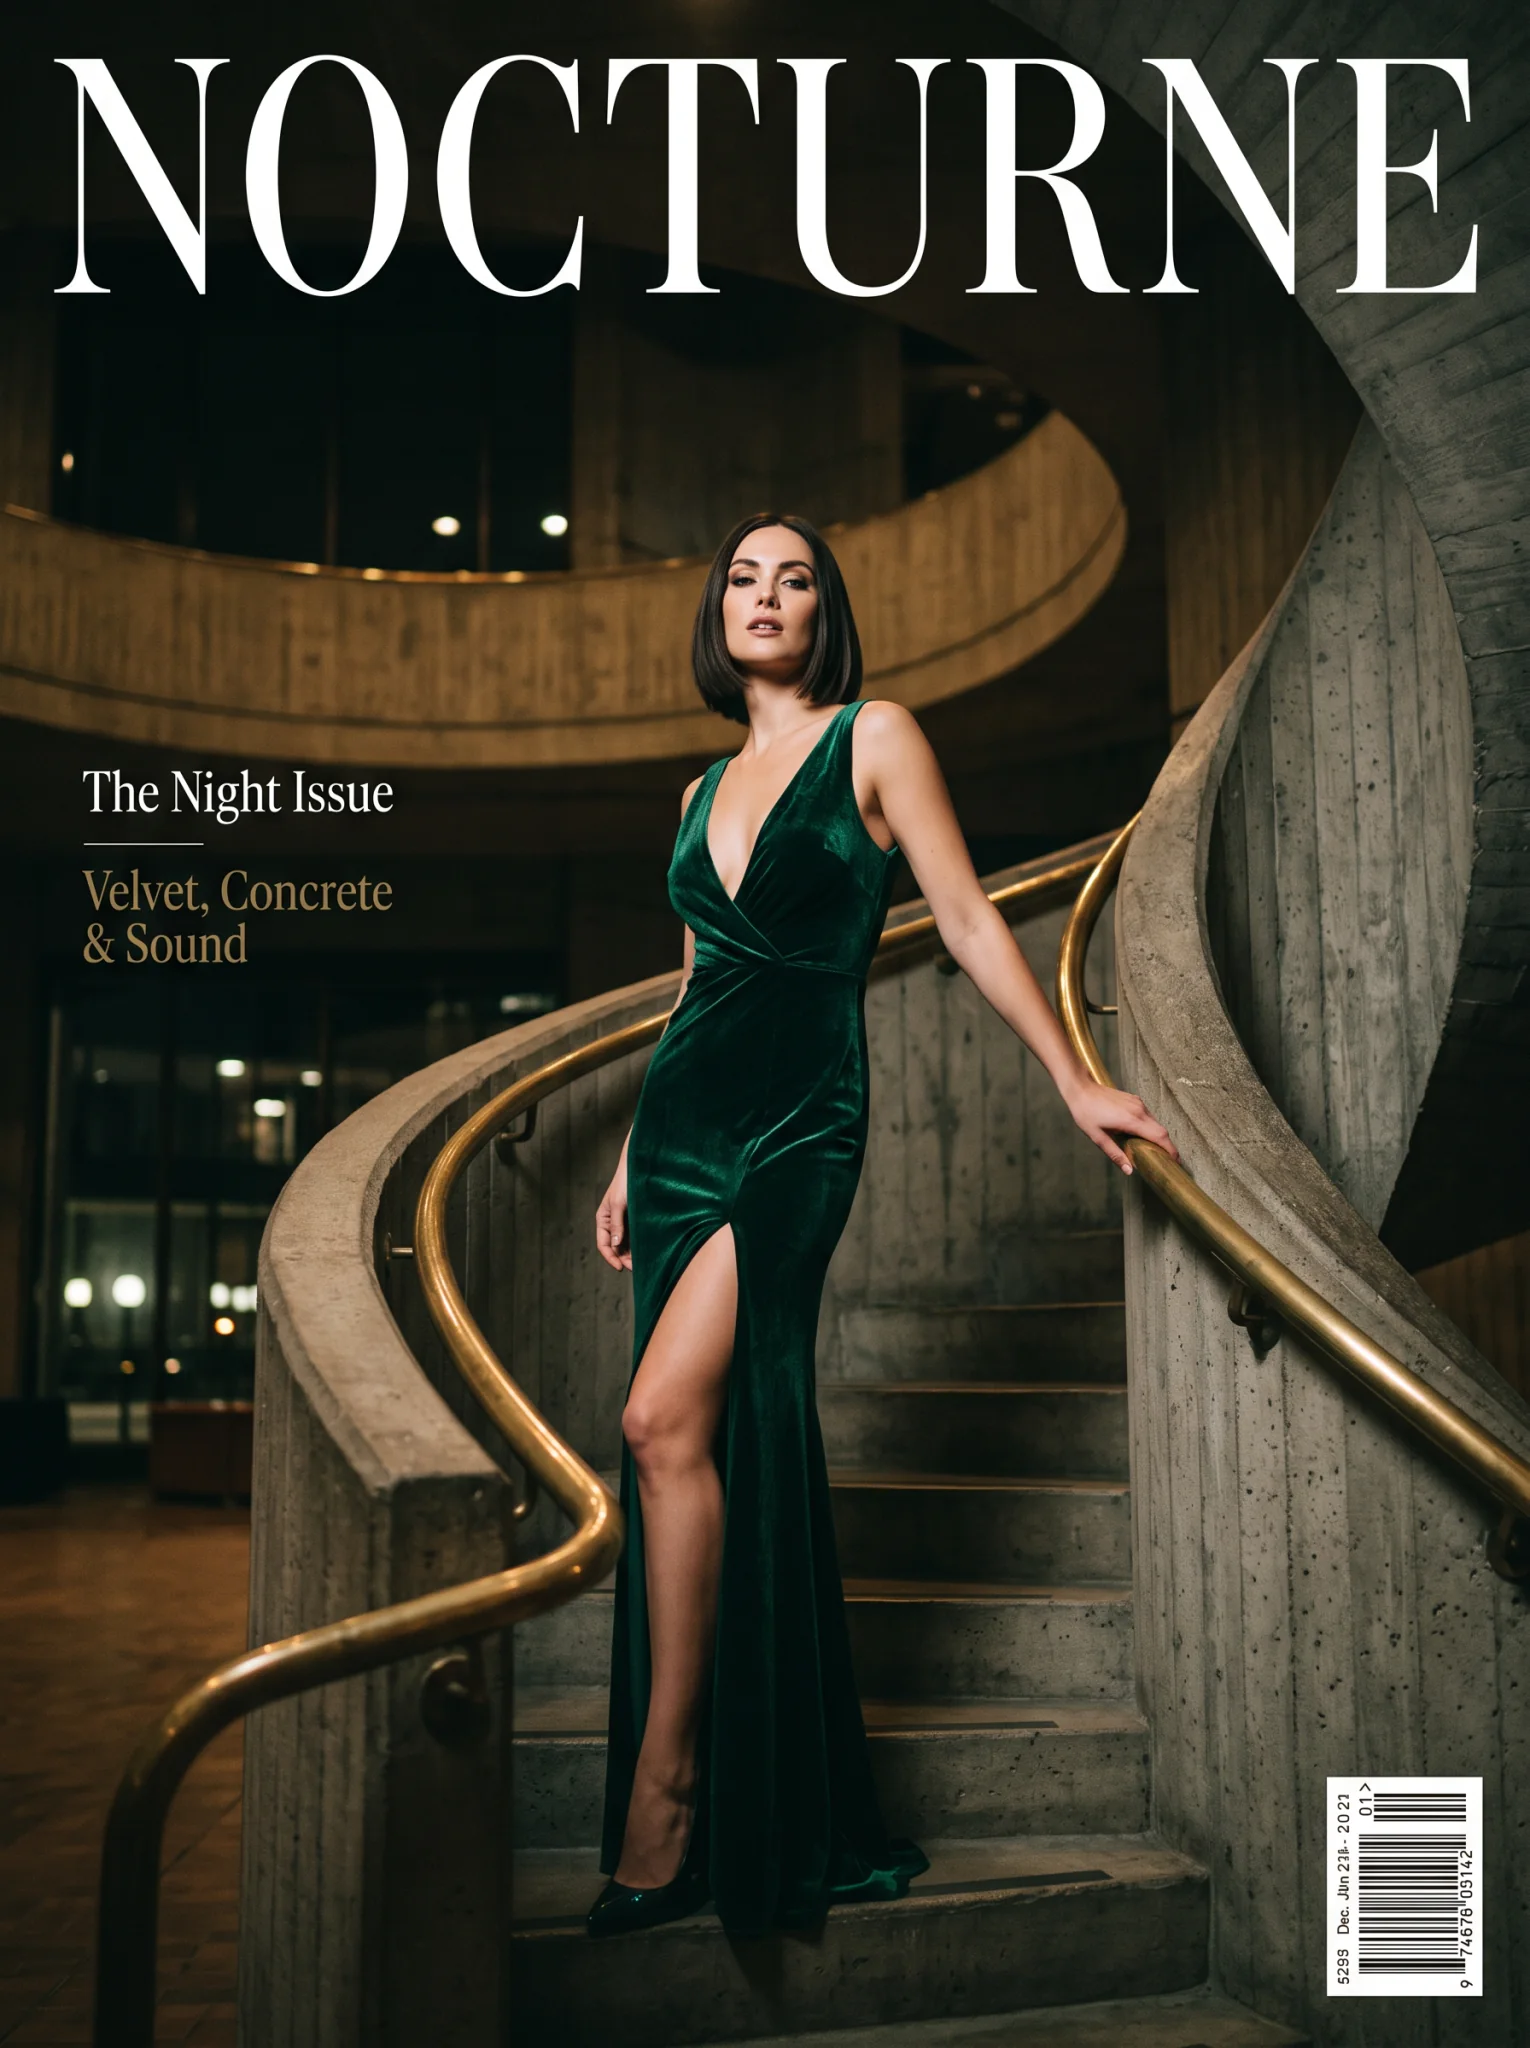
Tekst na obraz, 3:4, 2k. Winieta i oba hasła okładkowe są napisane tak, jak podano. Cyfry kodu kreskowego, których prompt nie wpisywał, to wypełniacz.
Prompt, którego użyliśmy:
Fashion magazine cover photograph. The masthead across the top, in tall elegant serif capitals, reads "NOCTURNE". A woman in her early thirties with a sleek dark bob stands on the curving concrete spiral staircase of a brutalist concert hall at night, wearing a plunging emerald velvet gown with a thigh-high slit, one hand on the brass rail, looking down at the camera. Small cover lines on the left read "The Night Issue" and "Velvet, Concrete & Sound". A small barcode in the lower right corner. Low-key cinematic lighting, deep green and charcoal palette.Otwórz ten prompt w Nano Banana 2.1 tekst na obraz i ustaw aspect_ratio na 3:4 oraz resolution na 2k, aby odtworzyć nasz przebieg; link wypełnia tylko prompt.
Plakat filmowy pokazuje granicę: tytuł i linia premiery są dokładne, ale blok nazwisk, o który poprosiliśmy bez wpisywania jakichkolwiek nazwisk, wyszedł jako przekonująco wyglądający bełkot.
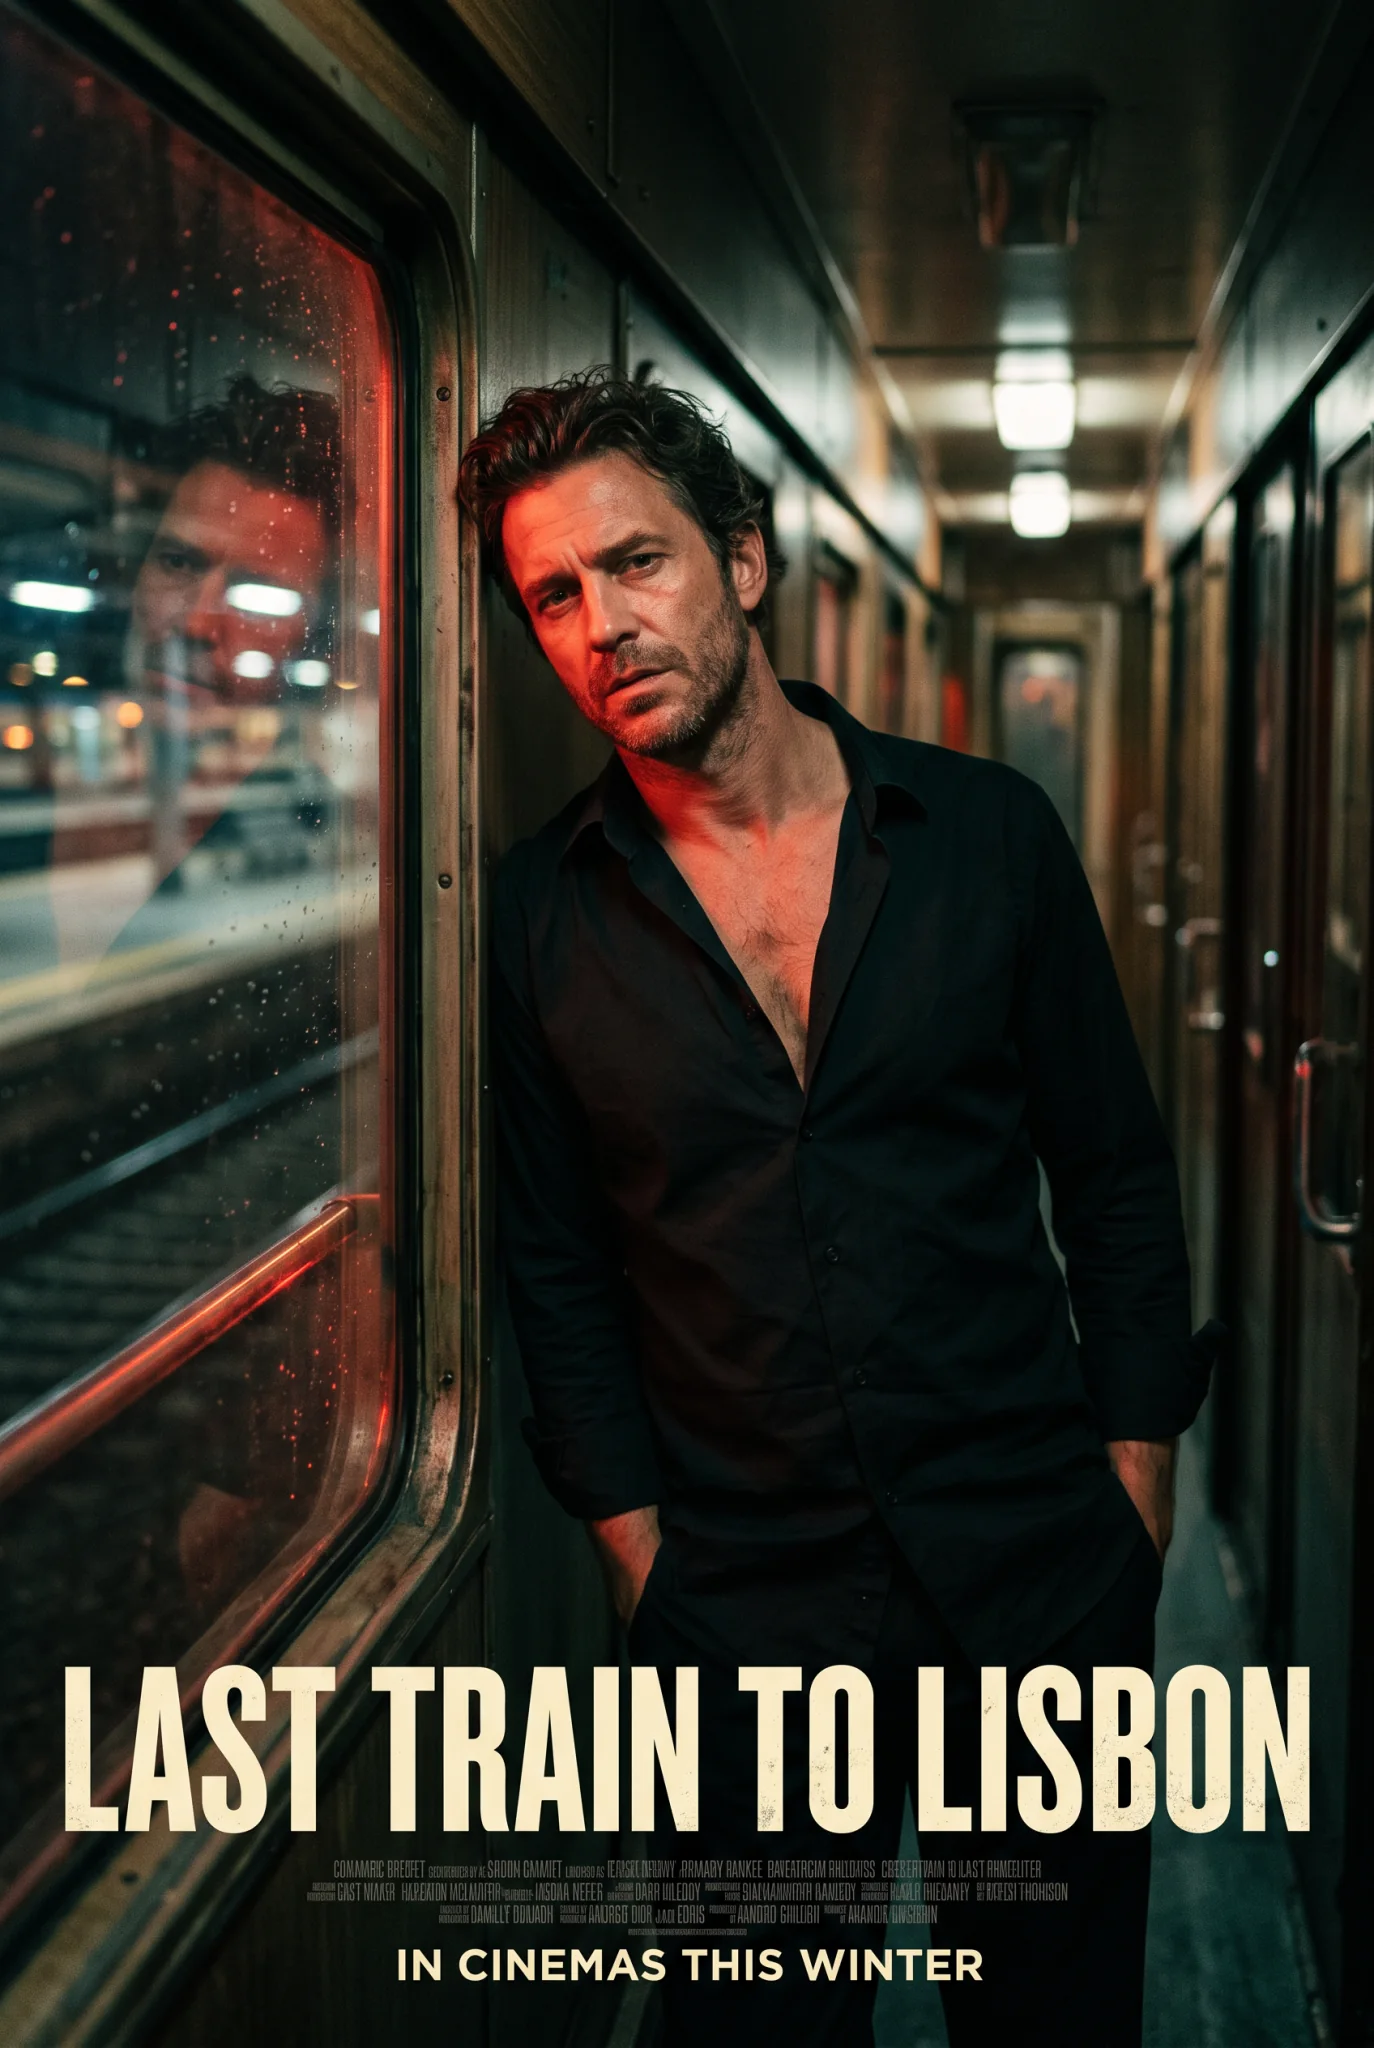
Tekst na obraz, 2:3, 2k. Tytuł i linia premiery dokładne; blok nazwisk między nimi to wypełniacz.
Co to znaczy przy pisaniu promptu z tekstem:
- Ujmij w cudzysłów każde słowo, które ma się pojawić.
- Napisz, gdzie ma stać i jak wyglądać. „Na górze, wysokimi eleganckimi szeryfowymi wersalikami” trafiło dokładnie tam.
- Wpisz literalnie wszystko, co czytelnik ma przeczytać. To, co tylko opisujesz („mały kod kreskowy”, „blok nazwisk”), wraca jako tekstura, więc sprawdź drobny druk przed publikacją.
Pełny przepływ pracy z plakatem i punktowymi poprawkami tekstu znajdziesz w naszym poradniku układu tekstu w Nano Banana Pro; te same nawyki promptowania działają tutaj.
Edycje, które zachowują osobę i produkt
Zadanie edycji przyjmuje od 1 do 14 obrazów źródłowych w image_urls, wymienionych w kolejności, do której odwołuje się twój prompt. Google mówi, że zachowuje spójność do 4 postaci i do 10 obiektów.
Jedno źródło: nowa scena, ta sama twarz
Daliśmy mu dzienne zdjęcie rudowłosej kobiety podlewającej paprocie w szklarni, w białej lnianej koszuli i dżinsowych szortach, i poprosiliśmy o noc w operze.
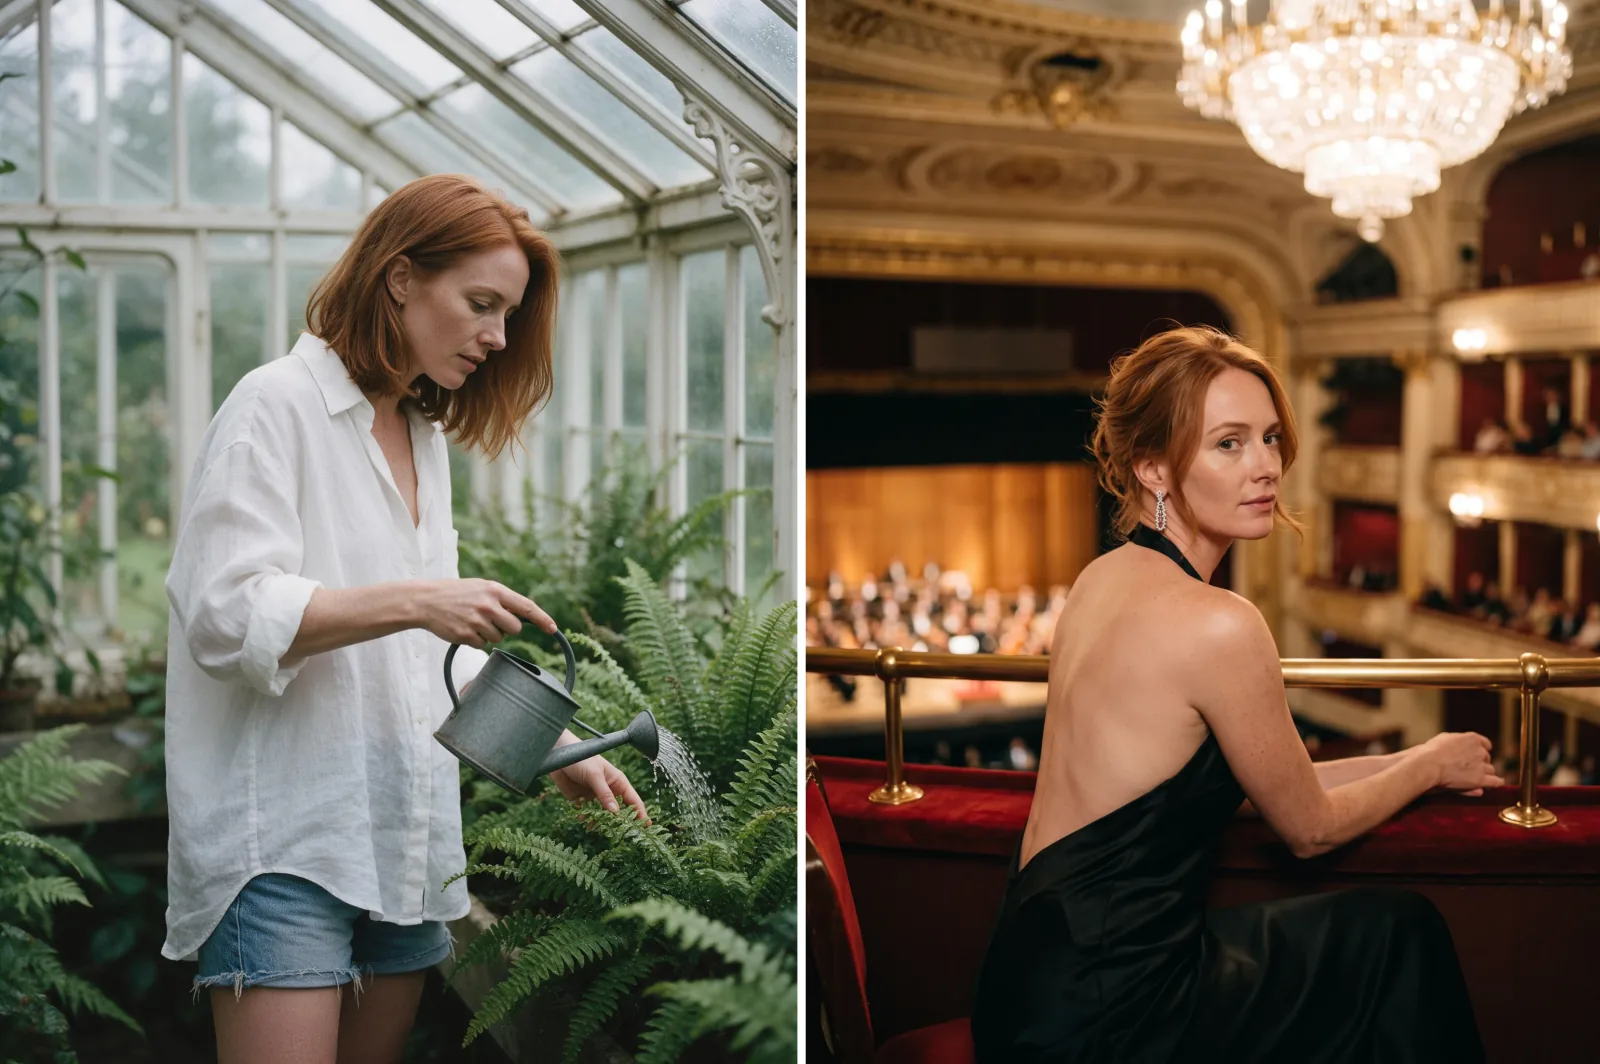
Po lewej: zdjęcie źródłowe. Po prawej: edycja w 2k, proporcje na auto. Twarz i kolor włosów zostały zachowane; suknia, upięte włosy, kolczyki, aksamitna loża, żyrandol i scena zgadzają się z promptem.
Take her from the greenhouse to an opera house at night: she sits in a red velvet box seat, leaning on the gilded balcony rail, wearing a backless black silk gown with her auburn hair pinned up and diamond drop earrings, looking back over her shoulder, the lit stage and a crystal chandelier softly blurred behind her. Keep her face and her hair colour.Ostatnie zdanie ma znaczenie: napisanie, co ma zostać („keep her face and her hair colour”), mówi modelowi, które części źródła są stałe.
Trzy źródła: osoba, produkt i miejsce
To zadanie, które najbardziej interesuje zespoły produktowe. Dostarczyliśmy studyjny portret mężczyzny, zdjęcie produktu, czyli koniakowej zamszowej kurtki koszulowej z mosiężnymi napami, oraz puste obserwatorium nocą.
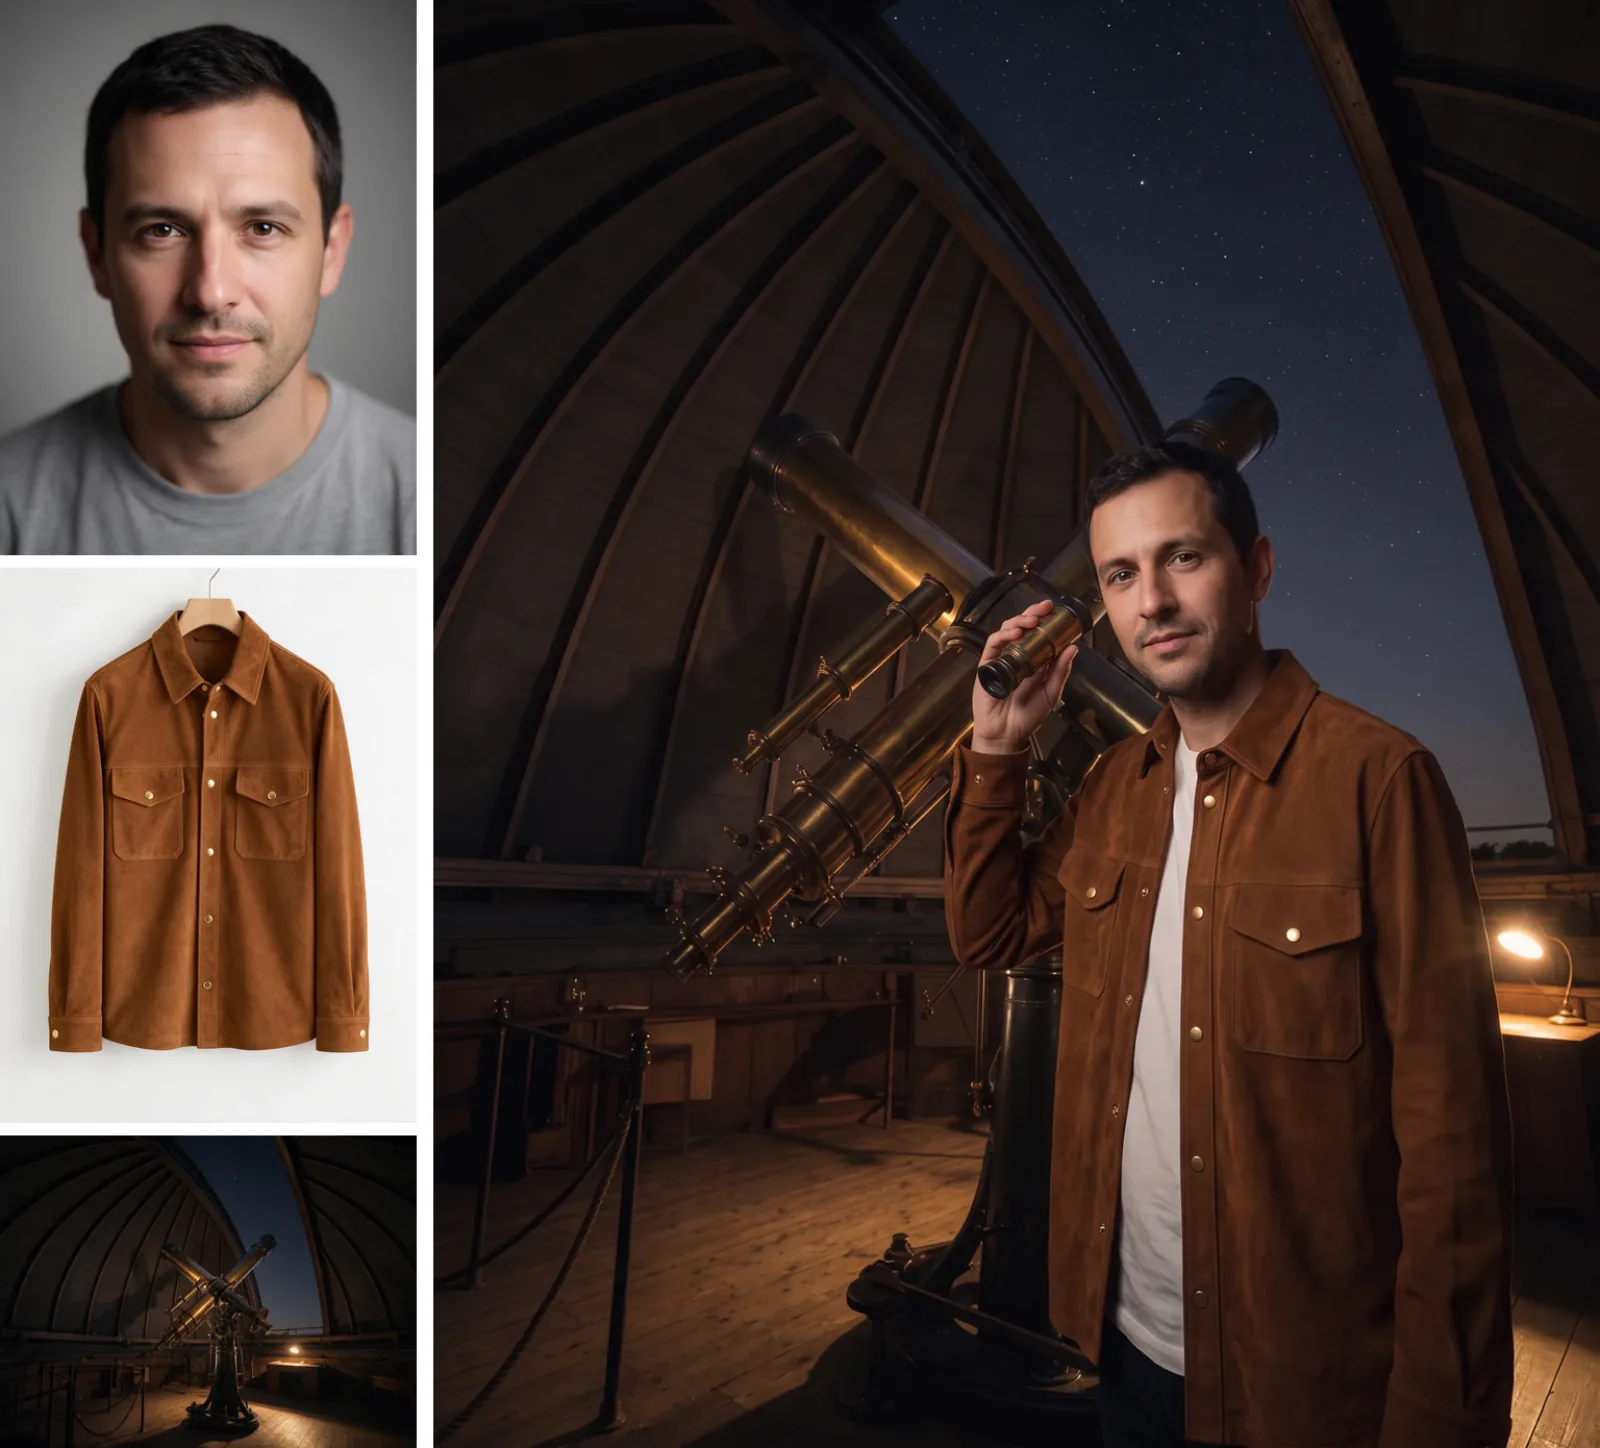
Po lewej: trzy źródła w kolejności promptu. Po prawej: edycja w 4:5, 2k. Twarz, kolor kurtki, mosiężne napy i kieszenie na piersi zostały zachowane. Jedna pomyłka: zamiast ręki na okularze teleskopu trzyma małą mosiężną lunetę.
Combine the three images: the man from the first image wears the cognac suede overshirt from the second image, unbuttoned over a white undershirt, and stands beside the brass telescope in the observatory from the third image at night, one hand on the eyepiece, starlight from the open dome and the warm desk lamp on his face. Keep his face, and keep the jacket's colour, brass snaps and chest pockets exactly.Co zadziałało: odwoływanie się do każdego źródła przez jego pozycję, napisanie, co wziąć z każdego, i wymienienie szczegółów, które muszą przetrwać. Czynność, o której wspomnieliśmy tylko mimochodem, to ta, która się zmieniła, więc ważnej pozie daj osobne zdanie.
Tekst wewnątrz edycji
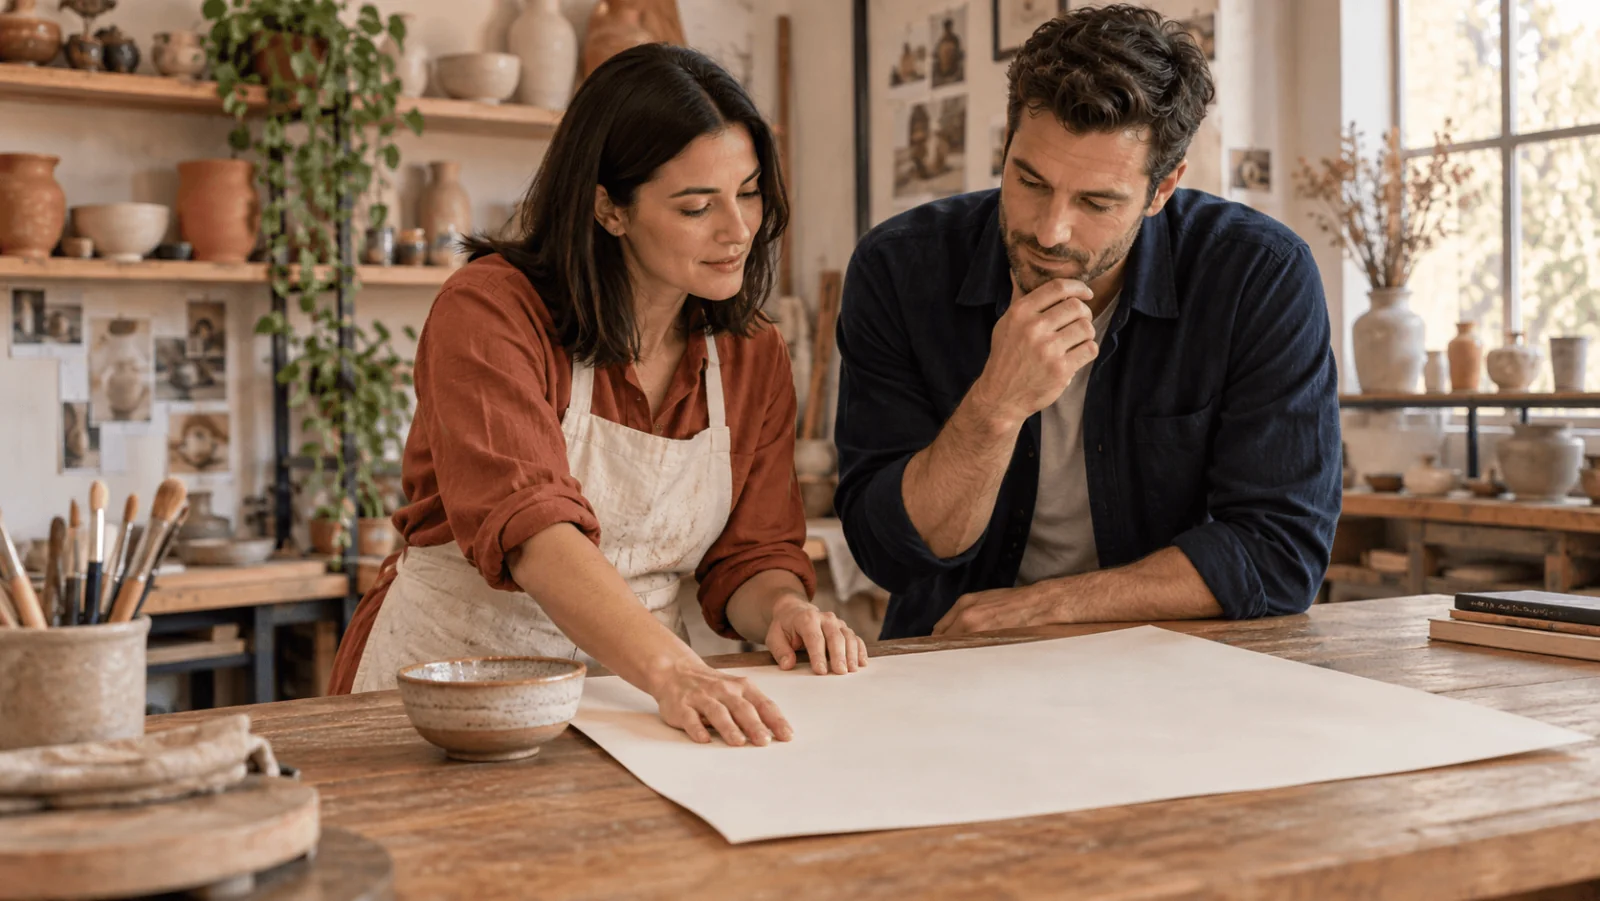
Ostatnia edycja zachowała dwie osoby i sklep dokładnie takimi, jakie są, i zaprojektowała okładkę, którą trzymają w rękach.
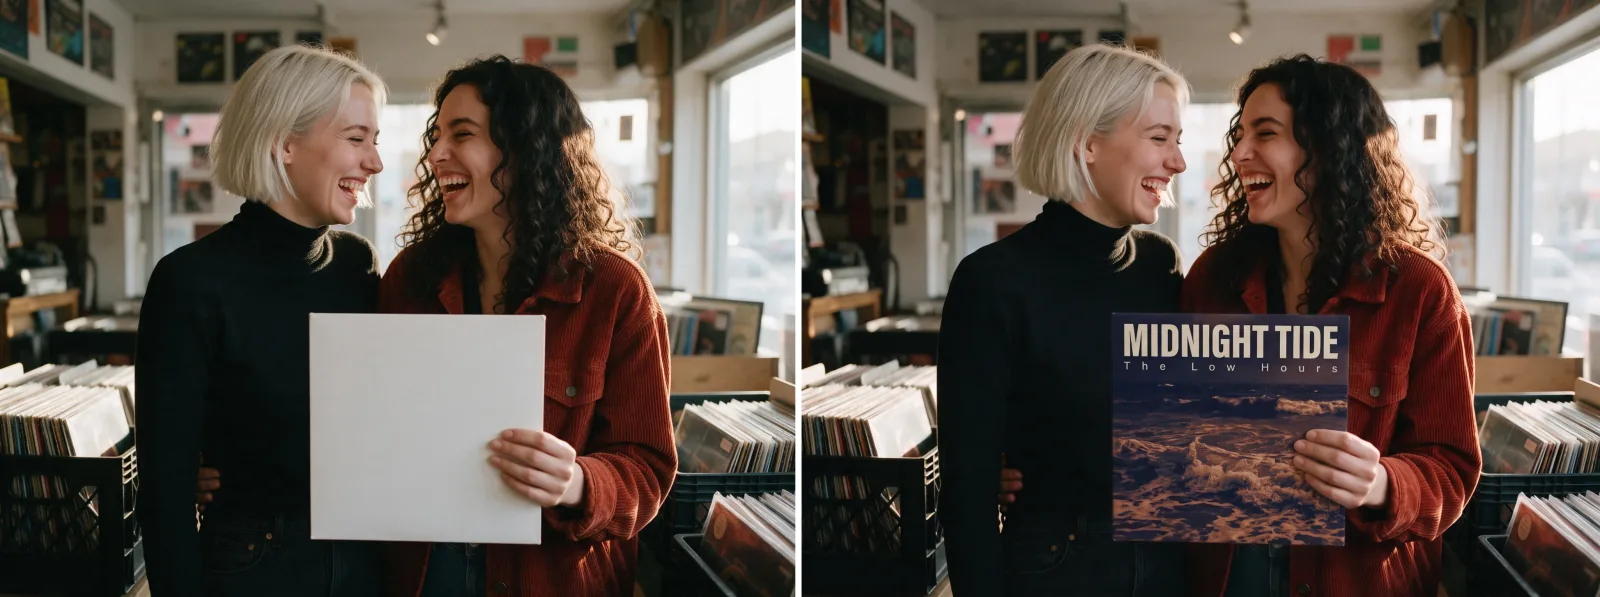
Po lewej: źródło. Po prawej: edycja w 2k. Kobiety, ubrania i sklep bez zmian; tytuł i nazwa zespołu napisane poprawnie, choć nazwa zespołu jest zapisana rozstrzelonymi małymi i wielkimi literami, a nie kapitalikami, o które prosiliśmy.
Design the blank album sleeve she is holding: a moody duotone photograph of ocean waves at night in deep blue and rust, with the title "MIDNIGHT TIDE" in large bold sans serif and the band name "The Low Hours" in small capitals beneath it. Keep both women, their clothes, their pose and the record store exactly as they are.Proporcje w edycjach. Zadanie edycji dodaje auto (domyślnie), które zachowuje kształt źródła: źródło panoramiczne 4:1 wróciło jako 2064 x 512. Przy kilku źródłach o różnych kształtach ustaw proporcje sam. W naszym teście z dwoma źródłami auto po prostu poszło za jednym z nich.
Role źródeł i poprawianie dryfu omawiamy dokładniej w naszym poradniku edycji z referencjami w Nano Banana 2.
Wyszukiwanie w sieci: remedium na daty i aktualne fakty
Uruchomiliśmy ten sam prompt dwa razy:
today's weather forecast poster for Tokyo with the datePrzy włączonym enable_web_search plakat wydrukował poprawną datę, środa, 7 października 2026. Przy wyłączonym model zmyślił datę (24 października). Jeśli obraz zależy od czegokolwiek aktualnego (daty, prognozy, wydarzenia), włącz tę opcję. enable_image_search też zadziałało i zwróciło obraz, ale nie zmierzyliśmy widocznej różnicy. Każda opcja wyszukiwania dolicza opłatę za żądanie, więc w pozostałych przypadkach zostaw obie wyłączone.
Szerokie i wysokie kształty: opisz jedną ciągłą scenę
Google mówi, że wersja 2.1 usunęła artefakty kafelkowania przy 1:4, 4:1, 1:8 i 8:1 w 2K i 4K. W naszych testach z 7 października 2026 roku to, czy szerokie i wysokie kształty trzymały się w całości, zależało od motywu, jak pokazują wyniki poniżej. W 21:9 model skomponował jeden ciągły kadr filmowy:
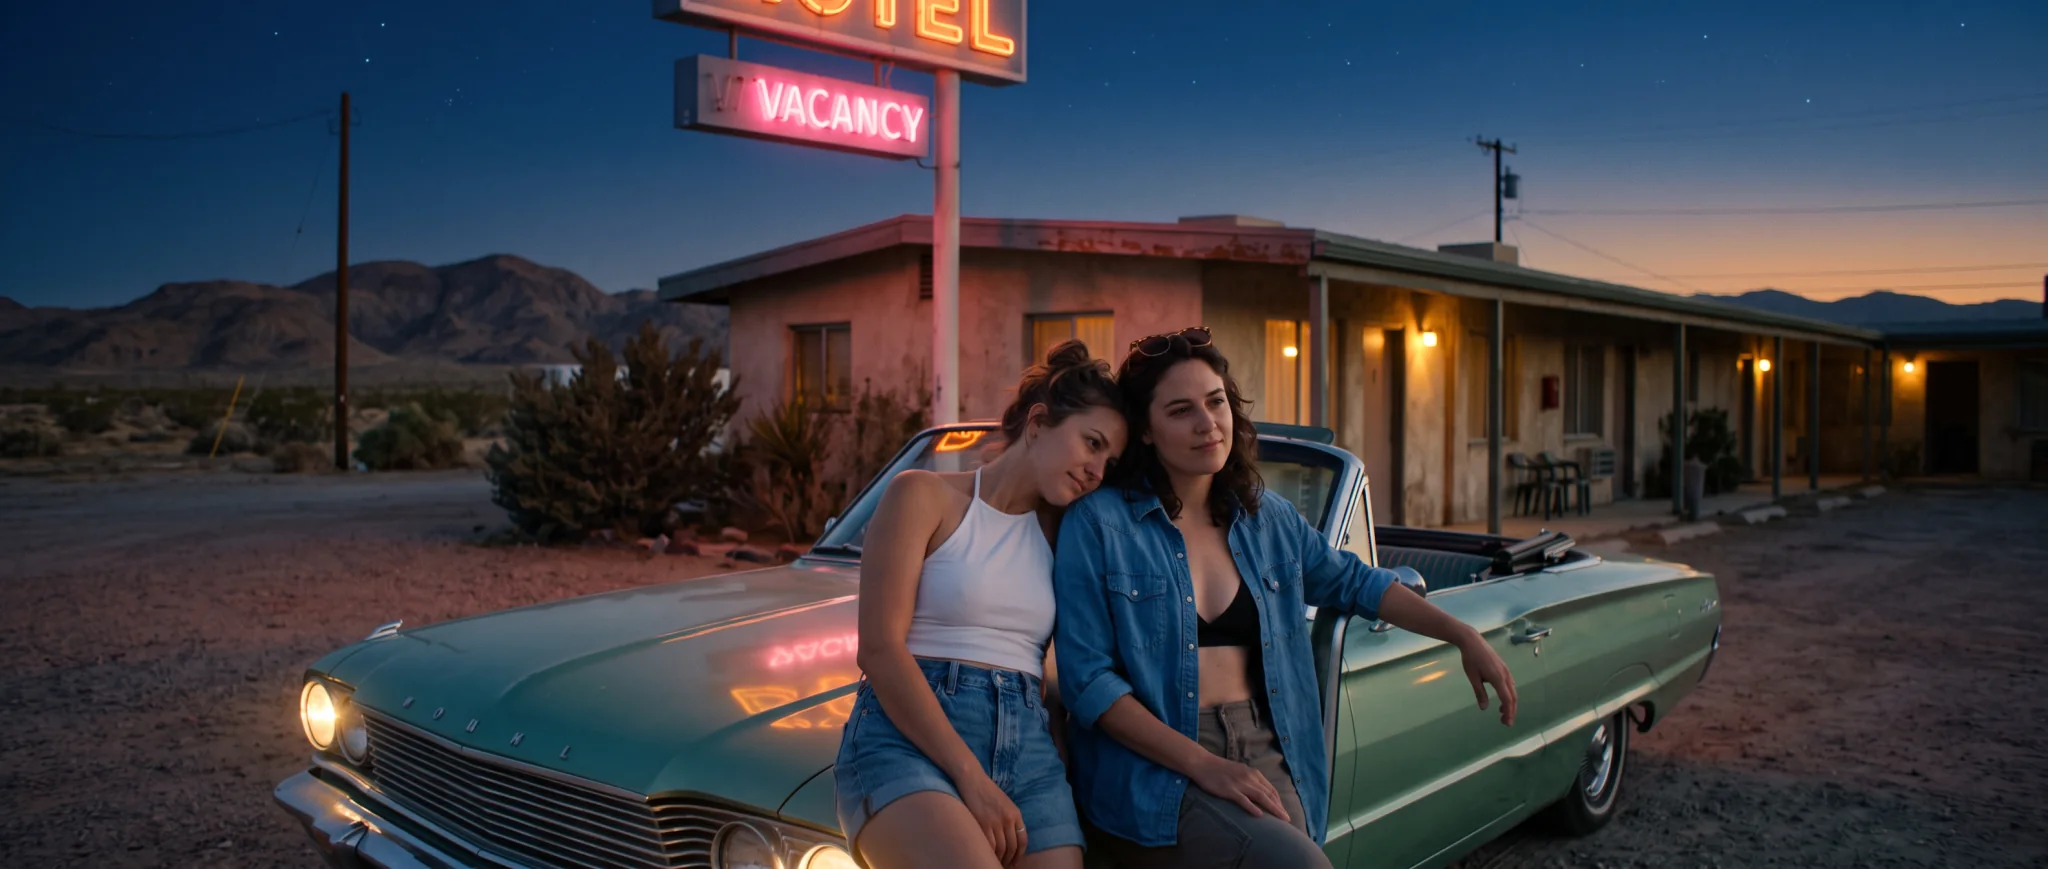
Tekst na obraz, 21:9, 2k. Jeden ciągły kadr; słowo w cudzysłowie „VACANCY” jest napisane tak, jak podano.
Uruchomiliśmy 8:1 sześć razy. Cztery wróciły jako jeden ciągły obraz; dwa wróciły jako kilka ujęć zszytych obok siebie, z wyraźnymi szwami i innym światłem w każdym panelu. Kafelkowanie nadal więc czasem się zdarza przy 8:1 i 2k, mimo poprawki. Różnicę zrobiło sformułowanie. Nasz pierwszy prompt z rave rozmieszczał osobne punkty orientacyjne na szerokości (kabina DJ-a po lewej, stalowe kolumny po prawej, para pośrodku) i wrócił zszyty. Prompty przepisane jako jedna ciągła scena, z jednym otoczeniem wypełniającym całą szerokość (grzbiet górski w 2k i 4k, tłum na rave w 4k oraz przeformułowany rave poniżej), wróciły ciągłe w czterech z pięciu przebiegów. Grzbiet górski 4:1 w 2k też był ciągły (4128 x 1024). To był nasz pierwszy test; późniejsza runda z kolejnymi 69 przebiegami, opisana niżej, pokazała, że wynik zależy także od tego, co jest w kadrze.
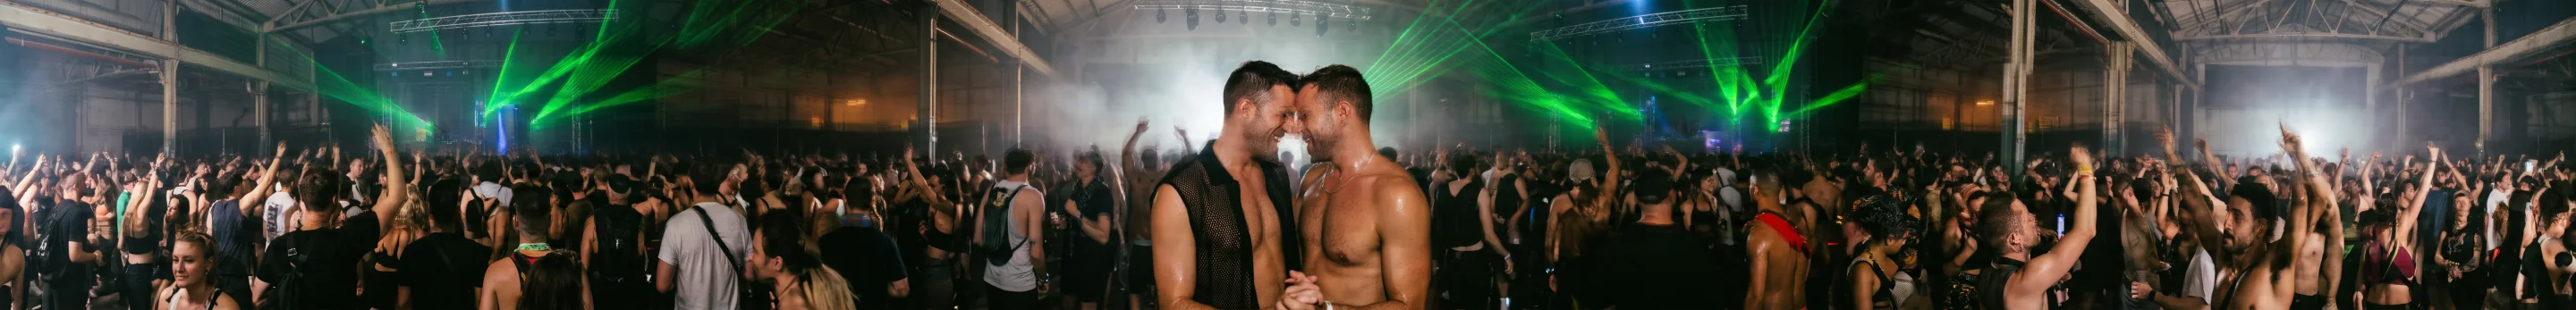
Tekst na obraz, 8:1, 2k (5856 x 704, pokazane mniejsze), napisane jako jedna ciągła scena: nieprzerwany tłum od krawędzi do krawędzi, z parą pośrodku.
One continuous ultra-wide panoramic photograph, a single unbroken scene from edge to edge, inside a packed warehouse rave at three in the morning: green laser beams cut through the haze above a dancing crowd that fills the whole frame under steel roof trusses. In the middle of the crowd two men in their thirties, a gay couple, dance forehead to forehead, one in an open black mesh shirt and one shirtless with a thin gold chain, sweat glinting under the lasers.Dla porównania nasz pierwszy, zszyty przebieg 8:1:
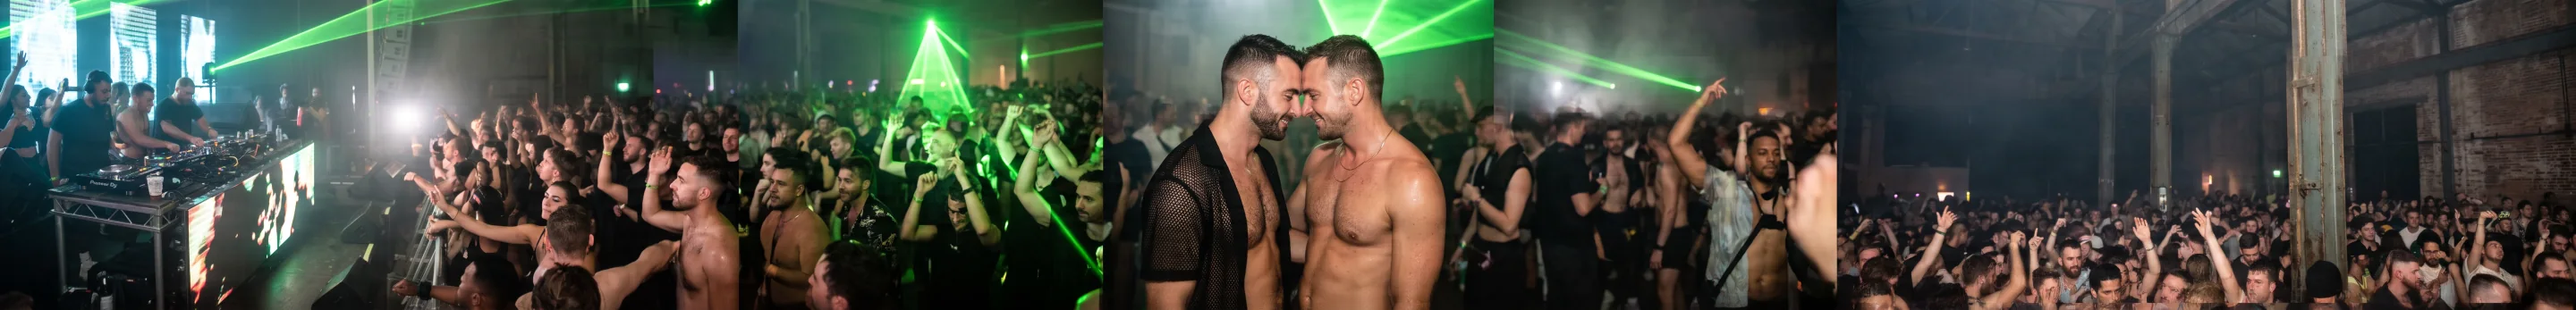
Jak wygląda zszyty wynik: 8:1, 2k. Każdy panel ma własne światło i własny tłum, a między nimi wyraźne pionowe szwy.
Wysokie kadry wypadły gorzej. W 1:8 i 1k model zwrócił sześć ułożonych ujęć tej samej sceny na plaży (352 x 2928); w 1:8 i 2k górski pejzaż wrócił jako pozioma panorama obrócona na bok (704 x 5856).
Późniejszy test z 69 przebiegów. Później 7 października wygenerowaliśmy jeszcze 69 szerokich i wysokich kadrów. To, czy kadr 8:1 lub 4:1 się zszyje, zależy od ludzi: pejzaże i dalekie tłumy trzymały się w całości, a ludzie blisko kamery lub rozmieszczeni na całej szerokości wracali zszyci mniej więcej co drugi raz. Spośród wszystkich naszych przebiegów 8:1 tego dnia 10 z 35 wróciło zszytych. W 1:4 i 1:8 działa motyw, który sam jest wysoki: 1:4 trzymał się w całości 8 razy na 8, a 1:8 11 razy na 14. Pełne szczegóły i prompty są w naszym przewodniku po promptach do panoram i banerów.
Co robić:
- Opisz jedną ciągłą scenę. Powiedz to w pierwszych słowach („one continuous ultra-wide panoramic photograph, a single unbroken scene from edge to edge”) i pozwól, by jedno otoczenie wypełniło szerokość, zamiast rozmieszczać osobne punkty orientacyjne na każdym końcu.
- Sprawdź każdy szeroki wynik w pełnym rozmiarze pod kątem pionowych szwów lub nagłej zmiany światła, zanim go użyjesz.
- W kadrach 8:1 i 4:1 trzymaj ludzi małych lub w jednym miejscu. To ludzie blisko kamery lub rozrzuceni na szerokość przechylali nasze późniejsze przebiegi w stronę zszycia.
- W 1:4 i 1:8 użyj motywu, który sam jest wysoki (stojąca postać, wieża, wodospad). Zobacz przewodnik po panoramach.
Rozmiary, szybkość i cena
Parametry, po jednej linii:
prompt: do 5000 znaków.aspect_ratio: 14 opcji od 1:1 do 8:1 i 1:8; domyślnie16:9dla tekst na obraz,autodla edycji.resolution:1k(domyślnie),2klub4k.output_format:png(domyślnie) lubjpeg. W 1k 21:9 JPEG miał 307 KB, a PNG około 1,1 MB.enable_web_searchienable_image_search: oba domyślnie wyłączone.image_urls(tylko edycja): od 1 do 14 obrazów źródłowych.
Rozmiary wyjściowe, które zmierzyliśmy:
| Poziom | Proporcje | Rozmiar (piksele) |
|---|---|---|
| 1k | 1:1 | 1024 x 1024 |
| 1k | 3:4 | 896 x 1200 |
| 1k | 21:9 | 1584 x 672 |
| 1k | 1:8 | 352 x 2928 (sześć ułożonych ujęć) |
| 2k | 3:4 | 1792 x 2400 |
| 2k | 2:3 | 1696 x 2528 |
| 2k | 4:5 | 1856 x 2304 |
| 2k | 16:9 | 2752 x 1536 |
| 2k | 21:9 | 3168 x 1344 |
| 2k | 4:1 | 4128 x 1024 |
| 2k | 8:1 | 5856 x 704 |
| 2k | 1:8 | 704 x 5856 (pejzaż obrócony na bok) |
| 4k | 1:1 | 4096 x 4096 |
Czas modelu w naszych testach z 7 października wynosił około 10–35 sekund w 1k i 2k oraz do około minuty w 4k.
Rozliczenie jest za obraz według poziomu rozmiaru (2k kosztuje więcej niż 1k, 4k więcej niż 2k); proporcje i format wyjściowy nie zmieniają ceny. W SpicyAPI Nano Banana 2.1 zaczyna się od ceny wyraźnie niższej niż cennik samego Google; strona modelu pokazuje aktualne ceny. Każda opcja wyszukiwania dolicza opłatę. Odrzucenia są bezpłatne; złagodzony obraz jest rozliczany jak każdy inny. Szkicuj w 1k, a udane wyniki uruchom ponownie w 2k lub 4k.
Jak daleko sięgają treści
Nano Banana 2.1 stosuje politykę treści Google; SpicyAPI nie dodaje własnego filtra. 7 października 2026 roku przeprowadziliśmy dwie rundy wyłącznie z dorosłymi bohaterami i sprawdziliśmy każdy obraz na oko: pierwszą rundę promptów tekst na obraz w 3:4 i 1k, a potem sześć typów prób uruchomionych po trzy razy w tekst na obraz i w edycji, przy ustawieniach domyślnych. Tabela pokazuje drugi zestaw.
| Poziom | Co obejmuje | Tekst na obraz (3 przebiegi) | Edycja (3 przebiegi) |
|---|---|---|---|
| L1 Sugestywny | Bielizna, zsuwające się ramiączko | 3 oddane zgodnie z zapisem | 3 odrzucone (zamiana na bieliznę) |
| L2 Dojrzałe motywy | Odsłonięty biust | 2 złagodzone (odwrócona lub zakryta), 1 odrzucony | 3 ukończone i rozliczone, ale z osobą ponownie ubraną w sweter lub koszulę |
| L3 Mocny | Mocne treści | 3 złagodzone (ponownie ubrani w koszulę i spodnie) | 3 odrzucone |
| L4 Intensywny | Intymna scena między dwojgiem dorosłych | 3 złagodzone (przytuleni pod kołdrą) | 3 odrzucone |
| L5 Ekstremalny | Dobrowolne skrępowanie między dorosłymi albo filmowy gore | Skrępowanie: 3 odrzucone. Gore: 3 odrzucone | Skrępowanie: 3 odrzucone. Gore: 3 oddane |
W tekst na obraz poziom L1 nadaje się naprawdę do mody, strojów kąpielowych i prac w stylu buduarowym. Te trzy pochodzą z naszej pierwszej rundy:
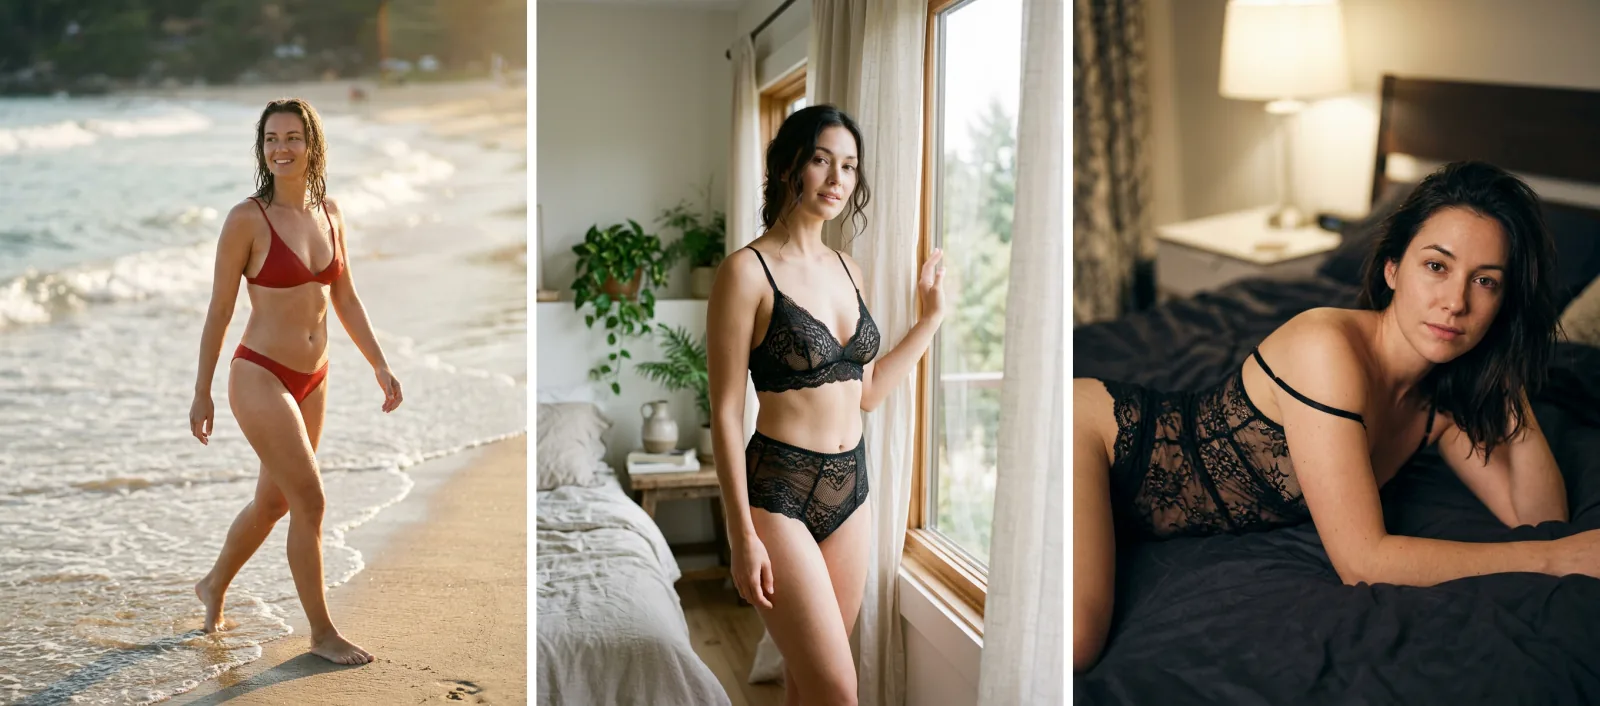
Tekst na obraz, 3:4, 1k. Trzy prompty L1 Sugestywny, każdy oddany zgodnie z zapisem.
Powyżej L1 tekst na obraz zwykle nie odrzuca; zmienia obraz. W naszej pierwszej rundzie dziesięć żądań od L2 do L4 (po dwa przebiegi pięciu promptów) zakończyło się, zostało rozliczonych i zwróciło obraz z ubraniami: kobieta w obszernym swetrze albo w kardiganie i dżinsach, mężczyzna w koszulce i dżinsach, scena pod prysznicem z kobietą owiniętą ręcznikiem, para przytulona pod prześcieradłem. W drugim zestawie jeden przebieg L2 został odrzucony wprost, a skrępowanie i gore odrzucono za każdym razem. Przy złagodzonym obrazie jedyny sposób, by się zorientować, to na niego spojrzeć.
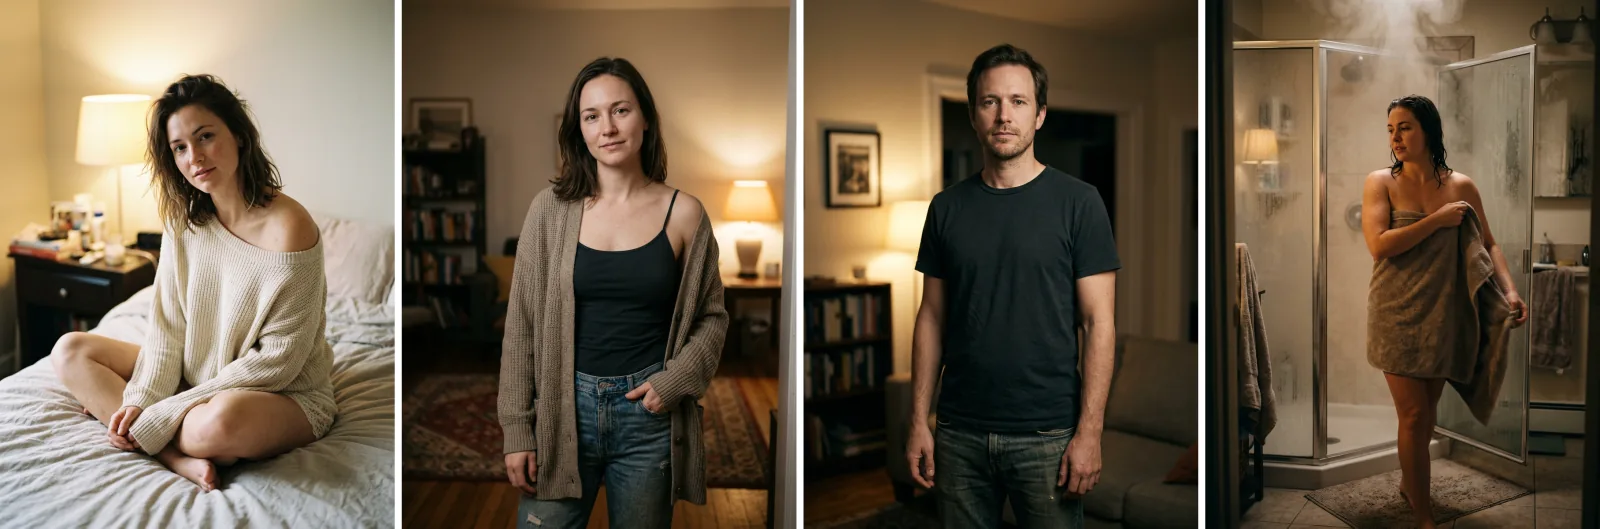
Pierwsza runda, co wróciło przy żądaniach L2 i L3: każde się zakończyło i zostało rozliczone, a nic w odpowiedzi nie wskazuje, że zostało zmienione. Wynik L4 opisano wyżej i nie pokazujemy go.
Zadanie edycji, pracując na naszych własnych ubranych zdjęciach źródłowych, odrzuca więcej. Zamiana sukienki na bieliznę i obie edycje ze zdjęciem ubrań z naszej pierwszej rundy zostały odrzucone komunikatem „Content flagged as potentially sensitive”, tak samo jak próby L3, L4 i skrępowania w drugim zestawie. Przeszły dwa rodzaje żądań: edycje L2 wróciły ukończone i rozliczone, ale z osobą ponownie ubraną w sweter lub koszulę, a filmowy gore został oddany zgodnie z zapisem. Przeszła też edycja sukni wieczorowej z odkrytymi plecami; przykład z operą powyżej to edycja tego rodzaju.
Co to oznacza w praktyce:
- Złagodzony obraz to cicha porażka. Zadanie mówi „ukończone” i płacisz, w tekst na obraz i przy edycjach L2 tak samo, więc przejrzyj każdy wynik, zanim trafi do klienta lub na feed.
- Odrzucenia są widoczne i bezpłatne. W obu zadaniach wracają jako nieudane z komunikatem „Content flagged as potentially sensitive” po około 70–90 sekundach i nie są rozliczane.
- Żadne ustawienie tego nie zmienia. Żaden publiczny parametr nie steruje treścią, a Nano Banana 2 i Pro mają tego samego wydawcę; nasz wcześniejszy test treści Nano Banana 2 opisuje, jak poradziły sobie z podobnymi żądaniami.
Który model wybrać?
7 października 2026 roku przepuściliśmy Nano Banana 2.1 przez nasz własny ślepy test, z tymi samymi pytaniami i punktami odniesienia co nasze wcześniejsze partie obrazów; trzech sędziów AI od różnych twórców oceniło obrazy na ślepo.
| Ślepy test | Nano Banana 2.1 | Nano Banana Pro | Nano Banana 2 |
|---|---|---|---|
| Wynik ogólny (na 100) | 75.6 | 74.4 | 70.3 |
| Data pomiaru | 7 października 2026 | 5 października 2026 | 5 października 2026 |
Wyniki cząstkowe Nano Banana 2.1 to 76.7 za zgodność z promptem (14 pytań), 77.8 za jakość obrazu (14) i 65.9 za spójność edycji (6 pytań edycyjnych). Gdzie się potknął: narysował sześć balonów, gdy prosiliśmy o pięć, i siedmiu gości przy stole, gdy prosiliśmy o sześciu, a w edycjach zamienił tło na nocną ulicę w zadaniu zmiany oświetlenia i przysunął kamerę w zadaniu z padającym śniegiem. Oba pytania o tekst wyszły poprawnie; nie publikujemy wyniku cząstkowego za tekst, bo test miał mniej niż sześć pytań o tekst. Jeśli liczy się dokładna liczba, sprawdź ją, a w edycjach napisz wprost, że tło i kadr mają zostać takie same.
Tabela łączy te liczby z naszymi praktycznymi przebiegami.
| Twoje zadanie | Wybierz | Dlaczego |
|---|---|---|
| Plakaty, okładki, szyldy lub infografiki, gdzie słowa muszą się zgadzać | Nano Banana 2.1 | Każda linia w cudzysłowie wyszła napisana tak, jak podano, w naszych testach |
| Osoba lub produkt przeniesione do nowej sceny | Nano Banana 2.1 edycja | Do 14 źródeł; twarz, kolor kurtki, napy i kieszenie zostały zachowane w naszym teście z trzema źródłami |
| Obrazy zależne od dzisiejszej daty lub aktualnych faktów | Nano Banana 2.1 z enable_web_search | Wydrukował poprawną datę przy włączonym wyszukiwaniu; zmyślił ją przy wyłączonym |
| Najmniejszy rozmiar szkicu | Nano Banana 2 | Ma poziom szkicu 0.5k; wersja 2.1 zaczyna od 1k |
| Potok już dostrojony na Nano Banana Pro | Nano Banana Pro, a potem spróbuj 2.1 na własnych promptach | Mała różnica w ślepym teście (75.6 wobec 74.4) |
| Szerokie banery do 8:1 | Nano Banana 2.1, z promptem jako jedną ciągłą sceną | Pejzaże i dalekie tłumy trzymały się w całości; ludzie blisko kamery lub na całej szerokości wracali zszyci mniej więcej co drugi raz (10 z 35 przebiegów 8:1 tego dnia). Wysokie 1:4 i 1:8 działają dla wysokich motywów. Zobacz przewodnik po panoramach |
| Obrazy dla dorosłych od L2 wzwyż | Rodziny obrazów bez cenzury w SpicyAPI | Polityka Google w większości to łagodzi albo odrzuca, w obu zadaniach |
Nano Banana 2.1 a Nano Banana 2. Google opisuje 2.1 jako bezpośrednią aktualizację, a nasz ślepy test zgadza się co do kierunku (75.6 wobec 70.3). Nowe prace zaczynaj na 2.1; zostań przy Nano Banana 2, jeśli polegasz na jego poziomie szkicu 0.5k albo nie chcesz jeszcze ponownie testować działającego potoku.
Nano Banana 2.1 a Nano Banana Pro. Google nazywa 2.1 bardziej efektywnym odpowiednikiem Pro, a w naszym ślepym teście wypadł nieco wyżej (pomiary dzieli dwa dni). Różnica jest niewielka, więc jeśli masz prompty Pro, którym ufasz, przepuść je przez 2.1 i porównaj, zanim się przełączysz.
Do prac dla dorosłych wybierz inną bazę. Nano Banana 2.1 pasuje do ubranej, publicznej strony projektu: plakatów promocyjnych, kart postaci, scen produktowych, mody na poziomie bielizny. Od L2 wzwyż otwórz katalog modeli SpicyAPI, przefiltruj go według polityki treści i wybierz według zadania rodzinę obrazów bez cenzury. Pracuj wyłącznie z fikcyjnymi dorosłymi lub dorosłymi, którzy wyrazili zgodę.
FAQ
Czy Nano Banana 2.1 jest bez cenzury?
Nie. Stosuje politykę treści Google. W naszych testach z 7 października 2026 roku tekst na obraz oddał L1 Sugestywny, w większości łagodził L2–L4 (jeden przebieg L2 został odrzucony) i odrzucał skrępowanie oraz gore. Zadanie edycji odrzuciło większość żądań dla dorosłych, ponownie ubrało żądania L2 i oddało filmowy gore.
Dlaczego dostałem ubrany obraz zamiast błędu?
Tekst na obraz zwykle kończy żądania wykraczające poza granicę Google złagodzonym obrazem i bez komunikatu o odrzuceniu, rozliczonym jak każdy inny obraz; zadanie edycji zrobiło to samo z żądaniami L2. Sprawdzaj każdy wynik na oko.
Czy płacę, gdy Nano Banana 2.1 odrzuci żądanie?
Nie. Odrzucenia w obu zadaniach wracają jako nieudane z komunikatem „Content flagged as potentially sensitive”, zwykle po około 70–90 sekundach, i nie są rozliczane. Żądanie, które model łagodzi, jest rozliczane, bo nadal zwraca obraz.
Ile obrazów referencyjnych mogę użyć w edycji?
Od 1 do 14, w image_urls, w kolejności, do której odwołuje się twój prompt. Google mówi, że zachowuje spójność do 4 postaci i do 10 obiektów; w naszym teście z trzema źródłami zachowały się twarz i szczegóły kurtki.
Kiedy włączyć wyszukiwanie w sieci?
Gdy obraz zależy od aktualnych informacji. Przy włączonym enable_web_search nasz plakat z prognozą dla Tokio wydrukował poprawną datę; przy wyłączonym model zmyślił ją. Każda opcja wyszukiwania dolicza opłatę za żądanie.
Której rozdzielczości użyć?
Szkicuj w 1k, a udane wyniki uruchom ponownie w 2k lub 4k. Każdy stopień kosztuje więcej, a czas modelu wynosił około 10–35 sekund w 1k i 2k wobec do około minuty w 4k.