Google ha rilasciato Nano Banana 2.1 il 6 ottobre 2026 e la sua promessa punta ai lavori in cui i modelli di immagine di solito deludono: la testata di una rivista, il titolo di un film, un'insegna sullo sfondo. Prima di spostare su di esso una pipeline di poster, pubblicità o personaggi ti servono tre risposte: la promessa sul testo regge, le modifiche mantengono la persona di partenza, e fin dove ti lascia arrivare la policy sui contenuti di Google prima che il modello cambi in silenzio la tua immagine?
Nano Banana 2.1 è il modello di immagini di Google da scegliere quando le parole nell'immagine devono essere giuste. Nei nostri test del 7 ottobre 2026 ogni riga messa tra virgolette doppie è uscita scritta esattamente come l'avevamo scritta, le modifiche multi-immagine hanno portato volti e dettagli di prodotto in scene nuove e la ricerca web ha corretto una data che altrimenti il modello inventava. Non è un modello senza censura. Le immagini di lingerie sono state rese in testo a immagine, ma le richieste da L2 a L4 sono per lo più tornate completate, addebitate e attenuate in silenzio, costrizione e gore sono stati rifiutati e la modifica ha rifiutato la maggior parte delle richieste per adulti. I banner larghi hanno retto con paesaggi e folle lontane, ma con persone vicine alla camera sono tornati giuntati circa una volta su due, e i formati alti 1:8 hanno funzionato solo con soggetti alti di per sé.
Abbiamo eseguito tutti i test dalla pagina della famiglia Nano Banana 2.1 su SpicyAPI, dove il modello è attivo dal 7 ottobre 2026. Le affermazioni di Google qui sotto vengono dalla sua documentazione del modello.
In breve
| Nano Banana 2.1 (provato il 7 ottobre 2026) | |
|---|---|
| Editore e uscita | Google, 6 ottobre 2026; il codice modello di Google è gemini-nano-banana-2.1 |
| Che cos'è | Un aggiornamento di Nano Banana 2 (Gemini 3.1 Flash Image); Google lo definisce la controparte più efficiente di Nano Banana Pro |
| Nomi dei modelli API | google/nano-banana-2.1/text-to-image e google/nano-banana-2.1/edit |
| Input | prompt fino a 5.000 caratteri; la modifica accetta da 1 a 14 immagini sorgente |
| Dimensioni | 1k (predefinito), 2k, 4k; 14 proporzioni da 1:1 a 8:1 e 1:8 |
| Output | Un PNG (predefinito) o JPEG per richiesta |
| Velocità nei nostri test | Circa 10-35 secondi a 1k e 2k, fino a circa un minuto a 4k (tempo del modello) |
| Testo nei nostri test | Ogni riga tra virgolette scritta esattamente; le scritte minute non specificate sono uscite come testo di riempimento |
| Contenuti nei nostri test | Vale la policy di Google. Da testo a immagine: L1 reso, da L2 a L4 per lo più attenuati senza avviso (addebitati), costrizione e gore rifiutati. Modifica: la maggior parte delle richieste per adulti rifiutata, L2 rivestito (addebitato), gore cinematografico reso |
| Non disponibile | Seed, prompt negativo, più immagini per richiesta, maschera, un livello bozza 0.5k |
| Test alla cieca (7 ottobre 2026) | 75,6 / 100: aderenza al prompt 76,7, qualità dell'immagine 77,8, coerenza delle modifiche 65,9. Stesse domande: Nano Banana Pro 74,4, Nano Banana 2 70,3 (entrambi il 5 ottobre 2026) |
| Prezzi | Per immagine in base al livello di dimensione, a partire da un prezzo ben inferiore al listino di Google; ogni opzione di ricerca aggiunge un costo |
Che cos'è Nano Banana 2.1
Google dice che Nano Banana 2.1 è "an update to Nano Banana 2 (Gemini 3.1 Flash Image)" che "maintains Flash-level speed and cost efficiency while delivering significant improvements in visual quality, prompt adherence, multi-turn character consistency, and text rendering". Lo definisce anche "the more efficient counterpart to Gemini 3 Pro Image (Nano Banana Pro)". Tra le novità principali indicate da Google ci sono una migliore impaginazione delle infografiche, giunzioni corrette sui formati larghi e panoramici a 2K e 4K, fino a 14 immagini di riferimento (fino a 4 personaggi e 10 oggetti restano coerenti) e il grounding con la Ricerca web e la Ricerca immagini di Google. Le sezioni qui sotto verificano queste affermazioni su ciò che è uscito davvero.
Resa del testo: il miglioramento principale regge
È il motivo per provare il modello e l'affermazione che ha retto meglio. Abbiamo chiesto otto righe di scritte in tre prompt da testo a immagine e una modifica (una copertina di rivista, una locandina di film, un'insegna al neon di un motel e una copertina di album, tutte mostrate in questo articolo) e ogni riga tra virgolette doppie è tornata scritta esattamente come l'avevamo scritta.
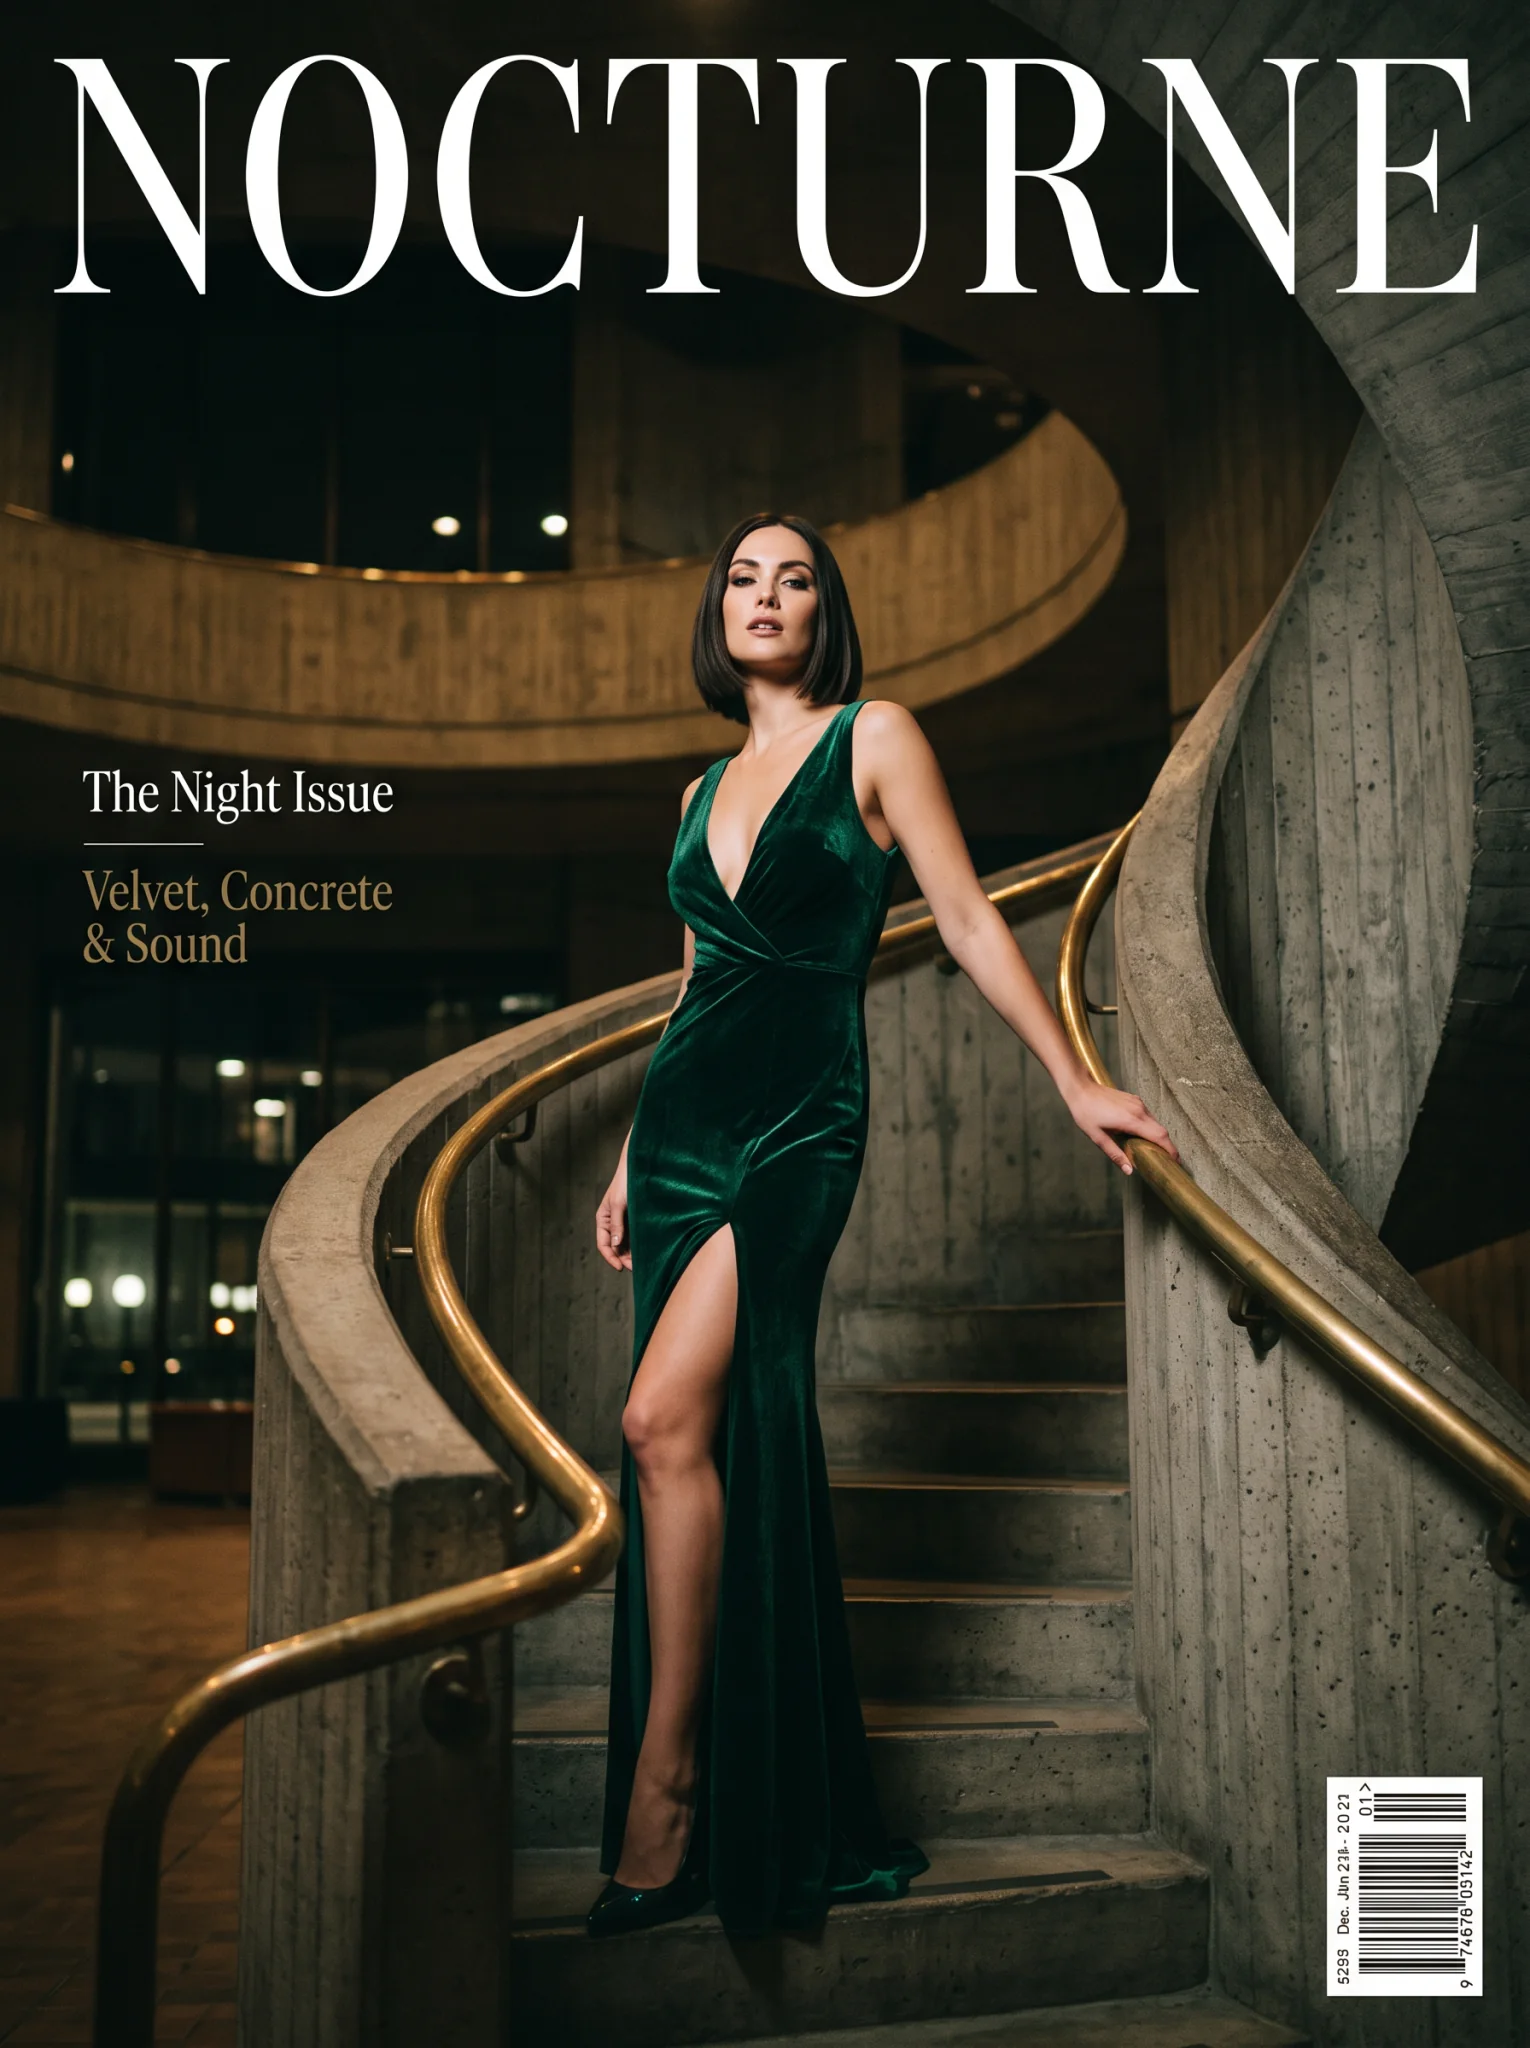
Da testo a immagine, 3:4, 2k. La testata e i due titoli di copertina sono scritti esattamente. Le cifre del codice a barre, che il prompt non specificava, sono riempimento.
Il prompt usato:
Fashion magazine cover photograph. The masthead across the top, in tall elegant serif capitals, reads "NOCTURNE". A woman in her early thirties with a sleek dark bob stands on the curving concrete spiral staircase of a brutalist concert hall at night, wearing a plunging emerald velvet gown with a thigh-high slit, one hand on the brass rail, looking down at the camera. Small cover lines on the left read "The Night Issue" and "Velvet, Concrete & Sound". A small barcode in the lower right corner. Low-key cinematic lighting, deep green and charcoal palette.Apri questo prompt in Nano Banana 2.1 da testo a immagine e imposta aspect_ratio su 3:4 e resolution su 2k per rifare la nostra prova; il link compila solo il prompt.
La locandina del film mostra il limite: titolo e riga di uscita sono esatti, ma il blocco di nomi, che avevamo chiesto senza scrivere alcun nome, è uscito come un nonsenso dall'aspetto convincente.
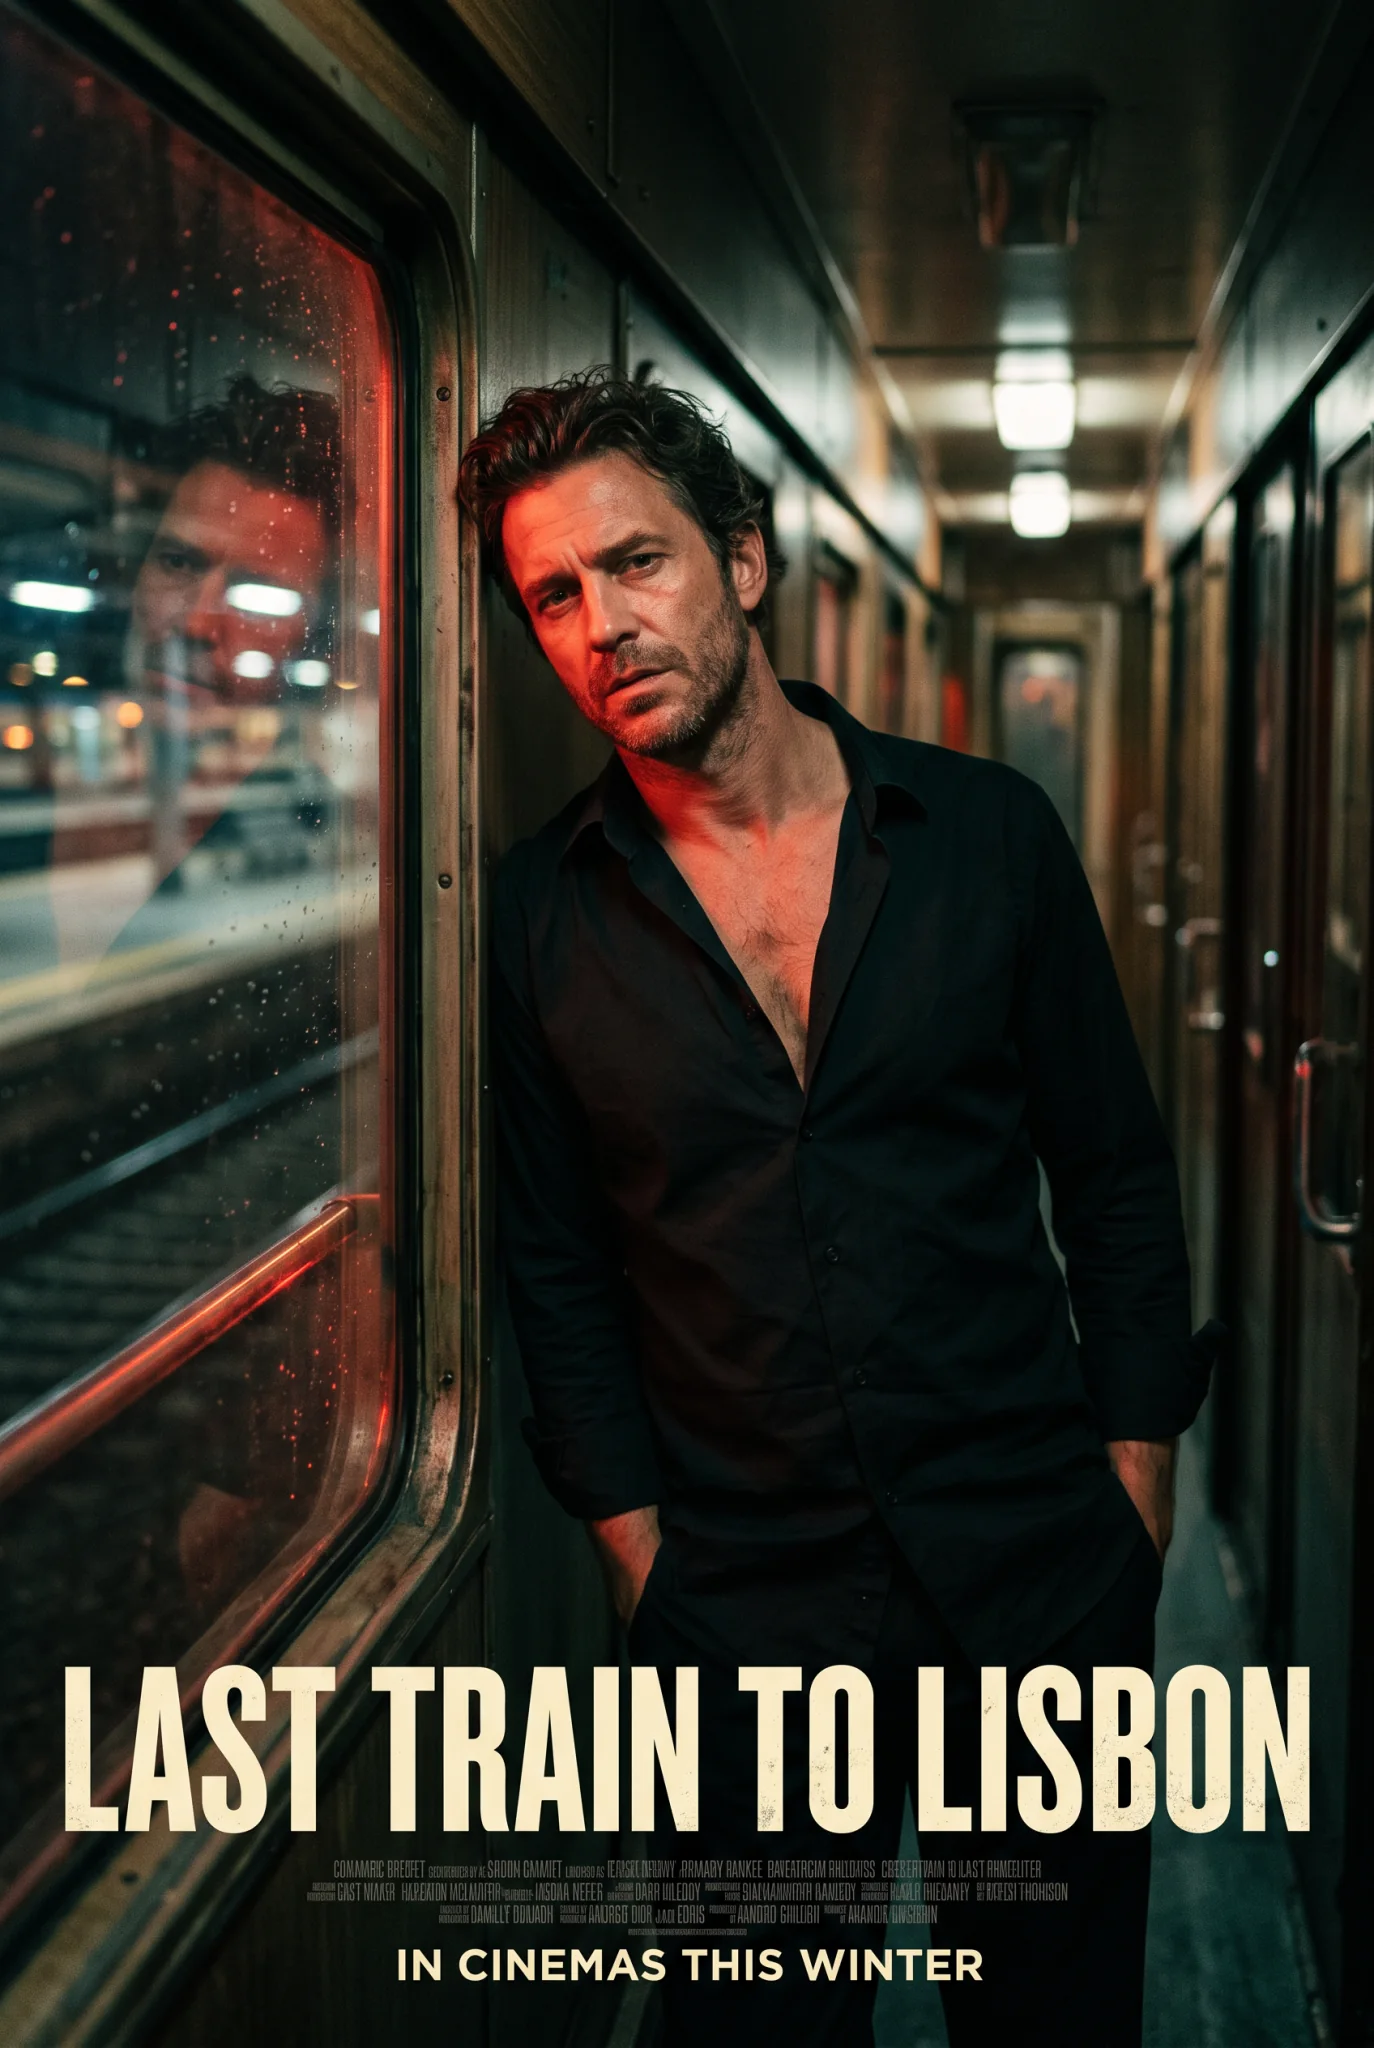
Da testo a immagine, 2:3, 2k. Titolo e riga di uscita esatti; il blocco di nomi in mezzo è riempimento.
Cosa significa quando scrivi un prompt con del testo:
- Metti tra virgolette ogni parola che deve comparire.
- Di' dove va e che aspetto ha. "Across the top, in tall elegant serif capitals" è finito esattamente lì.
- Scrivi per intero tutto ciò che un lettore leggerà. Quello che descrivi soltanto ("a small barcode", "a block of names") torna come texture, quindi controlla le scritte minute prima di pubblicare.
Per un flusso completo di poster con correzioni di testo mirate, vedi la nostra guida all'impaginazione del testo con Nano Banana Pro; le stesse abitudini di prompt valgono qui.
Modifiche che mantengono la persona e il prodotto
La modifica accetta da 1 a 14 immagini sorgente in image_urls, elencate nell'ordine a cui il tuo prompt si riferisce. Google dice che mantiene coerenti fino a 4 personaggi e fino a 10 oggetti.
Una sorgente: una scena nuova, lo stesso volto
Gli abbiamo dato una foto diurna di una donna dai capelli rossi che annaffia felci in una serra di vetro, con camicia di lino bianca e shorts di jeans, e abbiamo chiesto una serata all'opera.
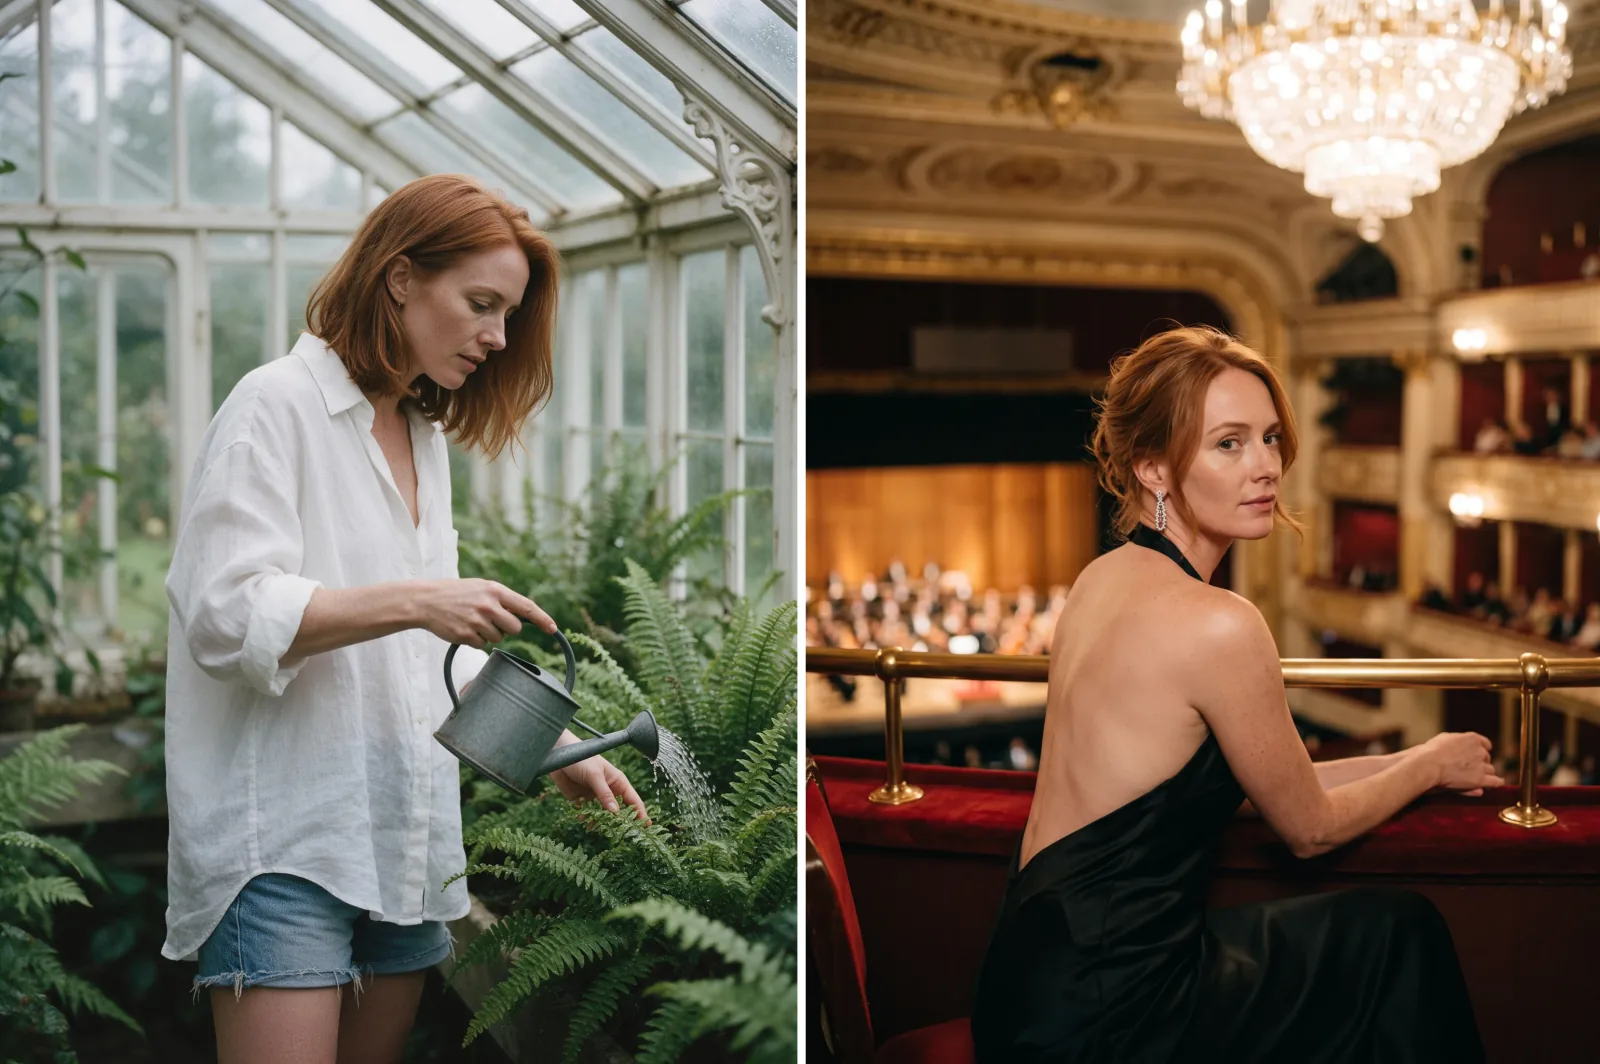
A sinistra: la foto sorgente. A destra: la modifica a 2k, proporzioni su auto. Volto e colore dei capelli sono stati mantenuti; abito, capelli raccolti, orecchini, palco di velluto, lampadario e palcoscenico corrispondono al prompt.
Take her from the greenhouse to an opera house at night: she sits in a red velvet box seat, leaning on the gilded balcony rail, wearing a backless black silk gown with her auburn hair pinned up and diamond drop earrings, looking back over her shoulder, the lit stage and a crystal chandelier softly blurred behind her. Keep her face and her hair colour.L'ultima frase conta: indicare ciò che deve restare ("keep her face and her hair colour") dice al modello quali parti della sorgente sono fisse.
Tre sorgenti: una persona, un prodotto e un luogo
È il lavoro che interessa di più ai team prodotto. Abbiamo fornito un ritratto da studio di un uomo, una foto prodotto di una camicia-giacca in camoscio cognac con bottoni a pressione d'ottone e un osservatorio vuoto di notte.
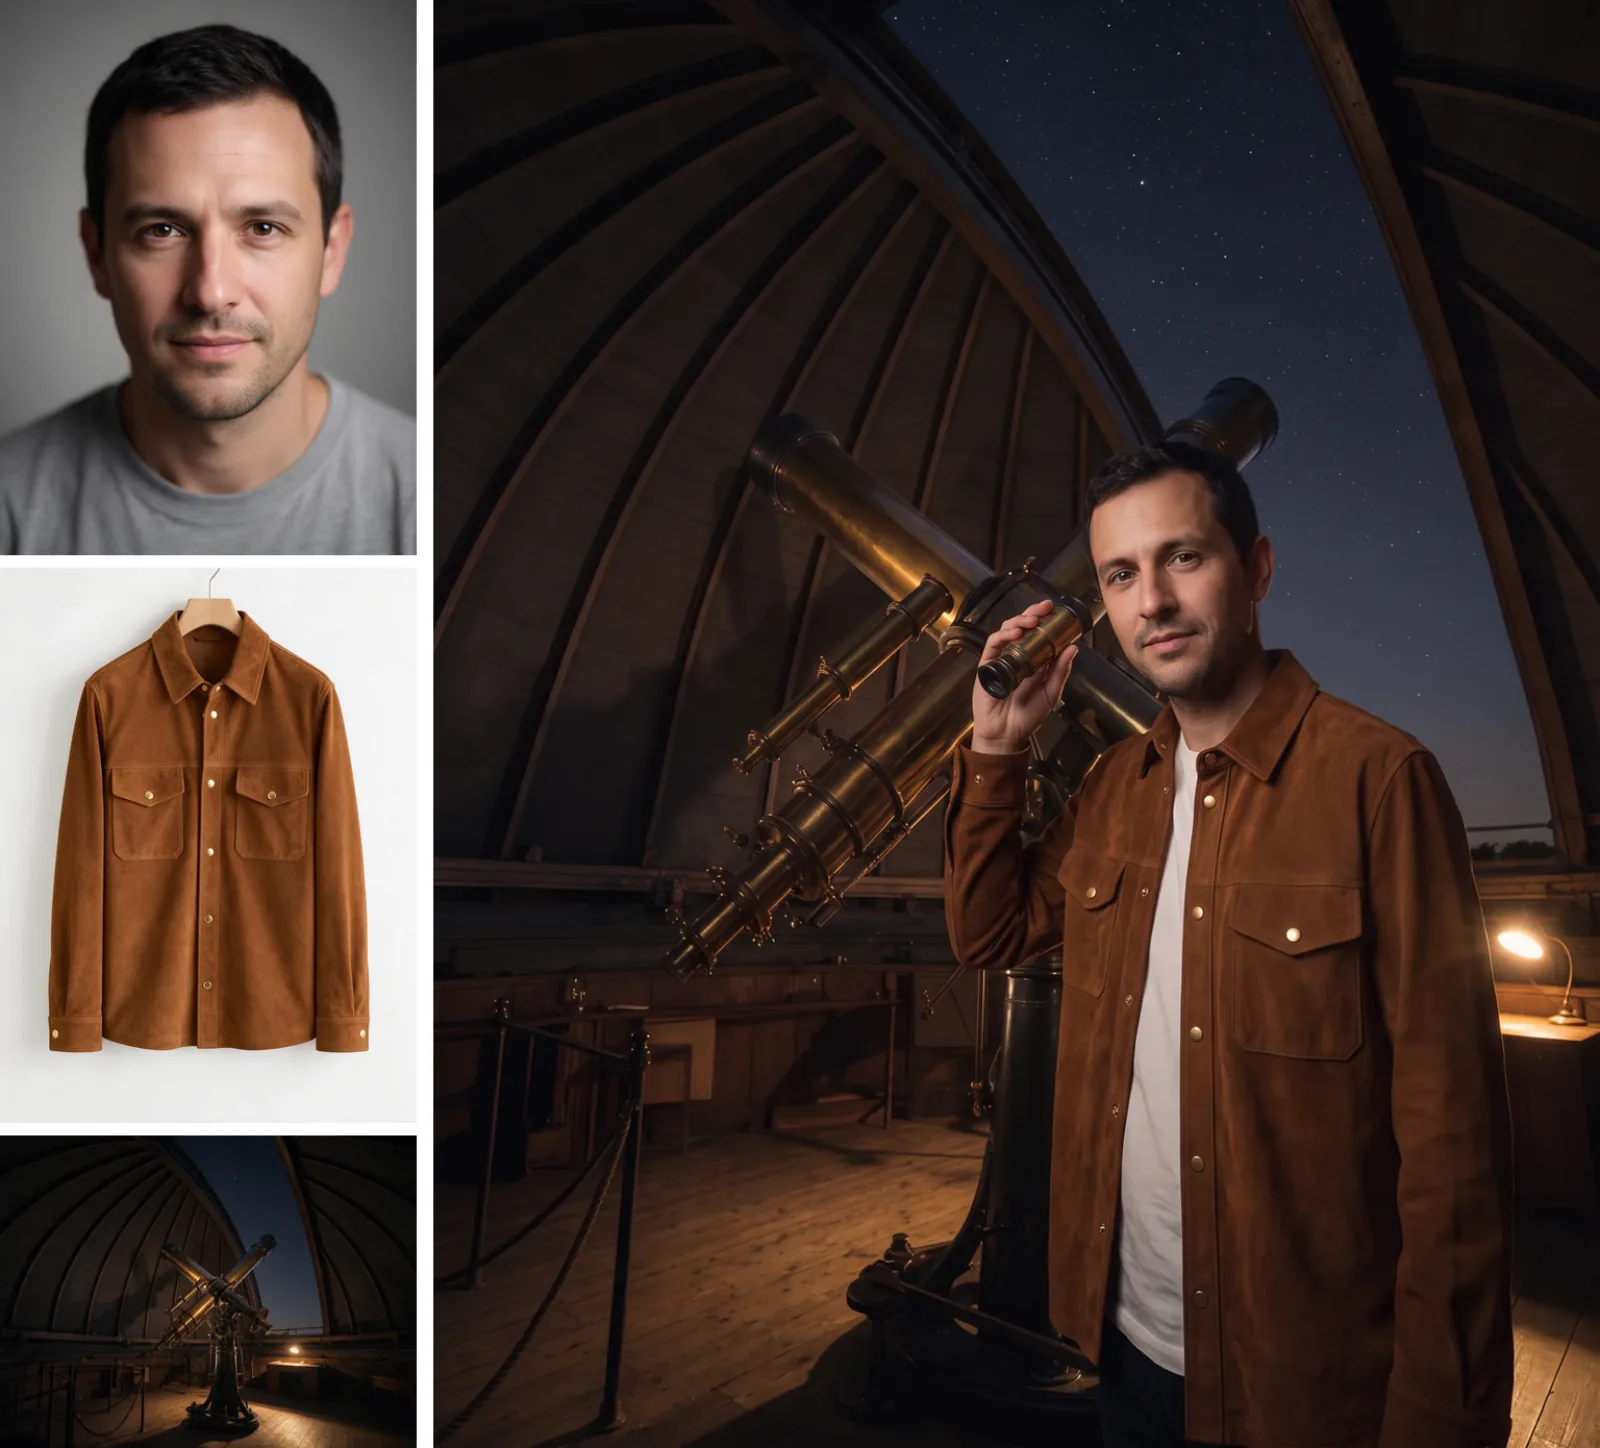
A sinistra: le tre sorgenti nell'ordine del prompt. A destra: la modifica in 4:5, 2k. Volto, colore della giacca, bottoni a pressione d'ottone e tasche sul petto sono stati mantenuti. Un errore: invece di una mano sull'oculare del telescopio, tiene un piccolo cannocchiale d'ottone.
Combine the three images: the man from the first image wears the cognac suede overshirt from the second image, unbuttoned over a white undershirt, and stands beside the brass telescope in the observatory from the third image at night, one hand on the eyepiece, starlight from the open dome and the warm desk lamp on his face. Keep his face, and keep the jacket's colour, brass snaps and chest pockets exactly.Cosa ha funzionato: riferirsi a ogni sorgente per posizione, dire cosa prendere da ciascuna ed elencare i dettagli che devono sopravvivere. L'azione che abbiamo menzionato solo di passaggio è quella che il modello ha cambiato, quindi dai a una posa che conta una frase tutta sua.
Testo dentro una modifica
L'ultima modifica ha lasciato due persone e un negozio esattamente come sono e ha disegnato la custodia che hanno in mano.
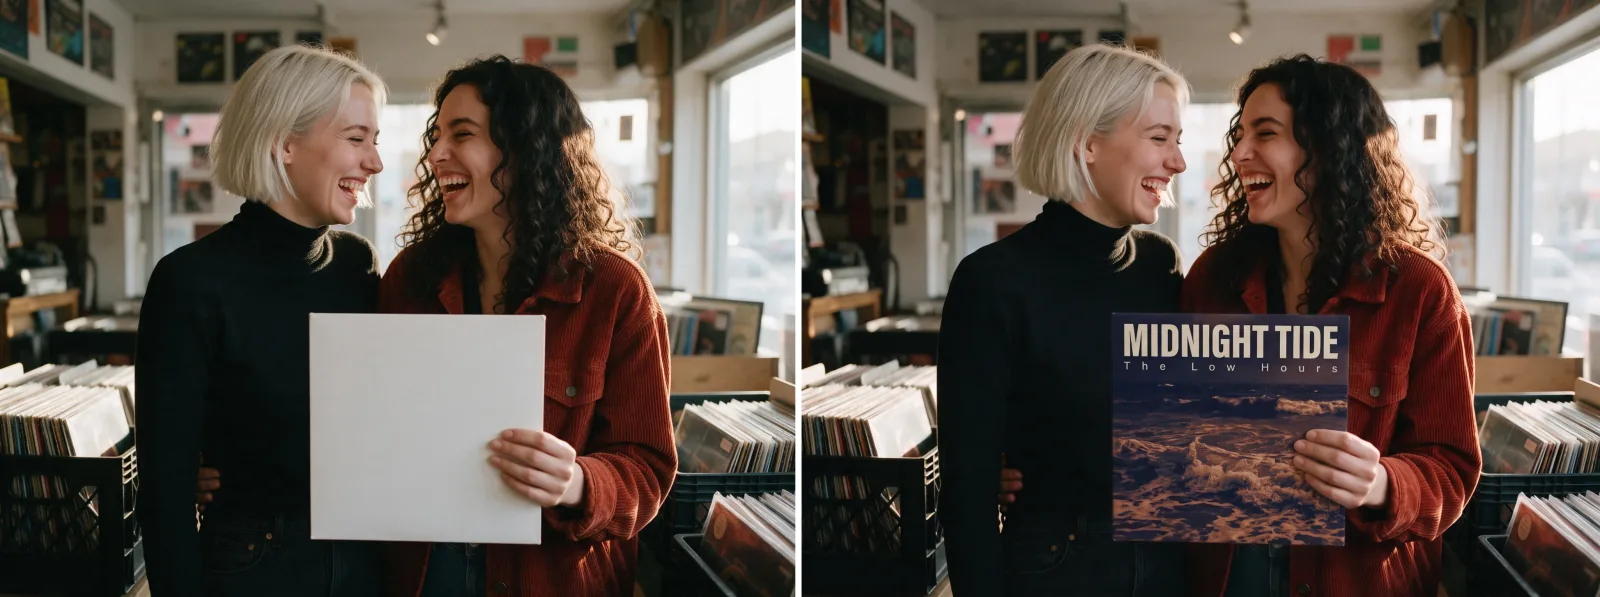
A sinistra: la sorgente. A destra: la modifica a 2k. Donne, vestiti e negozio invariati; titolo e nome della band scritti giusto, anche se il nome della band è in maiuscole e minuscole spaziate e non nelle maiuscolette che avevamo chiesto.
Design the blank album sleeve she is holding: a moody duotone photograph of ocean waves at night in deep blue and rust, with the title "MIDNIGHT TIDE" in large bold sans serif and the band name "The Low Hours" in small capitals beneath it. Keep both women, their clothes, their pose and the record store exactly as they are.Proporzioni nelle modifiche. La modifica aggiunge auto (predefinito), che mantiene la forma della sorgente: una sorgente panoramica 4:1 è tornata a 2064 x 512. Con più sorgenti di forme diverse, imposta tu le proporzioni. Nel nostro test con due sorgenti, auto ha semplicemente seguito una delle due.
Per approfondire i ruoli delle sorgenti e come correggere le derive, vedi la nostra guida alla modifica con riferimenti di Nano Banana 2.
Ricerca web: la soluzione per date e fatti attuali
Abbiamo eseguito due volte lo stesso prompt:
today's weather forecast poster for Tokyo with the dateCon enable_web_search attivo, il poster ha stampato la data corretta, mercoledì 7 ottobre 2026. Senza, il modello ha inventato una data (24 ottobre). Se un'immagine dipende da qualcosa di attuale (una data, una previsione, un evento), attivala. Anche enable_image_search è stato eseguito e ha restituito un'immagine, ma non abbiamo misurato una differenza visibile. Ogni opzione di ricerca aggiunge un costo per richiesta, quindi lasciale entrambe disattivate negli altri casi.
Formati larghi e alti: descrivi un'unica scena continua
Google dice che la 2.1 ha corretto gli artefatti di tiling su 1:4, 4:1, 1:8 e 8:1 a 2K e 4K. Nei nostri test del 7 ottobre 2026 la tenuta dei formati larghi e alti dipendeva dal soggetto, come mostrano i risultati qui sotto. A 21:9 il modello ha composto un unico fotogramma di film continuo:
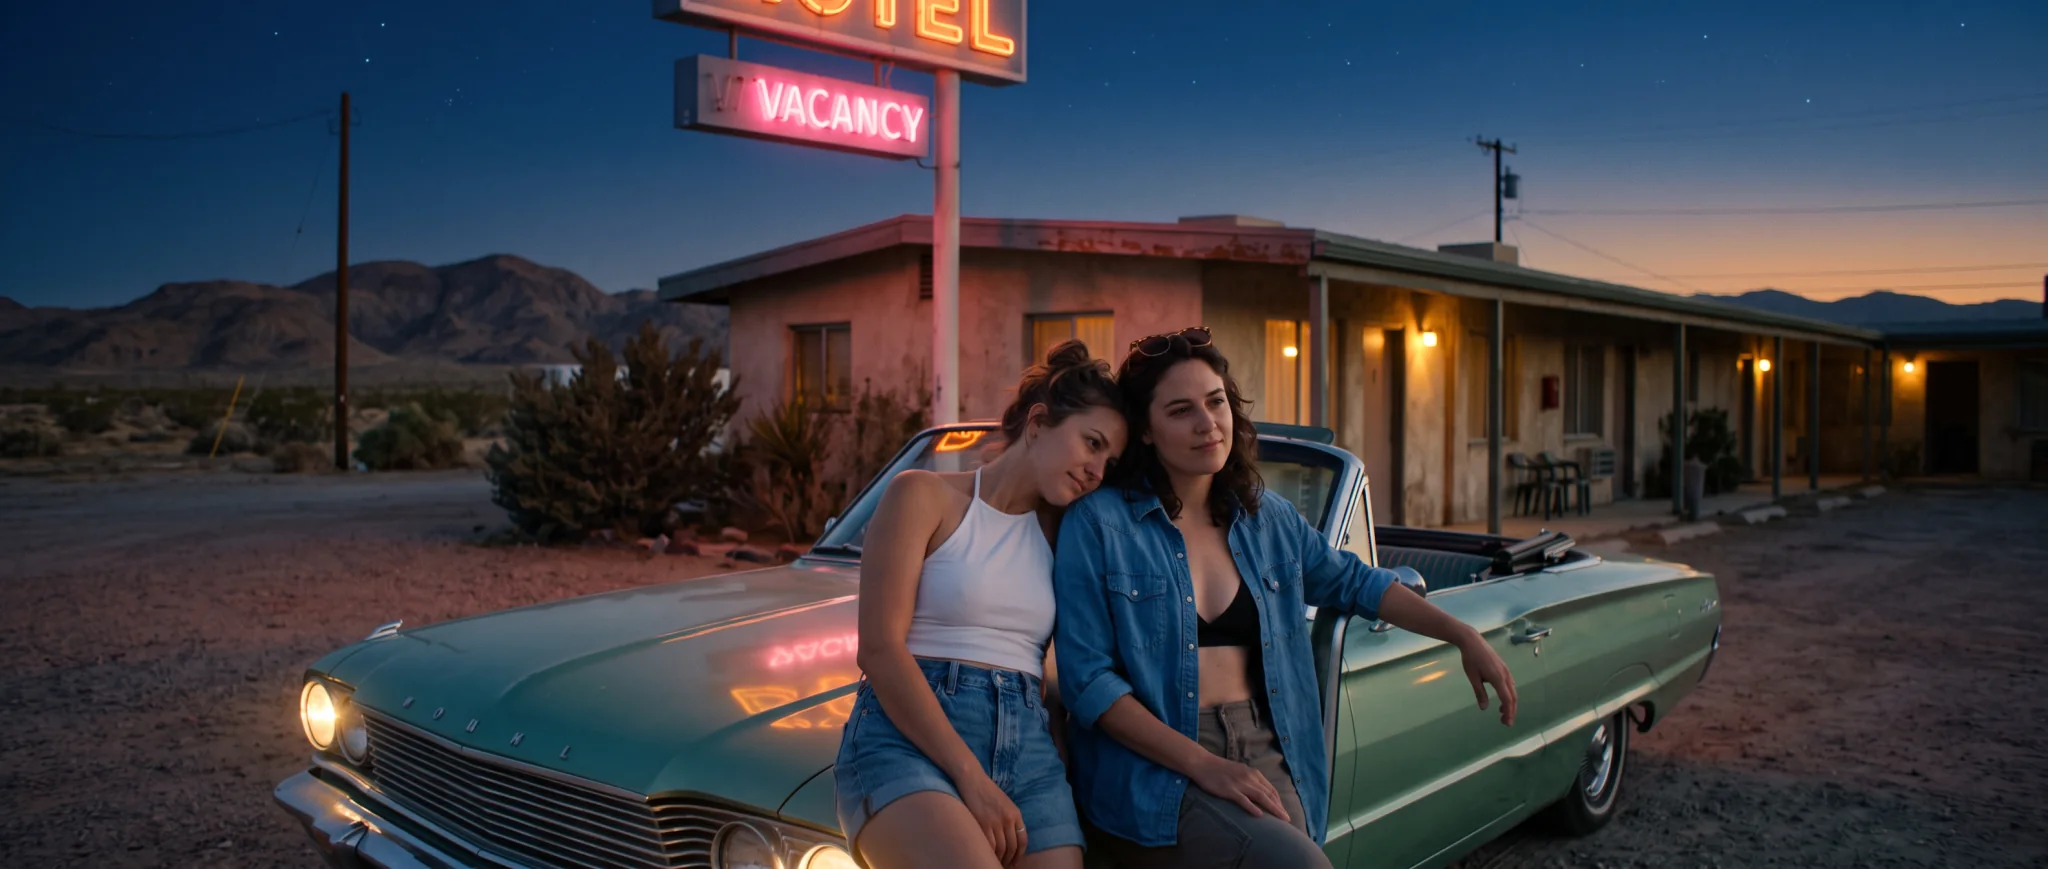
Da testo a immagine, 21:9, 2k. Un unico fotogramma continuo; la parola "VACANCY" tra virgolette è scritta esattamente.
Abbiamo eseguito l'8:1 sei volte. Quattro sono tornate come un'unica immagine continua; due sono tornate come più inquadrature affiancate, con giunzioni nette e luce diversa in ogni pannello. Quindi il tiling a volte avviene ancora a 8:1 e 2k, nonostante la correzione. A fare la differenza è stata la formulazione. Il nostro primo prompt da rave collocava punti di riferimento separati lungo la larghezza (una console da DJ all'estrema sinistra, colonne d'acciaio all'estrema destra, una coppia al centro) ed è tornato giuntato. I prompt riscritti come un'unica scena continua, con un solo ambiente che riempie la larghezza (una cresta di montagna a 2k e 4k, una folla da rave a 4k e il rave riformulato qui sotto), sono tornati continui in quattro prove su cinque. Anche una cresta di montagna 4:1 a 2k era continua (4128 x 1024). Era il nostro primo test; un secondo ciclo con altre 69 prove, descritto più avanti, ha mostrato che l'esito dipende anche da ciò che c'è nell'inquadratura.
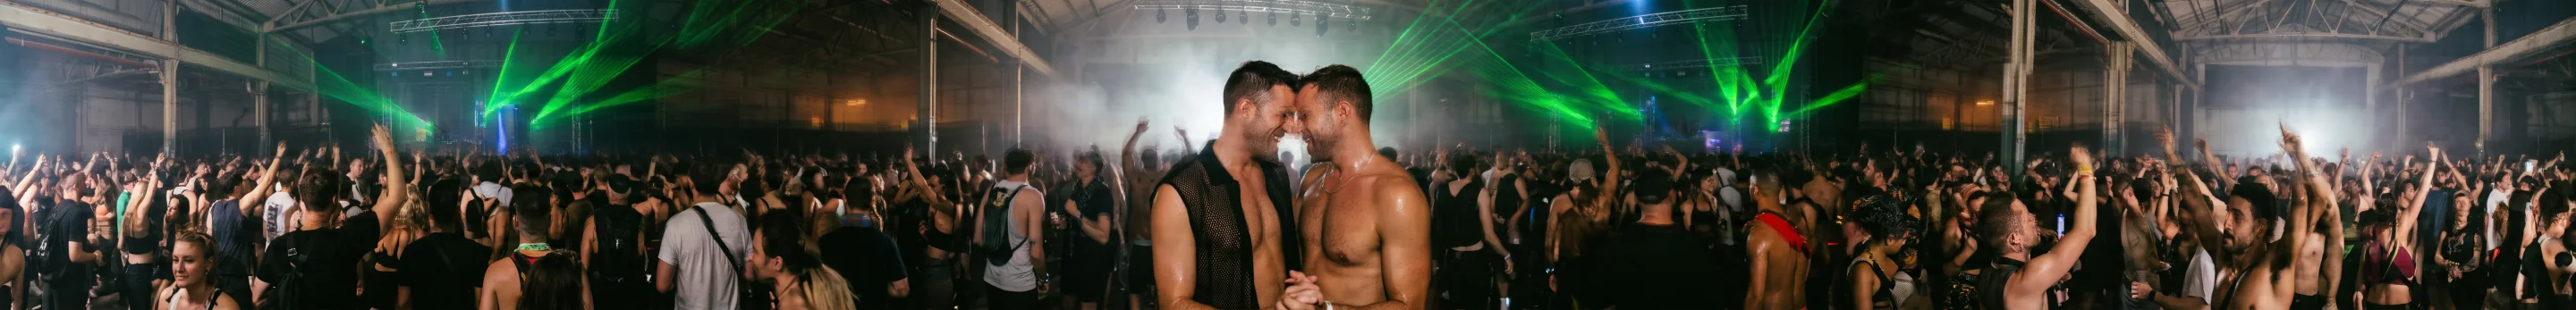
Da testo a immagine, 8:1, 2k (5856 x 704, mostrata più piccola), scritta come un'unica scena continua: una folla ininterrotta da un bordo all'altro, con la coppia al centro.
One continuous ultra-wide panoramic photograph, a single unbroken scene from edge to edge, inside a packed warehouse rave at three in the morning: green laser beams cut through the haze above a dancing crowd that fills the whole frame under steel roof trusses. In the middle of the crowd two men in their thirties, a gay couple, dance forehead to forehead, one in an open black mesh shirt and one shirtless with a thin gold chain, sweat glinting under the lasers.Per confronto, ecco la nostra prima prova 8:1, giuntata:
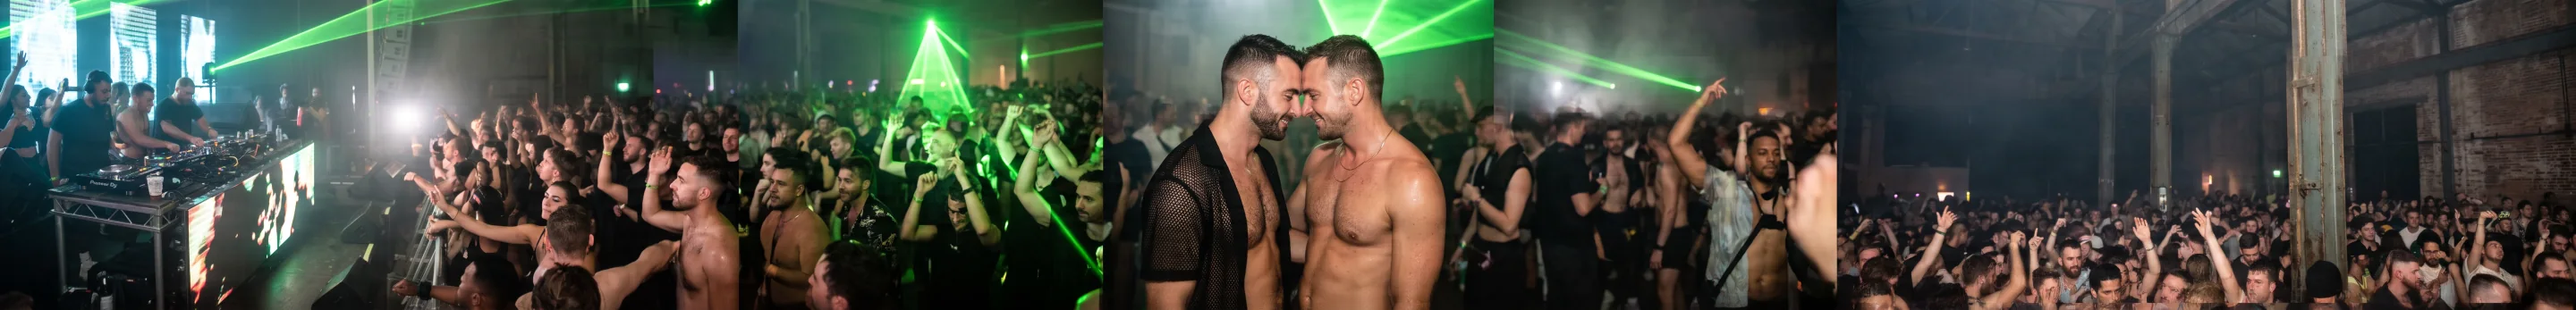
Come appare un risultato giuntato: 8:1, 2k. Ogni pannello ha la sua luce e la sua folla, con nette giunzioni verticali in mezzo.
I formati alti sono andati peggio. A 1:8 e 1k il modello ha restituito sei inquadrature impilate della stessa scena di spiaggia (352 x 2928); a 1:8 e 2k un paesaggio di montagna è tornato come un panorama orizzontale ruotato su un lato (704 x 5856).
Test successivo con 69 prove. Più tardi, il 7 ottobre, abbiamo generato altri 69 fotogrammi larghi e alti. Se un fotogramma 8:1 o 4:1 viene giuntato dipende dalle persone: paesaggi e folle lontane hanno retto, mentre persone vicine alla camera o distribuite lungo la larghezza sono tornate giuntate circa una volta su due. Su tutte le nostre prove 8:1 di quel giorno, 10 su 35 sono tornate giuntate. Con 1:4 e 1:8 funziona un soggetto alto di per sé: l'1:4 ha retto 8 volte su 8 e l'1:8 11 su 14. Dettagli completi e prompt sono nella nostra guida ai prompt per panorami e banner.
Cosa fare:
- Descrivi un'unica scena continua. Dillo nelle prime parole ("one continuous ultra-wide panoramic photograph, a single unbroken scene from edge to edge") e lascia che un solo ambiente riempia la larghezza, invece di collocare punti di riferimento separati a ciascuna estremità.
- Controlla ogni risultato largo a dimensione piena per giunzioni verticali o un cambio improvviso di luce prima di usarlo.
- Tieni le persone piccole o in un punto solo nei formati 8:1 e 4:1. Persone vicine alla camera o sparse lungo la larghezza hanno fatto cadere le nostre prove successive nella giunzione.
- Con 1:4 e 1:8 usa un soggetto alto di per sé (una figura in piedi, una torre, una cascata). Vedi la guida ai panorami.
Dimensioni, velocità e prezzo
I parametri, una riga ciascuno:
prompt: fino a 5.000 caratteri.aspect_ratio: 14 opzioni da 1:1 a 8:1 e 1:8; predefinito16:9per il testo a immagine,autoper la modifica.resolution:1k(predefinito),2ko4k.output_format:png(predefinito) ojpeg. A 1k e 21:9 il JPEG pesava 307 KB e il PNG circa 1,1 MB.enable_web_searcheenable_image_search: entrambi disattivati per impostazione predefinita.image_urls(solo modifica): da 1 a 14 immagini sorgente.
Le dimensioni di output che abbiamo misurato:
| Livello | Proporzioni | Dimensione (pixel) |
|---|---|---|
| 1k | 1:1 | 1024 x 1024 |
| 1k | 3:4 | 896 x 1200 |
| 1k | 21:9 | 1584 x 672 |
| 1k | 1:8 | 352 x 2928 (sei inquadrature impilate) |
| 2k | 3:4 | 1792 x 2400 |
| 2k | 2:3 | 1696 x 2528 |
| 2k | 4:5 | 1856 x 2304 |
| 2k | 16:9 | 2752 x 1536 |
| 2k | 21:9 | 3168 x 1344 |
| 2k | 4:1 | 4128 x 1024 |
| 2k | 8:1 | 5856 x 704 |
| 2k | 1:8 | 704 x 5856 (un paesaggio ruotato su un lato) |
| 4k | 1:1 | 4096 x 4096 |
Il tempo del modello nei nostri test del 7 ottobre è stato di circa 10-35 secondi a 1k e 2k e fino a circa un minuto a 4k.
La fatturazione è per immagine in base al livello di dimensione (la 2k costa più della 1k, la 4k più della 2k); proporzioni e formato di output non cambiano il prezzo. Su SpicyAPI, Nano Banana 2.1 parte da un prezzo ben inferiore al listino di Google; la pagina del modello mostra i prezzi attuali. Ogni opzione di ricerca aggiunge un costo. I rifiuti sono gratuiti; un'immagine attenuata viene addebitata come qualsiasi altra. Fai le bozze a 1k, poi rilancia quelle buone a 2k o 4k.
Fin dove arrivano i contenuti
Nano Banana 2.1 segue la policy sui contenuti di Google; SpicyAPI non aggiunge alcun filtro proprio. Il 7 ottobre 2026 abbiamo fatto due round solo con soggetti adulti e controllato ogni immagine a occhio: un primo round di prompt da testo a immagine a 3:4 e 1k, poi sei tipi di prova eseguiti tre volte ciascuno da testo a immagine e in modifica, alle impostazioni predefinite. La tabella mostra il secondo gruppo.
| Livello | Cosa copre | Da testo a immagine (3 esecuzioni) | Modifica (3 esecuzioni) |
|---|---|---|---|
| L1 Allusivo | Lingerie, uno spallino che scivola | 3 resi come richiesto | 3 rifiutati (uno scambio con lingerie) |
| L2 Parziale | Seno scoperto | 2 attenuati (distolti o coperti), 1 rifiutato | 3 completati e addebitati, ma rivestiti con un maglione o una camicia |
| L3 Forte | Contenuto forte | 3 attenuati (rivestiti con camicia e pantaloni) | 3 rifiutati |
| L4 Intenso | Una scena intima tra due adulti | 3 attenuati (a coccolarsi sotto le coperte) | 3 rifiutati |
| L5 Estremo | Costrizione consensuale tra adulti, o gore cinematografico | Costrizione: 3 rifiutati. Gore: 3 rifiutati | Costrizione: 3 rifiutati. Gore: 3 resi |
Da testo a immagine, il livello L1 è davvero utilizzabile per moda, costumi da bagno e lavori in stile boudoir. Queste tre immagini vengono dal nostro primo round:
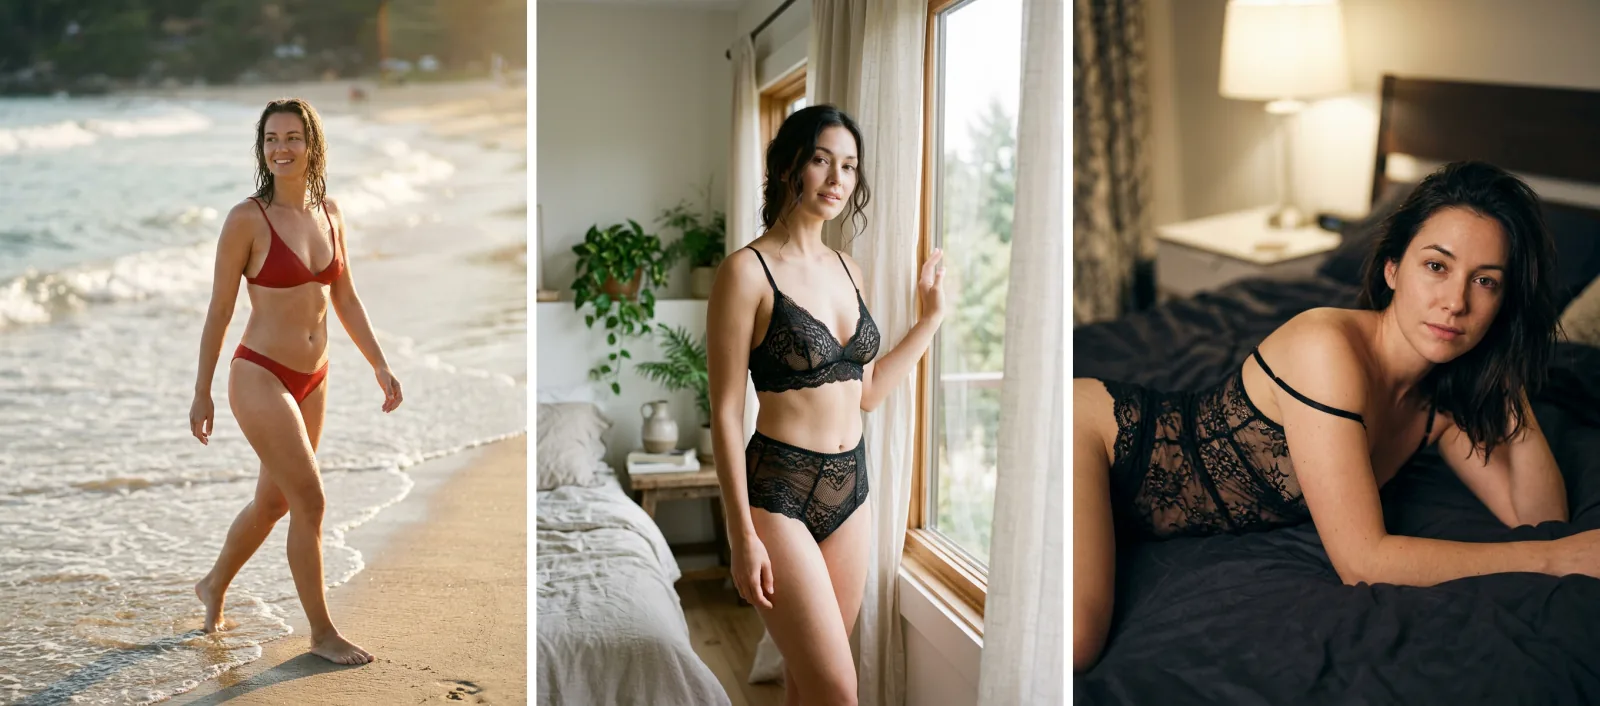
Da testo a immagine, 3:4, 1k. I tre prompt L1 Allusivo, ciascuno reso come richiesto.
Oltre L1, da testo a immagine di solito non rifiuta: cambia l'immagine. Nel nostro primo round dieci richieste da L2 a L4 (due esecuzioni ciascuna di cinque prompt) sono arrivate tutte in fondo, sono state addebitate e hanno restituito un'immagine vestita: la donna con un maglione oversize o con cardigan e jeans, l'uomo in maglietta e jeans, la scena sotto la doccia avvolta in un asciugamano, la coppia che si coccola sotto le lenzuola. Nel secondo gruppo una prova L2 è stata rifiutata del tutto, e costrizione e gore sono stati rifiutati ogni volta. Per un'immagine attenuata l'unico modo per accorgersene è guardarla.
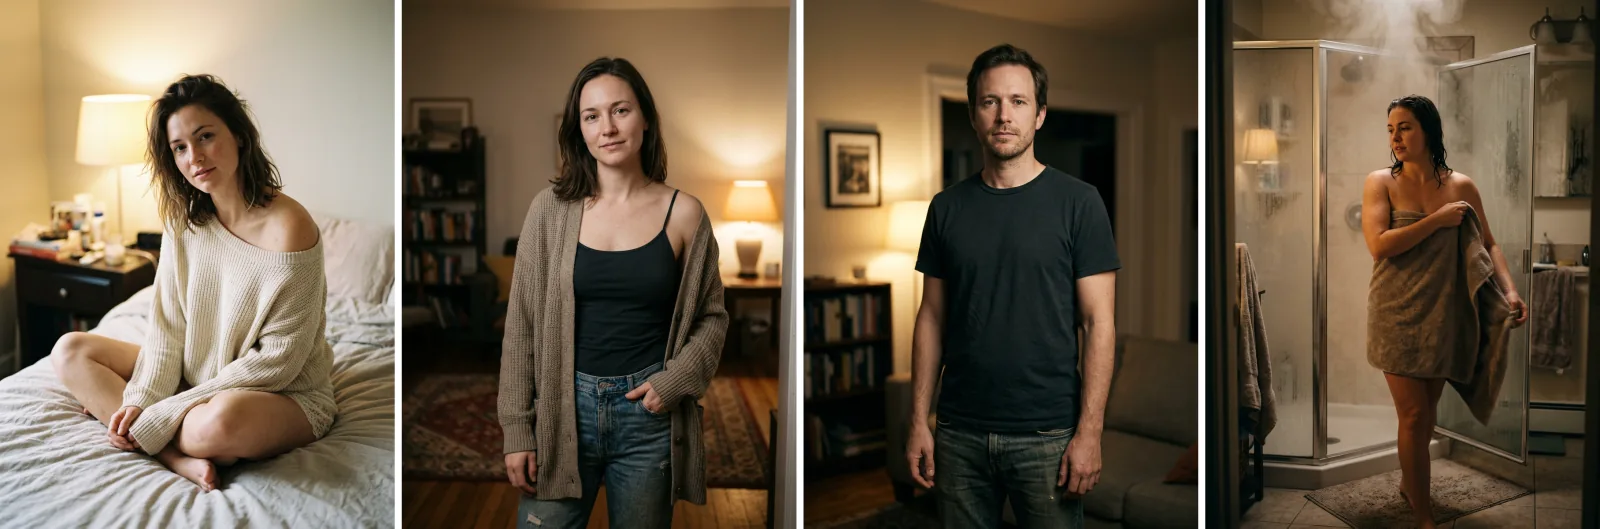
Primo round, cosa è tornato per le richieste a L2 e L3: ognuna è arrivata in fondo ed è stata addebitata, e nulla nella risposta segnala che sia stata modificata. Il risultato L4 è descritto sopra e non è mostrato.
La modifica, che lavora sulle nostre foto sorgente vestite, rifiuta di più. Sostituire un abito con lingerie e le due modifiche per togliere i vestiti del nostro primo round sono state rifiutate con "Content flagged as potentially sensitive", così come le prove L3, L4 e costrizione del secondo gruppo. Due tipi di richiesta sono passati: le modifiche L2 sono tornate completate e addebitate ma con la persona rivestita con un maglione o una camicia, e il gore cinematografico è stato reso come richiesto. Anche una modifica verso un abito da sera a schiena scoperta è passata; l'esempio dell'opera qui sopra è una modifica di questo tipo.
Cosa significa in pratica:
- Un'immagine attenuata è il fallimento silenzioso. L'attività risulta completata e paghi, sia da testo a immagine sia per le modifiche L2; controlla quindi ogni output prima che arrivi a un cliente o a un feed.
- I rifiuti sono visibili e gratuiti. Su entrambe le attività tornano come falliti con "Content flagged as potentially sensitive" dopo circa 70-90 secondi e non vengono addebitati.
- Nessuna impostazione cambia la cosa. Nessun parametro pubblico controlla i contenuti, e Nano Banana 2 e Pro hanno lo stesso editore; il nostro precedente test sui contenuti di Nano Banana 2 spiega come hanno trattato richieste simili.
Quale modello scegliere?
Il 7 ottobre 2026 abbiamo fatto passare Nano Banana 2.1 dal nostro test alla cieca, con le stesse domande e gli stessi ancoraggi di riferimento dei nostri precedenti lotti di immagini; tre giudici IA di produttori diversi hanno valutato le immagini alla cieca.
| Test alla cieca | Nano Banana 2.1 | Nano Banana Pro | Nano Banana 2 |
|---|---|---|---|
| Punteggio complessivo (su 100) | 75,6 | 74,4 | 70,3 |
| Data di misura | 7 ottobre 2026 | 5 ottobre 2026 | 5 ottobre 2026 |
I sottopunteggi di Nano Banana 2.1 sono stati 76,7 per l'aderenza al prompt (14 domande), 77,8 per la qualità dell'immagine (14) e 65,9 per la coerenza delle modifiche (6 domande di modifica). Dove è scivolato: ha disegnato sei palloncini quando ne servivano cinque e sette commensali quando ne servivano sei, e nelle modifiche ha sostituito lo sfondo con una strada notturna in un compito di cambio di luce e ha avvicinato la camera in un compito di nevicata. Entrambe le domande sul testo sono state scritte correttamente; non pubblichiamo un sottopunteggio per il testo perché il test aveva meno di sei domande sul testo. Se ti serve un conteggio esatto, controllalo, e nelle modifiche di' esplicitamente che sfondo e inquadratura devono restare uguali.
La tabella unisce questi numeri alle nostre prove pratiche.
| Il tuo lavoro | Scelta | Perché |
|---|---|---|
| Poster, copertine, insegne o infografiche in cui le parole devono essere giuste | Nano Banana 2.1 | Nei nostri test ogni riga tra virgolette è uscita scritta esattamente |
| Una persona o un prodotto portato in una scena nuova | Modifica di Nano Banana 2.1 | Fino a 14 sorgenti; volto, colore della giacca, bottoni a pressione e tasche mantenuti nel nostro test con tre sorgenti |
| Immagini che dipendono dalla data di oggi o da fatti attuali | Nano Banana 2.1 con enable_web_search | Ha stampato la data corretta con la ricerca; ne ha inventata una senza |
| La dimensione bozza più piccola | Nano Banana 2 | Ha un livello bozza 0.5k; la 2.1 parte da 1k |
| Una pipeline già messa a punto su Nano Banana Pro | Nano Banana Pro, poi prova la 2.1 con i tuoi prompt | Un piccolo scarto nel test alla cieca (75,6 contro 74,4) |
| Banner larghi fino a 8:1 | Nano Banana 2.1, con un prompt che descrive un'unica scena continua | Paesaggi e folle lontane hanno retto; persone vicine alla camera o lungo la larghezza sono tornate giuntate circa una volta su due (10 prove 8:1 su 35 quel giorno). Gli 1:4 e 1:8 funzionano con soggetti alti. Vedi la guida ai panorami |
| Immagini per adulti da L2 in su | Le famiglie di immagini senza censura di SpicyAPI | La policy di Google attenua o rifiuta la maggior parte di queste, su entrambe le attività |
Nano Banana 2.1 contro Nano Banana 2. Google descrive la 2.1 come un aggiornamento diretto, e il nostro test alla cieca concorda sulla direzione (75,6 contro 70,3). Avvia i lavori nuovi sulla 2.1; resta su Nano Banana 2 se fai affidamento sul suo livello bozza 0.5k o non vuoi ancora ritestare una pipeline che funziona.
Nano Banana 2.1 contro Nano Banana Pro. Google chiama la 2.1 la controparte più efficiente di Pro, e nel nostro test alla cieca ha ottenuto un punteggio leggermente più alto (misurato a due giorni di distanza). Lo scarto è piccolo: se hai prompt Pro di cui ti fidi, passali nella 2.1 e confronta prima di cambiare.
Per i lavori per adulti, scegli un'altra base. Nano Banana 2.1 si adatta al lato vestito e pubblico di un progetto: poster promozionali, schede personaggio, scene di prodotto, moda a livello lingerie. Da L2 in su, apri il catalogo modelli di SpicyAPI, filtra per policy sui contenuti e scegli una famiglia di immagini senza censura in base al compito. Lavora solo con adulti di fantasia o con adulti che hanno dato il loro consenso.
Domande frequenti
Nano Banana 2.1 è senza censura?
No. Segue la policy sui contenuti di Google. Nei nostri test del 7 ottobre 2026, da testo a immagine ha reso le immagini L1 Allusivo, ha per lo più attenuato da L2 a L4 (una prova L2 è stata rifiutata) e ha rifiutato costrizione e gore. La modifica ha rifiutato la maggior parte delle richieste per adulti, ha rivestito le richieste L2 e ha reso gore cinematografico.
Perché ho ricevuto un'immagine vestita invece di un errore?
Da testo a immagine di solito completa le richieste oltre la linea di Google con un'immagine attenuata e senza messaggio di rifiuto, addebitata come qualsiasi altra immagine; la modifica ha fatto lo stesso con le richieste L2. Controlla ogni risultato a occhio.
Mi viene addebitato qualcosa quando Nano Banana 2.1 rifiuta una richiesta?
No. I rifiuti, su entrambe le attività, tornano come falliti con "Content flagged as potentially sensitive", di solito dopo circa 70-90 secondi, e non vengono addebitati. Una richiesta che il modello attenua viene addebitata, perché restituisce comunque un'immagine.
Quante immagini di riferimento posso usare in una modifica?
Da 1 a 14, in image_urls, nell'ordine a cui il tuo prompt si riferisce. Google dice che mantiene coerenti fino a 4 personaggi e fino a 10 oggetti; nel nostro test con tre sorgenti, il volto e i dettagli della giacca sono stati mantenuti.
Quando devo attivare la ricerca web?
Quando l'immagine dipende da informazioni attuali. Con enable_web_search attivo, il nostro poster delle previsioni per Tokyo ha stampato la data corretta; senza, il modello ne ha inventata una. Ogni opzione di ricerca aggiunge un costo per richiesta.
Quale risoluzione devo usare?
Fai le bozze a 1k, poi rilancia quelle buone a 2k o 4k. Ogni gradino in più costa di più, e il tempo del modello è stato di circa 10-35 secondi a 1k e 2k contro fino a circa un minuto a 4k.