Google hat Nano Banana 2.1 am 6. Oktober 2026 veröffentlicht, und das Versprechen zielt auf genau die Aufgaben, an denen Bildmodelle sonst scheitern: ein Magazintitel, ein Filmtitel, ein Schild im Hintergrund. Bevor Sie eine Poster-, Werbe- oder Figuren-Pipeline darauf umstellen, brauchen Sie drei Antworten: Hält das Text-Versprechen? Behalten Bearbeitungen die Person, mit der Sie angefangen haben? Und wie weit lässt Googles Inhaltsrichtlinie Sie gehen, bevor das Modell Ihr Bild stillschweigend verändert?
Nano Banana 2.1 ist das Google-Bildmodell der Wahl, wenn die Wörter im Bild stimmen müssen. In unseren Tests am 7. Oktober 2026 kam jede Zeile in doppelten Anführungszeichen exakt so geschrieben heraus, Mehrbild-Bearbeitungen übertrugen Gesichter und Produktdetails in neue Szenen, und die Websuche korrigierte ein Datum, das das Modell sonst erfand. Es ist kein unzensiertes Modell. Dessous-Bilder wurden bei Text zu Bild gerendert, doch Anfragen von L2 bis L4 kamen meist abgeschlossen, berechnet und stillschweigend abgeschwächt zurück, Fesselung und Gore wurden abgelehnt, und die Bearbeitung lehnte die meisten Anfragen für Erwachsene ab. Breite Banner hielten bei Landschaften und fernen Menschenmengen zusammen, wurden mit Personen nah an der Kamera aber etwa jedes zweite Mal zusammengesetzt, und hohe 1:8-Formate funktionierten nur bei Motiven, die selbst hoch sind.
Wir haben alle Tests über die Familienseite von Nano Banana 2.1 bei SpicyAPI gefahren, wo das Modell am 7. Oktober 2026 live ging. Googles eigene Aussagen unten stammen aus der Modelldokumentation.
Auf einen Blick
| Nano Banana 2.1 (getestet am 7. Oktober 2026) | |
|---|---|
| Anbieter und Veröffentlichung | Google, 6. Oktober 2026; Googles Modellcode ist gemini-nano-banana-2.1 |
| Was es ist | Ein Update von Nano Banana 2 (Gemini 3.1 Flash Image); Google nennt es das effizientere Gegenstück zu Nano Banana Pro |
| API-Modellnamen | google/nano-banana-2.1/text-to-image und google/nano-banana-2.1/edit |
| Eingaben | prompt bis 5.000 Zeichen; die Bearbeitung nimmt 1 bis 14 Quellbilder |
| Größen | 1k (Standard), 2k, 4k; 14 Seitenverhältnisse von 1:1 bis 8:1 und 1:8 |
| Ausgabe | Ein PNG (Standard) oder JPEG pro Anfrage |
| Tempo in unseren Tests | Etwa 10 bis 35 Sekunden bei 1k und 2k, bis zu etwa einer Minute bei 4k (Modellzeit) |
| Text in unseren Tests | Jede Zeile in Anführungszeichen exakt geschrieben; nicht ausgeschriebenes Kleingedrucktes kam als Füllmaterial zurück |
| Inhalte in unseren Tests | Googles Richtlinie gilt. Text zu Bild: L1 gerendert, L2 bis L4 meist ohne Hinweis abgeschwächt (berechnet), Fesselung und Gore abgelehnt. Bearbeitung: die meisten Anfragen für Erwachsene abgelehnt, L2 neu eingekleidet (berechnet), filmisches Gore gerendert |
| Nicht verfügbar | Seed, Negativ-Prompt, mehrere Bilder pro Anfrage, Maske, eine 0.5k-Entwurfsstufe |
| Blindtest (7. Oktober 2026) | 75,6 / 100: Prompt-Treue 76,7, Bildqualität 77,8, Bearbeitungskonsistenz 65,9. Gleiche Fragen: Nano Banana Pro 74,4, Nano Banana 2 70,3 (beide 5. Oktober 2026) |
| Preise | Pro Bild nach Größenstufe, ab einem Preis deutlich unter Googles eigenem Listenpreis; jede Suchoption kostet extra |
Was Nano Banana 2.1 ist
Google sagt, Nano Banana 2.1 sei „an update to Nano Banana 2 (Gemini 3.1 Flash Image)“, das „maintains Flash-level speed and cost efficiency while delivering significant improvements in visual quality, prompt adherence, multi-turn character consistency, and text rendering“. Außerdem nennt Google es „the more efficient counterpart to Gemini 3 Pro Image (Nano Banana Pro)“. Zu den wichtigsten Neuerungen laut Google gehören ein besseres Infografik-Layout, behobene Kachelnähte bei breiten und Panorama-Formaten in 2K und 4K, bis zu 14 Referenzbilder (bis zu 4 Figuren und 10 Objekte bleiben konsistent) und Grounding mit der Google-Websuche und Bildersuche. Die Abschnitte unten prüfen diese Aussagen an dem, was tatsächlich herauskam.
Textdarstellung: Die wichtigste Verbesserung hält
Das ist der Grund, das Modell auszuprobieren, und die Aussage, die sich am besten bestätigt hat. Wir haben in drei Text-zu-Bild-Prompts und einer Bearbeitung acht Textzeilen verlangt (ein Magazincover, ein Filmplakat, ein Neon-Motelschild und ein Albumcover, alle in diesem Artikel zu sehen), und jede Zeile in doppelten Anführungszeichen kam exakt so geschrieben zurück.
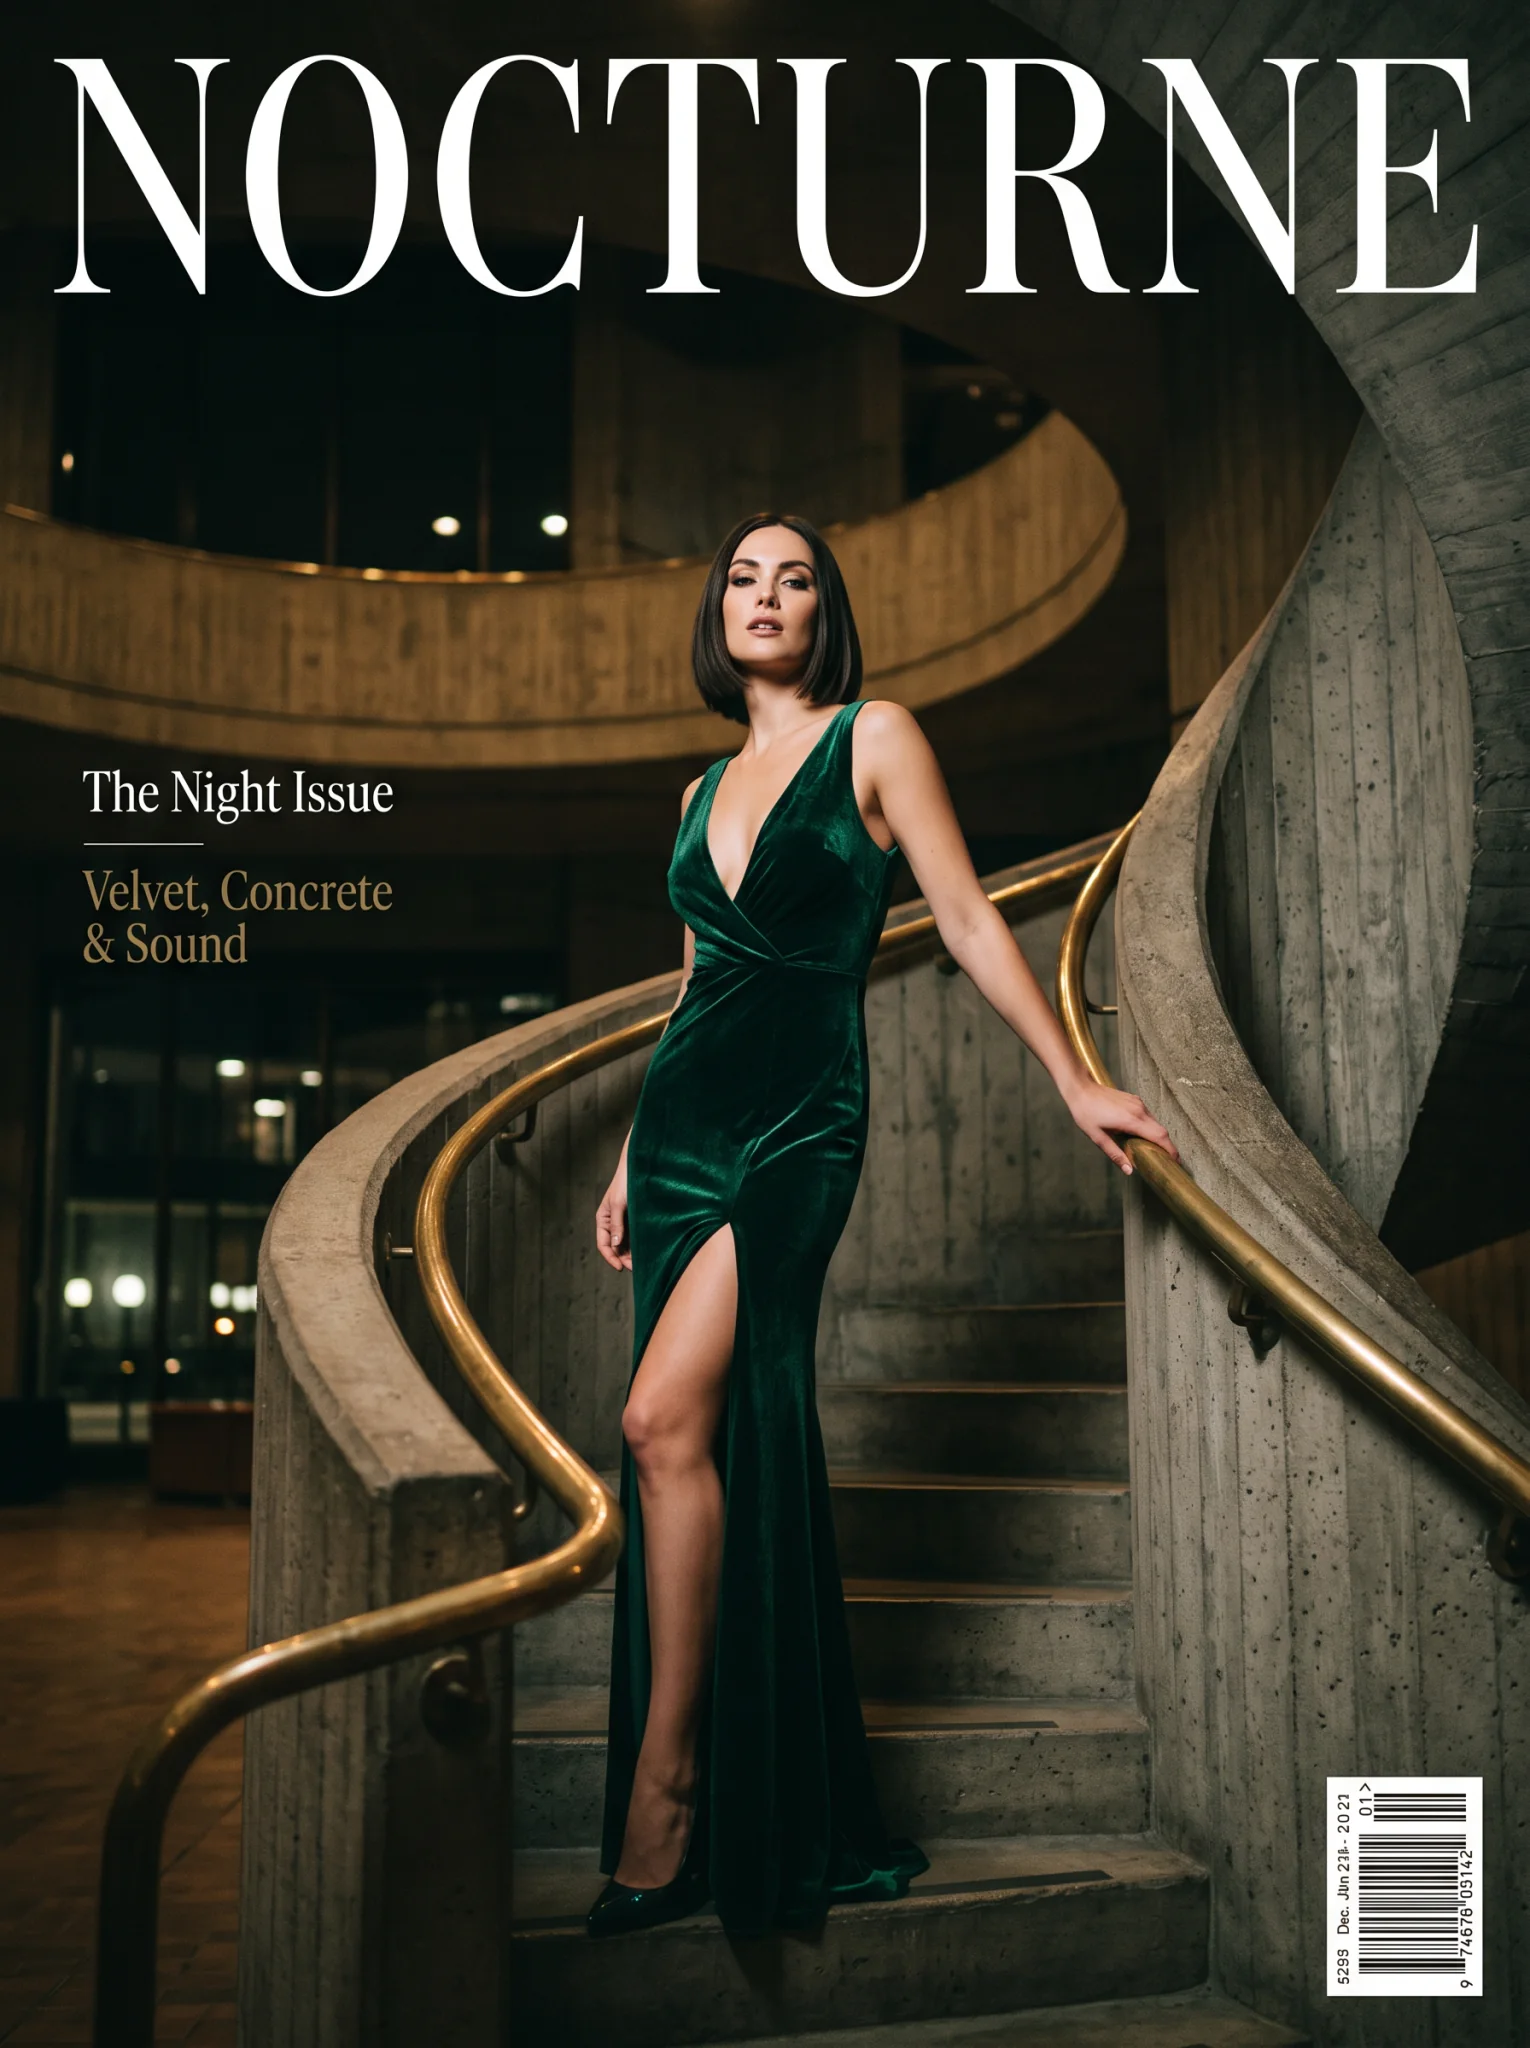
Text zu Bild, 3:4, 2k. Der Titel und beide Titelzeilen sind exakt geschrieben. Die Barcode-Ziffern, die der Prompt nicht vorgab, sind Füllmaterial.
Der verwendete Prompt:
Fashion magazine cover photograph. The masthead across the top, in tall elegant serif capitals, reads "NOCTURNE". A woman in her early thirties with a sleek dark bob stands on the curving concrete spiral staircase of a brutalist concert hall at night, wearing a plunging emerald velvet gown with a thigh-high slit, one hand on the brass rail, looking down at the camera. Small cover lines on the left read "The Night Issue" and "Velvet, Concrete & Sound". A small barcode in the lower right corner. Low-key cinematic lighting, deep green and charcoal palette.Diesen Prompt in Nano Banana 2.1 Text-zu-Bild öffnen und stellen Sie aspect_ratio auf 3:4 und resolution auf 2k, um unseren Lauf nachzustellen; der Link füllt nur den Prompt aus.
Das Filmplakat zeigt die Grenze: Titel und Starttermin sind exakt, aber der Block mit Namen, den wir verlangt haben, ohne Namen vorzugeben, kam als überzeugend aussehender Unsinn heraus.
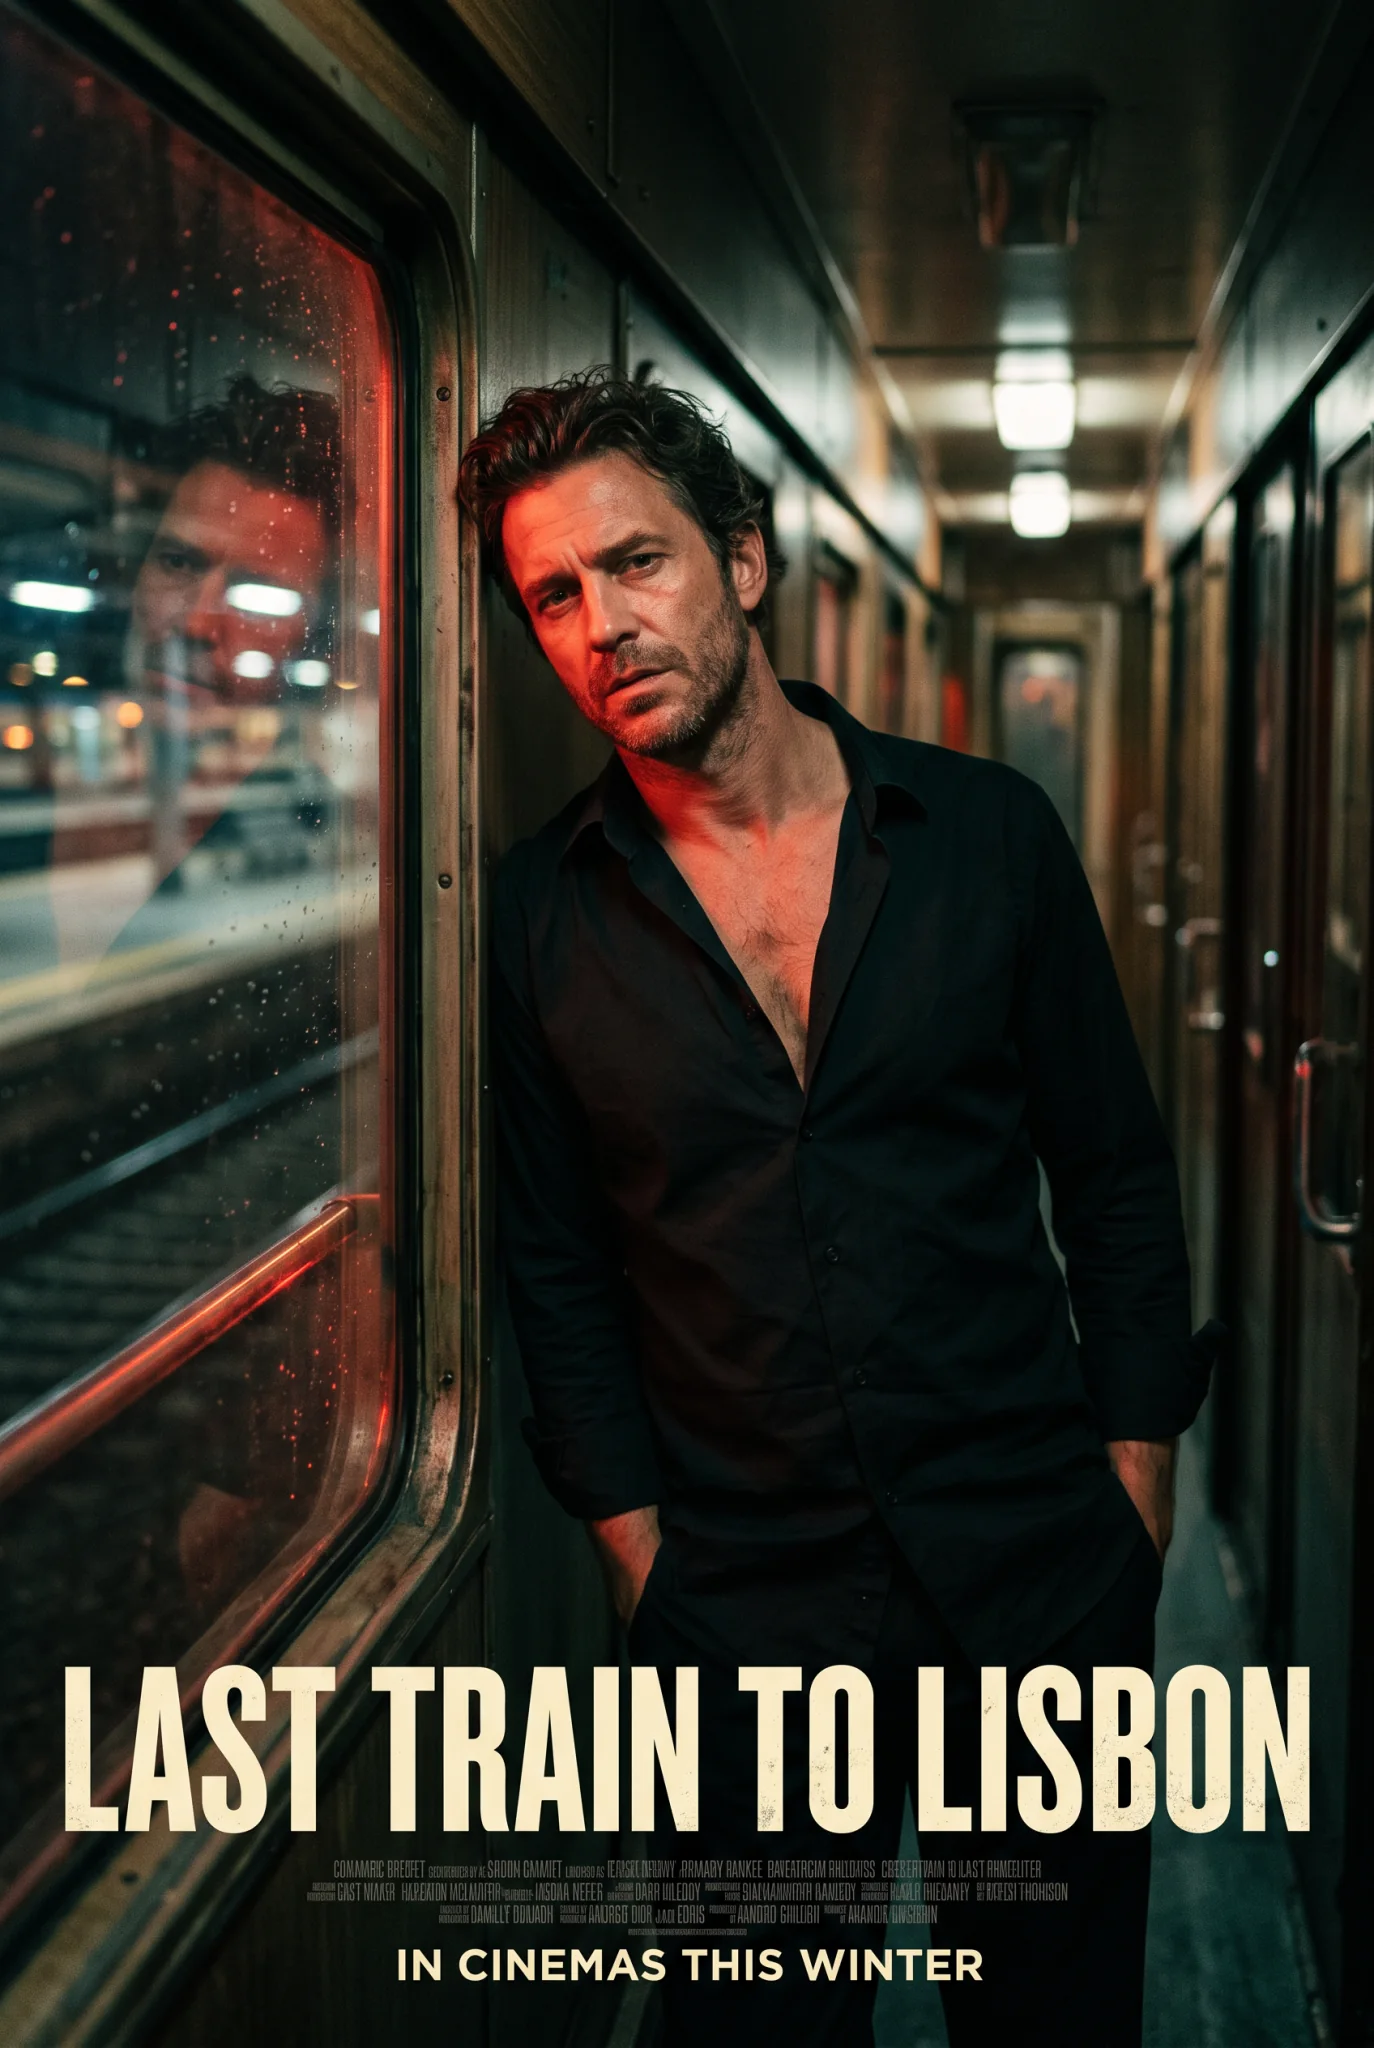
Text zu Bild, 2:3, 2k. Titel und Startzeile exakt; der Namensblock dazwischen ist Füllmaterial.
Was das für das Schreiben eines Text-Prompts heißt:
- Setzen Sie jedes Wort, das erscheinen muss, in Anführungszeichen.
- Sagen Sie, wohin es gehört und wie es aussieht. „Across the top, in tall elegant serif capitals“ landete genau dort.
- Schreiben Sie alles aus, was ein Leser lesen wird. Was Sie nur beschreiben („a small barcode“, „a block of names“), kommt als Textur zurück; prüfen Sie das Kleingedruckte also, bevor Sie veröffentlichen.
Einen kompletten Poster-Workflow mit gezielten Textkorrekturen finden Sie in unserer Anleitung zum Textlayout mit Nano Banana Pro; dieselben Prompt-Gewohnheiten gelten auch hier.
Bearbeitungen, die Person und Produkt erhalten
Die Bearbeitung nimmt 1 bis 14 Quellbilder in image_urls entgegen, in der Reihenfolge, in der Ihr Prompt auf sie verweist. Google sagt, dass bis zu 4 Figuren und bis zu 10 Objekte konsistent bleiben.
Eine Quelle: neue Szene, dasselbe Gesicht
Wir gaben ihm ein Tagesfoto einer rothaarigen Frau, die in einem Glashaus Farne gießt, in weißem Leinenhemd und Jeansshorts, und baten um einen Abend in der Oper.
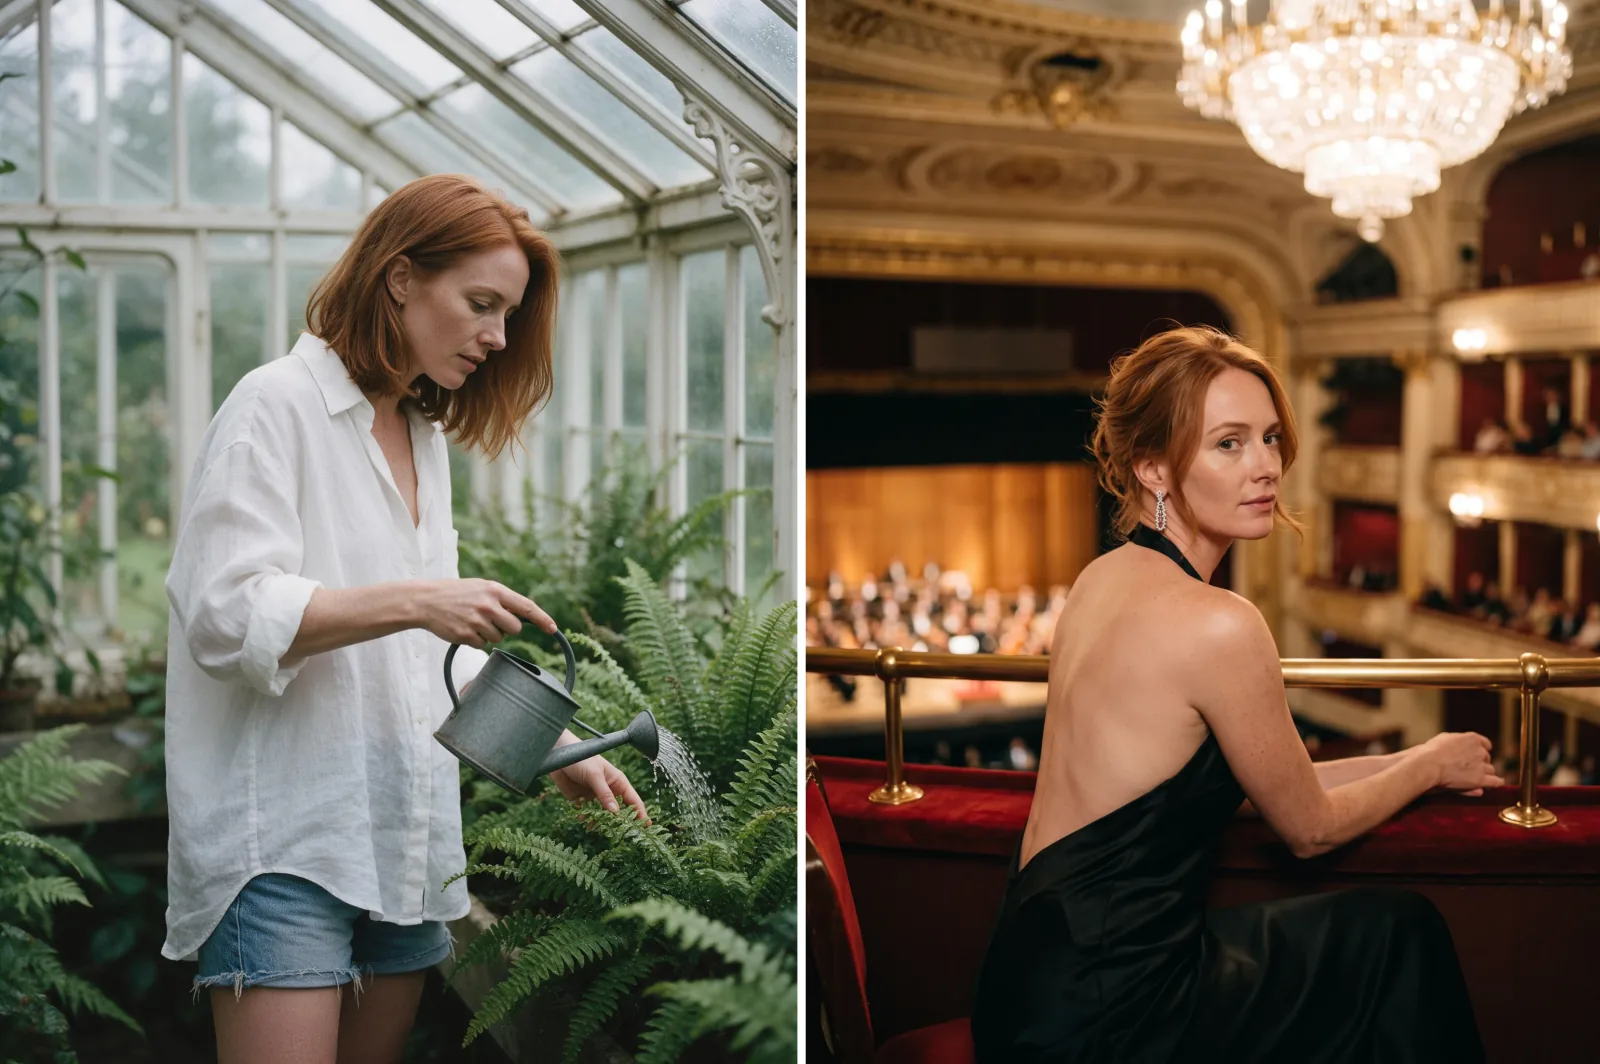
Links: das Quellfoto. Rechts: die Bearbeitung in 2k, Seitenverhältnis auf auto. Gesicht und Haarfarbe wurden übernommen; Kleid, hochgesteckte Haare, Ohrringe, Samtloge, Kronleuchter und Bühne entsprechen dem Prompt.
Take her from the greenhouse to an opera house at night: she sits in a red velvet box seat, leaning on the gilded balcony rail, wearing a backless black silk gown with her auburn hair pinned up and diamond drop earrings, looking back over her shoulder, the lit stage and a crystal chandelier softly blurred behind her. Keep her face and her hair colour.Der letzte Satz ist wichtig: Wenn Sie nennen, was bleiben muss („keep her face and her hair colour“), erfährt das Modell, welche Teile der Quelle feststehen.
Drei Quellen: eine Person, ein Produkt und ein Ort
Das ist die Aufgabe, die die meisten Produktteams interessiert. Wir lieferten ein Studio-Porträt eines Mannes, ein Produktfoto eines cognacfarbenen Wildleder-Overshirts mit Messingdruckknöpfen und eine leere Sternwarte bei Nacht.
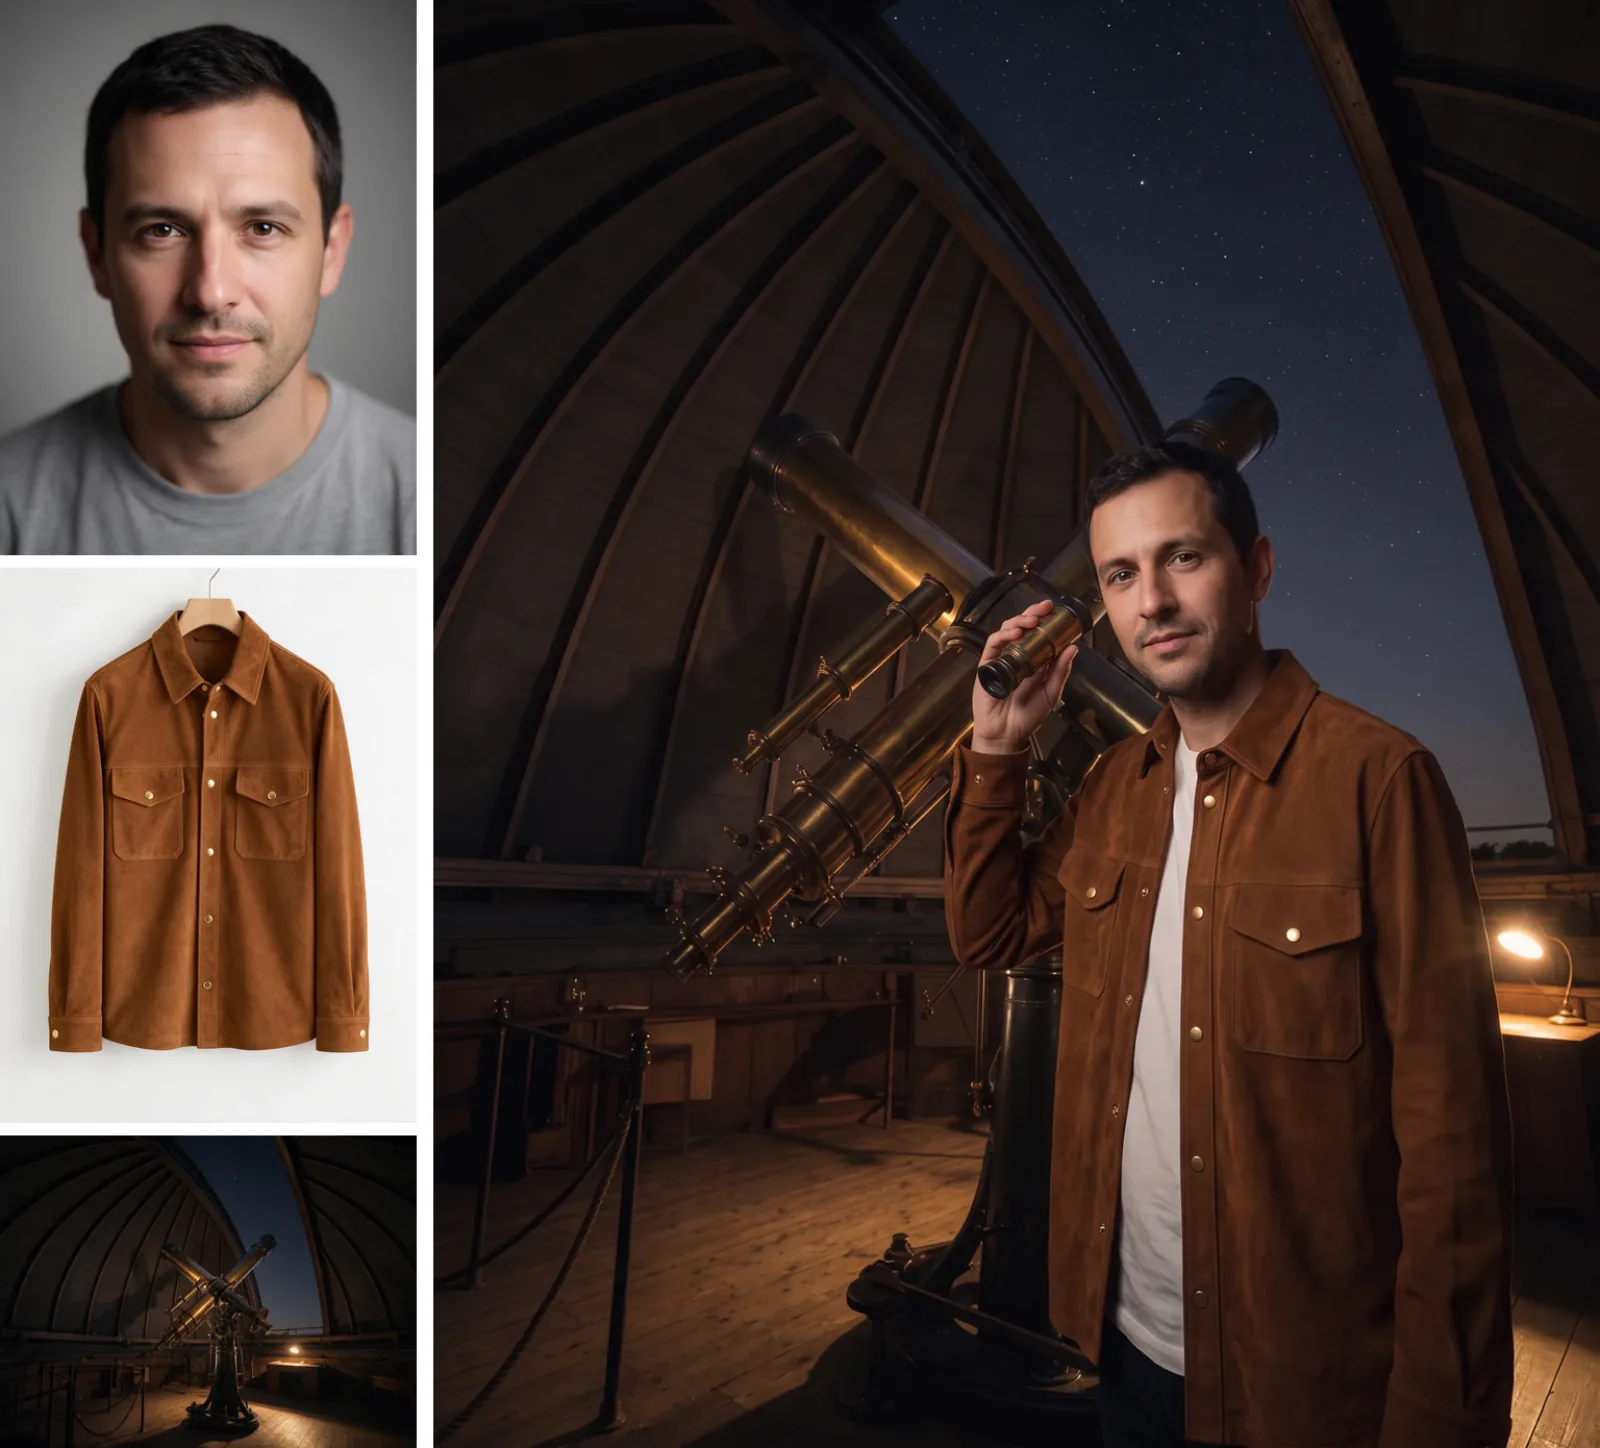
Links: die drei Quellen in Prompt-Reihenfolge. Rechts: die Bearbeitung in 4:5, 2k. Gesicht, Jackenfarbe, Messingdruckknöpfe und Brusttaschen wurden übernommen. Ein Fehler: Statt einer Hand am Okular des Teleskops hält er ein kleines Messing-Fernglas.
Combine the three images: the man from the first image wears the cognac suede overshirt from the second image, unbuttoned over a white undershirt, and stands beside the brass telescope in the observatory from the third image at night, one hand on the eyepiece, starlight from the open dome and the warm desk lamp on his face. Keep his face, and keep the jacket's colour, brass snaps and chest pockets exactly.Was funktionierte: auf jede Quelle über ihre Position verweisen, sagen, was von jeder zu übernehmen ist, und die Details nennen, die erhalten bleiben müssen. Die Handlung, die wir nur nebenbei erwähnten, ist genau die, die das Modell verändert hat; geben Sie einer Pose, auf die es ankommt, deshalb einen eigenen Satz.
Text innerhalb einer Bearbeitung
Die letzte Bearbeitung ließ zwei Personen und ein Geschäft genau so, wie sie sind, und gestaltete die Hülle in ihren Händen.
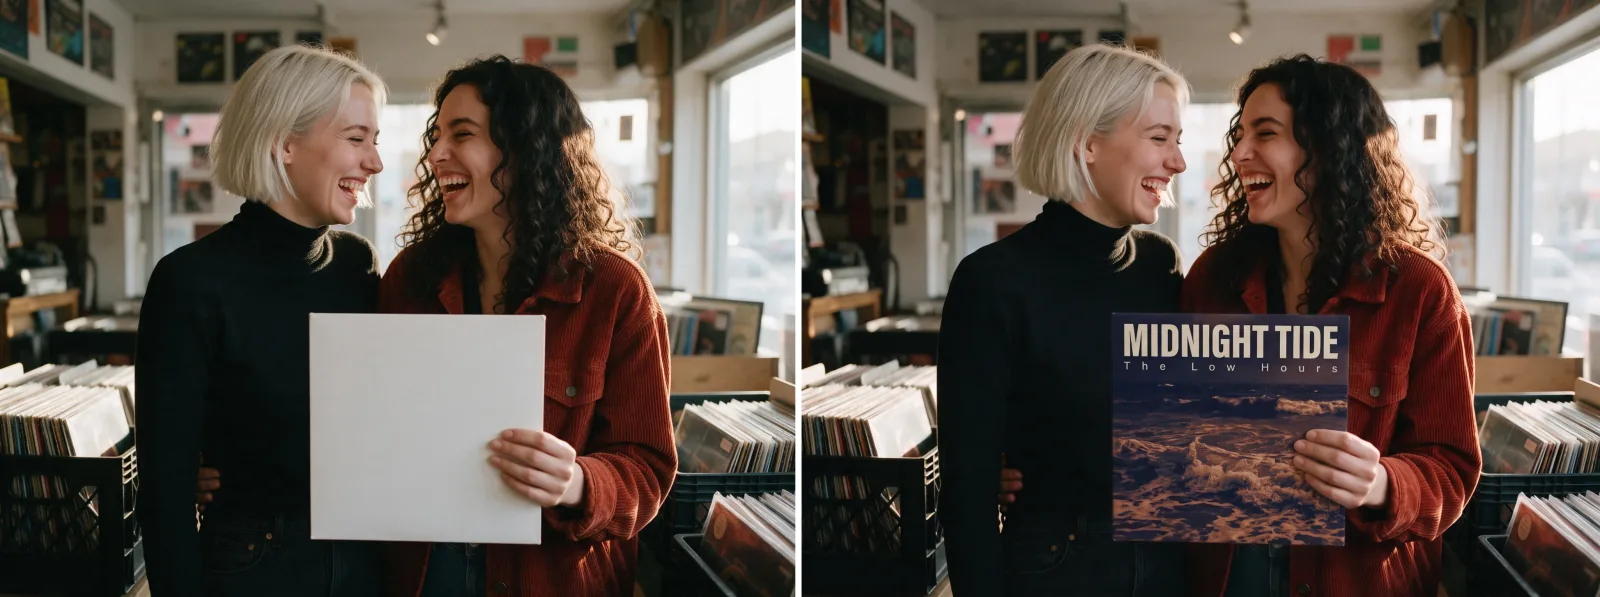
Links: die Quelle. Rechts: die Bearbeitung in 2k. Frauen, Kleidung und Laden unverändert; Titel und Bandname richtig geschrieben, der Bandname steht allerdings in gesperrter Groß- und Kleinschreibung statt in den von uns verlangten Kapitälchen.
Design the blank album sleeve she is holding: a moody duotone photograph of ocean waves at night in deep blue and rust, with the title "MIDNIGHT TIDE" in large bold sans serif and the band name "The Low Hours" in small capitals beneath it. Keep both women, their clothes, their pose and the record store exactly as they are.Seitenverhältnis bei Bearbeitungen. Die Bearbeitung kennt zusätzlich auto (Standard), das die Form der Quelle beibehält: Eine Panorama-Quelle im Format 4:1 kam mit 2064 x 512 zurück. Bei mehreren Quellen unterschiedlicher Form legen Sie das Verhältnis selbst fest. In unserem Test mit zwei Quellen folgte auto einfach einer der beiden.
Mehr zu Quellenrollen und zum Beheben von Abweichungen finden Sie in unserer Anleitung zur Referenzbearbeitung mit Nano Banana 2.
Websuche: die Lösung für Daten und aktuelle Fakten
Wir haben denselben Prompt zweimal ausgeführt:
today's weather forecast poster for Tokyo with the dateMit eingeschaltetem enable_web_search druckte das Plakat das richtige Datum, Mittwoch, 7. Oktober 2026. Ohne sie erfand das Modell ein Datum (24. Oktober). Wenn ein Bild von irgendetwas Aktuellem abhängt (einem Datum, einer Vorhersage, einer Veranstaltung), schalten Sie sie ein. enable_image_search lief ebenfalls und lieferte ein Bild, doch einen sichtbaren Unterschied haben wir nicht gemessen. Jede Suchoption kostet pro Anfrage extra; lassen Sie beide sonst aus.
Breite und hohe Formate: eine durchgehende Szene beschreiben
Google sagt, 2.1 habe Kachelartefakte bei 1:4, 4:1, 1:8 und 8:1 in 2K und 4K behoben. In unseren Tests am 7. Oktober 2026 hing es vom Motiv ab, ob breite und hohe Formate zusammenhielten, wie die Ergebnisse unten zeigen. Bei 21:9 komponierte das Modell ein durchgehendes Filmstill:
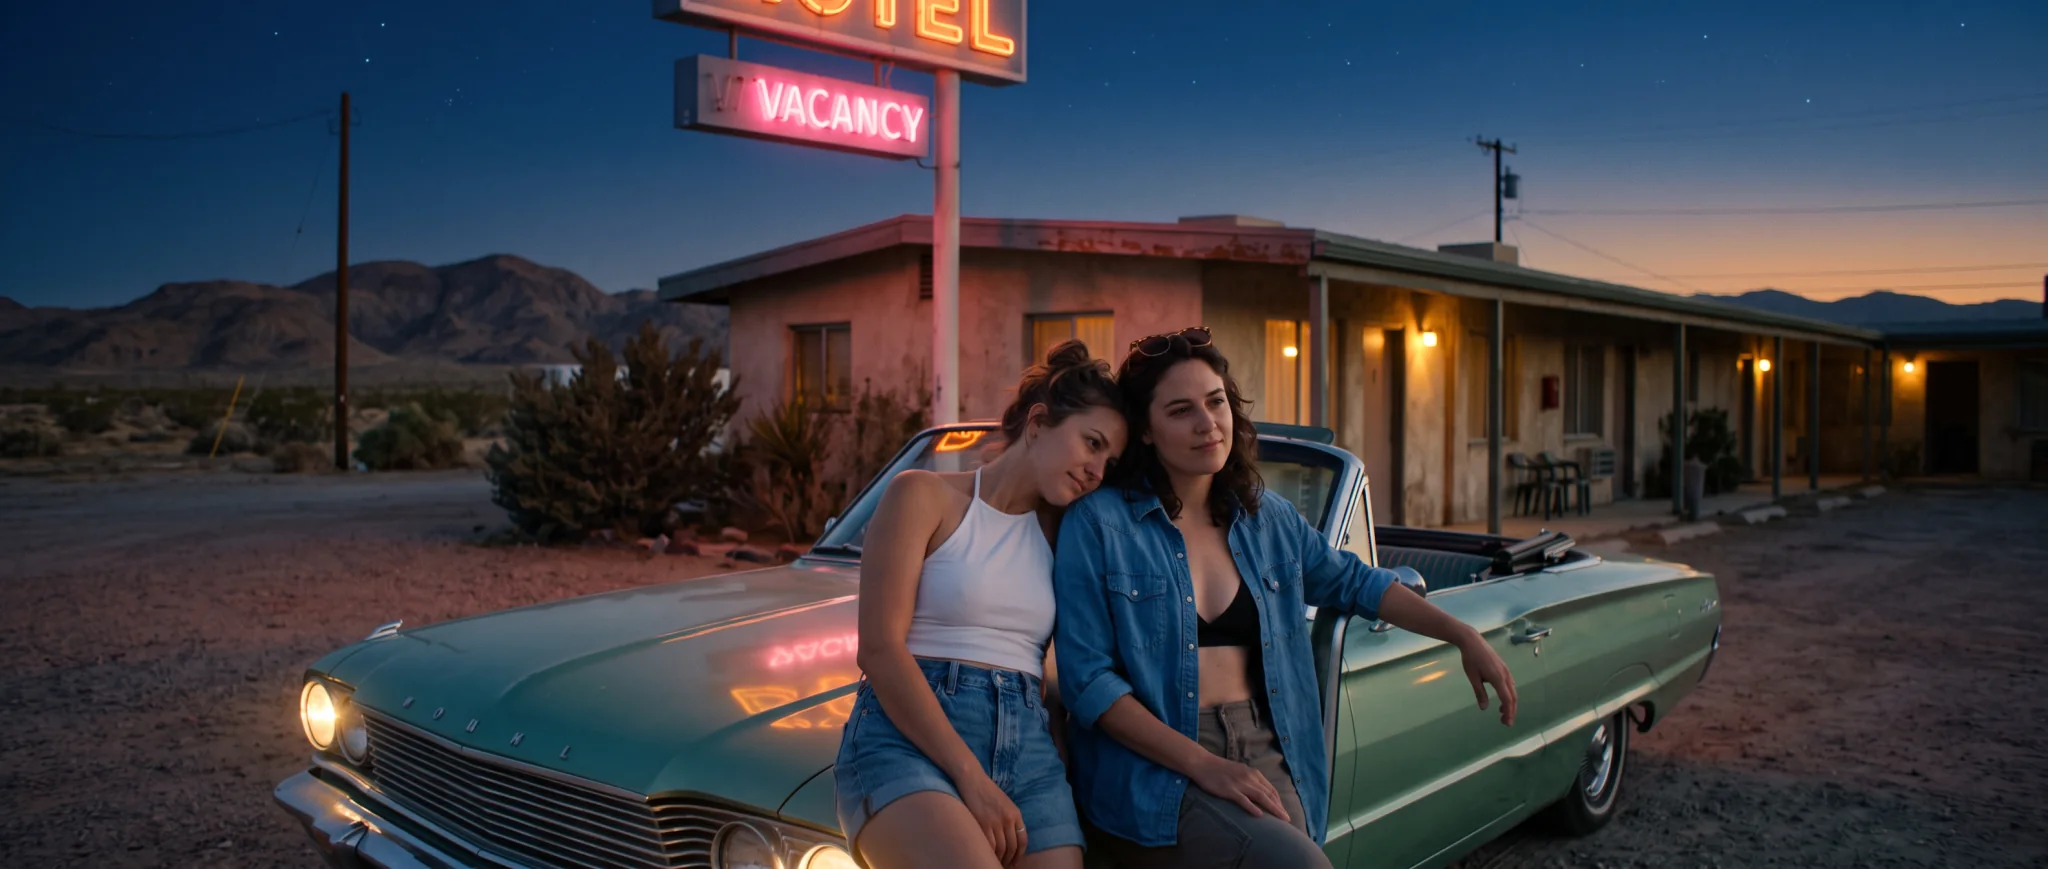
Text zu Bild, 21:9, 2k. Ein durchgehendes Bild; das Wort „VACANCY“ in Anführungszeichen ist exakt geschrieben.
Wir haben 8:1 sechsmal ausgeführt. Vier kamen als ein durchgehendes Bild zurück; zwei kamen als mehrere nebeneinandergesetzte Aufnahmen mit harten Nähten und unterschiedlichem Licht in jedem Feld. Trotz der Korrektur kommt es bei 8:1 und 2k also manchmal noch zu Kachelung. Den Unterschied machte die Formulierung. Unser erster Rave-Prompt verteilte einzelne Orientierungspunkte über die Breite (ein DJ-Pult ganz links, Stahlsäulen ganz rechts, in der Mitte ein Paar) und kam zusammengesetzt zurück. Prompts, die wir als eine durchgehende Szene umgeschrieben haben, bei der ein einziger Schauplatz die Breite füllt (ein Bergkamm in 2k und 4k, eine Raver-Menge in 4k und der umformulierte Rave unten), kamen in vier von fünf Läufen durchgehend zurück. Ein 4:1-Bergkamm in 2k war ebenfalls durchgehend (4128 x 1024). Das war unser erster Test; eine spätere Runde mit 69 weiteren Läufen, die unten beschrieben wird, zeigte, dass das Ergebnis auch davon abhängt, was im Bild ist.
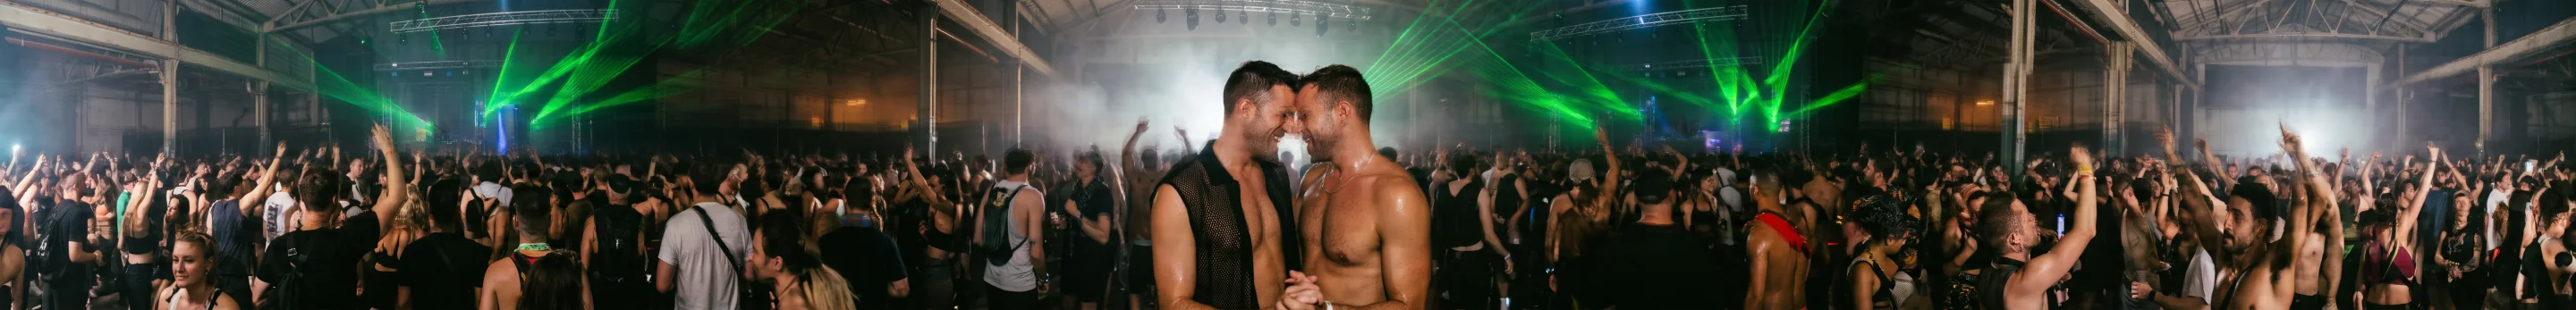
Text zu Bild, 8:1, 2k (5856 x 704, verkleinert dargestellt), als eine durchgehende Szene geschrieben: eine ununterbrochene Menge von Rand zu Rand, das Paar in der Mitte.
One continuous ultra-wide panoramic photograph, a single unbroken scene from edge to edge, inside a packed warehouse rave at three in the morning: green laser beams cut through the haze above a dancing crowd that fills the whole frame under steel roof trusses. In the middle of the crowd two men in their thirties, a gay couple, dance forehead to forehead, one in an open black mesh shirt and one shirtless with a thin gold chain, sweat glinting under the lasers.Zum Vergleich unser erster, zusammengesetzter 8:1-Lauf:
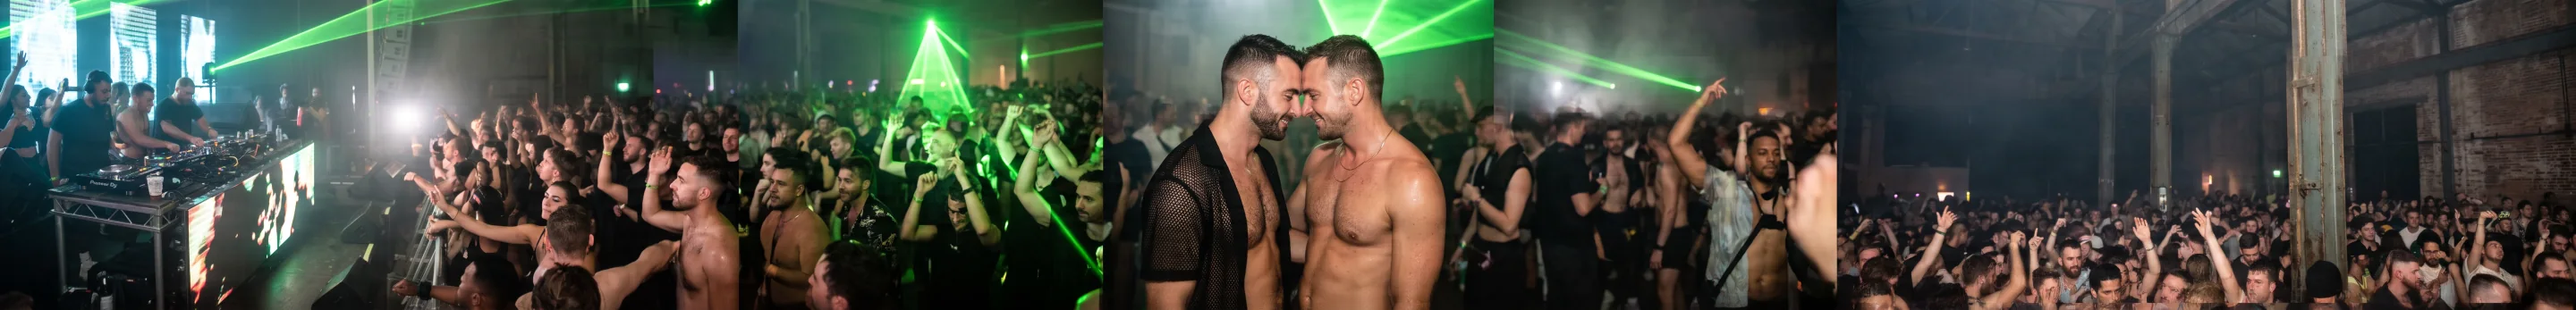
So sieht ein zusammengesetztes Ergebnis aus: 8:1, 2k. Jedes Feld hat sein eigenes Licht und seine eigene Menge, dazwischen harte senkrechte Nähte.
Hohe Formate waren schlechter. Bei 1:8 und 1k lieferte das Modell sechs übereinandergestapelte Aufnahmen derselben Strandszene (352 x 2928); bei 1:8 und 2k kam eine Berglandschaft als zur Seite gekipptes horizontales Panorama zurück (704 x 5856).
Späterer Test mit 69 Läufen. Später am 7. Oktober haben wir 69 weitere breite und hohe Formate erzeugt. Ob ein 8:1- oder 4:1-Bild zusammengesetzt wirkt, hängt von Personen ab: Landschaften und ferne Menschenmengen hielten zusammen, während Personen nah an der Kamera oder über die Bildbreite verteilt etwa jedes zweite Mal zusammengesetzt wurden. Über alle unsere 8:1-Läufe dieses Tages kamen 10 von 35 zusammengesetzt zurück. Bei 1:4 und 1:8 funktioniert ein Motiv, das selbst hoch ist: 1:4 hielt 8 von 8 Mal zusammen, 1:8 11 von 14 Mal. Alle Details und Prompts stehen in unserem Leitfaden für Panorama- und Banner-Prompts.
Was zu tun ist:
- Beschreiben Sie eine durchgehende Szene. Sagen Sie das gleich in den ersten Worten („one continuous ultra-wide panoramic photograph, a single unbroken scene from edge to edge“) und lassen Sie einen einzigen Schauplatz die Breite füllen, statt an beiden Enden einzelne Orientierungspunkte zu setzen.
- Prüfen Sie jedes breite Ergebnis in voller Größe auf senkrechte Nähte oder einen plötzlichen Lichtwechsel, bevor Sie es verwenden.
- Halten Sie Personen in 8:1- und 4:1-Formaten klein oder an einer Stelle. Personen nah an der Kamera oder über die Breite verteilt kippten unsere späteren Läufe ins Zusammengesetzte.
- Nehmen Sie bei 1:4 und 1:8 ein Motiv, das selbst hoch ist (eine stehende Figur, ein Turm, ein Wasserfall). Siehe den Panorama-Leitfaden.
Größen, Tempo und Preis
Die Parameter, jeweils in einer Zeile:
prompt: bis zu 5.000 Zeichen.aspect_ratio: 14 Optionen von 1:1 bis 8:1 und 1:8; Standard16:9bei Text zu Bild,autobei der Bearbeitung.resolution:1k(Standard),2koder4k.output_format:png(Standard) oderjpeg. Bei 1k und 21:9 war das JPEG 307 KB groß und das PNG etwa 1,1 MB.enable_web_searchundenable_image_search: beide standardmäßig aus.image_urls(nur Bearbeitung): 1 bis 14 Quellbilder.
Die von uns gemessenen Ausgabegrößen:
| Stufe | Verhältnis | Größe (Pixel) |
|---|---|---|
| 1k | 1:1 | 1024 x 1024 |
| 1k | 3:4 | 896 x 1200 |
| 1k | 21:9 | 1584 x 672 |
| 1k | 1:8 | 352 x 2928 (sechs gestapelte Aufnahmen) |
| 2k | 3:4 | 1792 x 2400 |
| 2k | 2:3 | 1696 x 2528 |
| 2k | 4:5 | 1856 x 2304 |
| 2k | 16:9 | 2752 x 1536 |
| 2k | 21:9 | 3168 x 1344 |
| 2k | 4:1 | 4128 x 1024 |
| 2k | 8:1 | 5856 x 704 |
| 2k | 1:8 | 704 x 5856 (ein zur Seite gekipptes Querformat) |
| 4k | 1:1 | 4096 x 4096 |
Die Modellzeit lag in unseren Tests am 7. Oktober bei etwa 10 bis 35 Sekunden bei 1k und 2k und bei bis zu etwa einer Minute bei 4k.
Abgerechnet wird pro Bild nach Größenstufe (2k kostet mehr als 1k, 4k mehr als 2k); Seitenverhältnis und Ausgabeformat ändern den Preis nicht. Auf SpicyAPI startet Nano Banana 2.1 zu einem Preis deutlich unter Googles eigenem Listenpreis; die Modellseite zeigt die aktuellen Preise. Jede Suchoption kostet extra. Ablehnungen sind kostenlos; ein abgeschwächtes Bild wird wie jedes andere berechnet. Entwerfen Sie mit 1k und lassen Sie die gelungenen Bilder dann in 2k oder 4k neu laufen.
Wie weit die Inhalte gehen
Nano Banana 2.1 folgt Googles Inhaltsrichtlinie; SpicyAPI fügt keinen eigenen Filter hinzu. Am 7. Oktober 2026 haben wir zwei Runden nur mit erwachsenen Motiven gefahren und jedes Bild mit bloßem Auge geprüft: eine erste Runde mit Text-zu-Bild-Prompts bei 3:4 und 1k, danach sechs Probearten mit je drei Läufen bei Text zu Bild und bei der Bearbeitung, mit Standardeinstellungen. Die Tabelle zeigt den zweiten Satz.
| Stufe | Was sie umfasst | Text zu Bild (3 Läufe) | Bearbeitung (3 Läufe) |
|---|---|---|---|
| L1 Andeutung | Dessous, ein rutschender Träger | 3 wie verlangt gerendert | 3 abgelehnt (ein Dessous-Tausch) |
| L2 Teilweise | Freizügige Inhalte | 2 abgeschwächt (abgewandt oder bedeckt), 1 abgelehnt | 3 abgeschlossen und berechnet, aber in Pullover oder Hemd neu eingekleidet |
| L3 Stark | Starke Inhalte | 3 abgeschwächt (in Hemd und Hose neu eingekleidet) | 3 abgelehnt |
| L4 Intensiv | Eine intime Szene zwischen zwei Erwachsenen | 3 abgeschwächt (unter der Decke kuschelnd) | 3 abgelehnt |
| L5 Extrem | Einvernehmliche Fesselung unter Erwachsenen oder filmisches Gore | Fesselung: 3 abgelehnt. Gore: 3 abgelehnt | Fesselung: 3 abgelehnt. Gore: 3 gerendert |
Bei Text zu Bild ist die Stufe L1 für Mode, Bademode und Boudoir-Motive wirklich brauchbar. Diese drei stammen aus unserer ersten Runde:
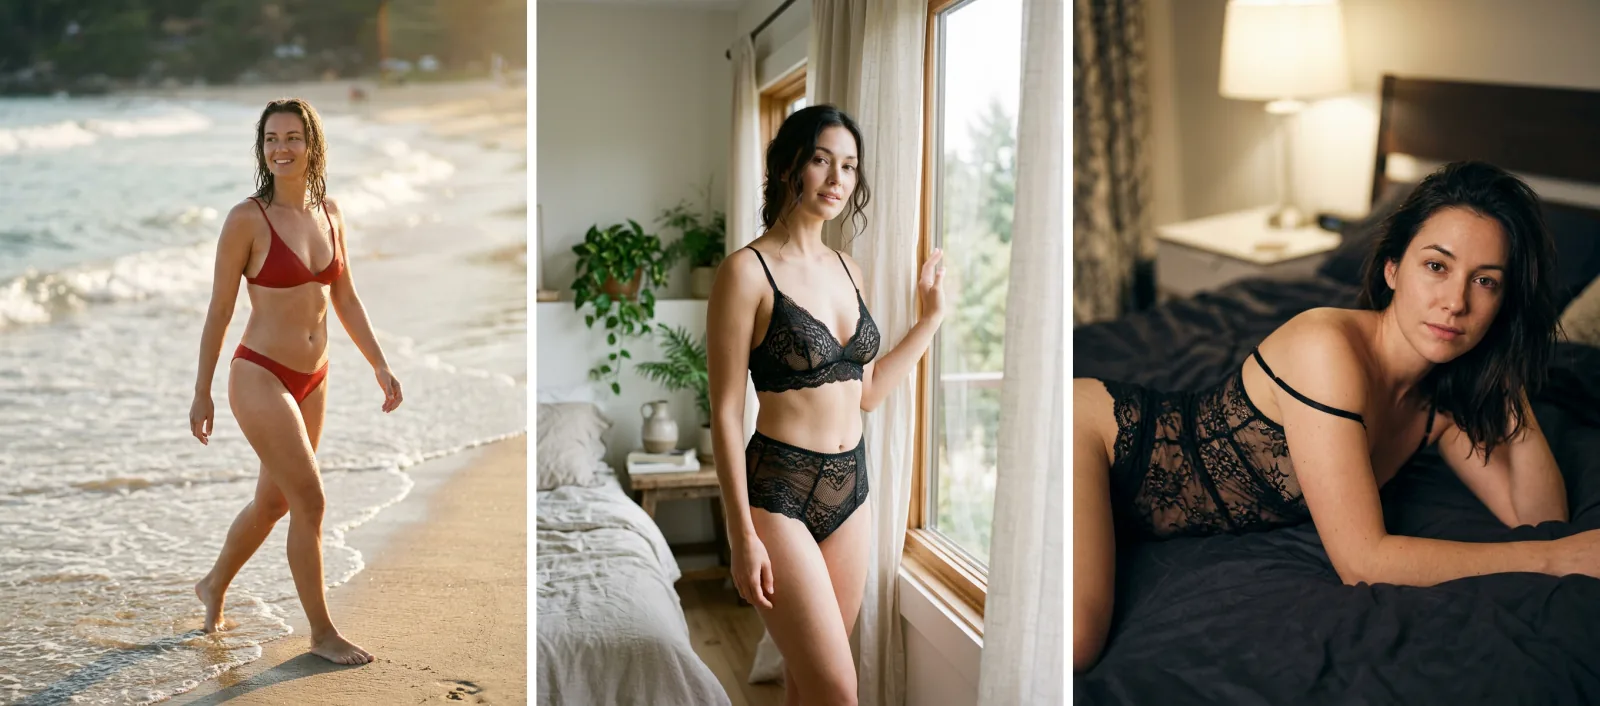
Text zu Bild, 3:4, 1k. Die drei Prompts der Stufe L1 Andeutung, jeweils wie verlangt gerendert.
Oberhalb von L1 lehnt Text zu Bild meist nicht ab, sondern verändert das Bild. In unserer ersten Runde liefen zehn Anfragen von L2 bis L4 (je zwei Läufe von fünf Prompts) alle durch, wurden berechnet und gaben ein bekleidetes Bild zurück: die Frau im übergroßen Pullover oder in Strickjacke und Jeans, der Mann in T-Shirt und Jeans, die Duschszene in ein Handtuch gehüllt, das Paar, das unter der Bettdecke kuschelt. Im zweiten Satz wurde ein L2-Lauf ausdrücklich abgelehnt, und Fesselung und Gore wurden jedes Mal abgelehnt. Ein abgeschwächtes Bild erkennt man nur, indem man es ansieht.
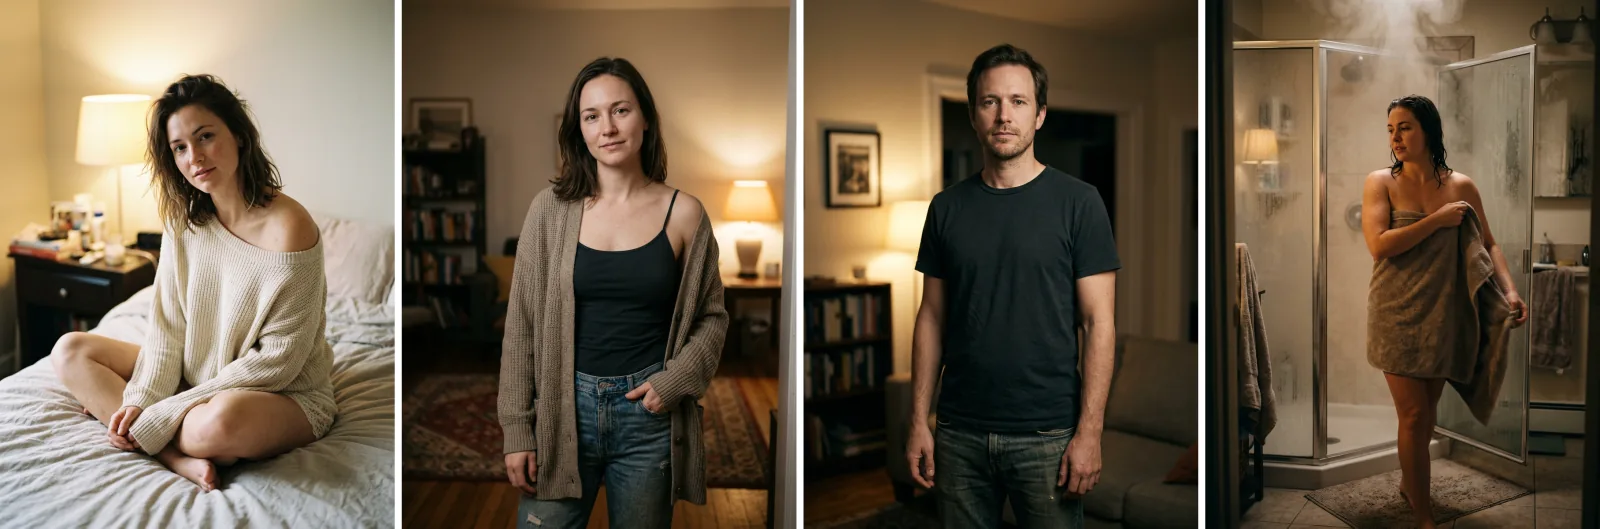
Erste Runde, was bei Anfragen auf L2 und L3 zurückkam: Jede lief durch und wurde berechnet, und nichts in der Antwort kennzeichnet sie als verändert. Das Ergebnis auf L4 ist oben beschrieben und wird nicht gezeigt.
Die Bearbeitung lehnt mit unseren eigenen bekleideten Quellfotos mehr ab. Der Tausch eines Kleides gegen Dessous und beide Bearbeitungen zum Entfernen von Kleidung in unserer ersten Runde wurden mit „Content flagged as potentially sensitive“ abgelehnt, ebenso die Proben zu L3, L4 und Fesselung im zweiten Satz. Zwei Arten von Anfragen gingen durch: L2-Bearbeitungen kamen abgeschlossen und berechnet zurück, aber mit der Person neu eingekleidet in Pullover oder Hemd, und filmisches Gore wurde wie verlangt gerendert. Auch eine Bearbeitung zu einem rückenfreien Abendkleid ging durch; das Opern-Beispiel oben ist eine solche Bearbeitung.
Was das in der Praxis bedeutet:
- Ein abgeschwächtes Bild ist das stille Scheitern. Die Aufgabe meldet „abgeschlossen“, und Sie zahlen, bei Text zu Bild ebenso wie bei L2-Bearbeitungen; prüfen Sie daher jede Ausgabe, bevor sie einen Kunden oder einen Feed erreicht.
- Ablehnungen sind sichtbar und kostenlos. Bei beiden Aufgaben kommen sie nach etwa 70 bis 90 Sekunden als fehlgeschlagen mit „Content flagged as potentially sensitive“ zurück und werden nicht berechnet.
- Keine Einstellung ändert das. Kein öffentlicher Parameter steuert Inhalte, und Nano Banana 2 und Pro haben denselben Anbieter; unser früherer Inhaltstest zu Nano Banana 2 behandelt, wie sie ähnliche Anfragen handhabten.
Welches Modell sollten Sie wählen?
Am 7. Oktober 2026 haben wir Nano Banana 2.1 durch unseren eigenen Blindtest laufen lassen, mit denselben Fragen und Referenzankern wie bei unseren früheren Bild-Durchläufen; drei KI-Juroren verschiedener Hersteller bewerteten die Bilder blind.
| Blindtest | Nano Banana 2.1 | Nano Banana Pro | Nano Banana 2 |
|---|---|---|---|
| Gesamtwertung (von 100) | 75,6 | 74,4 | 70,3 |
| Messdatum | 7. Oktober 2026 | 5. Oktober 2026 | 5. Oktober 2026 |
Die Teilwerte von Nano Banana 2.1 waren 76,7 für Prompt-Treue (14 Fragen), 77,8 für Bildqualität (14) und 65,9 für Bearbeitungskonsistenz (6 Bearbeitungsfragen). Wo es patzte: Es zeichnete sechs Luftballons statt fünf und sieben Gäste statt sechs, und bei Bearbeitungen tauschte es bei einer Aufgabe zur Neubeleuchtung den Hintergrund gegen eine nächtliche Straße aus und rückte bei einer Schneefall-Aufgabe die Kamera näher heran. Beide Textfragen wurden richtig geschrieben; einen Teilwert für Text veröffentlichen wir nicht, weil der Test weniger als sechs Textfragen enthielt. Wenn es auf eine exakte Anzahl ankommt, zählen Sie nach, und sagen Sie bei Bearbeitungen ausdrücklich, dass Hintergrund und Bildausschnitt gleich bleiben müssen.
Die Tabelle verbindet diese Zahlen mit unseren praktischen Läufen.
| Ihre Aufgabe | Wahl | Warum |
|---|---|---|
| Poster, Cover, Schilder oder Infografiken, bei denen die Wörter stimmen müssen | Nano Banana 2.1 | In unseren Tests kam jede Zeile in Anführungszeichen exakt geschrieben heraus |
| Eine Person oder ein Produkt in eine neue Szene bringen | Bearbeitung mit Nano Banana 2.1 | Bis zu 14 Quellen; Gesicht, Jackenfarbe, Druckknöpfe und Taschen wurden in unserem Test mit drei Quellen übernommen |
| Bilder, die vom heutigen Datum oder von aktuellen Fakten abhängen | Nano Banana 2.1 mit enable_web_search | Mit Suche das richtige Datum gedruckt; ohne sie eines erfunden |
| Die kleinste Entwurfsgröße | Nano Banana 2 | Es hat eine 0.5k-Entwurfsstufe; 2.1 beginnt bei 1k |
| Eine Pipeline, die bereits auf Nano Banana Pro abgestimmt ist | Nano Banana Pro, dann 2.1 mit Ihren eigenen Prompts ausprobieren | Ein kleiner Abstand im Blindtest (75,6 gegenüber 74,4) |
| Breite Banner bis 8:1 | Nano Banana 2.1, als eine durchgehende Szene formuliert | Landschaften und ferne Menschenmengen hielten zusammen; Personen nah an der Kamera oder über die Breite verteilt wurden etwa jedes zweite Mal zusammengesetzt (10 von 35 8:1-Läufen an diesem Tag). Hohe 1:4 und 1:8 funktionieren bei hohen Motiven. Siehe den Panorama-Leitfaden |
| Bilder für Erwachsene ab L2 | Die unzensierten Bildfamilien von SpicyAPI | Googles Richtlinie schwächt die meisten davon ab oder lehnt sie ab, bei beiden Aufgaben |
Nano Banana 2.1 gegen Nano Banana 2. Google beschreibt 2.1 als direktes Update, und unser Blindtest bestätigt die Richtung (75,6 gegenüber 70,3). Beginnen Sie neue Arbeit mit 2.1; bleiben Sie bei Nano Banana 2, wenn Sie auf dessen 0.5k-Entwurfsstufe angewiesen sind oder eine funktionierende Pipeline noch nicht neu testen wollen.
Nano Banana 2.1 gegen Nano Banana Pro. Google nennt 2.1 das effizientere Gegenstück zu Pro, und in unserem Blindtest erzielte es einen etwas höheren Wert (im Abstand von zwei Tagen gemessen). Der Abstand ist klein; wenn Sie Pro-Prompts haben, denen Sie vertrauen, lassen Sie sie durch 2.1 laufen und vergleichen Sie, bevor Sie wechseln.
Für Inhalte für Erwachsene wählen Sie eine andere Basis. Nano Banana 2.1 passt zur bekleideten, öffentlichen Seite eines Projekts: Werbeplakate, Figurenkarten, Produktszenen, Mode auf Dessous-Niveau. Für L2 und darüber öffnen Sie den SpicyAPI-Modellkatalog, filtern nach Inhaltsrichtlinie und wählen je nach Aufgabe eine unzensierte Bildfamilie. Arbeiten Sie nur mit fiktiven Erwachsenen oder mit Erwachsenen, die ihre Zustimmung gegeben haben.
FAQ
Ist Nano Banana 2.1 unzensiert?
Nein. Es folgt Googles Inhaltsrichtlinie. In unseren Tests am 7. Oktober 2026 renderte Text zu Bild Bilder der Stufe L1 Andeutung, schwächte L2 bis L4 meist ab (ein L2-Lauf wurde abgelehnt) und lehnte Fesselung und Gore ab. Die Bearbeitung lehnte die meisten Anfragen für Erwachsene ab, kleidete L2-Anfragen neu ein und renderte filmisches Gore.
Warum habe ich ein bekleidetes Bild statt eines Fehlers erhalten?
Text zu Bild schließt Anfragen jenseits von Googles Grenze meist mit einem abgeschwächten Bild und ohne Ablehnungsmeldung ab, berechnet wie jedes andere Bild; die Bearbeitung tat bei L2-Anfragen dasselbe. Prüfen Sie jedes Ergebnis mit bloßem Auge.
Werde ich berechnet, wenn Nano Banana 2.1 eine Anfrage ablehnt?
Nein. Ablehnungen kommen bei beiden Aufgaben als fehlgeschlagen mit „Content flagged as potentially sensitive“ zurück, meist nach etwa 70 bis 90 Sekunden, und werden nicht berechnet. Eine Anfrage, die das Modell abschwächt, wird berechnet, weil sie trotzdem ein Bild liefert.
Wie viele Referenzbilder kann ich bei einer Bearbeitung verwenden?
Zwischen 1 und 14, in image_urls, in der Reihenfolge, in der Ihr Prompt auf sie verweist. Google sagt, dass bis zu 4 Figuren und bis zu 10 Objekte konsistent bleiben; in unserem Test mit drei Quellen wurden das Gesicht und die Jackendetails übernommen.
Wann sollte ich die Websuche einschalten?
Wenn das Bild von aktuellen Informationen abhängt. Mit enable_web_search druckte unser Tokioter Vorhersageplakat das richtige Datum; ohne sie erfand das Modell eines. Jede Suchoption kostet pro Anfrage extra.
Welche Auflösung sollte ich verwenden?
Entwerfen Sie mit 1k und lassen Sie die gelungenen Bilder in 2k oder 4k neu laufen. Jede Stufe darüber kostet mehr, und die Modellzeit lag bei etwa 10 bis 35 Sekunden bei 1k und 2k gegenüber bis zu etwa einer Minute bei 4k.