O Google lançou o Nano Banana 2.1 em 6 de outubro de 2026, e a proposta mira os trabalhos em que os modelos de imagem costumam falhar: o título de uma revista, o nome de um filme, uma placa ao fundo. Antes de mover um fluxo de pôsteres, anúncios ou personagens para ele, você precisa de três respostas: a promessa sobre o texto se sustenta, as edições mantêm a pessoa de partida e até onde a política de conteúdo do Google deixa você ir antes que o modelo troque sua imagem em silêncio?
O Nano Banana 2.1 é o modelo de imagem do Google para quando as palavras na imagem precisam estar certas. Nos nossos testes de 7 de outubro de 2026, toda linha que pusemos entre aspas duplas saiu escrita como pedido, as edições com várias imagens levaram rostos e detalhes de produto para cenas novas, e a busca na web corrigiu uma data que o modelo, de outro modo, inventava. Não é um modelo sem censura. Imagens no nível lingerie foram renderizadas em texto para imagem, mas os pedidos de L2 a L4 voltaram quase sempre concluídos, cobrados e suavizados sem aviso, contenção e gore foram recusados, e a tarefa de edição recusou a maioria dos pedidos adultos. Banners largos se mantiveram inteiros com paisagens e multidões distantes, mas com pessoas perto da câmera voltaram colados cerca de metade das vezes, e os quadros altos 1:8 só funcionaram com assuntos que já são altos.
Rodamos todos os testes pela página da família Nano Banana 2.1 na SpicyAPI, onde o modelo entrou no ar em 7 de outubro de 2026. As afirmações do próprio Google abaixo vêm da sua documentação do modelo.
Em resumo
| Nano Banana 2.1 (testado em 7 de outubro de 2026) | |
|---|---|
| Editor e lançamento | Google, 6 de outubro de 2026; o código de modelo do Google é gemini-nano-banana-2.1 |
| O que é | Uma atualização do Nano Banana 2 (Gemini 3.1 Flash Image); o Google o chama de contraparte mais eficiente do Nano Banana Pro |
| Nomes de modelo na API | google/nano-banana-2.1/text-to-image e google/nano-banana-2.1/edit |
| Entradas | prompt de até 5.000 caracteres; a edição aceita de 1 a 14 imagens de origem |
| Tamanhos | 1k (padrão), 2k, 4k; 14 proporções de 1:1 a 8:1 e 1:8 |
| Saída | Uma imagem PNG (padrão) ou JPEG por requisição |
| Velocidade nos nossos testes | Cerca de 10 a 35 segundos em 1k e 2k, até cerca de um minuto em 4k (tempo do modelo) |
| Texto nos nossos testes | Toda linha entre aspas saiu escrita como pedido; letras miúdas que não soletramos voltaram como enchimento |
| Conteúdo nos nossos testes | Vale a política do Google. Texto para imagem: L1 renderizado, L2 a L4 quase sempre suavizados sem aviso (cobrados), contenção e gore recusados. Edição: a maioria dos pedidos adultos recusada, L2 com a pessoa vestida de novo (cobrado), gore cinematográfico renderizado |
| Não disponível | Seed, prompt negativo, várias imagens por requisição, máscara, um nível de rascunho 0.5k |
| Teste às cegas (7 de outubro de 2026) | 75.6 / 100: aderência ao prompt 76.7, qualidade de imagem 77.8, consistência de edição 65.9. Mesmas perguntas: Nano Banana Pro 74.4, Nano Banana 2 70.3 (ambos em 5 de outubro de 2026) |
| Preço | Por imagem conforme o nível de tamanho, a partir de um preço bem abaixo da tabela de preços do próprio Google; cada opção de busca acrescenta uma cobrança |
O que é o Nano Banana 2.1
O Google diz que o Nano Banana 2.1 é “uma atualização do Nano Banana 2 (Gemini 3.1 Flash Image)” que “mantém a velocidade e a eficiência de custo do Flash, com melhorias significativas em qualidade visual, aderência ao prompt, consistência de personagens entre turnos e renderização de texto”. Também o chama de “a contraparte mais eficiente do Gemini 3 Pro Image (Nano Banana Pro)”. As principais novidades do Google incluem melhor diagramação de infográficos, correção das emendas em proporções largas e panorâmicas em 2K e 4K, até 14 imagens de referência (mantendo consistentes até 4 personagens e 10 objetos) e embasamento com o Google Web Search e o Image Search. As seções abaixo conferem essas afirmações com o que voltou.
Renderização de texto: a melhoria principal se sustenta
É o motivo para testar o modelo e a afirmação que melhor resistiu. Pedimos oito linhas de letreiro em três prompts de texto para imagem e uma edição (uma capa de revista, um pôster de filme, um letreiro de néon de motel e o encarte de um álbum, todos mostrados neste artigo), e toda linha entre aspas duplas saiu escrita como pedido.
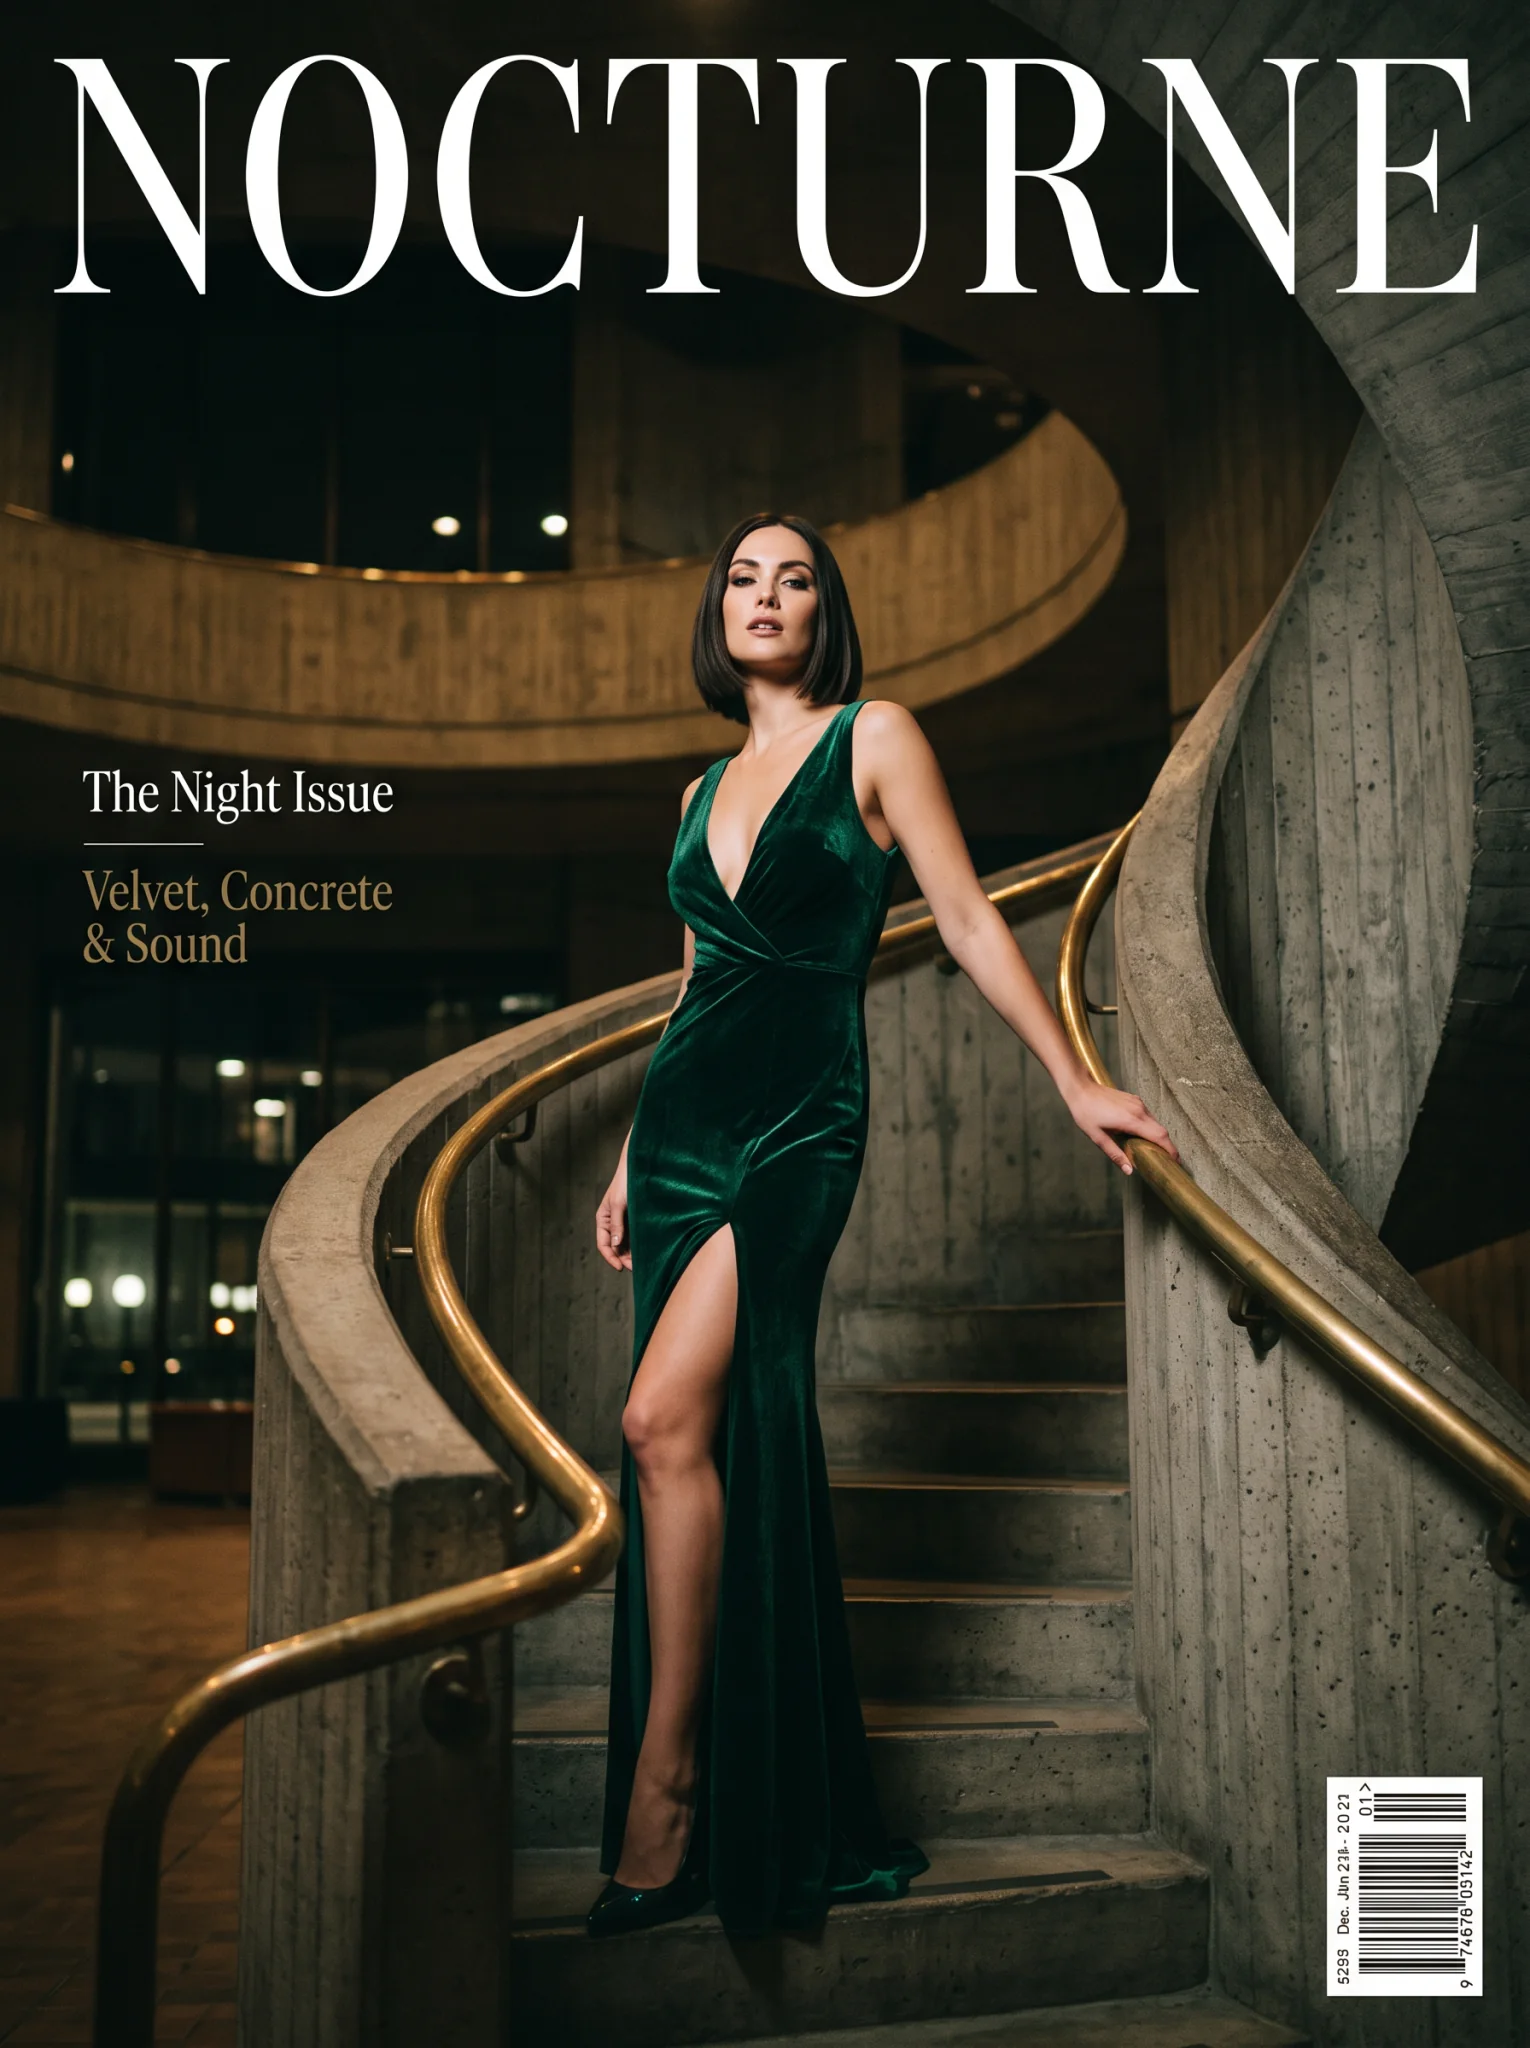
Texto para imagem, 3:4, 2k. O título e as duas chamadas de capa estão escritos como pedido. Os dígitos do código de barras, que o prompt não soletrou, são enchimento.
O prompt que usamos:
Fashion magazine cover photograph. The masthead across the top, in tall elegant serif capitals, reads "NOCTURNE". A woman in her early thirties with a sleek dark bob stands on the curving concrete spiral staircase of a brutalist concert hall at night, wearing a plunging emerald velvet gown with a thigh-high slit, one hand on the brass rail, looking down at the camera. Small cover lines on the left read "The Night Issue" and "Velvet, Concrete & Sound". A small barcode in the lower right corner. Low-key cinematic lighting, deep green and charcoal palette.Abrir este prompt no Nano Banana 2.1 texto para imagem e defina aspect_ratio como 3:4 e resolution como 2k para igualar a nossa execução; o link preenche apenas o prompt.
O pôster de filme mostra o limite: o título e a linha de estreia estão exatos, mas o bloco de nomes, que pedimos sem escrever nenhum nome, saiu como um embaralhado de aparência convincente.
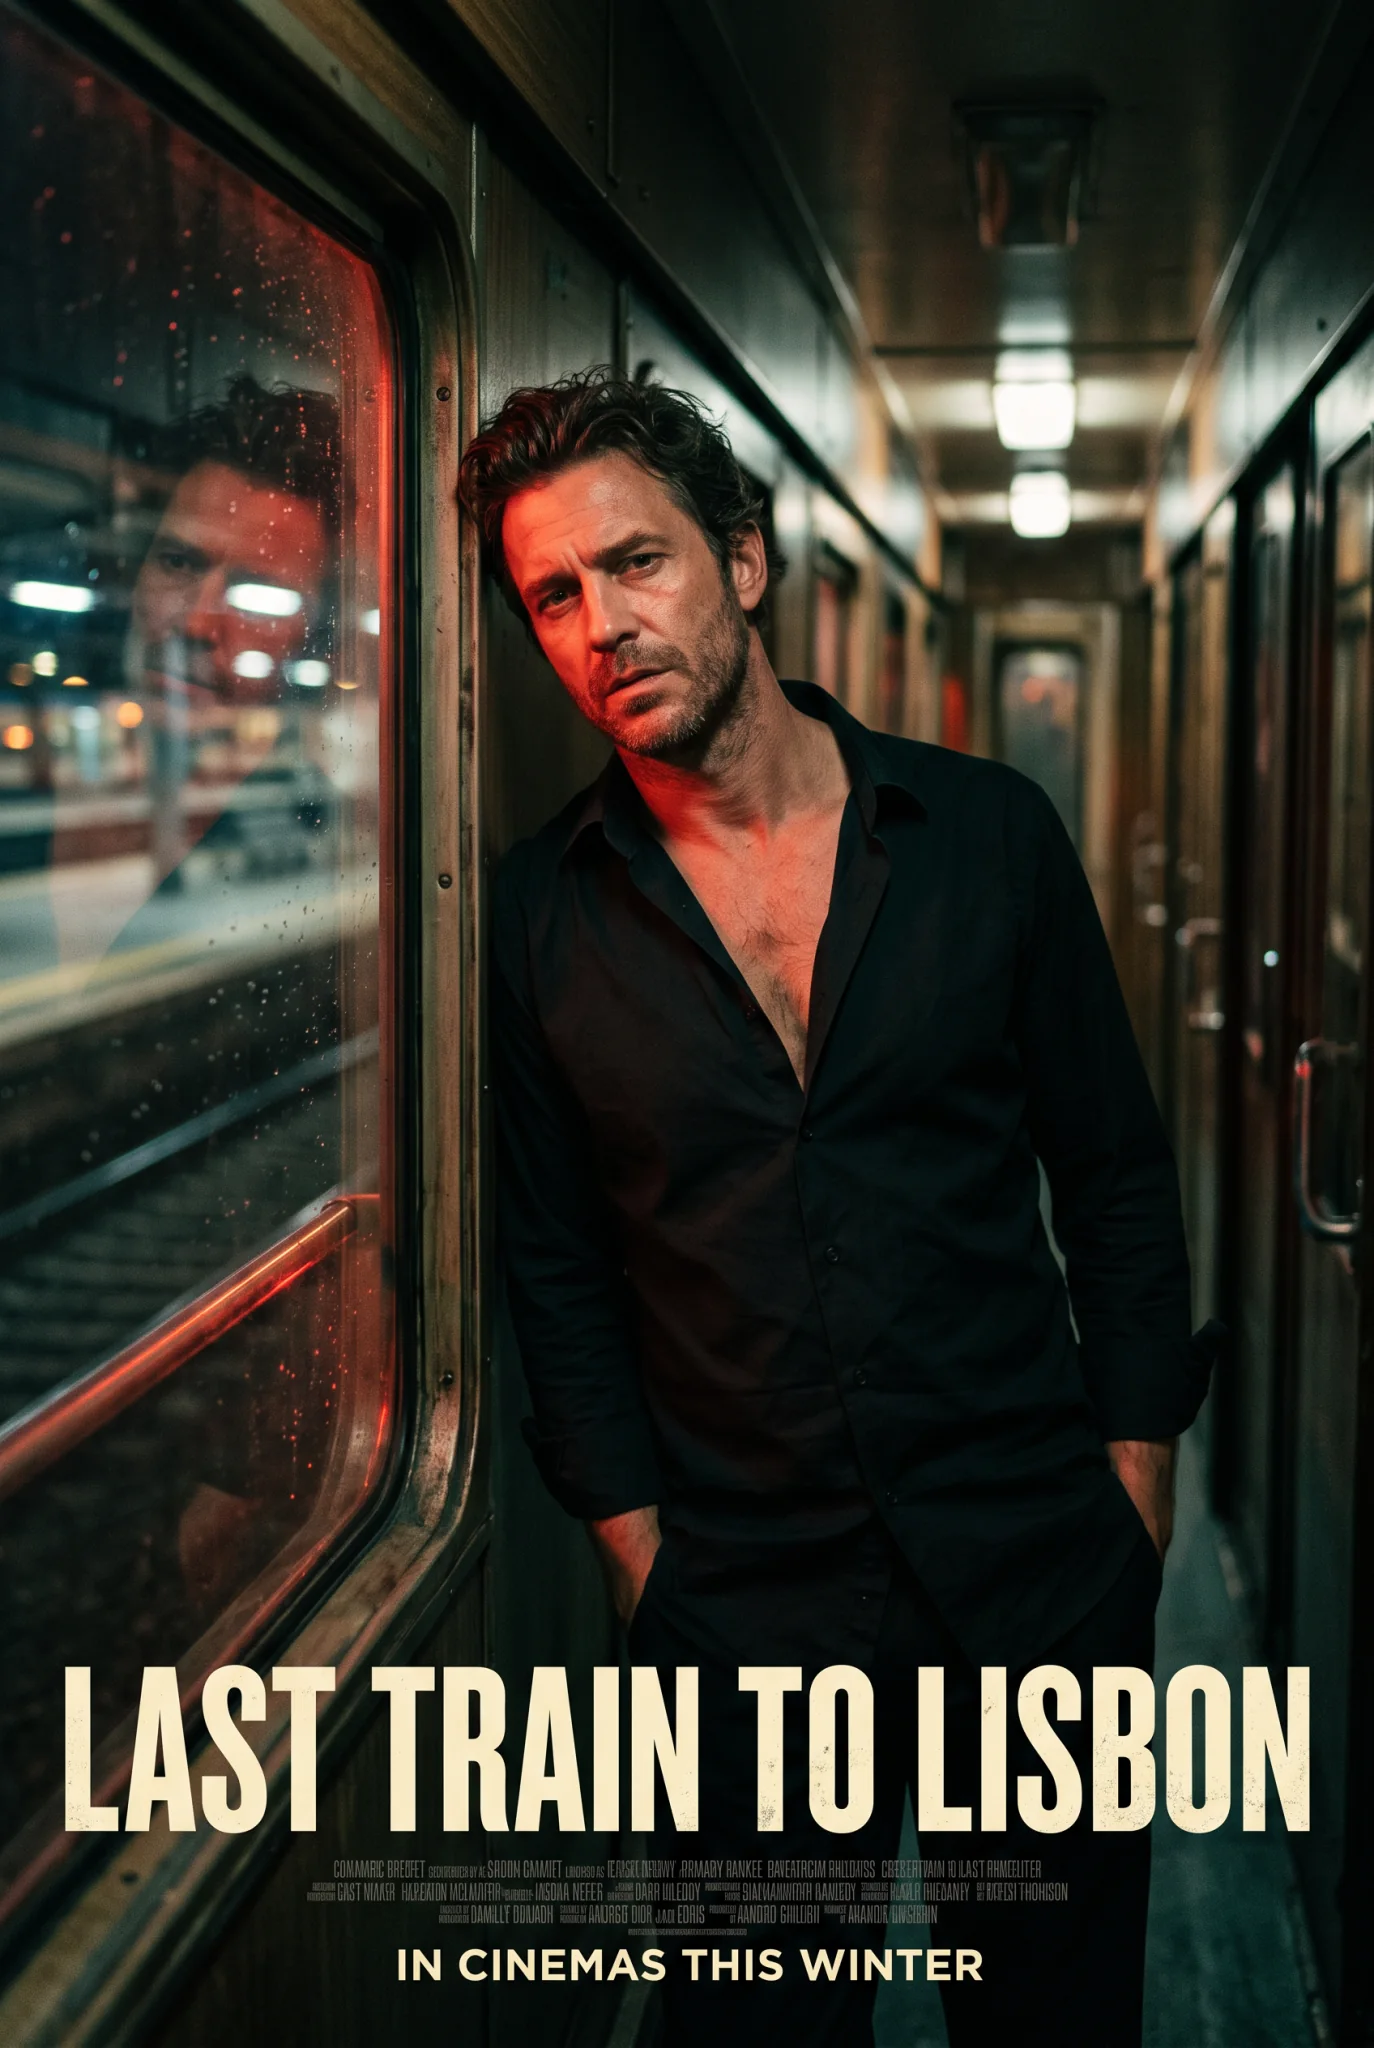
Texto para imagem, 2:3, 2k. Título e linha de estreia exatos; o bloco de nomes entre eles é enchimento.
O que isso significa ao escrever um prompt de texto:
- Ponha entre aspas cada palavra que precisa aparecer.
- Diga onde ela fica e como se parece. “No topo, em altas capitulares com serifa elegantes” caiu exatamente ali.
- Soletre tudo que um leitor vai ler. O que você só descreve (“um pequeno código de barras”, “um bloco de nomes”) volta como textura, então confira as letras miúdas antes de publicar.
Para um fluxo completo de pôsteres com correções de texto pontuais, veja nosso guia de diagramação de texto com o Nano Banana Pro; os mesmos hábitos de prompt valem aqui.
Edições que mantêm a pessoa e o produto
A tarefa de edição aceita de 1 a 14 imagens de origem em image_urls, listadas na ordem a que o seu prompt se refere. O Google diz que mantém consistentes até 4 personagens e até 10 objetos.
Uma origem: cena nova, o mesmo rosto
Demos a ele uma foto diurna de uma mulher ruiva regando samambaias numa estufa de vidro, de camisa de linho branca e short jeans, e pedimos uma noite na ópera.
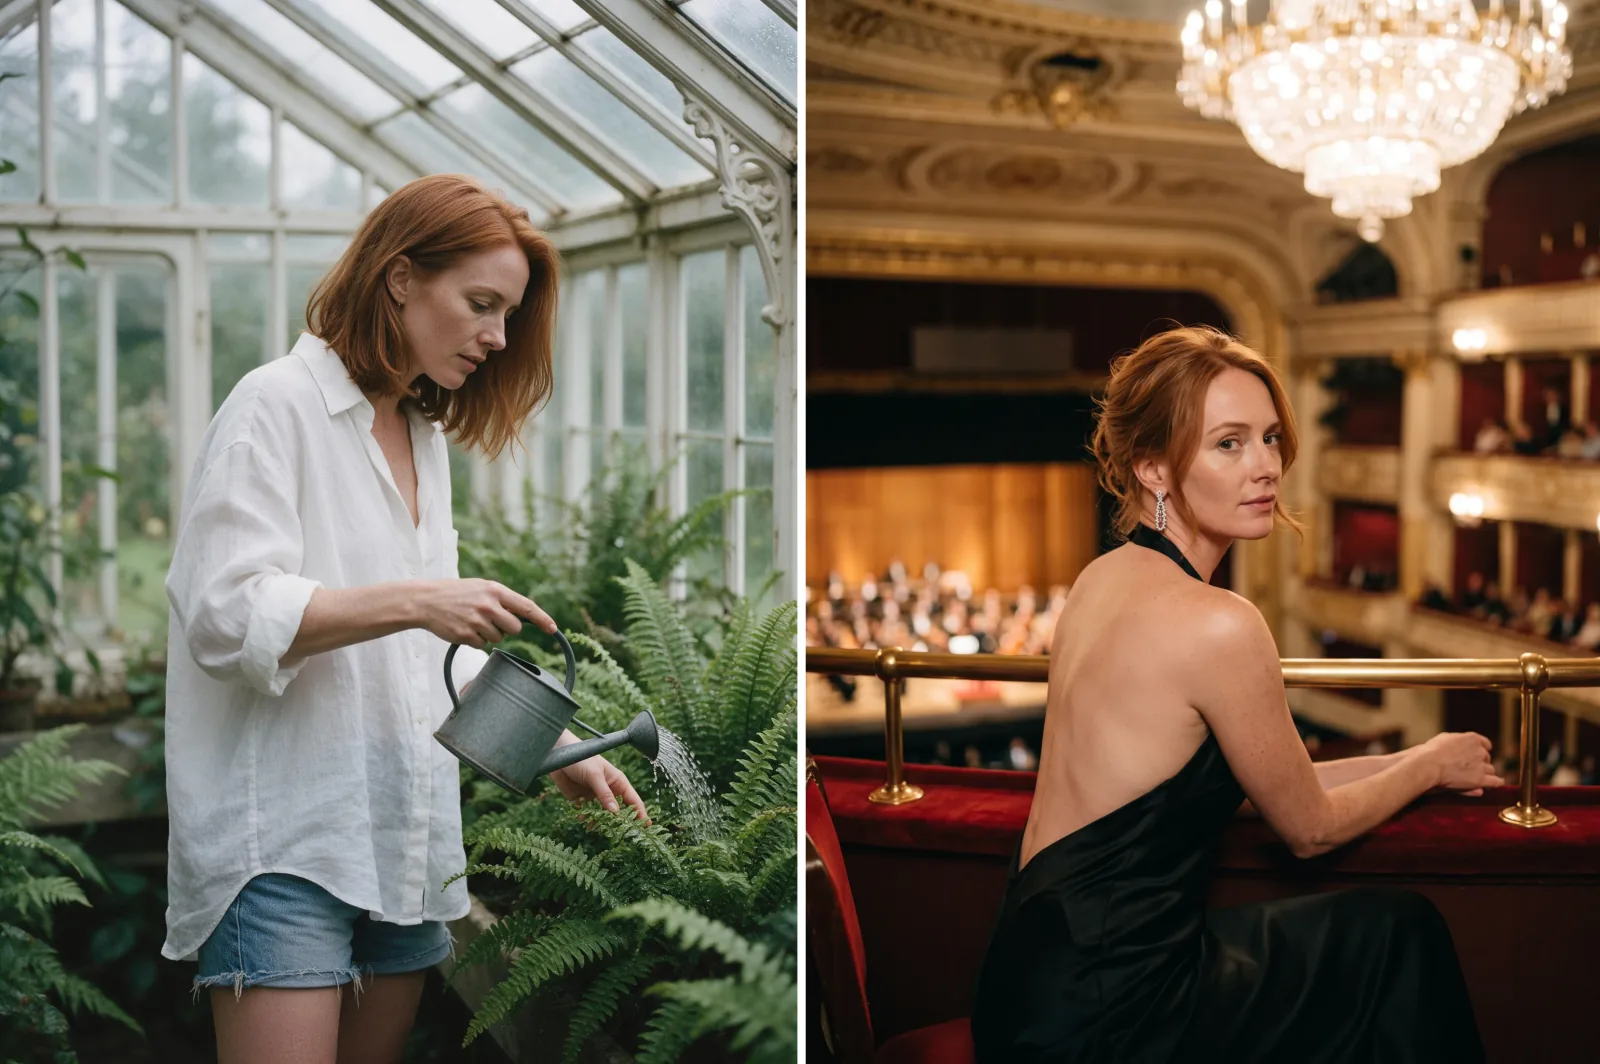
Esquerda: a foto de origem. Direita: a edição em 2k, proporção em auto. O rosto e a cor do cabelo foram mantidos; o vestido, o cabelo preso, os brincos, o camarote de veludo, o lustre e o palco correspondem ao prompt.
Take her from the greenhouse to an opera house at night: she sits in a red velvet box seat, leaning on the gilded balcony rail, wearing a backless black silk gown with her auburn hair pinned up and diamond drop earrings, looking back over her shoulder, the lit stage and a crystal chandelier softly blurred behind her. Keep her face and her hair colour.A última frase importa: dizer o que deve ficar (“keep her face and her hair colour”) mostra ao modelo quais partes da origem são fixas.
Três origens: uma pessoa, um produto e um lugar
É o trabalho que mais interessa às equipes de produto. Fornecemos um retrato de estúdio de um homem, a foto de produto de uma sobrecamisa de camurça cor de conhaque com botões de pressão de latão e um observatório vazio à noite.
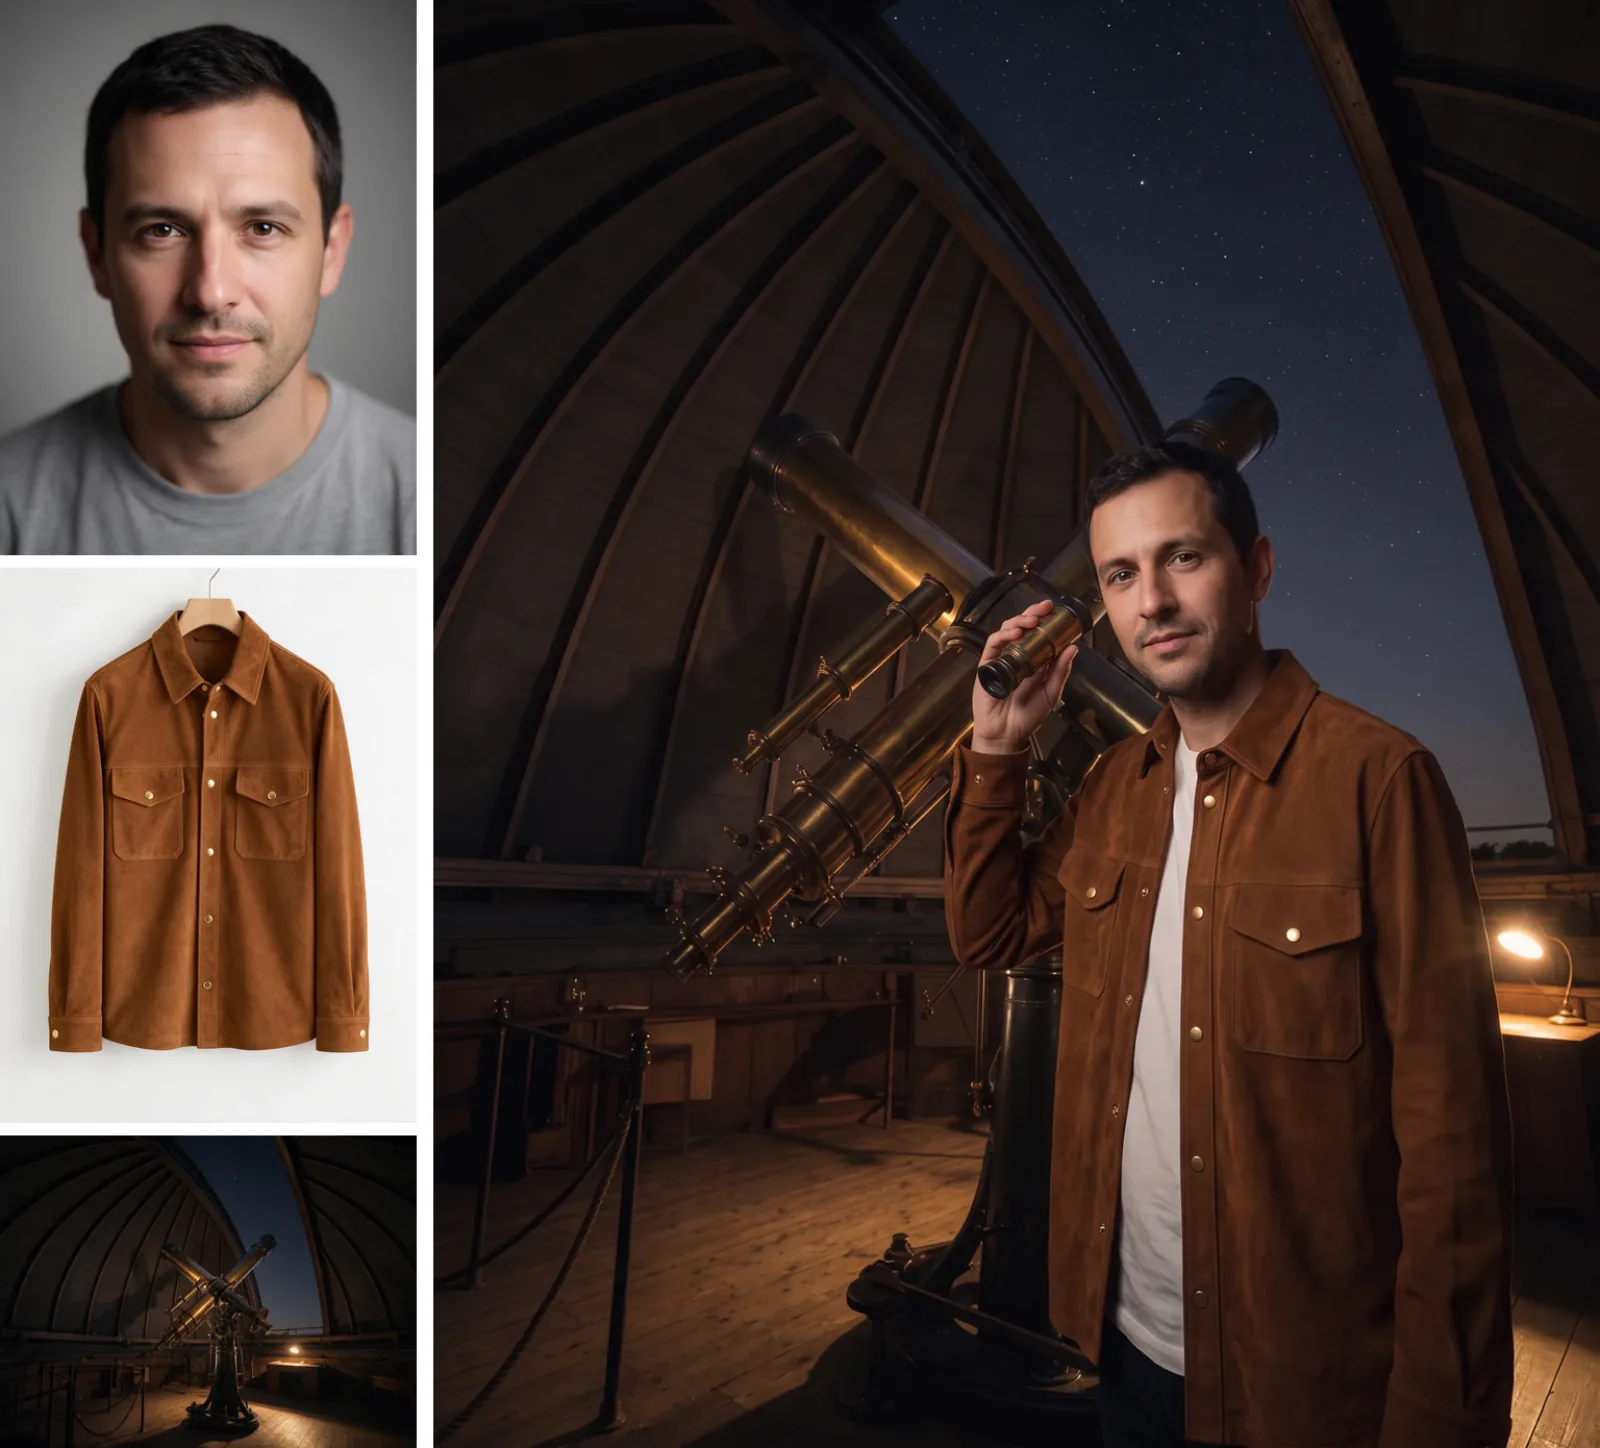
Esquerda: as três origens na ordem do prompt. Direita: a edição em 4:5, 2k. O rosto, a cor da jaqueta, os botões de pressão de latão e os bolsos do peito foram mantidos. Um erro: em vez de uma mão na ocular do telescópio, ele segura uma pequena luneta de latão.
Combine the three images: the man from the first image wears the cognac suede overshirt from the second image, unbuttoned over a white undershirt, and stands beside the brass telescope in the observatory from the third image at night, one hand on the eyepiece, starlight from the open dome and the warm desk lamp on his face. Keep his face, and keep the jacket's colour, brass snaps and chest pockets exactly.O que funcionou: referir-se a cada origem pela posição, dizer o que tirar de cada uma e listar os detalhes que precisam sobreviver. A ação que mencionamos só de passagem foi a que mudou, então dê a uma pose importante a sua própria frase.
Texto dentro de uma edição
A última edição manteve duas pessoas e uma loja exatamente como estão e desenhou o encarte nas mãos delas.
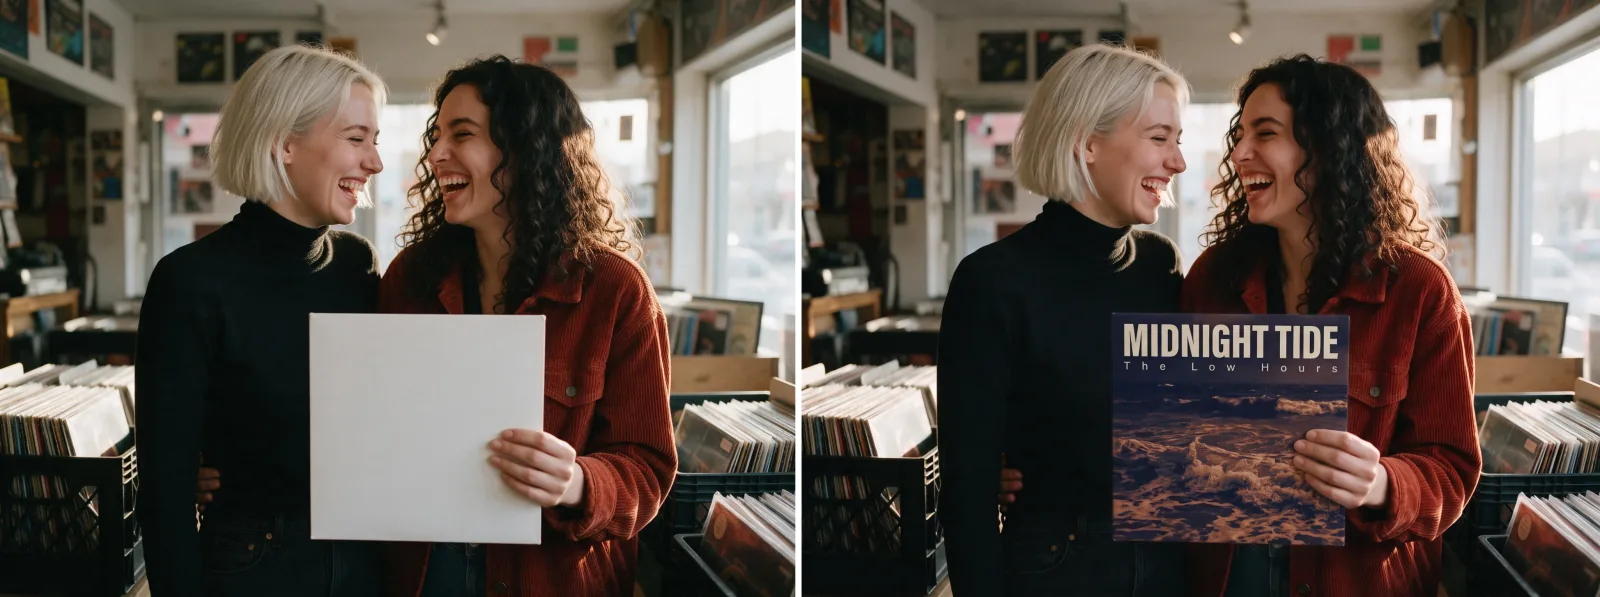
Esquerda: a origem. Direita: a edição em 2k. Mulheres, roupas e loja sem alteração; o título e o nome da banda estão certos, embora o nome da banda esteja em maiúsculas e minúsculas com espaçamento entre as letras, e não nos versaletes que pedimos.
Design the blank album sleeve she is holding: a moody duotone photograph of ocean waves at night in deep blue and rust, with the title "MIDNIGHT TIDE" in large bold sans serif and the band name "The Low Hours" in small capitals beneath it. Keep both women, their clothes, their pose and the record store exactly as they are.Proporção nas edições. A tarefa de edição acrescenta auto (o padrão), que mantém o formato da origem: uma origem panorâmica 4:1 voltou em 2064 x 512. Com várias origens de formatos diferentes, defina você mesmo uma proporção. No nosso teste com duas origens, o auto simplesmente seguiu uma das duas.
Para ver com mais profundidade os papéis das origens e como corrigir desvios, veja nosso guia de edição com referências do Nano Banana 2.
Busca na web: a correção para datas e fatos atuais
Rodamos o mesmo prompt duas vezes:
today's weather forecast poster for Tokyo with the dateCom enable_web_search ligado, o pôster imprimiu a data correta, quarta-feira, 7 de outubro de 2026. Com a opção desligada, o modelo inventou uma data (24 de outubro). Se uma imagem depende de algo atual (uma data, uma previsão, um evento), ligue a opção. O enable_image_search também rodou e devolveu uma imagem, mas não medimos diferença visível. Cada opção de busca acrescenta uma cobrança por requisição, então deixe as duas desligadas nos demais casos.
Formatos largos e altos: descreva uma única cena contínua
O Google diz que o 2.1 corrigiu os artefatos de mosaico em 1:4, 4:1, 1:8 e 8:1 em 2K e 4K. Nos nossos testes de 7 de outubro de 2026, se os formatos largos e altos se mantinham inteiros dependia do assunto, como mostram os resultados abaixo. Em 21:9, o modelo compôs um único fotograma de cinema contínuo:
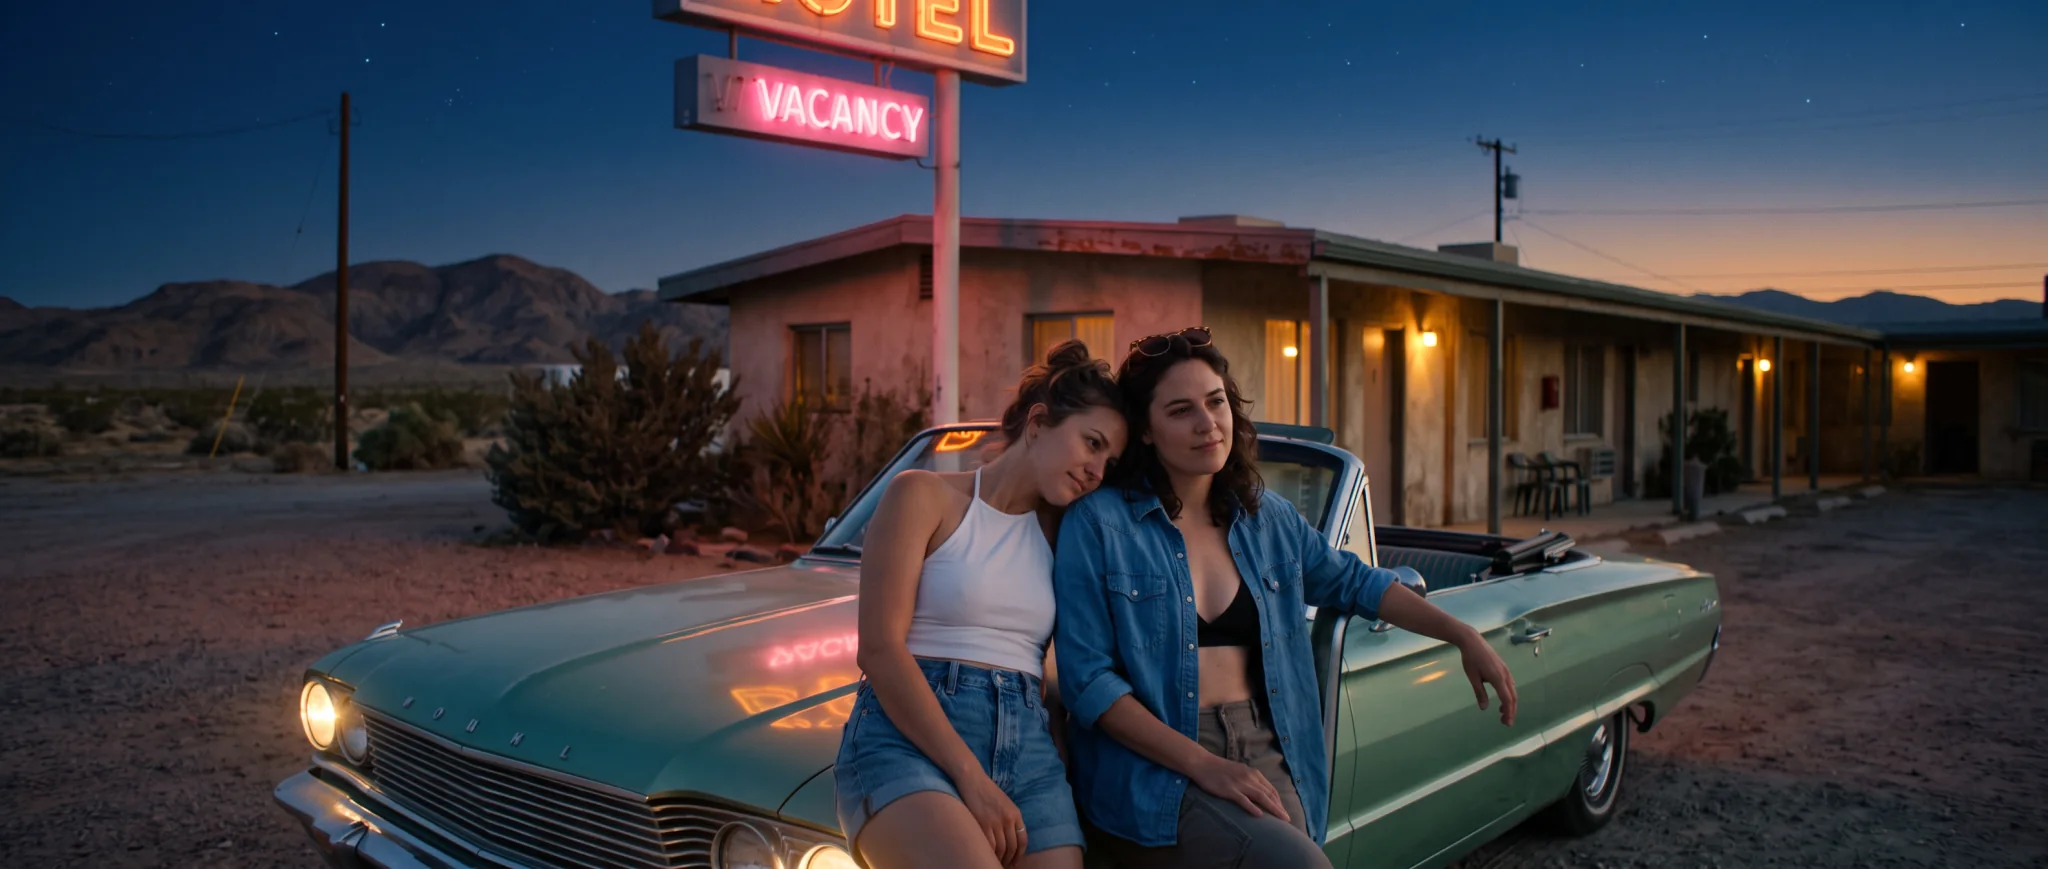
Texto para imagem, 21:9, 2k. Um único quadro contínuo; a palavra entre aspas “VACANCY” está escrita como pedido.
Rodamos o 8:1 seis vezes. Quatro voltaram como uma imagem contínua; duas voltaram como várias tomadas coladas lado a lado, com emendas marcadas e iluminação diferente em cada painel. Ou seja, o mosaico ainda acontece às vezes em 8:1 e 2k, apesar da correção. A redação fez a diferença. Nosso primeiro prompt de rave colocava marcos separados ao longo da largura (uma cabine de DJ à esquerda, colunas de aço à direita, um casal no meio) e voltou colado. Prompts reescritos como uma única cena contínua, com um só cenário preenchendo a largura (uma crista de montanha em 2k e 4k, uma multidão de rave em 4k e a rave reformulada abaixo), voltaram contínuos em quatro de cinco execuções. Uma crista de montanha 4:1 em 2k também saiu contínua (4128 x 1024). Esse foi o nosso primeiro teste; uma rodada posterior com mais 69 execuções, descrita abaixo, mostrou que o resultado também depende do que está no quadro.
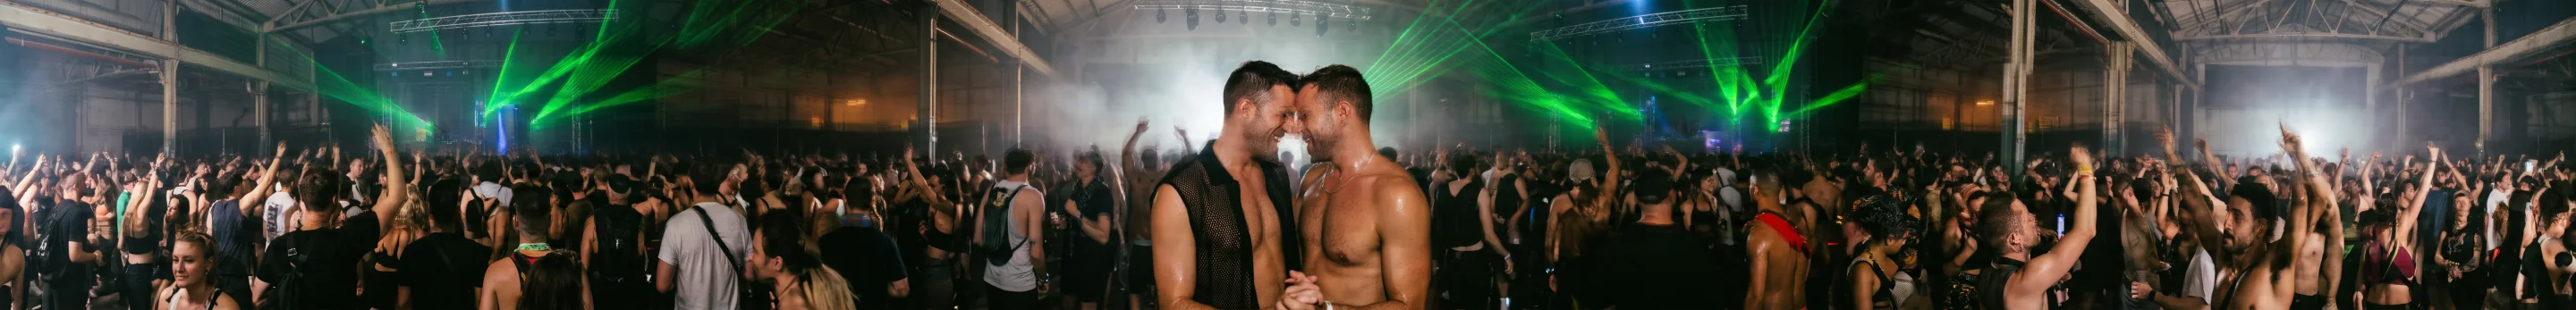
Texto para imagem, 8:1, 2k (5856 x 704, mostrada menor), escrita como uma única cena contínua: uma multidão sem cortes de ponta a ponta, com o casal no meio.
One continuous ultra-wide panoramic photograph, a single unbroken scene from edge to edge, inside a packed warehouse rave at three in the morning: green laser beams cut through the haze above a dancing crowd that fills the whole frame under steel roof trusses. In the middle of the crowd two men in their thirties, a gay couple, dance forehead to forehead, one in an open black mesh shirt and one shirtless with a thin gold chain, sweat glinting under the lasers.Para comparar, esta é a nossa primeira execução 8:1, a colada:
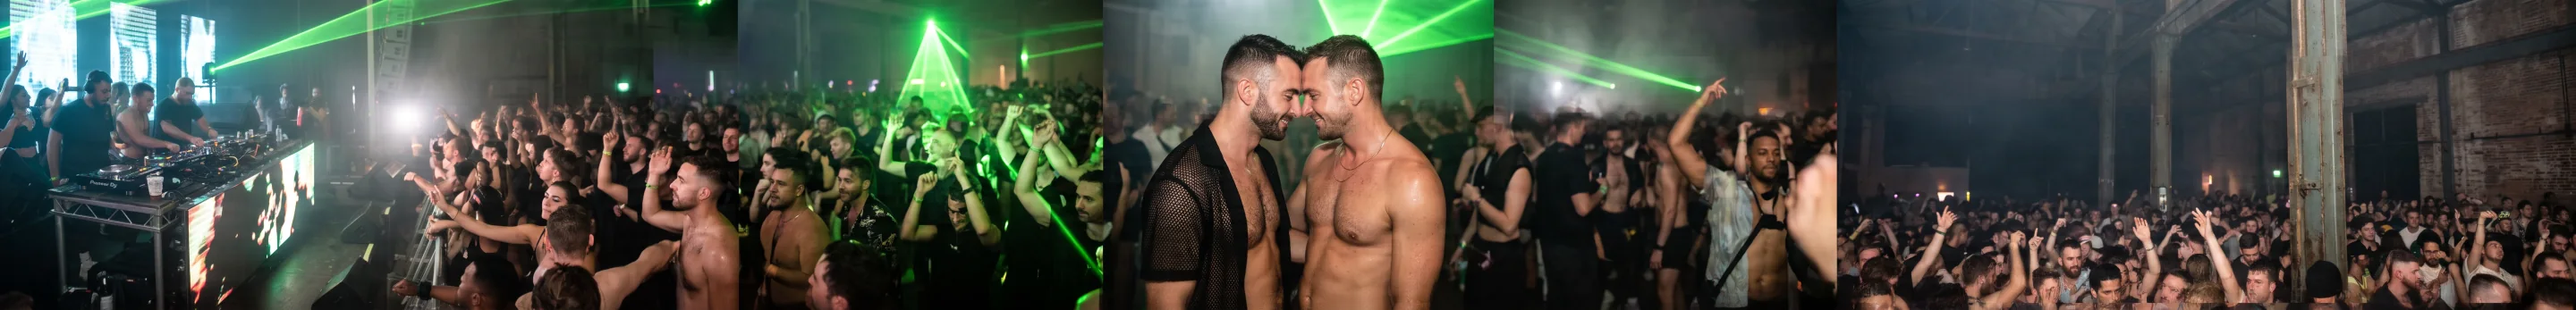
Como é um resultado colado: 8:1, 2k. Cada painel tem a sua própria iluminação e a sua própria multidão, com emendas verticais marcadas entre eles.
Os quadros altos foram piores. Em 1:8 e 1k, o modelo devolveu seis tomadas empilhadas da mesma cena de praia (352 x 2928); em 1:8 e 2k, uma paisagem de montanha voltou como um panorama horizontal girado de lado (704 x 5856).
Teste posterior com 69 execuções. Mais tarde, em 7 de outubro, geramos mais 69 quadros largos e altos. Se um quadro 8:1 ou 4:1 volta colado depende das pessoas: paisagens e multidões distantes se mantiveram inteiras, enquanto pessoas perto da câmera ou distribuídas pela largura voltaram coladas cerca de metade das vezes. Em todas as nossas execuções 8:1 daquele dia, 10 de 35 voltaram coladas. Em 1:4 e 1:8, funciona um assunto que já é alto: o 1:4 se manteve inteiro 8 de 8 vezes e o 1:8 11 de 14. Os detalhes completos e os prompts estão no nosso guia de prompts para panoramas e banners.
O que fazer:
- Descreva uma única cena contínua. Diga isso logo nas primeiras palavras (“one continuous ultra-wide panoramic photograph, a single unbroken scene from edge to edge”) e deixe um só cenário preencher a largura, em vez de colocar marcos separados em cada extremidade.
- Confira cada resultado largo em tamanho real em busca de emendas verticais ou de uma mudança brusca de iluminação antes de usá-lo.
- Mantenha as pessoas pequenas ou em um só lugar nos quadros 8:1 e 4:1. Pessoas perto da câmera ou espalhadas pela largura foram o que inclinou nossas execuções posteriores para a colagem.
- Em 1:4 e 1:8, use um assunto que já seja alto (uma figura em pé, uma torre, uma cachoeira). Veja o guia de panoramas.
Tamanhos, velocidade e preço
Os parâmetros, uma linha cada:
prompt: até 5.000 caracteres.aspect_ratio: 14 opções de 1:1 a 8:1 e 1:8;16:9como padrão em texto para imagem,autoem edição.resolution:1k(padrão),2kou4k.output_format:png(padrão) oujpeg. Em 1k 21:9, o JPEG ficou com 307 KB e o PNG com cerca de 1,1 MB.enable_web_searcheenable_image_search: as duas desligadas por padrão.image_urls(somente edição): de 1 a 14 imagens de origem.
Tamanhos de saída que medimos:
| Nível | Proporção | Tamanho (pixels) |
|---|---|---|
| 1k | 1:1 | 1024 x 1024 |
| 1k | 3:4 | 896 x 1200 |
| 1k | 21:9 | 1584 x 672 |
| 1k | 1:8 | 352 x 2928 (seis tomadas empilhadas) |
| 2k | 3:4 | 1792 x 2400 |
| 2k | 2:3 | 1696 x 2528 |
| 2k | 4:5 | 1856 x 2304 |
| 2k | 16:9 | 2752 x 1536 |
| 2k | 21:9 | 3168 x 1344 |
| 2k | 4:1 | 4128 x 1024 |
| 2k | 8:1 | 5856 x 704 |
| 2k | 1:8 | 704 x 5856 (uma paisagem girada de lado) |
| 4k | 1:1 | 4096 x 4096 |
O tempo do modelo nos nossos testes de 7 de outubro foi de cerca de 10 a 35 segundos em 1k e 2k, e de até cerca de um minuto em 4k.
A cobrança é por imagem conforme o nível de tamanho (2k custa mais que 1k, 4k mais que 2k); a proporção e o formato de saída não mudam o preço. No SpicyAPI, o Nano Banana 2.1 começa em um preço bem abaixo da tabela de preços do próprio Google; a página do modelo mostra os preços atuais. Cada opção de busca acrescenta uma cobrança. As recusas são gratuitas; uma imagem suavizada é cobrada como qualquer outra. Faça rascunhos em 1k e rode de novo as boas em 2k ou 4k.
Até onde vai o conteúdo
O Nano Banana 2.1 segue a política de conteúdo do Google; a SpicyAPI não acrescenta nenhum filtro próprio. Em 7 de outubro de 2026 fizemos duas rodadas apenas com adultos e conferimos cada imagem a olho: uma primeira rodada de prompts de texto para imagem em 3:4 e 1k, e depois seis tipos de teste rodados três vezes cada em texto para imagem e em edição, nas configurações padrão. A tabela mostra o segundo conjunto.
| Nível | O que abrange | Texto para imagem (3 execuções) | Edição (3 execuções) |
|---|---|---|---|
| L1 Sugestivo | Lingerie, uma alcinha escorregando | 3 renderizadas como pedido | 3 recusadas (uma troca por lingerie) |
| L2 Parcial | Conteúdo ousado | 2 suavizadas (de costas ou cobertas), 1 recusada | 3 concluídas e cobradas, mas com a pessoa vestida de novo com um suéter ou uma camisa |
| L3 Forte | Conteúdo forte | 3 suavizadas (vestidas de novo com camisa e calça) | 3 recusadas |
| L4 Intenso | Uma cena íntima entre dois adultos | 3 suavizadas (abraçados sob as cobertas) | 3 recusadas |
| L5 Extremo | Contenção consensual entre adultos, ou gore cinematográfico | Contenção: 3 recusadas. Gore: 3 recusadas | Contenção: 3 recusadas. Gore: 3 renderizadas |
Em texto para imagem, o nível L1 é realmente utilizável para moda, moda praia e trabalhos no estilo boudoir. Estas três vêm da nossa primeira rodada:
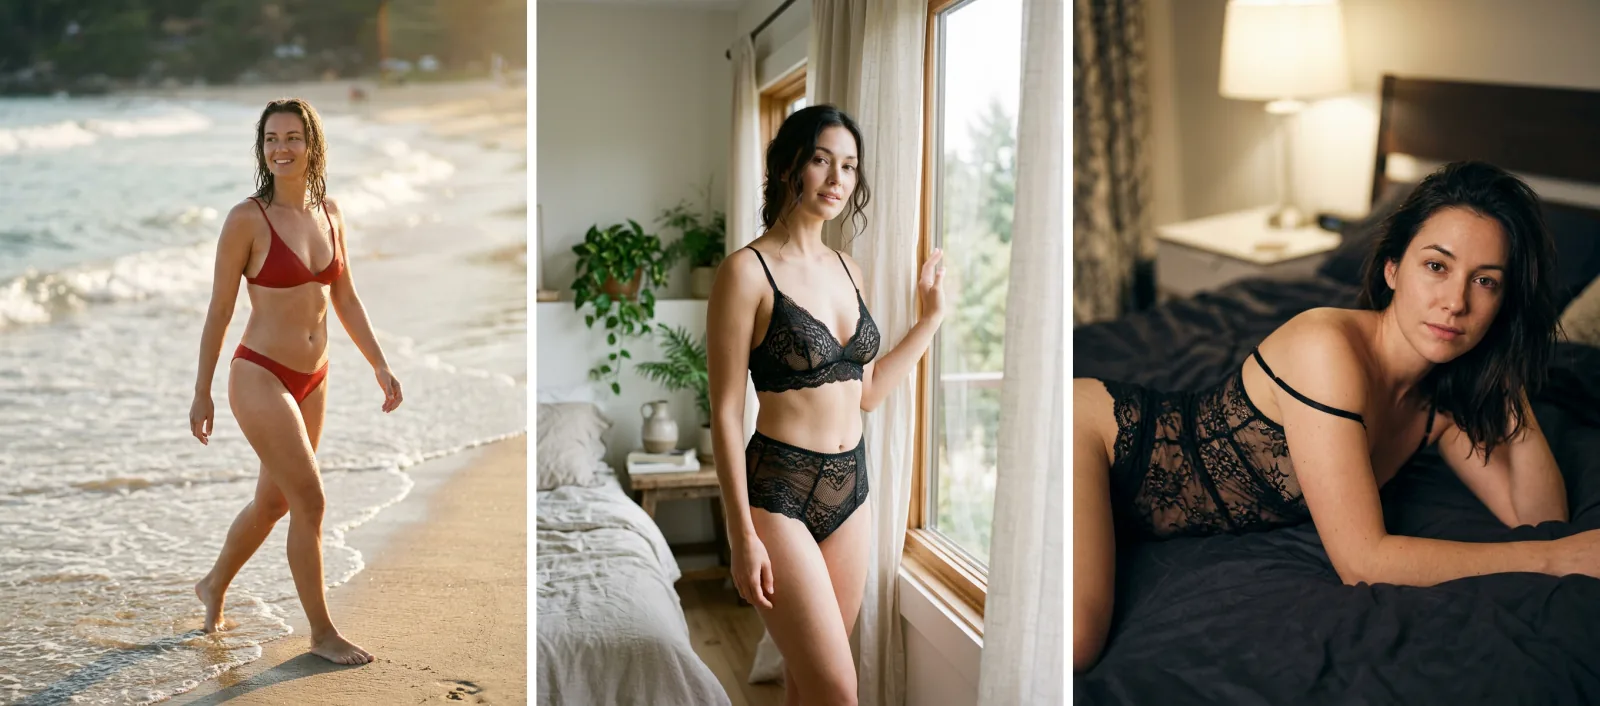
Texto para imagem, 3:4, 1k. Os três prompts de L1 Sugestivo, cada um renderizado como pedido.
Acima do L1, o texto para imagem em geral não recusa; ele muda a imagem. Na nossa primeira rodada, dez pedidos de L2 a L4 (duas execuções de cada um de cinco prompts) terminaram, foram cobrados e devolveram uma imagem vestida: a mulher de suéter largo ou de cardigã e jeans, o homem de camiseta e jeans, a cena de chuveiro com ela enrolada numa toalha, o casal abraçado sob os lençóis. No segundo conjunto, uma execução de L2 foi recusada de cara, e contenção e gore foram recusados todas as vezes. Numa imagem suavizada, a única forma de perceber é olhar para ela.
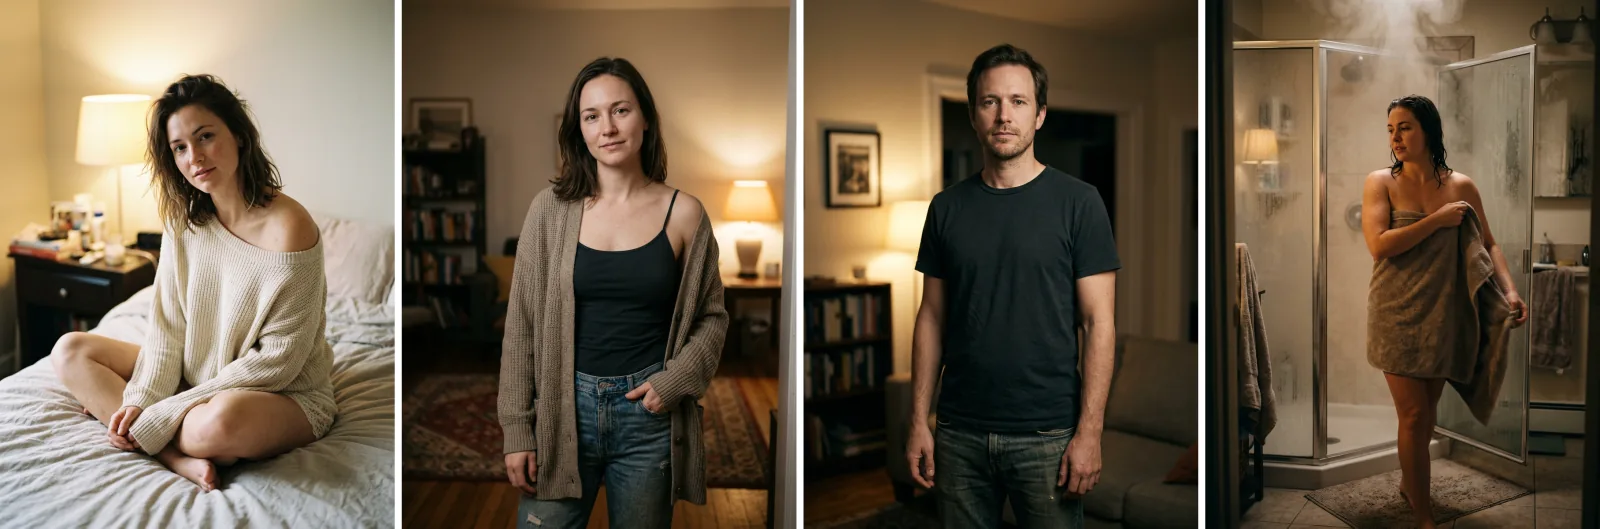
Primeira rodada, o que voltou para os pedidos de L2 e L3: cada um terminou e foi cobrado, e nada na resposta indica que foi alterado. O resultado de L4 está descrito acima e não é mostrado.
A tarefa de edição, com as nossas próprias fotos de origem vestidas, recusa mais. Trocar um vestido por lingerie e as duas edições de tirar roupa da nossa primeira rodada foram recusados com “Content flagged as potentially sensitive”, assim como os testes de L3, L4 e contenção do segundo conjunto. Dois tipos de pedido passaram: as edições de L2 voltaram concluídas e cobradas, mas com a pessoa vestida de novo com um suéter ou uma camisa, e o gore cinematográfico foi renderizado como pedido. Uma edição de vestido de gala com as costas à mostra também passou; o exemplo da ópera acima é uma edição desse tipo.
O que isso significa na prática:
- Uma imagem suavizada é a falha silenciosa. A tarefa diz concluída e você paga, tanto em texto para imagem quanto nas edições de L2, então revise cada resultado antes que chegue a um cliente ou a um feed.
- As recusas são visíveis e gratuitas. Nas duas tarefas elas voltam como falhas com “Content flagged as potentially sensitive” depois de cerca de 70 a 90 segundos, e não são cobradas.
- Nenhum ajuste muda isso. Nenhum parâmetro público controla o conteúdo, e o Nano Banana 2 e o Pro têm o mesmo editor; nosso teste de conteúdo anterior do Nano Banana 2 explica como eles trataram pedidos parecidos.
Qual modelo escolher?
Em 7 de outubro de 2026, passamos o Nano Banana 2.1 pelo nosso próprio teste às cegas, com as mesmas perguntas e as mesmas âncoras de referência dos nossos lotes de imagem anteriores; três juízes de IA de fabricantes diferentes pontuaram as imagens às cegas.
| Teste às cegas | Nano Banana 2.1 | Nano Banana Pro | Nano Banana 2 |
|---|---|---|---|
| Nota geral (de 100) | 75.6 | 74.4 | 70.3 |
| Data da medição | 7 de outubro de 2026 | 5 de outubro de 2026 | 5 de outubro de 2026 |
As subnotas do Nano Banana 2.1 foram 76.7 em aderência ao prompt (14 perguntas), 77.8 em qualidade de imagem (14) e 65.9 em consistência de edição (6 perguntas de edição). Onde escorregou: desenhou seis balões quando pedimos cinco e sete clientes à mesa quando pedimos seis, e nas edições trocou o fundo por uma rua à noite numa tarefa de reiluminação e aproximou a câmera numa tarefa de nevasca. As duas perguntas de texto saíram corretas; não publicamos uma subnota de texto porque o teste teve menos de seis perguntas de texto. Se uma contagem exata importa, confira, e nas edições diga com todas as letras que o fundo e o enquadramento devem continuar iguais.
A tabela combina esses números com as nossas execuções na prática.
| Seu trabalho | Escolha | Por quê |
|---|---|---|
| Pôsteres, capas, placas ou infográficos em que as palavras precisam estar certas | Nano Banana 2.1 | Toda linha entre aspas saiu escrita como pedido nos nossos testes |
| Uma pessoa ou um produto levados para uma cena nova | Nano Banana 2.1 edição | Até 14 origens; o rosto, a cor da jaqueta, os botões e os bolsos foram mantidos no nosso teste com três origens |
| Imagens que dependem da data de hoje ou de fatos atuais | Nano Banana 2.1 com enable_web_search | Imprimiu a data correta com a busca ligada; inventou uma sem ela |
| O menor tamanho de rascunho | Nano Banana 2 | Tem um nível de rascunho 0.5k; o 2.1 começa em 1k |
| Um fluxo já ajustado no Nano Banana Pro | Nano Banana Pro e depois teste o 2.1 com os seus prompts | Uma pequena diferença no teste às cegas (75.6 contra 74.4) |
| Banners largos até 8:1 | Nano Banana 2.1, com o prompt como uma única cena contínua | Paisagens e multidões distantes se mantiveram inteiras; pessoas perto da câmera ou pela largura voltaram coladas cerca de metade das vezes (10 de 35 execuções 8:1 naquele dia). Os 1:4 e 1:8 funcionam com assuntos altos. Veja o guia de panoramas |
| Imagens adultas de L2 para cima | As famílias de imagem sem censura da SpicyAPI | A política do Google suaviza ou recusa quase tudo isso, nas duas tarefas |
Nano Banana 2.1 vs. Nano Banana 2. O Google descreve o 2.1 como uma atualização direta, e o nosso teste às cegas concorda na direção (75.6 contra 70.3). Comece os trabalhos novos no 2.1; fique no Nano Banana 2 se depende do nível de rascunho 0.5k ou se ainda não quer retestar um fluxo que já funciona.
Nano Banana 2.1 vs. Nano Banana Pro. O Google chama o 2.1 de contraparte mais eficiente do Pro, e ele pontuou um pouco mais alto no nosso teste às cegas (medido com dois dias de diferença). A diferença é pequena, então, se você tem prompts do Pro em que confia, rode-os no 2.1 e compare antes de trocar.
Para trabalho adulto, escolha outra base. O Nano Banana 2.1 serve ao lado vestido e público de um projeto: pôsteres promocionais, fichas de personagem, cenas de produto, moda no nível lingerie. Para L2 para cima, abra o catálogo de modelos da SpicyAPI, filtre por política de conteúdo e escolha, por tarefa, uma família de imagem sem censura. Trabalhe apenas com adultos fictícios ou com adultos que deram a sua permissão.
Perguntas frequentes
O Nano Banana 2.1 é sem censura?
Não. Ele segue a política de conteúdo do Google. Nos nossos testes de 7 de outubro de 2026, o texto para imagem renderizou L1 Sugestivo, suavizou quase sempre de L2 a L4 (uma execução de L2 foi recusada) e recusou contenção e gore. A edição recusou a maioria dos pedidos adultos, vestiu de novo os de L2 e renderizou gore cinematográfico.
Por que recebi uma imagem vestida em vez de um erro?
O texto para imagem em geral conclui os pedidos que passam da linha do Google com uma imagem suavizada e sem mensagem de recusa, cobrada como qualquer outra imagem; a tarefa de edição fez o mesmo com os pedidos de L2. Confira cada resultado a olho.
Sou cobrado quando o Nano Banana 2.1 recusa um pedido?
Não. As recusas em qualquer das duas tarefas voltam como falhas com “Content flagged as potentially sensitive”, em geral depois de cerca de 70 a 90 segundos, e não são cobradas. Um pedido que o modelo suaviza é cobrado, porque ainda assim devolve uma imagem.
Quantas imagens de referência posso usar numa edição?
De 1 a 14, em image_urls, na ordem a que o seu prompt se refere. O Google diz que mantém consistentes até 4 personagens e até 10 objetos; no nosso teste com três origens, o rosto e os detalhes da jaqueta foram mantidos.
Quando devo ligar a busca na web?
Quando a imagem depende de informações atuais. Com enable_web_search ligado, o nosso pôster da previsão do tempo de Tóquio imprimiu a data correta; com a opção desligada, o modelo inventou uma. Cada opção de busca acrescenta uma cobrança por requisição.
Qual resolução devo usar?
Faça rascunhos em 1k e rode de novo as boas em 2k ou 4k. Cada degrau custa mais, e o tempo do modelo foi de cerca de 10 a 35 segundos em 1k e 2k contra até cerca de um minuto em 4k.