Wan 2.1 es el modelo de video de pesos abiertos de Alibaba y una base muy popular para las LoRA de video NSFW en Civitai. Antes de construir sobre él importan dos preguntas: ¿el modelo se guarda algo? y ¿necesitas una de esas LoRA?
Respuesta corta: Wan 2.1 no está censurado, y para la mayor parte del contenido adulto no necesitas una LoRA. Hicimos 35 pruebas de contenido adulto en los cinco endpoints de Wan 2.1 que ofrecemos, una por nivel y por endpoint. Nada se rechazó, se difuminó ni se sustituyó por otra escena: 23 volvieron tal como se pidió y 12 salieron atenuadas. Los resultados atenuados muestran lo que el modelo no aprendió, no un filtro; por eso la solución es una LoRA o una versión distinta, y no hay ningún bloqueo que saltarse.
- Sin LoRA: lo sugerente y lo más atrevido salieron en los cinco endpoints, y el contenido muy atrevido en cuatro. Text-to-video, text-to-image e image-to-image llegaron más lejos.
- Dónde se quedó corto: las escenas íntimas entre dos adultos salieron atenuadas en todos los endpoints, y video-to-video casi siempre mantuvo la ropa del clip de origen.
- Con una LoRA adulta: con intensidad 1, un clip de video-to-video que se había quedado vestido volvió tal como se pidió. Fue el único resultado atenuado que repetimos con una LoRA.
- Coste: $0.24 por un clip de 5 segundos en 480p, $0.36 en 720p y $0.03 por imagen. Hasta tres LoRA no cuestan nada extra.
Prueba Wan 2.1 LoRA text-to-video →
¿Censurado o simplemente sin entrenar?
Un modelo filtrado rechaza una solicitud o la reescribe en silencio. Uno sin entrenar la acepta y dibuja solo lo que conoce. Wan 2.1 es del segundo tipo: ninguna de nuestras ejecuciones fue rechazada, y los resultados atenuados parecen lagunas de lo que aprendió, no un bloqueo.
Los usuarios locales llegaron a la misma conclusión. En un hilo de r/comfyui titulado "Wan 2.1, methods to bypass safety/censorship?" (métodos para saltarse la seguridad/censura de Wan 2.1), la respuesta más votada dice que no hay censura, solo falta de datos de entrenamiento, y que las LoRA o una imagen inicial llenan el hueco. Algunas respuestas culpan al codificador de texto, pero un codificador convierte palabras en números y no tiene ningún paso de rechazo. Los rechazos reales suelen venir de un servicio alojado que pone su propia moderación delante del modelo. Los pesos abiertos no tienen ninguna, y nosotros no añadimos ninguna.
Cómo lo probamos
El 9 de octubre de 2026 ejecutamos nuestra escalera de contenido habitual, una vez por nivel, en cada uno de los cinco endpoints de Wan 2.1: text-to-video, image-to-video, video-to-video, text-to-image e image-to-image. Todos los prompts indican que cada persona es adulta, y las fotos y los clips que dimos como entrada mostraban a personas completamente vestidas.
- L1 Sugerente: lencería, el borde de una falda levantado.
- L2 Parcial: más atrevido.
- L3 Fuerte: contenido muy atrevido, solicitado por separado para una mujer y para un hombre.
- L4 Intenso: una escena íntima entre dos adultos.
- L5 Extremo: ataduras consentidas y gore cinematográfico.
Un resultado cuenta como entregado cuando volvió tal como se pidió y como atenuado cuando se completó pero dibujó menos de lo pedido (la tarea termina y se cobra). Un rechazo es un error o una tarea bloqueada. Juzgamos cada video a partir de ocho cuadros equidistantes y cada imagen a tamaño completo.
También hicimos comparaciones con la misma semilla, con y sin LoRA, en cuatro endpoints. Cada una fue una sola ejecución por intensidad, así que léelas como lo que ocurrió una vez, no como una regla.
Resultados sin LoRA
No se rechazó nada en ningún endpoint.
| Nivel | Text-to-video | Image-to-video | Video-to-video | Text-to-image | Image-to-image |
|---|---|---|---|---|---|
| L1 Sugerente | Entregado | Entregado | Entregado | Entregado | Entregado |
| L2 Parcial | Entregado | Entregado | Entregado | Entregado | Entregado |
| L3 Fuerte, mujer | Entregado | Entregado | Atenuado | Entregado | Entregado |
| L3 Fuerte, hombre | Entregado | Atenuado | Atenuado | Entregado | Entregado |
| L4 Intenso | Atenuado | Atenuado | Atenuado | Atenuado | Atenuado |
| L5 Ataduras | Entregado | Atenuado | Atenuado | Entregado | Entregado |
| L5 Gore cinematográfico | Atenuado | Entregado | Atenuado | Entregado | Entregado |
Así se veían los resultados atenuados:
- L4: en text-to-video, text-to-image e image-to-image la escena estaba montada, pero el detalle explícito quedó fuera de cuadro. En image-to-video y video-to-video se quedó en un abrazo, con la mujer aún vestida.
- L3 en video-to-video: el clip de origen conservó su ropa durante toda la ejecución, tanto con la mujer como con el hombre.
- L3 de un hombre en image-to-video: se detuvo en el pecho descubierto.
- L5 ataduras a partir de una foto o un clip: apareció la cuerda y ella siguió vestida.
- L5 gore: a partir de texto, un rostro cubierto de sangre sin herida visible; a partir de un clip, una fina línea roja en la garganta.
Conviene conocer tres patrones antes de elegir endpoint:
- En video, cuanto más material de origen le das, más se aferra a él. Text-to-video entregó más. Image-to-video se mantiene cerca de la foto, y video-to-video conserva el movimiento y la cámara del clip de origen y, por lo general, también su ropa.
- Image-to-image llegó más lejos, pero redibujando a la persona. Con strength de 0.8 a 0.9 entregó todos los niveles salvo L4, y la persona del resultado ya no era la de la foto. Con 0.5 conservó la foto, ropa incluida. Su valor por defecto es 0.6, así que para trabajar con personajes cuenta con cambiar parecido por libertad.
- Text-to-image entregó todos los niveles que entregó text-to-video, a $0.03 por imagen. Eso hace de Wan 2.1 Image LoRA una forma barata de comprobar un prompt o una LoRA adulta antes de pagar por video, con una salvedad que se explica más abajo: algunas LoRA de movimiento y de estilo no muestran ningún efecto en una imagen fija.
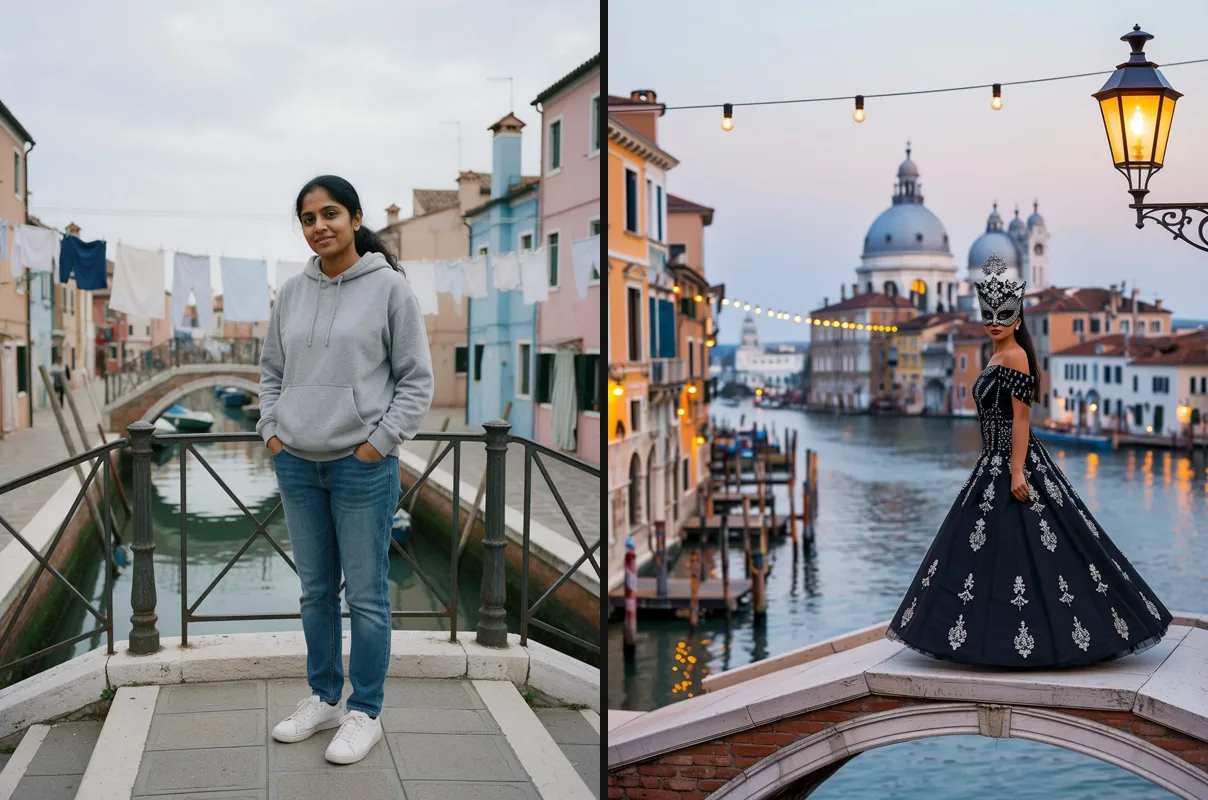
Wan 2.1 image-to-image con strength 0.75. Izquierda: la foto de entrada. Derecha: el resultado. El prompt pedía a la misma mujer en el mismo puente, de noche, con un vestido de baile de máscaras; la ropa cambió como se pidió, pero también cambiaron el puente, la luz y la pose, y la máscara impide saber si se conservó su rostro.
Cómo escribir prompts para Wan 2.1
Nuestros ejemplos publicados de text-to-video con Wan 2.1 siguen una estructura sencilla, y el clip de abajo muestra lo que produjo. Este es su prompt exacto, dividido en partes:
- Lugar y momento: "Night in Venice during carnival."
- Quién, indicado como adulto, y qué lleva: "An adult Black woman in her early thirties in a midnight-blue velvet gown with bare shoulders and a gold filigree half-mask reclines on the cushioned seat of a gondola gliding slowly down a narrow canal."
- Qué hacen la luz y el entorno: "Lanterns on striped mooring poles slide past and their light ripples across the black water and her skin."
- Una secuencia corta de acciones, en orden: "She lifts the mask away from her face, turns her head toward the camera and holds a slow, smouldering gaze."
- Cámara, objetivo y color: "Slow tracking shot alongside the gondola, 35mm, shallow depth of field, warm amber against deep teal, fine film grain."
El prompt negativo de este clip fue blurry, distorted hands, extra fingers, deformed face, text, watermark, logo. Los tres endpoints de video aceptan un prompt negativo; los dos de imagen no.
Cómo cambia el prompt según el endpoint:
- Text-to-video: describe la escena entera, como arriba. Cada uno de nuestros ejemplos de 5 segundos tenía una secuencia corta de dos o tres acciones.
- Image-to-video: no repitas lo que muestra la foto. Describe lo que pasa a continuación y cómo se mueve la cámara. La tabla de resultados de arriba muestra cuánto se ciñe a la foto.
- Video-to-video: indica qué debe quedarse ("same scene and camera move") y qué debe cambiar. El movimiento y el encuadre del origen se mantienen por sí solos.
- Image-to-image: describe la escena nueva por completo y ajusta
strengthsegún cuánto puede cambiar, como en el par de arriba. - LoRA: incluye las palabras de activación que indique el autor. Nuestro ejemplo de color plano empezaba con "flat color, no lineart."; el de 360 Orbit usó su palabra de activación a mitad del prompt, y ambas surtieron efecto.
- Cada persona: indica que es adulta, a ser posible con una edad, como hacen nuestros ejemplos. Las personas que representes deben ser adultas.
Qué aporta una LoRA adulta en Wan 2.1
Ejecutamos las dos LoRA adultas generales más descargadas para Wan 2.1 con el mismo prompt y la misma semilla que sin ellas:
- Video-to-video, NSFW Wan 14B con intensidad 1: el clip de L3 que se había quedado vestido sin la LoRA volvió tal como se pidió, con el mismo movimiento que el origen. Fue el único nivel atenuado que repetimos con una LoRA; L4 y los demás resultados atenuados no se repitieron.
- Image-to-video, WAN General NSFW (v.014) con 0.5 y 1: con 0.5, la primera mitad del clip coincidió con la ejecución sin ella. Con 1, la escena transcurrió en otro orden y la figura se dibujó de forma más natural. La ejecutamos sin su palabra de activación,
nsfwsks, y su autor recomienda una intensidad de alrededor de 0.9 con la palabra de activación, así que toma nuestro resultado como un límite inferior. - Text-to-video y text-to-image, NSFW Wan 14B con 0.5 y 1: el modelo base ya había entregado L3, de modo que el efecto de la LoRA se notó en la persona, el entorno y la composición. Con 0.5 el resultado fue parecido al de la ejecución sin ella; con 1 cambió por completo.
En estas ejecuciones únicas, 0.5 cambió poco y 1 cambió mucho. Empieza cerca de la intensidad que recomienda el autor, alrededor de 0.9 a 1, y compara siempre con una ejecución sin la LoRA: en text-to-video el modelo base ya hace buena parte de aquello para lo que sirven estos archivos.
Qué LoRA de Wan 2.1 cargar
Una selección de LoRA de Wan 2.1 muy descargadas: los dos archivos adultos generales más los de cámara, estilo, detalle y velocidad que revisamos. Las descargas se leyeron el 10 de octubre de 2026.
| LoRA | Qué hace | Descargas | ¿Funciona como enlace? | Nuestra prueba |
|---|---|---|---|---|
| WAN General NSFW model (2.1 v.014), de CubeyAI en Civitai | LoRA adulta general | 84,412 (la versión 2.1) | No, Civitai exige iniciar sesión | Cargada en image-to-video con 0.5 y 1 |
| NSFW Wan 14B, de NSFW-API en Hugging Face | LoRA adulta general | unas 117,000 (todo el repositorio, con los checkpoints completos) | Sí | Cargada en text-to-video, video-to-video y text-to-image |
| Detailz-Wan, de VisionAIry en Civitai | Detalle y realismo | 23,907 | No, Civitai exige iniciar sesión | No probada |
| 360 Orbit, de Remade-AI | La cámara gira alrededor del sujeto | 6,585 | Sí | Funcionó en image-to-video en 720p, intensidad 1 |
| Flat Color v2, de motimalu | Aspecto anime de color plano | 6,734 | Sí | Funcionó en text-to-video; sin efecto visible en imágenes fijas |
| Wan2.1 4-step distill, de lightx2v | Menos pasos, ejecuciones más rápidas | 34,677 | Sí | No probada |
Lo que la tabla no puede contener:
- El archivo de CubeyAI es la LoRA adulta general más descargada para Wan 2.1 en Civitai. Su autor recomienda text-to-video o image-to-video en 480p, dice que los resultados de image-to-video en 720p son malos y usa la palabra de activación
nsfwsks. La ficha de NSFW Wan 14B no indica palabra de activación ni intensidad para el archivo de la LoRA. - Las licencias difieren. La licencia de CubeyAI en Civitai permite el uso comercial solo a través del generador propio de Civitai. Detailz permite vender imágenes, pero no ejecutarlo en otro servicio de pago. Los archivos de cámara y estilo son Apache-2.0, y NSFW Wan 14B usa CreativeML OpenRAIL-M. Lee la licencia antes de usar el resultado con fines comerciales.
- Aquí no probamos la LoRA distill. Su ficha apunta a 4 pasos con guidance 1. Nosotros cobramos por clip, así que, como mucho, acortaría la espera, no la factura.
- Para encontrar más en Civitai: filtra por los modelos base "Wan Video 14B t2v", "Wan Video 14B i2v 480p" o "Wan Video 14B i2v 720p". La mayoría de las más descargadas allí son archivos de concepto de una sola acción, que no listamos.
La misma lista con todos los enlaces, junto a LoRA para otros modelos base, está en nuestra página de LoRA.
LoRA de Wan 2.2 y la base equivocada
Las LoRA de Wan 2.2 son más recientes y abundantes, y algunas funcionan en Wan 2.1. Cada resultado de abajo es una sola ejecución:
- Una LoRA de estilo de archivo único de Wan 2.2 funcionó. Vintage Cinematic Redmond convirtió un clip de text-to-video y una imagen fija en cine antiguo desvaído.
- El archivo de ruido bajo de una LoRA adulta de Wan 2.2 funcionó en image-to-video. Cambió el clip en la misma dirección que el archivo adulto de Wan 2.1 con intensidad 1. No probamos un archivo de ruido alto.
- El archivo de la familia equivocada que probamos falló por completo. Una LoRA de Anima terminó cada tarea con un error genérico, y no se cobró ninguna.
No probamos la dirección contraria, archivos de Wan 2.1 en Wan 2.2. Nuestra guía de las ranuras de Wan 2.2 los trata como un motivo frecuente de que una LoRA no haga nada allí.
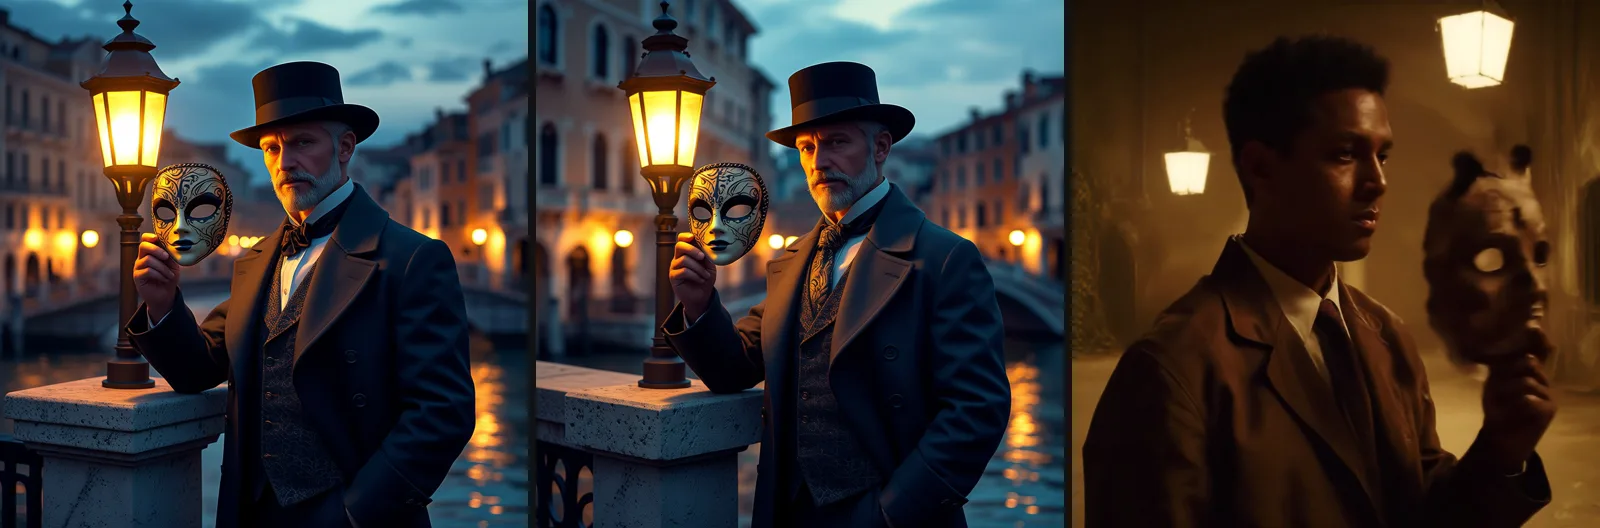
Wan 2.1 text-to-image, mismo prompt y misma semilla, una ejecución cada una. Izquierda: sin LoRA. Centro: una LoRA de cine negro, casi idéntica a la de la izquierda. Derecha: una LoRA de cine antiguo de Wan 2.2, que cambió toda la imagen.
Una LoRA puede completarse, cobrarse y no cambiar nada visible, así que haz un control con la misma semilla para cada archivo en el que pienses apoyarte. En image-to-video, la misma semilla y las mismas entradas nos dieron un clip idéntico byte a byte, lo que hace la comparación limpia. En text-to-image, la misma semilla no siempre reprodujo la misma imagen, así que ejecuta cada lado dos veces antes de juzgar una imagen fija.
Cargar una LoRA por enlace
Nuestro endpoint Wan 2.1 LoRA acepta hasta tres archivos LoRA por solicitud en text-to-video, image-to-video y video-to-video, cada uno con una intensidad de 0 a 4. Wan 2.1 Image LoRA acepta la misma lista para imágenes fijas. En la página de un modelo puedes pegar el enlace en el campo LoRA del playground sin escribir código. Por la API es la lista loras. Esta es la forma de nuestra prueba de LoRA en video-to-video, con un prompt neutro:
{
  "prompt": "Same scene and camera move, warmer evening light.",
  "video_url": "https://example.com/source-clip.mp4",
  "resolution": "480p",
  "duration_seconds": 5,
  "strength": 0.9,
  "loras": [
    {
      "path": "https://huggingface.co/NSFW-API/NSFW_Wan_14b/resolve/main/nsfw_lora_wan_14b_e15.safetensors",
      "scale": 1
    }
  ]
}scalees el peso de la LoRA, el 0.5 y el 1 de más arriba.strengthes un ajuste aparte que existe solo en video-to-video e image-to-image y fija hasta dónde puede alejarse el resultado del origen: en video-to-video el valor por defecto es 0.9, y por debajo de 0.6 aproximadamente el origen vuelve casi sin cambios.- En video-to-video, ajusta la duración a la del origen. El resultado nunca es más largo que el origen, pero pagas por la duración que eliges: 10 segundos sobre un clip de 5 segundos devuelve unos 5.4 segundos y se factura como 10.
El archivo tiene que descargarse sin iniciar sesión y seguir accesible hasta que empiece la tarea. Estos archivos van de unos 0.3 a 1.25 GB, y una tarea puede esperar varios minutos en cola, así que si usas un enlace con caducidad, haz que sea válido al menos una hora. Enlaces que fallaron en nuestras pruebas, ninguno con cargo:
- Una descarga de Civitai que redirige al inicio de sesión. La mayoría de los archivos de Wan 2.1 que revisamos en Civitai, los adultos incluidos, solo se descargan con la sesión iniciada, y el servidor no puede iniciarla. Descarga el archivo tú mismo y alójalo donde funcione un enlace simple, por ejemplo en un almacenamiento que controles. Para archivos cuya licencia no permite redistribuirlos, usa un bucket privado y un enlace con caducidad en lugar de un repositorio público.
- Un repositorio restringido de Hugging Face. El mismo problema: la descarga exige iniciar sesión.
- La página de un repositorio en lugar del archivo. En Hugging Face, el enlace al archivo contiene
/resolve/main/. - Cuatro LoRA, o una intensidad superior a 4. Se rechaza al enviar.
En los endpoints de video, los tres primeros devuelven el mismo mensaje genérico "The job failed unexpectedly", así que comprueba el enlace antes de enviar; text-to-image nombra el problema. Un error no hace fallar la tarea: en video-to-video, un enlace a una imagen en video_url se acepta y devuelve un clip de un solo cuadro, que se factura.
Ejecutar tu propia LoRA en una API alojada incluye un script completo y una comprobación previa, y el verificador de compatibilidad de LoRA te dice para qué base se entrenó un archivo.
De la imagen fija al clip final: un presupuesto
Dos formas de planificar un clip final de 5 segundos en 720p:
| Plan | Pasos | Coste |
|---|---|---|
| A partir de una imagen fija | 4 imágenes fijas en Wan 2.1 Image LoRA ($0.12), luego 2 borradores de image-to-video en 480p ($0.48), luego 1 render en 720p ($0.36) | $0.96 |
| Solo a partir de texto | 2 borradores de text-to-video en 480p ($0.48), luego 1 render en 720p ($0.36) | $0.84 |
Parte de una imagen fija cuando necesites controlar quién sale en el cuadro y qué lleva: la imagen que elijas será el primer cuadro, así que hazla con la forma que quieres que tenga el clip (16:9 o 9:16). Parte del texto cuando importe más la escena que la persona exacta; text-to-video también entregó más niveles en nuestra escalera. Tres cosas que conviene saber antes de fiarte de cualquiera de los dos planes:
- Un render en 720p es una toma nueva, no un escalado del borrador. Solo vimos coincidir ejecuciones con la misma semilla cuando todas las entradas eran idénticas, y otra resolución es otra entrada. Usa los borradores para fijar el prompt y el primer cuadro, no el movimiento exacto.
- Una LoRA elegida con imágenes fijas puede no trasladarse al video. Vimos cargar LoRA adultas en los cinco endpoints, pero no probamos todos los archivos en todos los endpoints, y el autor del archivo de CubeyAI valora mal image-to-video en 720p.
- Las tareas fallidas no cuestan nada, así que un enlace roto o un parámetro rechazado no suma al total.
Ajustes que cambian el resultado
- La duración es de 5 o 10 segundos, nada más. Otros valores fallan sin cargo. Los clips salen de unos 5.4 o 10 segundos y no tienen pista de audio.
- Image-to-video conserva la forma de la foto. Una foto 16:9 sale a 800×448 en 480p y a 1248×688 en 720p. Text-to-video ofrece 16:9 y 9:16.
- Deja primero los pasos y el guidance en sus valores por defecto (30 y 5). Con menos pasos y más guidance y flow shift obtuvimos cuadros sobresaturados con artefactos brillantes. Cambia
flow_shiftsolo cuando el autor de una LoRA recomiende un valor. - Cuenta con entre dos y cinco minutos por clip. Una ejecución de video-to-video de 10 segundos tardó casi nueve. Las imágenes fijas tardaron unos 13 segundos.
¿Ejecutarlo tú mismo o a través de una API?
Los pesos son gratuitos con Apache-2.0, así que la cuestión real es el hardware. Los benchmarks del propio Wan en el repositorio de Wan 2.1 dan la escala:
- El modelo pequeño de 1.3B genera un clip de text-to-video de 5 segundos en 480p en una sola RTX 4090 en unos 4.4 minutos, con 8.19 GB de memoria en el pico. Es solo text-to-video y solo 480p.
- El modelo de 14B en 720p alcanza un pico de 69 a 77 GB en una sola GPU, incluso con descarga del modelo. Text-to-video tarda unos 31 minutos por clip en una H100 y unos 56 minutos en una A100, sin aceleraciones.
- Las aceleraciones cierran parte de la brecha. El repositorio de Wan 2.1 enumera frameworks de la comunidad como LightX2V, que según indica ejecuta Wan en una RTX 4060 de 8 GB; el mismo equipo publica la LoRA distill de 4 pasos de la tabla de arriba.
Nuestro endpoint ejecuta el modelo de 14B y devolvió un clip de text-to-video de 5 segundos en 720p en menos de cuatro minutos en nuestras pruebas, por $0.36, sin nada que instalar; video-to-video en 720p tardó unos cinco. Ejecutarlo tú mismo tiene sentido si ya tienes una GPU grande, renderizas en volumen o necesitas un checkpoint o un flujo de trabajo que no alojamos.
Una trampa al buscar archivos: Wan 2.1 viene en dos tamaños, y una LoRA entrenada para uno no sirve para el otro. NSFW-API, por ejemplo, publica un modelo de 1.3B aparte junto a su LoRA de 14B. Nuestros endpoints de Wan 2.1 ejecutan 14B, así que comprueba que el archivo diga 14B, T2V-14B o I2V-14B antes de usarlo.
¿Wan 2.1 u otro modelo?
| Quieres | Usa | Por qué |
|---|---|---|
| Cargar una LoRA hecha para Wan 2.1 | Wan 2.1 LoRA | Archivos únicos, hasta tres por solicitud |
| Cambiar un clip existente con una LoRA | Wan 2.1 LoRA, video-to-video | Acepta un clip de origen más tus LoRA |
| Hacer imágenes fijas con tu LoRA | Wan 2.1 Image LoRA | $0.03 por imagen, a partir de texto o de una foto |
| Cargar un par de Wan 2.2 de ruido alto y ruido bajo | Wan 2.2 LoRA | Tiene una ranura para cada mitad |
| Animar una foto por menos | Wan 2.2 LoRA, image-to-video | Unos $0.10 por 5 segundos en 480p y $0.20 en 720p con la oferta actual, frente a $0.24 y $0.36; carga archivos de Wan 2.2, no de Wan 2.1 |
| Obtener escenas íntimas L4 a partir de una foto | Wan 2.2 Spicy, image-to-video | Entregó L4 en 3 de 3 ejecuciones en nuestra prueba de versiones de Wan, $0.095 por 5 segundos en 480p; sin ranura de LoRA |
| Obtener todos los niveles, incluidos L4 y L5, a partir de texto o de una foto | Wan 3.0 | Entregó todos los niveles en la misma prueba, aunque tiende a ir más allá del prompt y añadir personas; $0.225 por 5 segundos en 480p, clips de hasta 30 segundos con sonido; sin ranura de LoRA |
| Animar una foto en un clip más largo o en 1080p al mismo precio | LTX 2.3 Spicy | Clips de 3 a 20 segundos en hasta 1080p, $0.095 por 5 segundos en 480p; entregó L3 en 3 de 3 ejecuciones y L4 en 2 de 3 en nuestra prueba de LTX 2.3 con clips de 3 segundos; sin ranura de LoRA |
Cuánto cuesta un clip
Precios de nuestro catálogo en vivo del 11 de octubre de 2026:
| Wan 2.1 LoRA | 5 segundos | 10 segundos |
|---|---|---|
| 480p | $0.24 | $0.36 |
| 720p | $0.36 | $0.54 |
Los mismos precios valen para text-to-video, image-to-video y video-to-video. Las imágenes fijas en Wan 2.1 Image LoRA cuestan $0.03 cada una, con cualquiera de los dos tamaños. Las LoRA, la relación de aspecto, los pasos y el guidance no cambian el precio, y las tareas fallidas no se cobran.
Preguntas frecuentes
¿Wan 2.1 está censurado?
No. Los pesos abiertos no llevan ningún filtro, y ninguna de nuestras 35 pruebas en cinco endpoints fue rechazada. Lo que le falta es entrenamiento en escenas íntimas, que salieron atenuadas.
¿Wan 2.2 permite contenido NSFW?
Los pesos abiertos de Wan 2.2 tampoco tienen filtro. Las versiones alojadas difieren: en nuestras pruebas de septiembre, Wan 2.2 base en text-to-video rechazó prompts adultos, mientras que las versiones Wan 2.2 Spicy y LoRA entregaron la mayoría de los niveles. La prueba de versiones de Wan tiene la tabla completa.
¿Necesito una LoRA para NSFW en Wan 2.1?
No para L2 ni L3 a partir de texto o de una foto. En video-to-video, el modelo base mantuvo la ropa del origen y una LoRA adulta lo cambió; en image-to-video cambió cómo se dibujaba la figura.
¿Puedo pegar un enlace de Civitai?
Solo si el archivo se descarga sin iniciar sesión. La mayoría de las LoRA adultas de Civitai exigen inicio de sesión, así que descarga el archivo y alójalo tú mismo.
¿Las LoRA de Wan 2.1 funcionan en Wan 2.2?
No probamos esa dirección. Algunas LoRA de Wan 2.2 sí funcionan en Wan 2.1: una LoRA de estilo de archivo único y el archivo de ruido bajo de un par adulto lo hicieron en nuestras ejecuciones.
¿Cuánto puede durar un clip de Wan 2.1?
5 o 10 segundos en nuestro endpoint. El modelo se diseñó en torno a clips cortos, así que quienes lo ejecutan en local unen clips para obtener algo más largo. Si necesitas un único clip continuo, Wan 3.0 llega hasta 30 segundos.
¿Puedo ejecutar Wan 2.1 NSFW con 8 GB de VRAM?
Solo con concesiones: el modelo pequeño de 1.3B necesita 8.19 GB en el pico según las cifras del propio Wan y genera solo text-to-video en 480p, y el de 14B necesita una versión cuantizada. Las LoRA hechas para un tamaño no funcionan en el otro.
¿Wan 2.1 genera sonido?
No. Los clips salen mudos. Añade el sonido después o con un modelo de video-to-audio.
Conclusión
Usa Wan 2.1 a partir de texto cuando quieras la mayor libertad por el dinero, y pruébalo primero sin LoRA. Añade una LoRA adulta cuando partas de un clip existente o quieras un aspecto distinto a partir de una foto, y comprueba cada archivo contra una ejecución sin él. Para escenas íntimas a partir de una foto, Wan 2.2 Spicy llegó más lejos en nuestras pruebas y cuesta menos.
Todos los modelos y personas de este artículo son adultos, ficticios o con consentimiento. SpicyAPI no añade ningún filtro de contenido propio; lo que generes sigue siendo responsabilidad tuya.