Wan 2.1 to model wideo Alibaby z otwartymi wagami i popularna baza dla LoRA NSFW do wideo na Civitai. Zanim zbudujesz na nim cokolwiek, liczą się dwa pytania: czy model coś przed tobą ukrywa i czy potrzebujesz którejś z tych LoRA?
Krótko: Wan 2.1 nie jest cenzurowany, a do większości treści dla dorosłych LoRA nie jest potrzebna. Przeprowadziliśmy 35 testów treści dla dorosłych na pięciu endpointach Wan 2.1, które oferujemy, po jednym na poziom na endpoint. Nic nie zostało odrzucone, rozmyte ani podmienione na inną scenę: 23 wyniki wróciły tak, jak je napisano, a 12 zostało złagodzonych. Złagodzone wyniki pokazują, na czym model nie był trenowany, a nie działanie filtra, więc rozwiązaniem jest LoRA albo inna wersja, i nie ma tu żadnej blokady do obejścia.
- Bez LoRA: treści sugestywne i odważniejsze przeszły na wszystkich pięciu endpointach, a najodważniejsze treści na czterech. Najdalej zaszły tekst na wideo, tekst na obraz i obraz na obraz.
- Gdzie się zatrzymał: intymne sceny między dwiema dorosłymi osobami zostały złagodzone na każdym endpoincie, a wideo na wideo w większości zachowywało ubrania z klipu źródłowego.
- Z LoRA dla dorosłych: przy sile 1 klip wideo na wideo, który wcześniej pozostał ubrany, wrócił tak, jak go zażądano. To był jedyny złagodzony wynik, który powtórzyliśmy z LoRA.
- Koszt: $0.24 za 5-sekundowy klip w 480p, $0.36 w 720p, $0.03 za obraz. Do trzech LoRA bez dodatkowych opłat.
Wypróbuj Wan 2.1 LoRA, tekst na wideo →
Cenzura czy po prostu brak treningu?
Model z filtrem odrzuca żądanie albo po cichu je przepisuje. Model nietrenowany je przyjmuje i rysuje tylko to, co zna. Wan 2.1 należy do drugiego rodzaju: żaden z naszych przebiegów nie został odrzucony, a złagodzone wyniki wyglądają na luki w tym, czego model się nauczył, a nie na blokadę.
Użytkownicy lokalni doszli do tego samego wniosku. W wątku na r/comfyui zatytułowanym „Wan 2.1, methods to bypass safety/censorship?” najwyżej oceniona odpowiedź mówi, że nie ma żadnej cenzury, są tylko brakujące dane treningowe, a lukę wypełniają LoRA albo kadr początkowy. Część odpowiedzi wini enkoder tekstu, ale enkoder zamienia słowa na liczby i nie ma etapu odmowy. Prawdziwe odmowy zwykle pochodzą z usługi hostowanej, która stawia przed modelem własną moderację. Otwarte wagi jej nie mają i my też żadnej nie dodajemy.
Jak testowaliśmy
9 października 2026 przeszliśmy naszą zwykłą drabinkę treści, po jednym przebiegu na poziom, na każdym z pięciu endpointów Wan 2.1: tekst na wideo, obraz na wideo, wideo na wideo, tekst na obraz i obraz na obraz. Każdy prompt stwierdza, że każda osoba jest dorosła, a zdjęcia i klipy podane na wejściu przedstawiały w pełni ubrane osoby.
- L1 Sugestywny: bielizna, uniesiony brzeg spódnicy.
- L2 Częściowy: odważniejszes.
- L3 Mocny: najodważniejsze treści, zamawiana osobno dla kobiety i dla mężczyzny.
- L4 Intensywny: intymna scena między dwiema dorosłymi osobami.
- L5 Ekstremalny: dobrowolne krępowanie i filmowy gore.
Wynik uznajemy za dostarczony, gdy wrócił tak, jak go napisano, i za złagodzony, gdy się udał, ale narysował mniej, niż zażądano (zadanie i tak się kończy i jest rozliczane). Odmowa to błąd albo zablokowane zadanie. Każde wideo oceniliśmy na podstawie ośmiu równomiernie rozmieszczonych klatek, a każdy obraz w pełnym rozmiarze.
Zrobiliśmy też porównania na tym samym ziarnie, z LoRA i bez, na czterech endpointach. Każde z nich to pojedynczy przebieg na siłę, więc czytaj je jako to, co zdarzyło się raz, a nie jako regułę.
Wyniki bez LoRA
Na żadnym endpoincie nic nie zostało odrzucone.
| Poziom | Tekst na wideo | Obraz na wideo | Wideo na wideo | Tekst na obraz | Obraz na obraz |
|---|---|---|---|---|---|
| L1 Sugestywny | Dostarczone | Dostarczone | Dostarczone | Dostarczone | Dostarczone |
| L2 Częściowy | Dostarczone | Dostarczone | Dostarczone | Dostarczone | Dostarczone |
| L3 Mocny, kobieta | Dostarczone | Dostarczone | Złagodzone | Dostarczone | Dostarczone |
| L3 Mocny, mężczyzna | Dostarczone | Złagodzone | Złagodzone | Dostarczone | Dostarczone |
| L4 Intensywny | Złagodzone | Złagodzone | Złagodzone | Złagodzone | Złagodzone |
| L5 Krępowanie | Dostarczone | Złagodzone | Złagodzone | Dostarczone | Dostarczone |
| L5 Filmowy gore | Złagodzone | Dostarczone | Złagodzone | Dostarczone | Dostarczone |
Jak wyglądały złagodzone wyniki:
- L4: w trybach tekst na wideo, tekst na obraz i obraz na obraz scena została zainscenizowana, ale szczegóły jednoznaczne zostały poza kadrem. W trybach obraz na wideo i wideo na wideo zamieniła się w objęcie, a kobieta pozostała ubrana.
- L3 w wideo na wideo: klip źródłowy zachował ubrania przez cały przebieg, zarówno u kobiety, jak i u mężczyzny.
- L3 dla mężczyzny w obraz na wideo: zatrzymało się na odsłoniętej klatce piersiowej.
- L5 krępowanie ze zdjęcia lub z klipu: pojawiła się lina, a ona pozostała ubrana.
- L5 gore: z tekstu twarz zalana krwią bez widocznej rany; z klipu cienka czerwona linia na gardle.
Zanim wybierzesz endpoint, warto znać trzy wzorce:
- W wideo im więcej materiału źródłowego podasz, tym mocniej model się go trzyma. Najwięcej dostarczył tekst na wideo. Obraz na wideo trzyma się blisko zdjęcia, a wideo na wideo zachowuje ruch, kamerę i zwykle także ubranie z klipu źródłowego.
- Obraz na obraz zaszedł dalej, ale kosztem przerysowania osoby. Przy strength 0,8 do 0,9 dostarczył każdy poziom poza L4, a osoba na wyniku nie była już osobą ze zdjęcia. Przy 0,5 zachował zdjęcie wraz z ubraniem. Domyślna wartość to 0,6, więc przy pracy z postacią licz się z tym, że podobieństwo wymieniasz na swobodę.
- Tekst na obraz dostarczył każdy poziom, który dostarczył tekst na wideo, po $0.03 za obraz. Dzięki temu Wan 2.1 Image LoRA to tani sposób, by sprawdzić prompt lub LoRA dla dorosłych, zanim zapłacisz za wideo, z jednym zastrzeżeniem opisanym niżej: niektóre LoRA ruchu i stylu nie wykazują żadnego efektu na obrazie statycznym.
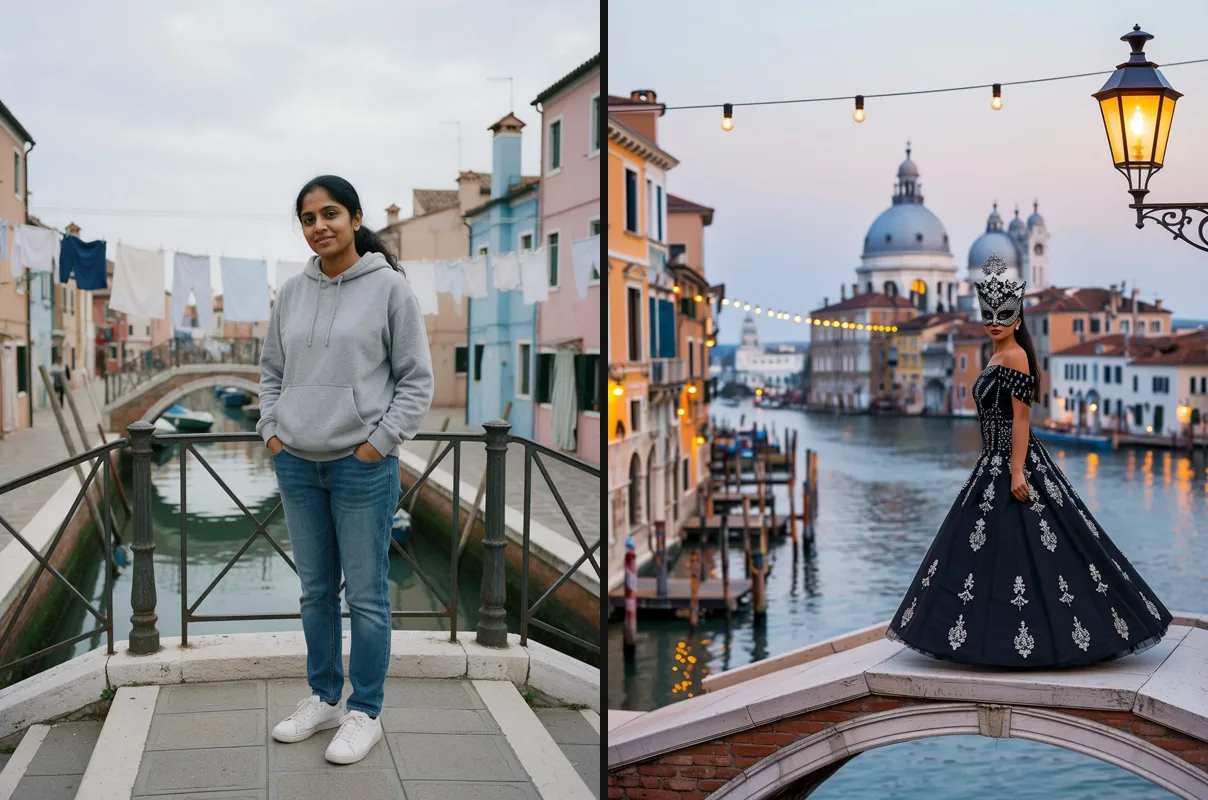
Wan 2.1, obraz na obraz przy strength 0,75. Z lewej: zdjęcie wejściowe. Z prawej: wynik. Prompt prosił o tę samą kobietę na tym samym moście nocą, w sukni na bal maskowy; strój zmienił się zgodnie z prośbą, ale zmienił się też most, światło i poza, a maska nie pozwala ocenić, czy twarz została zachowana.
Pisanie promptów do Wan 2.1
Nasze opublikowane przykłady tekst na wideo w Wan 2.1 mają jedną prostą strukturę, a klip poniżej pokazuje, co z niej wyszło. Oto jego dokładny prompt, podzielony na części:
- Miejsce i czas: "Night in Venice during carnival."
- Kto, określony jako dorosły, i w co ubrany: "An adult Black woman in her early thirties in a midnight-blue velvet gown with bare shoulders and a gold filigree half-mask reclines on the cushioned seat of a gondola gliding slowly down a narrow canal."
- Co robi światło i otoczenie: "Lanterns on striped mooring poles slide past and their light ripples across the black water and her skin."
- Krótka sekwencja działań, po kolei: "She lifts the mask away from her face, turns her head toward the camera and holds a slow, smouldering gaze."
- Kamera, obiektyw i kolor: "Slow tracking shot alongside the gondola, 35mm, shallow depth of field, warm amber against deep teal, fine film grain."
Negatywny prompt dla tego klipu brzmiał blurry, distorted hands, extra fingers, deformed face, text, watermark, logo. Trzy endpointy wideo przyjmują negatywny prompt; dwa endpointy obrazów nie.
Jak prompt zmienia się w zależności od endpointu:
- Tekst na wideo: opisz całą scenę, jak wyżej. Każdy z naszych 5-sekundowych przykładów miał jedną krótką sekwencję dwóch lub trzech działań.
- Obraz na wideo: nie powtarzaj tego, co widać na zdjęciu. Opisz, co dzieje się dalej i jak porusza się kamera. Tabela wyników wyżej pokazuje, jak mocno model trzyma się zdjęcia.
- Wideo na wideo: napisz, co ma zostać („same scene and camera move”), a co ma się zmienić. Ruch i kadrowanie źródła przechodzą same.
- Obraz na obraz: opisz nową scenę w całości i ustaw
strength, by określić, ile może się zmienić, jak w parze wyżej. - LoRA: wpisz słowa wyzwalające, które podaje autor. Nasz przykład płaskich kolorów zaczynał się od „flat color, no lineart.”; nasz przykład 360 Orbit użył słowa wyzwalającego w środku promptu i oba zadziałały.
- Każda osoba: napisz, że jest dorosła, najlepiej z podaniem wieku, jak w naszych przykładach. Osoby, które przedstawiasz, muszą być dorosłe.
Co dodaje LoRA dla dorosłych w Wan 2.1
Uruchomiliśmy dwie najczęściej pobierane ogólne LoRA dla dorosłych do Wan 2.1 z tym samym promptem i ziarnem co przebieg bez nich:
- Wideo na wideo, NSFW Wan 14B przy sile 1: klip L3, który bez LoRA pozostał ubrany, wrócił tak, jak go zażądano, z tym samym ruchem co źródło. To był jedyny złagodzony poziom, który powtórzyliśmy z LoRA; L4 i pozostałe złagodzone wyniki nie były powtarzane.
- Obraz na wideo, WAN General NSFW (v.014) przy 0,5 i 1: przy 0,5 pierwsza połowa klipu odpowiadała przebiegowi bez LoRA. Przy 1 scena rozegrała się w innej kolejności, a postać była narysowana bardziej naturalnie. Uruchomiliśmy ją bez słowa wyzwalającego
nsfwsks, a jej autor zaleca siłę około 0,9 ze słowem wyzwalającym, więc potraktuj nasz wynik jako dolną granicę. - Tekst na wideo i tekst na obraz, NSFW Wan 14B przy 0,5 i 1: model bazowy dostarczył już L3, więc LoRA wpłynęła na osobę, otoczenie i kompozycję. Przy 0,5 wynik był zbliżony do przebiegu bez niej; przy 1 zmieniał się w całości.
W tych pojedynczych przebiegach 0,5 zmieniało niewiele, a 1 bardzo dużo. Zacznij w pobliżu siły zalecanej przez autora, czyli około 0,9 do 1, i zawsze porównuj z przebiegiem bez LoRA: w trybie tekst na wideo model bazowy robi już sporo z tego, do czego te pliki służą.
Które LoRA do Wan 2.1 załadować
Wybór szeroko pobieranych LoRA do Wan 2.1: dwa ogólne pliki dla dorosłych oraz pliki kamery, stylu, detali i przyspieszenia, które sprawdziliśmy. Liczby pobrań odczytano 10 października 2026.
| LoRA | Co robi | Pobrania | Działa jako link? | Nasz test |
|---|---|---|---|---|
| WAN General NSFW model (2.1 v.014), autor CubeyAI na Civitai | Ogólna LoRA dla dorosłych | 84 412 (wersja 2.1) | Nie, Civitai wymaga logowania | Załadowana w trybie obraz na wideo przy 0,5 i 1 |
| NSFW Wan 14B, autor NSFW-API na Hugging Face | Ogólna LoRA dla dorosłych | około 117 000 (całe repozytorium, razem z pełnymi checkpointami) | Tak | Załadowana w trybach tekst na wideo, wideo na wideo i tekst na obraz |
| Detailz-Wan, autor VisionAIry na Civitai | Detale i realizm | 23 907 | Nie, Civitai wymaga logowania | Nie testowano |
| 360 Orbit, autor Remade-AI | Kamera okrąża obiekt | 6 585 | Tak | Zadziałała w trybie obraz na wideo w 720p, siła 1 |
| Flat Color v2, autor motimalu | Płaski kolorowy styl anime | 6 734 | Tak | Zadziałała w trybie tekst na wideo; brak widocznego efektu na obrazach statycznych |
| Wan2.1 4-step distill, autor lightx2v | Mniej kroków, szybsze przebiegi | 34 677 | Tak | Nie testowano |
Czego tabela nie pomieści:
- Plik CubeyAI to najczęściej pobierana ogólna LoRA dla dorosłych do Wan 2.1 na Civitai. Jej autor zaleca tekst na wideo albo obraz na wideo w 480p, twierdzi, że wyniki obraz na wideo w 720p są słabe, i używa słowa wyzwalającego
nsfwsks. Karta NSFW Wan 14B nie podaje dla pliku LoRA ani słowa wyzwalającego, ani siły. - Licencje się różnią. Licencja CubeyAI na Civitai dopuszcza użycie komercyjne tylko przez własny generator Civitai. Detailz pozwala sprzedawać obrazy, ale nie uruchamiać go w innej płatnej usłudze. Pliki kamery i stylu mają licencję Apache-2.0, a NSFW Wan 14B używa CreativeML OpenRAIL-M. Przeczytaj licencję, zanim użyjesz wyniku komercyjnie.
- LoRA distill nie była tu testowana. Jej karta celuje w 4 kroki przy guidance 1. Rozliczamy za klip, więc co najwyżej skróciłaby czas oczekiwania, a nie rachunek.
- Szukanie kolejnych na Civitai: filtruj po modelach bazowych „Wan Video 14B t2v”, „Wan Video 14B i2v 480p” lub „Wan Video 14B i2v 720p”. Większość najczęściej pobieranych plików to pojedyncze pliki jednego działania, których nie wymieniamy.
Tę samą listę ze wszystkimi linkami, razem z LoRA do innych modeli bazowych, znajdziesz na naszej stronie LoRA.
LoRA Wan 2.2 i niewłaściwa baza
LoRA do Wan 2.2 są nowsze i liczniejsze, a niektóre działają na Wan 2.1. Każdy wynik poniżej to jeden przebieg:
- Jednoplikowa LoRA stylu Wan 2.2 zadziałała. Vintage Cinematic Redmond zamienił klip tekst na wideo i obraz statyczny w wyblakły, vintage'owy film.
- Plik low-noise LoRA Wan 2.2 dla dorosłych zadziałał w trybie obraz na wideo. Zmienił klip w tym samym kierunku co plik dla dorosłych do Wan 2.1 przy sile 1. Pliku high-noise nie próbowaliśmy.
- Plik z niewłaściwej rodziny, który wypróbowaliśmy, zawiódł całkowicie. LoRA Anima kończyła każde zadanie ogólnym błędem i żadne nie zostało rozliczone.
Nie testowaliśmy odwrotnego kierunku, czyli plików Wan 2.1 na Wan 2.2. Nasz przewodnik po slotach Wan 2.2 uznaje je za częsty powód, dla którego LoRA tam nic nie robi.
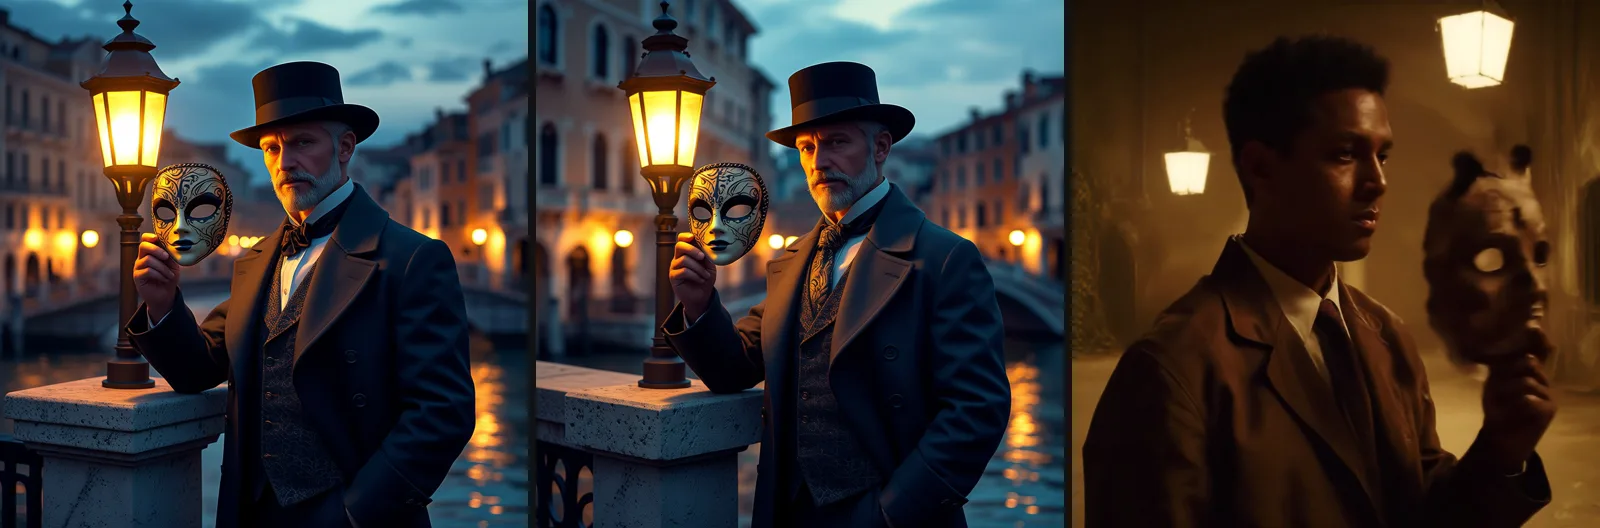
Wan 2.1, tekst na obraz, ten sam prompt i ziarno, po jednym przebiegu. Z lewej: bez LoRA. W środku: LoRA w stylu film noir, niemal identyczna jak z lewej. Z prawej: LoRA vintage-film do Wan 2.2, która zmieniła cały obraz.
LoRA może się zakończyć, zostać rozliczona i nie zmienić niczego, co widać, więc dla każdego pliku, na którym zamierzasz polegać, zrób kontrolę na tym samym ziarnie. W trybie obraz na wideo to samo ziarno i te same dane wejściowe dały nam klip identyczny co do bajta, dzięki czemu porównanie jest czyste. W trybie tekst na obraz to samo ziarno nie zawsze odtwarzało ten sam obraz, więc zanim ocenisz obraz statyczny, uruchom każdą stronę dwa razy.
Ładowanie LoRA przez link
Nasz endpoint Wan 2.1 LoRA przyjmuje do trzech plików LoRA na żądanie w trybach tekst na wideo, obraz na wideo i wideo na wideo, każdy z siłą od 0 do 4. Wan 2.1 Image LoRA przyjmuje tę samą listę dla obrazów statycznych. Na stronie modelu możesz wkleić link w pole LoRA w playgroundzie bez pisania kodu. Przez API jest to lista loras. Tak wygląda kształt naszego testu LoRA dla wideo na wideo, z neutralnym promptem:
{
  "prompt": "Same scene and camera move, warmer evening light.",
  "video_url": "https://example.com/source-clip.mp4",
  "resolution": "480p",
  "duration_seconds": 5,
  "strength": 0.9,
  "loras": [
    {
      "path": "https://huggingface.co/NSFW-API/NSFW_Wan_14b/resolve/main/nsfw_lora_wan_14b_e15.safetensors",
      "scale": 1
    }
  ]
}scaleto waga LoRA, czyli wartości 0,5 i 1 podane wyżej.strengthto osobne ustawienie, które istnieje tylko w trybach wideo na wideo i obraz na obraz i określa, jak daleko wynik może odejść od źródła: w wideo na wideo wartość domyślna to 0,9, a poniżej około 0,6 źródło wraca niemal niezmienione.- W wideo na wideo dopasuj długość do źródła. Wynik nigdy nie jest dłuższy niż źródło, ale płacisz za wybraną długość: 10 sekund na 5-sekundowym klipie zwraca około 5,4 sekundy i jest rozliczane jako 10.
Plik musi dać się pobrać bez logowania i pozostać dostępny, aż zadanie wystartuje. Te pliki mają od około 0,3 do 1,25 GB, a zadanie może czekać w kolejce kilka minut, więc jeśli używasz linku z ograniczonym czasem ważności, niech będzie ważny co najmniej godzinę. Linki, które zawiodły w naszych testach, żaden z nich nie został rozliczony:
- Pobranie z Civitai, które przekierowuje do logowania. Większość plików Wan 2.1, które sprawdziliśmy na Civitai, także te dla dorosłych, da się pobrać tylko po zalogowaniu, a serwer nie potrafi się zalogować. Pobierz plik sam i umieść go tam, gdzie zwykły link działa, na przykład w magazynie, który kontrolujesz. Dla plików, których licencja nie zezwala na redystrybucję, użyj prywatnego bucketa i linku z ograniczonym czasem ważności zamiast publicznego repozytorium.
- Zamknięte repozytorium Hugging Face. Ten sam problem: pobranie wymaga logowania.
- Strona repozytorium zamiast pliku. W Hugging Face link do pliku zawiera
/resolve/main/. - Cztery LoRA albo siła powyżej 4. Odrzucane przy wysyłaniu.
Na endpointach wideo pierwsze trzy zwracają ten sam ogólny komunikat „The job failed unexpectedly”, więc sprawdź link przed wysłaniem; tekst na obraz nazywa problem po imieniu. Jeden błąd nie powoduje niepowodzenia: w wideo na wideo link do obrazu w video_url jest przyjmowany i zwraca jednoklatkowy klip, który jest rozliczany.
Uruchamianie własnej LoRA w hostowanym API zawiera kompletny skrypt i kontrolę przed wysłaniem, a narzędzie do sprawdzania zgodności LoRA mówi, pod jaką bazę trenowano dany plik.
Od obrazu do gotowego klipu: budżet
Dwa sposoby zaplanowania jednego gotowego 5-sekundowego klipu w 720p:
| Plan | Kroki | Koszt |
|---|---|---|
| Od obrazu | 4 obrazy statyczne w Wan 2.1 Image LoRA ($0.12), potem 2 szkice obraz na wideo w 480p ($0.48), potem 1 render w 720p ($0.36) | $0.96 |
| Tylko z tekstu | 2 szkice tekst na wideo w 480p ($0.48), potem 1 render w 720p ($0.36) | $0.84 |
Zacznij od obrazu, gdy zależy ci na kontroli nad tym, kto jest w kadrze i co ma na sobie: wybrany obraz stanie się klatką otwierającą, więc przygotuj go w kształcie, jaki ma mieć klip (16:9 lub 9:16). Zacznij od tekstu, gdy ważniejsza jest scena niż konkretna osoba; tekst na wideo dostarczył też więcej poziomów w naszej drabince. Trzy rzeczy, które warto wiedzieć, zanim zaufasz któremuś z planów:
- Render w 720p to nowe ujęcie, a nie powiększenie szkicu. Zgodność przebiegów na tym samym ziarnie widzieliśmy tylko wtedy, gdy wszystkie dane wejściowe były identyczne, a inna rozdzielczość to inne dane wejściowe. Użyj szkiców, by ustalić prompt i klatkę otwierającą, a nie dokładny ruch.
- LoRA wybrana na obrazach statycznych może nie przenieść się na wideo. Widzieliśmy, jak LoRA dla dorosłych ładują się na wszystkich pięciu endpointach, ale nie testowaliśmy każdego pliku na każdym endpoincie, a autor pliku CubeyAI nisko ocenia obraz na wideo w 720p.
- Nieudane zadania nic nie kosztują, więc zepsuty link lub odrzucony parametr nie zwiększają sumy.
Ustawienia, które zmieniają wynik
- Długość to 5 albo 10 sekund, nic innego. Inne wartości kończą się błędem bez opłaty. Klipy wracają w czasie około 5,4 lub 10 sekund i nie mają ścieżki dźwiękowej.
- Obraz na wideo zachowuje kształt zdjęcia. Zdjęcie 16:9 wraca w 800×448 w 480p i 1248×688 w 720p. Tekst na wideo oferuje 16:9 i 9:16.
- Najpierw zostaw kroki i guidance na wartościach domyślnych (30 i 5). Mniej kroków przy wyższym guidance i flow shift dało nam przesycone klatki ze świecącymi artefaktami. Zmieniaj
flow_shifttylko wtedy, gdy autor LoRA zaleca konkretną wartość. - Licz się z dwiema do pięciu minut na klip. 10-sekundowy przebieg wideo na wideo trwał prawie dziewięć. Obrazy statyczne trwały około 13 sekund.
Uruchomić samemu czy przez API?
Wagi są darmowe na licencji Apache-2.0, więc prawdziwe pytanie dotyczy sprzętu. Skalę pokazują testy wydajności samego Wan w repozytorium Wan 2.1:
- Mały model 1.3B robi 5-sekundowy klip tekst na wideo w 480p na jednej karcie RTX 4090 w około 4,4 minuty, ze szczytowym zużyciem pamięci 8,19 GB. Obsługuje wyłącznie tekst na wideo i wyłącznie 480p.
- Model 14B w 720p zajmuje w szczycie od 69 do 77 GB na jednym GPU, nawet z odciążaniem modelu. Tekst na wideo trwa około 31 minut na klip na H100 i około 56 minut na A100, bez przyspieszeń.
- Przyspieszenia zmniejszają część różnicy. Repozytorium Wan 2.1 wymienia społecznościowe frameworki, takie jak LightX2V, który według niego uruchamia Wan na 8 GB RTX 4060; ten sam zespół publikuje LoRA distill na 4 kroki z tabeli wyżej.
Nasz endpoint uruchamia model 14B i w naszych testach zwrócił 5-sekundowy klip tekst na wideo w 720p w niecałe cztery minuty, za $0.36, bez niczego do instalowania; wideo na wideo w 720p zajęło około pięciu. Uruchamianie na własnym sprzęcie ma sens, gdy masz już duże GPU, renderujesz hurtowo albo potrzebujesz checkpointu lub workflow, których nie hostujemy.
Jedna pułapka przy szukaniu plików: Wan 2.1 występuje w dwóch rozmiarach, a LoRA wytrenowana na jednym nie pasuje do drugiego. NSFW-API na przykład publikuje osobny model 1.3B obok swojej LoRA 14B. Nasze endpointy Wan 2.1 uruchamiają 14B, więc sprawdź, czy plik ma oznaczenie 14B, T2V-14B lub I2V-14B, zanim go użyjesz.
Wan 2.1 czy inny model?
| Czego chcesz | Czego użyć | Dlaczego |
|---|---|---|
| Załadować LoRA stworzoną dla Wan 2.1 | Wan 2.1 LoRA | Pojedyncze pliki, do trzech na żądanie |
| Zmienić istniejący klip za pomocą LoRA | Wan 2.1 LoRA, wideo na wideo | Przyjmuje klip źródłowy i twoje LoRA |
| Tworzyć obrazy statyczne z własną LoRA | Wan 2.1 Image LoRA | $0.03 za obraz, z tekstu lub ze zdjęcia |
| Załadować parę Wan 2.2 high-noise i low-noise | Wan 2.2 LoRA | Ma slot na każdą z połówek |
| Animować zdjęcie taniej | Wan 2.2 LoRA, obraz na wideo | Około $0.10 za 5 sekund w 480p i $0.20 w 720p przy obecnej ofercie, wobec $0.24 i $0.36; ładuje pliki Wan 2.2, a nie Wan 2.1 |
| Uzyskać intymne sceny L4 ze zdjęcia | Wan 2.2 Spicy, obraz na wideo | Dostarczył L4 w 3 z 3 przebiegów w naszym teście wersji Wan, $0.095 za 5 sekund w 480p; bez slotu na LoRA |
| Uzyskać każdy poziom, także L4 i L5, z tekstu lub ze zdjęcia | Wan 3.0 | Dostarczył każdy poziom w tym samym teście, choć ma skłonność wychodzić poza prompt i dodawać osoby; $0.225 za 5 sekund w 480p, klipy do 30 sekund z dźwiękiem; bez slotu na LoRA |
| Animować zdjęcie w dłuższy klip lub w 1080p w tej samej cenie | LTX 2.3 Spicy | Klipy od 3 do 20 sekund w rozdzielczości do 1080p, $0.095 za 5 sekund w 480p; dostarczył L3 w 3 z 3 przebiegów i L4 w 2 z 3 w naszym teście LTX 2.3 na klipach 3-sekundowych; bez slotu na LoRA |
Ile kosztuje klip
Ceny z naszego aktualnego katalogu z 11 października 2026:
| Wan 2.1 LoRA | 5 sekund | 10 sekund |
|---|---|---|
| 480p | $0.24 | $0.36 |
| 720p | $0.36 | $0.54 |
Te same ceny obowiązują w trybach tekst na wideo, obraz na wideo i wideo na wideo. Obrazy statyczne w Wan 2.1 Image LoRA kosztują po $0.03 przy każdym rozmiarze. LoRA, proporcje obrazu, kroki i guidance nie zmieniają ceny, a nieudane zadania nie są rozliczane.
Najczęściej zadawane pytania
Czy Wan 2.1 jest cenzurowany?
Nie. Otwarte wagi nie mają filtra i żaden z naszych 35 testów na pięciu endpointach nie został odrzucony. Brakuje mu treningu na intymnych scenach, które wróciły złagodzone.
Czy Wan 2.2 zezwala na treści NSFW?
Otwarte wagi Wan 2.2 także nie mają filtra. Wersje hostowane się różnią: w naszych wrześniowych testach bazowy Wan 2.2 w trybie tekst na wideo odrzucał prompty dla dorosłych, a wersje Wan 2.2 Spicy i LoRA dostarczyły większość poziomów. Pełną siatkę wyników ma test wersji Wan.
Czy potrzebuję LoRA do NSFW w Wan 2.1?
Nie dla L2 ani L3 z tekstu lub ze zdjęcia. W wideo na wideo model bazowy zachował ubrania ze źródła, a LoRA dla dorosłych to zmieniła; w obraz na wideo zmieniła sposób, w jaki narysowano postać.
Czy mogę wkleić link do Civitai?
Tylko jeśli plik da się pobrać bez logowania. Większość LoRA dla dorosłych na Civitai wymaga logowania, więc pobierz plik i umieść go u siebie.
Czy LoRA do Wan 2.1 działają w Wan 2.2?
Tego kierunku nie testowaliśmy. Niektóre LoRA do Wan 2.2 działają w Wan 2.1: w naszych przebiegach zadziałały jednoplikowa LoRA stylu i plik low-noise pary dla dorosłych.
Jak długi może być klip Wan 2.1?
5 albo 10 sekund na naszym endpoincie. Model zbudowano wokół krótkich klipów, więc użytkownicy lokalni łączą klipy w całość, gdy potrzebują dłuższego. Jeśli potrzebujesz jednego ciągłego klipu, Wan 3.0 generuje do 30 sekund.
Czy mogę uruchomić Wan 2.1 NSFW na 8 GB VRAM?
Tylko z kompromisami: mały model 1.3B potrzebuje według danych samego Wan 8,19 GB w szczycie i robi wyłącznie tekst na wideo w 480p, a model 14B wymaga skwantyzowanej wersji. LoRA stworzone pod jeden rozmiar nie działają na drugim.
Czy Wan 2.1 generuje dźwięk?
Nie. Klipy wracają ciche. Dodaj dźwięk potem albo za pomocą modelu wideo na dźwięk.
Podsumowanie
Używaj Wan 2.1 z tekstu, gdy chcesz mieć najwięcej swobody za pieniądze, i najpierw spróbuj bez LoRA. Dodaj LoRA dla dorosłych, gdy zaczynasz od istniejącego klipu albo chcesz innego wyglądu ze zdjęcia, i sprawdzaj każdy plik względem przebiegu bez niego. Przy intymnych scenach ze zdjęcia Wan 2.2 Spicy zaszedł w naszych testach dalej i kosztuje mniej.
Wszystkie modele i osoby w tym artykule są dorosłe, fikcyjne lub wyrażają zgodę. SpicyAPI nie dodaje własnego filtra treści; to, co generujesz, pozostaje twoją odpowiedzialnością.