Wan 2.1 è il modello video open-weights di Alibaba e una base molto diffusa per le LoRA video NSFW su Civitai. Prima di costruirci sopra contano due domande: il modello si trattiene su qualcosa? E ti serve una di quelle LoRA?
In breve: Wan 2.1 non è censurato, e per la maggior parte dei contenuti per adulti non serve una LoRA. Abbiamo eseguito 35 test di contenuti per adulti sui cinque endpoint Wan 2.1 che offriamo, uno per livello per endpoint. Nulla è stato rifiutato, sfocato o sostituito con una scena diversa: 23 risultati sono tornati come scritto e 12 sono stati attenuati. I risultati attenuati mostrano ciò su cui il modello non è stato addestrato, non un filtro: la soluzione è una LoRA o un'altra versione, e non c'è nulla da aggirare con un jailbreak.
- Senza LoRA: le immagini allusive e più audaci sono passate su tutti e cinque gli endpoint, il contenuto molto audace su quattro. Text-to-video, text-to-image e image-to-image sono andati più lontano.
- Dove si è fermato prima: le scene intime tra due adulti sono state attenuate su ogni endpoint, e il video-to-video ha per lo più mantenuto i vestiti del clip di origine.
- Con una LoRA per adulti: con intensità 1, un clip video-to-video che era rimasto vestito è tornato come richiesto. È stato l'unico risultato attenuato che abbiamo ripetuto con una LoRA.
- Costo: $0.24 per un clip da 5 secondi a 480p, $0.36 a 720p, $0.03 per immagine. Fino a tre LoRA non costano nulla in più.
Prova Wan 2.1 LoRA text-to-video →
Censurato o semplicemente non addestrato?
Un modello filtrato rifiuta o riscrive di nascosto una richiesta. Uno non addestrato la accetta e disegna solo ciò che conosce. Wan 2.1 è del secondo tipo: nessuna delle nostre esecuzioni è stata rifiutata, e i risultati attenuati somigliano a lacune di ciò che ha imparato, non a un blocco.
Gli utenti in locale sono giunti alla stessa conclusione. In un thread di r/comfyui intitolato "Wan 2.1, methods to bypass safety/censorship?", la risposta più votata dice che non c'è alcuna censura, solo dati di addestramento mancanti, e che LoRA o un'immagine iniziale colmano la lacuna. Alcune risposte danno la colpa all'encoder di testo, ma un encoder trasforma le parole in numeri e non ha alcun passaggio di rifiuto. I veri rifiuti arrivano di solito da un servizio ospitato che mette davanti al modello una propria moderazione. I pesi open non ne hanno, e noi non ne aggiungiamo.
Come abbiamo testato
Il 9 ottobre 2026 abbiamo eseguito la nostra solita scala di contenuti una volta per livello su ciascuno dei cinque endpoint Wan 2.1: text-to-video, image-to-video, video-to-video, text-to-image e image-to-image. Ogni prompt dichiara che ogni persona è adulta, e le foto e i clip che abbiamo dato come input mostravano persone completamente vestite.
- L1 Allusivo: lingerie, l'orlo di una gonna sollevato.
- L2 Parziale: più audace.
- L3 Forte: contenuto molto audace, richiesto separatamente per una donna e per un uomo.
- L4 Intenso: una scena intima tra due adulti.
- L5 Estremo: legature consensuali e gore cinematografico.
Un risultato vale reso quando è tornato come scritto e attenuato quando è riuscito ma ha disegnato meno di quanto richiesto (l'attività si completa comunque e viene addebitata). Un rifiuto è un errore o un'attività bloccata. Abbiamo giudicato ogni video da otto fotogrammi equidistanti e ogni immagine a dimensione piena.
Abbiamo anche eseguito confronti con lo stesso seed, con e senza LoRA, su quattro endpoint. Ognuno era una singola esecuzione per intensità, quindi leggili come ciò che è successo una volta, non come una regola.
Risultati senza LoRA
Nessun rifiuto su nessun endpoint.
| Livello | Text-to-video | Image-to-video | Video-to-video | Text-to-image | Image-to-image |
|---|---|---|---|---|---|
| L1 Allusivo | Reso | Reso | Reso | Reso | Reso |
| L2 Parziale | Reso | Reso | Reso | Reso | Reso |
| L3 Forte, donna | Reso | Reso | Attenuato | Reso | Reso |
| L3 Forte, uomo | Reso | Attenuato | Attenuato | Reso | Reso |
| L4 Intenso | Attenuato | Attenuato | Attenuato | Attenuato | Attenuato |
| L5 Legature | Reso | Attenuato | Attenuato | Reso | Reso |
| L5 Gore cinematografico | Attenuato | Reso | Attenuato | Reso | Reso |
Come apparivano i risultati attenuati:
- L4: in text-to-video, text-to-image e image-to-image la scena era messa in scena, ma il dettaglio esplicito restava fuori dall'inquadratura. In image-to-video e video-to-video è diventata un abbraccio, con la donna ancora vestita.
- L3 in video-to-video: il clip di origine ha mantenuto i vestiti per tutta l'esecuzione, sia per la donna sia per l'uomo.
- L3 per un uomo in image-to-video: si è fermato a un livello meno audace.
- L5 legature da una foto o da un clip: la corda è comparsa e lei è rimasta vestita.
- L5 gore: da testo, un volto coperto di sangue senza ferita visibile; da un clip, una sottile linea rossa alla gola.
Prima di scegliere un endpoint vale la pena conoscere tre schemi:
- Nel video, più materiale di origine dai, più il modello vi si attiene. Il text-to-video ha reso di più. L'image-to-video resta vicino alla foto, e il video-to-video mantiene il movimento, la camera e, di solito, i vestiti del clip di origine.
- L'image-to-image è andato più lontano, ma ridisegnando la persona. Con intensità 0,8–0,9 ha reso ogni livello tranne L4, e la persona nel risultato non era più quella della foto. Con 0,5 ha mantenuto la foto, vestiti compresi. Il valore predefinito è 0,6, quindi per il lavoro sui personaggi aspettati di rinunciare a parte della somiglianza in cambio di libertà.
- Il text-to-image ha reso ogni livello che ha reso il text-to-video, a $0.03 a immagine. Per questo Wan 2.1 Image LoRA è un modo economico per controllare un prompt o una LoRA per adulti prima di pagare il video, con un'avvertenza trattata più avanti: alcune LoRA di movimento e di stile non mostrano alcun effetto su un'immagine statica.
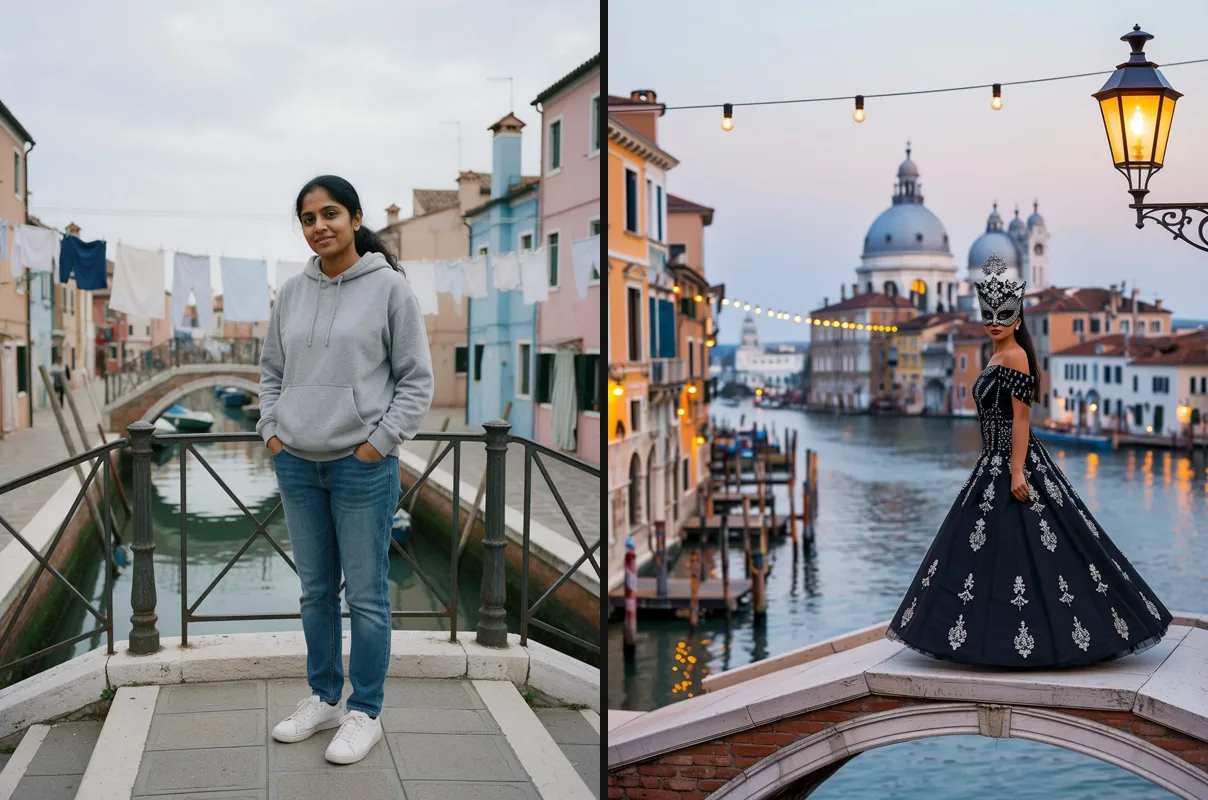
Wan 2.1 image-to-image con intensità 0,75. A sinistra: la foto di partenza. A destra: il risultato. Il prompt chiedeva la stessa donna sullo stesso ponte di notte con un abito da ballo in maschera; l'abito è cambiato come richiesto, ma sono cambiati anche il ponte, la luce e la posa, e la maschera nasconde se il volto sia stato mantenuto.
Scrivere prompt per Wan 2.1
I nostri esempi pubblicati di text-to-video su Wan 2.1 usano un'unica struttura semplice, e il clip qui sotto mostra cosa ha prodotto. Questo è il suo prompt esatto, diviso in parti:
- Luogo e momento: "Night in Venice during carnival."
- Chi, dichiarato come adulto, e cosa indossa: "An adult Black woman in her early thirties in a midnight-blue velvet gown with bare shoulders and a gold filigree half-mask reclines on the cushioned seat of a gondola gliding slowly down a narrow canal."
- Cosa fanno la luce e l'ambientazione: "Lanterns on striped mooring poles slide past and their light ripples across the black water and her skin."
- Una breve sequenza di azioni, in ordine: "She lifts the mask away from her face, turns her head toward the camera and holds a slow, smouldering gaze."
- Camera, obiettivo e colore: "Slow tracking shot alongside the gondola, 35mm, shallow depth of field, warm amber against deep teal, fine film grain."
Il prompt negativo per questo clip era blurry, distorted hands, extra fingers, deformed face, text, watermark, logo. I tre endpoint video accettano un prompt negativo; i due endpoint per immagini no.
Come cambia il prompt a seconda dell'endpoint:
- Text-to-video: descrivi l'intera scena, come sopra. I nostri esempi da 5 secondi avevano ciascuno una breve sequenza di due o tre azioni.
- Image-to-video: non ripetere ciò che mostra la foto. Descrivi cosa succede dopo e come si muove la camera. La tabella dei risultati qui sopra mostra quanto resta fedele alla foto.
- Video-to-video: di' cosa deve restare ("same scene and camera move") e cosa deve cambiare. Il movimento e l'inquadratura dell'origine passano da soli.
- Image-to-image: descrivi la nuova scena per intero e imposta
strengthin base a quanto può cambiare, come nella coppia qui sopra. - LoRA: inserisci le parole chiave indicate dall'autore. Il nostro esempio a colori piatti si apriva con "flat color, no lineart."; il nostro esempio 360 Orbit usava la sua parola chiave a metà prompt, ed entrambi hanno avuto effetto.
- Ogni persona: dichiara che è un adulto, possibilmente con un'età, come fanno i nostri esempi. Le persone raffigurate devono essere adulte.
Cosa aggiunge una LoRA per adulti su Wan 2.1
Abbiamo eseguito le due LoRA generali per adulti più scaricate per Wan 2.1 con lo stesso prompt e lo stesso seed delle esecuzioni senza di esse:
- Video-to-video, NSFW Wan 14B con intensità 1: il clip L3 che senza la LoRA era rimasto vestito è tornato come richiesto, con lo stesso movimento dell'origine. È stato l'unico livello attenuato che abbiamo ripetuto con una LoRA; L4 e gli altri risultati attenuati non sono stati ripetuti.
- Image-to-video, WAN General NSFW (v.014) a 0,5 e 1: a 0,5 la prima metà del clip coincideva con l'esecuzione senza la LoRA. A 1 la scena si è svolta in un ordine diverso e la figura è stata disegnata in modo più naturale. L'abbiamo eseguita senza la sua parola chiave,
nsfwsks, e il suo autore consiglia un'intensità di circa 0,9 con la parola chiave, quindi considera il nostro risultato un limite inferiore. - Text-to-video e text-to-image, NSFW Wan 14B a 0,5 e 1: il modello base aveva già reso L3, quindi l'effetto della LoRA ha riguardato la persona, l'ambientazione e la composizione. A 0,5 il risultato era vicino all'esecuzione senza di essa; a 1 è cambiato dappertutto.
In queste singole esecuzioni 0,5 ha cambiato poco e 1 ha cambiato molto. Parti vicino all'intensità consigliata dall'autore, intorno a 0,9–1, e confronta sempre con un'esecuzione senza la LoRA: in text-to-video il modello base fa già buona parte di ciò per cui questi file esistono.
Quali LoRA di Wan 2.1 caricare
Una selezione di LoRA di Wan 2.1 molto scaricate: i due file generali per adulti più i file di camera, stile, dettaglio e velocità che abbiamo controllato. I conteggi dei download sono stati letti il 10 ottobre 2026.
| LoRA | Cosa fa | Download | Funziona come link? | Il nostro test |
|---|---|---|---|---|
| WAN General NSFW model (2.1 v.014), di CubeyAI su Civitai | LoRA generale per adulti | 84,412 (la versione 2.1) | No, Civitai richiede l'accesso | Caricata in image-to-video a 0,5 e 1 |
| NSFW Wan 14B, di NSFW-API su Hugging Face | LoRA generale per adulti | circa 117,000 (intero repository, inclusi i checkpoint completi) | Sì | Caricata in text-to-video, video-to-video e text-to-image |
| Detailz-Wan, di VisionAIry su Civitai | Dettaglio e realismo | 23,907 | No, Civitai richiede l'accesso | Non testata |
| 360 Orbit, di Remade-AI | La camera gira intorno al soggetto | 6,585 | Sì | Ha funzionato in image-to-video a 720p, intensità 1 |
| Flat Color v2, di motimalu | Look anime a colori piatti | 6,734 | Sì | Ha funzionato in text-to-video; nessun effetto visibile sulle immagini statiche |
| Wan2.1 4-step distill, di lightx2v | Meno passi, esecuzioni più rapide | 34,677 | Sì | Non testata |
Ciò che la tabella non riesce a contenere:
- Il file di CubeyAI è la LoRA generale per adulti per Wan 2.1 più scaricata su Civitai. Il suo autore consiglia text-to-video o image-to-video a 480p, dice che i risultati dell'image-to-video a 720p sono scarsi e usa la parola chiave
nsfwsks. La scheda di NSFW Wan 14B non indica alcuna parola chiave né intensità per il file LoRA. - Le licenze differiscono. La licenza Civitai di CubeyAI consente l'uso commerciale solo tramite il generatore di Civitai. Detailz consente di vendere le immagini, ma non di usarla su un altro servizio a pagamento. I file di camera e di stile sono Apache-2.0, e NSFW Wan 14B usa CreativeML OpenRAIL-M. Leggi la licenza prima di usare l'output a fini commerciali.
- La LoRA distill qui non è stata testata. La sua scheda punta a 4 passi con guidance 1. Noi addebitiamo per clip, quindi al massimo accorcerebbe l'attesa, non il conto.
- Trovarne altre su Civitai: filtra per i modelli base "Wan Video 14B t2v", "Wan Video 14B i2v 480p" o "Wan Video 14B i2v 720p". La maggior parte dei download più alti lì sono file di concetto per una singola azione, che non elenchiamo.
La stessa lista con tutti i link, insieme alle LoRA per altri modelli base, è nella nostra pagina LoRA.
LoRA di Wan 2.2 e la base sbagliata
Le LoRA di Wan 2.2 sono più recenti e più numerose, e alcune funzionano su Wan 2.1. Ogni risultato qui sotto è una singola esecuzione:
- Una LoRA di stile a file singolo per Wan 2.2 ha funzionato. Vintage Cinematic Redmond ha trasformato un clip text-to-video e un'immagine statica in pellicola d'epoca sbiadita.
- Il file low-noise di una LoRA per adulti di Wan 2.2 ha funzionato in image-to-video. Ha cambiato il clip nella stessa direzione del file per adulti di Wan 2.1 con intensità 1. Non abbiamo provato un file high-noise.
- Il file della famiglia sbagliata che abbiamo provato è fallito del tutto. Una LoRA Anima ha chiuso ogni job con un errore generico, e nessuno è stato addebitato.
Non abbiamo testato la direzione opposta, cioè i file di Wan 2.1 su Wan 2.2. La nostra guida agli slot di Wan 2.2 li indica come un motivo comune per cui una LoRA non fa nulla lì.
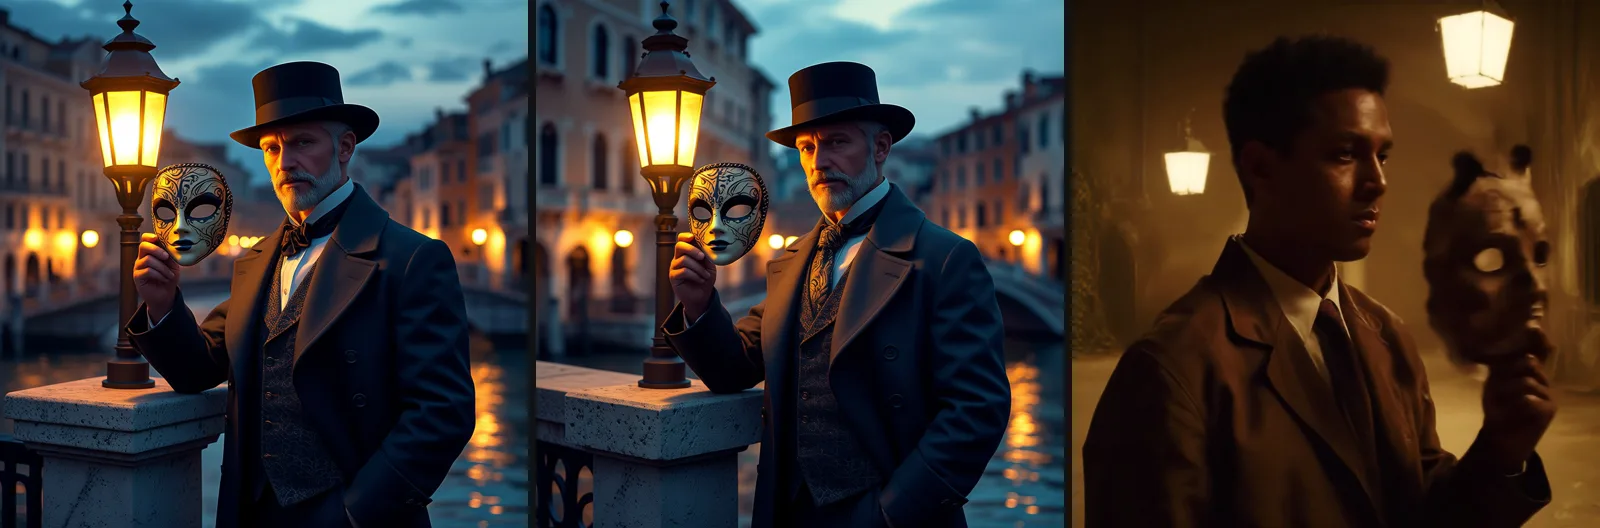
Wan 2.1 text-to-image, stesso prompt e stesso seed, un'esecuzione ciascuna. A sinistra: nessuna LoRA. Al centro: una LoRA film noir, quasi identica a quella di sinistra. A destra: una LoRA di pellicola d'epoca per Wan 2.2, che ha cambiato l'intera immagine.
Una LoRA può completarsi, essere addebitata e non cambiare nulla di visibile, quindi esegui un controllo con lo stesso seed per ogni file su cui conti di fare affidamento. In image-to-video lo stesso seed e gli stessi input ci hanno dato un clip identico byte per byte, il che rende pulito il confronto. In text-to-image lo stesso seed non ha sempre riprodotto la stessa immagine, quindi esegui ciascun lato due volte prima di giudicare un'immagine statica.
Caricare una LoRA tramite link
Il nostro endpoint Wan 2.1 LoRA accetta fino a tre file LoRA per richiesta in text-to-video, image-to-video e video-to-video, ciascuno con un'intensità da 0 a 4. Wan 2.1 Image LoRA accetta la stessa lista per le immagini statiche. Nella pagina di un modello puoi incollare il link nel campo LoRA del playground senza scrivere codice. Tramite l'API è la lista loras. Questa è la forma del nostro test LoRA in video-to-video, con un prompt neutro:
{
  "prompt": "Same scene and camera move, warmer evening light.",
  "video_url": "https://example.com/source-clip.mp4",
  "resolution": "480p",
  "duration_seconds": 5,
  "strength": 0.9,
  "loras": [
    {
      "path": "https://huggingface.co/NSFW-API/NSFW_Wan_14b/resolve/main/nsfw_lora_wan_14b_e15.safetensors",
      "scale": 1
    }
  ]
}scaleè il peso della LoRA, cioè lo 0,5 e l'1 citati sopra.strengthè un'impostazione separata che esiste solo in video-to-video e image-to-image e stabilisce quanto il risultato può allontanarsi dall'origine: in video-to-video il valore predefinito è 0,9, e sotto circa 0,6 l'origine torna quasi invariata.- In video-to-video fai coincidere la durata con quella dell'origine. Il risultato non è mai più lungo dell'origine, ma paghi la durata che scegli: 10 secondi su un clip di 5 secondi restituiscono circa 5,4 secondi e vengono addebitati come 10.
Il file deve scaricarsi senza accesso e restare raggiungibile finché il job non parte. Questi file vanno da circa 0,3 a 1,25 GB, e un job può restare in coda diversi minuti, quindi se usi un link a tempo, rendilo valido per almeno un'ora. I link che nei nostri test sono falliti, nessuno addebitato:
- Un download di Civitai che reindirizza all'accesso. La maggior parte dei file Wan 2.1 che abbiamo controllato su Civitai, quelli per adulti compresi, si scarica solo se hai effettuato l'accesso, e il server non può accedere. Scarica il file tu stesso e ospitalo dove un semplice link funziona, ad esempio in uno spazio di archiviazione che controlli. Per i file la cui licenza non consente la ridistribuzione, usa un bucket privato e un link a tempo invece di un repository pubblico.
- Un repository Hugging Face con accesso riservato (gated). Stesso problema: il download richiede un accesso.
- La pagina di un repository invece del file. Su Hugging Face il link al file contiene
/resolve/main/. - Quattro LoRA, o un'intensità superiore a 4. Rifiutate all'invio.
Sugli endpoint video i primi tre restituiscono tutti lo stesso messaggio generico "The job failed unexpectedly", quindi controlla il link prima di inviare; il text-to-image indica il problema. Un errore non fa fallire il job: in video-to-video, un link a un'immagine in video_url viene accettato e restituisce un clip di un solo fotogramma, che viene addebitato.
Usare la tua LoRA su un'API ospitata contiene uno script completo e un controllo preliminare, e il verificatore di compatibilità LoRA ti dice per quale base è stato addestrato un file.
Dall'immagine statica al clip finito: un budget
Due modi per pianificare un clip finito da 5 secondi a 720p:
| Piano | Passaggi | Costo |
|---|---|---|
| Da un'immagine statica | 4 immagini statiche su Wan 2.1 Image LoRA ($0.12), poi 2 bozze image-to-video a 480p ($0.48), poi 1 render a 720p ($0.36) | $0.96 |
| Solo da testo | 2 bozze text-to-video a 480p ($0.48), poi 1 render a 720p ($0.36) | $0.84 |
Parti da un'immagine statica quando ti serve controllo su chi c'è nell'inquadratura e cosa indossa: l'immagine che scegli diventa il fotogramma iniziale, quindi creala nel formato che vuoi per il clip (16:9 o 9:16). Parti dal testo quando conta di più la scena che la persona esatta; il text-to-video ha anche reso più livelli nella nostra scala. Tre cose da sapere prima di affidarti a uno dei due piani:
- Un render a 720p è una nuova ripresa, non un upscale della bozza. Abbiamo visto coincidere esecuzioni con lo stesso seed solo quando ogni input era identico, e una risoluzione diversa è un input diverso. Usa le bozze per fissare il prompt e il fotogramma iniziale, non il movimento esatto.
- Una LoRA scelta sulle immagini statiche potrebbe non funzionare nel video. Abbiamo visto le LoRA per adulti caricarsi su tutti e cinque gli endpoint, ma non abbiamo provato ogni file su ogni endpoint, e l'autore del file di CubeyAI giudica scarso l'image-to-video a 720p.
- I job falliti non costano nulla, quindi un link rotto o un parametro rifiutato non aumenta il totale.
Impostazioni che cambiano il risultato
- La durata è di 5 o 10 secondi, nient'altro. Gli altri valori falliscono senza addebito. I clip tornano di circa 5,4 o 10 secondi e non hanno traccia audio.
- L'image-to-video mantiene la forma della foto. Una foto 16:9 torna a 800×448 a 480p e a 1248×688 a 720p. Il text-to-video offre 16:9 e 9:16.
- Lascia prima passi e guidance ai valori predefiniti (30 e 5). Meno passi con guidance e flow shift più alti ci hanno dato fotogrammi saturati in eccesso con artefatti luminosi. Cambia
flow_shiftsolo quando l'autore di una LoRA consiglia un valore. - Aspettati da due a cinque minuti circa per clip. Un'esecuzione video-to-video da 10 secondi ne ha richiesti quasi nove. Le immagini statiche circa 13 secondi.
Eseguirlo in locale o tramite API?
I pesi sono gratuiti con licenza Apache-2.0, quindi la vera domanda è l'hardware. I benchmark di Wan stessa nel repository di Wan 2.1 danno l'ordine di grandezza:
- Il piccolo modello da 1.3B genera un clip text-to-video di 5 secondi a 480p su una sola RTX 4090 in circa 4,4 minuti, con 8,19 GB di memoria al picco. È solo text-to-video e solo a 480p.
- Il modello da 14B a 720p raggiunge un picco di 69–77 GB su una singola GPU, anche con l'offloading del modello. Il text-to-video richiede circa 31 minuti per clip su una H100 e circa 56 minuti su una A100, senza accelerazioni.
- Le accelerazioni colmano in parte il divario. Il repository di Wan 2.1 elenca framework della community come LightX2V, che secondo il repository fa girare Wan su una RTX 4060 da 8 GB; lo stesso team pubblica la LoRA distill a 4 passi presente nella tabella qui sopra.
Il nostro endpoint esegue il modello da 14B e nei nostri test ha restituito un clip text-to-video di 5 secondi a 720p in meno di quattro minuti, per $0.36, senza nulla da installare; il video-to-video a 720p ne ha richiesti circa cinque. Eseguirlo in locale ha senso quando hai già una GPU grande, fai rendering in volume o ti serve un checkpoint o un workflow che non ospitiamo.
Una trappola quando cerchi i file: Wan 2.1 esiste in due dimensioni, e una LoRA addestrata su una non si adatta all'altra. NSFW-API, per esempio, pubblica un modello separato da 1.3B accanto alla sua LoRA da 14B. I nostri endpoint Wan 2.1 usano il 14B, quindi verifica che un file indichi 14B, T2V-14B o I2V-14B prima di usarlo.
Wan 2.1 o un altro modello?
| Cosa vuoi fare | Cosa usare | Perché |
|---|---|---|
| Caricare una LoRA fatta per Wan 2.1 | Wan 2.1 LoRA | File singoli, fino a tre per richiesta |
| Modificare un clip esistente con una LoRA | Wan 2.1 LoRA, video-to-video | Accetta un clip di origine più le tue LoRA |
| Creare immagini statiche con la tua LoRA | Wan 2.1 Image LoRA | $0.03 a immagine, da testo o da una foto |
| Caricare una coppia high-noise e low-noise di Wan 2.2 | Wan 2.2 LoRA | Ha uno slot per ciascuna metà |
| Animare una foto spendendo meno | Wan 2.2 LoRA, image-to-video | Circa $0.10 per 5 secondi a 480p e $0.20 a 720p con l'offerta attuale, contro $0.24 e $0.36; carica file di Wan 2.2, non di Wan 2.1 |
| Ottenere scene intime L4 da una foto | Wan 2.2 Spicy, image-to-video | Ha reso L4 in 3 esecuzioni su 3 nel nostro test delle versioni di Wan, $0.095 per 5 secondi a 480p; nessuno slot LoRA |
| Ottenere ogni livello, compresi L4 e L5, da testo o da una foto | Wan 3.0 | Ha reso ogni livello nello stesso test, anche se tende ad andare oltre il prompt e ad aggiungere persone; $0.225 per 5 secondi a 480p, clip fino a 30 secondi con audio; nessuno slot LoRA |
| Animare una foto in un clip più lungo o in 1080p allo stesso prezzo | LTX 2.3 Spicy | Clip da 3 a 20 secondi fino a 1080p, $0.095 per 5 secondi a 480p; ha reso L3 in 3 esecuzioni su 3 e L4 in 2 su 3 nel nostro test di LTX 2.3 su clip di 3 secondi; nessuno slot LoRA |
Quanto costa un clip
Prezzi dal nostro catalogo dal vivo dell'11 ottobre 2026:
| Wan 2.1 LoRA | 5 secondi | 10 secondi |
|---|---|---|
| 480p | $0.24 | $0.36 |
| 720p | $0.36 | $0.54 |
Gli stessi prezzi valgono per text-to-video, image-to-video e video-to-video. Le immagini statiche su Wan 2.1 Image LoRA costano $0.03 ciascuna a entrambe le dimensioni. LoRA, formato, passi e guidance non cambiano il prezzo, e i job falliti non vengono addebitati.
Domande frequenti
Wan 2.1 è censurato?
No. I pesi open non hanno alcun filtro, e nessuno dei nostri 35 test su cinque endpoint è stato rifiutato. Gli manca l'addestramento sulle scene intime, che sono tornate attenuate.
Wan 2.2 consente contenuti NSFW?
Neanche i pesi open di Wan 2.2 hanno un filtro. Le versioni ospitate differiscono: nei nostri test di settembre il text-to-video base di Wan 2.2 ha rifiutato i prompt per adulti, mentre le versioni Wan 2.2 Spicy e LoRA hanno reso la maggior parte dei livelli. Il test delle versioni di Wan contiene la griglia completa.
Mi serve una LoRA per l'NSFW su Wan 2.1?
Non per L2 o L3 da testo o da una foto. In video-to-video il modello base ha mantenuto i vestiti dell'origine e una LoRA per adulti lo ha cambiato; in image-to-video ha cambiato il modo in cui la figura è stata disegnata.
Posso incollare un link di Civitai?
Solo se il file si scarica senza accedere. La maggior parte delle LoRA per adulti su Civitai richiede un accesso, quindi scarica il file e ospitalo tu.
Le LoRA di Wan 2.1 funzionano su Wan 2.2?
Non abbiamo testato quella direzione. Alcune LoRA di Wan 2.2 funzionano su Wan 2.1: nelle nostre esecuzioni ci sono riusciti una LoRA di stile a file singolo e il file low-noise di una coppia per adulti.
Quanto può durare un clip di Wan 2.1?
5 o 10 secondi sul nostro endpoint. Il modello è nato attorno a clip brevi, quindi in locale si montano più clip per ottenere durate maggiori. Se ti serve un unico clip continuo, Wan 3.0 arriva fino a 30 secondi.
Posso usare Wan 2.1 NSFW con 8 GB di VRAM?
Solo con dei compromessi: il piccolo modello da 1.3B richiede 8,19 GB al picco secondo i dati di Wan stessa e fa solo text-to-video a 480p, mentre il modello da 14B richiede una versione quantizzata. Le LoRA create per una dimensione non funzionano sull'altra.
Wan 2.1 produce suono?
No. I clip tornano muti. Aggiungi il suono dopo o con un modello video-to-audio.
In conclusione
Usa Wan 2.1 da testo quando vuoi la massima libertà per il prezzo, e provalo prima senza LoRA. Aggiungi una LoRA per adulti quando parti da un clip esistente o vuoi un aspetto diverso da una foto, e controlla ogni file confrontandolo con un'esecuzione senza di esso. Per le scene intime da una foto, Wan 2.2 Spicy è andato più lontano nei nostri test e costa meno.
Ogni modello e ogni persona in questo articolo è adulto, fittizio o consenziente. SpicyAPI non aggiunge alcun filtro sui contenuti; ciò che generi resta una tua responsabilità.