Vai al contenuto principale

Wan 2.1 LoRA da video a video ridisegna da un prompt una clip che hai già, mantenendone movimento e tempi, con fino a tre file LoRA tuoi sul modello da 14B di Alibaba. Output a 480p o 720p nella forma della sorgente, nulla viene filtrato.

Da $0.24/richiesta

Playground

Input

Editing video
Obbligatorio. Descrivi l’intero risultato (soggetto, abiti, ambientazione, luce, stile), non solo il cambiamento. Prima le parole trigger, se il tuo LoRA ne ha. almeno 1 caratteri
1/1

Trascina qui un video, oppure sfoglia · 1 file · Max 90 MB · MP4 · WEBM

  • 1
1 / 1 file
La clip di partenza. Movimento e tempi passano nel risultato, che ne mantiene la forma e non è mai più lungo. Deve essere un video: il link a un’immagine non viene rifiutato e restituisce una clip di un solo fotogramma che viene comunque fatturata. almeno 1 caratteri
incide sul prezzo
480p (predefinito) oppure 720p. 720p costa di più per clip e richiede più tempo; la forma segue la sorgente.
Intensità della trasformazione
Quanto allontanarsi dalla sorgente, da 0,1 a 1, predefinito 0,9. Nella nostra prova 0,9 ha ridisegnato la clip e 0,5 l’ha restituita quasi invariata. Nessun effetto sul prezzo. non meno di 0.1 · non più di 1
Durataincide sul prezzo
510
5 (predefinito) oppure 10. Il risultato non è mai più lungo della sorgente, ma 10 viene fatturato alla tariffa dei 10 secondi, quindi usalo solo per sorgenti di 10 secondi o più. Le altre durate vengono rifiutate.
LoRA di stile0/3
Fino a tre voci {path, scale} addestrate per Wan 2.1 14B; path è un link diretto pubblico a un file .safetensors, scale va da 0 a 4 (1 di default). Caricare LoRA non cambia il prezzo. al massimo 3 elementi
Controllo di sicurezzaDisattivato

SpicyAPI non applica nessun controllo di sicurezza a questo modello. Il tuo prompt e i tuoi media arrivano al modello così come li hai scritti, ed è il modello stesso a decidere che cosa torna indietro.

Controllo del tuo account prima di abilitare invio e prezzi.

Output

Pronto per una nuova esecuzione
Risultato di esempio

Manca il modello che ti serve?

Dicci cosa aggiungere e dove lo useresti. Le richieste arrivano a chi decide quali modelli integrare per primi.

API VIDEO LORA

L’API di Wan 2.1 LoRA in sintesi

Wan 2.1 con i tuoi LoRA: scrivi una scena, anima una foto o cambia lo stile a una clip, da 5 o 10 secondi, senza filtro sui contenuti.

LoRA per chiamata
3
Fino a tre file di pesi per richiesta, ciascuno con la propria intensità da 0 a 4.
LoRA compatibili
2.1, 2.2
I LoRA Wan 2.1 14B si caricano e, nelle nostre prove, anche i LoRA Wan 2.2 a file unico e a basso rumore hanno cambiato il risultato.
Modi di partire
3
Un prompt, una foto iniziale o una clip tua a cui cambiare stile.
Durata della clip
5 / 10 s
Due durate; una clip da 10 secondi costa una volta e mezza una da 5 secondi.
Risoluzione massima
720p
480p o 720p; testo in video in 16:9 o 9:16, foto e clip mantengono la propria forma.
Filtro sui contenuti
Nessuno
Senza censura: nessuna revisione dei tuoi LoRA e nessun filtro sul risultato.

Risultati

Cosa puoi creare con Wan 2.1 LoRA

  • LoRA di camera

    Il movimento di camera viene dal LoRA

    Un LoRA orbitale a 360 gradi addestrato per Wan 2.1 da immagine a video, con la sua frase trigger nel prompt. Senza di esso, con lo stesso seed, la camera restava ferma; con il LoRA l’inquadratura le gira intorno fino a posizionarsi alle sue spalle, verso il canale.

    Immagine in video con un LoRA orbitale a 360 gradi a 1, 720p, cinque secondi.

  • LoRA di stile

    Entra la ripresa dal vivo, esce l’animazione

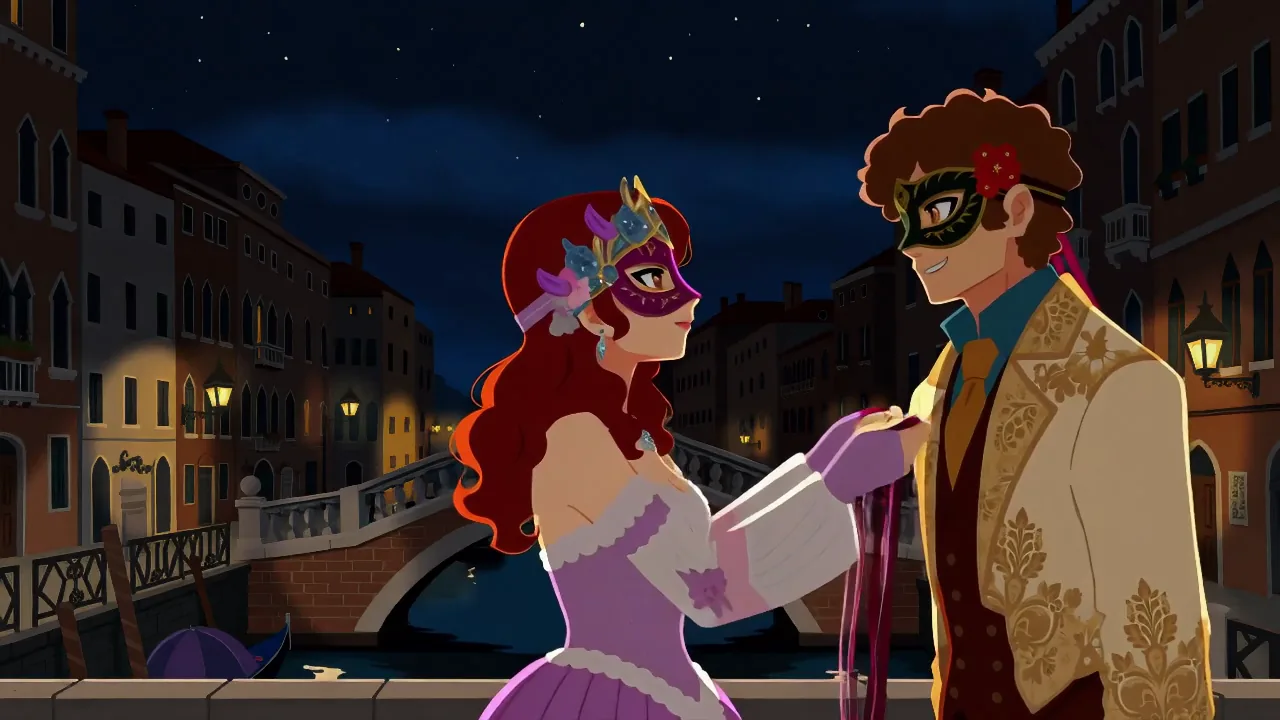
    Stesso prompt, stesso seed: senza il LoRA una coppia ripresa dal vivo sul ponte, con un LoRA a colori piatti a scale 1 un’animazione in cel shading dello stesso momento.

    Testo in video con un LoRA di stile a colori piatti a 1, 720p, 16:9.

  • Immagine in video

    Momenti ravvicinati da un’immagine fissa

    Nessun LoRA: due donne su una scalinata illuminata da lanterne, una che solleva la maschera dell’altra. La luce e i tessuti della foto reggono durante il lento avvicinamento.

    Immagine in video senza LoRA, 720p, cinque secondi.

Altre clip create con Wan 2.1 LoRA

  • 5 s
  • Testo in video senza LoRA, 720p, 16:9, cinque secondi.
    5 s
  • Video in video senza LoRA, 480p, intensità 0,9, cinque secondi.
    5 s
  • Immagine in video con un LoRA dolly effect a 1, 720p, foto verticale.
    5 s
  • Testo in video senza LoRA, 480p, 16:9, dieci secondi.
    10 s
  • Video in video con un LoRA a colori piatti a 1, 480p, sorgente verticale.
    5 s

Test dei contenuti

Wan 2.1 LoRA è senza censura? Cosa abbiamo testato

Abbiamo eseguito ogni livello sulla nostra configurazione reale e controllato ogni clip fotogramma per fotogramma. Superato significa che il contenuto era davvero sullo schermo, non solo che la richiesta è passata.

Livelli di contenuto testati su Wan 2.1 LoRA, per modalità
LivelloDa immagine a videoDa testo a videoEditing video
LieveI prompt più leggeri della prova
GeneratoTestato il 9 ott 2026
ModeratoDove i modelli con filtro iniziano a rifiutare
GeneratoTestato il 9 ott 2026
ForteLa metà della scala
GeneratoTestato il 9 ott 2026
Molto forteDove la maggior parte dei modelli comincia a frenare
Non ancora testato
Non ancora testato
Non ancora testato
MassimoIl vertice della scala
Non ancora testato
Non ancora testato
Non ancora testato

Generato: sullo schermo come scritto. Attenuato: generato, ma più tenue di quanto scritto. Rifiutato: respinto. Non ancora testato: non abbiamo ancora provato quel livello in quella modalità.

Come si comporta ogni modalità

Tutte le modalità
Solo 5 e 10 secondi, e le clip non hanno traccia audio. Le LoRA devono essere link diretti pubblici a file .safetensors, al massimo tre per richiesta; un file protetto, un link a una pagina o una LoRA per un modello non correlato fa fallire la richiesta, che non viene addebitata. Senza una LoRA senza filtro, le richieste più forti tornano attenuate: il contenuto di livello Forte viene disegnato e il livello Molto forte viene attenuato.
Da testo a video
Solo due forme: 16:9 e 9:16.
Da immagine a video
La clip mantiene la forma della tua foto; non c’è una proporzione da scegliere. Il modello resta vicino a ciò che mostra la foto, quindi gli abiti presenti nella foto tendono a restare, a meno che il prompt non chieda chiaramente un cambiamento.
Editing video
Il risultato non è mai più lungo della sorgente, e l’opzione da 10 secondi viene fatturata alla tariffa dei 10 secondi anche per una sorgente più corta. video_url deve puntare a un video: il link a un’immagine non viene rifiutato, restituisce una clip di un solo fotogramma che viene comunque fatturata. Sotto un’intensità di circa 0,6 la sorgente torna quasi invariata.

Casi d’uso

Cosa costruire con l’API di Wan 2.1 LoRA

  • Un personaggio, molte clip

    Carica lo stesso LoRA di personaggio o di stile a ogni richiesta e una serie mantiene lo stesso volto e lo stesso look tra le scene.

  • Movimenti di camera su un’immagine fissa

    I LoRA di camera addestrati per Wan 2.1 da immagine a video aggiungono il movimento a una foto; nel nostro esempio un LoRA orbitale girava intorno a una donna sulla loggia di un palazzo.

  • Cambia stile ai filmati che hai già

    Il video in video mantiene movimento e tempi della tua clip e cambia persone, abiti, ambientazione e luce in base al prompt; nelle nostre prove il risultato è rimasto fotografico.

  • LoRA della community senza censura

    Le LoRA di personaggi e stili senza filtro si caricano come qualsiasi altro file: nessuna lista di ammessi, nessuna revisione, nessun filtro sul risultato. Tutte le persone in scena devono essere adulte.

Prompt

Esempi di prompt per Wan 2.1 LoRA da copiare

Incollane uno così com’è nel playground, poi cambia una cosa alla volta.

  • Da testo a video

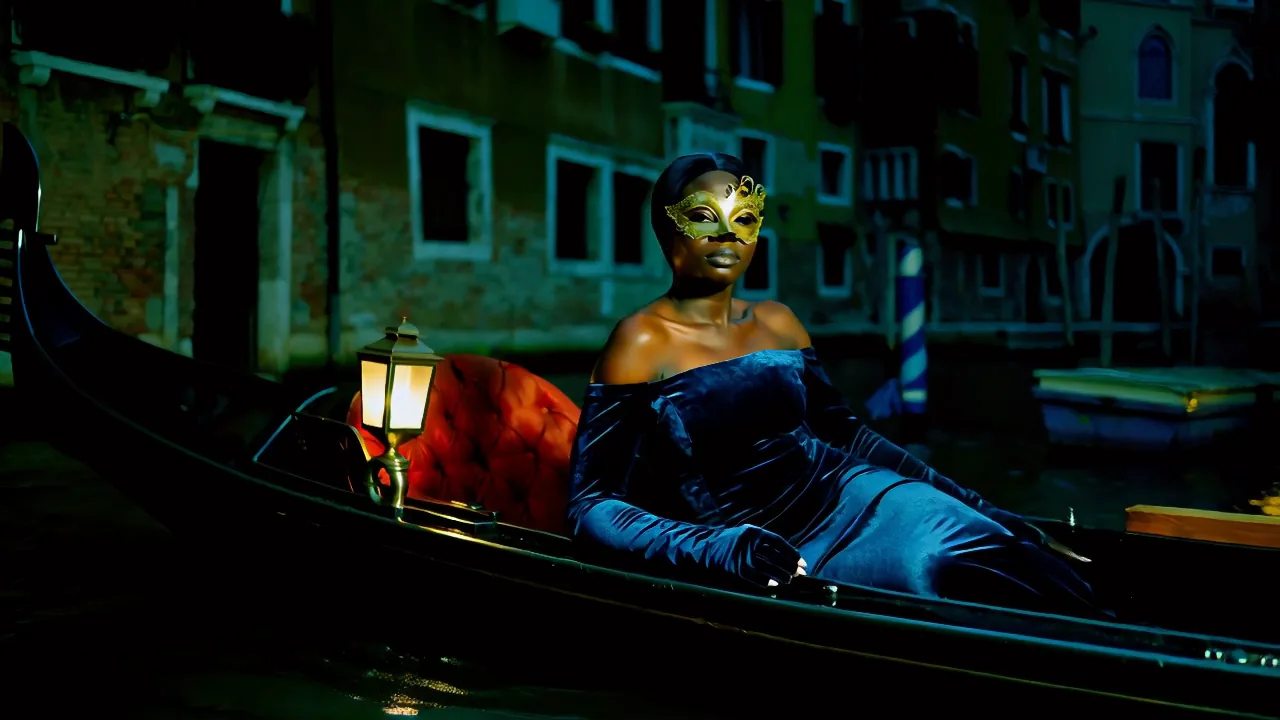
    Maschera di velluto su una gondola

    Risultato di questo prompt

    Night in Venice during carnival. An adult Black woman in her early thirties in a midnight-blue velvet gown with bare shoulders and a gold filigree half-mask reclines on the cushioned seat of a gondola gliding slowly down a narrow canal. Lanterns on striped mooring poles slide past and their light ripples across the black water and her skin. She lifts the mask away from her face, turns her head toward the camera and holds a slow, smouldering gaze. Slow tracking shot alongside the gondola, 35mm, shallow depth of field, warm amber against deep teal, fine film grain.

    Perché funziona. Nessun LoRA, il solo modello base a 720p. Una ripresa in movimento accanto alla gondola; lei tiene la camera con uno sguardo lungo mentre le lanterne scorrono. Il prompt le chiedeva anche di sollevare la maschera e lei l’ha tenuta addosso, quindi metti per prima l’unica azione che ti serve e mantienila semplice.

  • Da immagine a video

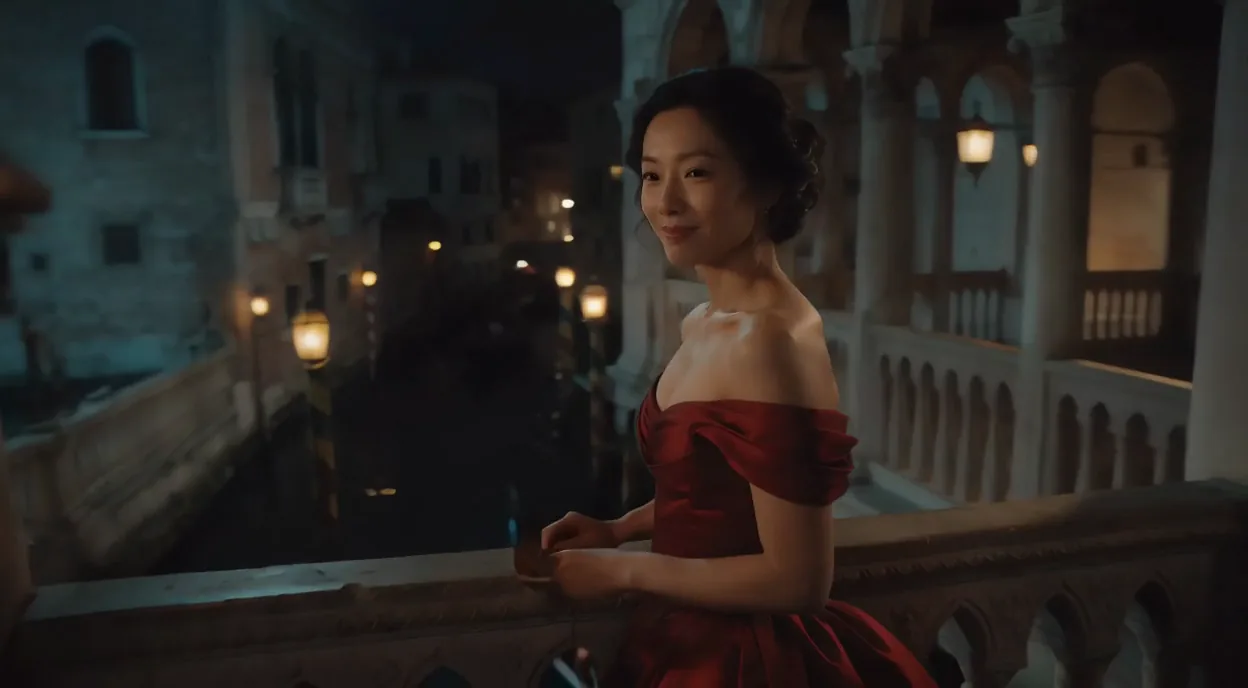
    Girando attorno a un ospite mascherato sulla loggia

    Risultato di questo prompt

    The woman in the crimson gown slowly lowers the gilded mask from her face and turns toward the canal, then back to the camera with a quiet, alluring smile; a gondola glides by below. The camera performs an 0rb4it 360 degree orbit, circling around her on the loggia with the lanterns and the canal sweeping past behind her. Warm lantern light, cinematic.

    Perché funziona. Un LoRA orbitale a 360 gradi per Wan 2.1 da immagine a video a 1, con la sua frase trigger nel prompt. Senza il LoRA (stessa foto, stesso seed) la camera restava ferma e lei si limitava a girare la testa; con il LoRA la camera le gira intorno fino a posizionarsi alle sue spalle, verso il canale.

    Questa modalità parte dalla tua immagine: aggiungila nel playground prima di avviare.

  • Da testo a video

    Nastri a colori piatti sul ponte

    Risultato di questo prompt

    flat color, no lineart. Masquerade night in Venice: an adult East Asian woman in a lilac satin gown and an adult white man with curly red hair in a cream brocade coat stand close on a small arched stone bridge over a lantern-lit canal, both wearing ornate half-masks. She reaches up and slowly unties the ribbon of his mask; he smiles and leans in until their foreheads almost touch. Lanterns sway, gentle mist drifts on the water. Slow push-in.

    Perché funziona. Un LoRA a colori piatti per Wan 2.1 a 1 con le sue parole trigger. Lo stesso prompt e lo stesso seed senza il LoRA sono tornati come un filmato dal vivo della coppia; con il LoRA il momento è un’animazione in cel shading, e lei scioglie il nastro della maschera di lui finché le loro fronti si toccano.

Prezzi

Prezzi dell’API di Wan 2.1 LoRA

Da $0.24 per richiesta.

Il Playground mostra il prezzo esatto per le tue impostazioni prima dell’avvio. Le attività fallite o scadute di norma non vengono addebitate. Alcuni modelli addebitano i rifiuti dei contenuti come indicato nella loro pagina; verifica queste condizioni di fatturazione prima dell’invio.

Vedi tutte le fasce di prezzo

Per iniziare

Come usare l’API di Wan 2.1 LoRA in tre passaggi

  1. Passaggio 1

    Collega il file, non la pagina

    Usa un link pubblico che scarichi direttamente il file .safetensors, come un link Hugging Face "resolve/main". La pagina di un repository, un file dietro un login o un link Civitai che rimanda all’accesso fanno fallire la richiesta, e le richieste fallite non vengono addebitate.

  2. Passaggio 2

    Abbina il modello base

    Scegli LoRA addestrati per Wan 2.1 14B: LoRA da testo a video, oppure LoRA per i checkpoint da immagine a video a 480P e 720P. Nelle nostre prove hanno avuto effetto anche i LoRA Wan 2.2. Un LoRA fatto per un modello non correlato, come un modello di immagini, fa fallire la richiesta.

  3. Passaggio 3

    Valuta un LoRA con l’immagine in video

    Nella nostra prova l’immagine in video ha restituito una clip identica byte per byte con lo stesso seed e gli stessi input, quindi un’esecuzione con loras vuoto e una con il tuo LoRA mostrano esattamente cosa fa il LoRA. Nelle nostre esecuzioni 0,5 spostava già il risultato e 1 lo spostava di più.

Riferimento dei parametri ed esempi di codice sono nelle schede API e Readme, in cima a questa pagina.

Perché SpicyAPI

Perché usare Wan 2.1 LoRA su SpicyAPI

  • Nessun filtro da parte nostra

    Non aggiungiamo alcun filtro dei contenuti. Quello che il modello genera è quello che ricevi.

  • Testato, non ipotizzato

    I livelli di contenuto vengono da generazioni reali che abbiamo eseguito e controllato, con la data del test sulla pagina.

  • Paghi a risultato, in dollari

    Nessun abbonamento e nessun credito. Le attività fallite o scadute di norma non vengono addebitate. Alcuni modelli addebitano i rifiuti dei contenuti come indicato nella loro pagina; verifica queste condizioni di fatturazione prima dell’invio.

  • Una chiave per tutti i modelli

    Una sola chiave API e un unico saldo coprono i modelli di immagini, video, audio e chat, così puoi esplorare più modelli dallo stesso account.

FAQ

Domande frequenti sull’API di Wan 2.1 LoRA

Informazioni su Wan 2.1 LoRA

Wan 2.1 LoRA è il modello video aperto da 14B di Alibaba con spazio per i tuoi pesi: fino a tre file LoRA per richiesta, ciascuno con un’intensità da 0 a 4, su testo in video, immagine in video e video in video. Le clip durano 5 o 10 secondi a 480p o 720p, con passi, guidance e flow shift aperti. I LoRA non vengono revisionati e nulla viene filtrato.

Tutti i modelli Wan22

Modelli video18

Modelli correlati e attività successive