Introduzione
FLUX.1 Dev LoRA Testo in immagine crea un’immagine da un prompt scritto con FLUX.1 [dev] di Black Forest Labs, un rectified flow transformer da 12 miliardi di parametri, con fino a tre file LoRA tuoi caricati. Scegli uno dei nove formati a circa un megapixel, imposta la guidance e ricevi JPEG, PNG o WebP a un unico prezzo fisso. La piattaforma non aggiunge alcun filtro sui contenuti a prompt, pesi o immagine.
Scegli la modalità in base al materiale di partenza
| Materiale di partenza | Modalità |
|---|---|
| una descrizione scritta e un LoRA per FLUX | FLUX.1 Dev LoRA Testo in immagine |
| un’immagine a cui dare un nuovo stile | FLUX.1 Dev LoRA Modifica immagine |
Caratteristiche principali
La più grande libreria di LoRA tra i modelli di immagini aperti
Hugging Face elenca oltre mille LoRA basati su FLUX.1 [dev]: realismo, moda, look da pellicola, cartoni, personaggi e stili senza filtri. Se hai trovato un look che ti piace, è molto probabile che sia un LoRA per FLUX, e qui gira come una semplice chiamata API.
Guidance regolabile
La guidance stabilisce quanto rigorosamente l’immagine segue il prompt, da 0 a 20. Il default 3,5 va bene per la maggior parte dei LoRA, e i LoRA di realismo spesso rendono in modo più naturale un po’ più in basso.
Senza censura con i tuoi pesi
I pesi non vengono mai revisionati e l’output non viene mai filtrato. Nei nostri test i LoRA senza filtri sono stati resi, ma al livello più alto che abbiamo testato il modello ha trattenuto parte della scena in tutti e tre i tentativi.
Parametri della richiesta
| Parametro | Obbligatorio | Nota |
|---|---|---|
prompt | Sì | Inizia con la frase trigger del LoRA, poi descrivi soggetto, ambientazione e luce con frasi complete. FLUX segue bene i prompt lunghi e specifici. almeno 1 caratteri · al massimo 5000 caratteri |
aspect_ratio | No | Nove opzioni da 21:9 a 9:21, tutte a circa un megapixel e tutte allo stesso prezzo. |
loras | No | Fino a tre voci {path, scale} addestrate per FLUX.1 [dev]; scale da 0 a 4, 1 è neutro. I LoRA di stile più forti possono richiedere un po’ più di 1. Predefinito: |
guidance_scale | No | Quanto rigorosamente seguire il prompt, da 0 a 20. Il default 3,5 va bene per la maggior parte dei LoRA; i LoRA di realismo spesso rendono meglio un po’ più in basso. |
steps | No | Passi di denoising, da 1 a 50 (predefinito 28). Più passi richiedono più tempo. |
output_format | No | JPEG di default, PNG o WebP se ti servono. Non cambia il prezzo. |
seed | No | Mantiene confrontabile una serie di immagini mentre regoli la guidance o lo scale di un LoRA. |
Prezzi
$0.018 / immagine
Addebitato per immagine a un unico prezzo fisso per ogni formato. Caricare LoRA non comporta costi aggiuntivi.
Casi d’uso
Usa un LoRA che hai trovato
Incolla il link di download, imposta lo scale, aggiungi la frase trigger al prompt. Niente addestramento, niente hosting e nessuna GPU: il LoRA che hai visto su un hub di modelli diventa una semplice chiamata API.
Immagini editoriali e di moda
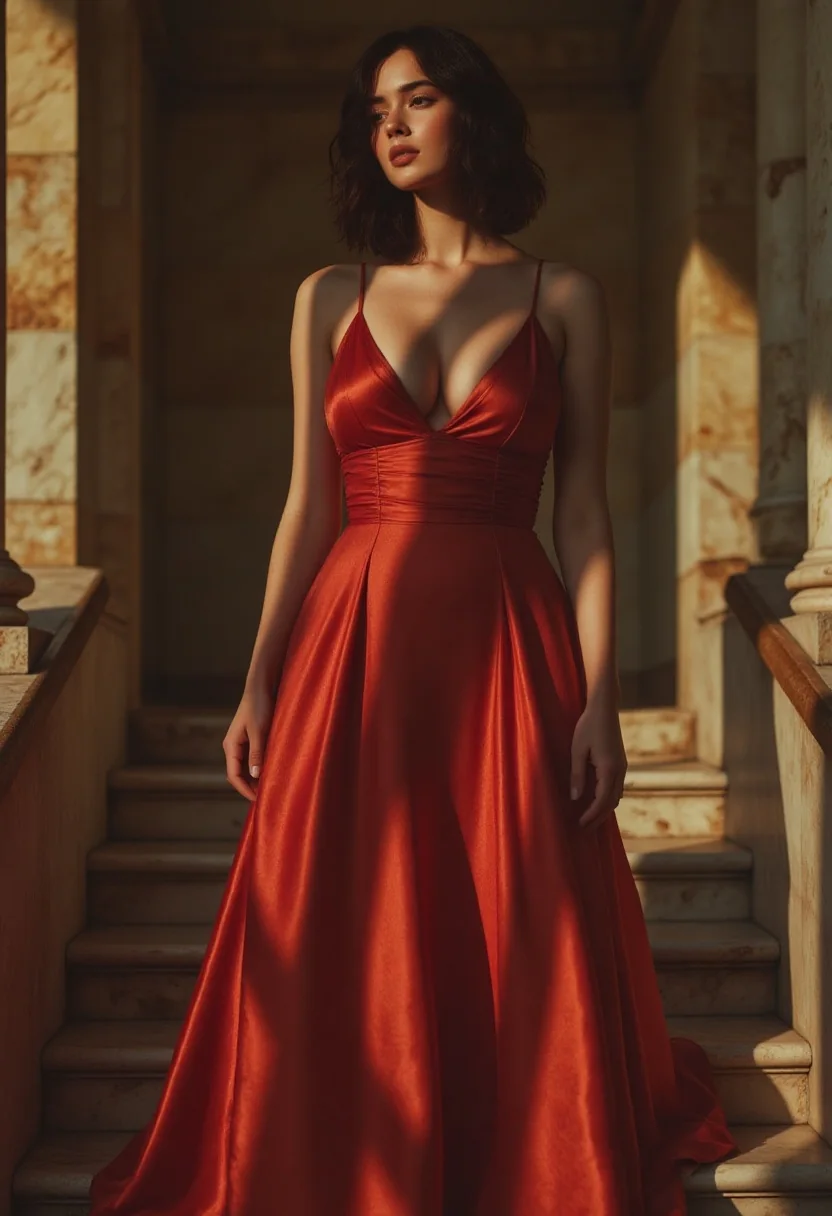
I LoRA di realismo e in stile rivista danno luce, tessuti e pelle credibili ad abiti da sera, ritratti e scene notturne, pronti per moodboard e bozze di campagna.
Serie stilizzate
I LoRA cartoon e di illustrazione mantengono un’intera serie in un unico look in nove formati, dai post quadrati ai banner larghi.
Consigli avanzati
Prima il trigger, poi frasi complete
FLUX legge bene i prompt lunghi. Inizia con la frase trigger presa dalla scheda del modello del LoRA, poi descrivi soggetto, ambientazione, abiti e luce con frasi complete invece di un elenco di tag.
Guidance più bassa per il realismo
Se un LoRA di realismo sembra cereo o troppo nitido, abbassa la guidance da 3,5 verso 2,5 e confronta con lo stesso seed. Una guidance più alta segue il prompt più alla lettera, ma a scapito della texture naturale.
Alza gli stili deboli un passo alla volta
Quando uno stile si vede appena, alza il suo scale di 0,2. Il nostro esempio cartoon ha avuto bisogno di 1,2. Con scale alti controlla bene volti e mani: sono le prime cose a deformarsi.
Niente testo sulle insegne
FLUX tende a scrivere parole su qualsiasi insegna o schermo presente nell’inquadratura, e spesso con errori di ortografia. Lascia le insegne fuori dal prompt, a meno che il testo esatto non sia importante.
Avvio rapido dell’API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "black-forest-labs/flux-1-dev-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "output_format": "jpeg",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Nel riferimento dell’API trovi autenticazione, schema completo, polling e gestione degli errori.