Introduzione
OmniHuman 2.0 Talking avatar è il modello avatar guidato dall'audio di ByteDance. Invii un ritratto (image_url) e un file audio di parlato o canto (audio_url), e ricevi un video 720p di quella persona che esegue l'audio: viso, labbra, testa e busto si muovono insieme, invece di lasciare il torso fermo. La clip dura quanto l'audio, da 4 a 300 secondi. Non c'è un campo per durata, risoluzione o proporzioni. Un prompt opzionale di fino a 300 caratteri dirige atmosfera, gesti, dove guardano gli occhi e, secondo l'editore, il movimento di camera.
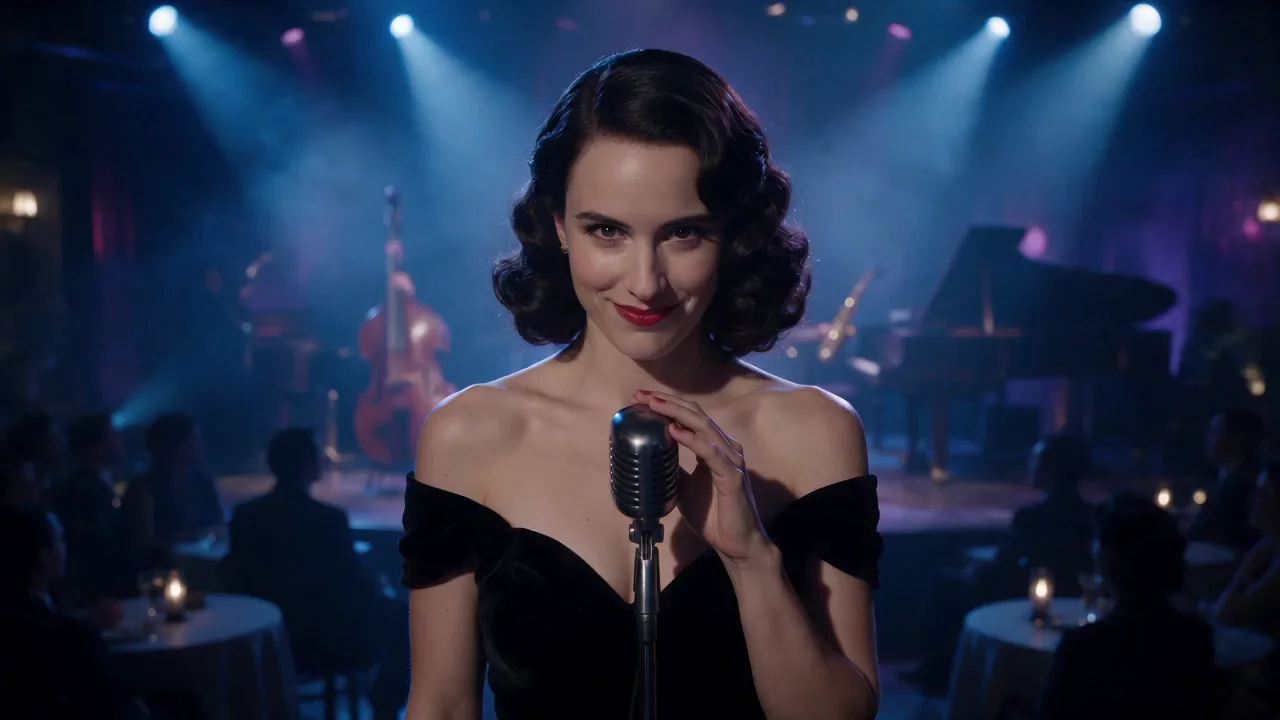
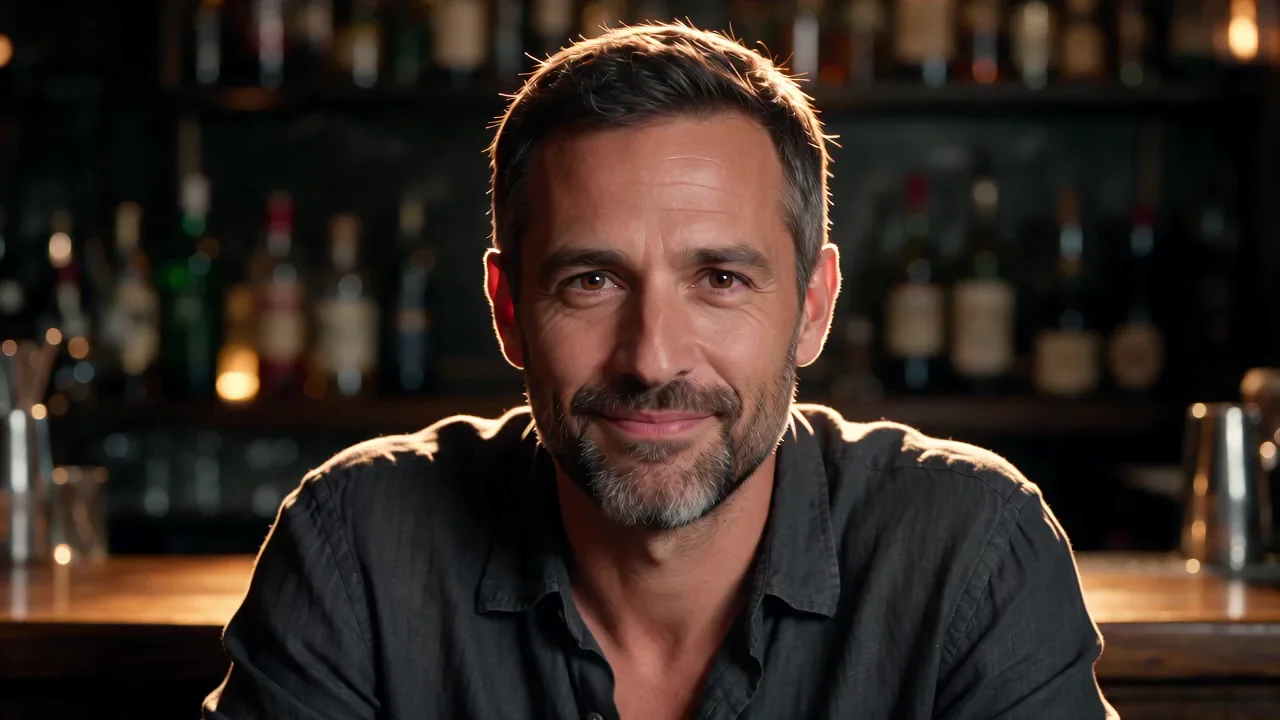
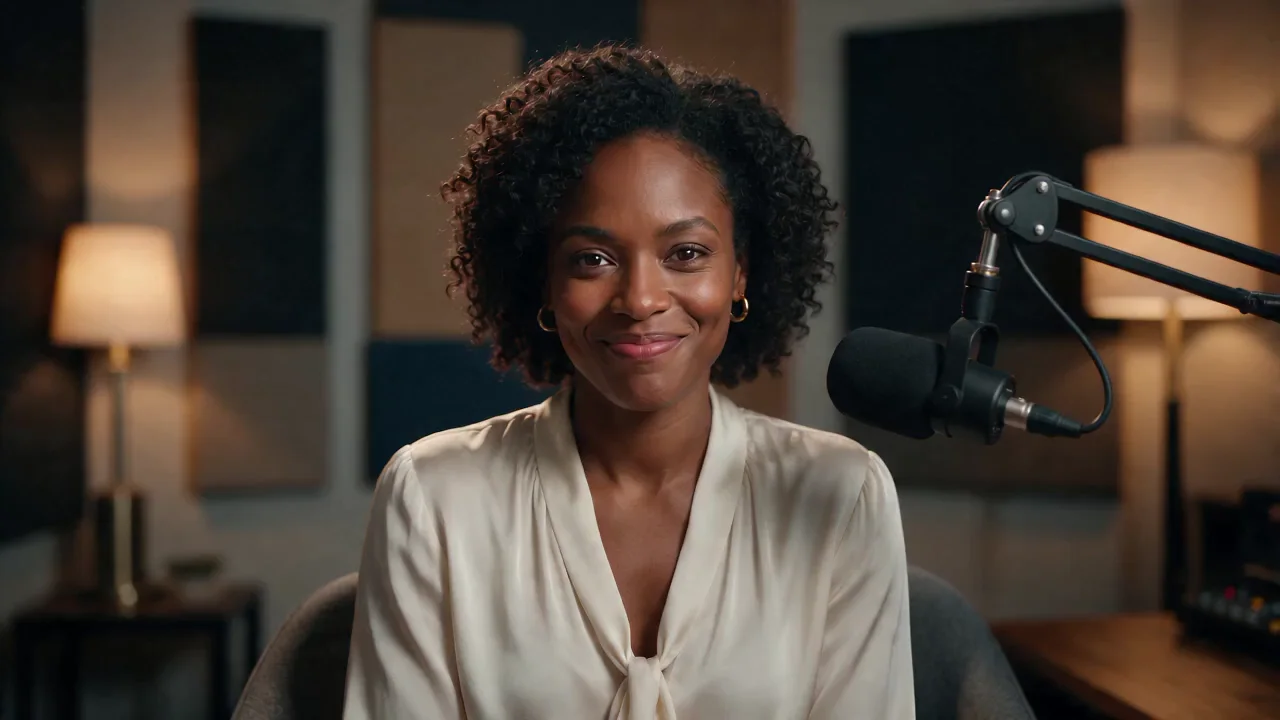
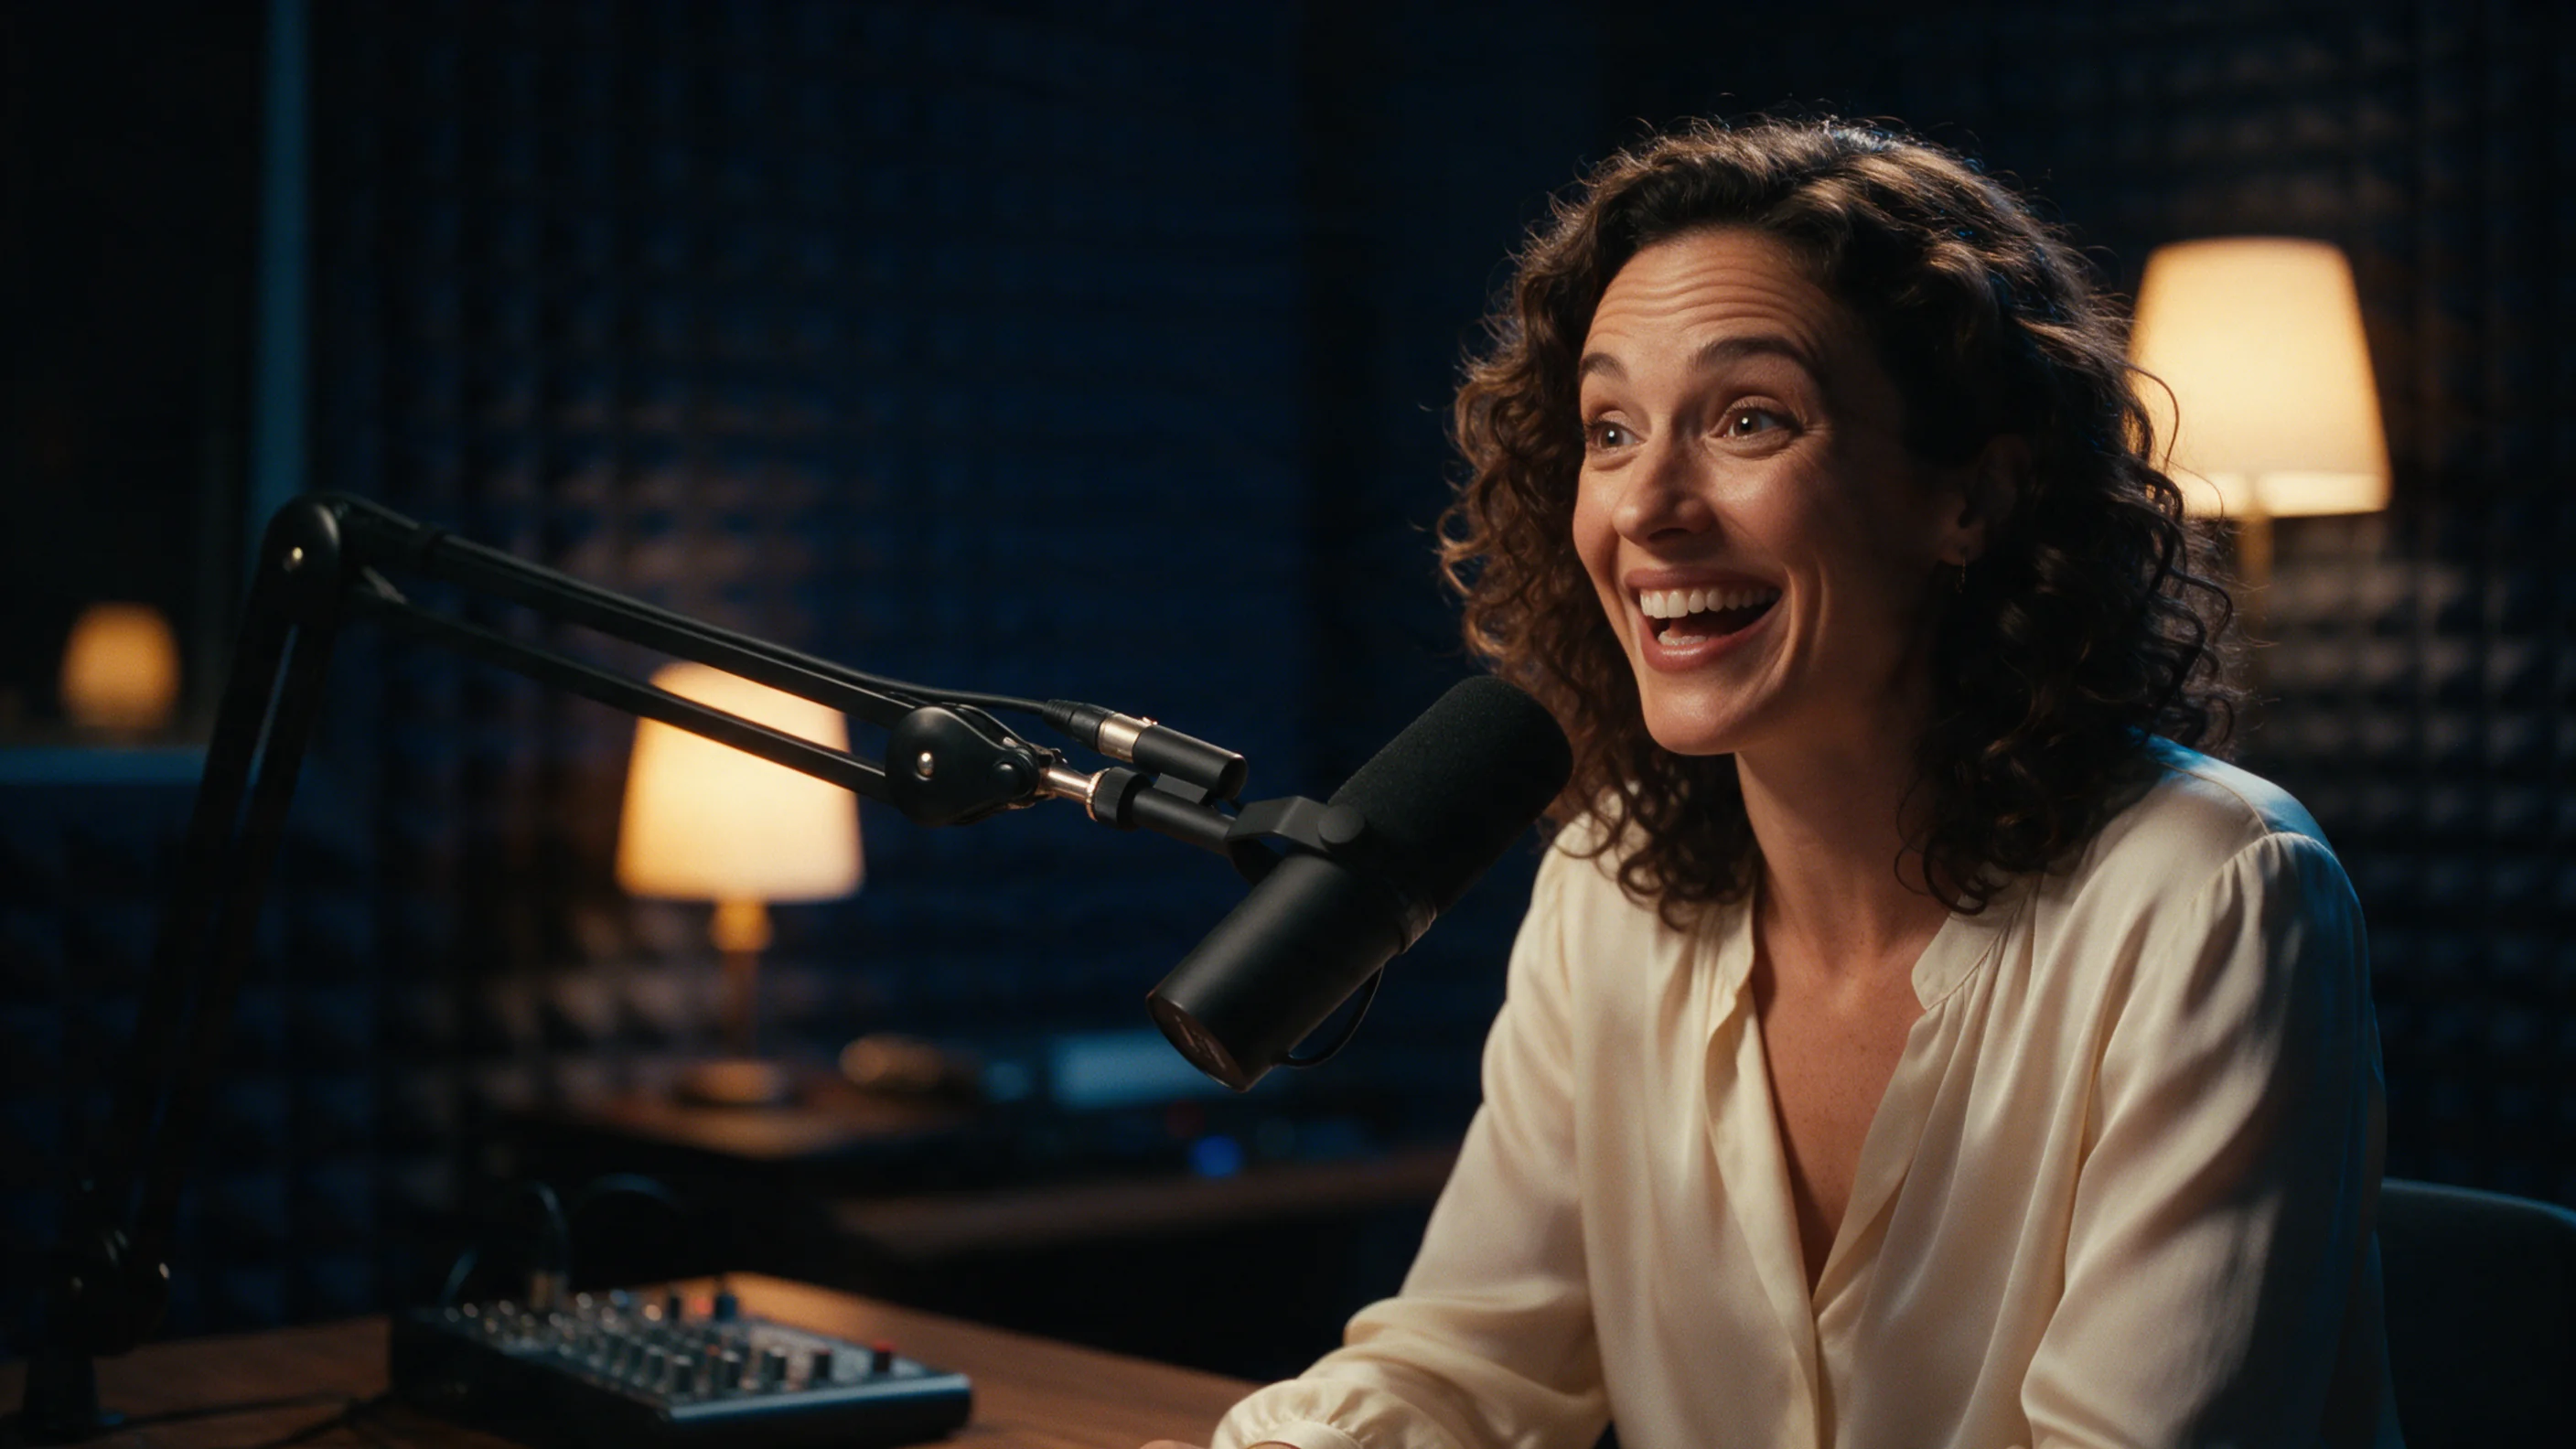
Tre dei quattro esempi di questa pagina (la cantante del supper club, il bancone del bar e lo show notturno) usano gli stessi ritratti e audio di Kling Avatar 2.0, tagliati a circa cinque secondi, così puoi confrontare le due pagine fianco a fianco.
Caratteristiche principali
L'audio imposta la durata
Taglia il tuo audio alla lunghezza che vuoi far durare la clip prima di inviarlo. L'audio più corto di 4 secondi o più lungo di 300 secondi viene rifiutato prima che venga addebitato qualsiasi importo. Nelle nostre prove la clip è tornata tra 0,2 e 1 secondo più lunga dell'audio, su un numero intero di secondi: 4,55 secondi di audio hanno dato una clip di 5 secondi, 5,2 secondi hanno dato una clip di 6 secondi. La fatturazione segue la durata dell'audio, non quella della clip finita.
Cosa abbiamo misurato
Abbiamo usato quattro ritratti, ciascuno con il proprio audio di 4,55-5,2 secondi e il proprio prompt di una riga. Tutti e quattro i ritratti erano 16:9. Ogni clip è tornata a 1280×720 e 24 fps con la traccia audio inclusa, e l'elaborazione ha richiesto circa due minuti per clip: da 110 a 133 secondi dall'invio al file finito. Confrontando i fotogrammi con il ritratto di partenza, il viso è rimasto riconoscibilmente la stessa persona in tutte e quattro le clip.
Labbra, espressione e gesto
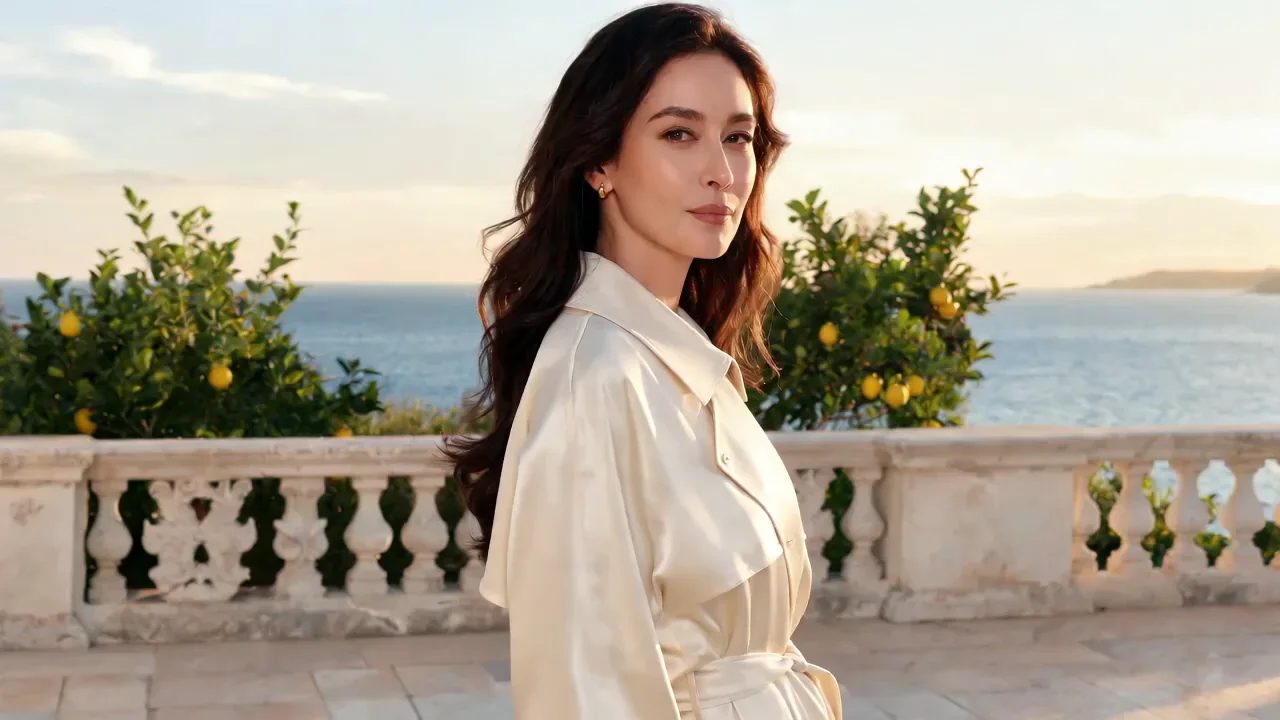
In tutte e quattro le clip le labbra hanno seguito l'audio. I prompt chiedevano piccoli gesti specifici, e la maggior parte si è vista: un sorriso e una leggera inclinazione della testa sull'ultima parola con la mano che resta sul microfono, un mezzo sorriso e un sopracciglio alzato con le bottiglie dietro il bancone stabili, la testa che si gira verso il mare nell'ultimo secondo, e una risatina con sopracciglia ampie sull'ultima parola. Una sola indicazione non si è vista in modo evidente: l'inclinazione verso il microfono nella clip dello show notturno.
Il prompt è facoltativo
Lascia prompt vuoto e il modello segue l'audio da solo. L'editore elenca come lingue del prompt cinese, inglese, giapponese, coreano, spagnolo (messicano) e indonesiano. I nostri quattro prompt erano in inglese e dirigevano espressione, gesti e dove guardano gli occhi; non abbiamo testato le indicazioni sul movimento di camera.
Cosa non abbiamo testato
L'editore elenca scene con più di una persona; non le abbiamo testate. Le nostre clip erano tutte di circa cinque secondi di audio, quindi non abbiamo testato una clip lunga vicina al massimo di 300 secondi, una canzone intera o ritratti che non sono 16:9.
Verifica dei contenuti
I ritratti che non superano la revisione dei contenuti di ByteDance vengono rifiutati, e non viene addebitato nulla. Uno dei nostri ritratti di prova è stato rifiutato così: nessuna clip, nessun addebito. Metti in conto che ogni richiesta passi da quella revisione.
Parametri della richiesta
| Parametro | Obbligatorio | Nota |
|---|---|---|
prompt | No | Opzionale, fino a 300 caratteri. Dirige atmosfera, gesti, dove guardano gli occhi e movimento di camera. al massimo 300 caratteri |
image_url | Sì | Ritratto da animare. JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC o HEIF, sotto 30 MB, da 300 a 6000 px per lato, con rapporto larghezza/altezza tra 0,4 e 2,5. |
audio_url | Sì | Parlato o canto, WAV o MP3, sotto 15 MB, da 4 a 300 secondi. |
Prezzi
$0.108 / secondo
Fatturato al secondo dell'audio in ingresso, con un minimo di 4 secondi e un massimo di 300 secondi; il blocco segue la durata dell'audio (o il massimo di 300 secondi quando non può essere letta) e la differenza viene rilasciata alla consegna. Le richieste fallite o rifiutate non vengono addebitate.
Casi d’uso
Dai un volto a una battuta registrata
Abbina una battuta registrata o generata a un ritratto per ottenere una clip di quella persona che la pronuncia: intro narrate, testimonianze o dialoghi per un personaggio di cui hai già definito il volto.
Brevi intro da conduttore e aperture a freddo
Una battuta di apertura brillante e giocosa, con un prompt che nomina l'atmosfera e un tempo sull'ultima parola, ci ha dato espressioni ampie, sopracciglia vivaci e una risata, come nell'esempio dello show notturno di questa pagina.
Una riga cantata da una foto ferma
L'editore elenca il canto accanto al parlato. Il nostro test includeva una riga lenta cantata/parlata di circa cinque secondi, davanti a un microfono vintage; non abbiamo ancora provato una canzone intera.
Foto dal telefono così come sono
Il ritratto può essere JPEG, PNG, WebP, BMP, TIFF, GIF, HEIC o HEIF, sotto 30 MB, quindi una foto scattata con il telefono può essere inviata senza doverla convertire prima.
Consigli avanzati
Lega un'espressione a un momento della battuta
«Un sorriso pigro sull'ultima parola» e «sguardo via alla fine» sono atterrati dove li abbiamo collocati: il sorriso e l'inclinazione della testa sono arrivati alla fine della clip del supper club, e la testa si è girata verso il mare nell'ultimo secondo della clip della terrazza. Nominare in quale punto della battuta deve avvenire il gesto dà al modello qualcosa su cui calcolare il tempismo.
Resta su pochi gesti
Ogni nostro prompt chiedeva un'atmosfera, uno o due gesti del viso e a volte una postura. Basta per dare forma a una clip di cinque secondi. Nelle nostre prove i gesti del viso hanno seguito il prompt più affidabilmente dei movimenti del corpo.
Non contare su un solo movimento del corpo
«Una leggera inclinazione verso il microfono» nel prompt dello show notturno non si è vista in modo evidente, mentre la risatina e le sopracciglia accanto sì. È l'osservazione di una sola prova, ma se un movimento del corpo ti è importante, genera una volta e verificalo prima di costruirci sopra.
Scegli il ritratto tenendo presenti i limiti
Larghezza e altezza devono essere ciascuna tra 300 e 6000 pixel, e il rapporto larghezza/altezza deve essere tra 0,4 e 2,5. Abbiamo testato solo ritratti 16:9.
Taglia l'audio sulla performance
La clip dura quanto l'audio e la fatturazione segue la durata dell'audio, quindi taglia il file sul parlato o sul canto che vuoi davvero. WAV o MP3, sotto 15 MB.
Avvio rapido dell’API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "bytedance/omnihuman-2.0/talking-avatar",
  "input": {
    "audio_url": "https://example.com/reference.mp3",
    "image_url": "https://example.com/reference.png",
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Nel riferimento dell’API trovi autenticazione, schema completo, polling e gestione degli errori.