
Il text-to-image Wan 2.7 di Alibaba usa un passaggio di ragionamento per pianificare la composizione prima di disegnare. Restituisce da una a quattro immagini per richiesta a circa 1 megapixel in sette proporzioni, con un seed per confronti stabili.
Il filtraggio cambia da un endpoint all’altro: Editing di immagini — Senza censura, Da testo a immagine — Attenuato.
Playground
Questi esempi sono stati scritti per questo endpoint. Sostituisci il prompt e gli URL dei media di esempio con input tuoi e raggiungibili, poi controlla il preventivo aggiornato e la disponibilità del modello prima di inviare.
 Output
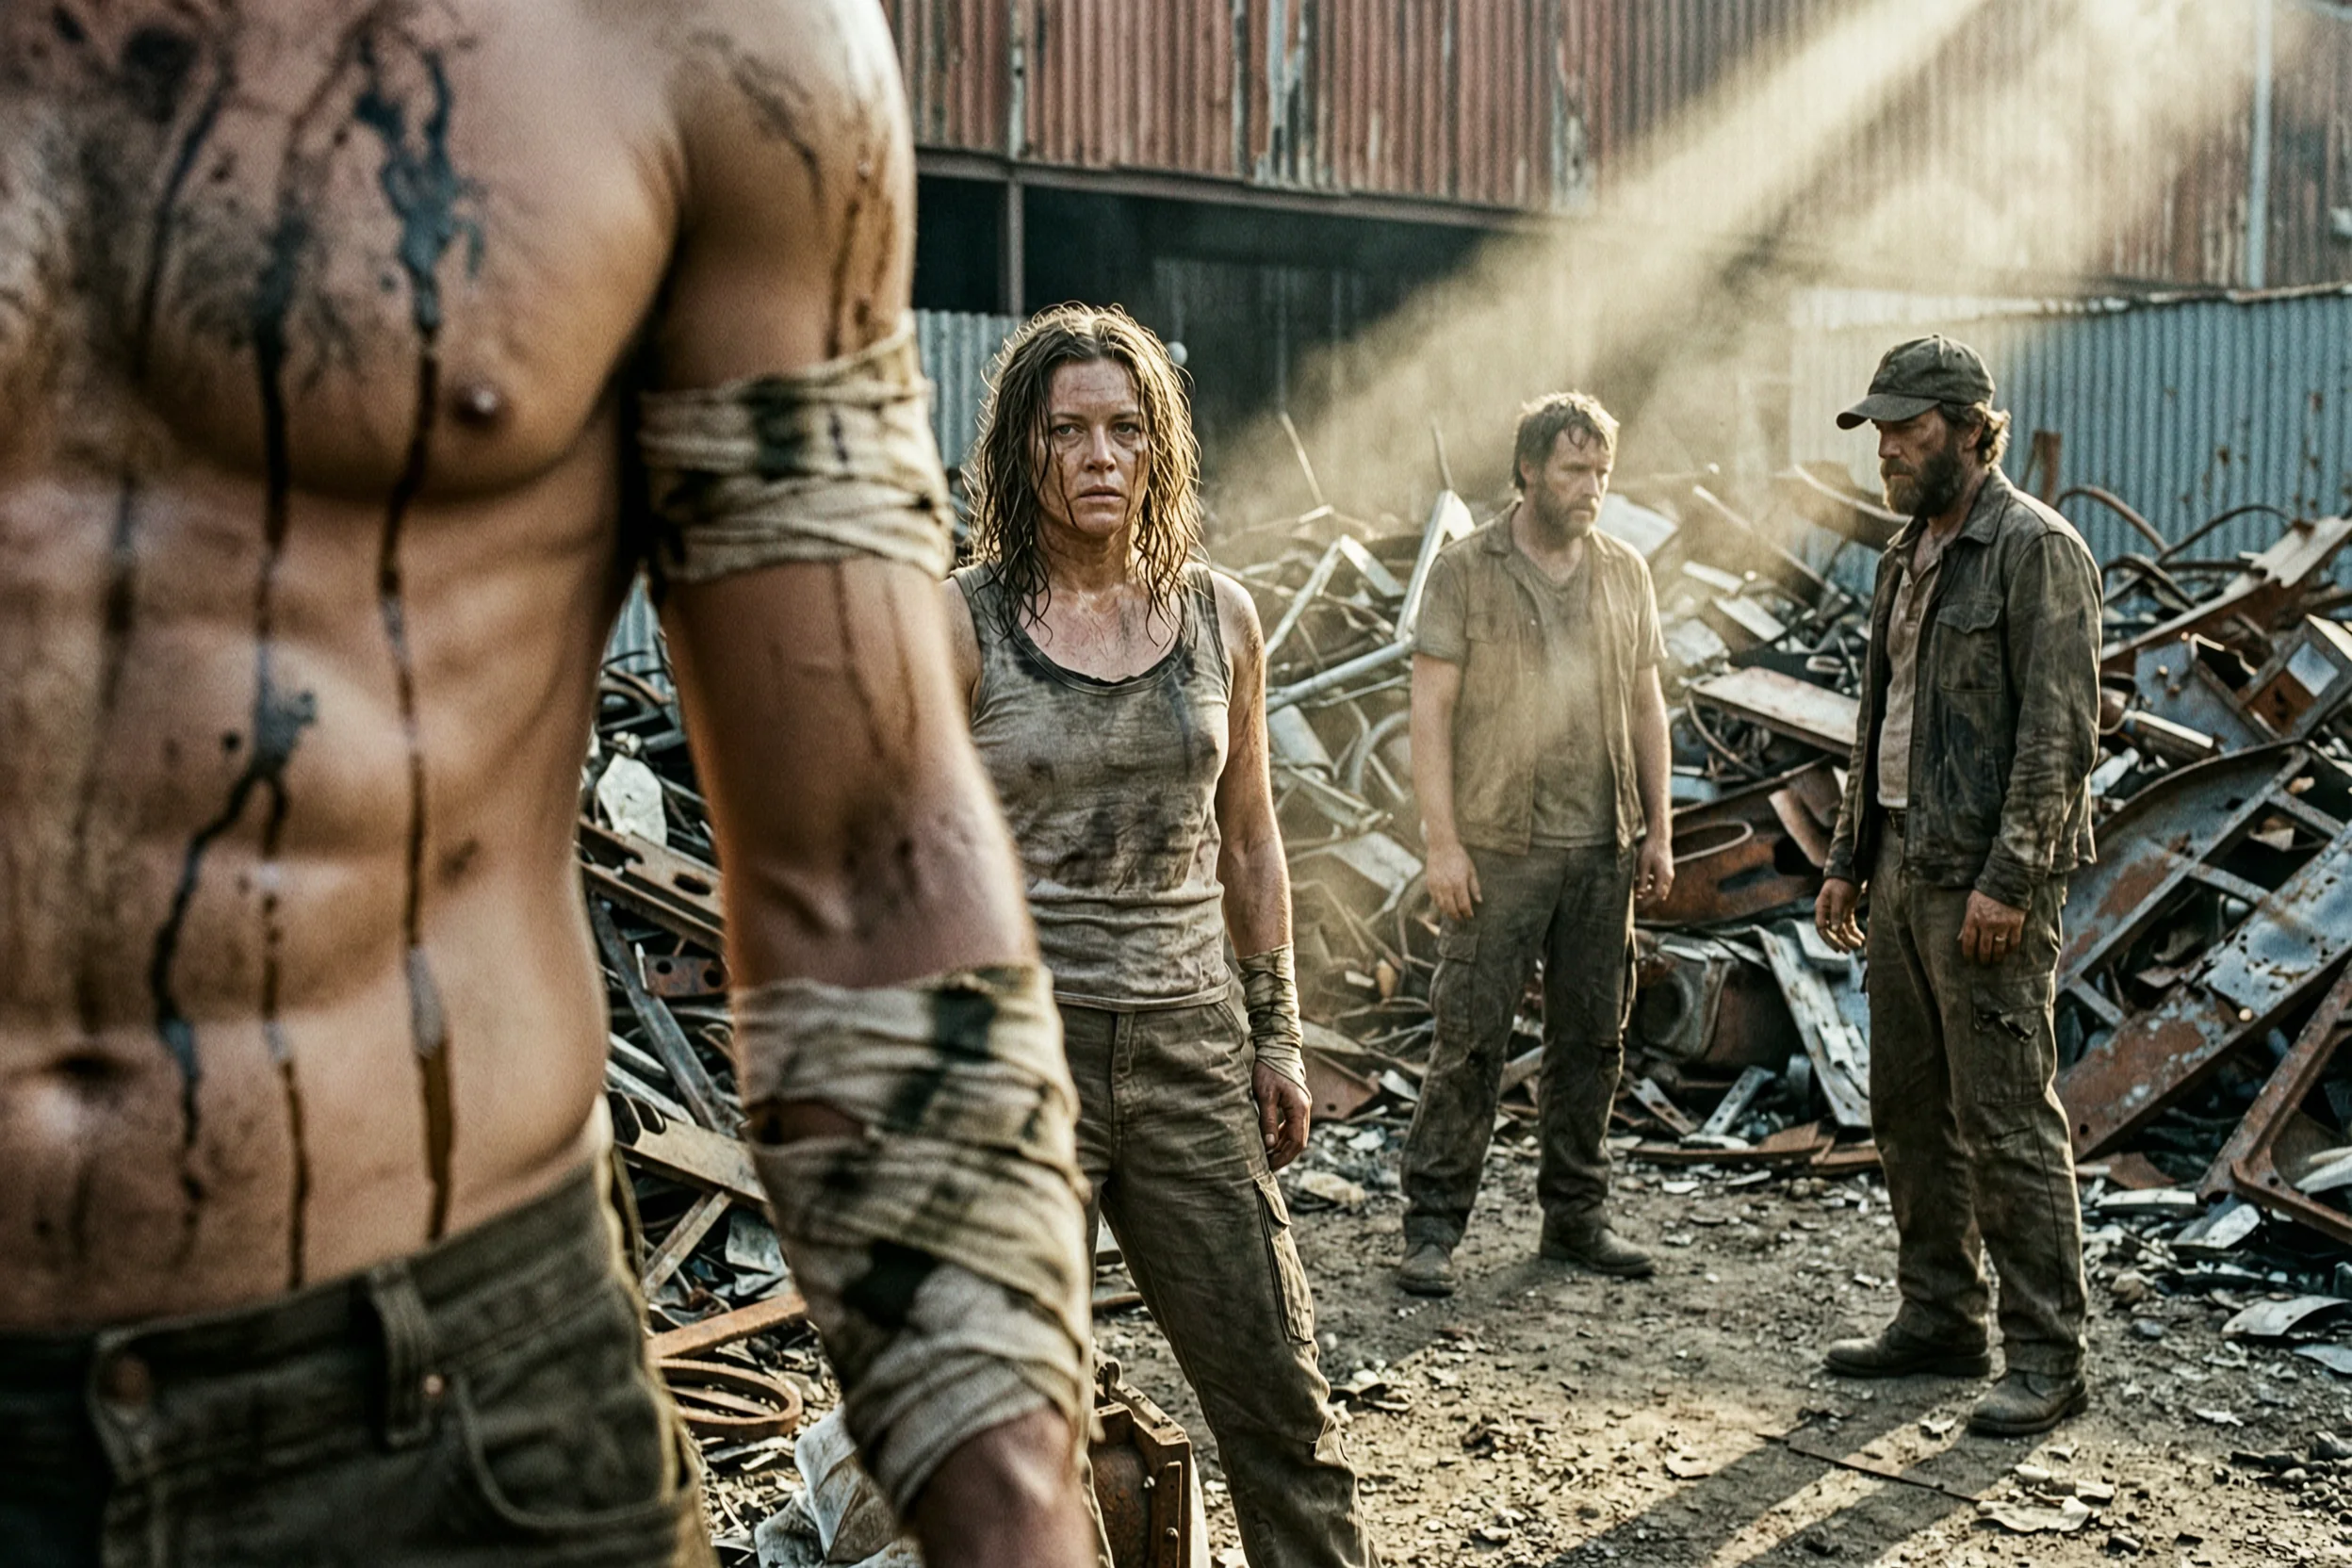
wasteland-three-depths Costruito per la passata di pianificazione che questo endpoint esegue prima di disegnare: tre figure collocate su tre piani di profondità distinti, la messa a fuoco tenuta su quella centrale e un fascio diagonale che le attraversa tutte. La scalatura in profondità è proprio ciò che salta quando una composizione viene assemblata avidamente dal primo piano verso il fondo: ci si ritrova tre soggetti alla stessa distanza. `resolution` è `2k` e `aspect_ratio` è `3:2`, abbastanza largo perché i piani si separino anche lateralmente.
- 2k
- 3:2
 Output
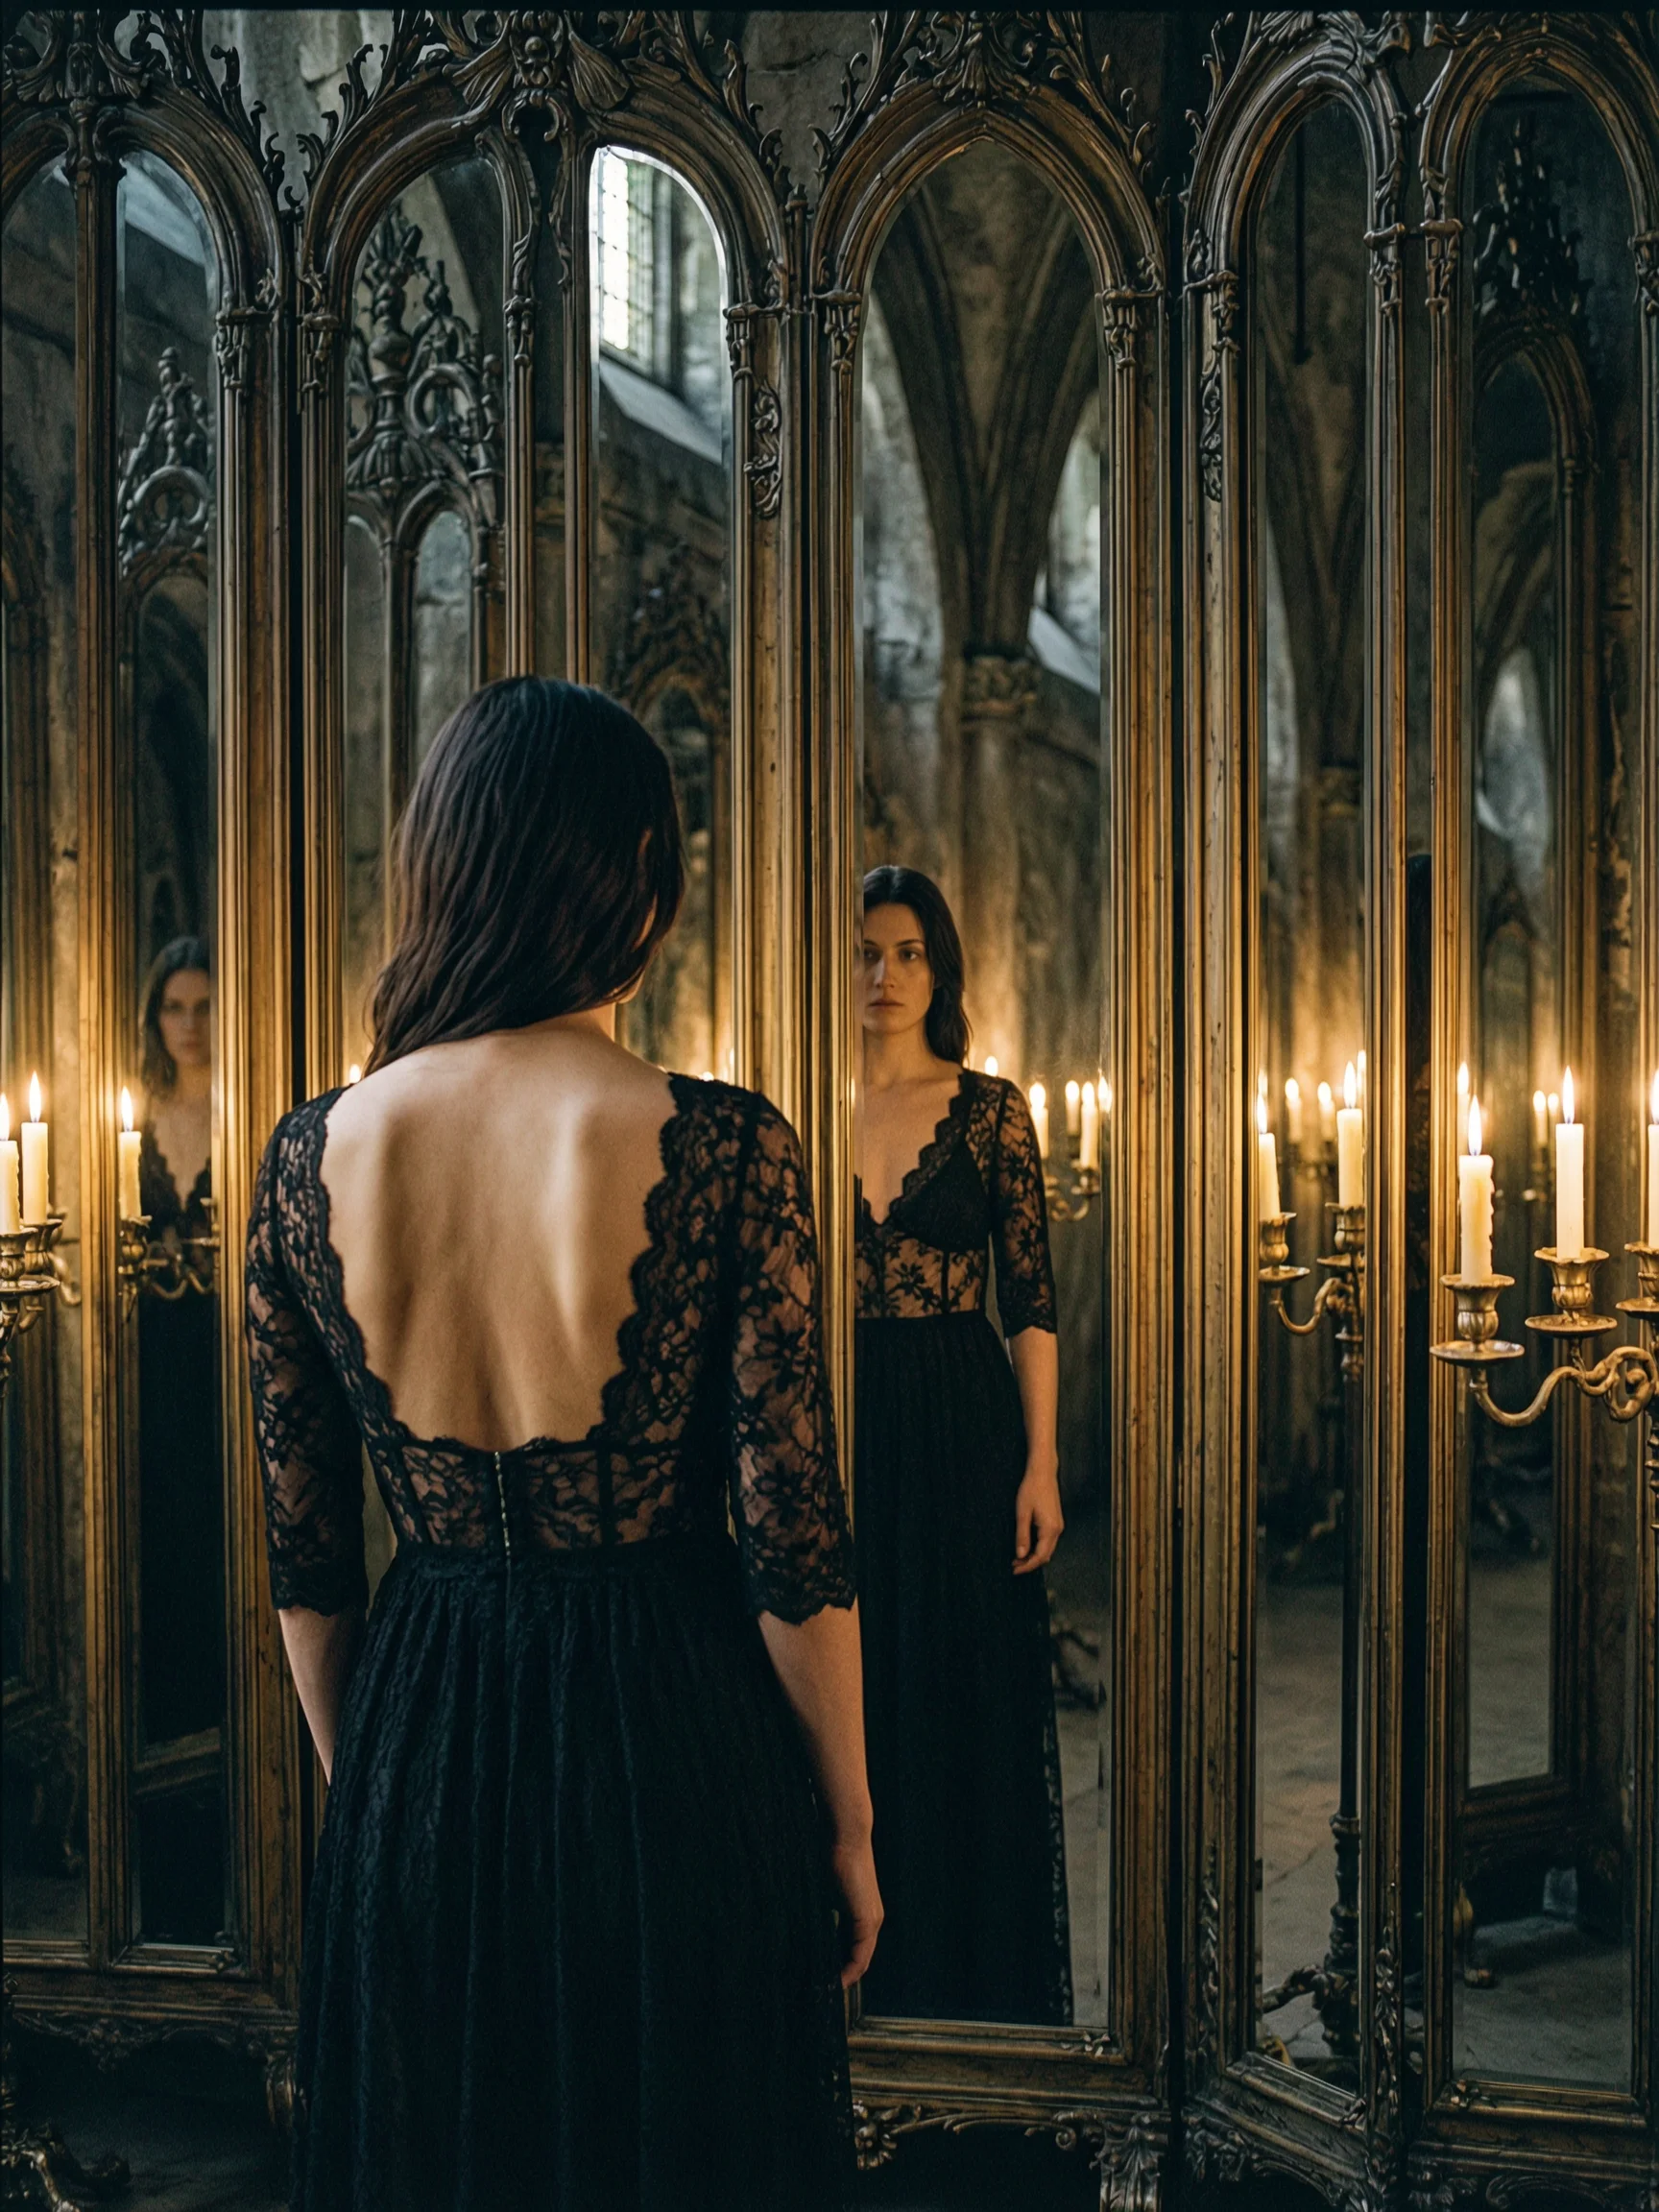
mirror-maze-second-figure Un rompicapo di riflessi più che di luce: una fuga di specchi in cui la seconda figura deve comparire solo al terzo riflesso, con la luce di candela sfalsata in modo diverso in ogni specchio. È un vincolo che il modello deve reggere su tutta l'immagine in una volta sola, ed è a questo che serve la passata di pianificazione. `resolution` è `2k` e `aspect_ratio` è `3:4` perché la fuga di specchi scenda in verticale. Contate gli specchi prima di giudicare il risultato.
- 2k
- 3:4
 Output
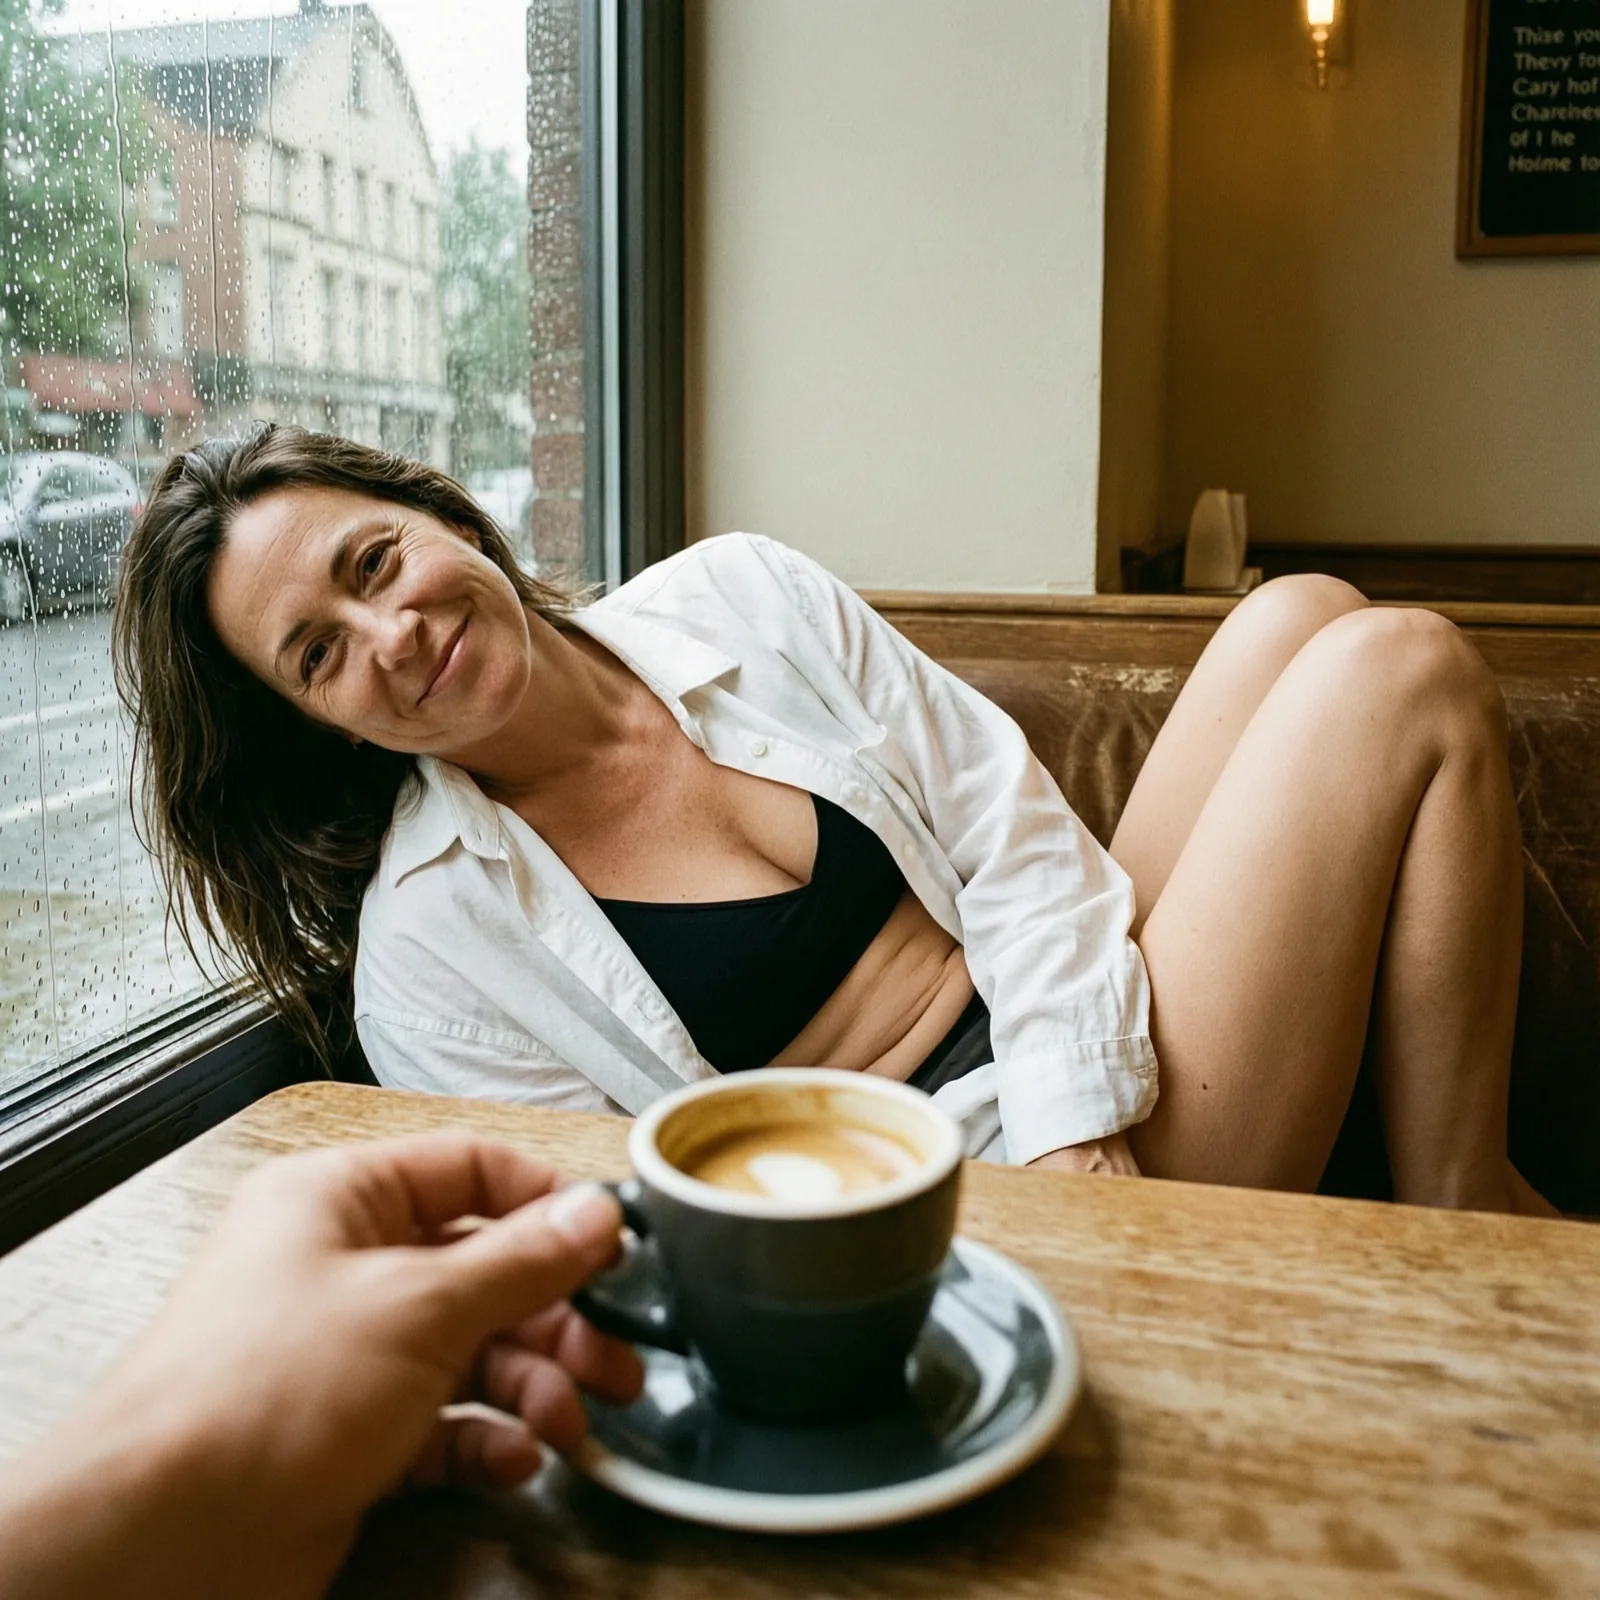
cafe-pov La richiesta esatta dietro l'immagine di questa pagina: un prompt semplice a 1:1, nessuna immagine di riferimento e nessun flag di contenuto da impostare. È anche più o meno il punto fin dove arriva il solo testo.
- 1:1
 Output
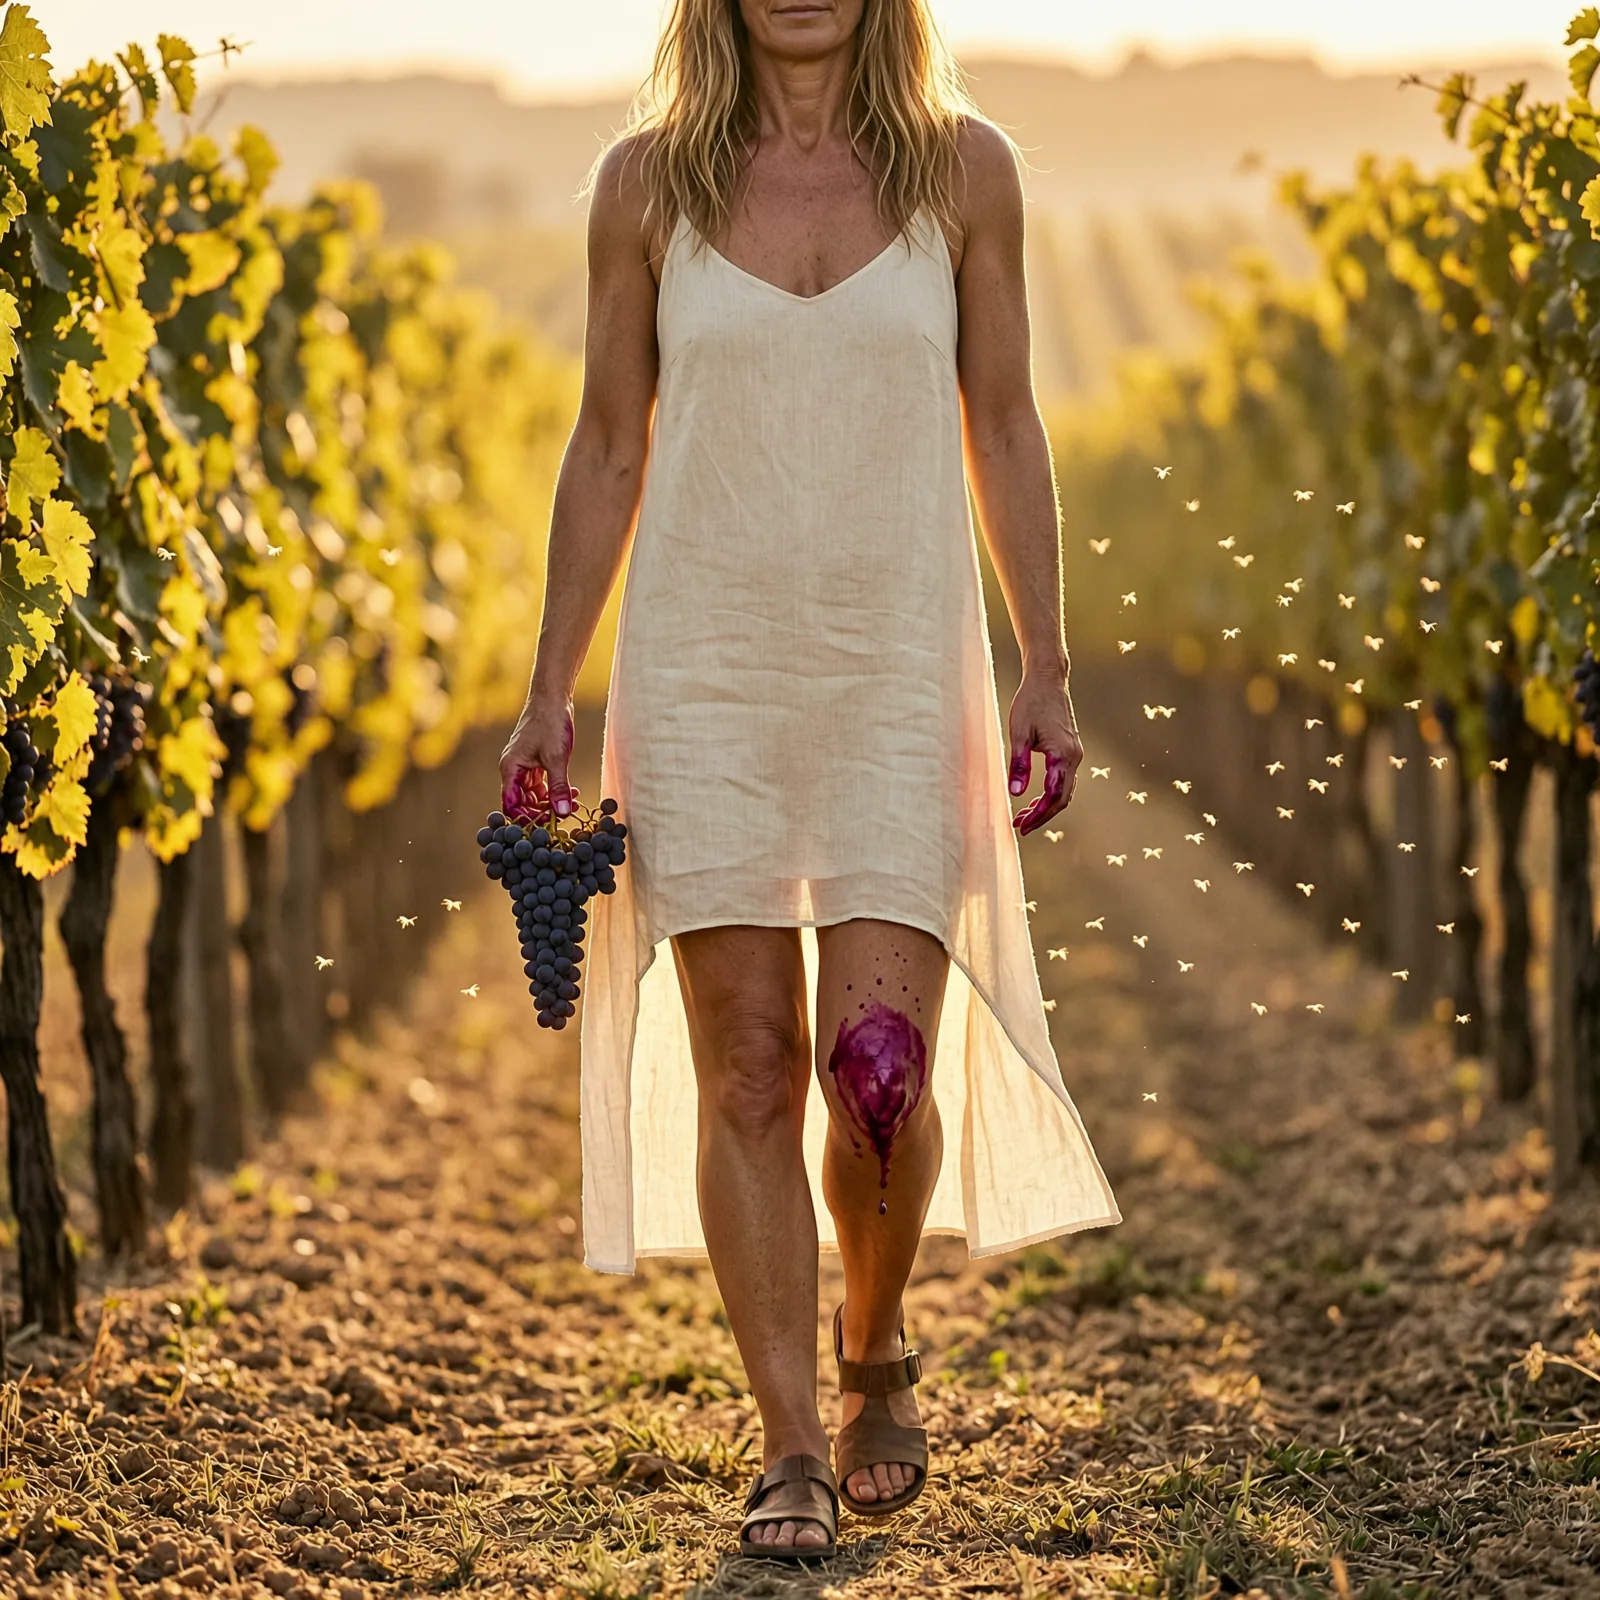
vineyard-backlit Gli altri due fotogrammi di questa pagina sono interni notturni ripresi dal posto di chi guarda; questo esce all'aperto con un 200mm all'ora dorata, con il sole dietro il soggetto così che la luce attraversi il lino sottile e la sagoma si legga attraverso la stoffa. Il controluce attraverso un tessuto è una richiesta molto più difficile di una lampada in una stanza.
- 1:1
 Output
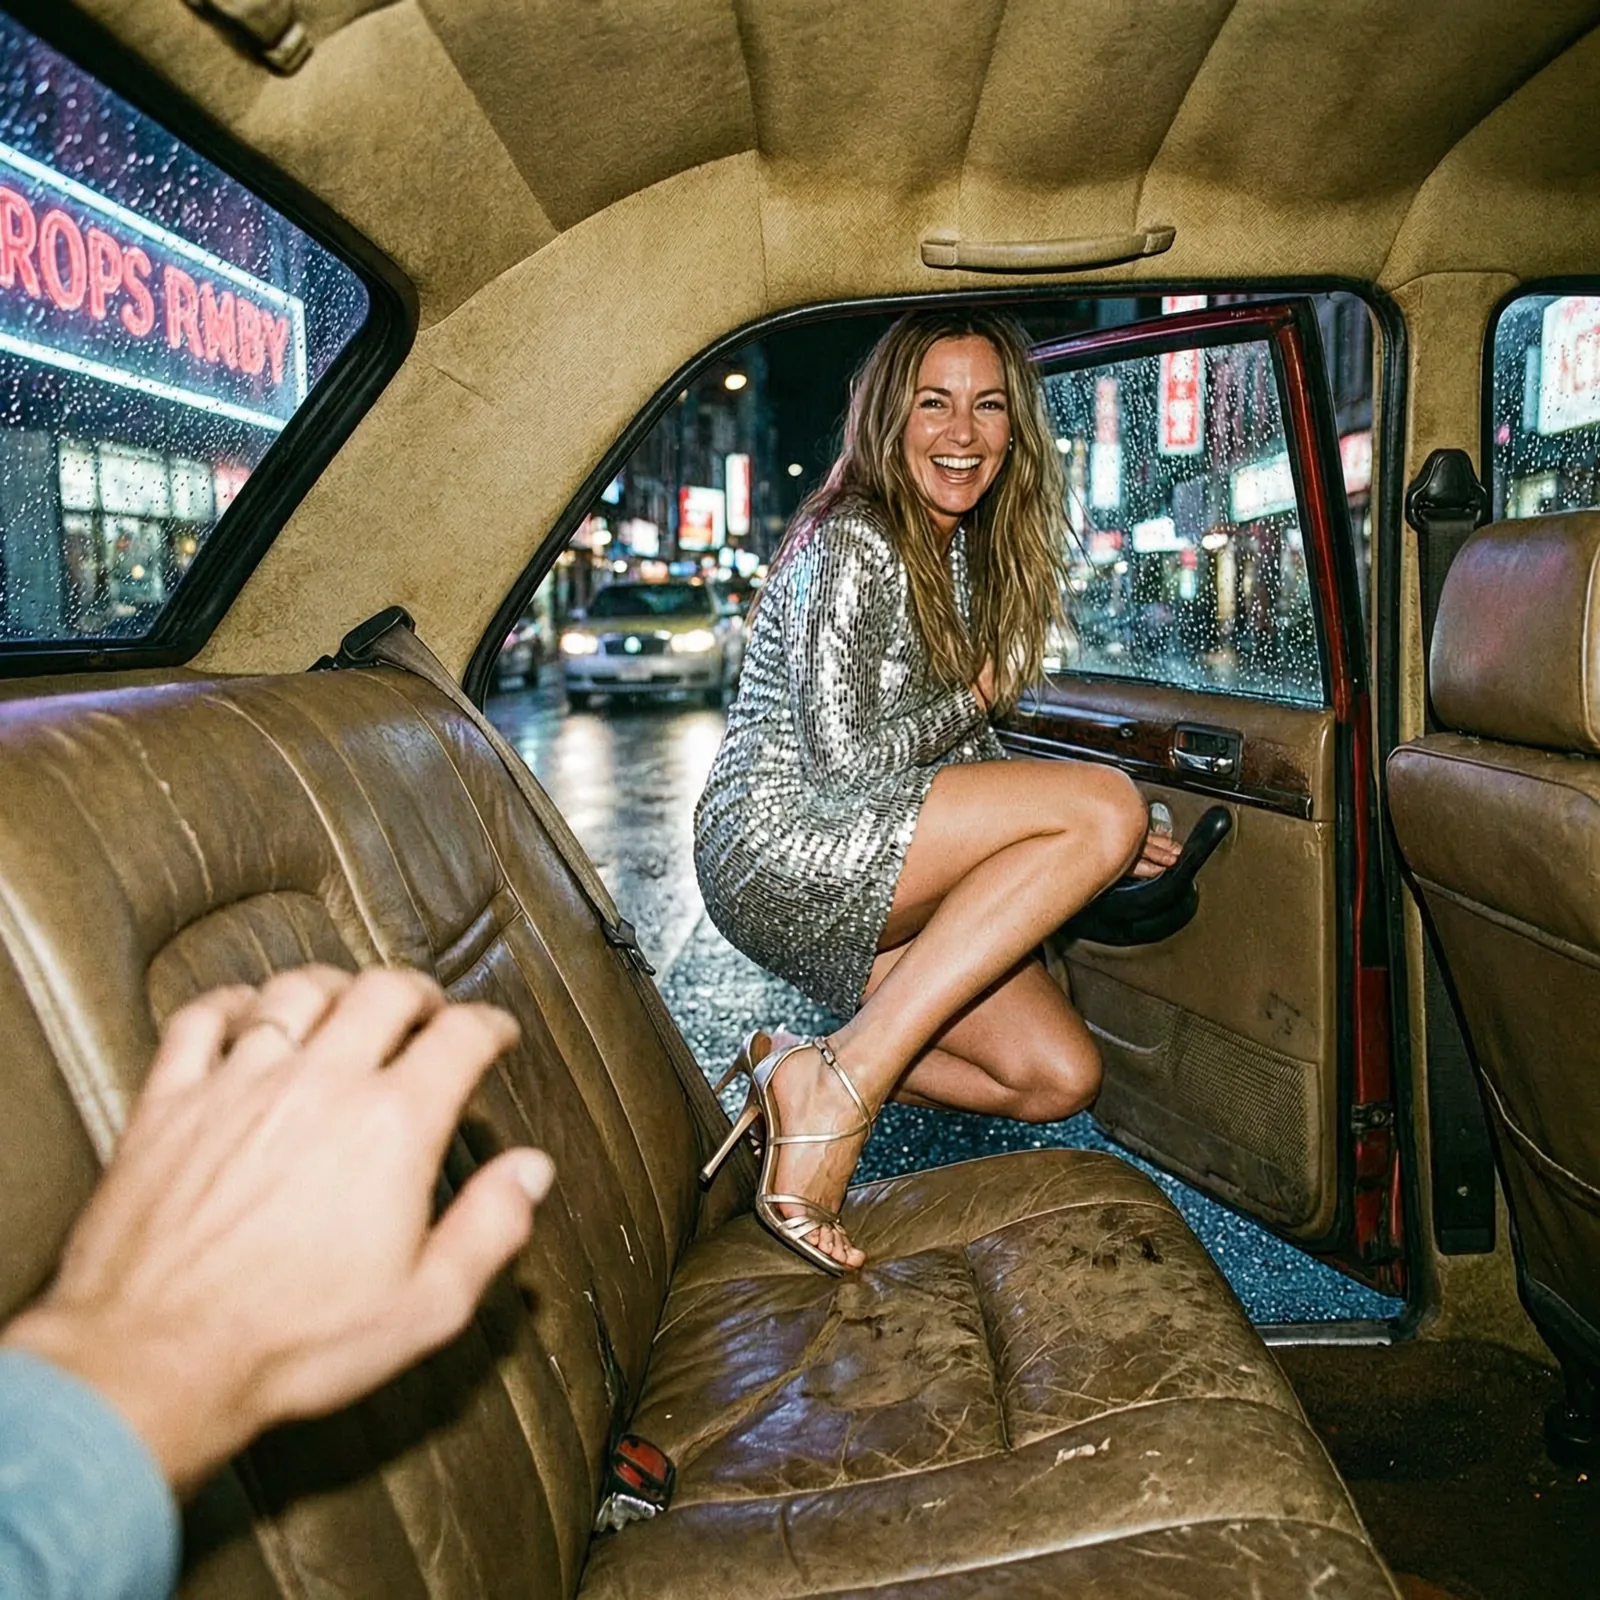
taxi-back-seat La seconda immagine di questa pagina. Proporzioni e seed omessi del tutto, quindi gira sul valore predefinito 1:1: inquadratura POV e grana della pellicola portate dal solo prompt.
Questo esempio parte da $0.03 per immagine. Il Playground aggiorna la stima quando cambi le impostazioni.