Vai al contenuto principale

Il text-to-image Wan 2.7 di Alibaba usa un passaggio di ragionamento per pianificare la composizione prima di disegnare. Restituisce da una a quattro immagini per richiesta a circa 1 megapixel in sette proporzioni, con un seed per confronti stabili.

Il filtraggio cambia da un endpoint all’altro: Editing di immagini — Senza censura, Da testo a immagine — Attenuato.

Da $0.03/immagine

Playground

Input

Da testo a immagine
502/5000
Descrivi l'inquadratura: soggetto, azione, posizione della camera, poi luce e obiettivo. Wan 2.7 pianifica prima la composizione, quindi una sola relazione spaziale chiara batte un mucchio di aggettivi. almeno 1 caratteri · al massimo 5000 caratteri
1:1, 4:3, 3:4, 16:9, 9:16, 3:2 o 2:3. Il valore predefinito è 1:1. Il budget di pixel è lo stesso per tutte, quindi proporzioni più larghe danno un'immagine più larga, non più grande.
Ragionamento approfondito
Consente al modello di ragionare sul prompt prima di iniziare a generare. Disattivarlo è sensibilmente più rapido e di solito non costa nulla in qualità sui prompt dettagliati.
1k o 2k; 1k per impostazione predefinita. 2k porta quattro volte i pixel di 1k, e la forma segue comunque aspect_ratio.
Palette di colori0/10
    Tema cromatico facoltativo da 3 a 10 colori (ne sono consigliati 8). Inserisci ogni colore come codice esadecimale #RRGGBB e, se vuoi, la quota dell'immagine che deve coprire in percentuale; le righe lasciate vuote si dividono la quota rimanente, quindi lasciandole tutte vuote i colori pesano uguale. Orienta la palette di tutta l'immagine: set, abiti e luce. Non cambia il prezzo. almeno 3 elementi · al massimo 10 elementi
    Seed
    Da 0 a 2147483647. Tienilo fermo e cambia una proposizione per volta: lo stesso seed tiene ferma l'estrazione, quindi ciò che si è mosso è la proposizione. È uno strumento di confronto, non la garanzia di un'immagine identica. non meno di 0 · non più di 2147483647
    Controllo di sicurezzaDisattivato

    SpicyAPI non applica nessun controllo di sicurezza a questo modello. Il tuo prompt e i tuoi media arrivano al modello così come li hai scritti, ed è il modello stesso a decidere che cosa torna indietro.

    Controllo del tuo account prima di abilitare invio e prezzi.

    Output

    Pronto per una nuova esecuzione
    wasteland-three-depthsRisultato di esempio

    Modelli correlati e attività successive

    Manca il modello che ti serve?

    Dicci cosa aggiungere e dove lo useresti. Le richieste arrivano a chi decide quali modelli integrare per primi.

    La composizione risolta prima che si accenda un pixel

    L’API di Wan 2.7 da testo a immagine trasforma un prompt in una o quattro immagini eseguendo prima un passaggio di ragionamento interno che risolve impaginazione, relazioni fra gli oggetti e illuminazione prima che parta il render. Il vantaggio si vede sulle istruzioni composte: più soggetti, una relazione spaziale dichiarata, una fonte di luce che deve restare coerente su tutta l’inquadratura. La tela nasce da sette proporzioni e due fasce di risoluzione, 1k o 2k.

    Apri il Playground
    La composizione risolta prima che si accenda un pixel
    Budget di tela
    Circa 1 megapixel a 1k, circa 4 a 2k, distribuiti in modo uniforme su tutte e sette le proporzioni
    Proporzioni
    Sette valori: 1:1, 4:3, 3:4, 16:9, 9:16, 3:2, 2:3
    Lunghezza del prompt
    Fino a 5.000 caratteri, un solo passaggio sull’intera scena
    Immagini per chiamata
    Da 1 a 4 tramite num_outputs, ciascuna fatturata come immagine a sé
    Passaggio di ragionamento
    enable_thinking è attivo per impostazione predefinita; disattivalo per un render più rapido
    Seed
    Da 0 a 2.147.483.647, oppure ometti per un’estrazione nuova ogni volta
    Ragionamento
    Un prompt solo, non cinque istruzioni breviIl passaggio di ragionamento risolve già gran parte dell’ambiguità, quindi un’unica descrizione ben strutturata rende più di diverse frasi brevi che si contendono l’attenzione del modello.
    Tela
    Proporzioni e risoluzione decidono il budget di pixelresolution sceglie la fascia, circa 1 megapixel a 1k o circa 4 a 2k, e tutte e sette le proporzioni vi attingono in modo uniforme, così un ritratto 9:16 non esce più morbido di un quadrato 1:1.
    Scala
    Il 4k di Wan 2.7 Pro vive nel text-to-imageIl 2k quadruplica già i pixel dell’1k. Oltre quello, il text-to-image di Wan 2.7 Pro porta un proprio campo di risoluzione con un’opzione 4k, che la documentazione di Alibaba limita al text-to-image; ogni endpoint di editing in entrambe le famiglie si ferma al 2k.

    Cosa fa bene l’API di Wan 2.7

    Le istruzioni composte reggono

    Le istruzioni composte reggono

    Più soggetti, una relazione spaziale esplicita («la tazza a sinistra del piatto, in ombra») o una fonte di luce condivisa su tutta l’inquadratura tendono a risolversi correttamente invece di slittare da una frase all’altra. Il passaggio di ragionamento legge l’intero prompt come un’unica scena prima di iniziare a disegnare, così una relazione dichiarata nella prima frase regge ancora nell’ultima.

    Nessun calo alle proporzioni estreme

    Nessun calo alle proporzioni estreme

    Ognuna delle sette proporzioni riceve le proprie dimensioni in pixel dallo stesso budget, così un fotogramma panoramico 16:9 e uno verticale 9:16 portano un dettaglio comparabile. Una richiesta 16:9 è più larga di una 1:1 ma non più grande, quindi scegliere una proporzione è una decisione di inquadratura e non incide su quanto dettaglio finisce nel file.

    • Esecuzioni ripetute sotto controllo

      Conserva il seed e la richiesta completa così le varianti successive si possono confrontare con essa; input identici non garantiscono comunque la stessa immagine. Cambia un solo campo fra una chiamata e l’altra, come la proporzione o una frase sul guardaroba, e il seed fisso tiene il resto della composizione abbastanza vicino perché la differenza sia quella che hai introdotto.

    • Da una a quattro immagini, ciascuna fatturata come una

      num_outputs va da 1 a 4 ed è l’unico campo che moltiplica il conto: ogni immagine viene addebitata separatamente. Lunghezza del prompt, proporzioni e risoluzione non aggiungono nulla, e il preventivo mostrato prima dell’invio copre già l’intero lotto.

    • Nessun preset di qualità da regolare

      Sei campi, e nessuno è una manopola di qualità: nessun sampler da impostare, nessun conteggio di step da sbagliare. resolution decide la dimensione, e enable_thinking, attivo per impostazione predefinita, è l’unico interruttore che cambia il modo in cui l’immagine viene elaborata. Disattivalo per una bozza più rapida; l’endpoint di editing non ha questo interruttore, perché la documentazione di Alibaba limita quel passaggio ai prompt inviati senza un’immagine in ingresso.

    Per chi è Wan 2.7

    • Scene con più di un elemento in movimento

      Lavoro di concept

      Scene con più di un elemento in movimento

      Un personaggio che interagisce con un oggetto preciso, due soggetti in una disposizione spaziale dichiarata, o una scena in cui la fonte di luce deve restare coerente su più elementi. Sono i prompt che su modelli più veloci si sgretolano in liste di parole chiave; scriverli come un’unica frase collegata dà al passaggio di ragionamento qualcosa da risolvere.

    • Composizioni che nominano una relazione fra gli oggetti

      Prodotto ed editoriale

      Composizioni che nominano una relazione fra gli oggetti

      Descrivi come gli oggetti stanno l’uno rispetto all’altro, perché è quella relazione che il passaggio di ragionamento risolve. Per una natura morta di prodotto significa nominare quale elemento sta davanti, quale cade nell’ombra dell’altro e dove cade il riflesso, poi tenere fermo il seed mentre la stessa disposizione viene ridisegnata a 3:2 e a 9:16.

    • Costruire una serie attorno a un solo volto

      Schede personaggio

      Costruire una serie attorno a un solo volto

      Fissa un seed una volta stabilito un volto, poi varia una alla volta le frasi su guardaroba o ambientazione per costruire la serie. Il seed fisso aiuta, ma controlla ogni risultato, perché il viso può comunque slittare.

    • Lotti in cui la precisione compositiva conta più della dimensione di stampa

      Concepting ad alto volume

      Lotti in cui la precisione compositiva conta più della dimensione di stampa

      L’1k va bene per la revisione a schermo e per l’output in scala social, e enable_thinking impostato a false accorcia ogni passaggio finché le composizioni sono ancora da sistemare; passa al 2k per i fotogrammi che vanno in consegna, e al text-to-image di Wan 2.7 Pro solo quando nemmeno quello basta.

    Come si chiama l’API di Wan 2.7

    1. Decidi prima le proporzioni

      aspect_ratio è l’unico campo che cambia la forma dell’inquadratura, e la stessa descrizione si compone in modo diverso su una tela verticale rispetto a una panoramica. Sceglierla per prima evita di scrivere una composizione pensata per un fotogramma quadrato su una tela che finisce alta o larga.

    2. Scrivi un solo prompt per l’intera scena

      Il passaggio di ragionamento sta già risolvendo l’ambiguità, quindi un’unica descrizione strutturata batte diverse istruzioni brevi in concorrenza fra loro. Copri soggetto, azione, relazioni spaziali e luce nello stesso paragrafo; prompt accetta fino a 5.000 caratteri, molto più spazio di quanto serva a una scena composta.

    3. Dichiara le relazioni in modo esplicito

      Nomina come gli elementi stanno fra loro («dietro», «nell’ombra di», «dello stesso colore di») invece di elencarli affiancati. Una lista piatta di oggetti non dà al passaggio di ragionamento nulla da risolvere; nominare la relazione è ciò su cui ragiona davvero.

    4. Esplora senza seed, poi bloccalo

      Lascia seed non impostato finché stai ancora cercando la composizione; quando un risultato ci va vicino, fissa quel seed e cambia un campo alla volta. Un seed non impostato dà un’estrazione nuova a ogni chiamata, utile per esplorare le opzioni prima di impegnarti su una direzione da affinare.

    5. Alza la risoluzione prima di cambiare modello

      Se il risultato è già corretto e deve solo essere più grande, imposta resolution su 2k: stesso prompt, quattro volte i pixel. Il text-to-image di Wan 2.7 Pro è il passo successivo, e una fascia 4k è l’unica cosa che aggiunge alla questione della dimensione.

    Esempi svolti con Wan 2.7

    • Una natura morta con una relazione spaziale esplicita

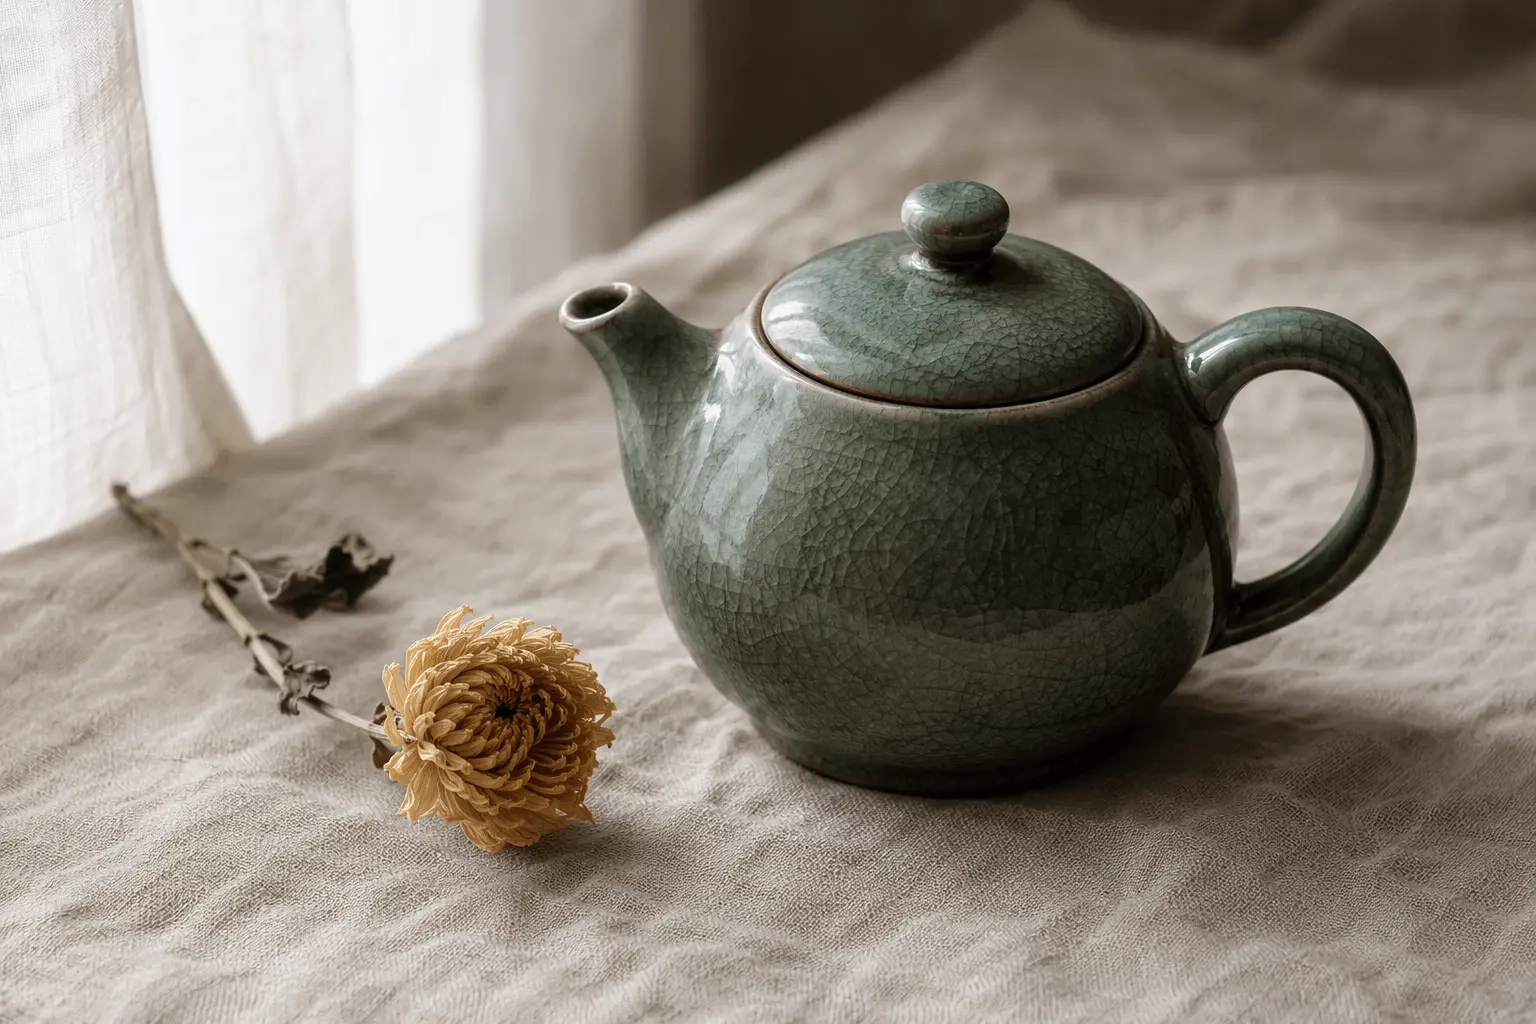
      Nominare il rapporto fra teiera, tessuto e luce impedisce alla composizione di scivolare verso una generica foto di prodotto.

      A hand-thrown stoneware teapot glazed in deep celadon, resting on undyed linen beside a single dried chrysanthemum stem, soft window light from the left, fine crackle texture visible in the glaze
    • Una serie di ritratti attorno a una sola identità

      Fissa un seed come ancora dell’identità, poi cambia da una chiamata all’altra solo guardaroba e sfondo; il passaggio di ragionamento aiuta a tenere ferma la struttura del viso mentre quelle frasi cambiano, anche se una corrispondenza esatta non è garantita.

      Portrait of a woman in her thirties, short dark hair, small scar above the left eyebrow, three-quarter view, overcast daylight, muted olive coat
    • Un’unica fonte di luce su un’inquadratura panoramica

      Nominare un’unica fonte di luce e chiedere che ogni oggetto nell’inquadratura le risponda è il tipo di istruzione che il passaggio di ragionamento è pensato per risolvere, e regge su un ritaglio panoramico 16:9 con la stessa efficacia di uno quadrato.

      A row of five mismatched ceramic vases on a long wooden shelf, each holding a different dried flower, one warm lamp glowing from the left edge of the frame so every vase casts a soft shadow to the right, fine dust visible in the light

    Domande sull’API di Wan 2.7

    Scrivi l’intera scena in un unico paragrafo strutturato: soggetto, cosa sta facendo, dove si trova la camera, poi la luce. Metti le esclusioni nello stesso paragrafo, perché non esiste un campo di prompt negativo dove spostarle. Definisci la composizione a 1k con seed omesso, poi fissa quel seed, alza la risoluzione a 2k e cambia una frase per chiamata, così ogni differenza che vedi è quella che hai introdotto.

    Tutti i modelli Wan22

    Modelli video18