Masz obraz dorosłej postaci, który Ci się podoba, i chcesz go poruszyć bez zastąpienia sceny przez model łagodniejszą interpretacją. To inne pytanie niż to, czy HappyHorse potrafi stworzyć scenę dla dorosłych z jednego zdania.
HappyHorse 1.1 nie ma ograniczeń w zadaniach image-to-video i reference-to-video na SpicyAPI; text-to-video jest filtrowane. Image-to-video dostarczyło żądaną treść w trzech z trzech prób w każdej testowanej kategorii dla dorosłych, w tym zaawansowanych obrazach NSFW i intensywniejszych scenach dla dorosłych. Text-to-video odrzuciło wszystkie trzy intensywniejsze żądania w odpowiadającej kategorii. Reference-to-video także dostarczyło zaawansowane obrazy NSFW, ale zakres testów był znacznie mniejszy.
Jeśli tworzysz treści dla dorosłych i masz zatwierdzony obraz początkowy, zacznij od image-to-video. Wybierz reference-to-video, gdy chcesz złożyć nową kompozycję z oddzielnych obrazów. Nie wybieraj text-to-video, oczekując tych samych granic treści. Wszystkie trzy kosztują 0,14 $ za sekundę w 720p lub 0,18 $ za sekundę w 1080p: pięć sekund kosztuje 0,70 $ lub 0,90 $.
Co rzeczywiście pokazały testy NSFW HappyHorse 1.1
Poniższe wyniki pochodzą z testów integracyjnych z 25 września 2026, z użyciem trzysekundowych klipów w 720p.
Nazwy kategorii zachowują różnice z oryginalnego zestawu: L1 to treści sugestywne, L2 umiarkowane obrazy NSFW, L3 zaawansowane obrazy NSFW, a L4 intensywniejsze sceny dla dorosłych. Nie oznacza to, że przetestowano każdą możliwą scenę w kategorii.
| Testowana kategoria | Image-to-video | Reference-to-video | Text-to-video |
|---|---|---|---|
| L1: treści sugestywne | 3 dostarczone, 0 odrzuconych | 1 dostarczone, 0 odrzuconych | 3 dostarczone, 0 odrzuconych |
| L2: umiarkowane obrazy NSFW | 3 dostarczone, 0 odrzuconych | Nie testowano | 3 dostarczone, 0 odrzuconych |
| L3: zaawansowane obrazy NSFW | 3 dostarczone, 0 odrzuconych | 3 dostarczone, 0 odrzuconych | 2 dostarczone, 1 odrzucone |
| L4: intensywniejsze sceny dla dorosłych | 3 dostarczone, 0 odrzuconych | Nie testowano | 0 dostarczonych, 3 odrzucone |
| L5 klasa A: skrajny podzbiór kategorii dla dorosłych | 3 dostarczone, 0 odrzuconych | Nie testowano | 0 dostarczonych, 2 odrzucone |
Raport testów HappyHorse 1.1 podaje zapisane wyniki według zadania i kategorii treści. Wiersz text-to-video L5 klasa A obejmuje dwa żądania. Próby kategorii przemocy wyłączono z tej tabeli treści dla dorosłych.
W tych wierszach nie odnotowano złagodzonych wyników. Dla image-to-video „dostarczone” oznacza, że treść dla dorosłych ze źródła i żądania pozostała w klipie wynikowym. Dla text-to-video odmowa oznacza, że żądany klip nie został dostarczony; nie opisuje gotowego wideo o mniejszej intensywności.
Praktyczna różnica jest widoczna przy L3 i L4. Generowanie z tekstu staje się niespójne przy L3 i nie przechodzi próbki L4, podczas gdy testowana droga przez klatkę początkową dostarcza obie kategorie.
Reference-to-video dostarczyło wszystkie trzy żądania kategorii zaawansowanej; dla szerszego zakresu kategorii dla dorosłych pokazanego wyżej użyj drogi opartej na obrazie.
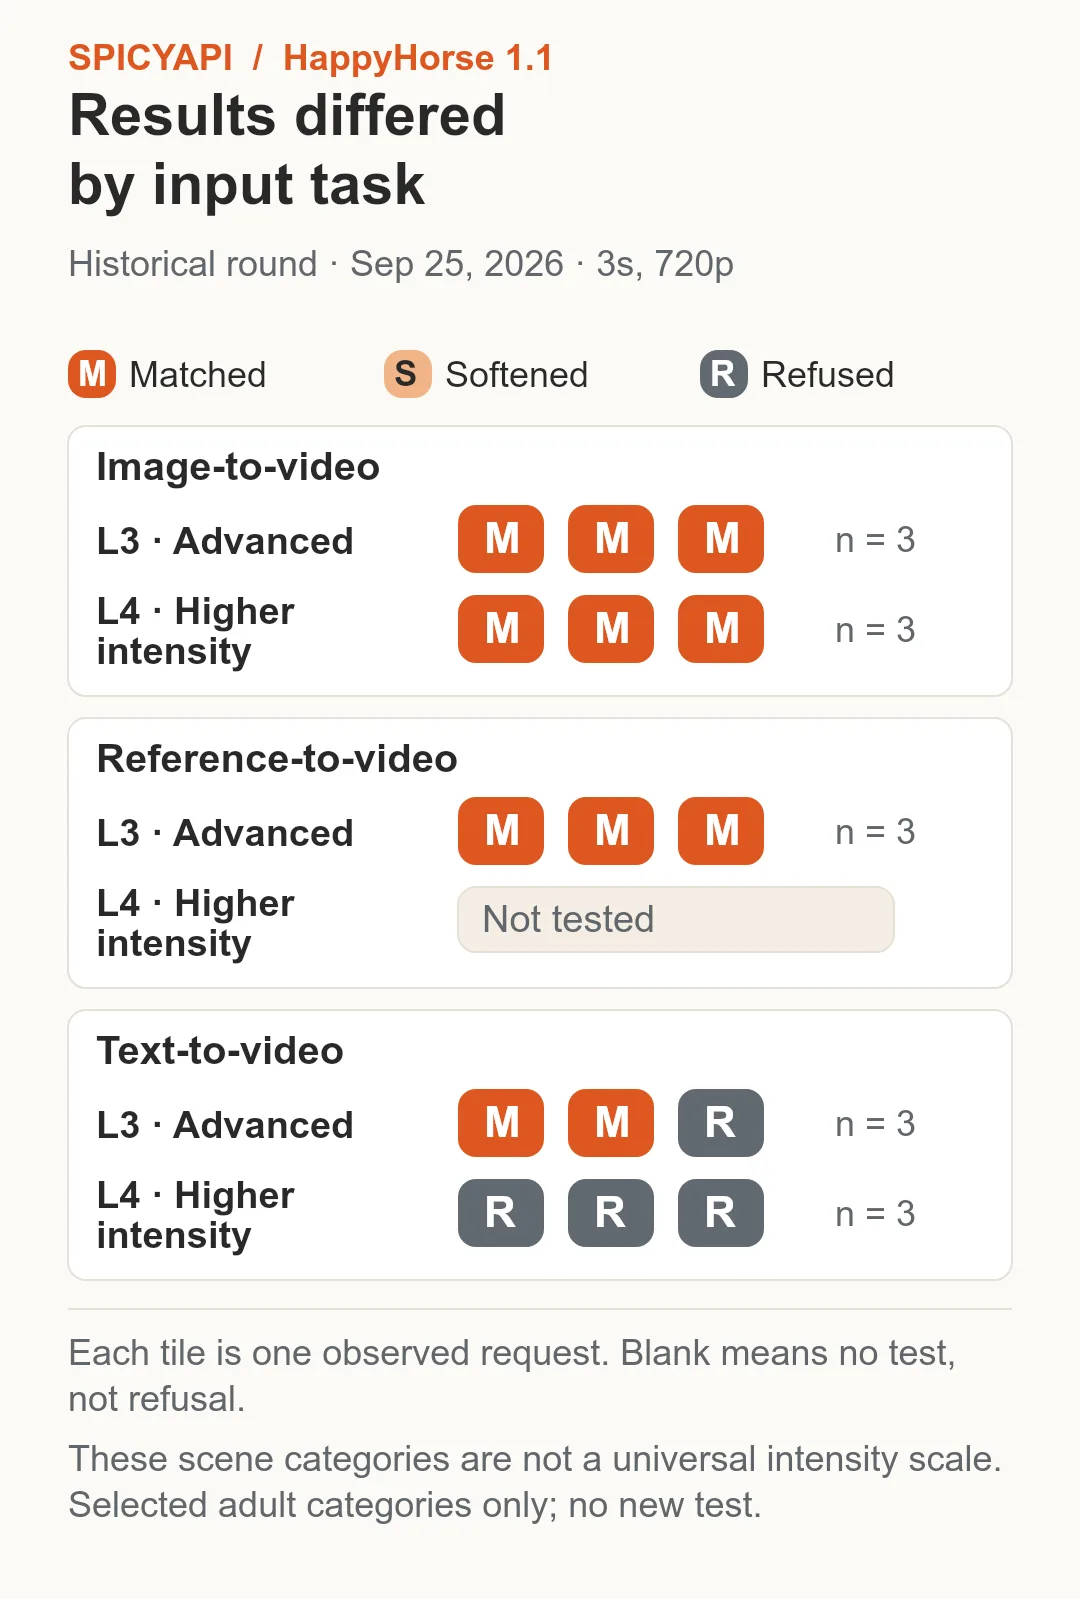
Zgodne oznacza dostarczenie żądanej treści. Wejście obrazowe dostarczyło obie wybrane kategorie; wejście tekstowe nie dostarczyło żądań L4. Komórkę L4 dla referencji oznaczono „Nie testowano”.
„Bez cenzury” nie mówi, czy ujęcie nadaje się do użycia
Akceptacja treści i jakość ujęcia to oddzielne decyzje. Klip może zachować żądaną treść, zmieniając twarz, koszulę lub pozę. Zacznij od krótkiego ujęcia i jednego małego ruchu, potem oceń tożsamość, ubiór i ruch przed wydłużeniem.
Zacznij od obrazu, gdy dorosła postać już wygląda dobrze
Otwórz HappyHorse 1.1 image-to-video. Prześlij obraz początkowy, na którego użycie masz zgodę, dodaj prompt ruchu i wybierz pięć sekund w 720p. Image-to-video przyjmuje jedno image_url i zachowuje kształt obrazu; nie ma oddzielnego pola aspect_ratio.
Dla pionowego teasera dorosłej postaci przygotuj obraz w naprawdę docelowym pionowym kadrze. Zostaw miejsce wokół głowy i na planowany ruch dłoni. Ciasny portret nie pokaże ręki sięgającej w pustą przestrzeń bez wymagania od modelu wideo wymyślenia tej części osoby i pokoju.
Prompt początkowy dla siedzącego dorosłego mężczyzny w grafitowej satynowej koszuli obok ciepłej lampy:
One continuous five-second medium close-up of the fictional 35-year-old man in the opening image. He glances slowly toward the adult partner already seated beside him, then looks back toward the camera with a small smile. Preserve both faces, the charcoal satin shirt, its neckline and the warm bedside lamp. Keep both people seated and the camera still. Quiet room ambience, no dialogue, no cuts and no added people.
Obraz źródłowy powinien już zawierać oboje dorosłych, jeśli oboje mają się pojawić. Proszenie modelu opartego na klatce początkowej o dodanie partnera tworzy drugie zadanie: wymyślić osobę oprócz animowania zatwierdzonej. Jeśli teaser potrzebuje jednej postaci, usuń partnera i opisz zamiast tego spojrzenie w kamerę.
HappyHorse przyjmuje całkowite długości od trzech do piętnastu sekund. Zacznij od pięciu sekund dla spojrzenia. Trzysekundowe ujęcie w 720p kosztuje 0,42 $; siedmiosekundowe kosztuje 0,98 $.
Image-to-video oferuje opcjonalny seed. Zachowuj go przy porównywaniu zmian promptu, jeśli chcesz ograniczyć jedno źródło zmienności, ale nie traktuj jako gwarancji identycznej tożsamości lub ruchu. Zadanie nie ma pola klatki końcowej: gdy ostatni wyraz twarzy musi dokładnie odpowiadać zatwierdzonemu obrazowi, ta droga nie pozwala przypiąć klatki przez dodatkowe przesłanie.
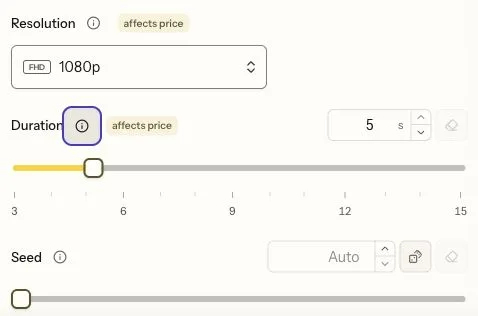
Kontrolki pokazują pięć sekund w 1080p; te ustawienia kosztują 0,90 $. Wybierz 720p dla podglądu za 0,70 $ opisanego wyżej; seed nie zmienia ceny.
Użyj referencji, gdy chcesz nowej sceny, a nie tylko ruchu
Załóżmy, że masz zatwierdzony portret dorosłej kobiety, oddzielny obraz referencyjny nieprzezroczystego stroju i obraz pustego pokoju. Chcesz, żeby siedziała przy oknie tego pokoju zamiast animować oryginalne tło portretu. To zadanie dla HappyHorse 1.1 reference-to-video.
Zadanie przyjmuje od jednego do dziewięciu uporządkowanych reference_image_urls oraz proporcje wyjściowe. Nadaj każdemu obrazowi jasną rolę. Obraz postaci określa twarz i włosy, obraz stroju – części garderoby, a obraz pokoju – otoczenie. Zdjęcie pokoju z inną rozpoznawalną osobą wprowadza konkurencyjną tożsamość, więc pusty pokój łatwiej opisać.
Proponowany kierunek dla tego układu:
[Image 1] defines the fictional adult woman's face and hairstyle. [Image 2] defines her opaque black satin outfit. [Image 3] defines the room and window. Begin with her already seated beside the window, framed from the waist up. She turns her eyes toward the camera and rests one hand on the chair arm. Preserve the outfit's shape and color. One continuous take, stationary camera, no extra people. Soft evening room ambience.
Jeśli wygenerowana osoba wygląda dobrze, ale jej poza początkowa jest błędna, pięć kolejnych portretów raczej nie wyjaśni miejsca jej dłoni. Najpierw zatwierdź docelową scenę jako nieruchomy obraz i animuj ją przez image-to-video. Jeśli poza początkowa może się zmieniać i chcesz szukać kompozycji, zachowaj zadanie referencyjne i użyj mniejszej liczby jednoznacznych obrazów.
Budżet na krótki klip dorosłej postaci
Obecny cennik SpicyAPI nie różnicuje cen trzech zadań HappyHorse 1.1. Długość i rozdzielczość określają sumę częściową generowania.
| Żądana długość | 720p za 0,14 $/sekundę | 1080p za 0,18 $/sekundę |
|---|---|---|
| 3 sekundy | 0,42 $ | 0,54 $ |
| 5 sekund | 0,70 $ | 0,90 $ |
| 10 sekund | 1,40 $ | 1,80 $ |
| 15 sekund | 2,10 $ | 2,70 $ |
Trzy ukończone pięciosekundowe warianty w 720p kosztują łącznie 2,10 $; dziesięć kosztuje 7,00 $. To przykłady arytmetyczne, a nie przewidywanie, że trzy próby dadzą użyteczną scenę. Tworzenie nieruchomych obrazów, edycja i inne zadania modeli nie są uwzględnione w tych sumach.
Przeniesienie pięciosekundowej próby z 720p do 1080p dodaje 0,20 $. Kupujesz inny poziom rozdzielczości, nie naprawiasz zmienionej twarzy ani niejasnego promptu ruchu. Rozwiąż ujęcie na tańszym poziomie, gdy wystarcza do oceny, potem zdecyduj, czy warto kupić kolejne generowanie w 1080p. Nowe generowanie nie jest zwiększeniem rozdzielczości tego samego dokładnego wykonania.
Różnica ma znaczenie także przy dłuższych scenach. Dwa niezależne pięciosekundowe ujęcia mają taką samą sumę częściową z cennika jak jedno dziesięciosekundowe przy tej samej rozdzielczości. Mogą być łatwiejsze do oddzielnej wymiany, ale wprowadzają cięcie i nie gwarantują ciągłości między klipami. Wybierz zgodnie z docelowym montażem zamiast zakładać, że jedna forma zawsze jest lepsza.
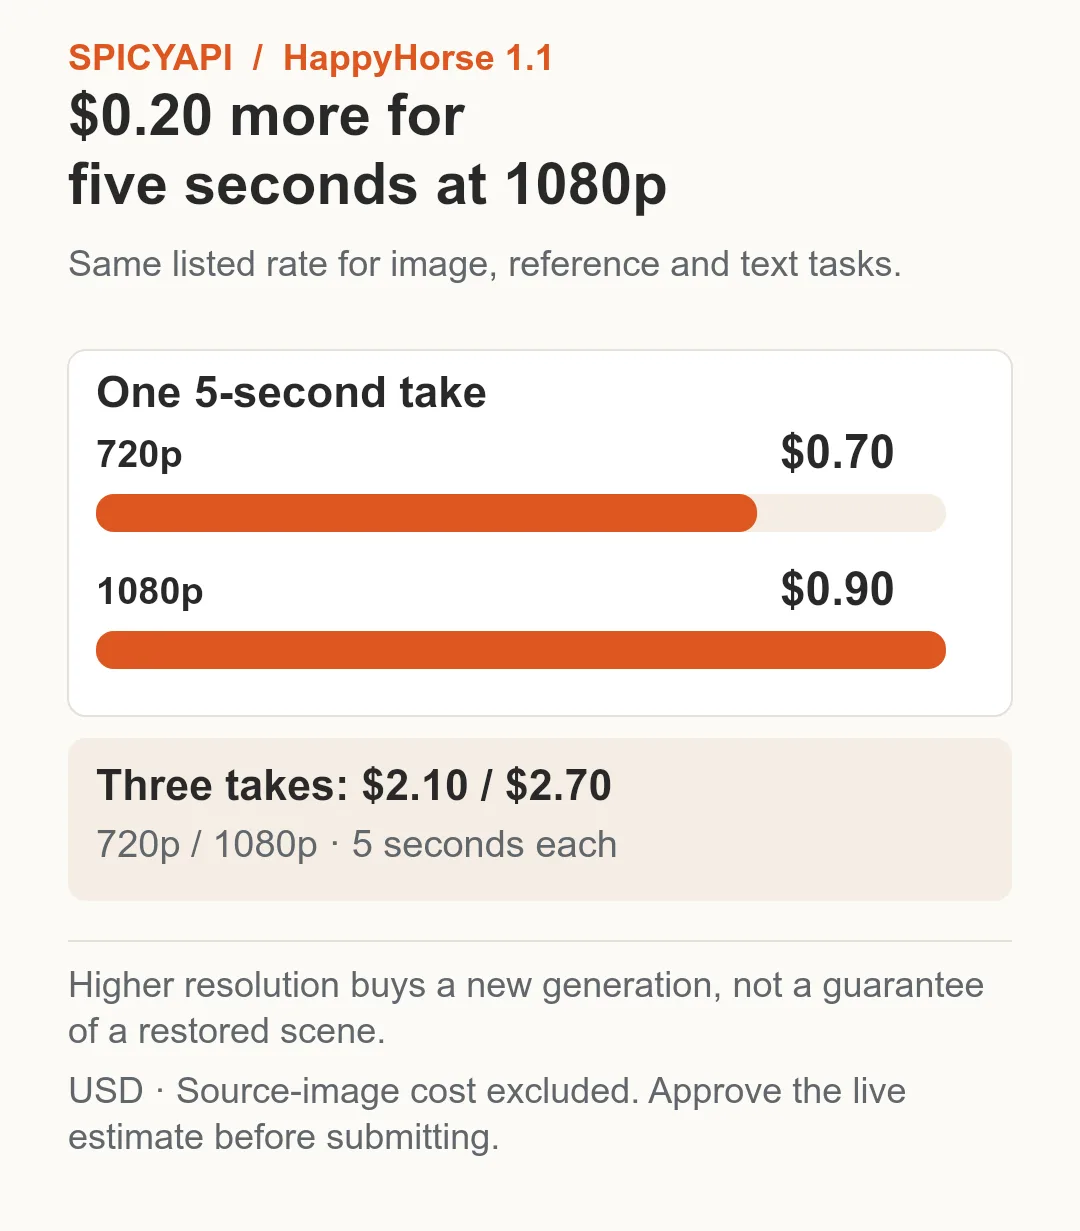
Pięciosekundowe ujęcie HappyHorse kosztuje 0,70 $ w 720p lub 0,90 $ w 1080p. Dopłata za rozdzielczość to 0,20 $ na ujęcie we wszystkich trzech zadaniach z cennika.
Dźwięk i ustawienia istotne dla twórców treści dla dorosłych
HappyHorse zwraca wygenerowany dźwięk, ale obecne zadania nie mają przełącznika generate_audio. Opisz oczekiwane odgłosy otoczenia w prompcie i posłuchaj dostarczonego pliku. Jeśli potrzebujesz cichej pętli lub istniejącej ścieżki głosu, wycisz lub zastąp wygenerowane audio w edytorze. Nie wysyłaj wymyślonego parametru wyłączania dźwięku.
Przyjemnie wyglądający klip nie jest więc gotowy do publikacji, dopóki go nie odsłuchasz. Niespodziewana kwestia lub dźwięk może zmienić ton intymnej sceny dorosłych postaci, nawet gdy obraz działa.
Te zadania nie mają pola negative_prompt. Opisz jasno oczekiwane ujęcie w głównym prompcie. Nieruchoma kamera i krótkie spojrzenie są bardziej informacyjne niż długa lista niechcianych zachowań kamery. Image-to-video i reference-to-video udostępniają seed; text-to-video nie.
Więcej przykładów żądań i różnic między zadaniami znajdziesz w przewodniku wyboru zadań HappyHorse.
Czy warto używać HappyHorse 1.1 do wideo NSFW?
Wybierz image-to-video dla zatwierdzonej dorosłej postaci i reference-to-video do złożenia kompozycji z oddzielnych obrazów postaci, stroju i otoczenia. Dla intensywniejszej sceny dla dorosłych preferuj zadanie oparte na obrazie zamiast text-to-video, które odrzuciło odpowiadające żądania.