Wybierz image-to-video, gdy masz zatwierdzoną klatkę początkową, reference-to-video, gdy postać, strój, przedmiot lub miejsce dostarczają osobne obrazy, a text-to-video, gdy masz same słowa. Wszystkie trzy kosztują 0,14 $ za sekundę w 720p lub 0,18 $ w 1080p, więc pięciosekundowy klip to 0,70 $ lub 0,90 $, a wybór dotyczy kontroli, nie ceny. Image-to-video i reference-to-video to endpointy uncensored; text-to-video jest filtrowane.
Które zadanie wysłać
| Co masz | ID modelu i wymagane dane | Wybierz, gdy | Ograniczenie, które trzeba uwzględnić |
|---|---|---|---|
| Opisaną scenę | alibaba/happyhorse-1.1/text-to-video; prompt | Dopiero ustalasz kadr, światło i tempo albo szybko potrzebujesz konkretnych proporcji | Twarz, strój i kadrowanie zostają po stronie modelu, więc kolejne uruchomienia się różnią |
| Jeden zatwierdzony obraz | alibaba/happyhorse-1.1/image-to-video; prompt, image_url | Klip ma pasować do istniejącego obrazu | Brak pola proporcji (kształt wyznacza obraz) i brak klatki końcowej, więc akcja musi zakończyć się sama |
| Od jednego do dziewięciu obrazów o różnych rolach | alibaba/happyhorse-1.1/reference-to-video; prompt, reference_image_urls | Łączysz postać, strój, rekwizyt i miejsce albo używasz tej samej obsady w kilku ujęciach | Jedna rola na obraz; tylko obrazy, bez referencji wideo i audio |
Wszystkie trzy przyjmują prompt od 1 do 2500 znaków, duration_seconds od 3 do 15 (domyślnie 5) oraz resolution 720p (domyślnie) lub 1080p. W tym zakresie klip kosztuje od 0,42 $ do 2,10 $ w 720p i od 0,54 $ do 2,70 $ w 1080p, więc rób wersje robocze w 720p, a wybrane ujęcie uruchom ponownie w 1080p; nowe uruchomienie daje nowe ujęcie nawet przy tym samym opisie.
- Proporcje obrazu: zadania tekstowe i referencyjne przyjmują proporcje; image-to-video podąża za twoim obrazem, więc najpierw go przytnij.
- Seed: tylko zadania z obrazem i referencjami. Zachowaj go bez zmian i zmieniaj jedną rzecz naraz.
- Dźwięk: zawsze generowany, bez pola do wyłączenia; wycisz go lub zastąp w swoim edytorze.
- Nieobsługiwane:
last_image_urlinegative_prompt.
Rozmiar obrazu, rozmiar referencji i limity przesyłania są na stronie każdego modelu.
Treści dla dorosłych zależą od zadania
Według naszych testów z września 2026 image-to-video zrealizowało każdą wypróbowaną kategorię treści dla dorosłych, od scen sugestywnych po najbardziej intensywne, więc obraz dorosłej postaci to najbezpieczniejszy punkt wyjścia. Reference-to-video również jest uncensored. Text-to-video przeszło lżejsze prompty, ale intensywniejsze odrzucało całkowicie, zamiast je łagodzić. Jeśli scena ma dotrzeć do modelu bez zmian, zbuduj ją z obrazu. Wyniki według kategorii zawierają testy NSFW HappyHorse 1.1 (ten artykuł jest na razie tylko po angielsku); aktualne zadania pokazuje strona modelu HappyHorse 1.1.
Najpierw wypróbuj w Playground
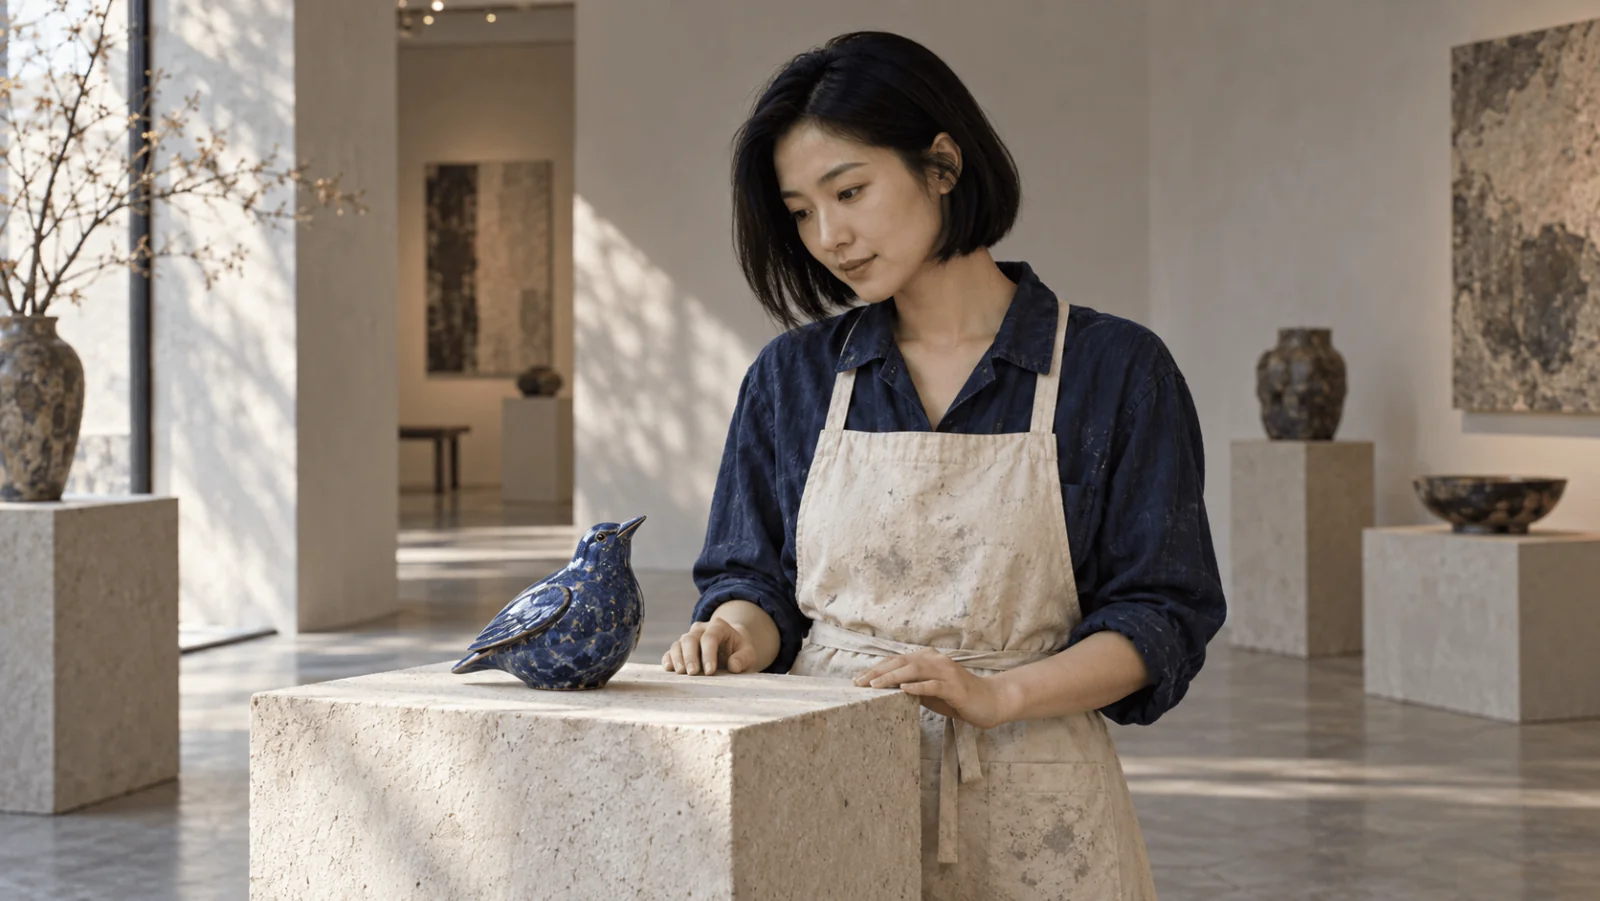
Przykład: ożywienie portretu fikcyjnej 35-letniej ceramiczki w indygo koszuli i kremowym fartuchu, która trzyma niebieskiego ceramicznego ptaka tuż nad cokołem, z obiema dłońmi i cokołem w kadrze.
- Otwórz stronę image-to-video, zostań na karcie Playground w widoku Form i zaloguj się, aby uruchomić.
- W polu Input image upuść własny, autoryzowany portret (JPG, PNG, WEBP lub GIF, do 10 MB) albo wklej jego Asset URL.
- Wklej poniższy prompt albo otwórz go już wypełnionego:
Uruchom ten prompt w HappyHorse 1.1 →. Opisuje tylko to, co zmienia się po klatce początkowej; artystkę, ptaka i pomieszczenie wyznacza już obraz. Prompt zostaje po angielsku, tak jak trafia do modelu.
- Ustaw Resolution na 720p i Duration na 5, po czym uruchom. W 720p kosztuje to 0,70 $, a trzy próby 2,10 $; przy dziesięciu sekundach w 1080p każda próba kosztuje 1,80 $.
- Zachowaj ujęcie, które ci odpowiada, i uruchom je ponownie w 1080p.
Dla referencji otwórz stronę reference-to-video, dodaj obrazy w Reference images w stałej kolejności i ponumeruj je w prompcie jako [Image 1], [Image 2] i [Image 3], nazywając, co wnosi każdy z nich. Daj każdemu obrazowi referencyjnemu jedną rolę: kilka zdjęć tego samego obiektu zostaje uśrednionych, a nie uzgodnionych, a dziewięć miejsc to limit, nie cel. Dla samych słów użyj strony text-to-video, gdzie dostępne jest Aspect ratio, i opisz w prompcie artystkę, ptaka i galerię.
Potem uruchom z kodu
Zainstaluj Python SDK (pip install spicyapi), ustaw SPICY_API_KEY w środowisku serwera i uruchom:
import uuid

from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

frame = client.upload_file("./opening-frame.png")  # becomes a spicy:// URI

task = client.create_task(
    model="alibaba/happyhorse-1.1/image-to-video",
    input_data={
        "image_url": frame["uri"],
        "prompt": "One continuous medium shot. The adult artist gently lowers the blue ceramic bird "
                  "onto the pedestal, releases it, draws both hands back and pauses. "
                  "Keep the camera still. Quiet gallery ambience and one soft ceramic contact sound. "
                  "No cuts or added people.",
        "duration_seconds": 5,
        "resolution": "720p",
        "seed": 240103,
    },
    idempotency_key=str(uuid.uuid4()),  # new key per new request; reuse only to retry the same one
)

print("Resume task:", task["taskId"], flush=True)
final = client.wait_for_terminal(task["taskId"])
if final["state"] != "succeeded":
    raise RuntimeError(f"Task {task['taskId']} ended as {final['state']}")
assets = output_assets(final)
if not assets or any(a.get("pending") or a.get("unavailable") or not a.get("url") for a in assets):
    raise RuntimeError(f"Task {task['taskId']} has no ready output; check this task before a new run")
print(assets[0]["url"])
W reference-to-video zmień model i użyj reference_image_urls; text-to-video przyjmuje tylko prompt, aspect_ratio, duration_seconds i resolution. Oczekiwanie, błędy i ponawianie opisuje przewodnik po zadaniach oraz dokumentacja Python SDK.
Albo pozwól uruchomić to agentowi
Gdy klipy ma uruchamiać asystent, CLI, serwer MCP i Agent Skill czytają aktualny schemat; CLI i MCP pokazują cenę i proszą o potwierdzenie przed płatnym wywołaniem. Z tym samym obiektem input w input.json:
npx @spicyapi/cli tasks create --model alibaba/happyhorse-1.1/image-to-video --input-file input.json --waitPrzez MCP poproś: „Animuj ./opening-frame.png w HappyHorse 1.1 image-to-video”; asystent wywoła spicyapi_upload_file, a potem spicyapi_task_create. npx skills add spicyapi-ai/spicy-skill instaluje Skill.
Napraw konkretną usterkę
| Objaw | Następny krok |
|---|---|
Nieznane aspect_ratio w image-to-video | Usuń pole i przed przesłaniem przytnij obraz początkowy do zamierzonego kształtu |
Nieznane seed w text-to-video | Usuń seed; to zadanie go nie udostępnia |
invalid_asset przy obrazie | Adres URL zwrócił stronę WWW; prześlij plik i użyj jego URI spicy:// |
| Zła pozycja końcowa mimo dobrej pierwszej klatki | Uprość akcję; nie ma wejścia na klatkę końcową, które ustalałoby zakończenie |
| Przedmiot zlewa się z dłonią | Skróć ruch i trzymaj kamerę nieruchomo |
| Scena nocna zmienia się w dzień | Zostaw jedną porę dnia, nazwij widoczną lampę lub światło księżyca i usuń wschód słońca oraz upływ czasu; obejrzyj cały klip |
| Odłożenie przedmiotu kończy się po końcu klipu | Usuń z promptu wejście w kadr albo wydłuż czas z 5 do 7 sekund (0,98 $ w 720p) |
| Twarze lub przedmioty z referencji się mieszają | Daj każdemu obrazowi jeden obiekt i nazwij go obok znacznika [Image N] |
| Dobry obraz, niechciana ścieżka dźwiękowa | Wycisz lub zastąp ścieżkę w edytorze; nie ma parametru wyłączającego dźwięk |
content_rejected | Filtr zadania odrzucił żądanie; zmiana czasu lub rozdzielczości nie pomoże. Filtrowane jest text-to-video, więc alternatywą jest klatka początkowa w image-to-video |
Kadr ustal na tanich wersjach roboczych 720p, potem zablokuj zatwierdzony obraz lub zestaw referencji i uruchom ponownie na potrzeby dostawy. Planuj jedno czytelne zdarzenie na 5-sekundowy klip: wyższa rozdzielczość powiększa źle wykonaną interakcję, ale jej nie naprawia.