Use image-to-video quando você tiver um frame inicial aprovado, reference-to-video quando imagens separadas fornecem o personagem, a roupa, o objeto ou o local, e text-to-video quando você só tem palavras. As três custam US$ 0,14 por segundo em 720p ou US$ 0,18 em 1080p, então um clipe de cinco segundos sai por US$ 0,70 ou US$ 0,90, e a escolha é sobre controle, não preço. Image-to-video e reference-to-video são endpoints uncensored; text-to-video é filtrado.
Qual tarefa enviar
| O que você tem | ID do modelo e entradas obrigatórias | Escolha quando | Limite a considerar |
|---|---|---|---|
| Uma cena escrita | alibaba/happyhorse-1.1/text-to-video; prompt | Você ainda está definindo enquadramento, luz e ritmo, ou precisa rápido de uma proporção específica | Rosto, figurino e enquadramento ficam por conta do modelo, então as repetições variam |
| Uma imagem aprovada | alibaba/happyhorse-1.1/image-to-video; prompt, image_url | O clipe precisa corresponder a uma imagem que já existe | Sem campo de proporção (a imagem define o formato) e sem frame final, então a ação precisa se resolver sozinha |
| De uma a nove imagens com funções diferentes | alibaba/happyhorse-1.1/reference-to-video; prompt, reference_image_urls | Você combina personagem, roupa, objeto e local, ou reutiliza o mesmo elenco em várias cenas | Uma função por imagem; só imagens, sem referências de vídeo ou áudio |
As três aceitam um prompt de 1 a 2.500 caracteres, duration_seconds de 3 a 15 (padrão 5) e resolution com 720p (padrão) ou 1080p. Nesse intervalo, um clipe custa de US$ 0,42 a US$ 2,10 em 720p e de US$ 0,54 a US$ 2,70 em 1080p; por isso, faça rascunhos em 720p e refaça em 1080p a versão de que você gostou. A nova execução gera uma nova versão mesmo com as mesmas palavras.
- Proporção: as tarefas de texto e de referência aceitam uma proporção; image-to-video segue a sua imagem, então corte-a antes.
- Seed: só nas tarefas de imagem e de referência. Mantenha-a fixa e mude uma coisa de cada vez.
- Som: sempre gerado, sem campo para desligar; silencie ou substitua no seu editor.
- Não aceitos:
last_image_urlenegative_prompt.
Tamanho das imagens, tamanho das referências e limites de upload estão na página de cada modelo.
Conteúdo adulto depende da tarefa
Em nossos testes de setembro de 2026, image-to-video entregou todas as categorias adultas que tentamos, de cenas sugestivas às de maior intensidade; por isso, uma imagem de personagem adulto é o ponto de partida mais seguro. Reference-to-video também é uncensored. Text-to-video passou em prompts mais leves, mas recusou de vez os de maior intensidade em vez de suavizá-los. Se uma cena precisa chegar ao modelo sem alterações, monte-a a partir de uma imagem. Os resultados por categoria estão nos testes NSFW do HappyHorse 1.1 (por enquanto esse artigo existe só em inglês); a página do modelo HappyHorse 1.1 mostra as tarefas atuais.
Experimente primeiro no Playground
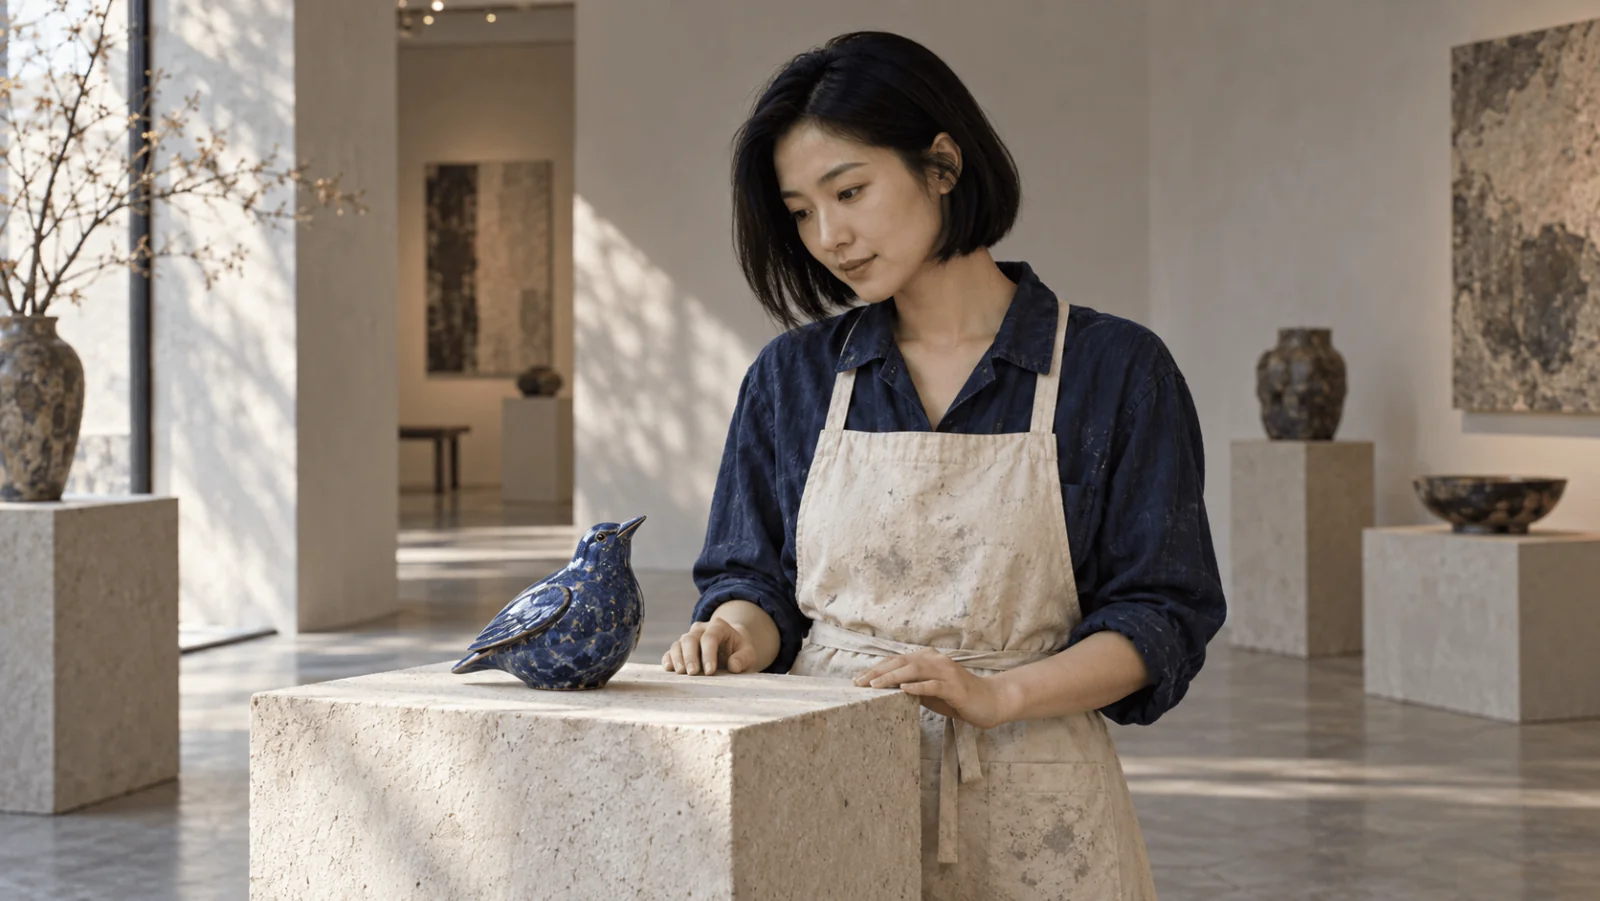
Exemplo: animar o retrato de uma ceramista fictícia de 35 anos, de camisa índigo e avental creme, segurando um pássaro de cerâmica azul logo acima de um pedestal, com as duas mãos e o pedestal dentro do quadro.
- Abra a página de image-to-video, fique na aba Playground na visualização Form e entre na conta para executar.
- Em Input image, solte o seu próprio retrato autorizado (JPG, PNG, WEBP ou GIF, até 10 MB) ou cole o Asset URL dele.
- Cole o prompt abaixo, ou abra-o já preenchido:
Executar este prompt no HappyHorse 1.1 →. Ele descreve só o que muda depois do frame; a imagem já define a artista, o pássaro e a sala. O prompt fica em inglês, como é enviado ao modelo.
- Defina Resolution como 720p e Duration como 5, e execute. Em 720p isso custa US$ 0,70, e três tentativas custam US$ 2,10; com dez segundos em 1080p, cada tentativa custa US$ 1,80.
- Fique com a versão de que gostou e refaça em 1080p.
Para referências, abra a página de reference-to-video, adicione as imagens em Reference images numa ordem fixa e numere-as no prompt como [Image 1], [Image 2] e [Image 3], dizendo o que cada uma contribui. Dê a cada imagem de referência uma só função: várias fotos do mesmo sujeito são combinadas em média em vez de conciliadas, e nove vagas são um teto, não uma meta. Para só palavras, use a página de text-to-video, onde Aspect ratio está disponível, e descreva no prompt a artista, o pássaro e a galeria.
Depois, execute por código
Instale o SDK Python (pip install spicyapi), defina SPICY_API_KEY no ambiente do seu servidor e execute:
import uuid

from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

frame = client.upload_file("./opening-frame.png")  # becomes a spicy:// URI

task = client.create_task(
    model="alibaba/happyhorse-1.1/image-to-video",
    input_data={
        "image_url": frame["uri"],
        "prompt": "One continuous medium shot. The adult artist gently lowers the blue ceramic bird "
                  "onto the pedestal, releases it, draws both hands back and pauses. "
                  "Keep the camera still. Quiet gallery ambience and one soft ceramic contact sound. "
                  "No cuts or added people.",
        "duration_seconds": 5,
        "resolution": "720p",
        "seed": 240103,
    },
    idempotency_key=str(uuid.uuid4()),  # new key per new request; reuse only to retry the same one
)

print("Resume task:", task["taskId"], flush=True)
final = client.wait_for_terminal(task["taskId"])
if final["state"] != "succeeded":
    raise RuntimeError(f"Task {task['taskId']} ended as {final['state']}")
assets = output_assets(final)
if not assets or any(a.get("pending") or a.get("unavailable") or not a.get("url") for a in assets):
    raise RuntimeError(f"Task {task['taskId']} has no ready output; check this task before a new run")
print(assets[0]["url"])
Para reference-to-video, troque o modelo e use reference_image_urls; text-to-video aceita só o prompt, aspect_ratio, duration_seconds e resolution. Espera, erros e novas tentativas estão no guia de tarefas e na referência do SDK Python.
Ou deixe um agente executar
Quando um assistente deve gerar os clipes, a CLI, o servidor MCP e a Agent Skill leem todos o schema atual; CLI e MCP mostram o preço e pedem confirmação antes de uma chamada paga. Com o mesmo objeto input em input.json:
npx @spicyapi/cli tasks create --model alibaba/happyhorse-1.1/image-to-video --input-file input.json --waitNo MCP, peça: "Anime ./opening-frame.png com HappyHorse 1.1 image-to-video"; o assistente chama spicyapi_upload_file e depois spicyapi_task_create. npx skills add spicyapi-ai/spicy-skill instala a Skill.
Corrija a falha específica
| Sintoma | Próxima ação |
|---|---|
aspect_ratio desconhecido em image-to-video | Remova o campo e corte a imagem inicial no formato desejado antes do upload |
seed desconhecido em text-to-video | Remova seed; esta tarefa não o expõe |
invalid_asset em uma imagem | A URL devolveu uma página da web; faça upload do arquivo e use o URI spicy:// |
| Pose final errada apesar de um bom primeiro frame | Simplifique a ação; não há entrada de frame final para fixar o desfecho |
| O objeto se funde com uma mão | Encurte o movimento e mantenha a câmera parada |
| Uma cena noturna vira dia | Mantenha um só horário, nomeie o abajur ou a luz da lua visível e retire nascer do sol ou passagem de tempo; confira o clipe inteiro |
| A colocação termina depois do fim do clipe | Retire do prompt a entrada em cena, ou aumente a duração de 5 para 7 segundos (US$ 0,98 em 720p) |
| Rostos ou objetos de referência se misturam | Dê a cada imagem um só sujeito e nomeie esse sujeito ao lado da tag [Image N] |
| Boa imagem, trilha sonora indesejada | Silencie ou substitua a faixa no seu editor; não há parâmetro para desligar o áudio |
content_rejected | O filtro da tarefa recusou o pedido; mudar duração ou resolução não ajuda. Text-to-video é a tarefa filtrada, então a alternativa é um frame inicial em image-to-video |
Defina o enquadramento com rascunhos baratos em 720p, depois trave a imagem aprovada ou o conjunto de referências e refaça para a entrega. Planeje um evento legível por clipe de 5 segundos: uma resolução maior amplia uma interação malformada, não a conserta.