Usa image-to-video cuando tengas un fotograma inicial aprobado, reference-to-video cuando imágenes separadas aporten el personaje, el vestuario, el objeto o el lugar, y text-to-video cuando solo tengas palabras. Las tres cuestan 0,14 $ por segundo en 720p o 0,18 $ en 1080p, así que un clip de cinco segundos sale por 0,70 $ o 0,90 $, y la elección trata del control, no del precio. Image-to-video y reference-to-video son endpoints uncensored; text-to-video está filtrado.
Qué tarea enviar
| Lo que tienes | ID del modelo y entradas obligatorias | Elígela cuando | Límite que conviene prever |
|---|---|---|---|
| Una escena escrita | alibaba/happyhorse-1.1/text-to-video; prompt | Aún estás definiendo encuadre, luz y ritmo, o necesitas rápido una relación de aspecto concreta | Rostro, vestuario y encuadre quedan en manos del modelo, así que las repeticiones varían |
| Una imagen aprobada | alibaba/happyhorse-1.1/image-to-video; prompt, image_url | El clip debe coincidir con una imagen que ya existe | Sin campo de relación de aspecto (la imagen fija la forma) y sin fotograma final, así que la acción tiene que resolverse sola |
| De una a nueve imágenes con funciones distintas | alibaba/happyhorse-1.1/reference-to-video; prompt, reference_image_urls | Combinas personaje, vestuario, atrezo y lugar, o reutilizas el mismo reparto en varios planos | Una función por imagen; solo imágenes, sin referencias de vídeo ni de audio |
Las tres aceptan un prompt de 1 a 2.500 caracteres, duration_seconds de 3 a 15 (5 por defecto) y resolution con 720p (por defecto) o 1080p. En ese rango, un clip cuesta de 0,42 $ a 2,10 $ en 720p y de 0,54 $ a 2,70 $ en 1080p, así que haz los borradores en 720p y repite en 1080p la toma que te guste; la nueva ejecución genera una toma nueva aunque uses las mismas palabras.
- Relación de aspecto: las tareas de texto y de referencia aceptan una proporción; image-to-video sigue tu imagen, así que recórtala antes.
- Seed: solo en las tareas de imagen y de referencia. Mantenla fija y cambia una sola cosa cada vez.
- Sonido: siempre se genera, sin campo para desactivarlo; siléncialo o sustitúyelo en tu editor.
- No se aceptan:
last_image_urlynegative_prompt.
El tamaño de las imágenes, el de las referencias y los límites de subida están en cada página de modelo.
El contenido para adultos depende de la tarea
Según nuestras pruebas de septiembre de 2026, image-to-video entregó todas las categorías para adultos que probamos, desde escenas sugerentes hasta las de mayor intensidad, así que una imagen de un personaje adulto es el punto de partida más seguro. Reference-to-video también es uncensored. Text-to-video superó los prompts más suaves, pero rechazó de plano los de mayor intensidad en lugar de suavizarlos. Si una escena debe llegar al modelo sin alteraciones, constrúyela a partir de una imagen. Los resultados por categoría están en las pruebas NSFW de HappyHorse 1.1 (por ahora ese artículo solo existe en inglés); la página del modelo HappyHorse 1.1 muestra las tareas actuales.
Pruébalo primero en el Playground
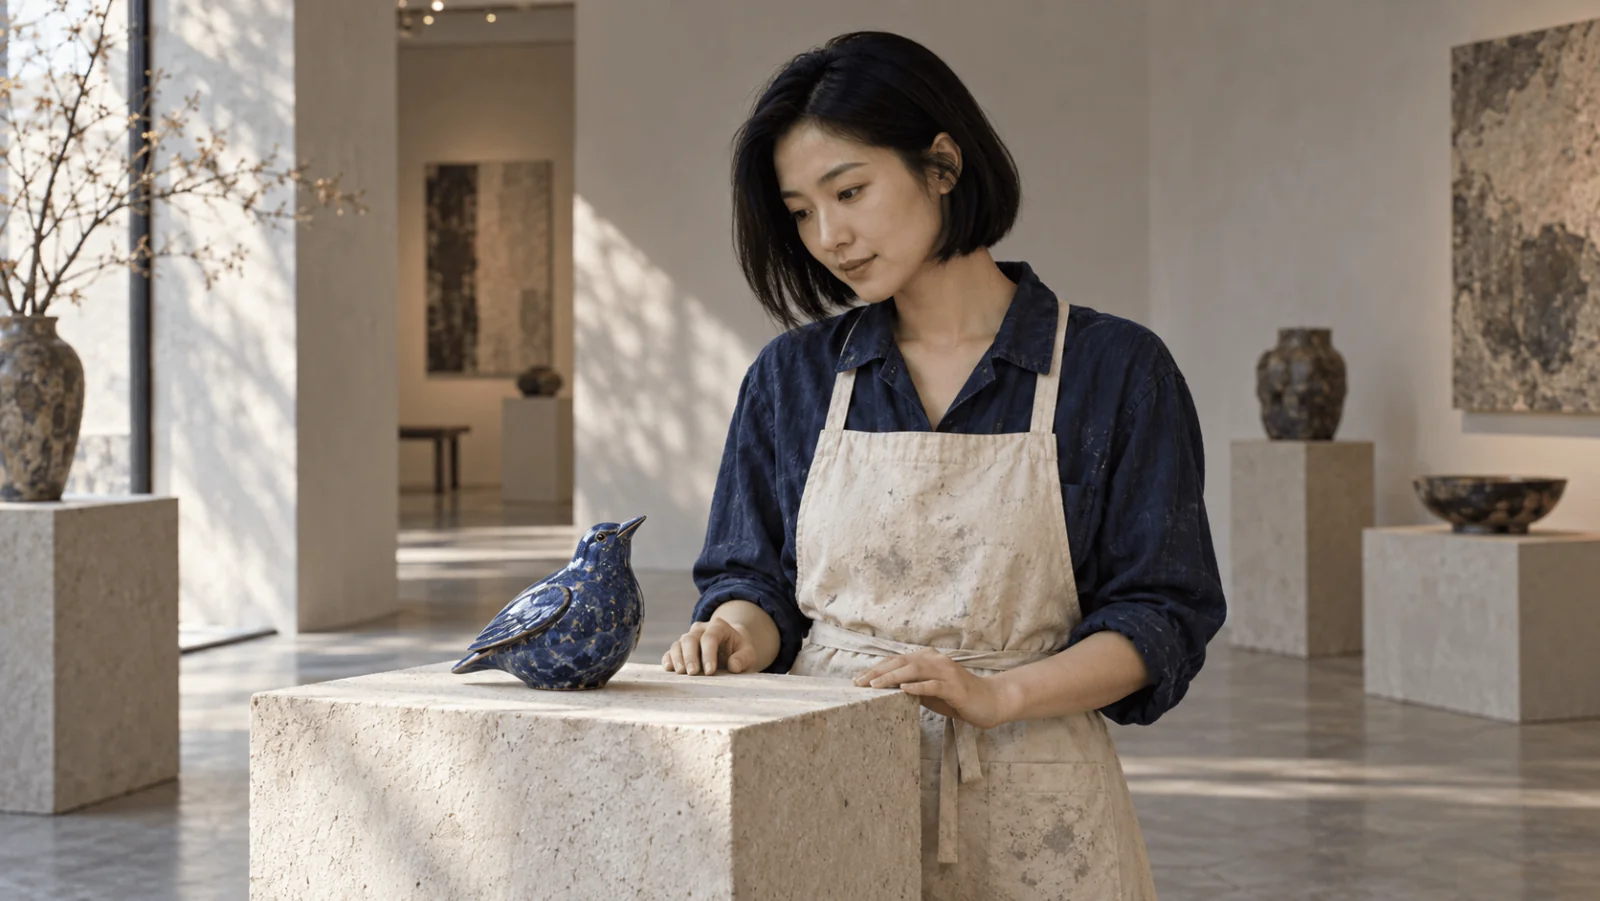
Ejemplo: animar el retrato de una ceramista ficticia de 35 años, con camisa índigo y delantal crema, que sostiene un pájaro de cerámica azul justo sobre un pedestal, con ambas manos y el pedestal dentro del encuadre.
- Abre la página de image-to-video, quédate en la pestaña Playground con la vista Form e inicia sesión para ejecutar.
- En Input image, suelta tu propio retrato autorizado (JPG, PNG, WEBP o GIF, hasta 10 MB) o pega su Asset URL.
- Pega el prompt de abajo, o ábrelo ya rellenado:
Ejecutar este prompt en HappyHorse 1.1 →. Describe solo lo que cambia después del fotograma; la imagen ya fija a la artista, el pájaro y la sala. El prompt va en inglés, tal como se envía al modelo.
- Pon Resolution en 720p y Duration en 5, y ejecuta. En 720p cuesta 0,70 $, y tres intentos cuestan 2,10 $; con diez segundos y 1080p, cada intento cuesta 1,80 $.
- Quédate con la toma que te guste y repítela en 1080p.
Para referencias, abre la página de reference-to-video, añade las imágenes en Reference images en un orden fijo y numéralas en el prompt como [Image 1], [Image 2] y [Image 3], indicando qué aporta cada una. Da a cada imagen de referencia una sola función: varias fotos del mismo sujeto se promedian en vez de conciliarse, y nueve ranuras son un tope, no un objetivo. Para solo palabras, usa la página de text-to-video, donde está disponible Aspect ratio, y describe en el prompt a la artista, el pájaro y la galería.
Después, ejecútalo desde código
Instala el SDK de Python (pip install spicyapi), define SPICY_API_KEY en el entorno de tu servidor y ejecuta:
import uuid

from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

frame = client.upload_file("./opening-frame.png")  # becomes a spicy:// URI

task = client.create_task(
    model="alibaba/happyhorse-1.1/image-to-video",
    input_data={
        "image_url": frame["uri"],
        "prompt": "One continuous medium shot. The adult artist gently lowers the blue ceramic bird "
                  "onto the pedestal, releases it, draws both hands back and pauses. "
                  "Keep the camera still. Quiet gallery ambience and one soft ceramic contact sound. "
                  "No cuts or added people.",
        "duration_seconds": 5,
        "resolution": "720p",
        "seed": 240103,
    },
    idempotency_key=str(uuid.uuid4()),  # new key per new request; reuse only to retry the same one
)

print("Resume task:", task["taskId"], flush=True)
final = client.wait_for_terminal(task["taskId"])
if final["state"] != "succeeded":
    raise RuntimeError(f"Task {task['taskId']} ended as {final['state']}")
assets = output_assets(final)
if not assets or any(a.get("pending") or a.get("unavailable") or not a.get("url") for a in assets):
    raise RuntimeError(f"Task {task['taskId']} has no ready output; check this task before a new run")
print(assets[0]["url"])
Para reference-to-video, cambia el modelo y usa reference_image_urls; text-to-video solo acepta el prompt, aspect_ratio, duration_seconds y resolution. La espera, los errores y los reintentos están en la guía de tareas y en la referencia del SDK de Python.
O deja que lo ejecute un agente
Cuando un asistente deba ejecutar los clips, la CLI, el servidor MCP y la Agent Skill leen todos el esquema vigente; CLI y MCP muestran el precio y piden confirmación antes de una llamada de pago. Con el mismo objeto input en input.json:
npx @spicyapi/cli tasks create --model alibaba/happyhorse-1.1/image-to-video --input-file input.json --waitCon MCP, pide: «Anima ./opening-frame.png con HappyHorse 1.1 image-to-video»; el asistente llama a spicyapi_upload_file y luego a spicyapi_task_create. npx skills add spicyapi-ai/spicy-skill instala la Skill.
Corrige el fallo concreto
| Síntoma | Siguiente paso |
|---|---|
aspect_ratio desconocido en image-to-video | Quita el campo y recorta la imagen inicial a la forma deseada antes de subirla |
seed desconocido en text-to-video | Quita seed; esta tarea no lo expone |
invalid_asset en una imagen | La URL devolvió una página web; sube el archivo y usa su URI spicy:// |
| Pose final equivocada pese a un buen primer fotograma | Simplifica la acción; no hay entrada de fotograma final que fije el desenlace |
| El objeto se fusiona con una mano | Acorta el movimiento y mantén la cámara fija |
| Una escena nocturna se vuelve de día | Mantén una sola hora del día, nombra la lámpara o la luz de luna visible y quita amanecer o paso del tiempo; revisa el clip completo |
| La colocación termina después de que acabe el clip | Quita la entrada en escena del prompt, o sube la duración de 5 a 7 segundos (0,98 $ en 720p) |
| Rostros u objetos de referencia se mezclan | Da a cada imagen un solo sujeto y nómbralo junto a su etiqueta [Image N] |
| Buena imagen, banda sonora no deseada | Silencia o sustituye la pista en tu editor; no hay parámetro para desactivar el audio |
content_rejected | El filtro de la tarea rechazó la solicitud; cambiar duración o resolución no ayuda. Text-to-video es la tarea filtrada, así que la alternativa es un fotograma inicial en image-to-video |
Define el encuadre con borradores baratos en 720p, luego fija la imagen aprobada o el conjunto de referencias y repite para la entrega. Planifica un solo suceso legible por cada clip de 5 segundos: una resolución mayor agranda una interacción mal formada, no la repara.