Usa image-to-video quando hai un primo fotogramma approvato, reference-to-video quando immagini separate forniscono personaggio, abito, oggetto o ambiente, e text-to-video quando hai solo parole. Tutte e tre costano 0,14 $ al secondo in 720p o 0,18 $ in 1080p: una clip di cinque secondi costa quindi 0,70 $ o 0,90 $, e la scelta riguarda il controllo, non il prezzo. Image-to-video e reference-to-video sono endpoint uncensored; text-to-video è filtrato.
Quale attività inviare
| Cosa hai | ID del modello e input obbligatori | Sceglila quando | Limite da mettere in conto |
|---|---|---|---|
| Una scena scritta | alibaba/happyhorse-1.1/text-to-video; prompt | Stai ancora definendo inquadratura, luce e ritmo, o ti serve in fretta un formato preciso | Volto, abiti e inquadratura sono lasciati al modello, quindi le ripetizioni variano |
| Un'immagine approvata | alibaba/happyhorse-1.1/image-to-video; prompt, image_url | La clip deve corrispondere a un'immagine già esistente | Nessun campo per le proporzioni (la forma la decide l'immagine) e nessun fotogramma finale, quindi l'azione deve concludersi da sola |
| Da una a nove immagini con ruoli diversi | alibaba/happyhorse-1.1/reference-to-video; prompt, reference_image_urls | Combini personaggio, abito, oggetto di scena e ambiente, o riusi lo stesso cast in più inquadrature | Un ruolo per immagine; solo immagini, nessun riferimento video o audio |
Tutte e tre accettano un prompt da 1 a 2.500 caratteri, duration_seconds da 3 a 15 (predefinito 5) e resolution 720p (predefinita) o 1080p. Su questo intervallo una clip costa da 0,42 $ a 2,10 $ in 720p e da 0,54 $ a 2,70 $ in 1080p: fai le bozze in 720p e rilancia in 1080p la ripresa che ti piace; la nuova esecuzione produce una nuova ripresa anche con le stesse parole.
- Proporzioni: le attività testo e riferimento accettano un rapporto; image-to-video segue la tua immagine, quindi ritagliala prima.
- Seed: solo attività immagine e riferimento. Tienilo fisso e cambia una cosa per volta.
- Audio: sempre generato, nessun campo per disattivarlo; silenzialo o sostituiscilo nel tuo editor.
- Non accettati:
last_image_urlenegative_prompt.
Dimensione delle immagini, dei riferimenti e limiti di upload sono nella pagina di ciascun modello.
I contenuti per adulti dipendono dall'attività
Secondo i nostri test di settembre 2026, image-to-video ha consegnato tutte le categorie per adulti provate, dalle scene allusive a quelle di massima intensità: un'immagine di un personaggio adulto è quindi il punto di partenza più sicuro. Anche reference-to-video è uncensored. Text-to-video ha superato i prompt più leggeri ma ha rifiutato del tutto quelli più intensi, invece di attenuarli. Se una scena deve arrivare al modello senza alterazioni, costruiscila da un'immagine. I risultati per categoria sono nei test NSFW di HappyHorse 1.1 (articolo per ora disponibile solo in inglese); la pagina del modello HappyHorse 1.1 mostra le attività attuali.
Prova prima nel Playground
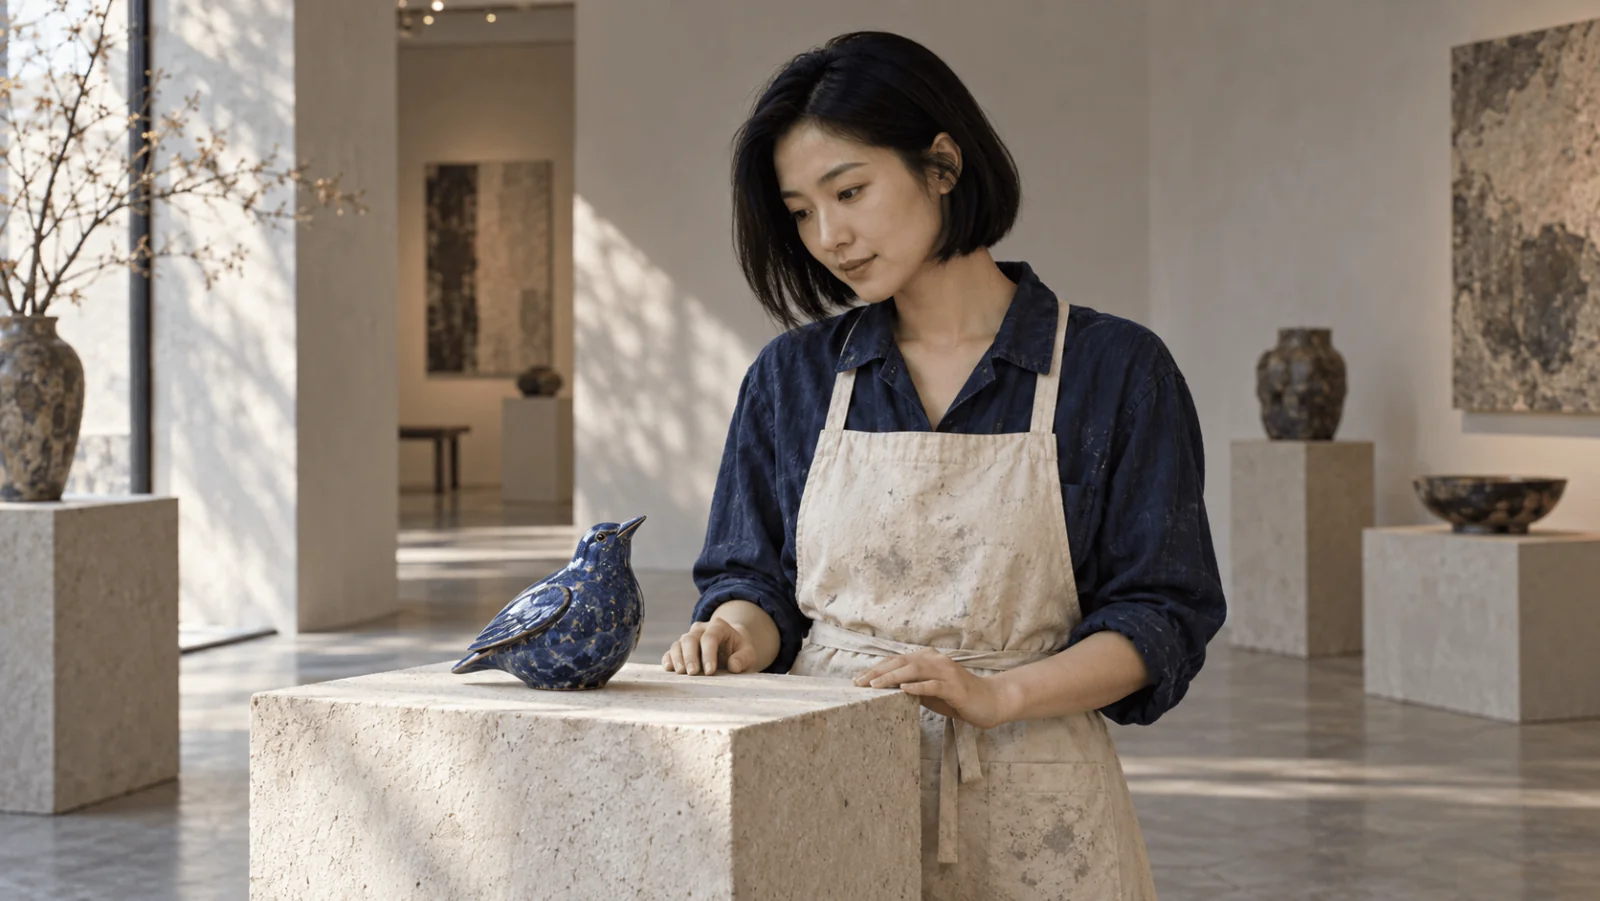
Esempio: animare il ritratto di una ceramista di fantasia di 35 anni, con camicia indaco e grembiule color crema, che tiene un uccello di ceramica blu appena sopra un piedistallo, con entrambe le mani e il piedistallo nell'inquadratura.
- Apri la pagina image-to-video, resta sulla scheda Playground nella vista Form e accedi per eseguire.
- In Input image, trascina il tuo ritratto autorizzato (JPG, PNG, WEBP o GIF, fino a 10 MB) o incolla il suo Asset URL.
- Incolla il prompt qui sotto, oppure aprilo già compilato:
Esegui questo prompt su HappyHorse 1.1 →. Descrive solo ciò che cambia dopo il fotogramma; l'immagine fissa già l'artista, l'uccello e la stanza. Il prompt resta in inglese, così com'è inviato al modello.
- Imposta Resolution su 720p e Duration su 5, poi esegui. In 720p costa 0,70 $, tre tentativi costano 2,10 $; a dieci secondi e 1080p ogni tentativo costa 1,80 $.
- Tieni la ripresa che ti piace e rilanciala in 1080p.
Per i riferimenti, apri la pagina reference-to-video, aggiungi le immagini in Reference images in un ordine fisso e numerale nel prompt come [Image 1], [Image 2] e [Image 3], indicando che cosa porta ciascuna. Dai a ogni immagine di riferimento un solo ruolo: più foto dello stesso soggetto vengono mediate anziché conciliate, e nove posti sono un tetto, non un obiettivo. Per le sole parole, usa la pagina text-to-video, dove è disponibile Aspect ratio, e descrivi nel prompt l'artista, l'uccello e la galleria.
Poi eseguilo da codice
Installa l'SDK Python (pip install spicyapi), imposta SPICY_API_KEY nell'ambiente del server ed esegui:
import uuid

from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

frame = client.upload_file("./opening-frame.png")  # becomes a spicy:// URI

task = client.create_task(
    model="alibaba/happyhorse-1.1/image-to-video",
    input_data={
        "image_url": frame["uri"],
        "prompt": "One continuous medium shot. The adult artist gently lowers the blue ceramic bird "
                  "onto the pedestal, releases it, draws both hands back and pauses. "
                  "Keep the camera still. Quiet gallery ambience and one soft ceramic contact sound. "
                  "No cuts or added people.",
        "duration_seconds": 5,
        "resolution": "720p",
        "seed": 240103,
    },
    idempotency_key=str(uuid.uuid4()),  # new key per new request; reuse only to retry the same one
)

print("Resume task:", task["taskId"], flush=True)
final = client.wait_for_terminal(task["taskId"])
if final["state"] != "succeeded":
    raise RuntimeError(f"Task {task['taskId']} ended as {final['state']}")
assets = output_assets(final)
if not assets or any(a.get("pending") or a.get("unavailable") or not a.get("url") for a in assets):
    raise RuntimeError(f"Task {task['taskId']} has no ready output; check this task before a new run")
print(assets[0]["url"])
Per reference-to-video cambia il modello e usa reference_image_urls; text-to-video accetta solo il prompt, aspect_ratio, duration_seconds e resolution. Attesa, errori e nuovi tentativi sono nella guida alle attività e nel riferimento dell'SDK Python.
Oppure lascia che lo esegua un agente
Quando le clip deve generarle un assistente, la CLI, il server MCP e l'Agent Skill leggono tutti lo schema attuale; CLI e MCP mostrano il prezzo e chiedono conferma prima di una chiamata a pagamento. Con lo stesso oggetto input in input.json:
npx @spicyapi/cli tasks create --model alibaba/happyhorse-1.1/image-to-video --input-file input.json --waitCon MCP, chiedi: «Anima ./opening-frame.png con HappyHorse 1.1 image-to-video»; l'assistente chiama spicyapi_upload_file e poi spicyapi_task_create. npx skills add spicyapi-ai/spicy-skill installa la Skill.
Risolvi il guasto specifico
| Sintomo | Prossima azione |
|---|---|
aspect_ratio sconosciuto su image-to-video | Rimuovi il campo e ritaglia l'immagine iniziale nella forma voluta prima dell'upload |
seed sconosciuto su text-to-video | Rimuovi seed; questa attività non lo espone |
invalid_asset su un'immagine | L'URL ha restituito una pagina web; carica il file e usa il suo URI spicy:// |
| Posa finale sbagliata nonostante un buon primo fotogramma | Semplifica l'azione; non esiste un input per il fotogramma finale che fissi la conclusione |
| L'oggetto si fonde con una mano | Accorcia il movimento e tieni ferma la camera |
| Una scena notturna diventa giorno | Mantieni una sola ora del giorno, nomina la lampada o la luce lunare visibile, togli alba e passare del tempo; controlla la clip intera |
| Il posizionamento finisce dopo la fine della clip | Togli dal prompt l'ingresso in scena, oppure porta la durata da 5 a 7 secondi (0,98 $ in 720p) |
| Volti o oggetti di riferimento si confondono | Dai a ogni immagine un solo soggetto e nominalo accanto al tag [Image N] |
| Immagine buona, colonna sonora indesiderata | Silenzia o sostituisci la traccia nel tuo editor; non esiste un parametro per disattivare l'audio |
content_rejected | Il filtro dell'attività ha rifiutato la richiesta; cambiare durata o risoluzione non serve. Text-to-video è l'attività filtrata, quindi l'alternativa è un primo fotogramma su image-to-video |
Definisci l'inquadratura con bozze economiche in 720p, poi blocca l'immagine approvata o l'insieme di riferimenti e rilancia per la consegna. Pianifica un evento leggibile per ogni clip da 5 secondi: una risoluzione più alta ingrandisce un'interazione fatta male, non la ripara.