Utilisez image-to-video quand vous avez une image de départ validée, reference-to-video quand des images distinctes fournissent le personnage, la tenue, l'objet ou le lieu, et text-to-video quand vous n'avez que des mots. Les trois coûtent 0,14 $ par seconde en 720p ou 0,18 $ en 1080p : un clip de cinq secondes revient donc à 0,70 $ ou 0,90 $, et le choix porte sur le contrôle, pas sur le prix. Image-to-video et reference-to-video sont des endpoints uncensored ; text-to-video est filtré.
Quelle tâche envoyer
| Ce que vous avez | ID du modèle et entrées obligatoires | À choisir quand | Limite à prévoir |
|---|---|---|---|
| Une scène écrite | alibaba/happyhorse-1.1/text-to-video ; prompt | Vous cherchez encore le cadrage, la lumière et le rythme, ou il vous faut vite un format précis | Visage, tenue et cadrage sont laissés au modèle, donc les relances dérivent |
| Une image validée | alibaba/happyhorse-1.1/image-to-video ; prompt, image_url | Le clip doit correspondre à une image qui existe déjà | Pas de champ de format (l'image fixe la forme) et pas d'image de fin : l'action doit se conclure d'elle-même |
| De une à neuf images aux rôles différents | alibaba/happyhorse-1.1/reference-to-video ; prompt, reference_image_urls | Vous combinez personnage, tenue, accessoire et lieu, ou réutilisez une même distribution d'un plan à l'autre | Un rôle par image ; des images uniquement, pas de référence vidéo ni audio |
Les trois acceptent un prompt de 1 à 2 500 caractères, duration_seconds de 3 à 15 (5 par défaut) et resolution à 720p (par défaut) ou 1080p. Sur cette plage, un clip coûte de 0,42 $ à 2,10 $ en 720p et de 0,54 $ à 2,70 $ en 1080p : faites vos brouillons en 720p, puis relancez en 1080p la prise qui vous plaît ; la nouvelle exécution produit une nouvelle prise, même avec les mêmes mots.
- Format d'image : les tâches texte et référence acceptent un ratio ; image-to-video suit votre image, recadrez-la donc d'abord.
- Seed : tâches image et référence uniquement. Gardez-le fixe et ne changez qu'un élément à la fois.
- Son : toujours généré, sans champ pour le couper ; coupez-le ou remplacez-le dans votre logiciel de montage.
- Non acceptés :
last_image_urletnegative_prompt.
La taille des images, celle des références et les limites d'upload figurent sur chaque page de modèle.
Le contenu pour adultes dépend de la tâche
D'après nos tests de septembre 2026, image-to-video a livré toutes les catégories adultes essayées, des scènes suggestives aux plus intenses : une image de personnage adulte est donc le point de départ le plus sûr. Reference-to-video est lui aussi uncensored. Text-to-video a accepté les prompts légers mais refusé net les plus intenses au lieu de les atténuer. Si une scène doit arriver au modèle sans altération, construisez-la à partir d'une image. Les résultats par catégorie figurent dans les tests NSFW de HappyHorse 1.1 (cet article n'existe pour l'instant qu'en anglais) ; la page du modèle HappyHorse 1.1 montre les tâches actuelles.
Essayer d'abord dans le Playground
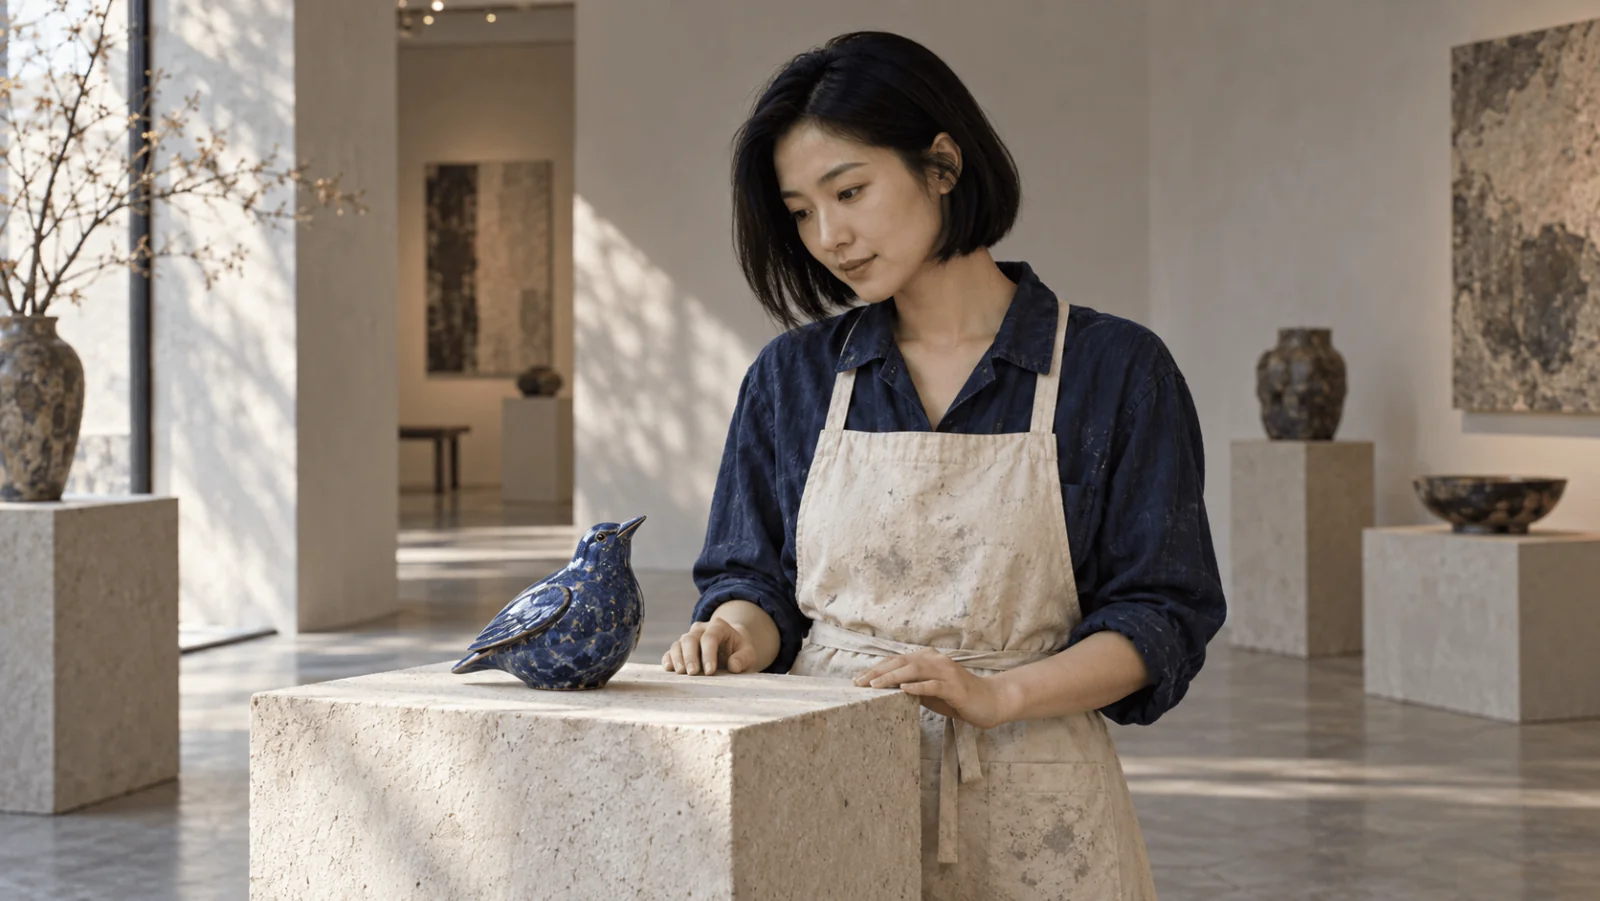
Exemple : animer le portrait d'une céramiste fictive de 35 ans, en chemise indigo et tablier crème, qui tient un oiseau en céramique bleue juste au-dessus d'un piédestal, les deux mains et le piédestal dans le cadre.
- Ouvrez la page image-to-video, restez sur l'onglet Playground en vue Form et connectez-vous pour lancer.
- Sous Input image, déposez votre propre portrait autorisé (JPG, PNG, WEBP ou GIF, jusqu'à 10 Mo) ou collez son Asset URL.
- Collez le prompt ci-dessous, ou ouvrez-le déjà rempli :
Lancer ce prompt avec HappyHorse 1.1 →. Il décrit seulement ce qui change après l'image ; l'image fixe déjà l'artiste, l'oiseau et la pièce. Le prompt reste en anglais, tel qu'il est envoyé au modèle.
- Réglez Resolution sur 720p et Duration sur 5, puis lancez. En 720p, cela coûte 0,70 $, et trois essais 2,10 $ ; pour dix secondes en 1080p, chaque essai coûte 1,80 $.
- Gardez la prise qui vous plaît et relancez-la en 1080p.
Pour des références, ouvrez la page reference-to-video, ajoutez les images sous Reference images dans un ordre fixe et numérotez-les dans le prompt [Image 1], [Image 2] et [Image 3], en nommant ce que chacune apporte. Donnez un seul rôle à chaque image : plusieurs photos d'un même sujet sont moyennées au lieu d'être réconciliées, et neuf emplacements sont un plafond, pas un objectif. Pour les mots seuls, utilisez la page text-to-video, où Aspect ratio est disponible, et décrivez l'artiste, l'oiseau et la galerie dans le prompt.
Puis l'exécuter depuis le code
Installez le SDK Python (pip install spicyapi), définissez SPICY_API_KEY dans l'environnement de votre serveur, puis lancez :
import uuid

from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

frame = client.upload_file("./opening-frame.png")  # becomes a spicy:// URI

task = client.create_task(
    model="alibaba/happyhorse-1.1/image-to-video",
    input_data={
        "image_url": frame["uri"],
        "prompt": "One continuous medium shot. The adult artist gently lowers the blue ceramic bird "
                  "onto the pedestal, releases it, draws both hands back and pauses. "
                  "Keep the camera still. Quiet gallery ambience and one soft ceramic contact sound. "
                  "No cuts or added people.",
        "duration_seconds": 5,
        "resolution": "720p",
        "seed": 240103,
    },
    idempotency_key=str(uuid.uuid4()),  # new key per new request; reuse only to retry the same one
)

print("Resume task:", task["taskId"], flush=True)
final = client.wait_for_terminal(task["taskId"])
if final["state"] != "succeeded":
    raise RuntimeError(f"Task {task['taskId']} ended as {final['state']}")
assets = output_assets(final)
if not assets or any(a.get("pending") or a.get("unavailable") or not a.get("url") for a in assets):
    raise RuntimeError(f"Task {task['taskId']} has no ready output; check this task before a new run")
print(assets[0]["url"])
Pour reference-to-video, changez de modèle et utilisez reference_image_urls ; text-to-video n'accepte que le prompt, aspect_ratio, duration_seconds et resolution. L'attente, les erreurs et les relances sont décrites dans le guide des tâches et la référence du SDK Python.
Ou laisser un agent l'exécuter
Quand un assistant doit lancer les clips, la CLI, le serveur MCP et l'Agent Skill lisent tous le schéma en vigueur ; la CLI et le MCP affichent le prix et demandent confirmation avant un appel payant. Avec le même objet input dans input.json :
npx @spicyapi/cli tasks create --model alibaba/happyhorse-1.1/image-to-video --input-file input.json --waitAvec MCP, demandez : « Anime ./opening-frame.png avec HappyHorse 1.1 image-to-video » ; l'assistant appelle spicyapi_upload_file puis spicyapi_task_create. npx skills add spicyapi-ai/spicy-skill installe le Skill.
Corriger l'échec précis
| Symptôme | Action suivante |
|---|---|
aspect_ratio inconnu sur image-to-video | Retirer le champ et recadrer l'image de départ au format voulu avant l'upload |
seed inconnu sur text-to-video | Retirer seed ; cette tâche ne l'expose pas |
invalid_asset sur une image | L'URL a renvoyé une page web ; téléverser le fichier et utiliser son URI spicy:// |
| Mauvaise pose finale malgré une bonne première image | Simplifier l'action ; aucune entrée d'image de fin ne fixe la conclusion |
| L'objet fusionne avec une main | Raccourcir le mouvement et garder la caméra fixe |
| Une scène de nuit devient du plein jour | Garder un seul moment de la journée, nommer la lampe ou la lune visible, retirer lever de soleil et passage du temps ; examiner le clip entier |
| La pose de l'objet se termine après la fin du clip | Retirer l'entrée en marche du prompt, ou passer la durée de 5 à 7 secondes (0,98 $ en 720p) |
| Les visages ou objets de référence se mélangent | Donner un seul sujet à chaque image et nommer ce sujet à côté de sa balise [Image N] |
| Bonne image, bande-son indésirable | Couper ou remplacer la piste dans votre logiciel de montage ; il n'existe aucun paramètre pour couper le son |
content_rejected | Le filtre de la tâche a refusé la requête ; changer durée ou résolution n'y fait rien. Text-to-video est la tâche filtrée : une image de départ en image-to-video est l'alternative |
Réglez le cadrage avec des brouillons 720p peu coûteux, puis verrouillez l'image validée ou le jeu de références et relancez pour la livraison. Prévoyez un événement lisible par clip de 5 secondes : une résolution plus haute agrandit une interaction ratée, elle ne la répare pas.