Nimm Image-to-Video, wenn du ein freigegebenes Anfangsbild hast, Reference-to-Video, wenn einzelne Bilder Figur, Outfit, Objekt oder Ort liefern, und Text-to-Video, wenn du nur Worte hast. Alle drei kosten 0,14 $ pro Sekunde in 720p oder 0,18 $ in 1080p; ein Clip von fünf Sekunden kostet also 0,70 $ oder 0,90 $, und die Wahl betrifft die Kontrolle, nicht den Preis. Image-to-Video und Reference-to-Video sind Uncensored-Endpunkte; Text-to-Video ist gefiltert.
Welche Aufgabe du senden solltest
| Was du hast | Modell-ID und Pflichtfelder | Wähle sie, wenn | Grenze, die du einplanen solltest |
|---|---|---|---|
| Eine geschriebene Szene | alibaba/happyhorse-1.1/text-to-video; prompt | Du Bildausschnitt, Licht und Tempo erst noch festlegst oder schnell ein bestimmtes Seitenverhältnis brauchst | Gesicht, Kleidung und Bildausschnitt überlässt du dem Modell, deshalb weichen Wiederholungen ab |
| Ein freigegebenes Standbild | alibaba/happyhorse-1.1/image-to-video; prompt, image_url | Der Clip zu einem bereits vorhandenen Bild passen muss | Kein Feld für das Seitenverhältnis (das Bild bestimmt die Form) und kein Schlussbild, die Handlung muss also von selbst zu Ende kommen |
| Ein bis neun Bilder mit verschiedenen Aufgaben | alibaba/happyhorse-1.1/reference-to-video; prompt, reference_image_urls | Du Figur, Outfit, Requisite und Ort kombinierst oder dieselbe Besetzung in mehreren Einstellungen wiederverwendest | Eine Aufgabe pro Bild; nur Bilder, keine Video- oder Audioreferenzen |
Alle drei nehmen einen Prompt mit 1 bis 2.500 Zeichen, duration_seconds von 3 bis 15 (Standard 5) und resolution mit 720p (Standard) oder 1080p. Über diesen Bereich kostet ein Clip 0,42 $ bis 2,10 $ in 720p und 0,54 $ bis 2,70 $ in 1080p. Entwirf also in 720p und wiederhole die Version, die dir gefällt, in 1080p; der neue Lauf liefert auch bei gleichem Wortlaut eine neue Version.
- Seitenverhältnis: Text- und Referenzaufgabe nehmen ein Seitenverhältnis; Image-to-Video folgt deinem Bild, beschneide es also vorher.
- Seed: nur bei Bild- und Referenzaufgabe. Halte ihn fest und ändere immer nur eine Sache.
- Ton: wird immer erzeugt, es gibt kein Feld zum Abschalten; schalte ihn in deinem Schnittprogramm stumm oder ersetze ihn.
- Nicht akzeptiert:
last_image_urlundnegative_prompt.
Bildgröße, Referenzgröße und Upload-Limits stehen auf der jeweiligen Modellseite.
Erwachsene Inhalte hängen von der Aufgabe ab
Nach unseren Tests vom September 2026 hat Image-to-Video jede erwachsene Kategorie geliefert, die wir probiert haben, von andeutenden Szenen bis zu den intensivsten; ein Bild einer erwachsenen Figur ist deshalb der sicherste Ausgangspunkt. Auch Reference-to-Video ist uncensored. Text-to-Video bestand leichtere Prompts, lehnte intensivere aber ganz ab, statt sie abzuschwächen. Muss eine Szene unverändert beim Modell ankommen, baue sie aus einem Bild auf. Die Ergebnisse nach Kategorie stehen in den HappyHorse-1.1-NSFW-Tests (dieser Artikel liegt bisher nur auf Englisch vor); die HappyHorse-1.1-Modellseite zeigt die aktuellen Aufgaben.
Zuerst im Playground ausprobieren
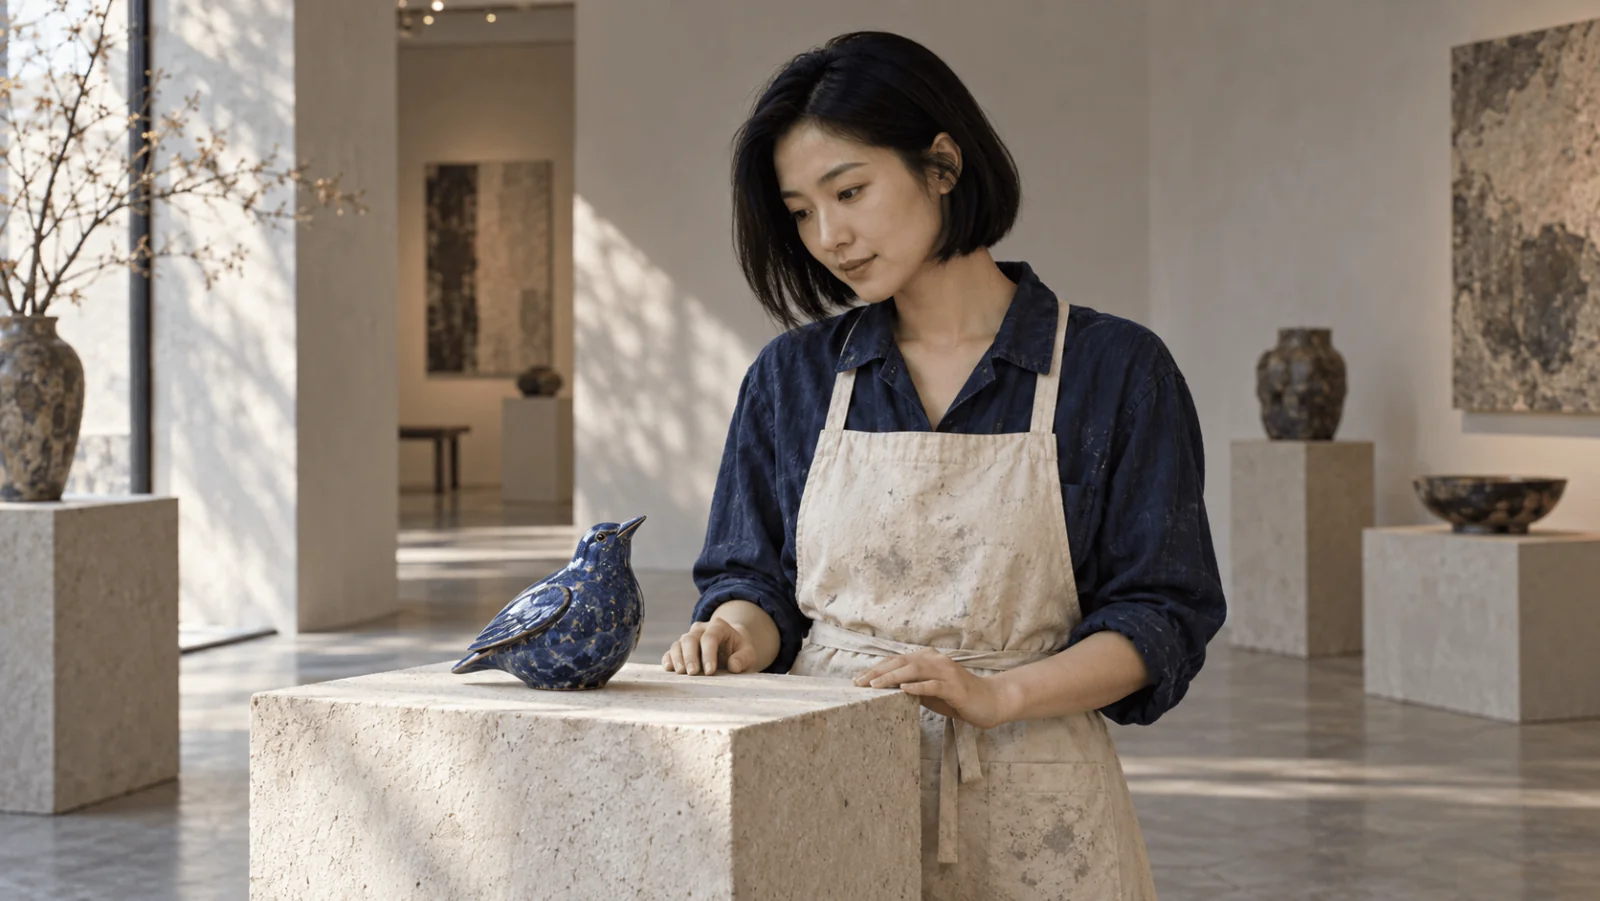
Beispiel: ein Porträt einer fiktiven 35-jährigen Keramikkünstlerin in indigoblauem Hemd und cremefarbener Schürze animieren, die einen blauen Keramikvogel knapp über einem Sockel hält, beide Hände und der Sockel im Bild.
- Öffne die Seite Image-to-Video, bleib im Tab Playground in der Ansicht Form und melde dich zum Ausführen an.
- Ziehe unter Input image dein eigenes, freigegebenes Porträt hinein (JPG, PNG, WEBP oder GIF, bis 10 MB) oder füge dessen Asset URL ein.
- Füge den folgenden Prompt ein oder öffne ihn vorausgefüllt:
Diesen Prompt mit HappyHorse 1.1 ausführen →. Der Prompt beschreibt nur, was nach dem Anfangsbild passiert; Künstlerin, Vogel und Raum legt das Bild bereits fest. Der Prompt steht auf Englisch, so wie er an das Modell geht.
- Stelle Resolution auf 720p und Duration auf 5 und starte. In 720p kostet das 0,70 $, drei Versuche kosten 2,10 $; bei zehn Sekunden und 1080p kostet jeder Versuch 1,80 $.
- Behalte die Version, die dir gefällt, und wiederhole sie in 1080p.
Für Referenzen öffne die Seite Reference-to-Video, füge die Bilder unter Reference images in fester Reihenfolge hinzu und nummeriere sie im Prompt als [Image 1], [Image 2] und [Image 3], jeweils mit dem Beitrag des Bildes. Gib jedem Referenzbild eine Aufgabe: Mehrere Fotos desselben Motivs werden gemittelt statt abgeglichen, und neun Plätze sind eine Obergrenze, kein Ziel. Für reinen Text nutze die Seite Text-to-Video, auf der Aspect ratio verfügbar ist, und beschreibe Künstlerin, Vogel und Galerie im Prompt.
Dann per Code ausführen
Installiere das Python-SDK (pip install spicyapi), setze SPICY_API_KEY in deiner Server-Umgebung und führe aus:
import uuid

from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

frame = client.upload_file("./opening-frame.png")  # becomes a spicy:// URI

task = client.create_task(
    model="alibaba/happyhorse-1.1/image-to-video",
    input_data={
        "image_url": frame["uri"],
        "prompt": "One continuous medium shot. The adult artist gently lowers the blue ceramic bird "
                  "onto the pedestal, releases it, draws both hands back and pauses. "
                  "Keep the camera still. Quiet gallery ambience and one soft ceramic contact sound. "
                  "No cuts or added people.",
        "duration_seconds": 5,
        "resolution": "720p",
        "seed": 240103,
    },
    idempotency_key=str(uuid.uuid4()),  # new key per new request; reuse only to retry the same one
)

print("Resume task:", task["taskId"], flush=True)
final = client.wait_for_terminal(task["taskId"])
if final["state"] != "succeeded":
    raise RuntimeError(f"Task {task['taskId']} ended as {final['state']}")
assets = output_assets(final)
if not assets or any(a.get("pending") or a.get("unavailable") or not a.get("url") for a in assets):
    raise RuntimeError(f"Task {task['taskId']} has no ready output; check this task before a new run")
print(assets[0]["url"])
Für Reference-to-Video tauschst du das Modell und nutzt reference_image_urls; Text-to-Video nimmt nur den Prompt, aspect_ratio, duration_seconds und resolution. Warten, Fehler und Wiederholungen stehen im Task-Leitfaden und in der Python-SDK-Referenz.
Oder von einem Agenten ausführen lassen
Soll ein Assistent die Clips erzeugen, lesen die CLI, der MCP-Server und der Agent Skill alle das aktuelle Schema; CLI und MCP zeigen den Preis und bitten vor einem kostenpflichtigen Aufruf um Bestätigung. Mit demselben input-Objekt in input.json:
npx @spicyapi/cli tasks create --model alibaba/happyhorse-1.1/image-to-video --input-file input.json --waitBei MCP bittest du: „Animiere ./opening-frame.png mit HappyHorse 1.1 Image-to-Video“; der Assistent ruft spicyapi_upload_file und dann spicyapi_task_create auf. npx skills add spicyapi-ai/spicy-skill installiert den Skill.
Den konkreten Fehler beheben
| Symptom | Nächster Schritt |
|---|---|
Unbekanntes aspect_ratio bei Image-to-Video | Das Feld entfernen und das Anfangsbild vor dem Upload auf die gewünschte Form zuschneiden |
Unbekanntes seed bei Text-to-Video | seed entfernen; diese Aufgabe bietet es nicht an |
invalid_asset bei einem Bild | Die URL lieferte eine Webseite; die Datei hochladen und ihre spicy://-URI verwenden |
| Falsche Endpose trotz gutem ersten Bild | Die Handlung vereinfachen; es gibt keine Schlussbild-Eingabe, die das Ende festlegt |
| Objekt verschmilzt mit einer Hand | Die Bewegung kürzen und die Kamera ruhig halten |
| Nachtszene wird zu Tageslicht | Eine Tageszeit beibehalten, die sichtbare Lampe oder das Mondlicht nennen, Sonnenaufgang oder Zeitablauf streichen; den ganzen Clip prüfen |
| Das Abstellen endet erst nach dem Clipende | Das Hereingehen aus dem Prompt streichen oder die Dauer von 5 auf 7 Sekunden erhöhen (0,98 $ in 720p) |
| Referenzgesichter oder -objekte verschwimmen | Jedem Bild ein Motiv geben und dieses Motiv neben dem [Image N]-Tag nennen |
| Gutes Bild, unerwünschter Soundtrack | Die Spur im Schnittprogramm stummschalten oder ersetzen; es gibt keinen Parameter zum Abschalten |
content_rejected | Der Filter der Aufgabe hat die Anfrage abgelehnt; Dauer oder Auflösung zu ändern hilft nicht. Text-to-Video ist die gefilterte Aufgabe, eine Alternative ist daher ein Anfangsbild bei Image-to-Video |
Lege den Bildausschnitt mit günstigen 720p-Entwürfen fest, fixiere dann das freigegebene Bild oder den Referenzsatz und wiederhole den Lauf für die Auslieferung. Plane pro 5-Sekunden-Clip ein gut lesbares Ereignis: Eine höhere Auflösung vergrößert eine misslungene Interaktion, sie repariert sie nicht.