確定した開始フレームがあるなら image-to-video、キャラクター・衣装・小道具・場所を別々の画像で与えるなら reference-to-video、文章しかないなら text-to-video を使います。3つとも720pは1秒あたり$0.14、1080pは$0.18なので、5秒のクリップは$0.70または$0.90です。選ぶ基準は価格ではなく、どこまで制御できるかです。image-to-videoとreference-to-videoはuncensoredのエンドポイントで、text-to-videoはフィルタが適用されます。
どのタスクを送るか
| 手元にあるもの | モデルIDと必須入力 | 選ぶ場面 | 見込んでおく制限 |
|---|---|---|---|
| 文章のシーン | alibaba/happyhorse-1.1/text-to-video;prompt | 構図・光・テンポをまだ決めている途中、または特定のアスペクト比がすぐ必要なとき | 顔・衣装・構図はモデル任せなので、再実行すると変わります |
| 確定した静止画1枚 | alibaba/happyhorse-1.1/image-to-video;prompt、image_url | クリップを既存の画像に合わせたいとき | アスペクト比のフィールドがなく(形は画像で決まります)、終了フレームもないため、動作は自力で完結させる必要があります |
| 役割の異なる画像1~9枚 | alibaba/happyhorse-1.1/reference-to-video;prompt、reference_image_urls | キャラクター・衣装・小道具・場所を組み合わせる、または同じキャストを複数のショットで使い回すとき | 1枚につき役割は1つ。画像のみで、動画や音声の参照は使えません |
3つとも、1~2,500文字のプロンプト、3~15秒の duration_seconds(既定は5)、720p(既定)または 1080p の resolution を受け付けます。この範囲でクリップの料金は720pで$0.42~$2.10、1080pで$0.54~$2.70です。下書きは720pで作り、気に入ったテイクを1080pで再実行してください。同じ文言でも、再実行すれば新しいテイクになります。
- アスペクト比: テキストと参照のタスクは比率を指定できます。image-to-videoは画像に従うので、先に画像を切り抜いてください。
- Seed: 画像と参照のタスクのみ。固定したまま、一度に1つだけ変えてください。
- 音: 常に生成され、オフにするフィールドはありません。編集ソフトでミュートまたは差し替えてください。
- 受け付けないもの:
last_image_urlとnegative_prompt。
画像サイズ、参照画像のサイズ、アップロード上限は各モデルページに載っています。
成人向けコンテンツはタスクで変わります
2026年9月のテストでは、image-to-videoは試したすべての成人向けカテゴリを出力しました。示唆的なシーンから最も強度の高いものまで含まれるため、成人キャラクターの画像が最も確実な出発点です。reference-to-videoもuncensoredです。text-to-videoは穏やかなプロンプトは通りましたが、強度の高いものは和らげずに明確に拒否しました。シーンを改変なしでモデルに届けたいなら、画像から作ってください。カテゴリ別の結果はHappyHorse 1.1のNSFWテストにまとめています(この記事は現在英語のみです)。現在のタスクはHappyHorse 1.1のモデルページで確認できます。
まずPlaygroundで試す
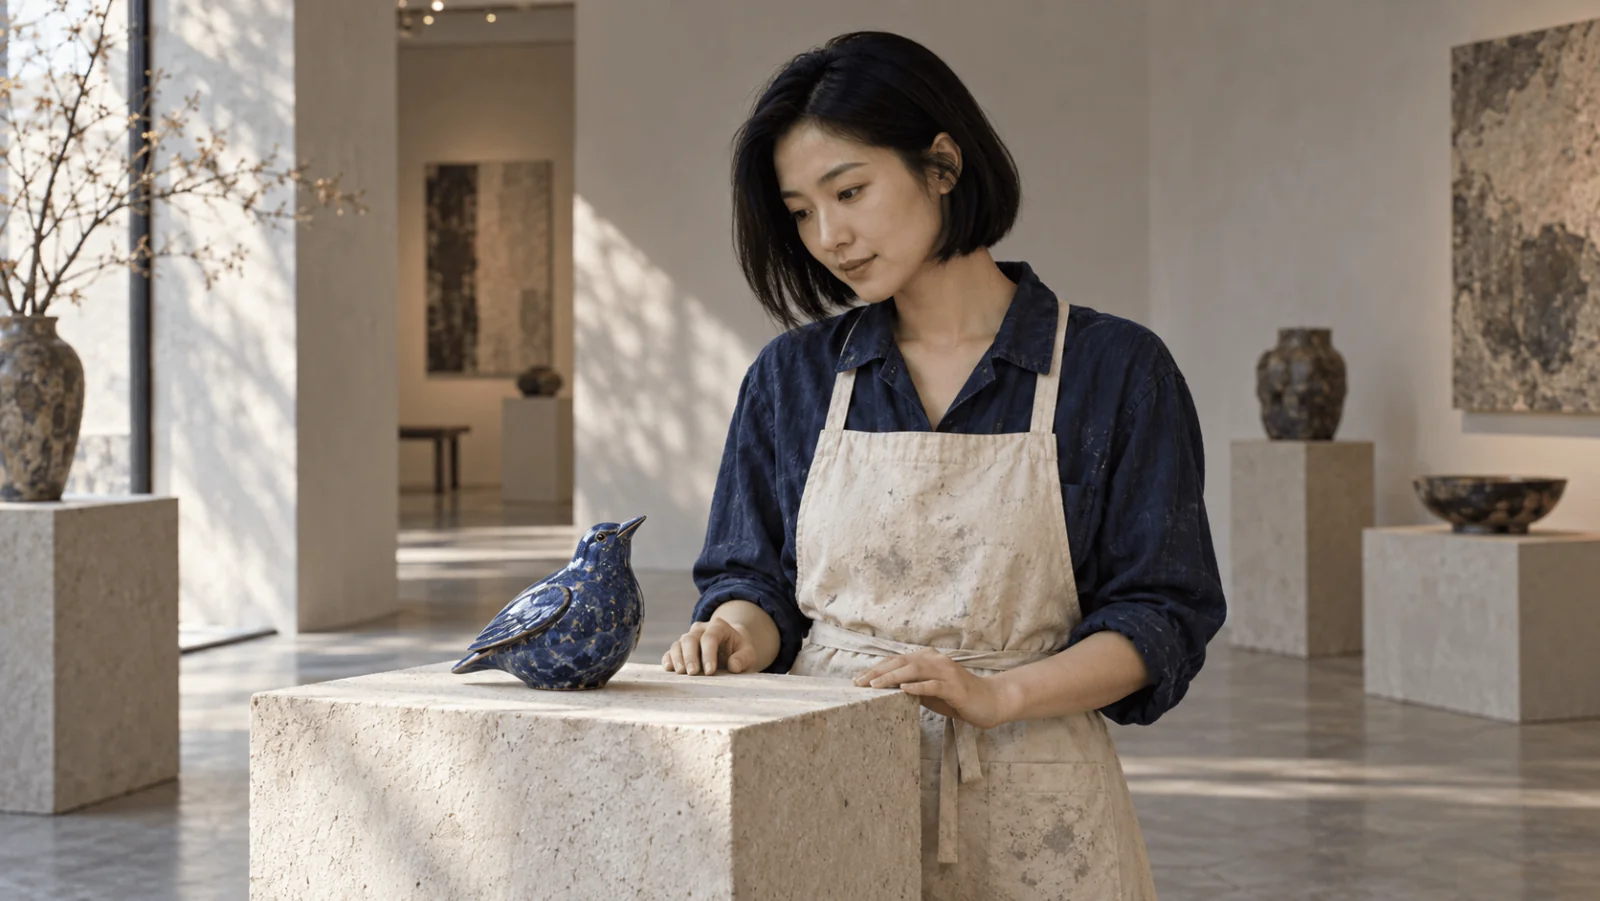
例:インディゴのシャツとクリーム色のエプロンを着た架空の35歳の陶芸家が、青い陶器の鳥を台座のすぐ上で持っているポートレートを動かします。両手と台座はフレーム内です。
- image-to-videoのページを開き、Playground タブの Form 表示のままサインインして実行します。
- Input image に、利用が許可された自分のポートレート(JPG、PNG、WEBP、GIF、最大10MB)をドロップするか、その Asset URL を貼り付けます。
- 下のプロンプトを貼り付けるか、入力済みの状態で開きます。
このプロンプトをHappyHorse 1.1で実行 →。フレームの後で変わることだけを書いています。陶芸家、鳥、部屋は画像がすでに決めています。プロンプトはモデルに送られる形のまま英語です。
- Resolution を720p、Duration を5にして実行します。720pでは$0.70、3回試すと$2.10です。10秒・1080pなら1回あたり$1.80です。
- 気に入ったテイクを残し、1080pで再実行します。
参照画像を使うなら、reference-to-videoのページを開き、Reference images に画像を決まった順序で追加します。プロンプトでは [Image 1]、[Image 2]、[Image 3] のように番号を付け、それぞれが何を担うかを書いてください。参照画像1枚に役割は1つにします。同じ被写体の写真を複数入れると、すり合わされず平均化されます。9スロットは上限であり、目標ではありません。文章だけなら、Aspect ratio を使えるtext-to-videoのページで、陶芸家・鳥・ギャラリーをプロンプトに書いてください。
次にコードから実行する
Python SDKをインストールし(pip install spicyapi)、サーバー環境に SPICY_API_KEY を設定して実行します。
import uuid

from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

frame = client.upload_file("./opening-frame.png")  # becomes a spicy:// URI

task = client.create_task(
    model="alibaba/happyhorse-1.1/image-to-video",
    input_data={
        "image_url": frame["uri"],
        "prompt": "One continuous medium shot. The adult artist gently lowers the blue ceramic bird "
                  "onto the pedestal, releases it, draws both hands back and pauses. "
                  "Keep the camera still. Quiet gallery ambience and one soft ceramic contact sound. "
                  "No cuts or added people.",
        "duration_seconds": 5,
        "resolution": "720p",
        "seed": 240103,
    },
    idempotency_key=str(uuid.uuid4()),  # new key per new request; reuse only to retry the same one
)

print("Resume task:", task["taskId"], flush=True)
final = client.wait_for_terminal(task["taskId"])
if final["state"] != "succeeded":
    raise RuntimeError(f"Task {task['taskId']} ended as {final['state']}")
assets = output_assets(final)
if not assets or any(a.get("pending") or a.get("unavailable") or not a.get("url") for a in assets):
    raise RuntimeError(f"Task {task['taskId']} has no ready output; check this task before a new run")
print(assets[0]["url"])
reference-to-videoではモデルを入れ替えて reference_image_urls を使います。text-to-videoが受け付けるのはプロンプト、aspect_ratio、duration_seconds、resolution だけです。待機、エラー、再試行はタスクガイドとPython SDKリファレンスにあります。
またはエージェントに実行させる
アシスタントにクリップを実行させるなら、CLI、MCPサーバー、Agent Skillはいずれも現行のスキーマを読み取り、CLIとMCPは有料呼び出しの前に料金を表示して確認を求めます。同じ input オブジェクトを input.json に置いて実行します。
npx @spicyapi/cli tasks create --model alibaba/happyhorse-1.1/image-to-video --input-file input.json --waitMCPでは「HappyHorse 1.1のimage-to-videoで ./opening-frame.png を動かして」と依頼します。アシスタントは spicyapi_upload_file を呼び出し、続けて spicyapi_task_create を呼び出します。Skillは npx skills add spicyapi-ai/spicy-skill でインストールします。
具体的な不具合への対処
| 症状 | 次の対応 |
|---|---|
image-to-videoで未知の aspect_ratio | フィールドを削除し、アップロード前に開始画像を目的の形に切り抜く |
text-to-videoで未知の seed | seed を削除する。このタスクでは使えません |
画像で invalid_asset | URLがウェブページを返しています。ファイルをアップロードして、その spicy:// URIを使う |
| 最初のフレームは良いのに最後のポーズが違う | 動作を単純にする。結末を固定する終了フレームの入力はありません |
| 物体が手と融合する | 動きを短くし、カメラを固定する |
| 夜のシーンが昼になる | 時間帯を1つに保ち、見えているランプや月明かりを明記し、日の出や時間経過の表現を外す。クリップ全体を確認する |
| 置く動作がクリップの終了後に完了する | プロンプトから歩いて入る動作を外すか、長さを5秒から7秒に延ばす(720pで$0.98) |
| 参照した顔や物体が混ざる | 画像1枚につき被写体を1つにし、[Image N] タグの隣にその被写体を書く |
| 映像は良いが不要なサウンドトラック | 編集ソフトでトラックをミュートまたは差し替える。音をオフにするパラメータはありません |
content_rejected | タスクのフィルタがリクエストを拒否しました。長さや解像度を変えても解決しません。フィルタ対象はtext-to-videoなので、代わりにimage-to-videoで開始フレームを使います |
構図は安価な720pの下書きで固め、そのあと確定したフレームや参照画像のセットを固定して、納品用に再実行してください。5秒のクリップには、見て分かる出来事を1つだけ計画します。解像度を上げても、破綻した動きは大きく見えるだけで直りません。