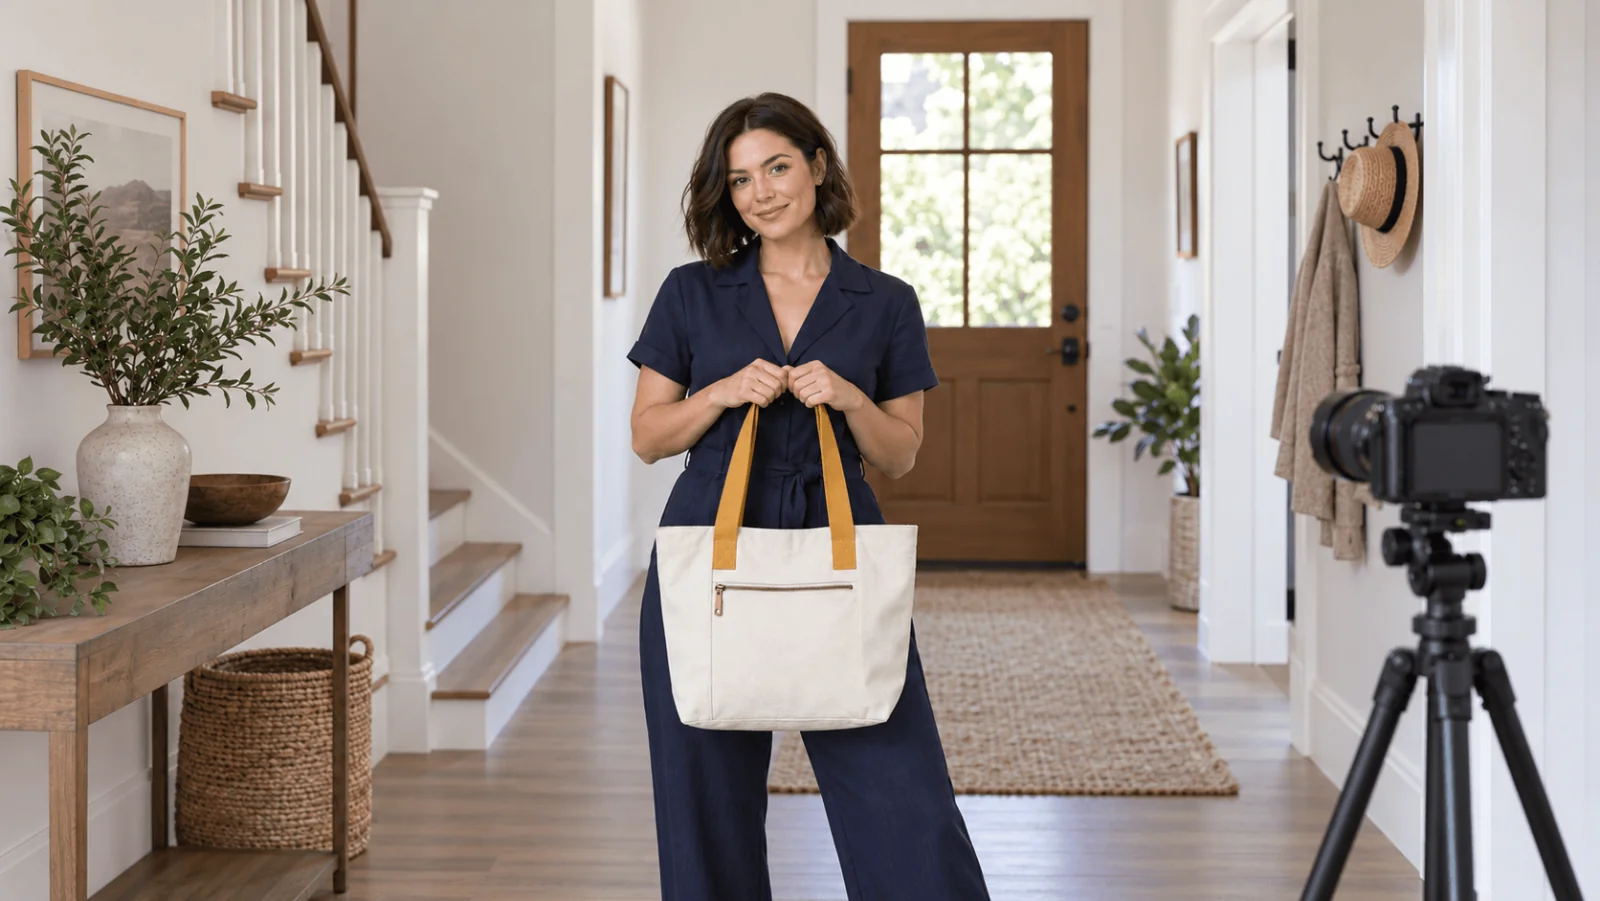
Zbuduj 12-sekundowe wideo produktowe w stylu UGC z AI z dwóch krótkich animowanych ujęć i jednego prawdziwego zdjęcia detalu produktu. Użyj Qwen Image 2.1 Edit, aby umieścić prezenterkę z produktem, i zatwierdź tę klatkę, a następnie ją animuj przez Seedance 2.5 image-to-video. Sprzedawana cecha produktu, tutaj suwak, zostaje prawdziwym zdjęciem, ponieważ model potrafi rozjechać się właśnie na detalach, które kupujący sprawdza. Przykład kosztuje około 2,89 $ opłat za model; każda dodatkowa próba kosztuje kilka centów (klatki) albo około 1,39 $ (5-sekundowy klip w 720p).
Prezenterką w przykładzie jest Lena, fikcyjna dorosła kobieta w granatowym kombinezonie, która niesie płócienną torbę w kolorze kremowym z dwiema musztardowymi rączkami i jedną zewnętrzną kieszenią suwakową. Podstaw własny produkt.
12-sekundowe cięcie i jego koszt
| Ostateczna oś czasu | Obraz | Jak zrobić | Narracja |
|---|---|---|---|
| 0–4 s (hak) | Lena unosi torbę do pozycji noszenia | Pięciosekundowy klip obraz na wideo, przycięty | "Proste noszenie codziennych rzeczy." |
| 4–8 s (dowód) | Zbliżenie na prawdziwą zewnętrzną kieszeń suwakową | Zatrzymaj zdjęcie produktu w edytorze lub powoli przesuń po nim | "Zewnętrzna kieszeń suwakowa trzyma drobiazgi osobno." |
| 8–12 s (zamknięcie) | Lena przy drzwiach, torba na ramieniu | Drugi pięciosekundowy klip, przycięty | "Gotowe, kiedy tylko zechcesz." |
Umieść twierdzenie w pierwszych sekundach i pozwól, by udowodniło je jedno ujęcie. Kreatywne wytyczne TikToka wymagają haka w pierwszych 6 sekundach, pionowej klatki 9:16 w 720p lub wyższej oraz wyraźnego wezwania do działania po pokazie. Jeśli reklama go potrzebuje, zamień zdanie końcowe na wezwanie do działania ("Kup torbę"). Mów tylko to, co może potwierdzić strona produktu: żadnych twierdzeń o wodoodporności, pojemności, wadze ani trwałości.
| Krok | Model i ustawienia | Cena katalogowa |
|---|---|---|
| Portret prezenterki, raz | Qwen Image 2.1 text-to-image, 1k, 9:16 | 0,024 $ |
| 2 klatki z prezenterką | Qwen Image 2.1 Edit, 1k, po dwie referencje każda | po 0,048 $; 0,036 $ przy jednej referencji, 0,06 $ przy trzech, więc każda dodatkowa referencja dokłada 0,012 $ |
| 2 klipy | Seedance 2.5 image-to-video, 720p, 5 s | po 1,3865 $ (0,2773 $ za sekundę); dźwięk włączony lub wyłączony kosztuje tyle samo |
| Zbliżenie na suwak, montaż, napisy | Twoje własne zdjęcie i twój edytor | Nienaliczane przez API |
| Razem, bez powtórzeń | 2,893 $ |
Zaplanuj powtórzenia. Najpierw obejrzyj klip w 480p (0,1234 $ za sekundę; najkrótszy, 4 sekundy, kosztuje 0,4936 $), żeby potwierdzić ruch. Render w 720p to nowe generowanie, a nie powiększenie podglądu, więc może potrzebować własnej powtórki. 1080p kosztuje 0,6823 $ za sekundę (3,41 $ za pięć sekund); używaj go tylko dla klatki, która jest już ostra. Realistyczny pułap to podgląd w 480p, jedno udane ujęcie w 720p i jedna powtórka w 720p na ujęcie: 0,49 $ + 1,39 $ + 1,39 $ = około 3,27 $ na ujęcie, 6,53 $ za oba klipy, plus około 0,12 $ za portret i dwie klatki. Pominięcie podglądu i dopuszczenie trzech prób w 720p na ujęcie kosztuje 8,32 $.
Przygotuj widok produktu, zanim dodasz prezenterkę
Użyj zdjęcia produktu od przodu, na którym widać obie rączki, kieszeń zewnętrzną i ogólne proporcje. Do środkowego ujęcia dodaj osobne zbliżenie na suwak. Jeśli produkt ma dokładne logo lub obowiązkowy tekst na opakowaniu, zachowaj te oryginalne piksele w kompozycji końcowej, zamiast prosić model o ich przepisanie.
Prezenterka zbudowana ze zdjęcia prawdziwej osoby może zostać odrzucona przez własne sprawdzenie danych wejściowych Seedance, gdy twarz jest rozpoznawalna. Użyj portretu fikcyjnego lub licencjonowanego i tego samego portretu we wszystkich ujęciach, aby twarz pozostała spójna. Aby go stworzyć, opisz prezenterkę w Qwen Image 2.1 text-to-image (0,024 $ za próbę, 1k, 9:16), zatwierdź jedną klatkę i używaj jej dalej. Przechowuj zatwierdzony portret i zdjęcia torby w miejscu, z którego znów je wyślesz: przesłane pliki i wyniki wygasają (patrz limity przesyłania i przechowywania), a wygenerowane pliki są usuwane po około 14 dniach.
Wypróbuj w Playground. Otwórz Qwen Image 2.1 Edit i zostań w zakładce Playground w widoku Form. Zaloguj się kontem z saldem, aby uruchomić.
- W sekcji Images użyj Add a file najpierw dla zatwierdzonego portretu Leny, potem dla zdjęcia torby. Staną się Picture 1 i Picture 2.
- Wklej poniższą instrukcję do Prompt. Qwen sam nie przypisuje ról, więc prompt musi powiedzieć, co daje każdy obraz.
- Ustaw Aspect ratio na 9:16, a Resolution na 1k. W sekcji Advanced parameters ustaw Output format na PNG i wyłącz Prompt expansion (dostępne przy 1k i 2k).
- Uruchom model i zatwierdź klatkę przed jej animacją.
Skopiuj tę instrukcję lub otwórz Playground z nią już uzupełnioną:
Picture 1 supplies Lena, a fictional adult woman with short dark hair wearing a closed navy jumpsuit. Picture 2 supplies the cream canvas tote with exactly two mustard handles and one external zip pocket. Show Lena standing in a bright apartment entryway, holding both tote handles together in her right hand at hip height. The tote front faces the camera, with its pocket visible. Keep the product's proportions, handle colour and closure design. Vertical medium-full composition, soft daylight, natural expression, no added text.
Do drugiej klatki otwierającej zmień tylko instrukcję noszenia:
Show the same adult presenter with the same tote hanging from her right shoulder, both mustard handles together over that shoulder. Her right hand rests lightly on the handles. She stands beside the doorway, facing slightly toward the camera. Keep the bag front and external pocket visible.
Klatka, którą wysyłasz do Seedance, musi mieć każdy bok od 300 do 6000 pikseli i ważyć mniej niż 10 MB; mniejsze obrazy są odrzucane, zanim zostaniesz obciążony. Zatwierdź każdą klatkę przed animacją: policz rączki, znajdź kieszeń, porównaj kolory ze zdjęciem. Zła klatka kosztuje 0,048 $ na wymianę; zły klip kosztuje 1,39 $. Jeśli Qwen wciąż robi inną kieszeń, naklej oryginalny wycinek torby na kompozycję z prezenterką i tłem.
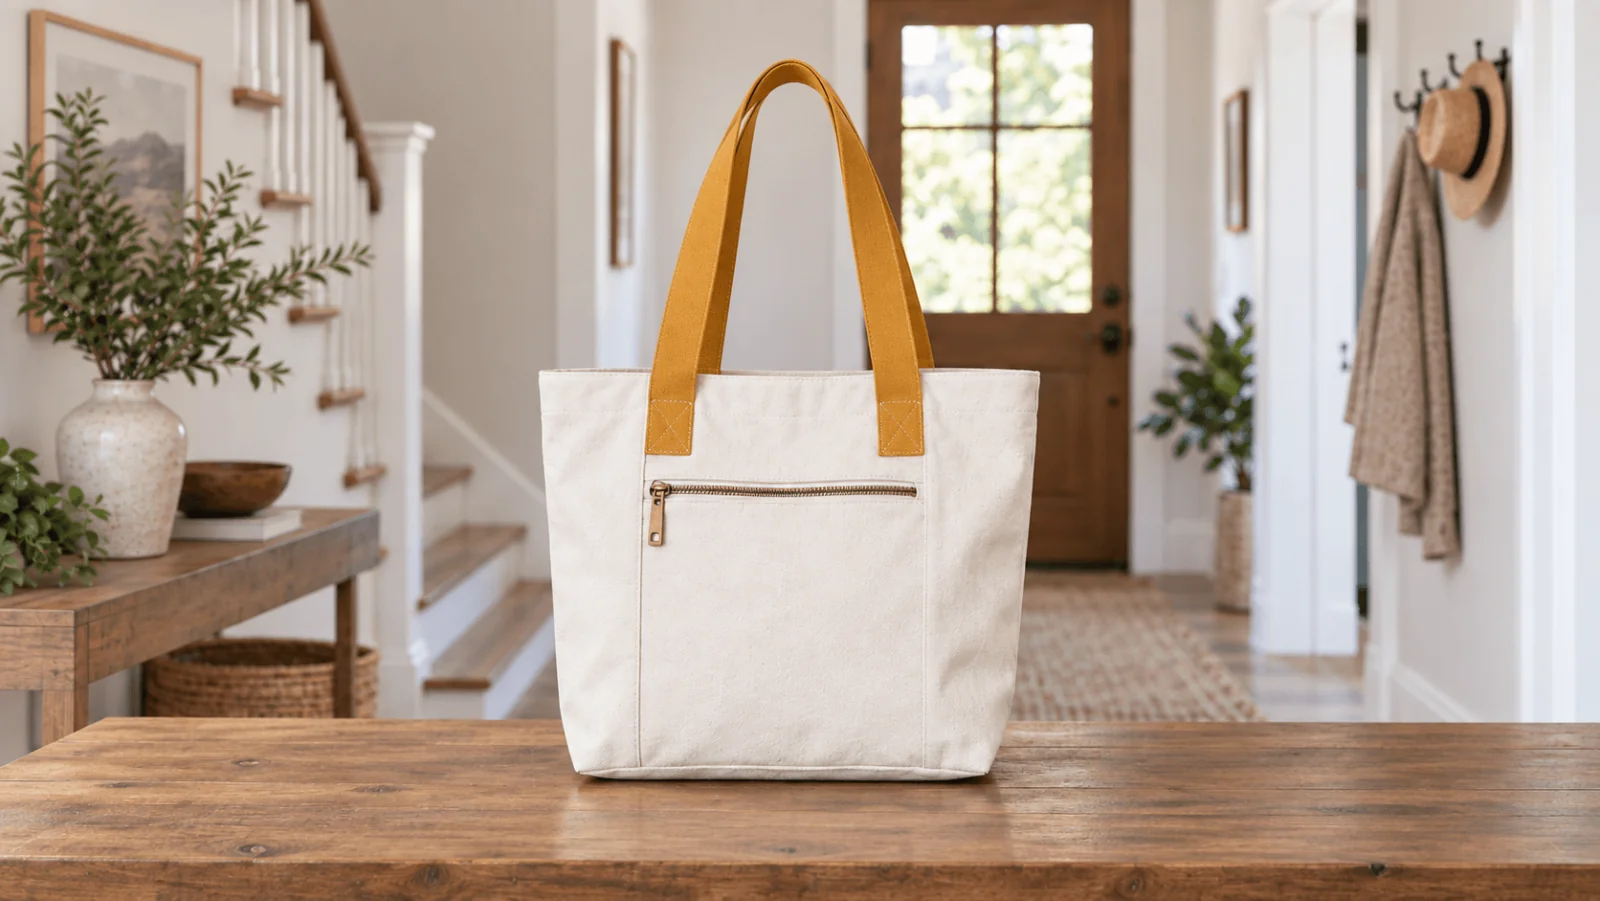
Ilustracja produktu: dwie rączki i zewnętrzna kieszeń suwakowa to fakty projektowe, których należy zachować; to nie jest zdjęcie prawdziwego produktu.
Animuj jedną małą akcję na ujęcie
Wypróbuj w Playground. Otwórz Seedance 2.5 image-to-video w zakładce Playground w widoku Form.
- W polu Input image dodaj pierwszą zatwierdzoną klatkę. Aspect ratio jest ustawiony zgodnie z obrazem wejściowym, więc najpierw przytnij klatkę lub wygeneruj ją w 9:16.
- Wklej prompt klipu poniżej do Prompt.
- Ustaw Resolution na 720p, Duration na 5 i wyłącz Generate audio. Czas trwa od 4 do 30 sekund; dłuższe ujęcia bardziej się rozjeżdżają, więc kilka krótkich ujęć lepiej utrzymuje produkt niż jedno długie.
- Uruchom model i obejrzyj klip przed zrobieniem kolejnego.
Pierwszy klip (otwórz z promptem już uzupełnionym):
The adult presenter gently raises the tote a few centimetres by its two handles, then holds it still at hip height. Her gaze moves briefly toward the camera. The cream canvas body, two mustard handles and external zip pocket keep their existing design. The bag does not rotate away from the viewer. Locked camera, subtle natural body movement, no text.
Klip przy drzwiach:
The adult presenter stands beside the doorway with the tote already on her right shoulder. She shifts her weight slightly and gives a small relaxed smile toward the camera. The tote remains on the same shoulder with both handles together. No walking, no putting on the bag, no pocket opening. Locked camera, no text.
"Załóż torbę, zasuń ją, wyjdź i uśmiechnij się" to za dużo dla jednego krótkiego klipu; zaczynając z torbą już na miejscu, usuwasz najtrudniejsze przejście. Do tego cięcia użyj zatwierdzonej klatki z torbą na ramieniu jako image_url dla klipu przy drzwiach; pierwszy klip kończy się torbą na wysokości bioder. Użyj return_last_frame i wyślij tę klatkę jako następną klatkę otwierającą tylko wtedy, gdy kontynuujesz z tego samego stanu końcowego.
Aby zamiast tego opisać klipy skryptem, wykonaj jedno wywołanie na klatkę (lokalna klatka jest najpierw wysyłana przez spicyapi files upload <path>, co zwraca link spicy:// dla image_url). Zobacz przewodnik obraz na wideo oraz dokumentację CLI:
spicyapi tasks create --model bytedance/seedance-2.5/image-to-video \
  --input-json '{"image_url":"https://example.com/lena-tote.png","prompt":"The adult presenter stands beside the doorway with the tote already on her right shoulder. She gives a small relaxed smile toward the camera. Locked camera, no text.","duration_seconds":5,"resolution":"720p","generate_audio":false}' \
  --wait
Albo pozwól, by wykonał to agent: daj mu CLI, serwer MCP (spicyapi_upload_file, potem spicyapi_task_create, który zatrzymuje się na potwierdzenie ceny) albo Skill (npx skills add spicyapi-ai/spicy-skill), który czyta bieżący schemat modelu zamiast zgadywać pola.
Złóż cięcie
Przytnij każdy 5-sekundowy klip do 4 sekund, umieść między nimi klatkę z suwakiem, dodaj głos lektora i podkład dźwiękowy, a potem wyeksportuj w 9:16, 720p lub wyższej. Aby przetestować haki, zrób trzy do pięciu wersji, które zmieniają tylko pierwsze 4 sekundy, a ujęcia produktu zostawiają identyczne.
Zrób ujęcie detalu produktu z prawdziwego zdjęcia
Umieść zbliżenie na suwak między dwoma klipami. Przytrzymaj je cztery sekundy z powolnym przesuwem w edytorze, który nigdy nie przycina zapięcia, i dodaj podpis cechy jako edytowalny tekst. Syntetyczne zbliżenie mogłoby wymyślić suwak, którego produkt nie ma.
Jeśli argumentem sprzedaży jest to, że suwak naprawdę się otwiera, zastąp przytrzymaną klatkę krótkim nagraniem z telefonu prawdziwej torby w trakcie rozsuwania, ciasno na kieszeń i ręce, z tą samą narracją na wierzchu. Klatka pokazuje, gdzie jest kieszeń; tylko prawdziwe nagranie pokazuje, jak działa mechanizm.
Dodaj głos, dźwięk i napisy
- Głos lektora, prezenterka milczy (wersja powyżej): zostaw
generate_audiowyłączone, nagraj narrację samodzielnie albo wygeneruj ją modelem syntezy mowy, dopasowując do 12 sekund, i podłóż pod wszystkie trzy ujęcia jedną ciągłą ścieżkę muzyki albo szumu pomieszczenia. Ścisz muzykę pod głosem. Dzięki temu unikasz też innego dźwięku pomieszczenia w każdym klipie. - Prezenterka mówi do kamery: włącz
generate_audioi zapisz zdanie w prompcie jako osobne linie dialogu i otoczenia; Seedance 2.5 generuje głos zsynchronizowany z obrazem. Trzymaj każdą wypowiedź w jednym krótkim zdaniu na 5-sekundowy klip i trzymaj torbę nieruchomo, gdy ona mówi. Aby zmienić słowa w klipie, który Ci się podoba, zobacz przepływ pracy synchronizacji ust. - Napisy: dodaj je w edytorze jako tekst, z dala od produktu i dolnej strefy interfejsu; wytyczne TikToka sugerują od 5 do 10 słów na sekundę tekstu na ekranie. Wygenerowana typografia może błędnie zapisać nazwę produktu.
Najpierw użyj własnej etykiety AI platformy: na przykład polityka reklamowa TikToka dopuszcza treści reklamowe w pełni wygenerowane przez AI, jeśli zastosujesz jej etykietę AIGC albo dodasz własne wyraźne zastrzeżenie, podpis, znak wodny lub naklejkę. Zasady różnią się w zależności od platformy i kraju. watermark: true dodatkowo oznacza wideo jako wygenerowane przez AI. Nie pisz w scenariuszu „Kupiłem to” ani nie opisuj własnego efektu; prezenterka jest fikcyjna, a narracja ma opisywać produkt.
Które produkty pasują do tego przepływu pracy
| Produkt | Dopasowanie | Dlaczego |
|---|---|---|
| Torba, plecak, butelka, kubek, pudełko | Dobre | Prosta sztywna forma, kilka detali do zachowania |
| Odzież w jednolitym kolorze | Dobre do ujęć noszenia i przymiarki | Sprawdzaj szwy, guziki i obszycie w każdej klatce |
| Drukowane tkaniny, drobny tekst na etykiecie, składy | Użyj prawdziwego nagrania lub nakładek | Model może przerobić drobny druk; nałóż zatwierdzony projekt w montażu |
| Urządzenia z ekranem, wszystko z działającym mechanizmem | Prawdziwe nagranie dla funkcji | Wygenerowane dotknięcie lub rozsunięcie nie dowodzi, że działa |
| Wyniki przed i po (skóra, czyszczenie, kondycja) | Nie generuj | Zmyślone wyniki wprowadzają kupujących w błąd |
Dla produktu oglądanego z kilku stron reference-to-video przyjmuje do 30 obrazów referencyjnych i kosztuje tyle samo co image-to-video, gdy nie podano klipu referencyjnego (0,2773 $ za sekundę w 720p). Nie ma on ustawienia pierwszej klatki, więc nie możesz wcześniej zatwierdzić klatki otwierającej. Użyj go dla kilku stron, a image-to-video dla dokładnej pierwszej klatki. Do statycznych układów reklamowych z tego samego zdjęcia zobacz od zdjęcia produktu do kreacji reklamowej; o brzmieniu promptów Seedance zobacz przewodnik po promptach Seedance 2.0.
Napraw typowe awarie
| Awaria | Naprawa |
|---|---|
| Rączki zamieniają się w trzy paski | Wróć do klatki i wskaż dwie rączki razem; jeśli liczba jest już zła, wymień klatkę. |
| Logo torby zmienia się w trakcie ruchu | Użyj spokojniejszego ujęcia albo nałóż zatwierdzony projekt etykiety w montażu końcowym. |
| Suwak znika pod dłonią | Trzymaj dłoń na rączkach, nie na kieszeni; do cechy użyj osobnego zbliżenia. |
| Pasek na ramię zmienia stronę | Usuń akcję unoszenia torby na ramię i zacznij z torbą już na prawym ramieniu. |
| Twarz prezenterki różni się między ujęciami | Używaj tego samego zatwierdzonego portretu jako Picture 1 dla każdej klatki. |
| Drugi klip ma inny dźwięk pomieszczenia | Zostaw wygenerowany dźwięk wyłączony i podłóż pod wszystkie trzy ujęcia jedną zewnętrzną ścieżkę dźwiękową. |
| Rozmiar lub kolor torby zmienia się w trakcie klipu | Skróć klip, uprość ruch i porównaj pierwszą i ostatnią klatkę ze zdjęciem. |
Oglądaj każdy klip na pierwszej klatce, w momencie kontaktu i na ostatniej klatce, porównując liczbę rączek, położenie kieszeni, kolor i logo ze zdjęciem. Animacje pokazują noszenie; prawdziwe zbliżenie pokazuje cechę.