Masz scenę trwającą 30–40 sekund i chcesz, żeby zmontowała się jak dramat, a nie jak sześć ładnych klipów. Zapisz zmianę sceny w jednym zdaniu, rozbij ją na widoczne działania i daj każdemu działaniu własne ujęcie: jedną klatkę still, jeden prompt ruchu, jeden punkt cięcia. Przykład z sześcioma ujęciami poniżej kosztuje 9,9828 $ w Seedance 2.5 obraz na wideo w 720p, a jedno ujęcie, które trzeba powtórzyć, kosztuje 1,6638 $. Grupowanie ujęć w dłuższe zlecenia nie zmienia sumy za sekundę, ale zmienia koszt powtórki (patrz sekcja o długim ujęciu).
Historia, która mieści się w sześciu ujęciach
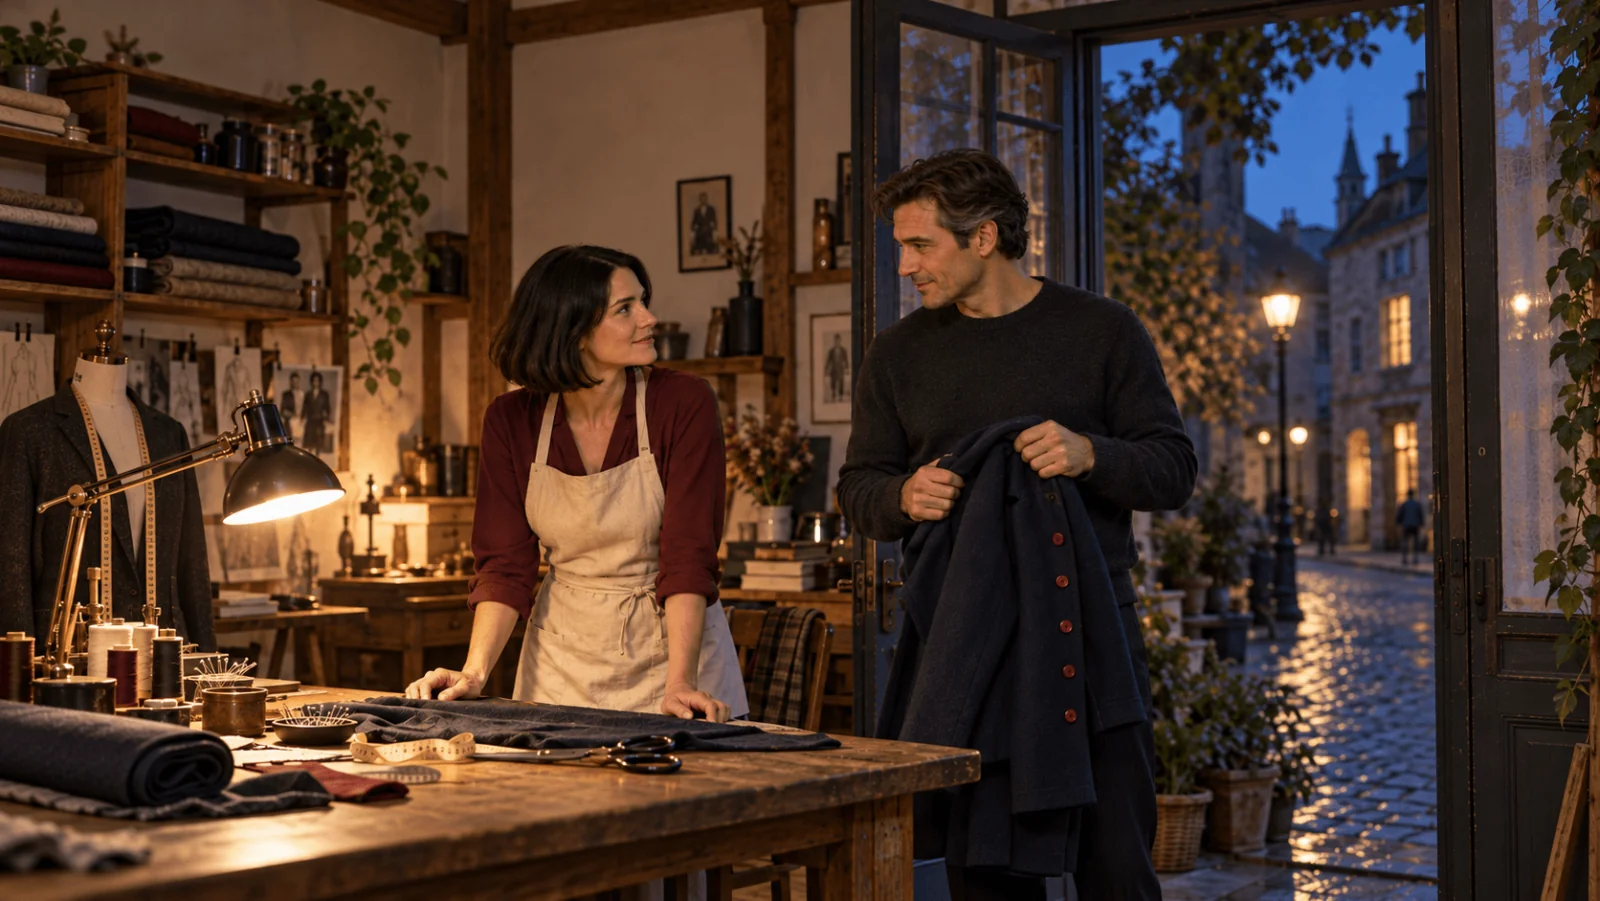
Sofia, dorosła krawcowa, fikcyjna postać w bordowej bluzce i kremowym fartuchu, zamyka swój warsztat. Jonas, mężczyzna po czterdziestce w grafitowym swetrze, przychodzi, niosąc granatowy płaszcz, któremu brakuje jednego czerwonego guzika. Widzi uszkodzenie, waha się, a potem postanawia pomóc. Film kończy się tym, że Sofia przyjmuje naprawę, a nie skończoną pracę szycia.
Lampa świeci przez cały czas. Płaszcz jest najpierw niesiony, potem kładziony na stole; Jonas nigdy go nie zakłada. Dzięki temu modelowi łatwiej zachować ciągłość.
| Montaż końcowy | Kadrowanie | Klatka still na początku | Jedno działanie do animacji | Cięcie, gdy |
|---|---|---|---|---|
| 0–6 s: zamykanie | plan ogólny | Sofia obok zapalonej lampy biurkowej, dłoń na stole warsztatowym | Jej dłoń zatrzymuje się, a wzrok kieruje się ku drzwiom | Jej uwaga dociera do drzwi |
| 6–12 s: przyjście | plan średni | Jonas w drzwiach, granatowy płaszcz na przedramionach | Robi jeden mały krok do wnętrza | Płaszcz jest widoczny, nie zasłaniając mu twarzy |
| 12–18 s: problem | detal | Płaszcz rozłożony na blacie; luźne nici w miejscu brakującego guzika | Powolne najechanie kamery na brakujące miejsce | Widz jest w stanie odczytać uszkodzenie |
| 18–24 s: wahanie | zbliżenie | Sofia patrzy w dół na płaszcz | Jej wzrok przechodzi z płaszcza na Jonasa | Jej twarz się uspokaja, zanim zacznie się drugi gest |
| 24–30 s: decyzja | plan średni | Sofia obok stołu, dłoń z dala od płaszcza | Przyciąga płaszcz o krótki odcinek ku sobie | Gest przyjęcia jest zakończony |
| 30–36 s: rozwiązanie | dwuosobowe | Obie dorosłe osoby widoczne przez stół, lampa wciąż zapalona | Jonas rozluźnia ramiona; Sofia kiwa głową | Zmiana emocjonalna jest widoczna |
Ujęcie ogólne umieszcza ludzi i lampę, zbliżenie niesie decyzję albo reakcję, detal pozwala widzowi odczytać przedmiot, a ujęcie dwuosobowe zamyka rozwiązanie. Między sąsiadującymi cięciami zmień najwyżej jeden z dwóch elementów: wielkość ujęcia albo kąt. Przytnij niezgrabne początki i końce na montażu; montaż trwający 31 sekund opowie tę historię lepiej niż zachowanie każdej wygenerowanej klatki.
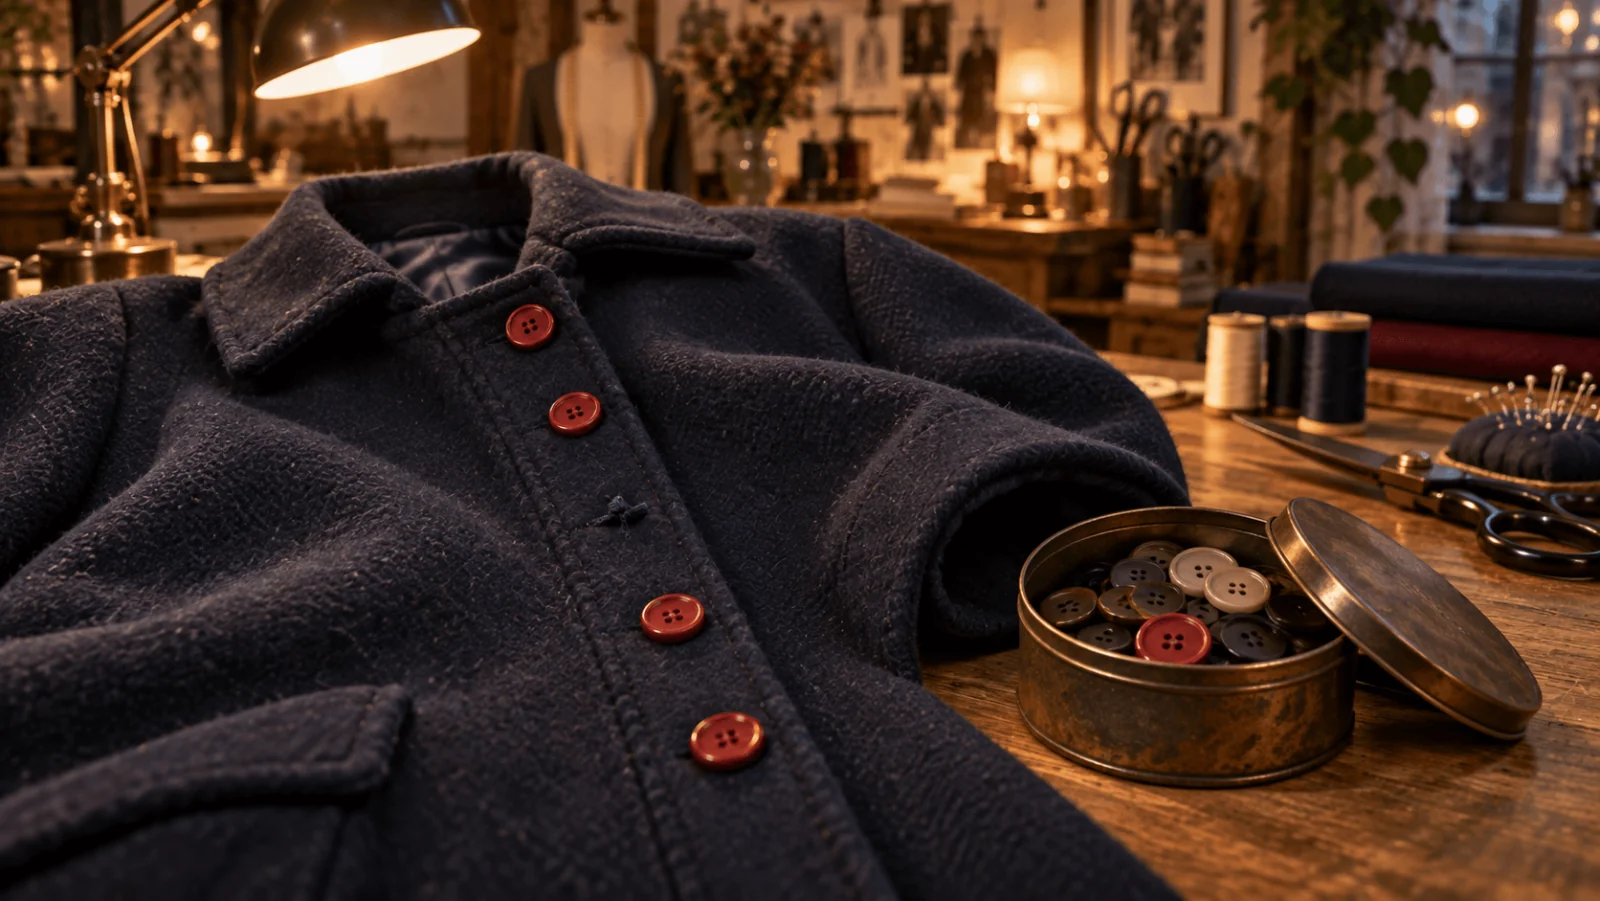
Rekwizyt płaszcza: brakuje jednego czerwonego guzika, a na jego miejscu zostały luźne nici.
Jak przejść od sceny do ujęć
- Określ zmianę. „Sofia zamyka warsztat, Jonas przychodzi z uszkodzonym płaszczem, a ona postanawia pomóc". Wytnij każde ujęcie, które jej nie przygotowuje, nie pokazuje i nie reaguje na nie.
- Wypisz widoczne momenty. Zamień myśli na rzeczy, które kamera może zobaczyć: „waha się" staje się „jej oczy przechodzą z płaszcza na Jonasa, a dłoń się zatrzymuje".
- Daj każdemu momentowi jedno działanie. Jeden podmiot, jeden gest, najwyżej jeden ruch kamery. „Czyta etykietę, rozumie, wstaje, obchodzi stół i konfrontuje go" to cztery ujęcia.
- Zapisz połączenie. Dla każdego ujęcia napisz, co jest widoczne na początku, co zmieniło się do końca i na co przechodzi cięcie.
- Policz cięcia wobec sekund. Sześć ujęć w 36 sekund to jedno cięcie co sześć sekund, co pasuje do cichego dramatu; scena akcji z osiemnastoma cięciami w piętnastu sekundach potrzebuje mniejszej liczby, ale dłuższych momentów przed generowaniem.
Jedno długie ujęcie czy osobne klipy
Seedance 2.5 przyjmuje od 4 do 30 sekund na zlecenie, ale dłuższe przebiegi dryfują: potwierdź ruch przy krótkim czasie trwania i licz się z tym, że kilka krótszych ujęć utrzymuje się lepiej niż jedno 30-sekundowe ujęcie. Większość ujęć najlepiej działa między 10 a 15 sekundami, z dryfem powyżej około 20 sekund. Wybór dla tego filmu:
| Plan (720p) | Zlecenia | Koszt | Pasuje do | Kosztuje cię |
|---|---|---|---|---|
| Sześć klipów po 6 s | 6 | 9,9828 $ | Każdy moment ma własny podmiot albo własny kąt, jak tutaj | Przygotowanie sześciu klatek still i ukrycie pięciu połączeń |
| Dwa klipy po 6 s i dwa po 12 s | 4 | 9,9828 $ | Sąsiednie momenty dzielą kamerę i pomieszczenie (ujęcia 3–4, 5–6) | Rytm momentów wyznacza prompt, a nie cięcie |
| Jedno ujęcie 30 s | 1 | 8,319 $ | Jedna ciągła przestrzeń bez zmian kąta | Nieudany gest oznacza zapłatę za wszystkie 30 sekund od nowa |
Oszczędność z długiego ujęcia znika przy pierwszym powtórzeniu: jedno sześciosekundowe ujęcie kosztuje 1,6638 $ przy wymianie, całe ujęcie 8,319 $. Grupuj według ustawienia kamery: ujęcia 1 i 2 zmieniają podmiot i zachowują własne zlecenia; ujęcia 3 i 4 dzielą płaszcz na stole i stają się jednym 12-sekundowym zleceniem, tak samo ujęcia 5 i 6. W przypadku ujęć 3 i 4 klatka still z płaszczem na stole musi dodatkowo obejmować pozycję siedzącej Sofii; jeśli nie da się tego osiągnąć, zostaw ujęcie 4 jako osobne zlecenie.
W przypadku zlecenia zbiorczego zapisz kolejne przedziały czasu bez luk, przy czym ostatni kończy się na całkowitym czasie trwania. Użyj tej klatki still jako Input image i ustaw Duration na 12:
Close insert, continuous. 0–6s: Slow push toward the navy coat flat on the worktable until the missing red-button position and loose thread fill the lower frame. 6–9s: Hold on the missing button. 9–12s: The camera eases up and across to Sofia looking down at the coat; her eyes move toward the doorway. The desk lamp stays lit. No other camera movement, no text. Sound: quiet room tone. No speech or music.
Aby łączyć ujęcia, włącz Return last frame w sekcji Advanced parameters: ostatnia klatka wraca jako obraz do użycia jako Input image następnego ujęcia. Aby ustalić zakończenie, dodaj klatkę still jako Closing frame; ustala ona koniec, nie środek, więc obie klatki powinny być zbliżone pod względem światła i kompozycji. Przewodnik po łączeniu ostatniej klatki omawia składanie w ffmpeg.
Niech klatki początkowe zajmą się ciągłością
Przygotuj portrety postaci i widok pomieszczenia przed sześcioma obrazami ujęć. Tanią drogą jest Seedream 5.0 Flash obraz na obraz za 0,029 $ za obraz: dodaj zatwierdzone portrety i widok pomieszczenia w polu Images, ustaw Aspect ratio zgodnie z formatem filmu (9:16 dla pionowego) i opisz ujęcie w polu Prompt. Sześć klatek still, każda powtórzona raz, plus dwa portrety i widok pomieszczenia to około 15 obrazów, czyli mniej więcej 0,44 $. Buduj każdą klatkę still ujęcia z tych samych zatwierdzonych odniesień; nie generuj osobnej, niezwiązanej „pracowni krawieckiej” dla każdego kąta, bo drzwi i stół mogą zamienić się stronami.
Powtarzaj te szczegóły w każdym briefie obrazu: bordowa bluza, kremowy fartuch, grafitowy sweter, granatowy płaszcz, czerwone guziki, ciepła lampa biurkowa, drzwi po tej samej stronie pomieszczenia. Dla zbliżenia na uszkodzenie pokaż puste ściegi i luźne nici tam, gdzie powinien być guzik; pełny rząd guzików nie zostanie odczytany jako uszkodzenie, bo prompt mówi „zepsuty płaszcz”.
Obraz na wideo nie pozwala wybrać proporcji, więc kadr niesie klatka still: zrób pionową klatkę still do pionowego filmu, trzymaj obie twarze z dala od krawędzi, a każdą stronę ustaw między 300 a 6000 pikseli.
Dla układu ujęcie–przeciwujęcie trzymaj Sofię po lewej stronie kadru patrzącą w prawo, a Jonasa po prawej patrzącego w lewo, z obiema kamerami po tej samej stronie linii, która ich łączy, i bez zmian ich względnych wysokości. Jeśli po cięciu oboje patrzą w lewo, odbuduj tę klatkę still.
Skopiuj te prompty ruchu
Wypróbuj w Playground
- Otwórz stronę Seedance 2.5 obraz na wideo i zostań w zakładce Playground, w widoku Form. Zaloguj się na doładowane konto, aby uruchomić generowanie.
- Dodaj zatwierdzoną początkową klatkę still w polu Input image; stanie się ona pierwszą klatką.
- Wklej jeden z promptów poniżej w pole Prompt.
- Ustaw Duration na 6, a Resolution na 480p do taniego sprawdzenia albo na 720p do wersji ostatecznej; zostaw Generate audio włączone lub wyłączone zgodnie z planem.
- Uruchom, a potem powtórz dla każdego ujęcia.
Do ujęcia otwierającego wgraj zatwierdzoną klatkę still z lampą jako image_url i użyj:
Locked wide shot of the workshop. Sofia, the adult tailor in the burgundy blouse and cream apron, slowly lowers her hand to the worktable, then pauses and looks toward the doorway. The lamp remains lit for the entire shot. She stays beside the table. No other person enters the frame. No text.
Dla przyjścia Jonasa:
Locked medium shot of the adult man in the charcoal sweater standing in the workshop doorway. He takes one small step forward while holding the navy coat across both forearms. The coat remains a carried object, not clothing he is wearing. His expression is hesitant. Keep his face visible. No camera orbit, no text.
Dla decyzji:
Medium view of the adult tailor beside the worktable. She gently slides the navy coat a short distance toward herself, then rests her hand beside it. The missing red-button position stays visible. Her expression changes from hesitation to a small reassuring smile. The desk lamp stays lit. Locked camera. No sewing action.
„Locked” to tylko sposób zapisu promptu (nie ma żadnego pola blokady kamery); przewodnik o kamerze stałej omawia kadry, które mimo to się poruszają. Aby ocenić prompt tanio, wygeneruj go w 480p (0,1234 $ za sekundę, 4,4424 $ za wszystkie sześć ujęć) i zmieniaj po jednej klauzuli; wersje ostateczne generuj w 720p albo w 1080p po 0,6823 $ za sekundę.
Albo wywołaj to z kodu
To samo ujęcie z CLI (npx @spicyapi/cli działa bez instalacji); przewodnik obraz na wideo zawiera Python SDK i pozostałe pola:
spicyapi tasks create --model bytedance/seedance-2.5/image-to-video \
  --input-json '{"image_url":"https://.../still.png","prompt":"<paste the prompt>","duration_seconds":6,"resolution":"720p","generate_audio":false}' --wait
Albo niech wykona to agent. Asystent może wykonać to wywołanie przez powyższe CLI, serwer MCP (spicyapi_upload_file dla każdej klatki still, potem spicyapi_task_create, który zatrzymuje się na potwierdzenie ceny) albo Skill (npx skills add spicyapi-ai/spicy-skill).
Dialog i dźwięk
generate_audio jest domyślnie włączone i kosztuje tyle samo niezależnie od tego, czy jest włączone, czy wyłączone. Podłóż pod cały montaż jedno ciągłe, spójne tło szumu pomieszczenia, żeby sześć osobno wyrenderowanych pomieszczeń nie brzmiało jak sześć różnych pomieszczeń.
Trzymaj kwestie krótkie: po jednej dla Jonasa i Sofii („Czy możecie to naprawić?” mieści się w ujęciu 2), nagrane albo podłożone osobno (ustaw generate_audio na false, ta sama cena, żeby wygenerowane głosy nie kłóciły się z nagraniem), ponieważ dźwięku wyrenderowanego razem z obrazem nie da się poprawić bez ponownego wyrenderowania klipu. Jeśli usta są w kadrze, postępuj zgodnie z przepływem synchronizacji ust; w przeciwnym razie wystarczy głos z offu albo napisy.
Kiedy zamiast tego wybrać wideo z referencji
Wybierz wideo z referencji, gdy chcesz, aby model zbudował ujęcie z odniesień postaci i pomieszczenia, zamiast animować zatwierdzoną klatkę. Przyjmuje do 30 obrazów referencyjnych, 10 klipów referencyjnych i 10 plików audio. Tryb referencyjny i tryb pierwszej klatki wykluczają się nawzajem: jeśli pierwsza klatka musi być dokładna, zostań przy obrazie na wideo.
Przypisz obrazy w kolejności i nazwij każdą rolę:
@Image1 is Sofia, the adult tailor. @Image2 is Jonas, the adult customer. @Image3 supplies the workshop layout. Show Sofia on the left side of the worktable and Jonas near the doorway on the right. Jonas carries the navy coat. Sofia looks toward him. Warm desk lamp remains lit, medium two-person composition, restrained movement.
Na stronie wideo z referencji dodaj portrety i widok pomieszczenia jako Reference images, ustaw Aspect ratio na 9:16, Duration na 6 i Resolution na 720p. Zlecenia tylko z obrazami kosztują tyle samo, czyli 0,2773 $ za sekundę w 720p; dodanie klipów referencyjnych obniża stawkę za sekundę do 0,1659 $, ale ich długość dolicza się do rozliczanych sekund, więc najpierw poproś o wycenę.
Napraw nieudane ujęcie, a nie cały film
| Problem w jednym ujęciu | Konkretna naprawa |
|---|---|
| Lampa gaśnie przed końcem | Trzymaj wszystkie dłonie z dala od włącznika, tak w klatce still, jak i w prompcie; animuj Sofię odwracającą się ku drzwiom, gdy jej dłoń zostaje na stole. |
| Jonas wygląda, jakby nosił płaszcz do naprawy | Zastąp początkową klatkę still taką, w której oba przedramiona wyraźnie podpierają płaszcz; zostaw „carried object” w prompcie ruchu. |
| Brakujący guzik staje się pełnym rzędem | Zachowaj na montażie zatwierdzoną klatkę still rekwizytu jako zbliżenie. |
| Dłoń zlewa się z płaszczem podczas przesuwania | Cięcie z ujęcia spojrzenia Sofii na osobną klatkę still z płaszczem bliżej niej, a potem na przytaknięcie. |
| Jonas i Sofia zmieniają twarze w ostatnim ujęciu dwuosobowym | Odbuduj tę początkową klatkę still z zatwierdzonych portretów; dłuższy prompt nie naprawi złej twarzy źródłowej. |
| Wygenerowany dialog zmienia słowa | Usuń dialog z promptu i dodaj kwestię jako nagrany głos z offu albo jako napisy. |
Powtórzenie tylko nieudanego gestu kosztuje 1,6638 $, a ponowne wygenerowanie wszystkich sześciu ujęć kosztuje kolejne 9,9828 $, więc zachowanie wadliwego ujęcia jako zatwierdzonej klatki still to realna oszczędność. Ceny pochodzą z katalogu z 3 października 2026 r.; dodaj około 0,45 $ na klatki still.
FAQ
Ile ujęć powinien mieć krótki dramat z AI trwający 30–40 sekund?
Mniej więcej jedno widoczne działanie co pięć do ośmiu sekund pasuje do cichego dramatu. Zacznij od momentów, a nie od liczby.
Czy jedno zlecenie Seedance 2.5 może wygenerować całą scenę?
Może trwać do 30 sekund, więc scena w jednym pomieszczeniu się mieści. Ceną jest to, że jeden zły gest oznacza wygenerowanie wszystkiego od nowa, i dlatego plan trzyma momenty w osobnych albo małych zbiorczych zleceniach.
Czy mogę zrobić ujęcia pionowe do TikToka albo Reels?
Tak. Generuj pionowe klatki still, bo obraz na wideo przyjmuje kształt klatki still, albo użyj trybu wideo z referencji i ustaw Aspect ratio na 9:16.