Seedance 2.0 w SpicyAPI (spicyapi.ai) ma trzy zadania wideo i każde wymaga innego promptu. W zadaniu tekst na wideo prompt niesie całe ujęcie. W zadaniu obraz na wideo wygląd ustala klatka otwierająca, więc prompt mówi tylko, co dzieje się dalej. W zadaniu referencja na wideo przekazujesz obrazy, klipy lub dźwięk, a prompt mówi, do czego służy każdy plik. Napiszesz prompt nieodpowiedniego rodzaju do zadania, to żadna liczba przymiotników nie uratuje klipu.
Ceny i limity poniżej pochodzą z publicznych stron modeli, październik 2026. Wszystkie trzy zadania zwracają od 4 do 15 sekund wideo z dźwiękiem, od 480p do 4K.
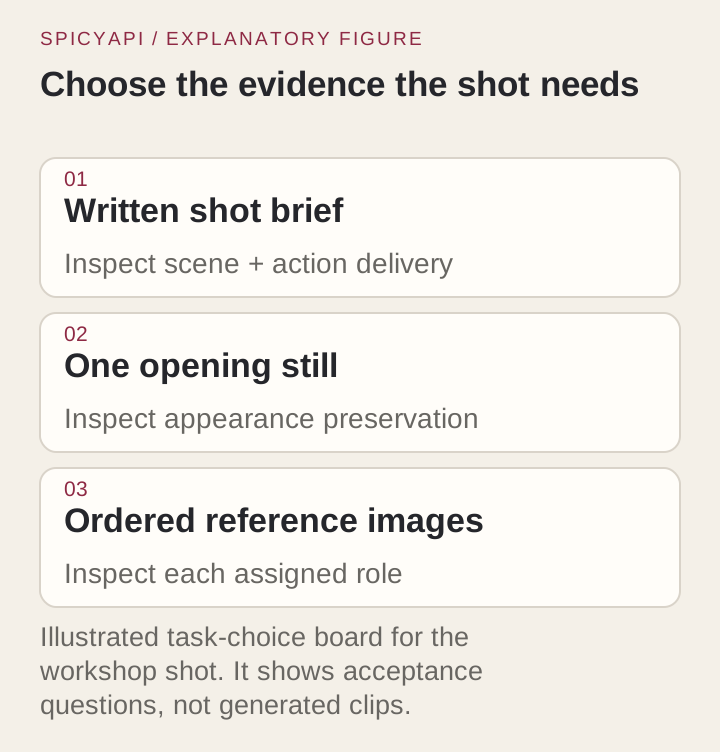
Wybierz zadanie według tego, co musi zostać stałe
| Co już masz | Zadanie | Rola promptu | Cena od |
|---|---|---|---|
| Pomysł, bez obrazu | Tekst na wideo | Opisz scenę, potem to, co się zmienia | 0,07 $/s |
| Dokładna klatka otwierająca (zrzut produktu, zatwierdzona klatka still) | Obraz na wideo | Opisz tylko to, co dzieje się po klatce | 0,07 $/s |
| Osobne źródła: twarz, miejsce, ruch kamery, dźwięk | Referencja na wideo | Powiedz, co wnosi każdy plik, potem wyreżyseruj nowe ujęcie | 0,07 $/s (0,043 $ z wideo referencyjnym) |
Tekst na wideo wymyśla kompozycję otwierającą, więc używaj go do scen fikcyjnych lub elastycznych. Jeśli etykieta i proporcje prawdziwego produktu mają znaczenie, opis tekstowy ich nie odtworzy; zacznij od zdjęcia. Referencja na wideo nie ma kontroli nad pierwszą klatką; jeśli klatka otwierająca musi się zgadzać, użyj obrazu na wideo. Obraz na wideo zachowuje ubiór, kształt obiektów i oświetlenie z klatki. Nie gwarantuje, że przetrwają obrót albo przesłonięcie, więc obejrzyj cały klip.
Referencja na wideo przyjmuje do 9 obrazów, 3 klipy wideo i 3 pliki audio. Każdy klip lub plik audio trwa od 2 do 15 sekund, a każdy typ ma łączny limit 15 sekund. Wymagany jest co najmniej jeden obraz lub film; samo audio jest odrzucane. Wybierz najmniejszy zestaw, który wystarczy. Dodatkowe pliki wprowadzają sprzeczności, na przykład jedną twarz w trzech oświetleniach albo ruch kamery, który kłóci się z kadrem referencji, a model nie wie, który plik wygrywa, jeśli prompt tego nie określi.
Napisz brief ujęcia
Ta sama kolejność działa we wszystkich trzech zadaniach: postać, działanie, kamera, światło, dźwięk, jedna myśl na zdanie. Reszta tego przewodnika idzie za jednym przykładem: mechanik, który obraca pedał czerwonego miejskiego roweru.
- Jedno widoczne działanie, jedna instrukcja dla kamery. „Mechanik raz obraca pedał, potem kładzie dłoń obok" daje modelowi coś do wyrenderowania; „emocjonalne, filmowe" nie. Opisz, jak porusza się postać („powoli unosi roletę"), zamiast dodawać słowa jakości.
- Powiedz, gdzie jest kamera względem postaci. „Kamera zostaje na wysokości bioder, w średniej odległości" to użyteczna instrukcja. Nie łącz w jednym ujęciu „stałej kamery", „orbity" i „szybkiego zoomu"; wybierz jedno zachowanie albo żadne.
- Dopasuj czas trwania do działania. Pięć sekund udźwignie obrót, sięgnięcie albo spojrzenie. Wejście do pomieszczenia, podniesienie narzędzia i wypowiedzenie zdania wymaga 10 sekund lub więcej albo osobnych ujęć.
duration_secondsprzyjmuje całe sekundy od 4 do 15 albo-1, aby wybrał model. - Używaj kolejności ujęć, nie znaczników czasu. Seedance 2.0 realizuje „Shot 1, Shot 2, Shot 3" wiarygodniej niż zakresy sekunda po sekundzie. Jeśli działanie znika, ogranicz liczbę zdarzeń albo daj sekwencji więcej czasu.
- Styl daj na końcu i trzymaj krótko. „Miękkie poranne światło, dokumentalna faktura" wzmacnia ujęcie. Stos niepowiązanych etykiet popycha wynik ku generycznej gładkości i chowa działanie. Dla sceny stylizowanej zacznij od „Photorealistic live action, not animation", inaczej może zdryfować w stronę ilustracji.
Brief na kilka ujęć na 10 sekund, z wyraźnie zapisanym cięciem:
A mechanic in a dark blue work shirt repairs a red commuter bicycle in a tidy daylight workshop. Naturalistic photography, soft morning light.
Shot 1: Fixed medium shot. The mechanic turns the right pedal once by hand and the rear wheel spins.
Shot 2: Cut to a close side view of the rear wheel slowing while his gloved hand steadies the frame.
Shot 3: Back to the medium shot. He steps back and wipes his hands on a rag.
Sound: ratchet clicks, the spinning wheel, quiet workshop. No music, no captions.
Najpierw sprawdź w Playground
Uruchom brief w Playground, zanim napiszesz jakikolwiek kod; prompt, który tu zawiedzie, zawiedzie też przez API.
- Otwórz stronę tekst na wideo i zostań w zakładce Playground w widoku Form. Zaloguj się zasilonym kontem, aby uruchomić.
- Wklej brief w Prompt.
- Ustaw Aspect ratio (16:9), Resolution i Duration. Na szkic wybierz 480p i 5 sekund; oba ustawienia są oznaczone „affects price", tak jak Generate audio i Web search (zostaw Web search wyłączone).
- Odczytaj szacowaną cenę, potem uruchom. W sekcji Advanced parameters pole Seed pomaga porównać zmianę promptu z ostatnim uruchomieniem.
Obraz na wideo ma tę samą zakładkę z wgrywaniem Input image (i opcjonalnym Closing frame). W referencji na wideo dodawaj pliki w Reference images, Reference videos i Reference audio; są numerowane jako image 1, video 1, audio 1 w miarę dodawania, a Insert reference wstawia pasującą etykietę do promptu.
Potem wywołaj to z kodu
Zainstaluj Python SDK (pip install spicyapi), ustaw SPICY_API_KEY w środowisku serwera i uruchom:
import uuid
from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

request = {
    "model": "bytedance/seedance-2.0/text-to-video",
    "input_data": {
        "prompt": "One adult mechanic in a dark blue work shirt stands beside one red commuter bicycle on a repair stand. Medium shot in a tidy daylight workshop. The mechanic turns the right pedal once by hand, watches the rear wheel rotate, then pauses with the hand resting beside the pedal. The camera stays fixed at waist height; the bicycle remains fully visible. Soft morning light from the left. A quiet workshop ambience and one short mechanical click, with no speech. One continuous shot.",
        "duration_seconds": 5,
        "resolution": "720p",
        "aspect_ratio": "16:9",
        "generate_audio": True,
    },
}

quote = client.quote_task(**request)  # free; nothing is reserved
print(quote["estimatedCost"], quote["maxCharge"])

task = client.create_task(
    **request,
    idempotency_key=str(uuid.uuid4()),
    quote_id=quote["quoteId"],
    expected_cost=quote["estimatedCost"],
)
print("Resume task:", task["taskId"], flush=True)
final = client.wait_for_terminal(task["taskId"])
if final["state"] != "succeeded":
    raise RuntimeError(f"Task {task['taskId']} ended as {final['state']}")
assets = output_assets(final)
if not assets or any(a.get("pending") or a.get("unavailable") or not a.get("url") for a in assets):
    raise RuntimeError(f"Task {task['taskId']} has no ready output; check this task before a new run")
print(assets[0]["url"])  # copy it to your own storage now
Pozostałe dwa zadania używają tego samego wywołania z innym model i input_data: image_url (plus opcjonalne last_image_url) dla obrazu na wideo oraz reference_image_urls z opcjonalnymi listami wideo i audio referencyjnego dla referencji na wideo. Widok JSON w Playground pokazuje dokładne body dla zadania, na którym jesteś. Wgrywanie, oczekiwanie, ponowienia, błędy i oszczędzające klucze idempotencji są w referencji Python SDK oraz w przewodniku po zadaniach asynchronicznych.
Albo niech uruchomi to agent
Jeśli asystent ma uruchamiać klipy za ciebie, daj mu CLI, serwer MCP albo Skill. CLI i serwer MCP pokazują cenę i pytają o zgodę przed płatnym wywołaniem.
- CLI. Włóż ten sam obiekt
inputdoinput.json, potem uruchom poniższe (npx @spicyapi/clidziała bez instalacji; zob. dokumentację CLI):
``bash spicyapi tasks create --model bytedance/seedance-2.0/text-to-video --input-file input.json --wait ``
- Serwer MCP. Dodaj serwer MCP do swojego asystenta, potem zapytaj: „Run Seedance 2.0 text to video with this brief, 5 seconds at 480p." Wywołuje
spicyapi_task_create, które zatrzymuje się na potwierdzenie ceny, a następniespicyapi_task_wait. - Skill.
npx skills add spicyapi-ai/spicy-skillinstaluje Agent Skill, dzięki któremu asystent programistyczny czyta bieżący schemat modelu zamiast zgadywać pola.
Tekst na wideo: zbuduj całą scenę
Bez obrazu najpierw wymień obsadę i kluczowe przedmioty, potem kompozycję początkową, potem jedną drobną zmianę. „Mechanik trzyma pedał" to stan; „raz obraca pedał" to działanie, a model potrzebuje tego drugiego. Jeśli rower ma być czerwony i stać na stojaku, napisz to w opisie sceny, a nie na końcu.
One adult mechanic in a dark blue work shirt stands beside one red commuter bicycle on a repair stand. Medium shot in a tidy daylight workshop. The mechanic turns the right pedal once by hand, watches the rear wheel rotate, then pauses with the hand resting beside the pedal. The camera stays fixed at waist height; the bicycle remains fully visible. Soft morning light from the left. A quiet workshop ambience and one short mechanical click, with no speech. One continuous shot.enable_web_search istnieje tylko w zadaniu tekst na wideo i podnosi stawkę (720p rośnie z 0,152 $ do 0,246 $ za sekundę). Zostaw je wyłączone, chyba że ujęcie zależy od czegoś, co model musiałby wyszukać, a fakty sprawdź sam.
Gdy klip nie trafia w cel, zmień tę jedną część briefu, która jest za to odpowiedzialna:
| Co widzisz | Zmień to |
|---|---|
| Dodatkowe osoby albo drugi rower | Podaj liczbę („jeden mechanik, jeden rower") i usuń słowa o grupie |
| Działanie nigdy się nie kończy | Wyrzuć jedno zdarzenie albo wydłuż czas trwania |
| Kamera się rusza mimo „stałej" | Daj kamerze jedno bezpośrednie zdanie i usuń pozostałe słowa o kamerze |
| Niechciane cięcie | Powiedz „one continuous shot" i usuń zmiany sceny z briefu |
| Napisy albo muzyka, o które nie prosiłeś | Dodaj „no captions, no music"; to zmniejsza ryzyko, ale go nie gwarantuje |
| Wygląd kreskówkowy lub ilustracyjny | Zacznij od „Photorealistic live action, not animation" |
Obraz na wideo: niech klatka zrobi robotę wizualną
Wybierz klatkę pod ruch, którego chcesz. Ciasny portret nie daje promptowi chodzenia nic do pracy, a rower ucięty na tylnym kole nie pokaże, że to koło się obraca. Sprawdź klatkę przed wysłaniem: anatomię, liczbę obiektów, zbłąkany tekst i oświetlenie. Każdy defekt klatki still utrzymuje się przez cały klip, a animowanie go nie naprawi.
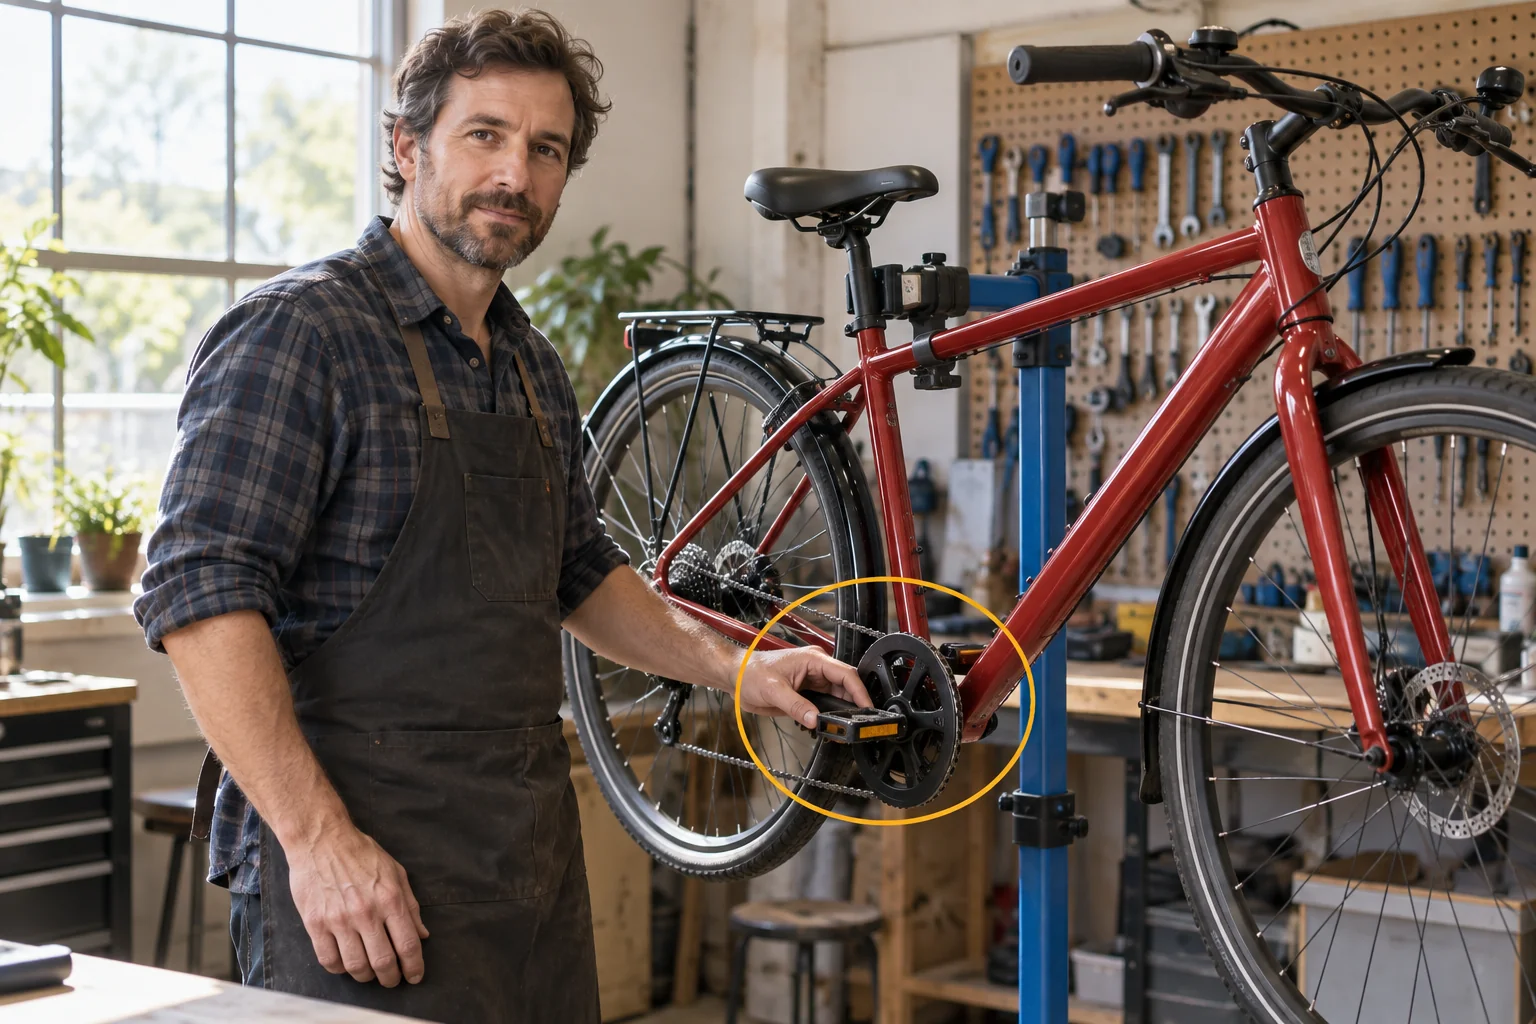
Potem napisz tylko to, co się zmienia. Ponowne opisanie ubioru mechanika i warsztatu daje modelowi dwa konkurujące opisy tej samej postaci, co sprzyja dryfowi. Nazwij ruchomą postać, działanie, kamerę i dźwięk:
The mechanic turns the visible pedal once by hand. The rear wheel rotates naturally, then slows while the mechanic watches it. The camera remains fixed at the original medium distance. One continuous shot, quiet workshop ambience.image_url musi być publicznym linkiem możliwym do bezpośredniego pobrania (od 300 do 6000 px na bok, poniżej 10 MB; zdjęcie realnej, rozpoznawalnej osoby może zostać odrzucone); dla pliku na twoim komputerze najpierw go wgraj i przekaż zwrócony URI spicy://. Prompt jest opcjonalny, a bez niego model sam wybiera ruch. aspect_ratio: "adaptive" idzie za własnym kształtem obrazu.
last_image_url przypina klatkę końcową i działa tylko razem z image_url. Używaj klatek zgodnych: ta sama postać, podobny kąt i zbliżona geometria obiektów. Dwie niezwiązane kompozycje zamieniają klip w problem transformacji, do którego model musi zmyślić drogę.
Aby przejść ponad 15 sekund, ustaw return_last_frame na true, zapisz zwróconą klatkę końcową i podaj ją jako image_url w następnym wywołaniu. Nie ma pola kontynuacji, więc każdy segment zaczyna się od zapisanej klatki.
Referencja na wideo: daj każdemu plikowi zadanie
Przypisz role w prompcie i dopasuj je do kolejności wgrywania: image 1, image 2, video 1, audio 1. Daj postaci krótką nazwę, zdefiniuj ją raz i używaj dalej. Powiedz modelowi, co ma wziąć z klipu, a co zostawić.
Define the mechanic in image 1 as the Mechanic. Use image 2 for the workshop and the red bicycle. The Mechanic turns the pedal once while the wheel rotates, then pauses. Medium shot, camera fixed at waist height. One continuous shot. Quiet ambience, no speech.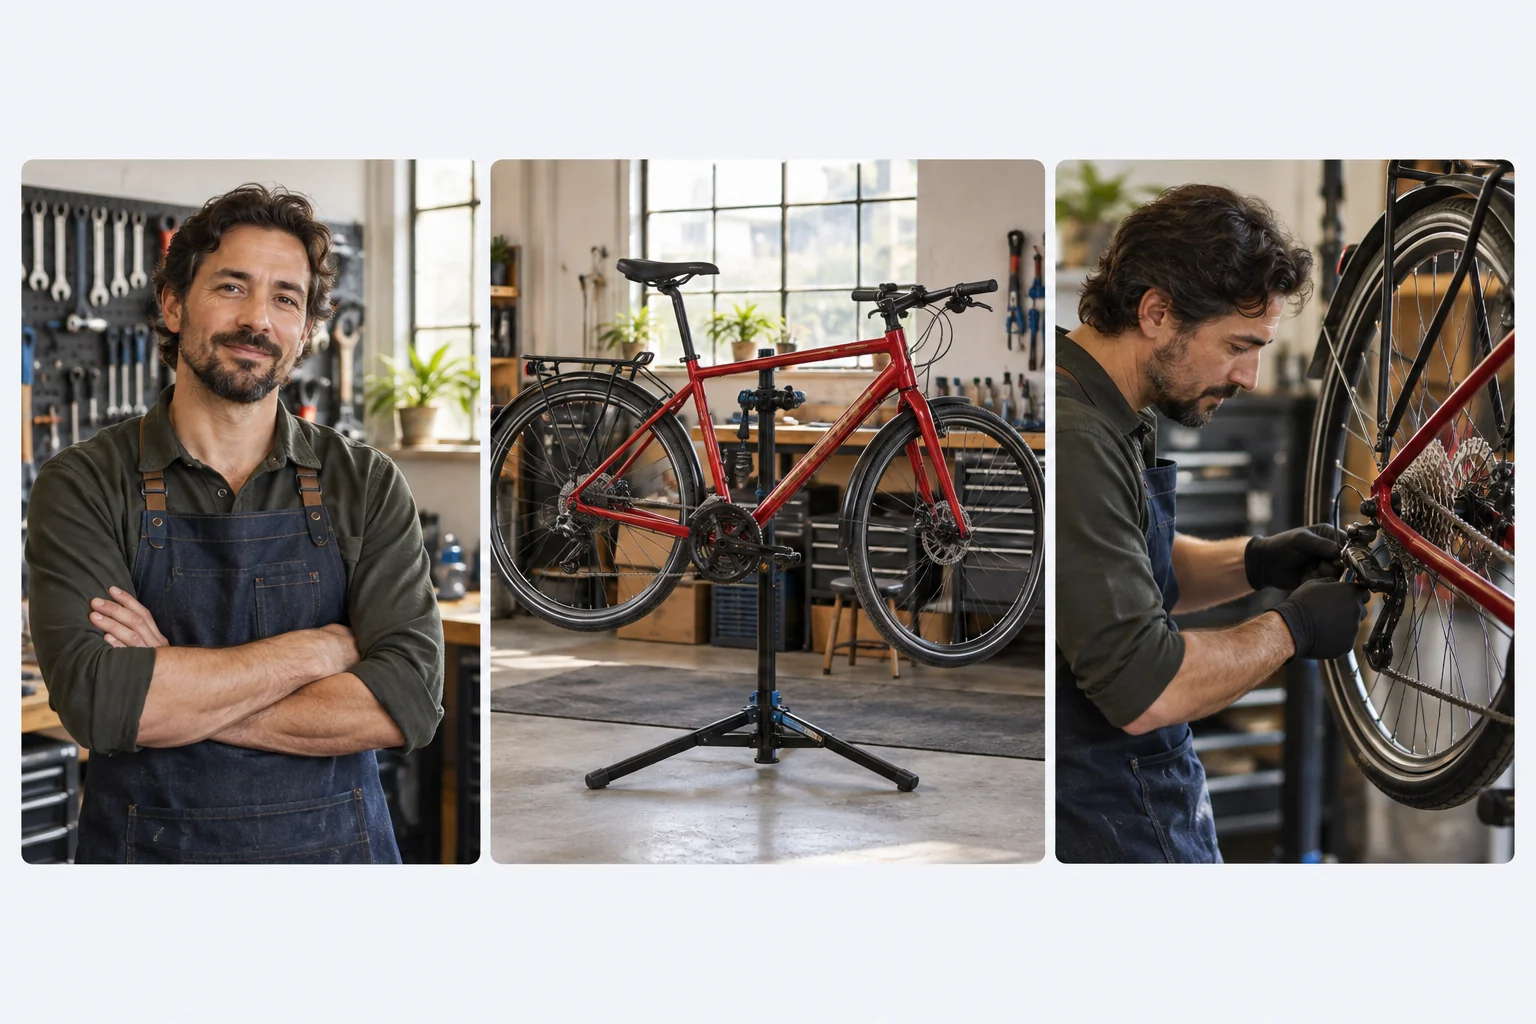
Co pomaga:
- Jedno zadanie na plik. Jeśli wygląd się rozjeżdża, oddziel referencję twarzy od referencji ubioru lub całej postaci i powiedz, która co daje. Dwa albo trzy ujęcia jednej postaci działają lepiej niż stos niemal identycznych klatek, a kolaż kilku widoków może czytać się jako kilka osób.
- Używaj twarzy wygenerowanych albo w pełni zwolnionych. Kontrola wejścia Seedance może odrzucić zdjęcie realnej, rozpoznawalnej osoby, jeszcze przed jakimkolwiek obciążeniem. Obrazy muszą mieć od 300 do 6000 px na bok i poniżej 10 MB.
- Trzymaj styl spójny. Mieszanie zdjęć, rysunków i anime w jednym zestawie referencji zwykle spłaszcza wynik.
- Referowanie to nie edytowanie. „Borrow the slow sideways track from video 1, not its people or location" prosi o nową scenę. „Edit video 1" prosi o zmianę tego materiału. Nie mieszaj obu rzeczy w jednym prompcie.
- Powiedz, co daje plik audio: głos, atmosferę albo charakter muzyczny. Potrzebuje obok siebie obrazu lub wideo, a przy wyłączonym
generate_audiożadna ścieżka nie jest renderowana, nawet jeśli audio zostało dostarczone. - Dodawaj wideo na końcu. Najpierw doprowadź scenę do działania na obrazach, potem dodaj klip z konkretnego powodu. Wideo zmienia też cenę (patrz niżej).
- Kolejność ma znaczenie. Jeśli narzędzie przesortuje pliki,
image 1stanie się innym obrazem. Gdy wymieniasz plik, odczytaj przypisania z promptu.
Wgrywaj tylko materiał, do którego masz prawo, i tylko osoby, które wyraziły zgodę na wystąpienie.
Steruj dźwiękiem
generate_audio jest domyślnie włączone i kosztuje tyle samo co wyłączone. Wyłącz je, jeśli później dodasz do klipu muzykę lub dubbing. Traktuj dźwięk jak osobną część briefu:
- Nazywaj źródła. „Ratchet clicks, spinning wheel, quiet workshop" bije „ambient sound". Pisz „no music", kiedy naprawdę to masz na myśli, bo scena może wrócić z muzyką.
- Dialog: nazwij mówiącego, wstaw kwestię w cudzysłów, trzymaj ją dość krótką na czas trwania i zostań w jednym języku. Słuchaj dokładnych słów; wiarygodnie brzmiąca kwestia i tak może zmienić imię albo ofertę.
- Napraw to na montażu. Jeśli obraz jest dobry, a dźwięk zły, podmień dźwięk lokalnie, zamiast generować obraz od nowa.
Iteruj po jednej zmianie
W każdej próbie zmieniaj jedną rzecz: zdanie o kamerze przy niechcianym zoomie, zestaw referencji przy dryfie tożsamości. Inaczej lepszy klip nie powie ci, która zmiana zadziałała. Ustal seed i trzymaj wszystko inne stałe, żeby ocenić zmianę promptu. Seed jest narzędziem porównania, a nie obietnicą powtórzeń identycznych klatka w klatkę.
Szkicuj w 480p i podnieś rozdzielczość, gdy działanie czyta się poprawnie; 720p to ustawienie domyślne. Rozdzielczość i czas trwania ustalają cenę, a proporcje, przepływność i znak wodny nie. Własna kontrola Seedance odrzuca pewne sformułowania przed renderowaniem, a sformułowania o pocałunku są niezawodnym wyzwalaczem; odrzucone zadanie jest zwykle zwalniane bez opłaty.
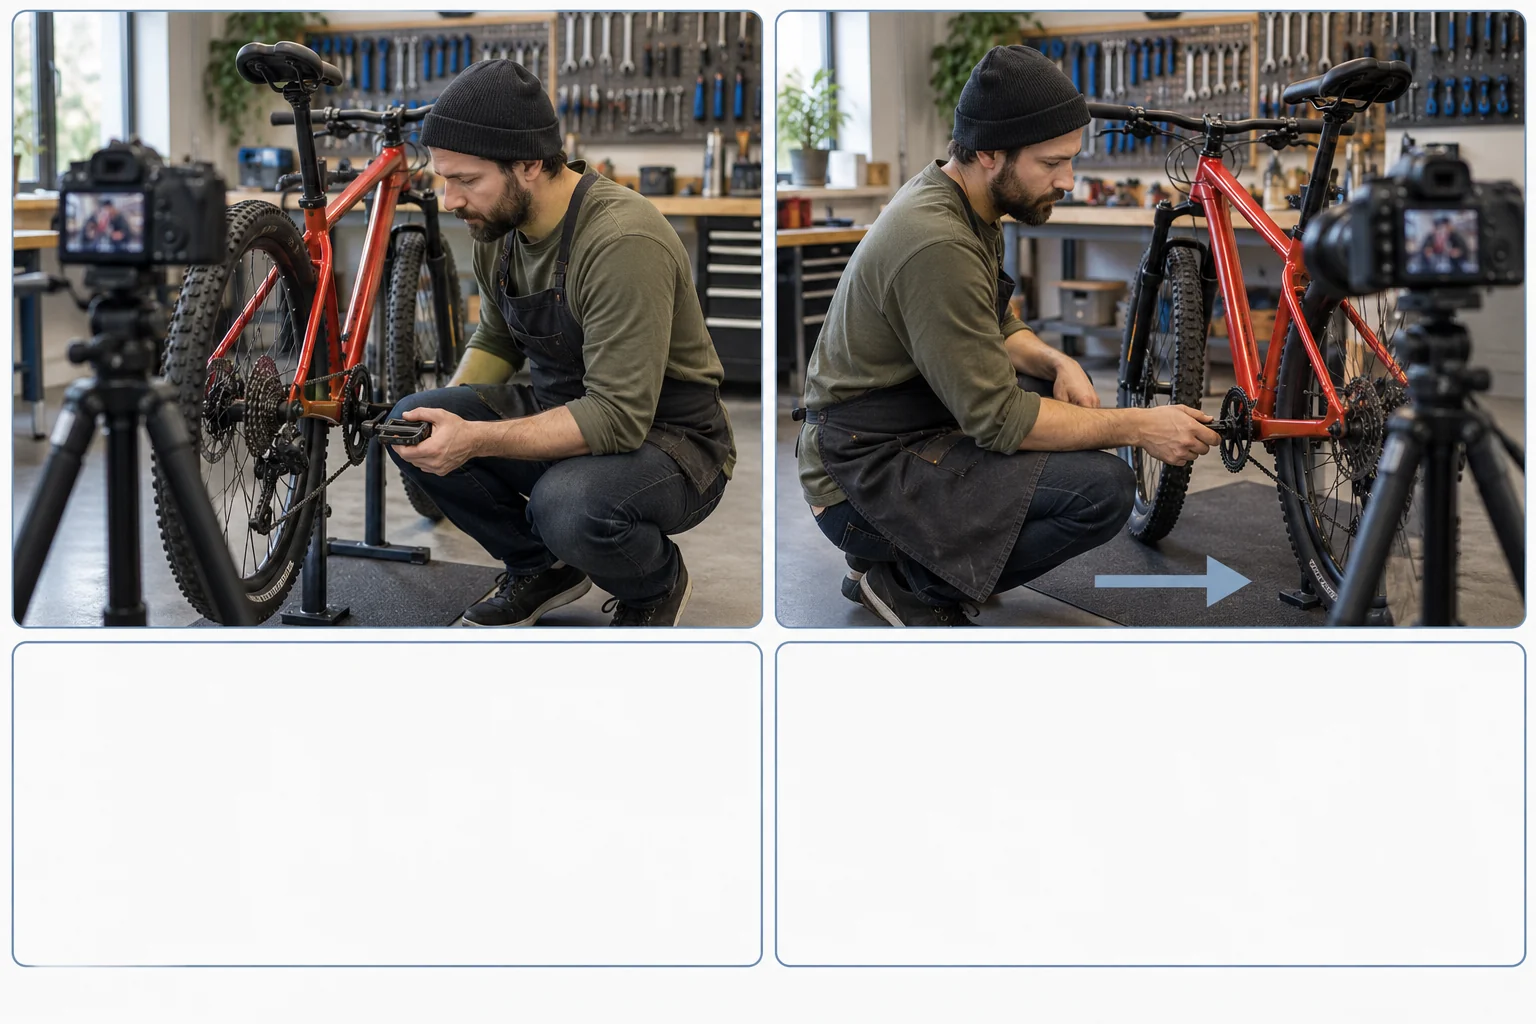
Prowadź zapis na każdą próbę: prompt, zadanie, pliki w kolejności wgrywania, czas trwania, rozdzielczość i seed. Gdy prompt działa na jednej scenie, ten zapis mówi ci, co użyć następnym razem.
Ile to kosztuje
Tekst na wideo i obraz na wideo są rozliczane za sekundę wyniku, z dźwiękiem włączonym lub wyłączonym według tej samej stawki:
| Rozdzielczość | Za sekundę | Klip 5-sekundowy |
|---|---|---|
| 480p | 0,07 $ | 0,35 $ |
| 720p | 0,152 $ | 0,76 $ |
| 1080p | 0,374 $ | 1,87 $ |
| 4K | 0,778 $ | 3,89 $ |
Trzy szkice w 480p plus final w 720p dają 1,81 $. Przy -1 (długość wybiera model) szacunek zakłada maksimum 15 sekund, czyli 2,28 $ przy 720p, a końcowe obciążenie zależy od dostarczonej długości. Seedance 2.0 Fast i Mini są tańsze (Mini startuje od 0,025 $ za sekundę w 480p, Fast od 0,045 $) i kończą się na 720p; traktuj szkic od nich jako wskazówkę o briefie, a nie jako podgląd wyniku modelu bazowego.
Wideo referencyjne to jedyne wejście, które zmienia rachunek. Referencja na wideo nalicza niższą stawkę za sekundę, gdy żądanie zawiera wideo (720p: 0,0928 $ zamiast 0,152 $), ale płacisz ją od swoich sekund wyniku plus sekundy klipu referencyjnego. Klip 5-sekundowy w 720p z 10-sekundowym klipem referencyjnym to 15 × 0,0928 $ = 1,39 $, wobec 0,76 $ bez klipu. W 4K stawka jest taka sama z wideo i bez niego, więc klip dokłada tylko sekundy. SpicyAPI zatrzymuje środki na maksimum z góry i zwalnia niewykorzystaną część, gdy zadanie jest rozliczane. Przytnij klipy referencyjne do tych kilku sekund, które niosą ruch.
Kiedy właściwą odpowiedzią jest inny model
Najpierw sprawdź wybór zadania, jakość klatki, role referencji i instrukcje dla kamery, bo te problemy towarzyszą ci w każdym modelu. Przechodź dalej, gdy wymaganie przekracza kontrakt 2.0: Seedance 2.5 działa od 4 do 30 sekund i przyjmuje do 30 obrazów, 10 klipów i 10 plików audio w zadaniu referencja na wideo, z własnymi cenami i limitem 1080p. Przeczytaj jego przewodnik po promptach, zanim przeniesiesz prompt z 2.0. BytePlus publikuje też własny przewodnik po promptach.
FAQ
Czy mogę wklejać prompty używające @Image1 z innych przewodników?
Przepisz je. W SpicyAPI etykiety to image 1, video 1 i audio 1, dopasowane do kolejności tablic wejściowych.