Masz nagranie lektora i scenariusz, który jest dłuższy niż jeden akapit. Chatterbox v1 w SpicyAPI potrafi odczytać ten scenariusz głosem nagrania, część po części. Użycie tego samego pliku referencyjnego i tych samych trzech ustawień dla każdej części pomaga zachować spójny głos w całym rozdziale.
Na pierwsze uruchomienie wytnij czysty fragment od 10 do 15 sekund z głosem jednej osoby w żądanym stylu i użyj wartości domyślnych exaggeration: 0.5, guidance_scale: 0.5 i temperature: 0.7. Na podstawie naszych testów z października 2026 roku nagranie kończy się po 40 sekundach, więc długie scenariusze dziel na części po około 500 znaków (około 27 sekund). Każde żądanie kosztuje stałe 0,036 $ niezależnie od długości, więc dziesięciominutowa narracja to około 17 do 24 części i 0,61 $ do 0,86 $ przed powtórkami. Zadanie jest asynchroniczne, tylko po angielsku i zwraca jeden plik WAV.
Jeśli potrzebujesz tylko stabilnego głosu, a nie konkretnego nagrania, modele z głosami predefiniowanymi dają to przez stały voice_id (porównanie „Uncensored Text-to-Speech APIs Compared” wymienia je wraz z cenami).
Co przyjmuje zadanie hostowane
Schemat Chatterbox v1 text to speech ma pięć pól:
| Pole | Dozwolone wartości | Praktyczny pierwszy wybór |
|---|---|---|
text | 1–1 000 znaków angielskich | Krótki fragment kończący się pełnym zdaniem |
reference_audio_url | Opcjonalny MP3 lub WAV; limit 90 MB | Czysty fragment jednej osoby, której głosu masz prawo używać |
exaggeration | 0–1 | 0.5 |
guidance_scale | 0.1–1 | 0.5 |
temperature | 0.05–2 | 0.7 |
Referencja jest opcjonalna. Pomiń ją, aby usłyszeć wbudowany głos — to szybki sposób na ocenę scenariusza, zanim zaczniesz myśleć o klonie. Z referencją czytanie przejmuje głos tego fragmentu; nic nie jest trenowane i żaden głos nie jest zapisywany, więc wysyłasz referencję ponownie przy każdym żądaniu. Cena się nie zmienia.
Wynikiem jest jeden plik WAV mono 24 kHz, 16-bitowy, bez znaczników czasu dla słów i bez napisów. Zadanie nie ma mnożnika prędkości, seeda, wyboru języka ani listy głosów. Oczekuj, że tagi w nawiasach kwadratowych, takie jak [sigh] czy <laugh>, zostaną odczytane na głos jako słowa. Zapisz dźwięk literami („Mmm…”, „ha…”) i trzymaj wskazówki reżyserskie poza text.
Przygotuj referencję pasującą do narracji
Referencja decyduje, czyj głos słyszysz, a także jak ten głos prowadzi tempo i podaje tekst. Przygotuj ją pod narrację, której chcesz, a nie pod najbardziej dramatyczną próbkę, jaką masz.
- Długość i format. Maintainerzy zalecają co najmniej 10 sekund, najlepiej WAV w 24 kHz lub wyższej, jedną osobę, brak szumu tła i sposób podania zgodny z tym, co chcesz usłyszeć: dla materiału w stylu audiobooka użyj fragmentu w stylu audiobooka.
- Zacznij od czystej mowy. Początek fragmentu ma największe znaczenie, ale hałaśliwy lub nietypowy fragment dalej w długim pliku też się liczy. Wytnij czyste 10 do 15 sekund zaczynające się od mowy.
- Dopasuj tempo. Referencja przenosi swoją prędkość do wyniku, więc wybierz fragment w tempie, w jakim ma płynąć narracja.
- Użyj fragmentu po angielsku. Referencja w innym języku może przynieść ze sobą własny akcent.
- Usuń to, czego nie chcesz kopiować. Muzyka, drugi głos, pogłos pomieszczenia, przycięte szczyty i długie fragmenty ciszy sprawiają, że przykład jest mniej czytelny. Agresywne usuwanie szumu, które wgryza się w głos, może być gorsze niż trochę stałego szumu tła, więc zachowaj nietknięty oryginał i porównaj.
- Nietypowe głosy sprawdź najpierw na jednym zdaniu. Niektóre akcenty się rozjeżdżają: australijski akcent może wyjść amerykański. Wydaj 0,036 $ na jedno zdanie, zanim ruszysz cały rozdział.
To polecenie wycina z surowego nagrania fragment 12-sekundowy zaczynający się od 3,2 sekundy i zapisuje go jako WAV mono 24 kHz, 16-bitowy (wymaga ffmpeg). 24 kHz to częstotliwość, przy której pracuje model, i dolna granica maintainerów; obniżenie nagrania 44,1 lub 48 kHz do niej jest w porządku, ale schodzenie niżej niczego nie daje:
ffmpeg -i narrator-raw.wav -ss 3.2 -t 12 -ac 1 -ar 24000 -c:a pcm_s16le reference.wavKorzystaj wyłącznie z głosu, do którego masz prawo: z lektora, który wyraził zgodę na piśmie, a nie z fragmentu wziętego z filmu lub z serwisu społecznościowego.
Najpierw wypróbuj w Playground
Otwórz stronę Chatterbox text to speech i użyj zakładki Playground. Fragment liczący około 240 znaków pokazuje tempo i intonację przy niewielkim koszcie:
I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.
- Wklej fragment w Text.
- W sekcji Voice reference wybierz przygotowany plik przez Choose a file (MP3 lub WAV, do 90 MB). Jeśli chcesz użyć pliku już dostępnego w sieci, wklej jego link w Asset URL i wybierz Add URL; musi to być bezpośredni link do pliku audio, bo strona dysku w chmurze lub udostępnienia w serwisie społecznościowym zwraca stronę internetową, a zadanie kończy się błędem
invalid_asset. Pomiń ten krok, aby usłyszeć wbudowany głos. - Zostaw Expressiveness (
exaggeration), Temperature i Prompt adherence (guidance_scale) na wartościach domyślnych: 0.5, 0.7 i 0.5. - Uruchom. Cena 0,036 $ wyświetla się obok formularza.
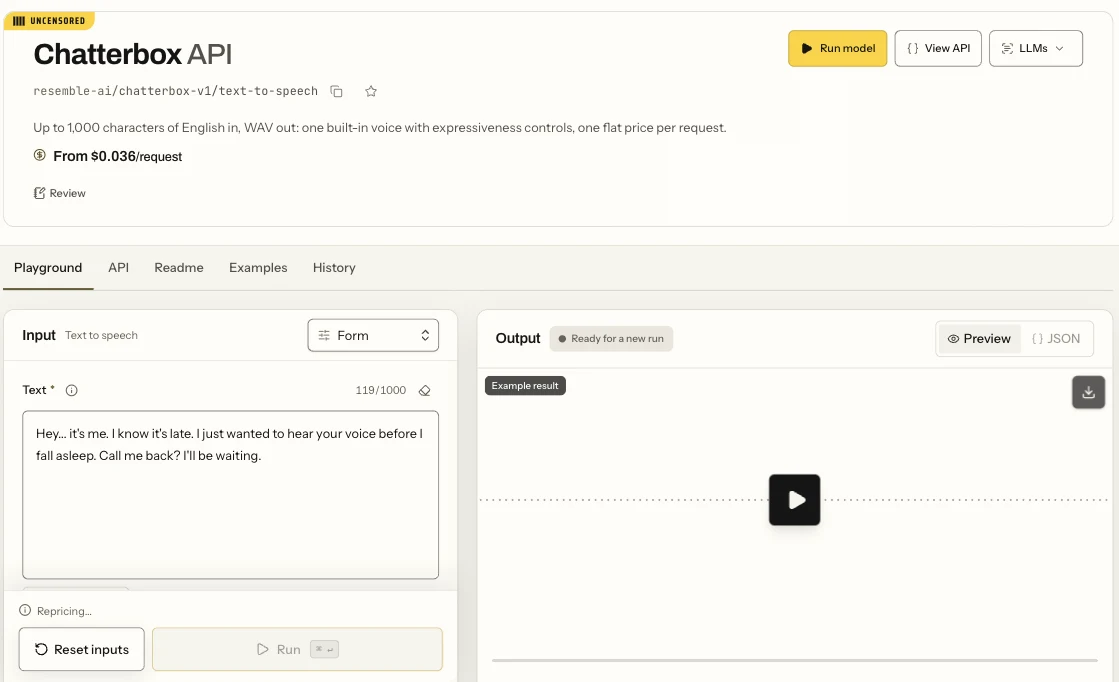
Playground syntezy mowy Chatterbox w widoku Formularz: pole tekstowe i przycisk Run.
Odsłuchaj całą część ze scenariuszem w ręku: wszystkie słowa obecne, pierwsze i ostatnie zdanie w całości, ta sama osoba przez cały czas, na końcu ani ciszy, ani szumu. Trzymaj jeden plik referencyjny na cały projekt; ponowne cięcie między częściami zmienia głos.
Potem wywołaj to z kodu
Gdy część brzmi dobrze, wyślij to samo żądanie z własnej aplikacji. Ustaw SPICY_API_KEY na klucz serwerowy i wskaż reference_audio_url na bezpośredni link HTTPS do fragmentu albo na adres spicy:// wypisany przez spicyapi files upload ./reference.wav (przesłany plik działa około doby):
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "resemble-ai/chatterbox-v1/text-to-speech",
    "input": {
      "text": "I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.",
      "reference_audio_url": "https://example.com/reference.wav",
      "exaggeration": 0.5,
      "guidance_scale": 0.5,
      "temperature": 0.7
    }
  }'
Wyniki, pliki do pobrania i błędy znajdziesz w dokumentacji zadań; przesyłanie plików opisuje przewodnik Media.
Albo niech części wygeneruje Agent
Agent może wykonać to samo wywołanie przez CLI, serwer MCP lub Agent Skill. CLI i MCP pokazują cenę i proszą o potwierdzenie przed utworzeniem zadania. Przy ustawionej SPICY_API_KEY i pliku input.json zawierającym wyłącznie obiekt input z powyższego żądania:
# CLI
spicyapi files upload ./reference.wav    # prints a spicy:// URI for reference_audio_url
spicyapi tasks create --model resemble-ai/chatterbox-v1/text-to-speech --input-file input.json --wait

# MCP server: the command your assistant's MCP config runs
# (it exposes spicyapi_upload_file and spicyapi_task_create)
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
Zmień ustawienie, które pasuje do tego, co słyszysz
Zmieniaj po jednym ustawieniu na część i nie ruszaj tekstu ani referencji, żeby wiedzieć, co spowodowało różnicę. Trzy części (bazowa, jedna zmiana ekspresji, jedna zmiana tempa) kosztują 0,108 $.
| Co słyszysz | Spróbuj najpierw | Dlaczego |
|---|---|---|
| Płasko, bez akcentów | exaggeration (Expressiveness) 0.7 | Wyższe wartości dodają ekspresji; tempo zmieniło się w naszym teście minimalnie (13,0 s wobec 13,4 s dla tych samych 240 znaków), więc oceniaj na słuch |
| Spieszone | guidance_scale (Prompt adherence) 0.3 | Obniżenie spowalnia czytanie: te same 240 znaków trwały 15,0 s przy 0,3 wobec 13,4 s przy 0,5 |
| Spieszone niezależnie od suwaków | Spokojniejsza referencja | Referencja przenosi swoje tempo |
| Jedno słowo wypowiedziane źle | Popraw text: rozwiń skrót literowo, zapisz liczby tak, jak chcesz je usłyszeć, podziel długie zdanie | Zadanie nie ma słownika wymowy |
| Dźwięk czytany jako słowo | Usuń tag; napisz „Mmm…” lub „ha…” | Tagi są w tym zadaniu czytane na głos |
| Nie brzmi jak lektor | Popraw referencję: szum, drugi głos, inny akcent lub inne podanie | temperature zmienia poszczególne części; to nie jest sterowanie tożsamością |
| Części różnią się bardziej, niż chcesz | Obniż temperature (spróbuj 0.5) | Steruje rozrzutem między częściami |
Dwa przykłady na stronie modelu dają orientacyjną wskazówkę: przy wartościach domyślnych nasze części szły z prędkością około 16 do 19 znaków na sekundę, a przykład spokojnej narracji, z exaggeration i guidance_scale na 0.3, około 14. Dla cichego tempa wieczornej bajki obniż oba. Nie kopiuj wartości ze skryptu open source: domyślna wartość temperature w wersji hostowanej to 0.7, a w open source 0.8.
Podziel dłuższe scenariusze na części po około 500 znaków
Żądanie przyjmuje 1 000 znaków, ale nagranie ma limit 40 sekund. Przy około 18 znakach na sekundę 700 znaków wróciło jako 36 sekund, a 900 i 998 znaków wróciły oba dokładnie jako 40 sekund, choć taka ilość tekstu wymaga około 49 sekund, więc koniec jest ucinany, a i tak płacisz pełne 0,036 $. Trzymaj części mniej więcej po 500 znaków (część o 492 znakach trwała 27 sekund) i sprawdzaj ostatnie zdanie każdej części.
Stała cena sprawia, że ten kompromis łatwo policzyć. Rozdział o 2 430 znaków kosztuje:
- 3 żądania po około 810 znaków: 0,108 $, ale każde wymaga około 45 sekund i jest ucinane do 40.
- 5 części po około 490 znaków: 0,18 $.
- 9 części po około 270 znaków, każda około 15 sekund: 0,324 $.
Dolicz zapas na powtórki: dwie powtórki w planie pięciu części dają siedem żądań, 0,252 $. Poprawienie jednego słowa też kosztuje pełne 0,036 $, więc powtórz całe zdanie albo całą część, zamiast łatać słowa pojedynczo.
Tnij na końcach akapitów albo między pełnymi zdaniami i zostawiaj kilka zdań razem dla kontekstu; części po około 300 do 500 znaków brzmią naturalnie. Używaj tego samego pliku referencyjnego, tych samych trzech liczb i tych samych konwencji tekstu dla każdej części i licz znaki razem ze spacjami i interpunkcją, a nie słowa.
Części dotarły z podobną głośnością; przycisz tę głośniejszą przed scaleniem. To polecenie skleja części z krótką przerwą między nimi (dopasuj 0,35 sekundy do sposobu, w jaki lektor robi przerwę między akapitami):
ffmpeg -y -f lavfi -i anullsrc=r=24000:cl=mono -t 0.35 -c:a pcm_s16le gap.wav
printf "file 'part-01.wav'\nfile 'gap.wav'\nfile 'part-02.wav'\nfile 'gap.wav'\nfile 'part-03.wav'\n" > list.txt
ffmpeg -y -f concat -safe 0 -i list.txt -c copy narration.wav
Jeśli jedna część jest zła, wygeneruj ponownie tylko tę część z tą samą referencją i tymi samymi ustawieniami; jeśli to się nie uda, zmień tekst przed trzecią próbą.
Kiedy Chatterbox nie jest właściwym narzędziem
- Inny język albo dwie osoby. Zadanie hostowane jest tylko po angielsku i czyta jeden głos na żądanie. Dla dwóch osób wyślij po jednym żądaniu na osobę i sklej pliki tak, jak pokazano wyżej, albo użyj jednego z trzech modeli syntezy mowy Gemini, których pole dialogu miesza do dwóch predefiniowanych głosów w jednym żądaniu (porównanie je wymienia). Dialog używa predefiniowanych głosów, a nie Twojego fragmentu referencyjnego. Dla innych języków porównanie obejmuje języki i ceny.
- Twarz, która wypowiada kwestię. Plik WAV nie zawiera danych o czasie. Przekaż go modelowi synchronizacji ust lub mówiącemu awatarowi, takiemu jak Talking Avatar czy Lip Sync.
- Napisy. Przepuść gotowe nagranie przez etap rozpoznawania mowy; nie wyliczaj czasów z długości scenariusza.
W przypadku fikcji dla dorosłych SpicyAPI nie dodaje filtra treści, a scenariusze dla dorosłych zostały w całości odczytane wbudowanym głosem. Nie czytaj scenariuszy dla dorosłych głosem prawdziwej osoby bez jej zgody.
Najczęstsze pytania
Czy Chatterbox obsługuje klonowanie głosu? Zadanie hostowane naśladuje głos opcjonalnej referencji MP3 lub WAV, ale nie trenuje żadnego głosu.
Czy klonowanie głosu jest nielegalne? To zależy od zgody, od tego, gdzie jesteś ty i gdzie jest lektor, oraz od tego, do czego nagranie służy. Użycie cudzego głosu bez pozwolenia albo przedstawienie mowy syntetycznej jako wypowiedzi prawdziwej osoby może stwarzać problemy prawne. Przechowuj zgodę w dokumentach i tam, gdzie to wymagane, ujawnij, że nagranie jest syntetyczne.
Czy mogę zapisać głos i wywoływać go po nazwie? Nie. Schemat nie ma voice ID, więc za każdym razem wysyłasz plik referencyjny.
Od czego zacząć
Wgraj do Playground czystą referencję trwającą 10 do 15 sekund i wykonaj jedną część o 240 znakach przy wartościach domyślnych za 0,036 $. Jeśli brzmi dobrze, podziel scenariusz na części po około 500 znaków i powtórz tylko te, które nie wyszły; jeśli nie, najpierw popraw referencję albo to jedno ustawienie z tabeli powyżej.





