Você tem uma gravação de uma pessoa narradora e um roteiro que passa de um parágrafo. O Chatterbox v1 na SpicyAPI consegue ler esse roteiro com o timbre da gravação, um bloco de cada vez. Usar o mesmo arquivo de referência e os mesmos três ajustes em cada bloco ajuda a manter a voz consistente ao longo de um capítulo.
Para a primeira execução, corte um trecho limpo de 10 a 15 segundos de uma única pessoa no estilo que você quer e use os valores padrão exaggeration: 0.5, guidance_scale: 0.5 e temperature: 0.7. Com base nos nossos testes de outubro de 2026, a saída para em 40 segundos, então divida roteiros longos em blocos de cerca de 500 caracteres (cerca de 27 segundos). Cada requisição custa um preço fixo de $0,036 qualquer que seja o tamanho, então uma narração de dez minutos dá cerca de 17 a 24 blocos, $0,61 a $0,86 antes das refações. A tarefa é assíncrona, somente em inglês e devolve um arquivo WAV.
Se você só precisa de uma voz estável, não de uma gravação específica, os modelos com vozes predefinidas entregam isso por meio de um voice_id fixo (a comparação «Uncensored Text-to-Speech APIs Compared» os lista com os preços).
O que a tarefa hospedada aceita
O esquema do Chatterbox v1 text to speech tem cinco campos:
| Campo | Valores válidos | Primeira escolha prática |
|---|---|---|
text | 1–1.000 caracteres em inglês | Uma passagem curta que termine numa frase completa |
reference_audio_url | MP3 ou WAV opcional; limite de 90 MB | Um trecho limpo de uma única pessoa que você tem direito de usar |
exaggeration | 0–1 | 0.5 |
guidance_scale | 0.1–1 | 0.5 |
temperature | 0.05–2 | 0.7 |
A referência é opcional. Deixe de fora para ouvir a voz embutida, um jeito rápido de avaliar um roteiro antes de se preocupar com um clone. Com referência, a leitura assume o timbre daquele trecho; nada é treinado e nenhuma voz é salva, então você envia a referência de novo a cada requisição. O preço não muda.
A saída é um único WAV mono de 24 kHz, 16 bits, sem marcações de tempo por palavra nem legendas. A tarefa não tem multiplicador de velocidade, seed, seletor de idioma nem lista de vozes. Espere que tags entre colchetes como [sigh] ou <laugh> sejam lidas em voz alta como palavras. Escreva um som por extenso («Mmm…», «ha…») e tire as indicações de cena de text.
Prepare uma referência que combine com a narração
A referência decide de quem é a voz que você ouve e também como ela marca o ritmo e atua. Prepare-a para a narração que você quer, não para a amostra mais dramática que você tem.
- Duração e formato. Os mantenedores recomendam pelo menos 10 segundos, idealmente WAV a 24 kHz ou mais, uma única pessoa, sem ruído de fundo e uma entrega que combine com o que você quer receber: para uma saída no estilo audiolivro, use um trecho no estilo audiolivro.
- Comece com fala limpa. O começo do trecho pesa mais, mas uma seção ruidosa ou fora de estilo mais adiante em um arquivo longo também conta. Corte 10 a 15 segundos limpos que comecem com fala.
- Acompanhe o ritmo. A referência carrega sua velocidade para o resultado, então escolha o trecho na velocidade que a narração deve ter.
- Use um trecho em inglês. Uma referência em outro idioma pode trazer o sotaque dela.
- Remova o que você não quer que seja copiado. Música, uma segunda voz, eco da sala, picos cortados e silêncios longos tornam o exemplo menos claro. Uma redução de ruído agressiva que corrói a voz pode ser pior do que um pouco de ruído de fundo constante, então guarde o original sem tocar e compare.
- Teste vozes incomuns em uma frase primeiro. Alguns sotaques derivam: um sotaque australiano pode sair americano. Gaste $0,036 em uma única frase antes de um capítulo inteiro.
Este comando recorta um trecho de 12 segundos a partir do segundo 3,2 de uma gravação bruta e salva como WAV mono de 24 kHz, 16 bits (precisa do ffmpeg). 24 kHz é a taxa em que o modelo trabalha e o piso dos mantenedores; converter uma gravação de 44,1 ou 48 kHz para ela tudo bem, mas não há ganho em ir abaixo:
ffmpeg -i narrator-raw.wav -ss 3.2 -t 12 -ac 1 -ar 24000 -c:a pcm_s16le reference.wavUse apenas uma voz que você tem direito de usar: uma narradora que concordou por escrito, não um trecho de um vídeo ou de um feed social.
Teste primeiro no Playground
Abra a página do Chatterbox text to speech e use a aba Playground. Uma passagem de cerca de 240 caracteres mostra ritmo e entonação com pouco custo:
I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.
- Cole a passagem em Text.
- Em Voice reference, escolha o trecho preparado com Choose a file (MP3 ou WAV, até 90 MB). Para usar um arquivo que já está online, cole o link em Asset URL e selecione Add URL; ele precisa ser um link direto para o arquivo de áudio, porque uma página de nuvem ou de compartilhamento social devolve uma página web e a tarefa falha com
invalid_asset. Pule este passo para ouvir a voz embutida. - Mantenha Expressiveness (
exaggeration), Temperature e Prompt adherence (guidance_scale) nos valores padrão: 0.5, 0.7 e 0.5. - Execute. O preço, $0,036, aparece ao lado do formulário.
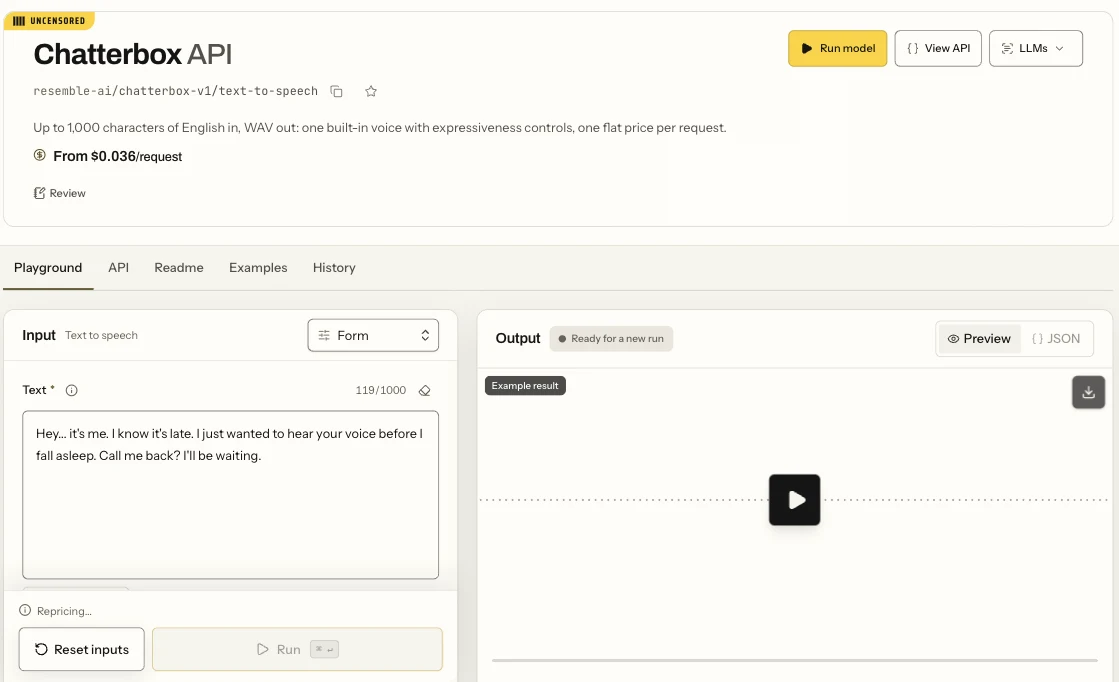
O Playground de síntese de voz do Chatterbox na visão Formulário: o campo de texto e o botão Run.
Ouça a tomada inteira com o roteiro à mão: todas as palavras presentes, a primeira e a última frases inteiras, a mesma pessoa do começo ao fim, sem silêncio morto nem ruído no fim. Mantenha um único arquivo de referência para o projeto todo; recortá-lo entre blocos muda a voz.
Depois chame pelo código
Quando uma tomada soar bem, envie a mesma requisição do seu próprio app. Defina SPICY_API_KEY com a sua chave de servidor e aponte reference_audio_url para um link HTTPS direto do trecho, ou para um endereço spicy:// impresso por spicyapi files upload ./reference.wav (um upload continua utilizável por cerca de um dia):
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "resemble-ai/chatterbox-v1/text-to-speech",
    "input": {
      "text": "I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.",
      "reference_audio_url": "https://example.com/reference.wav",
      "exaggeration": 0.5,
      "guidance_scale": 0.5,
      "temperature": 0.7
    }
  }'
Resultados, downloads e erros estão na documentação de tarefas; uploads estão no guia de mídia.
Ou deixe um agente fazer as tomadas
Um agente pode fazer a mesma chamada pelo CLI, pelo servidor MCP ou pelo Agent Skill. CLI e MCP mostram o preço e pedem confirmação antes de criar uma tarefa. Com SPICY_API_KEY definido e input.json contendo apenas o objeto input da requisição acima:
# CLI
spicyapi files upload ./reference.wav    # prints a spicy:// URI for reference_audio_url
spicyapi tasks create --model resemble-ai/chatterbox-v1/text-to-speech --input-file input.json --wait

# MCP server: the command your assistant's MCP config runs
# (it exposes spicyapi_upload_file and spicyapi_task_create)
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
Mude o controle que corresponde ao que você ouve
Mude um ajuste por tomada e mantenha o texto e a referência fixos, para saber o que causou a diferença. Três tomadas (uma base, uma mudança de expressão e uma mudança de ritmo) custam $0,108.
| O que você ouve | Tente primeiro | Por quê |
|---|---|---|
| Plano, sem ênfase | exaggeration (Expressiveness) 0.7 | Valores mais altos acrescentam ênfase; o ritmo quase não mudou no nosso teste (13,0 s contra 13,4 s para os mesmos 240 caracteres), então julgue pelo ouvido |
| Apressado | guidance_scale (Prompt adherence) 0.3 | Diminuí-lo deixa a leitura mais lenta: os mesmos 240 caracteres rodaram 15,0 s a 0,3 contra 13,4 s a 0,5 |
| Apressado com qualquer controle | Uma referência mais calma | A referência carrega o ritmo |
| Uma palavra está errada | Edite text: escreva uma sigla por extenso, escreva os números como as palavras que quer, divida uma frase longa | A tarefa não tem dicionário de pronúncia |
| Um som é lido como palavra | Remova a tag; escreva «Mmm…» ou «ha…» | As tags são lidas em voz alta nesta tarefa |
| Não soa como a narradora | Corrija a referência: ruído, uma segunda voz, outro sotaque ou outra entrega | temperature varia as tomadas; não é um controle de identidade |
| As tomadas diferem mais do que você quer | Baixe temperature (tente 0.5) | Ele controla a variação entre as tomadas |
Os dois exemplos na página do modelo dão uma ordem de grandeza: com os valores padrão nossas tomadas rodaram a cerca de 16 a 19 caracteres por segundo, e o exemplo de narração calma, com exaggeration e guidance_scale ambos em 0.3, a cerca de 14. Para um ritmo tranquilo de história de dormir, baixe os dois. Não copie valores do script open source: o padrão de temperature na versão hospedada é 0.7, enquanto o open source é 0.8.
Divida roteiros longos em blocos de cerca de 500 caracteres
Uma requisição aceita 1.000 caracteres, mas o áudio é limitado a 40 segundos. A cerca de 18 caracteres por segundo, 700 caracteres voltaram como 36 segundos, e 900 e 998 caracteres voltaram ambos como exatamente 40 segundos, enquanto esse texto precisa de cerca de 49 segundos, então o final é cortado e você ainda paga os $0,036 inteiros. Mantenha os blocos em cerca de 500 caracteres (uma tomada de 492 caracteres rodou 27 segundos) e confira a última frase de cada tomada.
O preço fixo torna a conta fácil. Um capítulo de 2.430 caracteres custa:
- 3 requisições de cerca de 810 caracteres: $0,108, mas cada uma precisa de cerca de 45 segundos e é cortada em 40.
- 5 blocos de cerca de 490 caracteres: $0,18.
- 9 blocos de cerca de 270 caracteres, cerca de 15 segundos cada: $0,324.
Some uma reserva para refações: duas refações no plano de cinco blocos dão sete requisições, $0,252. Consertar uma única palavra também custa os $0,036 inteiros, então refaça uma frase ou um bloco inteiro em vez de emendar palavra por palavra.
Corte no fim de parágrafos ou entre frases completas e mantenha várias frases juntas para dar contexto; blocos de cerca de 300 a 500 caracteres soam naturais. Use o mesmo arquivo de referência, os mesmos três números e as mesmas convenções de texto em cada bloco e conte caracteres incluindo espaços e pontuação, não palavras.
Os blocos chegaram com volume parecido; abaixe o mais alto antes de juntar. Isto junta as tomadas com uma pausa curta entre elas (ajuste os 0,35 segundos ao tempo que a narradora pausa entre parágrafos):
ffmpeg -y -f lavfi -i anullsrc=r=24000:cl=mono -t 0.35 -c:a pcm_s16le gap.wav
printf "file 'part-01.wav'\nfile 'gap.wav'\nfile 'part-02.wav'\nfile 'gap.wav'\nfile 'part-03.wav'\n" > list.txt
ffmpeg -y -f concat -safe 0 -i list.txt -c copy narration.wav
Se um bloco sair errado, gere apenas esse bloco de novo com a mesma referência e os mesmos ajustes; se ele falhar duas vezes, mude o texto antes de uma terceira tomada.
Quando o Chatterbox não é a ferramenta certa
- Outro idioma, ou duas pessoas. A tarefa hospedada é somente em inglês e lê uma voz por requisição. Para duas pessoas, faça uma requisição por pessoa e junte os arquivos como mostrado acima, ou use um dos três modelos de síntese de voz do Gemini, cujo campo de diálogo mistura até duas vozes predefinidas em uma requisição (a comparação os lista). Um diálogo usa vozes predefinidas, não o seu trecho de referência. Para outros idiomas, a comparação cobre idiomas e preços.
- Um rosto que diz a fala. O WAV não tem dados de tempo. Passe para um modelo de sincronização labial ou avatar falante como Talking Avatar ou Lip Sync.
- Legendas. Passe o áudio final por uma etapa de transcrição; não derive os tempos do tamanho do roteiro.
Para ficção adulta, a SpicyAPI não adiciona filtro de conteúdo e os roteiros adultos foram lidos por inteiro na voz embutida. Não leia roteiros adultos na voz de uma pessoa real sem o consentimento dela.
Perguntas frequentes
O Chatterbox suporta clonagem de voz? A tarefa hospedada imita o timbre de uma referência MP3 ou WAV opcional, mas não treina uma voz.
É ilegal clonar uma voz? Depende do consentimento, de onde você e a pessoa narradora estão e do uso que será feito do áudio. Usar a voz de alguém sem permissão, ou apresentar fala sintética como uma declaração de uma pessoa real, pode criar problemas legais. Guarde a permissão em arquivo e, onde exigido, revele que o áudio é sintético.
Posso salvar a voz e chamá-la pelo nome? Não. O esquema não tem ID de voz, então você envia o arquivo de referência todas as vezes.
Por onde começar
Envie ao Playground uma referência limpa de 10 a 15 segundos e rode uma tomada de 240 caracteres com os valores padrão por $0,036. Se soar bem, divida o roteiro em blocos de cerca de 500 caracteres e refaça só os que falharem; se não, conserte antes a referência ou o único controle da tabela acima.





