Hai la registrazione di una voce narrante e un copione che supera un paragrafo. Chatterbox v1 su SpicyAPI può leggere quel copione con il timbro della registrazione, un blocco alla volta. Usare lo stesso file di riferimento e le stesse tre impostazioni per ogni blocco aiuta a mantenere coerente la voce in tutto un capitolo.
Per una prima prova, taglia un frammento pulito di 10-15 secondi di una sola persona nello stile che desideri e usa i valori predefiniti exaggeration: 0.5, guidance_scale: 0.5 e temperature: 0.7. Dai nostri test di ottobre 2026, l'output si ferma a 40 secondi, quindi dividi i copioni lunghi in blocchi di circa 500 caratteri (circa 27 secondi). Ogni richiesta costa un prezzo fisso di $0.036 indipendentemente dalla lunghezza, quindi una narrazione di dieci minuti corrisponde a circa 17-24 blocchi, $0.61 a $0.86 prima delle riprese. L'attività è asincrona, solo in inglese e restituisce un unico file WAV.
Se ti serve solo una voce stabile, non una registrazione precisa, i modelli con voci predefinite te la danno tramite un voice_id fisso (il confronto «Uncensored Text-to-Speech APIs Compared» li elenca con i prezzi).
Che cosa accetta l'attività ospitata
Lo schema di Chatterbox v1 text to speech ha cinque campi:
| Campo | Valori validi | Prima scelta pratica |
|---|---|---|
text | 1-1.000 caratteri inglesi | Un breve passaggio che finisca con una frase completa |
reference_audio_url | MP3 o WAV opzionale; limite 90 MB | Un frammento pulito di una sola persona che hai il diritto di usare |
exaggeration | 0-1 | 0.5 |
guidance_scale | 0.1-1 | 0.5 |
temperature | 0.05-2 | 0.7 |
Il riferimento è opzionale. Omettilo per sentire la voce integrata, un modo rapido di valutare un copione prima di preoccuparti di un clone. Con un riferimento, la lettura assume il timbro di quel frammento; non viene addestrato nulla e nessuna voce viene salvata, quindi invii di nuovo il riferimento a ogni richiesta. Il prezzo non cambia.
L'output è un unico WAV mono a 24 kHz, 16 bit, senza tempi per parola né sottotitoli. L'attività non ha moltiplicatore di velocità, seed, selettore di lingua o elenco di voci. Aspettati che i tag tra parentesi quadre come [sigh] o <laugh> vengano letti ad alta voce come parole. Scrivi per esteso un suono («Mmm…», «ha…») e tieni le indicazioni di scena fuori da text.
Prepara un riferimento adatto alla narrazione
Il riferimento decide di chi è la voce che senti e anche come scandisce il ritmo e recita. Preparalo per la narrazione che vuoi, non per il campione più drammatico che possiedi.
- Lunghezza e formato. I manutentori consigliano almeno 10 secondi, idealmente WAV a 24 kHz o superiori, una sola persona, nessun rumore di fondo e una recitazione che corrisponda a ciò che vuoi ottenere: per un output in stile audiolibro, usa un frammento in stile audiolibro.
- Inizia con voce pulita. L'inizio del frammento conta più di tutto, ma una sezione rumorosa o fuori stile più avanti in un file lungo conta comunque. Taglia 10-15 secondi puliti che inizino con il parlato.
- Abbina il ritmo. Il riferimento porta con sé la sua velocità nel risultato, quindi scegli il frammento alla velocità che la narrazione dovrebbe avere.
- Usa un frammento in inglese. Un riferimento in un'altra lingua può portare dentro il suo accento.
- Rimuovi ciò che non vuoi far copiare. Musica, una seconda voce, eco della stanza, picchi tagliati e lunghe pause rendono l'esempio meno chiaro. Una riduzione del rumore aggressiva che intacca la voce può essere peggio di un po' di rumore di fondo costante, quindi conserva l'originale non toccato e confronta.
- Prova prima le voci insolite su una frase. Alcuni accenti migrano: un accento australiano può uscire americano. Spendi $0.036 su una sola frase prima di un capitolo intero.
Questo comando ritaglia da una registrazione grezza una sezione di 12 secondi che parte dal secondo 3.2 e la salva come WAV mono 24 kHz, 16 bit (richiede ffmpeg). 24 kHz è la frequenza con cui lavora il modello e il minimo dei manutentori; convertire a essa una registrazione a 44.1 o 48 kHz va bene, ma scendere più in basso non porta benefici:
ffmpeg -i narrator-raw.wav -ss 3.2 -t 12 -ac 1 -ar 24000 -c:a pcm_s16le reference.wavUsa solo una voce che hai il diritto di usare: una voce narrante che ha accettato per iscritto, non un frammento preso da un video o da un feed social.
Provalo prima nel Playground
Apri la pagina di Chatterbox text to speech e usa la scheda Playground. Un passaggio di circa 240 caratteri mostra ritmo e intonazione a basso costo:
I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.
- Incolla il passaggio in Text.
- In Voice reference scegli il frammento preparato con Choose a file (MP3 o WAV, fino a 90 MB). Per usare un file già online, incolla il suo link in Asset URL e seleziona Add URL; deve essere un link diretto al file audio, perché una pagina di cloud drive o condivisione social restituisce una pagina web e l'attività fallisce con
invalid_asset. Salta questo passaggio per sentire la voce integrata. - Lascia Expressiveness (
exaggeration), Temperature e Prompt adherence (guidance_scale) ai loro valori predefiniti: 0.5, 0.7 e 0.5. - Esegui. Il prezzo, $0.036, compare accanto al modulo.
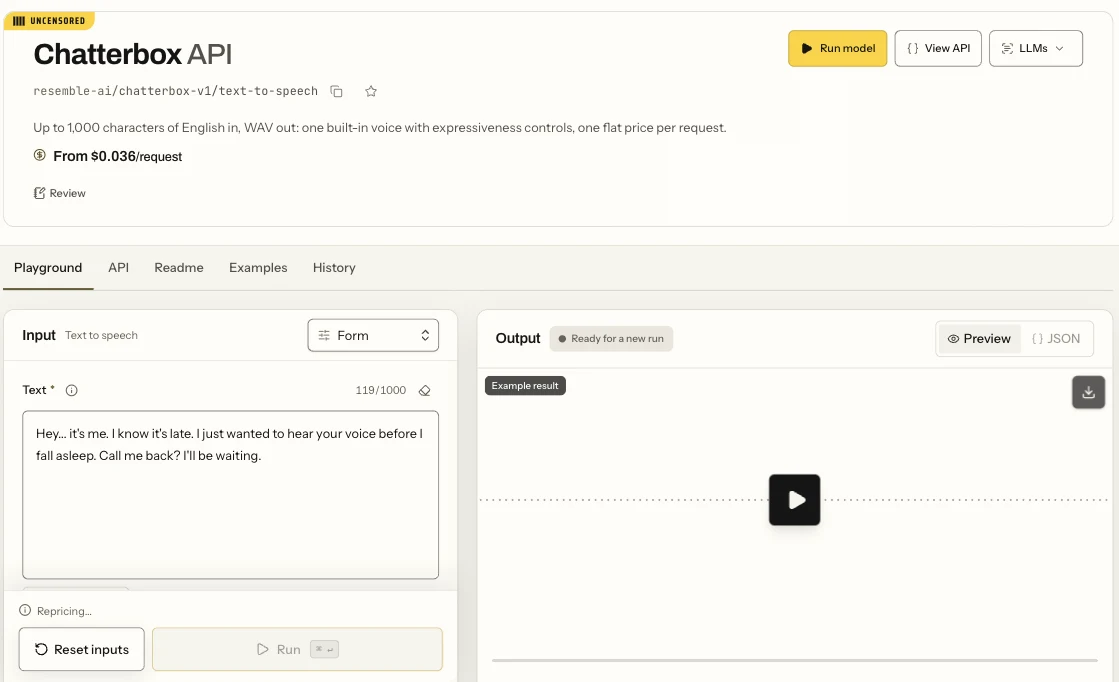
Il Playground di sintesi vocale di Chatterbox in vista Modulo: il campo di testo e il pulsante Run.
Ascolta l'intera presa con il copione accanto: ogni parola presente, la prima e l'ultima frase integre, la stessa persona dall'inizio alla fine, nessun vuoto o rumore in coda. Tieni un solo file di riferimento per tutto il progetto; ritagliarlo tra un blocco e l'altro cambia la voce.
Poi chiamala dal codice
Quando una presa suona bene, invia la stessa richiesta dalla tua app. Imposta SPICY_API_KEY sulla tua chiave lato server e punta reference_audio_url a un link HTTPS diretto al frammento, oppure a un indirizzo spicy:// stampato da spicyapi files upload ./reference.wav (un caricamento resta utilizzabile per circa un giorno):
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "resemble-ai/chatterbox-v1/text-to-speech",
    "input": {
      "text": "I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.",
      "reference_audio_url": "https://example.com/reference.wav",
      "exaggeration": 0.5,
      "guidance_scale": 0.5,
      "temperature": 0.7
    }
  }'
Risultati, download ed errori sono nella documentazione delle attività; i caricamenti sono nella guida Media.
Oppure lascia che un Agent esegua le prese
Un agent può fare la stessa chiamata tramite la CLI, il server MCP o l'Agent Skill. CLI e MCP mostrano il prezzo e ti chiedono conferma prima di creare un'attività. Con SPICY_API_KEY impostato e input.json che contiene solo l'oggetto input della richiesta sopra:
# CLI
spicyapi files upload ./reference.wav    # prints a spicy:// URI for reference_audio_url
spicyapi tasks create --model resemble-ai/chatterbox-v1/text-to-speech --input-file input.json --wait

# MCP server: the command your assistant's MCP config runs
# (it exposes spicyapi_upload_file and spicyapi_task_create)
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
Cambia il controllo che corrisponde a ciò che senti
Cambia un solo parametro per presa e tieni fissi testo e riferimento, così sai che cosa ha causato la differenza. Tre prese (di base, una variazione di espressione, una di ritmo) costano $0.108.
| Cosa senti | Prova prima | Perché |
|---|---|---|
| Piatto, senza enfasi | exaggeration (Expressiveness) 0.7 | I valori più alti aggiungono enfasi; il ritmo è cambiato appena nel nostro test (13.0 s contro 13.4 s per gli stessi 240 caratteri), quindi giudica a orecchio |
| Di fretta | guidance_scale (Prompt adherence) 0.3 | Abbassarlo rallenta la lettura: gli stessi 240 caratteri durano 15.0 s a 0.3 contro 13.4 s a 0.5 |
| Di fretta con qualunque cursore | Un riferimento più calmo | Il riferimento porta con sé il ritmo |
| Una parola è sbagliata | Modifica text: scrivi per esteso un'abbreviazione, scrivi i numeri come le parole che vuoi, spezza una frase lunga | L'attività non ha dizionario di pronuncia |
| Un suono viene letto come parola | Rimuovi il tag; scrivi «Mmm…» o «ha…» | I tag vengono letti ad alta voce in questa attività |
| Non suona come la voce narrante | Correggi il riferimento: rumore, una seconda voce, un accento o una recitazione diversi | temperature varia le prese; non è un controllo dell'identità |
| Le prese differiscono più di quanto vuoi | Abbassa temperature (prova 0.5) | Controlla la variazione tra le prese |
I due esempi nella pagina del modello danno un'idea approssimativa: con i valori predefiniti le nostre prese correvano a circa 16-19 caratteri al secondo, e l'esempio di narrazione calma, con exaggeration e guidance_scale entrambi a 0.3, a circa 14. Per un ritmo tranquillo da fiaba per la notte, abbassa entrambi. Non copiare i valori dallo script open source: il valore predefinito di temperature ospitato è 0.7, mentre quello open source è 0.8.
Dividi i copioni lunghi in blocchi di circa 500 caratteri
Una richiesta accetta 1.000 caratteri, ma l'audio è limitato a 40 secondi. A circa 18 caratteri al secondo, 700 caratteri sono tornati come 36 secondi, mentre 900 e 998 caratteri sono tornati entrambi come esattamente 40 secondi, anche se quella quantità di testo richiede circa 49 secondi: la fine viene tagliata e paghi comunque i $0.036 pieni. Tieni i blocchi a circa 500 caratteri (una presa di 492 caratteri è durata 27 secondi) e controlla l'ultima frase di ogni presa.
Il prezzo fisso rende il compromesso facile da calcolare. Un capitolo di 2.430 caratteri costa:
- 3 richieste di circa 810 caratteri: $0.108, ma ognuna richiede circa 45 secondi e viene tagliata a 40.
- 5 blocchi di circa 490 caratteri: $0.18.
- 9 blocchi di circa 270 caratteri, circa 15 secondi ciascuno: $0.324.
Aggiungi un margine per le riprese: due riprese sul piano a cinque blocchi fanno sette richieste, $0.252. Anche la riparazione di una sola parola costa tutti i $0.036, quindi riprendi un'intera frase o un intero blocco invece di rattoppare parola per parola.
Taglia a fine paragrafo o tra frasi complete e lascia più frasi insieme per dare contesto; blocchi di circa 300-500 caratteri suonano naturali. Usa lo stesso file di riferimento, gli stessi tre numeri e le stesse convenzioni di testo per ogni blocco, e conta i caratteri includendo spazi e punteggiatura, non le parole.
I blocchi sono arrivati con un volume simile; abbassa quello più forte prima di unirli. Questo comando unisce le prese con una breve pausa tra loro (adatta i 0.35 secondi a come la voce narrante fa pausa tra i paragrafi):
ffmpeg -y -f lavfi -i anullsrc=r=24000:cl=mono -t 0.35 -c:a pcm_s16le gap.wav
printf "file 'part-01.wav'\nfile 'gap.wav'\nfile 'part-02.wav'\nfile 'gap.wav'\nfile 'part-03.wav'\n" > list.txt
ffmpeg -y -f concat -safe 0 -i list.txt -c copy narration.wav
Se un blocco è sbagliato, rigenera solo quel blocco con lo stesso riferimento e le stesse impostazioni; se fallisce due volte, cambia il testo prima di una terza presa.
Quando Chatterbox non è lo strumento giusto
- Un'altra lingua, o due persone. L'attività ospitata è solo in inglese e legge una voce per richiesta. Per due persone, fai una richiesta per persona e unisci i file come sopra, oppure usa uno dei tre modelli di sintesi vocale di Gemini, il cui campo di dialogo mescola fino a due voci predefinite in una richiesta (il confronto li elenca). Un dialogo usa voci predefinite, non il tuo frammento di riferimento. Per le altre lingue, il confronto copre lingue e prezzi.
- Un viso che pronuncia la battuta. Il WAV non ha dati di timing. Passalo a un modello di sincronizzazione labiale o avatar parlante come Talking Avatar o Lip Sync.
- Sottotitoli. Passa l'audio finale attraverso una fase di trascrizione vocale (speech-to-text); non ricavare i tempi dalla lunghezza del copione.
Per la fiction adulta, SpicyAPI non aggiunge alcun filtro sui contenuti e i copioni adulti sono stati letti per intero con la voce integrata. Non leggere copioni adulti con la voce di una persona reale senza il suo consenso.
Domande frequenti
Chatterbox supporta la clonazione vocale? L'attività ospitata imita il timbro di un riferimento MP3 o WAV opzionale, ma non addestra una voce.
È illegale clonare una voce? Dipende dal consenso, da dove ti trovi tu e dove si trova la voce narrante, e da come viene usato l'audio. Usare la voce di qualcuno senza permesso, o presentare una voce sintetica come una dichiarazione di una persona reale, può creare problemi legali. Conserva il permesso agli atti e, dove richiesto, dichiara che l'audio è sintetico.
Posso salvare la voce e chiamarla per nome? No. Lo schema non ha un voice ID, quindi invii il file di riferimento ogni volta.
Da dove cominciare
Carica nel Playground un riferimento pulito di 10-15 secondi ed esegui una presa di 240 caratteri con i valori predefiniti per $0.036. Se suona bene, dividi il copione in blocchi di circa 500 caratteri e riprendi solo quelli che falliscono; altrimenti correggi prima il riferimento o l'unico controllo nella tabella qui sopra.





