У вас есть запись голоса рассказчика и сценарий, который длиннее одного абзаца. Chatterbox v1 в SpicyAPI может прочитать этот сценарий тембром этой записи, по одной части за раз. Один и тот же файл референса и одни и те же три настройки для каждой части помогают сохранить ровный голос рассказчика на протяжении всей главы.
Для первого прогона вырежьте чистый фрагмент длиной от 10 до 15 секунд с голосом одного человека в нужном стиле и используйте значения по умолчанию exaggeration: 0.5, guidance_scale: 0.5 и temperature: 0.7. По нашим тестам октября 2026 года звук обрывается на 40 секундах, поэтому длинные сценарии разбивайте на части примерно по 500 символов (около 27 секунд). Каждый запрос стоит фиксированные $0.036 независимо от длины, поэтому десятиминутная озвучка — это примерно 17–24 части и $0.61–$0.86 до перезаписей. Задача асинхронная, только на английском и возвращает один WAV-файл.
Если вам нужна один стабильный голос, а не конкретная запись, модели с предустановленными голосами дают это через фиксированный voice_id (сравнение «Uncensored Text-to-Speech APIs Compared» перечисляет их с ценами).
Что принимает размещённая задача
В схеме Chatterbox v1 text to speech пять полей:
| Поле | Допустимые значения | Практический первый выбор |
|---|---|---|
text | 1–1 000 английских символов | Короткий отрывок, который заканчивается полным предложением |
reference_audio_url | Необязательный MP3 или WAV; предел 90 MB | Чистый фрагмент одного голоса, который вы имеете право использовать |
exaggeration | 0–1 | 0.5 |
guidance_scale | 0.1–1 | 0.5 |
temperature | 0.05–2 | 0.7 |
Референс необязателен. Опустите его, чтобы услышать встроенный голос: это быстрый способ оценить сценарий, прежде чем думать о клоне. С референсом чтение принимает тембр этого фрагмента; ничего не обучается и голос не сохраняется, поэтому отправляйте референс заново с каждым запросом. Цена не меняется.
Результат — один WAV, моно, 24 kHz, 16 бит, без пословных отметок времени и субтитров. У задачи нет множителя скорости, seed, выбора языка и списка голосов. Ожидайте, что теги в квадратных скобках вроде [sigh] или <laugh> будут произнесены вслух как слова. Пишите звук буквами («Mmm…», «ha…») и не оставляйте режиссёрские указания в text.
Подготовьте референс, подходящий для озвучки
Референс определяет, чей голос вы слышите, а также то, как он держит темп и подаёт материал. Готовьте его под ту озвучку, которую хотите, а не под самый драматичный имеющийся у вас образец.
- Длина и формат. Разработчики рекомендуют не менее 10 секунд, желательно WAV с частотой 24 kHz или выше, один голос, без фонового шума и с подачей, которая соответствует тому, что вы хотите получить: для звучания как в аудиокниге возьмите фрагмент, записанный как аудиокнига.
- Начинайте с чистой речи. Начало фрагмента важнее всего, но шумный или неподходящий по стилю отрезок дальше в длинном файле тоже считается. Вырежьте чистые 10–15 секунд, начинающихся с речи.
- Согласуйте темп. Референс переносит свою скорость в результат, поэтому выбирайте фрагмент в том темпе, который должен быть у озвучки.
- Берите фрагмент на английском. Референс на другом языке может принести свой акцент.
- Уберите то, что не должно копироваться. Музыка, второй голос, эхо комнаты, срезанные пики и длинные паузы делают пример невнятным. Агрессивное шумоподавление, которое вгрызается в голос, может быть хуже небольшого ровного фонового шума, поэтому сохраните нетронутый оригинал и сравните.
- Сначала проверьте необычные голоса на одном предложении. Некоторые акценты дрейфуют: австралийский акцент может получиться американским. Потратьте $0.036 на одно предложение, прежде чем браться за целую главу.
Эта команда вырезает из сырой записи отрезок длиной 12 секунд, начиная с отметки 3.2 секунды, и сохраняет его как WAV, моно, 24 kHz, 16 бит (нужен ffmpeg). 24 kHz — частота, на которой работает модель, и нижняя граница, которую задают разработчики; снизить запись с 44.1 или 48 kHz до неё нормально, но идти ниже смысла нет:
ffmpeg -i narrator-raw.wav -ss 3.2 -t 12 -ac 1 -ar 24000 -c:a pcm_s16le reference.wavИспользуйте только голос, на который у вас есть право: рассказчик, давший письменное согласие, а не фрагмент из видео или социальной ленты.
Сначала попробуйте в Playground
Откройте страницу Chatterbox text to speech и используйте вкладку Playground. Отрывок примерно в 240 символов показывает темп и интонацию при небольших расходах:
I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.
- Вставьте отрывок в Text.
- В разделе Voice reference выберите подготовленный фрагмент через Choose a file (MP3 или WAV, до 90 MB). Чтобы использовать файл, который уже доступен по ссылке, вставьте её в Asset URL и нажмите Add URL; это должна быть прямая ссылка на аудиофайл, потому что страница облачного диска или социальной сети возвращает веб-страницу, и задача падает с
invalid_asset. Пропустите этот шаг, чтобы услышать встроенный голос. - Оставьте Expressiveness (
exaggeration), Temperature и Prompt adherence (guidance_scale) на значениях по умолчанию: 0.5, 0.7 и 0.5. - Запустите. Цена $0.036 показана рядом с формой.
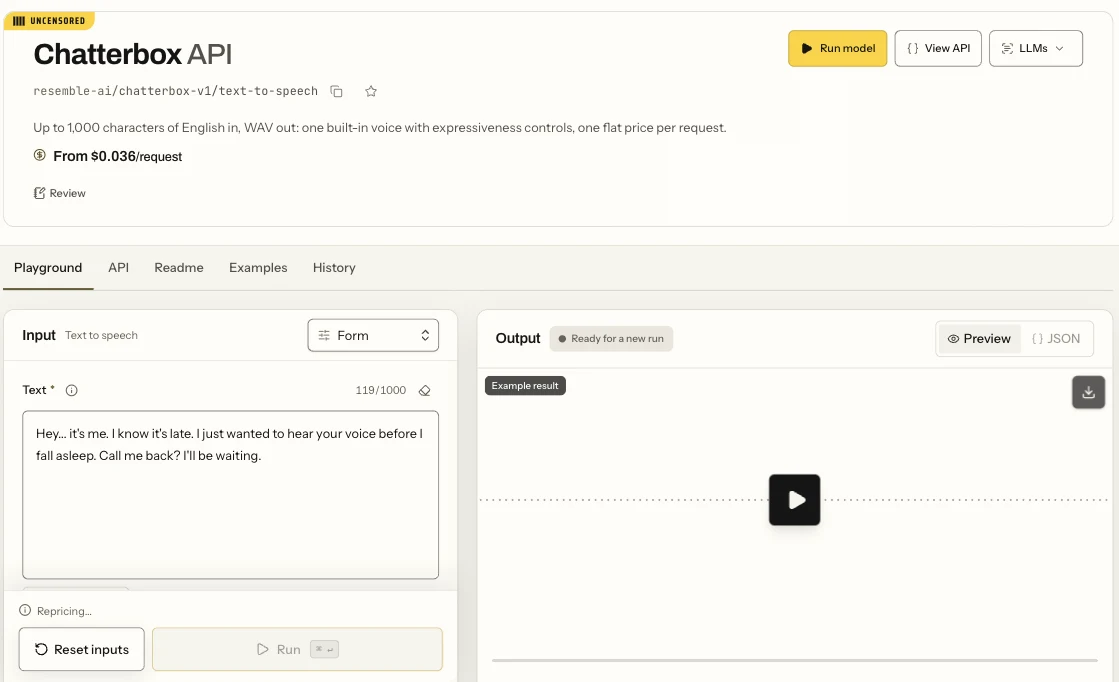
Playground синтеза речи Chatterbox в режиме Form: поле ввода текста и кнопка Run.
Прослушайте результат целиком, имея сценарий под рукой: все слова на месте, первое и последнее предложение целы, один и тот же голос от начала до конца, в конце нет ни тишины, ни шума. Держите один файл референса на весь проект; повторная нарезка между частями меняет голос.
Затем вызовите из кода
Когда результат звучит правильно, отправьте тот же запрос из собственного приложения. Задайте SPICY_API_KEY как серверный ключ и направьте reference_audio_url на прямую HTTPS-ссылку на фрагмент или на адрес spicy://, который печатает spicyapi files upload ./reference.wav (загруженный файл остаётся пригодным примерно на день):
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "resemble-ai/chatterbox-v1/text-to-speech",
    "input": {
      "text": "I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.",
      "reference_audio_url": "https://example.com/reference.wav",
      "exaggeration": 0.5,
      "guidance_scale": 0.5,
      "temperature": 0.7
    }
  }'
Результаты, загрузки и ошибки описаны в документации по задачам; загрузка файлов — в руководстве по медиа.
Или поручите прогоны агенту
Агент может выполнить тот же вызов через CLI, MCP-сервер или Agent Skill. CLI и MCP показывают цену и просят подтвердить создание задачи. При заданной SPICY_API_KEY и файле input.json, содержащем только объект input из запроса выше:
# CLI
spicyapi files upload ./reference.wav    # prints a spicy:// URI for reference_audio_url
spicyapi tasks create --model resemble-ai/chatterbox-v1/text-to-speech --input-file input.json --wait

# MCP server: the command your assistant's MCP config runs
# (it exposes spicyapi_upload_file and spicyapi_task_create)
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
Меняйте тот параметр, который соответствует услышанному
Меняйте по одному параметру за прогон и оставляйте текст и референс неизменными, чтобы понимать, что вызвало разницу. Три прогона (базовый, одно изменение выражения, одно изменение темпа) стоят $0.108.
| Что вы слышите | Попробуйте сначала | Почему |
|---|---|---|
| Плоско, без акцентов | exaggeration (Expressiveness) 0.7 | Более высокие значения добавляют выразительность; темп в нашем тесте почти не изменился (13.0 s против 13.4 s для тех же 240 символов), поэтому оценивайте на слух |
| Торопливо | guidance_scale (Prompt adherence) 0.3 | Снижение замедляет чтение: те же 240 символов заняли 15.0 s при 0.3 против 13.4 s при 0.5 |
| Торопливо при любых положениях ползунков | Более спокойный референс | Референс переносит свой темп |
| Слово произнесено неверно | Измените text: распишите сокращение буквами, запишите числа нужными словами, разбейте длинное предложение | У задачи нет словаря произношения |
| Звук читается как слово | Уберите тег; напишите «Mmm…» или «ha…» | Теги в этой задаче читаются вслух |
| Не похоже на рассказчика | Исправьте референс: шум, второй голос, другой акцент или другая подача | temperature меняет прогоны между собой; это не параметр идентичности |
| Прогоны различаются сильнее, чем нужно | Снизьте temperature (попробуйте 0.5) | Управляет разбросом между прогонами |
Два примера на странице модели дают примерную ориентировку: при значениях по умолчанию наши прогоны звучали примерно 16–19 символов в секунду, а пример спокойной озвучки, где и exaggeration, и guidance_scale стояли на 0.3, — около 14. Для тихого темпа сказки на ночь снижайте оба. Не копируйте значения из открытого скрипта: значение temperature по умолчанию в размещённой версии — 0.7, а в открытой — 0.8.
Разбивайте длинные сценарии на части примерно по 500 символов
Запрос принимает 1 000 символов, но звук ограничен 40 секундами. При примерно 18 символах в секунду 700 символов вернулись как 36 секунд, а 900 и 998 символов — оба ровно как 40 секунд, хотя такого текста нужно около 49 секунд, то есть конец обрезается, а вы всё равно платите полные $0.036. Держите части примерно по 500 символов (прогон в 492 символа занял 27 секунд) и проверяйте последнее предложение каждого прогона.
Фиксированная цена делает выбор простым счётом. Глава на 2 430 символов стоит:
- 3 запроса примерно по 810 символов: $0.108, но каждому нужно около 45 секунд, и он обрезается на 40.
- 5 частей примерно по 490 символов: $0.18.
- 9 частей примерно по 270 символов, около 15 секунд каждая: $0.324.
Заложите запас на перезаписи: две перезаписи в плане из пяти частей дают семь запросов, $0.252. Починка одного слова тоже стоит полных $0.036, поэтому перезаписывайте целое предложение или часть, а не латать слова по одному.
Режьте на концах абзацев или между полными предложениями и оставляйте несколько предложений вместе ради контекста; части примерно в 300–500 символов звучат естественно. Используйте один и тот же файл референса, одни и те же три числа и одни и те же правила текста для каждой части и считайте символы вместе с пробелами и знаками препинания, а не слова.
Части пришли с похожей громкостью; слишком громкую убавьте перед склейкой. Эта команда склеивает прогоны с короткой паузой между ними (подгоните 0.35 секунды к тому, как рассказчик делает паузу между абзацами):
ffmpeg -y -f lavfi -i anullsrc=r=24000:cl=mono -t 0.35 -c:a pcm_s16le gap.wav
printf "file 'part-01.wav'\nfile 'gap.wav'\nfile 'part-02.wav'\nfile 'gap.wav'\nfile 'part-03.wav'\n" > list.txt
ffmpeg -y -f concat -safe 0 -i list.txt -c copy narration.wav
Если одна часть получилась неверной, перегенерируйте только её с тем же референсом и теми же настройками; если она не удалась дважды, измените текст перед третьим прогоном.
Когда Chatterbox — не тот инструмент
- Другой язык или два голоса. Размещённая задача работает только на английском и читает один голос за запрос. Для двух голосов сделайте по запросу на голос и склейте файлы, как показано выше, или возьмите одну из трёх моделей синтеза речи Gemini, поле диалога в которых смешивает до двух предустановленных голосов в одном запросе (сравнение перечисляет их). Диалог использует предустановленные голоса, а не ваш референс. Для других языков сравнение охватывает языки и цены.
- Лицо, которое произносит реплику. В WAV нет данных о времени. Передайте его модели синхронизации губ или говорящему аватару, например Talking Avatar или Lip Sync.
- Субтитры. Пропустите готовый звук через шаг распознавания речи; не выводите тайминги из длины сценария.
Для взрослой прозы SpicyAPI не добавляет контент-фильтров, и взрослые сценарии читались целиком встроенным голосом. Не читайте взрослые сценарии голосом реального человека без его согласия.
Частые вопросы
Поддерживает ли Chatterbox клонирование голоса? Размещённая задача имитирует тембр необязательного референса MP3 или WAV, но не обучает голос.
Законно ли клонировать голос? Это зависит от согласия, от того, где находитесь вы и где находится рассказчик, и от того, для чего используется звук. Использование чужого голоса без разрешения или представление синтетической речи как высказывания реального человека может создать юридические проблемы. Храните разрешение в документах и, где это требуется, укажите, что звук синтетический.
Можно ли сохранить голос и обращаться к нему по имени? Нет. В схеме нет voice ID, поэтому вы отправляете файл референса каждый раз.
С чего начать
Загрузите в Playground чистый референс длиной 10–15 секунд и выполните один прогон в 240 символов на значениях по умолчанию за $0.036. Если результат подходит, разбейте сценарий на части примерно по 500 символов и перезаписывайте только неудачные части; если нет — сначала исправьте референс или тот единственный параметр из таблицы выше.





