Vous avez l'enregistrement d'une personne narratrice et un script qui dépasse un paragraphe. Chatterbox v1 sur SpicyAPI peut lire ce script avec le timbre de l'enregistrement, bloc par bloc. Utiliser le même fichier de référence et les mêmes trois réglages pour chaque bloc aide à garder une voix cohérente sur tout un chapitre.
Pour un premier essai, coupez un extrait propre de 10 à 15 secondes d'une seule personne, dans le style souhaité, et utilisez les valeurs par défaut exaggeration: 0.5, guidance_scale: 0.5 et temperature: 0.7. D'après nos tests d'octobre 2026, la sortie s'arrête à 40 secondes, donc découpez les longs scripts en blocs d'environ 500 caractères (environ 27 secondes). Chaque requête coûte un tarif fixe de $0.036 quelle que soit sa longueur, donc une narration de dix minutes représente environ 17 à 24 blocs, $0.61 à $0.86 avant les reprises. La tâche est asynchrone, uniquement en anglais, et renvoie un fichier WAV.
Si vous avez besoin d'une seule voix stable, pas d'un enregistrement particulier, les modèles à voix prédéfinies vous le permettent grâce à un voice_id fixe (la comparaison « Uncensored Text-to-Speech APIs Compared » les liste avec leurs prix).
Ce que la tâche hébergée accepte
Le schéma Chatterbox v1 text to speech comporte cinq champs :
| Champ | Valeurs valides | Premier choix pratique |
|---|---|---|
text | 1–1 000 caractères anglais | Un court passage qui se termine sur une phrase complète |
reference_audio_url | MP3 ou WAV facultatif ; limite 90 Mo | Un extrait propre d'une seule personne que vous avez le droit d'utiliser |
exaggeration | 0–1 | 0.5 |
guidance_scale | 0.1–1 | 0.5 |
temperature | 0.05–2 | 0.7 |
La référence est facultative. Omettez-la pour écouter la voix intégrée, un moyen rapide d'évaluer un script avant de vous préoccuper d'un clone. Avec une référence, la lecture prend le timbre de cet extrait ; rien n'est entraîné et aucune voix n'est conservée, vous renvoyez donc la référence à chaque requête. Le prix ne change pas.
La sortie est un unique WAV mono 24 kHz, 16 bits, sans horodatage des mots ni sous-titres. La tâche n'a ni multiplicateur de vitesse, ni seed, ni sélecteur de langue, ni liste de voix. Attendez-vous à entendre les balises entre crochets comme [sigh] ou <laugh> lues comme des mots. Écrivez un son en toutes lettres (« Mmm… », « ha… ») et laissez les indications de jeu hors de text.
Préparer une référence qui convient à la narration
La référence détermine la voix que vous entendez, et aussi la façon dont elle pose le rythme et joue le texte. Préparez-la pour la narration que vous voulez, pas pour l'échantillon le plus spectaculaire que vous possédez.
- Longueur et format. Les mainteneurs recommandent au moins 10 secondes, idéalement un WAV à 24 kHz ou plus, une seule personne, aucun bruit de fond et une diction qui correspond à ce que vous voulez obtenir : pour un rendu façon livre audio, utilisez un extrait façon livre audio.
- Commencez par une parole propre. Le début de l'extrait compte le plus, mais une section bruyante ou hors style plus loin dans un long fichier compte aussi. Coupez 10 à 15 secondes propres qui commencent sur une parole.
- Accordez le rythme. La référence entraîne sa vitesse dans le résultat, choisissez donc l'extrait à la vitesse que la narration doit avoir.
- Utilisez un extrait en anglais. Une référence dans une autre langue peut imposer son accent.
- Retirez ce que vous ne voulez pas voir copié. La musique, une seconde voix, l'écho de la pièce, les crêtes écrêtées et les longs silences rendent l'exemple moins clair. Une réduction de bruit agressive qui mord dans la voix peut être pire qu'un léger bruit de fond constant : gardez l'original intact et comparez.
- Testez d'abord les voix inhabituelles sur une phrase. Certains accents dérivent : un accent australien peut ressortir américain. Dépensez $0.036 sur une seule phrase avant un chapitre entier.
Cette commande découpe dans un enregistrement brut une section de 12 secondes à partir de la seconde 3.2 et l'enregistre en WAV mono 24 kHz, 16 bits (il faut ffmpeg). 24 kHz est la fréquence de travail du modèle et le minimum des mainteneurs ; convertir vers elle un enregistrement en 44.1 ou 48 kHz ne pose pas de problème, mais descendre plus bas n'apporte rien :
ffmpeg -i narrator-raw.wav -ss 3.2 -t 12 -ac 1 -ar 24000 -c:a pcm_s16le reference.wavN'utilisez qu'une voix que vous avez le droit d'utiliser : une personne narratrice qui a accepté par écrit, pas un extrait de vidéo ou de réseau social.
Essayez d'abord dans le Playground
Ouvrez la page Chatterbox text to speech et utilisez l'onglet Playground. Un passage d'environ 240 caractères montre le rythme et la diction sans grands frais :
I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.
- Collez le passage dans Text.
- Sous Voice reference, choisissez votre extrait préparé avec Choose a file (MP3 ou WAV, jusqu'à 90 Mo). Pour utiliser un fichier déjà en ligne, collez son lien sous Asset URL et sélectionnez Add URL ; il doit s'agir d'un lien direct vers le fichier audio, car une page de disque cloud ou de partage social renvoie une page web et la tâche échoue avec
invalid_asset. Passez cette étape pour écouter la voix intégrée. - Laissez Expressiveness (
exaggeration), Temperature et Prompt adherence (guidance_scale) à leurs valeurs par défaut : 0.5, 0.7 et 0.5. - Lancez. Le prix, $0.036, s'affiche à côté du formulaire.
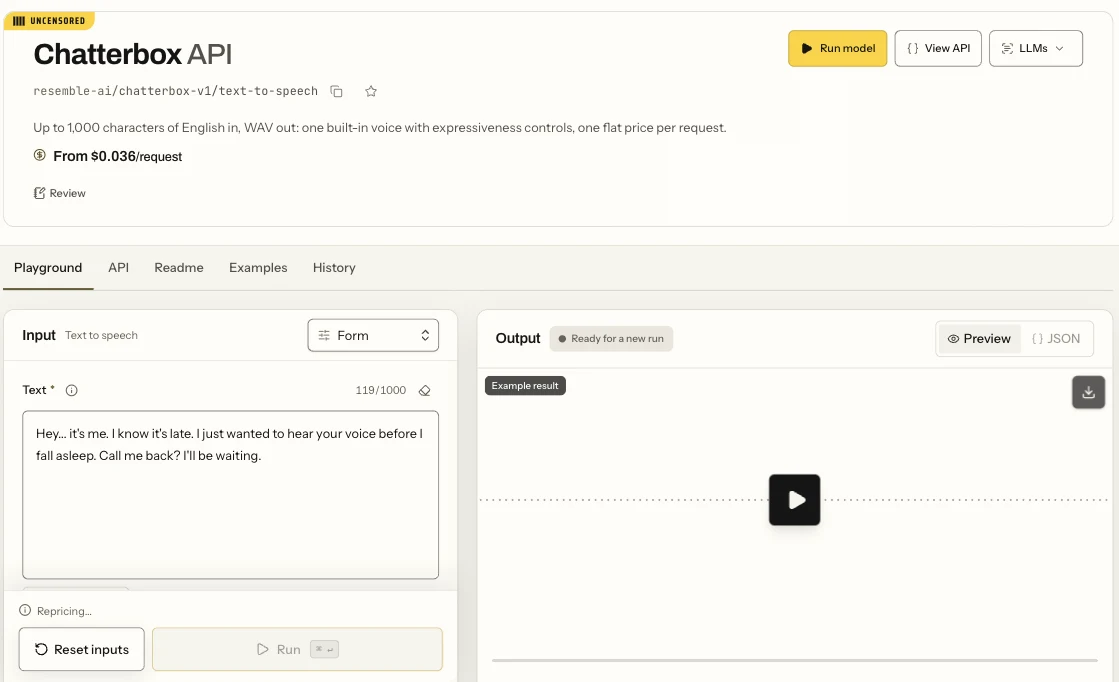
Le Playground de synthèse vocale Chatterbox en vue Formulaire : le champ de saisie et le bouton Run.
Écoutez la prise entière en gardant le script sous les yeux : tous les mots présents, la première et la dernière phrase intactes, la même personne du début à la fin, aucun blanc ni bruit à la fin. Tenez un seul fichier de référence pour tout le projet ; le recouper entre les blocs change la voix.
Puis appelez-la depuis le code
Quand une prise sonne juste, envoyez la même requête depuis votre propre application. Définissez SPICY_API_KEY sur votre clé côté serveur et faites pointer reference_audio_url vers un lien HTTPS direct vers l'extrait, ou vers une adresse spicy:// affichée par spicyapi files upload ./reference.wav (un téléversement reste utilisable environ une journée) :
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "resemble-ai/chatterbox-v1/text-to-speech",
    "input": {
      "text": "I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.",
      "reference_audio_url": "https://example.com/reference.wav",
      "exaggeration": 0.5,
      "guidance_scale": 0.5,
      "temperature": 0.7
    }
  }'
Les résultats, les téléchargements et les erreurs figurent dans la documentation des tâches ; les téléversements sont dans le guide Media.
Ou laissez un Agent faire les prises
Un agent peut effectuer le même appel via le CLI, le serveur MCP ou l'Agent Skill. Le CLI et MCP affichent le prix et vous demandent de confirmer avant de créer une tâche. Avec SPICY_API_KEY défini et input.json contenant uniquement l'objet input de la requête ci-dessus :
# CLI
spicyapi files upload ./reference.wav    # prints a spicy:// URI for reference_audio_url
spicyapi tasks create --model resemble-ai/chatterbox-v1/text-to-speech --input-file input.json --wait

# MCP server: the command your assistant's MCP config runs
# (it exposes spicyapi_upload_file and spicyapi_task_create)
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
Changez le réglage qui correspond à ce que vous entendez
Changez un seul réglage par prise et gardez le texte et la référence fixes, afin de savoir ce qui a causé la différence. Trois prises (une référence, un changement d'expression, un changement de rythme) coûtent $0.108.
| Ce que vous entendez | Essayez d'abord | Pourquoi |
|---|---|---|
| Plat, sans accent | exaggeration (Expressiveness) 0.7 | Les valeurs plus élevées ajoutent de l'emphase ; le rythme a à peine changé dans notre test (13.0 s contre 13.4 s pour les mêmes 240 caractères), alors jugez à l'oreille |
| Pressé | guidance_scale (Prompt adherence) 0.3 | Le diminuer ralentit la lecture : les mêmes 240 caractères ont duré 15.0 s à 0.3 contre 13.4 s à 0.5 |
| Pressé quel que soit le curseur | Une référence plus calme | La référence entraîne son propre rythme |
| Un mot est mal dit | Modifiez text : écrivez une abréviation en toutes lettres, écrivez les chiffres comme les mots que vous voulez, divisez une longue phrase | La tâche n'a pas de dictionnaire de prononciation |
| Un son est lu comme un mot | Retirez la balise ; écrivez « Mmm… » ou « ha… » | Les balises sont lues à voix haute sur cette tâche |
| Ne ressemble pas à la personne narratrice | Corrigez la référence : bruit, seconde voix, autre accent ou autre jeu | temperature fait varier les prises ; ce n'est pas un contrôle d'identité |
| Les prises diffèrent plus que vous ne voulez | Baissez temperature (essayez 0.5) | Il contrôle la variation entre les prises |
Les deux exemples de la page du modèle donnent un ordre de grandeur : avec les valeurs par défaut, nos prises tournaient à environ 16 à 19 caractères par seconde, et l'exemple de narration calme, avec exaggeration et guidance_scale à 0.3 tous les deux, à environ 14. Pour un rythme tranquille d'histoire du soir, baissez les deux. Ne copiez pas les valeurs du script open source : la valeur par défaut de temperature en hébergé est 0.7, alors que celle de l'open source est 0.8.
Découpez les longs scripts en blocs d'environ 500 caractères
Une requête accepte 1 000 caractères, mais l'audio est plafonné à 40 secondes. À environ 18 caractères par seconde, 700 caractères sont revenus en 36 secondes, et 900 comme 998 caractères sont revenus en exactement 40 secondes, alors que ce texte demande environ 49 secondes : la fin est coupée et vous payez quand même les $0.036 pleins. Gardez les blocs autour de 500 caractères (une prise de 492 caractères a duré 27 secondes) et vérifiez la dernière phrase de chaque prise.
Le prix fixe rend le compromis facile à calculer. Un chapitre de 2 430 caractères coûte :
- 3 requêtes d'environ 810 caractères : $0.108, mais chacune demande environ 45 secondes et est coupée à 40.
- 5 blocs d'environ 490 caractères : $0.18.
- 9 blocs d'environ 270 caractères, environ 15 secondes chacun : $0.324.
Ajoutez une marge pour les reprises : deux reprises sur le plan à cinq blocs font sept requêtes, $0.252. Réparer un seul mot coûte aussi les $0.036 pleins, donc reprenez une phrase ou un bloc entier plutôt que de rustiner mot par mot.
Coupez en fin de paragraphe ou entre des phrases complètes et laissez plusieurs phrases ensemble pour le contexte ; des blocs d'environ 300 à 500 caractères sonnent naturels. Utilisez le même fichier de référence, les mêmes trois nombres et les mêmes conventions de texte pour chaque bloc, et comptez les caractères espaces et ponctuation compris, pas les mots.
Les blocs sont arrivés à des niveaux sonores similaires ; baissez le plus fort avant de les assembler. Cette commande assemble les prises avec un court silence entre elles (adaptez les 0.35 secondes aux pauses de la personne narratrice entre les paragraphes) :
ffmpeg -y -f lavfi -i anullsrc=r=24000:cl=mono -t 0.35 -c:a pcm_s16le gap.wav
printf "file 'part-01.wav'\nfile 'gap.wav'\nfile 'part-02.wav'\nfile 'gap.wav'\nfile 'part-03.wav'\n" > list.txt
ffmpeg -y -f concat -safe 0 -i list.txt -c copy narration.wav
Si un bloc est mauvais, régénérez uniquement ce bloc avec la même référence et les mêmes réglages ; s'il échoue deux fois, changez le texte avant un troisième essai.
Quand Chatterbox n'est pas le bon outil
- Une autre langue, ou deux locuteurs. La tâche hébergée est uniquement en anglais et lit une voix par requête. Pour deux locuteurs, faites une requête par locuteur et assemblez les fichiers comme ci-dessus, ou utilisez l'un des trois modèles de synthèse vocale de Gemini, dont le champ de dialogue mélange jusqu'à deux voix prédéfinies dans une même requête (la comparaison les liste). Un dialogue utilise des voix prédéfinies, pas votre extrait de référence. Pour les autres langues, la comparaison couvre les langues et les prix.
- Un visage qui dit la réplique. Le WAV ne contient pas de données de minutage. Passez-le à un modèle de synchronisation labiale ou d'avatar parlant comme Talking Avatar ou Lip Sync.
- Sous-titres. Passez l'audio final par une étape de reconnaissance vocale ; ne déduisez pas les minutages de la longueur du script.
Pour de la fiction adulte, SpicyAPI n'ajoute aucun filtre de contenu et les scripts adultes ont été lus intégralement avec la voix intégrée. Ne lisez pas de scripts adultes avec la voix d'une vraie personne sans son consentement.
Questions fréquentes
Chatterbox prend-il en charge le clonage vocal ? La tâche hébergée imite le timbre d'une référence MP3 ou WAV facultative, mais n'entraîne aucune voix.
Est-il illégal de cloner une voix ? Cela dépend du consentement, de l'endroit où vous êtes et où se trouve le locuteur, et de l'usage de l'audio. Utiliser la voix de quelqu'un sans autorisation, ou présenter une parole synthétique comme une déclaration d'une vraie personne, peut créer des problèmes juridiques. Conservez l'autorisation et, là où c'est requis, indiquez que l'audio est synthétique.
Puis-je enregistrer la voix et l'appeler par son nom ? Non. Le schéma n'a pas d'identifiant de voix, vous renvoyez donc le fichier de référence à chaque fois.
Par où commencer
Importez dans le Playground une référence propre de 10 à 15 secondes et lancez une prise de 240 caractères aux valeurs par défaut pour $0.036. Si le rendu vous plaît, découpez le script en blocs d'environ 500 caractères et ne reprenez que ceux qui échouent ; sinon, corrigez d'abord la référence ou le seul réglage du tableau ci-dessus.





