Sie haben die Aufnahme einer Erzählerin oder eines Erzählers und ein Skript, das über einen Absatz hinausgeht. Chatterbox v1 auf SpicyAPI kann dieses Skript im Timbre der Aufnahme vorlesen, Abschnitt für Abschnitt. Dieselbe Referenzdatei und dieselben drei Einstellungen für jeden Abschnitt zu verwenden, hilft dabei, die Erzählstimme über ein Kapitel hinweg konsistent zu halten.
Für einen ersten Durchlauf schneiden Sie einen sauberen Clip von 10 bis 15 Sekunden mit einer einzigen Stimme im gewünschten Stil und verwenden Sie die Standardwerte exaggeration: 0.5, guidance_scale: 0.5 und temperature: 0.7. Auf Grundlage unserer Tests vom Oktober 2026 endet die Ausgabe nach 40 Sekunden, teilen Sie lange Skripte also in Abschnitte von etwa 500 Zeichen (etwa 27 Sekunden). Jede Anfrage kostet pauschal $0.036, egal wie lang sie ist, eine zehnminütige Erzählung sind also etwa 17 bis 24 Abschnitte und $0.61 bis $0.86 vor Neuaufnahmen. Der Task ist asynchron, nur auf Englisch und gibt eine WAV-Datei zurück.
Wenn Sie nur eine stabile Stimme brauchen und nicht die Aufnahme einer bestimmten Person, bieten Ihnen die Modelle mit Preset-Stimmen das über eine feste voice_id (der Vergleich „Uncensored Text-to-Speech APIs Compared“ listet sie mit ihren Preisen auf).
Was der gehostete Task akzeptiert
Das Schema von Chatterbox v1 text to speech hat fünf Felder:
| Feld | Gültige Werte | Praktische erste Wahl |
|---|---|---|
text | 1–1.000 englische Zeichen | Eine kurze Passage, die mit einem vollständigen Satz endet |
reference_audio_url | Optionales MP3 oder WAV; Limit 90 MB | Ein sauberer Clip einer einzigen Stimme, die Sie verwenden dürfen |
exaggeration | 0–1 | 0.5 |
guidance_scale | 0.1–1 | 0.5 |
temperature | 0.05–2 | 0.7 |
Die Referenz ist optional. Lassen Sie sie weg, um die eingebaute Stimme zu hören, ein schneller Weg, ein Skript zu beurteilen, bevor Sie sich um einen Klon kümmern. Mit einer Referenz nimmt die Wiedergabe das Timbre dieses Clips an; nichts wird trainiert und keine Stimme gespeichert, Sie senden die Referenz also bei jeder Anfrage erneut. Der Preis ändert sich nicht.
Die Ausgabe ist eine einzelne WAV-Datei in 24 kHz, 16 Bit, Mono, ohne Wortzeitstempel oder Untertitel. Der Task hat keinen Geschwindigkeitsfaktor, keinen Seed, keine Sprachauswahl und keine Stimmenliste. Tags in eckigen Klammern wie [sigh] oder <laugh> werden als Wörter vorgelesen. Schreiben Sie einen Laut aus („Mmm…“, „ha…“) und halten Sie Regieanweisungen aus text heraus.
Bereiten Sie eine Referenz vor, die zur Erzählung passt
Die Referenz bestimmt, wessen Stimme Sie hören, und auch, wie sie Tempo und Vortrag hält. Bereiten Sie sie für die Erzählung vor, die Sie wollen, nicht für die dramatischste Probe, die Sie besitzen.
- Länge und Format. Die Maintainer empfehlen mindestens 10 Sekunden, idealerweise WAV mit 24 kHz oder höher, eine einzelne Stimme, kein Hintergrundrauschen und einen Vortrag, der zu dem passt, was Sie zurückhaben wollen: Für eine Ausgabe im Hörbuchstil verwenden Sie einen Clip im Hörbuchstil.
- Beginnen Sie mit sauberer Sprache. Der Anfang des Clips zählt am meisten, aber ein verrauschter oder stilfremder Abschnitt weiter hinten in einer langen Datei zählt trotzdem. Schneiden Sie saubere 10 bis 15 Sekunden, die mit Sprache beginnen.
- Passen Sie das Tempo an. Die Referenz trägt ihr Tempo in das Ergebnis hinein, wählen Sie den Clip also in dem Tempo, das die Erzählung haben soll.
- Verwenden Sie einen englischen Clip. Eine Referenz in einer anderen Sprache kann deren Akzent einbringen.
- Entfernen Sie, was nicht kopiert werden soll. Musik, eine zweite Stimme, Raumhall, übersteuerte Spitzen und lange Pausen machen das Beispiel unklarer. Aggressive Rauschentfernung, die in die Stimme hineinfrisst, kann schlimmer sein als etwas gleichmäßiges Hintergrundrauschen, behalten Sie also das unbearbeitete Original und vergleichen Sie.
- Testen Sie ungewöhnliche Stimmen zuerst an einem Satz. Manche Akzente driften ab: Ein australischer Akzent kann amerikanisch herauskommen. Geben Sie $0.036 für einen einzigen Satz aus, bevor Sie ein ganzes Kapitel aufnehmen.
Dieser Befehl schneidet aus einer Rohaufnahme einen 12 Sekunden langen Abschnitt ab Sekunde 3,2 aus und speichert ihn als WAV in 24 kHz, 16 Bit, Mono (er benötigt ffmpeg). 24 kHz ist die Rate, mit der das Modell arbeitet, und die Untergrenze der Maintainer; eine Aufnahme mit 44,1 oder 48 kHz darauf herunterzurechnen ist in Ordnung, tiefer zu gehen bringt aber nichts:
ffmpeg -i narrator-raw.wav -ss 3.2 -t 12 -ac 1 -ar 24000 -c:a pcm_s16le reference.wavVerwenden Sie nur eine Stimme, die Sie verwenden dürfen: eine Erzählerin oder einen Erzähler, die oder der schriftlich zugestimmt hat, nicht einen Clip aus einem Video oder einem sozialen Feed.
Probieren Sie es zuerst im Playground aus
Öffnen Sie die Chatterbox text to speech Seite und nutzen Sie den Tab Playground. Eine Passage von etwa 240 Zeichen zeigt Tempo und Phrasierung mit geringen Kosten:
I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.
- Fügen Sie die Passage in Text ein.
- Wählen Sie unter Voice reference Ihren vorbereiteten Clip über Choose a file (MP3 oder WAV, bis 90 MB). Um eine bereits online verfügbare Datei zu nutzen, fügen Sie ihren Link unter Asset URL ein und wählen Sie Add URL; das muss ein direkter Link auf die Audiodatei sein, denn eine Cloud-Drive- oder Social-Sharing-Seite gibt eine Webseite zurück und der Task scheitert mit
invalid_asset. Überspringen Sie diesen Schritt, um die eingebaute Stimme zu hören. - Lassen Sie Expressiveness (
exaggeration), Temperature und Prompt adherence (guidance_scale) bei ihren Standardwerten: 0.5, 0.7 und 0.5. - Starten Sie den Lauf. Der Preis, $0.036, steht neben dem Formular.
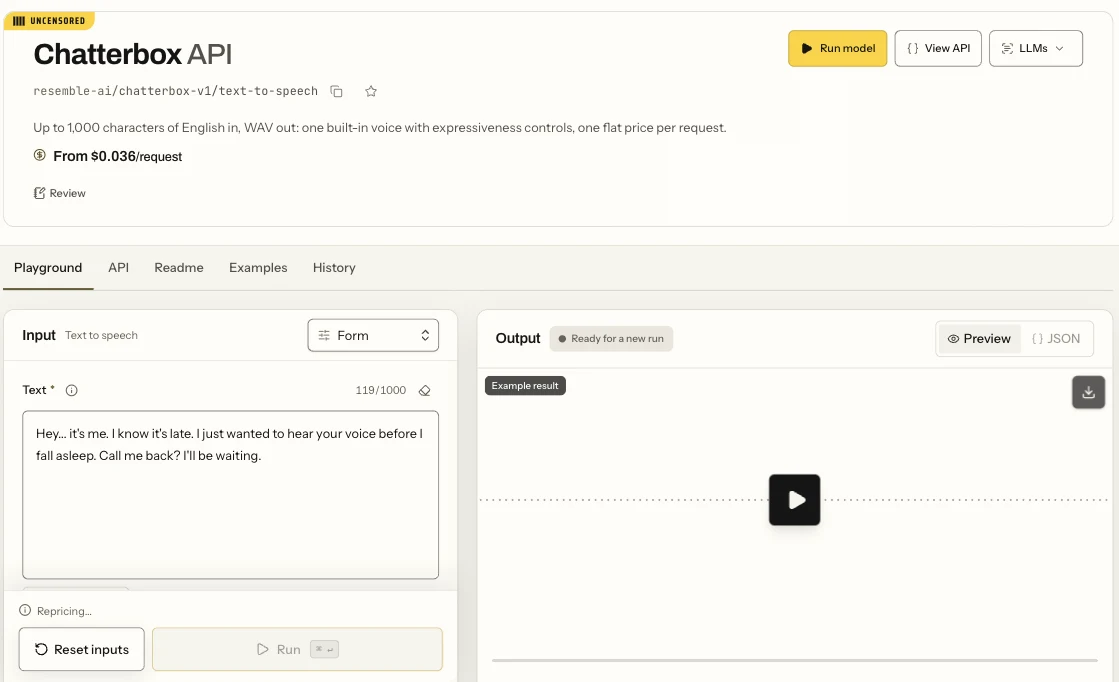
Das Chatterbox-Text-to-Speech-Playground in der Formansicht: die Texteingabe und der Run-Knopf.
Hören Sie den ganzen Take mit dem Skript in der Hand an: jedes Wort vorhanden, der erste und der letzte Satz unversehrt, dieselbe Stimme durchgehend, am Ende keine Stille und kein Rauschen. Behalten Sie für das ganze Projekt eine Referenzdatei bei; ein Neuschneiden zwischen den Abschnitten ändert die Stimme.
Rufen Sie ihn dann aus dem Code auf
Sobald ein Take richtig klingt, senden Sie dieselbe Anfrage aus Ihrer eigenen App. Setzen Sie SPICY_API_KEY auf Ihren serverseitigen Schlüssel und richten Sie reference_audio_url auf einen direkten HTTPS-Link auf den Clip oder auf eine spicy://-Adresse, die spicyapi files upload ./reference.wav ausgibt (ein Upload bleibt etwa einen Tag lang nutzbar):
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "resemble-ai/chatterbox-v1/text-to-speech",
    "input": {
      "text": "I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.",
      "reference_audio_url": "https://example.com/reference.wav",
      "exaggeration": 0.5,
      "guidance_scale": 0.5,
      "temperature": 0.7
    }
  }'
Ergebnisse, Downloads und Fehler finden Sie in der Task-Dokumentation; Uploads stehen im Media-Leitfaden.
Oder lassen Sie einen Agenten die Takes ausführen
Ein Agent kann denselben Aufruf über die CLI, den MCP-Server oder den Agent Skill machen. CLI und MCP zeigen den Preis und fragen Sie vor dem Erstellen eines Tasks um Bestätigung. Wenn SPICY_API_KEY gesetzt ist und input.json nur das input-Objekt aus der obigen Anfrage enthält:
# CLI
spicyapi files upload ./reference.wav    # prints a spicy:// URI for reference_audio_url
spicyapi tasks create --model resemble-ai/chatterbox-v1/text-to-speech --input-file input.json --wait

# MCP server: the command your assistant's MCP config runs
# (it exposes spicyapi_upload_file and spicyapi_task_create)
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
Ändern Sie die Einstellung, die zu dem passt, was Sie hören
Ändern Sie pro Take nur eine Einstellung und lassen Sie Text und Referenz gleich, damit Sie wissen, was den Unterschied verursacht hat. Drei Takes (Ausgangsbasis, eine Änderung am Ausdruck, eine Änderung am Tempo) kosten $0.108.
| Was Sie hören | Zuerst versuchen | Warum |
|---|---|---|
| Flach, ohne Betonung | exaggeration (Expressiveness) 0.7 | Höhere Werte geben mehr Betonung; das Tempo änderte sich in unserem Test kaum (13,0 s gegenüber 13,4 s für dieselben 240 Zeichen), beurteilen Sie das also nach dem Gehör |
| Gehetzt | guidance_scale (Prompt adherence) 0.3 | Ein niedrigerer Wert verlangsamt die Wiedergabe: dieselben 240 Zeichen liefen mit 0,3 in 15,0 s gegenüber 13,4 s mit 0,5 |
| Gehetzt, egal welche Regler | Eine ruhigere Referenz | Die Referenz trägt ihr Tempo mit |
| Ein Wort ist falsch | Bearbeiten Sie text: schreiben Sie eine Abkürzung aus, schreiben Sie Zahlen als die Wörter, die Sie wollen, teilen Sie einen langen Satz | Der Task hat kein Aussprachelexikon |
| Ein Laut wird als Wort gelesen | Entfernen Sie den Tag; schreiben Sie „Mmm…“ oder „ha…“ | Tags werden bei diesem Task vorgelesen |
| Klingt nicht nach der Erzählstimme | Korrigieren Sie die Referenz: Rauschen, eine zweite Stimme, ein anderer Akzent oder Vortrag | temperature variiert die Takes; es ist keine Identitätssteuerung |
| Takes unterscheiden sich stärker, als Sie wollen | Senken Sie temperature (versuchen Sie 0.5) | Es steuert die Schwankung zwischen Takes |
Die beiden Beispiele auf der Modellseite geben eine grobe Orientierung: Mit Standardwerten liefen unsere Takes mit etwa 16 bis 19 Zeichen pro Sekunde, das Beispiel mit ruhiger Erzählung, bei dem exaggeration und guidance_scale beide auf 0.3 standen, mit etwa 14. Für ein ruhiges Tempo einer Gute-Nacht-Geschichte senken Sie beide. Übernehmen Sie keine Werte aus dem Open-Source-Skript: Der Standardwert für temperature im gehosteten Task ist 0.7, im Open-Source-Modell 0.8.
Teilen Sie längere Skripte in Abschnitte von etwa 500 Zeichen
Eine Anfrage akzeptiert 1.000 Zeichen, aber die Audioausgabe ist auf 40 Sekunden begrenzt. Bei etwa 18 Zeichen pro Sekunde kamen 700 Zeichen als 36 Sekunden zurück, 900 und 998 Zeichen kamen beide als genau 40 Sekunden zurück, während diese Textmenge etwa 49 Sekunden braucht, das Ende wird also abgeschnitten und Sie zahlen trotzdem die vollen $0.036. Halten Sie die Abschnitte bei etwa 500 Zeichen (ein Take mit 492 Zeichen lief 27 Sekunden) und prüfen Sie den letzten Satz jedes Takes.
Der pauschale Preis macht die Abwägung leicht berechenbar. Ein Kapitel mit 2.430 Zeichen kostet:
- 3 Anfragen mit je etwa 810 Zeichen: $0.108, aber jede braucht etwa 45 Sekunden und wird bei 40 abgeschnitten.
- 5 Abschnitte mit je etwa 490 Zeichen: $0.18.
- 9 Abschnitte mit je etwa 270 Zeichen, je etwa 15 Sekunden: $0.324.
Rechnen Sie Neuaufnahmen hinzu: Zwei Neuaufnahmen im Plan mit fünf Abschnitten ergeben sieben Anfragen, $0.252. Auch die Reparatur eines einzelnen Wortes kostet volle $0.036, nehmen Sie also einen ganzen Satz oder Abschnitt neu auf, statt Wort für Wort zu flicken.
Schneiden Sie an Absatzenden oder zwischen vollständigen Sätzen und lassen Sie mehrere Sätze für den Zusammenhang zusammen; Abschnitte von etwa 300 bis 500 Zeichen klingen natürlich. Verwenden Sie für jeden Abschnitt dieselbe Referenzdatei, dieselben drei Zahlen und dieselben Textkonventionen und zählen Sie Zeichen inklusive Leerzeichen und Satzzeichen, nicht Wörter.
Die Abschnitte kamen mit ähnlicher Lautstärke an; senken Sie einen lauteren, bevor Sie sie verbinden. Dieser Befehl verbindet die Takes mit einer kurzen Pause dazwischen (passen Sie die 0.35 Sekunden an, wie die sprechende Person zwischen Absätzen pausiert):
ffmpeg -y -f lavfi -i anullsrc=r=24000:cl=mono -t 0.35 -c:a pcm_s16le gap.wav
printf "file 'part-01.wav'\nfile 'gap.wav'\nfile 'part-02.wav'\nfile 'gap.wav'\nfile 'part-03.wav'\n" > list.txt
ffmpeg -y -f concat -safe 0 -i list.txt -c copy narration.wav
Wenn ein Abschnitt falsch ist, erzeugen Sie nur diesen Abschnitt mit derselben Referenz und denselben Einstellungen neu; schlägt er zweimal fehl, ändern Sie den Text vor einem dritten Take.
Wann Chatterbox das falsche Werkzeug ist
- Eine andere Sprache oder zwei Sprecher. Der gehostete Task ist nur auf Englisch und liest pro Anfrage eine Stimme. Für zwei Sprecher machen Sie entweder eine Anfrage pro Sprecher und verbinden die Dateien wie oben gezeigt, oder Sie nutzen eines der drei Gemini-Text-to-Speech-Modelle, deren Dialogfeld in einer Anfrage bis zu zwei Preset-Stimmen mischt (der Vergleich listet sie auf). Ein Dialog nimmt Preset-Stimmen, nicht Ihren Referenzclip. Für andere Sprachen deckt der Vergleich Sprachen und Preise ab.
- Ein Gesicht, das die Zeile spricht. Die WAV hat keine Zeitdaten. Füttern Sie sie in ein Modell für Lippensynchronisation oder Talking Avatar, etwa Talking Avatar oder Lip Sync.
- Untertitel. Lassen Sie das fertige Audio durch einen Speech-to-Text-Schritt laufen; leiten Sie Zeitangaben nicht aus der Skriptlänge ab.
Für Erwachsenenfiction fügt SpicyAPI keinen Inhaltsfilter hinzu, und Erwachsenen-Skripte wurden in der eingebauten Stimme vollständig vorgelesen. Lesen Sie keine Erwachsenen-Skripte in der Stimme einer echten Person ohne deren Einwilligung.
Häufige Fragen
Unterstützt Chatterbox Stimmenklonen? Der gehostete Task imitiert das Timbre einer optionalen MP3- oder WAV-Referenz, trainiert aber keine Stimme.
Ist es illegal, eine Stimme zu klonen? Das hängt von der Einwilligung ab, davon, wo Sie und der Sprecher sich befinden, und davon, wofür das Audio verwendet wird. Die Stimme einer anderen Person ohne Erlaubnis zu verwenden oder synthetische Sprache als Aussage einer echten Person auszugeben kann rechtliche Probleme schaffen. Bewahren Sie die Erlaubnis auf und geben Sie, wo erforderlich, an, dass das Audio synthetisch ist.
Kann ich die Stimme speichern und sie beim Namen rufen? Nein. Das Schema hat keine Voice-ID, Sie senden die Referenzdatei also jedes Mal erneut.
Wo Sie anfangen sollten
Laden Sie im Playground eine saubere Referenz von 10 bis 15 Sekunden hoch und starten Sie einen Take mit 240 Zeichen bei den Standardwerten für $0.036. Wenn es richtig klingt, teilen Sie das Skript in Abschnitte von etwa 500 Zeichen und nehmen Sie nur die Abschnitte neu auf, die misslingen; wenn nicht, korrigieren Sie zuerst die Referenz oder die eine Einstellung in der Tabelle oben.





