내레이터의 녹음과, 한 단락을 넘어서는 대본이 있습니다. SpicyAPI의 Chatterbox v1은 그 녹음의 음색으로 대본을 파트별로 읽어줄 수 있습니다. 모든 파트에 같은 레퍼런스 파일과 같은 세 가지 설정을 쓰면 한 챕터 전체에서 목소리의 느낌이 일정하게 유지됩니다.
첫 시도에서는 원하는 스타일로 한 사람만 말하는 깨끗한 10~15초 클립을 잘라내고 기본값인 exaggeration: 0.5, guidance_scale: 0.5, temperature: 0.7을 사용하세요. 2026년 10월 테스트에서 출력은 40초에서 끊기므로, 긴 대본은 약 500자(약 27초)씩의 파트로 나누세요. 요청 길이에 상관없이 한 번의 요청은 정액 $0.036이고, 10분짜리 내레이션은 약 17~24개 파트, 재녹음 전 $0.61~$0.86입니다. 이 작업은 비동기이며 영어만 지원하고 WAV 파일을 하나 반환합니다.
특정 녹음의 목소리가 아니라 안정적인 음성 하나만 필요하다면, 프리셋 음성을 가진 텍스트 음성 변환 모델이 고정된 voice_id로 그걸 제공합니다(비교 글 「Uncensored Text-to-Speech APIs Compared」에 가격과 함께 정리되어 있습니다).
호스팅 작업이 받아들이는 것
Chatterbox v1 text to speech 스키마에는 다섯 개의 필드가 있습니다.
| 필드 | 유효한 값 | 실용적인 첫 선택 |
|---|---|---|
text | 영어 1~1,000자 | 완전한 문장으로 끝나는 짧은 지문 |
reference_audio_url | 선택적 MP3 또는 WAV, 90 MB 제한 | 사용할 권리가 있는 한 사람의 깨끗한 클립 |
exaggeration | 0–1 | 0.5 |
guidance_scale | 0.1–1 | 0.5 |
temperature | 0.05–2 | 0.7 |
레퍼런스는 선택 사항입니다. 생략하면 내장 음성으로 들을 수 있어, 음성 복제를 고민하기 전에 대본을 빠르게 판단하는 방법이 됩니다. 레퍼런스를 넣으면 읽기에는 그 클립의 음색이 실립니다. 학습은 없고 음성도 저장되지 않으므로, 요청마다 레퍼런스를 다시 보내야 합니다. 가격은 변하지 않습니다.
출력은 24 kHz, 16비트 모노 WAV 한 개이며 단어별 타임스탬프나 자막은 없습니다. 이 작업에는 속도 배수, seed, 언어 선택기, 음성 목록이 없습니다. [sigh]나 <laugh> 같은 대괄호 태그는 단어로 그대로 읽힙니다. 소리는 글자로 적고(「Mmm…」「ha…」), 무대 지시문은 text에 넣지 마세요.
내레이션에 맞는 레퍼런스 준비하기
레퍼런스는 어떤 사람의 목소리를 들을지, 그리고 그 목소리가 어떻게 템포와 연기를 끌어가는지까지 정합니다. 가장 극적인 샘플이 아니라 원하는 내레이션에 맞춰 준비하세요.
- 길이와 형식. 개발진은 최소 10초, 가능하면 24 kHz 이상의 WAV, 한 사람의 목소리, 배경 소음 없음, 그리고 원하는 결과와 맞는 전달을 권합니다. 오디오북식 결과가 필요하다면 오디오북식 클립을 쓰세요.
- 깨끗한 음성으로 시작하세요. 클립의 앞부분이 가장 중요하지만, 긴 파일 뒤쪽의 시끄럽거나 스타일이 다른 구간도 여전히 영향을 줍니다. 음성으로 시작하는 깨끗한 10~15초를 잘라내세요.
- 템포를 맞추세요. 레퍼런스는 자신의 속도를 결과로 끌어오므로, 내레이션이 가져야 할 속도의 클립을 고르세요.
- 영어 클립을 쓰세요. 다른 언어의 레퍼런스는 그 언어의 억양을 끌어올 수 있습니다.
- 복사하고 싶지 않은 것은 빼세요. 음악, 두 번째 목소리, 방의 반향, 잘린 피크, 긴 침묵은 모두 예제를 흐리게 만듭니다. 목소리를 파고드는 강한 노이즈 제거는 조금씩 남은 일정한 배경 소음보다 나쁠 수 있으니, 손대지 않은 원본을 보관하고 비교하세요.
- 낯선 목소리는 먼저 한 문장으로 테스트하세요. 억양이 바뀌기도 합니다. 호주 억양이 미국식으로 나올 수 있습니다. 챕터 전체를 시작하기 전에 문장 하나에 $0.036을 쓰세요.
이 명령은 원본 녹음에서 3.2초 지점부터 12초 구간을 잘라 24 kHz 모노 16비트 WAV로 저장합니다(ffmpeg 필요). 모델이 작업하는 샘플레이트이자 개발진이 정한 하한은 24 kHz입니다. 44.1이나 48 kHz 녹음을 이 값으로 낮추는 것은 괜찮지만, 더 낮게 내려도 이득은 없습니다:
ffmpeg -i narrator-raw.wav -ss 3.2 -t 12 -ac 1 -ar 24000 -c:a pcm_s16le reference.wav권리가 있는 목소리만 사용하세요. 서면으로 동의한 내레이터라면 괜찮지만, 영상이나 소셜 피드에서 가져온 클립은 안 됩니다.
먼저 Playground에서 시도해 보세요
Chatterbox text to speech 페이지를 열고 Playground 탭을 사용하세요. 약 240자의 지문이면 비용이 크지 않으면서 템포와 운율을 보여 줍니다.
I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.
- 그 지문을 Text에 붙여 넣습니다.
- Voice reference에서 준비한 클립을 Choose a file로 고릅니다(MP3 또는 WAV, 최대 90 MB). 이미 온라인에 있는 파일을 쓰려면 Asset URL에 링크를 붙여 넣고 Add URL을 선택하세요. 오디오 파일로 바로 연결되는 링크여야 합니다. 클라우드 드라이브나 소셜 공유 페이지를 넣으면 웹 페이지가 돌아와서 작업이
invalid_asset로 실패합니다. 이 단계를 건너뛰면 내장 음성을 들을 수 있습니다. - Expressiveness(
exaggeration), Temperature, Prompt adherence(guidance_scale)는 기본값 0.5, 0.7, 0.5로 그대로 두세요. - 실행합니다. 가격 $0.036이 양식 옆에 표시됩니다.
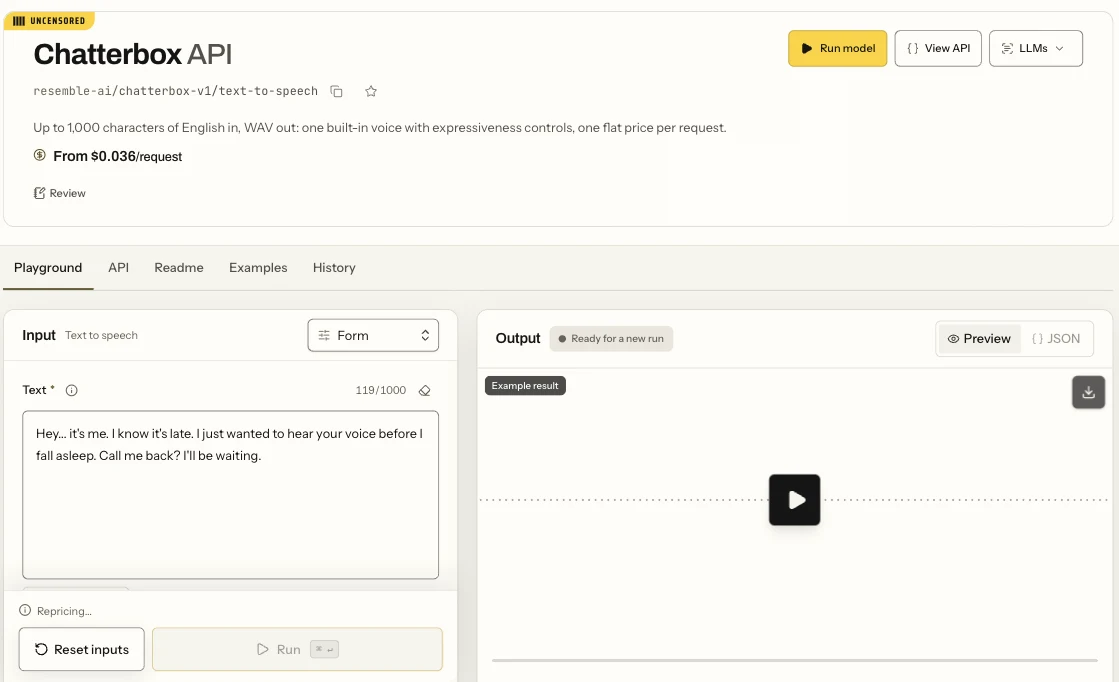
양식 뷰의 Chatterbox 텍스트 음성 변환 Playground: 텍스트 입력란과 Run 버튼.
대본을 손에 들고 전체를 들어 보세요. 단어가 빠지지 않고 첫 문장과 마지막 문장이 온전하며, 처음부터 끝까지 같은 화자이고, 끝부분에 무음이나 잡음이 없어야 합니다. 프로젝트 전체에서 레퍼런스 파일은 하나로 두세요. 파트마다 다시 잘라 내면 목소리가 달라집니다.
그다음 코드로 호출하기
한 번의 결과가 마음에 들면 같은 요청을 직접 만든 앱에서 보내세요. SPICY_API_KEY에 서버 쪽 키를 넣고, reference_audio_url에는 클립으로 바로 가는 HTTPS 링크 또는 spicyapi files upload ./reference.wav가 출력하는 spicy:// 주소를 넣으세요(업로드는 약 하루 동안 계속 쓸 수 있습니다):
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "resemble-ai/chatterbox-v1/text-to-speech",
    "input": {
      "text": "I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.",
      "reference_audio_url": "https://example.com/reference.wav",
      "exaggeration": 0.5,
      "guidance_scale": 0.5,
      "temperature": 0.7
    }
  }'
결과와 다운로드, 오류는 작업 문서에, 업로드는 Media 가이드에 있습니다.
또는 Agent에게 녹음 맡기기
에이전트는 CLI, MCP 서버, Agent Skill로도 같은 호출을 할 수 있습니다. CLI와 MCP는 가격을 보여 주고 작업을 만들기 전에 확인을 요청합니다. SPICY_API_KEY를 설정하고 input.json에는 위 요청의 input 객체만 담아 두면 됩니다:
# CLI
spicyapi files upload ./reference.wav    # prints a spicy:// URI for reference_audio_url
spicyapi tasks create --model resemble-ai/chatterbox-v1/text-to-speech --input-file input.json --wait

# MCP server: the command your assistant's MCP config runs
# (it exposes spicyapi_upload_file and spicyapi_task_create)
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
들리는 것에 맞는 조절값 바꾸기
녹음마다 설정은 하나만 바꾸고 텍스트와 레퍼런스는 고정해서, 차이가 무엇에서 왔는지 알 수 있게 하세요. 세 번의 녹음(기준 녹음, 표현 변화 하나, 속도 변화 하나)은 $0.108입니다.
| 들리는 것 | 먼저 시도할 것 | 이유 |
|---|---|---|
| 평평하고 강조가 없음 | exaggeration(Expressiveness) 0.7 | 값을 높이면 강조가 들어갑니다. 테스트에서 속도는 거의 변하지 않았습니다(같은 240자로 13.0 s 대 13.4 s). 귀로 판단하세요 |
| 급하게 읽힘 | guidance_scale(Prompt adherence) 0.3 | 낮추면 읽는 속도가 느려집니다. 같은 240자로 0.3에서는 15.0 s, 0.5에서는 13.4 s였습니다 |
| 슬라이더를 어떻게 바꿔도 급함 | 더 차분한 레퍼런스 | 레퍼런스가 속도를 그대로 전달합니다 |
| 단어 하나를 잘못 읽음 | text 수정: 줄임말을 철자로 쓰고, 숫자를 원하는 단어로 적고, 긴 문장을 나누기 | 이 작업에는 발음 사전이 없습니다 |
| 소리를 단어로 읽음 | 태그를 지우고 「Mmm…」 또는 「ha…」로 쓰기 | 이 작업에서는 태그가 그대로 소리 내어 읽힙니다 |
| 내레이터처럼 들리지 않음 | 레퍼런스 점검: 잡음, 두 번째 목소리, 다른 억양이나 전달 | temperature는 녹음 간 차이를 바꿉니다. 동일성 조절값이 아닙니다 |
| 녹음 간 차이가 생각보다 큼 | temperature를 낮추기(0.5 시도) | 녹음 사이의 편차를 조절합니다 |
모델 페이지의 두 예제는 대략적인 기준이 됩니다. 기본 설정에서 저희 테스트 녹음은 초당 약 16~19자였고, exaggeration과 guidance_scale를 모두 0.3으로 둔 차분한 내레이션 예제는 약 14였습니다. 잠잘 때 읽는 조용한 이야기 속도라면 둘 다 낮추세요. 오픈 소스 스크립트의 값을 복사하지 마세요. 호스팅 버전의 기본 temperature는 0.7이고 오픈 소스 버전은 0.8입니다.
긴 대본은 약 500자 파트로 나누기
요청 하나는 1,000자까지 받지만 오디오는 40초에서 잘립니다. 초당 약 18자 기준으로 700자는 36초로 돌아왔고, 900자와 998자는 둘 다 정확히 40초로 돌아왔습니다. 그만큼의 텍스트에는 약 49초가 필요하므로 끝부분이 잘려도 전체 가격 $0.036을 그대로 지불합니다. 파트는 약 500자로 유지하세요(492자짜리 녹음은 27초가 걸렸습니다). 각 녹음의 마지막 문장을 확인하세요.
정액 가격이라 절충점을 계산하기 쉽습니다. 2,430자짜리 챕터 비용은 이렇습니다:
- 약 810자짜리 요청 3회: $0.108, 다만 각각 약 45초가 필요해 40초에서 잘립니다.
- 약 490자짜리 파트 5개: $0.18.
- 약 270자짜리 파트 9개, 각각 약 15초: $0.324.
재녹음 여유분도 더해 보세요. 5개 파트 계획에서 두 번 다시 녹음하면 요청이 일곱 번이 되어 $0.252입니다. 단어 하나를 고치는 것도 온전한 $0.036이므로, 단어씩 손보지 말고 문장이나 파트 전체를 다시 녹음하세요.
자르기는 문단 끝이나 완전한 문장 사이에서 하고, 맥락을 위해 문장 몇 개는 함께 두세요. 약 300~500자짜리 파트는 자연스럽게 들립니다. 모든 파트에 같은 레퍼런스 파일, 같은 세 숫자, 같은 본문 규칙을 쓰고, 단어가 아니라 공백과 문장부호를 포함한 글자 수를 세세요.
파트들은 비슷한 음량으로 왔습니다. 합치기 전에 더 큰 소리인 파트를 낮추세요. 다음 명령은 녹음 사이에 짧은 간격을 두고 이어 붙입니다(0.35초는 화자가 문단 사이에서 멈추는 길이에 맞춰 조절하세요):
ffmpeg -y -f lavfi -i anullsrc=r=24000:cl=mono -t 0.35 -c:a pcm_s16le gap.wav
printf "file 'part-01.wav'\nfile 'gap.wav'\nfile 'part-02.wav'\nfile 'gap.wav'\nfile 'part-03.wav'\n" > list.txt
ffmpeg -y -f concat -safe 0 -i list.txt -c copy narration.wav
한 파트가 잘못됐다면 같은 레퍼런스와 설정으로 그 파트만 다시 생성하세요. 두 번 실패했다면 세 번째 녹음 전에 텍스트를 바꾸세요.
Chatterbox가 맞지 않는 때
- 다른 언어, 또는 두 명의 화자. 호스팅 작업은 영어만 지원하며 요청당 한 목소리만 읽습니다. 두 명이면 화자마다 요청을 하나씩 보내 위 방법대로 이어 붙이거나, Gemini 텍스트 음성 변환 모델 세 개 중 하나를 쓰세요. 그 대화 필드는 한 요청에서 프리셋 음성을 최대 두 개까지 섞습니다(비교 글에 정리되어 있습니다). 대화는 프리셋 음성을 쓰지, 당신의 레퍼런스 클립을 쓰지 않습니다. 다른 언어에 대해서는 비교 글이 언어와 가격을 다룹니다.
- 대사를 말하는 얼굴. WAV에는 타이밍 데이터가 없습니다. Talking Avatar나 Lip Sync 같은 립싱크 또는 아바타 발화 모델에 넣으세요.
- 자막. 완성된 오디오는 음성 인식 단계에 통과시키세요. 대본 길이로 타이밍을 추정하지 마세요.
성인 대상 소설에 대해 SpicyAPI는 콘텐츠 필터를 추가하지 않으며, 성인 대본은 내장 음성으로 끝까지 읽혔습니다. 본인의 동의 없이 실제 사람의 목소리로 성인 대본을 읽지 마세요.
자주 묻는 질문
Chatterbox가 음성 복제를 지원하나요? 호스팅 작업은 선택적 MP3 또는 WAV 레퍼런스의 음색을 모방할 뿐, 음성을 학습하지는 않습니다.
음성을 복제하는 것이 불법인가요? 동의 여부, 당신과 화자가 있는 지역, 오디오를 쓰는 목적에 따라 달라집니다. 허가 없이 다른 사람의 목소리를 쓰거나, 합성 음성을 실제 사람의 발언인 것처럼 제시하면 법적 문제가 생길 수 있습니다. 허가는 파일로 보관하고, 필요한 곳에서는 오디오가 합성임을 밝혀 주세요.
음성을 저장해서 이름으로 부를 수 있나요? 안 됩니다. 스키마에 voice ID가 없으므로 레퍼런스 파일을 매번 보내야 합니다.
시작 지점
Playground에 깨끗한 10~15초 레퍼런스를 올리고 기본값으로 240자짜리 녹음을 한 번, $0.036에 실행하세요. 결과가 좋으면 대본을 약 500자씩 나누고 실패한 파트만 다시 녹음하세요. 좋지 않으면 먼저 레퍼런스나 위 표의 조절값 하나를 고치세요.





