Tienes una grabación de una persona narradora y un guion que rebasa un párrafo. Chatterbox v1 en SpicyAPI puede leer ese guion con el timbre de la grabación, trozo a trozo. Usar el mismo archivo de referencia y los mismos tres ajustes en cada trozo ayuda a mantener la coherencia de la voz a lo largo de un capítulo.
Para una primera pasada, recorta un fragmento limpio de 10 a 15 segundos de una sola persona en el estilo que quieras y usa los valores predeterminados exaggeration: 0.5, guidance_scale: 0.5 y temperature: 0.7. Según nuestras pruebas de octubre de 2026, la salida se detiene a los 40 segundos, así que divide los guiones largos en trozos de unos 500 caracteres (unos 27 segundos). Cada solicitud cuesta una tarifa fija de $0.036 sea cual sea su longitud, de modo que una narración de diez minutos son unos 17 a 24 trozos, $0.61 a $0.86 antes de repetir tomas. La tarea es asíncrona, solo en inglés y devuelve un archivo WAV.
Si solo necesitas una voz estable, no una grabación concreta, los modelos con voces preestablecidas te lo dan mediante un voice_id fijo (la comparación «Uncensored Text-to-Speech APIs Compared» los lista con sus precios).
Qué acepta la tarea alojada
El esquema de Chatterbox v1 text to speech tiene cinco campos:
| Campo | Valores válidos | Primera opción práctica |
|---|---|---|
text | 1–1.000 caracteres en inglés | Un pasaje corto que termine en una frase completa |
reference_audio_url | MP3 o WAV opcional; límite 90 MB | Un fragmento limpio de una sola persona que tengas derecho a usar |
exaggeration | 0–1 | 0.5 |
guidance_scale | 0.1–1 | 0.5 |
temperature | 0.05–2 | 0.7 |
La referencia es opcional. Omítela para escuchar la voz integrada, una forma rápida de juzgar un guion antes de preocuparte por un clon. Con referencia, la lectura adopta el timbre de ese fragmento; no se entrena nada ni se guarda ninguna voz, así que envías la referencia otra vez con cada solicitud. El precio no cambia.
La salida es un único WAV mono de 24 kHz y 16 bits, sin marcas de tiempo por palabra ni subtítulos. La tarea no tiene multiplicador de velocidad, seed, selector de idioma ni lista de voces. Las etiquetas entre corchetes como [sigh] o <laugh> se leerán en voz alta como palabras. Escribe un sonido con letras («Mmm…», «ha…») y deja las acotaciones fuera de text.
Prepara una referencia que encaje con la narración
La referencia decide qué voz escuchas y también cómo marca el ritmo y actúa. Prepárala para la narración que quieres, no para la muestra más dramática que tengas.
- Longitud y formato. Los responsables recomiendan al menos 10 segundos, idealmente WAV a 24 kHz o más, una sola persona, sin ruido de fondo y una interpretación que coincida con lo que quieres recibir: para una salida al estilo de audiolibro, usa un fragmento al estilo de audiolibro.
- Empieza con habla limpia. El principio del fragmento es lo que más cuenta, pero una sección ruidosa o fuera de estilo más adelante en un archivo largo sigue contando. Recorta 10 a 15 segundos limpios que empiecen con habla.
- Ajusta el ritmo. La referencia arrastra su velocidad al resultado, así que elige el fragmento a la velocidad que debería tener la narración.
- Usa un fragmento en inglés. Una referencia en otro idioma puede traer su acento.
- Quita lo que no quieras que se copie. La música, una segunda voz, el eco de la sala, los picos recortados y los silencios largos hacen el ejemplo menos claro. Una reducción de ruido agresiva que se come la voz puede ser peor que un poco de ruido de fondo constante, así que conserva el original sin tocar y compara.
- Prueba primero las voces poco comunes con una frase. Algunos acentos se desvían: un acento australiano puede salir estadounidense. Gasta $0.036 en una sola frase antes que en un capítulo entero.
Este comando recorta un tramo de 12 segundos que empieza en el segundo 3.2 de una grabación original y lo guarda como WAV mono de 24 kHz y 16 bits (necesita ffmpeg). 24 kHz es la frecuencia con la que trabaja el modelo y el mínimo de los responsables; convertir a ella una grabación de 44.1 o 48 kHz está bien, pero bajar más no aporta nada:
ffmpeg -i narrator-raw.wav -ss 3.2 -t 12 -ac 1 -ar 24000 -c:a pcm_s16le reference.wavUsa solo una voz que tengas derecho a usar: una persona narradora que haya aceptado por escrito, no un fragmento de un vídeo o de un feed social.
Pruébalo primero en el Playground
Abre la página de Chatterbox text to speech y usa la pestaña Playground. Un pasaje de unos 240 caracteres muestra el ritmo y la entonación con poco coste:
I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.
- Pega el pasaje en Text.
- En Voice reference, elige tu fragmento preparado con Choose a file (MP3 o WAV, hasta 90 MB). Para usar un archivo que ya está en línea, pega su enlace en Asset URL y pulsa Add URL; debe ser un enlace directo al archivo de audio, porque una página de disco en la nube o de contenido social devuelve una página web y la tarea falla con
invalid_asset. Omite este paso para escuchar la voz integrada. - Deja Expressiveness (
exaggeration), Temperature y Prompt adherence (guidance_scale) en sus valores predeterminados: 0.5, 0.7 y 0.5. - Ejecuta. El precio, $0.036, aparece junto al formulario.
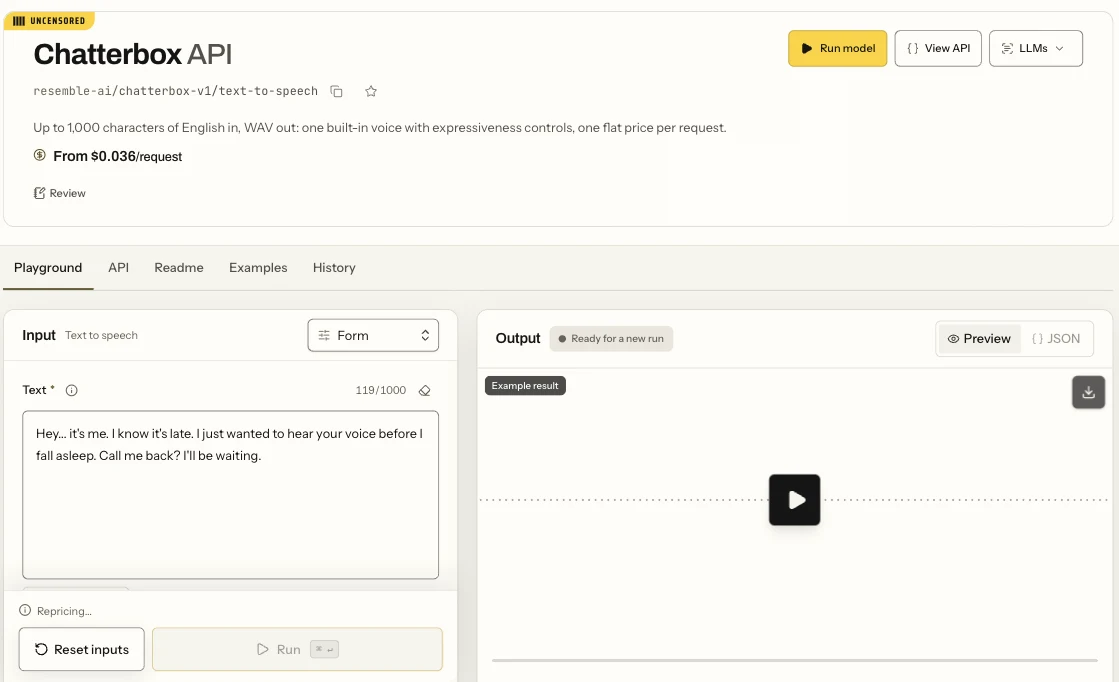
El Playground de texto a voz de Chatterbox en la vista de formulario: el campo de texto y el botón Run.
Escucha la toma completa con el guion a mano: todas las palabras presentes, la primera y la última frase intactas, la misma persona de principio a fin, sin silencio muerto ni ruido al final. Mantén un solo archivo de referencia para todo el proyecto; recortarlo entre trozos cambia la voz.
Después llámalo desde el código
Cuando una toma suene bien, envía la misma solicitud desde tu propia aplicación. Define SPICY_API_KEY con tu clave de servidor y apunta reference_audio_url a un enlace HTTPS directo al fragmento, o a una dirección spicy:// que imprima spicyapi files upload ./reference.wav (una subida sigue siendo utilizable aproximadamente un día):
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "resemble-ai/chatterbox-v1/text-to-speech",
    "input": {
      "text": "I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.",
      "reference_audio_url": "https://example.com/reference.wav",
      "exaggeration": 0.5,
      "guidance_scale": 0.5,
      "temperature": 0.7
    }
  }'
Los resultados, las descargas y los errores están en la documentación de tareas; las subidas están en la guía de medios.
O deja que un agente haga las tomas
Un agente puede hacer la misma llamada mediante la CLI, el servidor MCP o el Agent Skill. La CLI y MCP muestran el precio y te piden confirmar antes de crear una tarea. Con SPICY_API_KEY definido y input.json conteniendo solo el objeto input de la solicitud anterior:
# CLI
spicyapi files upload ./reference.wav    # prints a spicy:// URI for reference_audio_url
spicyapi tasks create --model resemble-ai/chatterbox-v1/text-to-speech --input-file input.json --wait

# MCP server: the command your assistant's MCP config runs
# (it exposes spicyapi_upload_file and spicyapi_task_create)
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
Cambia el control que corresponda a lo que oyes
Cambia un solo ajuste por toma y mantén el texto y la referencia fijos, así sabrás qué causó la diferencia. Tres tomas (una de base, un cambio de expresión y un cambio de ritmo) cuestan $0.108.
| Lo que oyes | Prueba primero | Por qué |
|---|---|---|
| Plano, sin énfasis | exaggeration (Expressiveness) 0.7 | Los valores más altos añaden énfasis; el ritmo apenas cambió en nuestra prueba (13.0 s frente a 13.4 s para los mismos 240 caracteres), así que juzga a oído |
| Apresurado | guidance_scale (Prompt adherence) 0.3 | Bajarlo ralentiza la lectura: los mismos 240 caracteres duraron 15.0 s a 0.3 frente a 13.4 s a 0.5 |
| Apresurado con cualquier control | Una referencia más tranquila | La referencia arrastra su ritmo |
| Una palabra está mal | Edita text: escribe una abreviatura completa, escribe los números como las palabras que quieres, divide una frase larga | La tarea no tiene diccionario de pronunciación |
| Un sonido se lee como una palabra | Quita la etiqueta; escribe «Mmm…» o «ha…» | Las etiquetas se leen en voz alta en esta tarea |
| No suena como la persona narradora | Corrige la referencia: ruido, una segunda voz, otro acento u otra interpretación | temperature varía las tomas; no es un control de identidad |
| Las tomas difieren más de lo que quieres | Baja temperature (prueba 0.5) | Controla la variación entre tomas |
Los dos ejemplos de la página del modelo dan una orientación aproximada: con los valores predeterminados nuestras tomas iban a unos 16 a 19 caracteres por segundo, y el ejemplo de narración tranquila, con exaggeration y guidance_scale ambos en 0.3, a unos 14. Para un ritmo suave de cuento de buenas noches, baja los dos. No copies valores del script de código abierto: el valor predeterminado de temperature en el servicio alojado es 0.7, mientras que en el de código abierto es 0.8.
Divide los guiones largos en trozos de unos 500 caracteres
Una solicitud acepta 1.000 caracteres, pero el audio se corta a los 40 segundos. A unos 18 caracteres por segundo, 700 caracteres volvieron como 36 segundos, y 900 y 998 caracteres volvieron ambos como exactamente 40 segundos, mientras que ese texto necesita unos 49 segundos, así que el final se recorta y aun así pagas los $0.036 completos. Mantén los trozos en unos 500 caracteres (una toma de 492 caracteres duró 27 segundos) y comprueba la última frase de cada toma.
El precio fijo hace fácil calcular el compromiso. Un capítulo de 2.430 caracteres cuesta:
- 3 solicitudes de unos 810 caracteres: $0.108, pero cada una necesita unos 45 segundos y se corta a los 40.
- 5 trozos de unos 490 caracteres: $0.18.
- 9 trozos de unos 270 caracteres, unos 15 segundos cada uno: $0.324.
Suma un margen para repeticiones: dos repeticiones en el plan de cinco trozos hacen siete solicitudes, $0.252. Una reparación de una sola palabra también cuesta los $0.036 completos, así que repite una frase o un trozo entero en lugar de retocar palabra por palabra.
Corta al final de los párrafos o entre frases completas y deja varias frases juntas para dar contexto; los trozos de unos 300 a 500 caracteres suenan naturales. Usa el mismo archivo de referencia, los mismos tres números y las mismas convenciones de texto para cada trozo, y cuenta caracteres con espacios y puntuación incluidos, no palabras.
Los trozos llegaron con un volumen parecido; baja el más fuerte antes de unirlos. Esto une las tomas con un hueco corto entre ellas (ajusta los 0.35 segundos a cómo hace pausas la persona narradora entre párrafos):
ffmpeg -y -f lavfi -i anullsrc=r=24000:cl=mono -t 0.35 -c:a pcm_s16le gap.wav
printf "file 'part-01.wav'\nfile 'gap.wav'\nfile 'part-02.wav'\nfile 'gap.wav'\nfile 'part-03.wav'\n" > list.txt
ffmpeg -y -f concat -safe 0 -i list.txt -c copy narration.wav
Si un trozo está mal, regenera solo ese trozo con la misma referencia y los mismos ajustes; si falla dos veces, cambia el texto antes del tercer intento.
Cuándo Chatterbox no es la herramienta adecuada
- Otro idioma, o dos personas. La tarea alojada es solo en inglés y lee una voz por solicitud. Para dos personas, haz una solicitud por persona y une los archivos como se muestra arriba, o usa uno de los tres modelos de texto a voz de Gemini, cuyo campo de diálogo mezcla hasta dos voces preestablecidas en una solicitud (la comparación los lista). Un diálogo usa voces preestablecidas, no tu fragmento de referencia. Para otros idiomas, la comparación cubre los idiomas y los precios.
- Una cara que dice la frase. El WAV no tiene datos de tiempos. Pásalo a un modelo de sincronización labial o de avatar parlante como Talking Avatar o Lip Sync.
- Subtítulos. Pasa el audio final por un paso de voz a texto; no deduzcas los tiempos a partir de la longitud del guion.
Para ficción adulta, SpicyAPI no añade ningún filtro de contenido y los guiones adultos se leyeron por completo con la voz integrada. No leas guiones adultos con la voz de una persona real sin su consentimiento.
Preguntas frecuentes
¿Chatterbox admite clonación de voz? La tarea alojada imita el timbre de una referencia MP3 o WAV opcional, pero no entrena ninguna voz.
¿Es ilegal clonar una voz? Depende del consentimiento, de dónde estés tú y dónde esté la persona que habla, y de para qué se use el audio. Usar la voz de alguien sin permiso, o presentar habla sintética como una declaración de una persona real, puede crear problemas legales. Guarda el permiso archivado y, donde haga falta, revela que el audio es sintético.
¿Puedo guardar la voz y llamarla por su nombre? No. El esquema no tiene ningún voice ID, así que envías el archivo de referencia cada vez.
Por dónde empezar
Sube al Playground una referencia limpia de 10 a 15 segundos y ejecuta una toma de 240 caracteres con los valores predeterminados por $0.036. Si suena bien, divide el guion en trozos de unos 500 caracteres y repite solo los que fallen; si no, arregla primero la referencia o el único control de la tabla de arriba.





