ナレーターの録音と、1段落を超える台本があります。SpicyAPIのChatterbox v1なら、その録音の声質をまねて台本をパートごとに読み上げられます。すべてのパートで同じ参照ファイルと同じ3つの設定を使えば、章全体でナレーターの声を一定に保てます。
最初の試行では、望むスタイルで話す1人だけのきれいな10〜15秒のクリップを使い、デフォルト値のexaggeration: 0.5、guidance_scale: 0.5、temperature: 0.7で始めます。2026年10月のテストでは音声は40秒で途切れるため、長い台本は約500文字(約27秒)ずつに分けます。1リクエストあたりの費用は長さに関係なく定額の$0.036なので、10分のナレーションなら約17〜24パート、録り直し前で$0.61〜$0.86です。タスクは非同期で、英語のみ、WAVファイルを1つ返します。
特定の録音ではなく、安定した声が1つあればよい場合は、プリセット音声のテキスト読み上げモデルで固定のvoice_idを選べば、どのリクエストでも同じ声になります(比較記事「Uncensored Text-to-Speech APIs Compared」が価格つきで一覧にしています)。
ホスト型タスクが受け付けるもの
Chatterbox v1 text to speechのスキーマには5つのフィールドがあります。
| フィールド | 有効な値 | 最初の実用的な選択 |
|---|---|---|
text | 英語1〜1,000文字 | 完結した文で終わる短い一節 |
reference_audio_url | 任意のMP3またはWAV、上限90 MB | 使用する権利のある1人分のきれいなクリップ |
exaggeration | 0–1 | 0.5 |
guidance_scale | 0.1–1 | 0.5 |
temperature | 0.05–2 | 0.7 |
参照音声は任意です。省略すると内蔵の声で読み上げるので、クローンを気にする前に台本を確かめる手軽な方法になります。参照を付けると、読み上げはそのクリップの声質を帯びます。学習は行われず、声も保存されないため、参照はリクエストごとに送り直します。価格は変わりません。
出力は24 kHz、16ビット、モノラルのWAVファイル1つで、単語ごとのタイミングも字幕もありません。タスクに速度倍率、seed、言語セレクター、声一覧はありません。[sigh]や<laugh>のような角括弧のタグは、単語として読み上げられます。音は文字で書き(「Mmm…」「ha…」のように)、舞台指示はtextに入れないでください。
ナレーションに合う参照音声を準備する
参照音声は、どの人の声が聞こえるか、そしてその声がどうテンポと演技を進めるかを決めます。最も劇的なサンプルではなく、欲しいナレーションに合わせて準備してください。
- 長さと形式。 開発元は少なくとも10秒、できれば24 kHz以上のWAV、1人だけ、背景ノイズなし、そして返したい結果に合わせた演技を推奨しています。オーディオブック風の出力には、オーディオブック風のクリップを使ってください。
- きれいな音声で始める。 クリップの先頭が最も重要ですが、長めのファイルの後半にあるノイズの多い部分やスタイルに合わない部分も無視できません。音声から始まるきれいな10〜15秒を切り出してください。
- ペースを合わせる。 参照音声は自身の速度を結果に持ち込むので、ナレーションに欲しいペースのクリップを選んでください。
- 英語のクリップを使う。 別の言語の参照音声は、そのアクセントを持ち込むことがあります。
- コピーしたくないものを除く。 音楽、2つ目の声、部屋の反響、クリップされたピーク、長い無音は、いずれも例を不明瞭にします。声に食い込むような強いノイズ除去は、わずかに残る安定した背景ノイズより悪化することがあります。無加工の原本は保存して比較してください。
- 珍しい声はまず1文で試す。 アクセントがずれることがあります。オーストラリアのアクセントがアメリカ式になることもあります。章全体に進む前に、1文に$0.036を使ってください。
次のコマンドは、生の録音から3.2秒の位置以降の12秒区間をカットし、24 kHzモノラル16ビットWAVとして保存します(ffmpegが必要)。24 kHzはモデルが動作する周波数であり、開発元が定める下限です。44.1 kHzや48 kHzの録音をここへ変換してダウンサンプリングしても構いませんが、それより低くしても利点はありません:
ffmpeg -i narrator-raw.wav -ss 3.2 -t 12 -ac 1 -ar 24000 -c:a pcm_s16le reference.wav使用権のある声だけを使ってください。書面で同意したナレーターなら使えますが、動画やソーシャルフィードからのクリップは使いません。
まずPlaygroundで試す
Chatterbox text to speechページを開き、Playgroundタブを使ってください。約240文字のひと節なら、わずかなコストでペースと抑揚を確認できます。
I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.
- その一節をTextに貼り付けます。
- Voice referenceで、準備したクリップをChoose a fileから選びます(MP3またはWAV、最大90 MB)。すでにオンラインにあるファイルを使う場合は、Asset URLにリンクを貼り付けてAdd URLを選びます。音声ファイルへの直接リンクでなければなりません。クラウドドライブやソーシャル共有のページはWebページを返すため、タスクは
invalid_assetで失敗します。この手順を飛ばせば内蔵の声が聞けます。 - Expressiveness(
exaggeration)、Temperature、Prompt adherence(guidance_scale)はデフォルト値の0.5、0.7、0.5のままにします。 - 実行します。価格$0.036がフォームの横に表示されます。
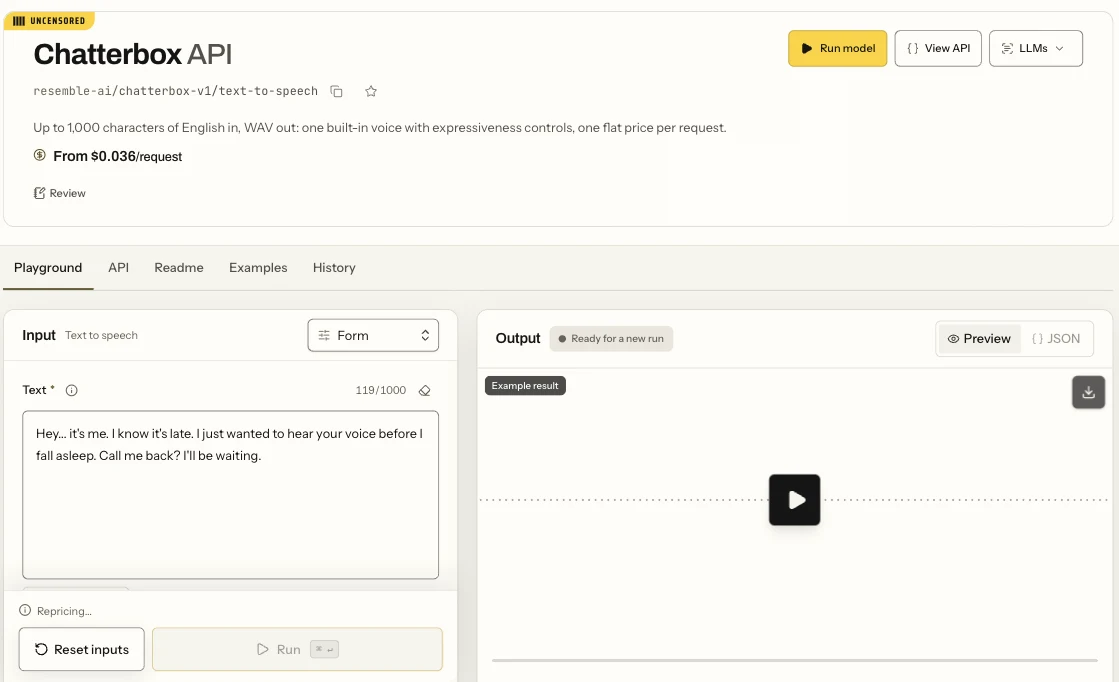
フォームビューでのChatterboxのテキスト読み上げPlayground:テキスト入力欄とRunボタン。
台本を手元に置いて全編を聴いてください。すべての言葉が揃い、最初と最後の文が保たれ、最初から最後まで同じ話者で、終わりに無音もノイズもない状態が目安です。プロジェクト全体で参照ファイルは1つに固定してください。パートごとに切り直すと声が変わります。
次にコードから呼び出す
試しの1回がうまく聞こえたら、同じリクエストを自分のアプリから送ります。SPICY_API_KEYにサーバー側のキーを設定し、reference_audio_urlにはクリップへの直接HTTPSリンク、またはspicyapi files upload ./reference.wavが出力するspicy://アドレスを指定します(アップロードされたファイルは約1日使えます):
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $(uuidgen)" \
  --data '{
    "model": "resemble-ai/chatterbox-v1/text-to-speech",
    "input": {
      "text": "I saved the window seat for you. The rain has stopped, and the lamps along the quay are coming on one by one. Sit down, pour the tea while it is hot, and I will tell you how the story begins. It starts with a locked door and a borrowed key.",
      "reference_audio_url": "https://example.com/reference.wav",
      "exaggeration": 0.5,
      "guidance_scale": 0.5,
      "temperature": 0.7
    }
}'結果、ダウンロード、エラーはタスクのドキュメントにあります。アップロードはMediaガイドにあります。
またはAgentに実行させる
AgentはCLI、MCPサーバー、Agent Skill経由でも同じ呼び出しができます。CLIとMCPは価格を表示し、タスク作成前に確認を求めます。SPICY_API_KEYを設定し、input.jsonには上のリクエストのinputオブジェクトだけを置いてください:
# CLI
spicyapi files upload ./reference.wav    # prints a spicy:// URI for reference_audio_url
spicyapi tasks create --model resemble-ai/chatterbox-v1/text-to-speech --input-file input.json --wait

# MCP server: the command your assistant's MCP config runs
# (it exposes spicyapi_upload_file and spicyapi_task_create)
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
聞こえたものに合わせて調整する
試行ごとに設定は1つだけ変え、テキストと参照音声は固定します。何が差を生んだのかが分かります。3回の試行(基準となるもの、表現の変更1つ、ペースの変更1つ)は$0.108です。
| 聞こえ方 | 最初に試すこと | 理由 |
|---|---|---|
| 平板で強調がない | exaggeration(Expressiveness)0.7 | 値が高いほど強調が入ります。テストではペースはほとんど変わらず、同じ240文字で13.0 sに対して13.4 sでした。耳で判断してください |
| 急ぎすぎる | guidance_scale(Prompt adherence)0.3 | 下げると読み上げが遅くなります。同じ240文字で0.3のときは15.0 s、0.5のときは13.4 sでした |
| スライダーを動かしても急ぎすぎる | より落ち着いた参照音声 | 参照音声がペースを持ち込みます |
| 単語が間違って発音される | textを編集:略語は省略せずに書き出し、数値は聞きたい言い方の単語で書く、長い文は分割 | タスクに発音辞書はありません |
| 音が単語として読まれる | タグを削除し、「Mmm…」「ha…」と書く | このタスクではタグがそのまま読み上げられます |
| ナレーターらしく聞こえない | 参照音声を修正:ノイズ、2つ目の声、違うアクセントや演技 | temperatureは試行ごとの差を変えます。身元の制御ではありません |
| 試行どうしの差が大きい | temperatureを下げる(0.5を試す) | 試行のばらつきを制御します |
モデルページの2つの例はおおよその目安になります。デフォルト設定での試行は秒あたり約16〜19文字、落ち着いたナレーションの例(exaggerationとguidance_scaleを両方0.3にしたもの)は約14文字/秒でした。寝る前のお話のような静かなペースが必要なら、両方を下げます。オープンソースのスクリプトから値をコピーはしないでください。ホスト版のデフォルトのtemperatureは0.7、オープンソース版は0.8です。
長い台本は約500文字のパートに分ける
1リクエストで1,000文字まで受け付けますが、音声は40秒で切れます。約18文字/秒では、700文字は36秒、900文字と998文字はどちらもちょうど40秒で返りました。それだけの文字を話すには約49秒かかるため、末尾は切れますが、費用は満額の$0.036です。パートは約500文字に収めてください(492文字の試行は27秒でした)。各試行の最後の文を確認してください。
固定料金ならトレードオフは計算しやすいです。2,430文字の章の費用は次のとおりです。
- 約810文字の3リクエスト:$0.108。ただし各々約45秒必要で、40秒で切れます。
- 約490文字の5パート:$0.18。
- 約270文字の9パート、各々約15秒:$0.324。
録り直しの余裕も見ておきます。5パートの計画で2回録り直すとリクエストは7回、$0.252です。1語の修正にも満額の$0.036がかかるので、単語を1つずつ直すのではなく、文やパート全体を録り直してください。
切り分けは段落の終わりに沿って、または完全な文の間で行い、文脈のために文をいくつかまとめて置いてください:約300〜500文字のパートなら自然です。すべてのパートで同じ参照ファイル、同じ3つの数値、同じ本文の書き方を守り、単語数ではなく空白と句読点を含めた文字数を数えてください。
パートは類似した音量で返ってきました。結合前に、大きい方を下げてください。次のコマンドは、試行の合間に短い間隔を置いて結合します(0.35秒は、段落のあいだで話者が止める長さに合わせてください):
ffmpeg -y -f lavfi -i anullsrc=r=24000:cl=mono -t 0.35 -c:a pcm_s16le gap.wav
printf "file 'part-01.wav'\nfile 'gap.wav'\nfile 'part-02.wav'\nfile 'gap.wav'\nfile 'part-03.wav'\n" > list.txt
ffmpeg -y -f concat -safe 0 -i list.txt -c copy narration.wav
1つのパートが間違っていたら、同じ参照音声と設定で、そのパートだけを生成し直してください。2回失敗したら、3回目の試行前に本文を変えます。
Chatterboxが向いていない場面
- 別の言語、または2人の話者。 ホスト型タスクは英語のみで、1リクエストにつき1つの声を読み上げます。2人の場合は話者ごとに1リクエストずつ送って上記のように結合するか、Geminiのテキスト読み上げモデル3つのいずれかを使ってください。そのダイアログフィールドは1リクエストでプリセット音声を最大2つまで混ぜて使えます(比較記事に一覧があります)。ダイアログが使うのはプリセット音声であり、あなたの参照クリップではありません。他の言語については比較記事が言語と価格をカバーしています。
- その台詞を話す顔。 WAVにはタイミングデータがありません。Talking AvatarやLip Syncなど、リップシンクまたはアバター発話モデルに渡してください。
- 字幕。 完成した音声を音声認識に通してください。タイミングを台本の長さから推測してはいけません。
成人向けコンテンツについて、SpicyAPIはコンテンツフィルターを追加していません。成人向け台本は内蔵の声で全文が読まれました。本人の同意なしに、実在の人の声で成人向け台本を読み上げないでください。
よくある質問
Chatterboxは音声クローンに対応していますか。 ホスト型タスクは任意のMP3またはWAVの参照音声の声質を真似ますが、声を訓練することはありません。
声をクローンするのは違法ですか。 同意の有無、あなたと話者の所在、音声の用途によって異なります。許可なく誰かの声を使ったり、合成音声を実在の人の発言として提示したりすると、法的問題が生じる可能性があります。許可はファイルに残し、求められる場合は音声が合成であることを示してください。
声を保存して名前で呼べますか。 できません。スキーマにvoice IDフィールドはないので、参照ファイルは毎回送ることになります。
どこから始めるか
Playgroundできれいな10〜15秒の参照音声をアップロードし、デフォルト設定で240文字の試行を1回、$0.036で実行してください。うまく聞こえたなら、台本を約500文字ずつに分けて、失敗したパートだけを録り直してください。うまくいかなければ、まず参照音声か上表の設定のうち1つを直してください。





