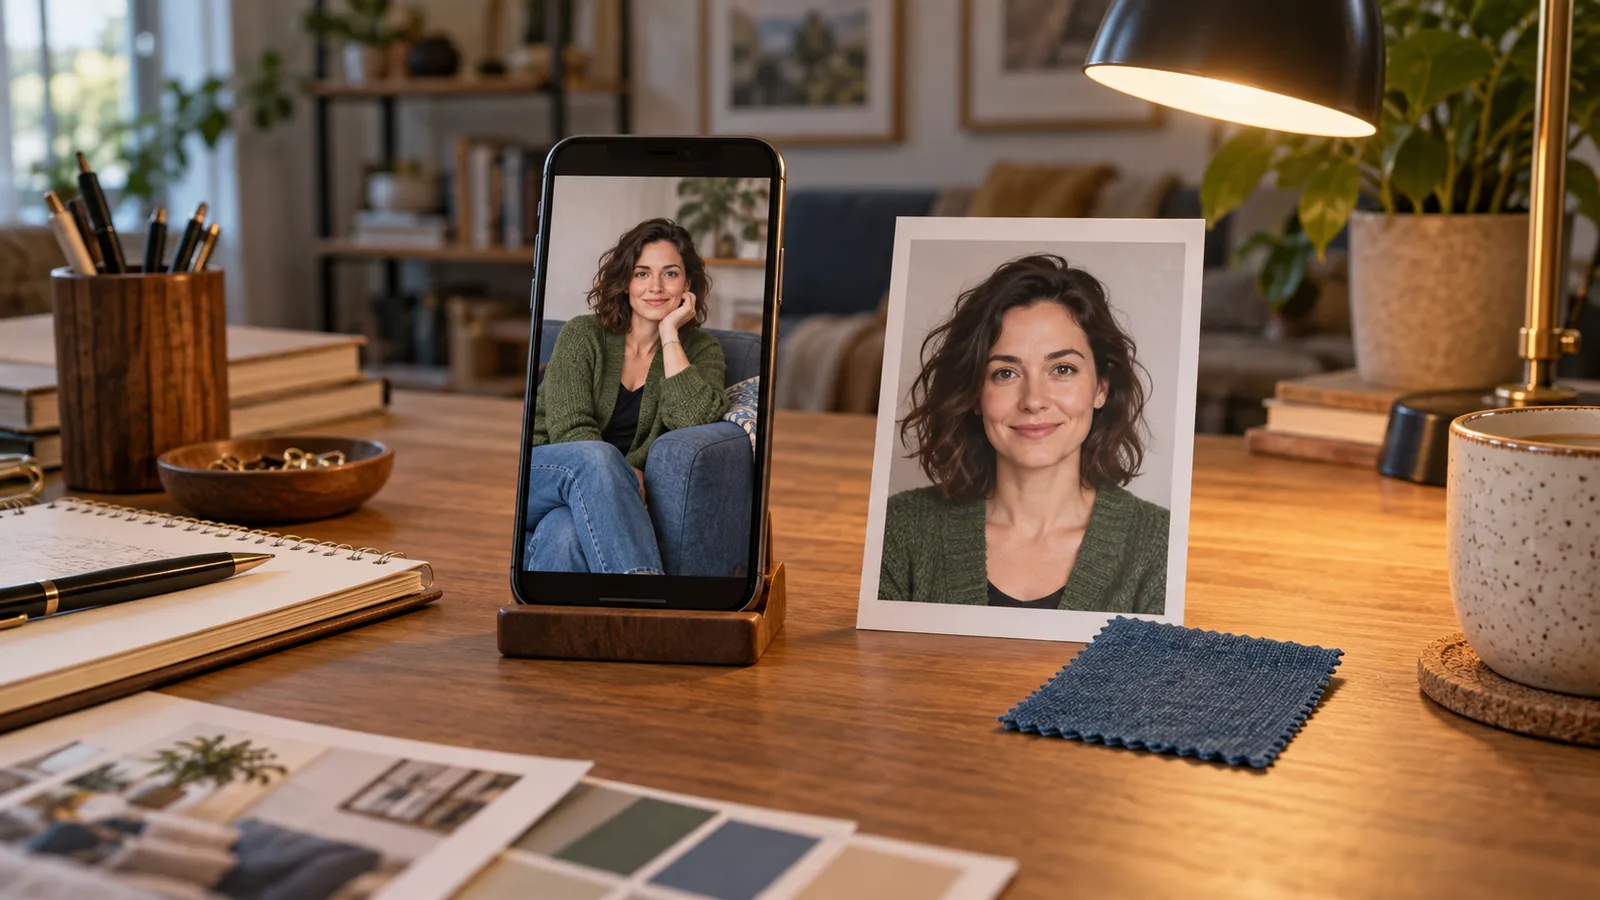
Użytkownik prosi swojego towarzysza AI NSFW: „Wyślij mi kolejne zdjęcie w tym zielonym kardiganie”. Aplikacja zwraca piękny portret, ale postać ma inne włosy, kardigan jest czarny, a mieszkanie zmieniło się w hotel. Generowanie obrazu się udało. Rozmowa już nie.
Twórz selfie towarzysza na podstawie zatwierdzonej referencji postaci i krótkiego zapisu bieżącej sceny. Przed generowaniem ustal osobę, strój, miejsce, wyraz twarzy i ujęcie aparatu. Oddziel stały wygląd od rzeczy, które postać jedynie mówi na czacie, i pozwól, by „kolejne” zmieniało fotografię, zamiast zastępować osobę.
W pierwszej implementacji użyj jednego wyraźnego portretu fikcyjnej dorosłej postaci w edycji Qwen Image 2.1, kadru 3:4, rozdzielczości 1k, nieprzezroczystego tła i wyłączonego rozszerzania promptu. Publiczna wycena dla jednej referencji wynosi $0.036 za wynik; druga referencja podnosi cenę tej konfiguracji do $0.048. Ceny pomagają zaplanować budżet procesu, ale nie gwarantują, że każdy gotowy obraz będzie zgodny z postacią.
Ten poradnik skupia się na wyborze tego, co selfie powinno przedstawiać. Przykłady są propozycjami promptów dla fikcyjnych osób dorosłych, z odzieżą i kompozycjami SFW. Nie zostały uruchomione jako nowy test spójności postaci. Wysyłanie zadań, callbacki i przechowywanie opisuje osobno poradnik dostarczania mediów towarzysza.
Daj żądaniu obrazu mniej kontekstu, ale lepszy kontekst
Rozmowa zawiera kilka rodzajów informacji. Postać może pamiętać swój wygląd, rozważać nową fryzurę, wyobrażać sobie przyszłe wakacje i opisywać pokój, w którym jest teraz. Tylko część tego należy do następnego zdjęcia.
Załóżmy, że twoim towarzyszem jest Nina, fikcyjna dorosła osoba w wieku 32 lat, z ciemnymi lokami do ramion, brązowymi oczami i wąską srebrną obrączką na prawej dłoni. Zatwierdzony portret określa jej twarz. W bieżącej scenie ma zielony kardigan na nieprześwitującym kremowym topie, siedzi obok niebieskiej sofy i mówi o przygotowaniach do wieczornego wyjścia. Użytkownik prosi o selfie, zanim wyjdzie.
Model obrazu potrzebuje referencji postaci, bieżącego stroju, pokoju i zamówionej fotografii. Nie potrzebuje całej rozmowy o dzisiejszych planach. „Może zetnę włosy w przyszłym tygodniu” nie powinno dziś zmieniać fryzury. Dawna scena plażowa nie powinna też zastępować mieszkania tylko dlatego, że pojawia się wcześniej w historii wiadomości.
To rzeczywiste źródło nieporozumień w produktach z towarzyszami AI. W oryginalnej dyskusji DearestAI użytkownik zgłosił, że selfie towarzysza przejęło krótszą fryzurę i siwe skronie, gdy te cechy pojawiły się w rozmowie. Odpowiedź opisująca zachowanie tej aplikacji mówiła, że pamięć wyglądu może mieć pierwszeństwo przed zdjęciem bazowym. To relacja o innym produkcie, a nie dowód na to, jak Qwen lub SpicyAPI interpretuje pamięć. Ilustruje decyzję, którą aplikacja musi podjąć wprost: który opis ma prawo zmienić obraz?
Dla Niny bezpieczna reguła domyślna zakłada, że zatwierdzona tożsamość wizualna pozostaje stała, dopóki użytkownik świadomie jej nie aktualizuje. Czat może zmienić dzisiejszy kardigan; nie może po cichu zastąpić twarzy ani jej dorosłego wieku. Jeśli fryzura jest zamierzoną zmianą projektu postaci, stwórz nową zatwierdzoną wersję tożsamości i od tego momentu używaj jej konsekwentnie.
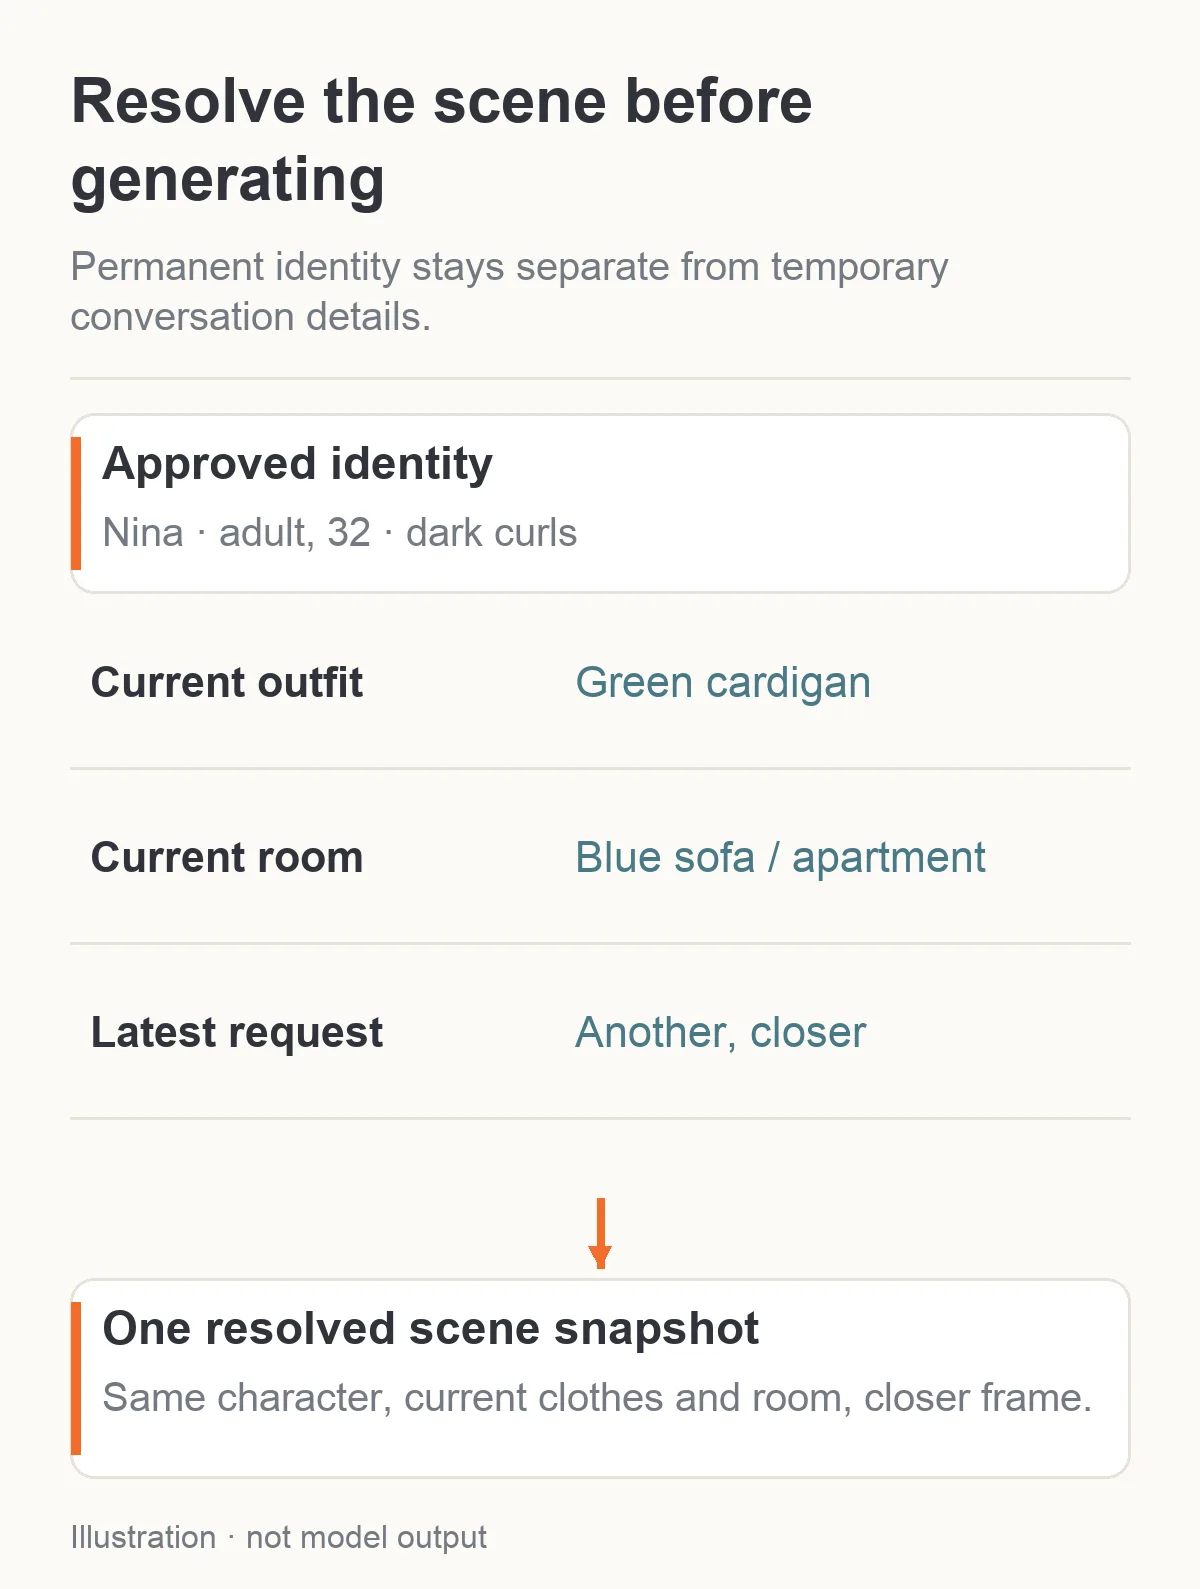
Ilustracja: bieżący kontekst dostarcza ubrania i miejsce; zatwierdzony portret dostarcza postać.
Zapisuj pięć przydatnych elementów pamięci wizualnej
Nie potrzebujesz ogromnej bazy postaci, by pierwsze selfie były spójne. Zacznij od oddzielnych rekordów w aplikacji:
| Rekord | Przykład Niny | Kiedy się zmienia |
|---|---|---|
| Zatwierdzona tożsamość | Plik portretu, wiek 32 lata, ciemne loki, brązowe oczy | Przy świadomej zmianie projektu postaci |
| Bieżący strój | Zielony kardigan, nieprześwitujący kremowy top | Przy wyraźnej zmianie ubrania w scenie |
| Bieżące otoczenie | Niebieska sofa, lampa stojąca, mieszkanie nocą | Gdy postać dociera w inne miejsce |
| Bieżąca fotografia | Od pasa w górę, lekki uśmiech, wzrok do aparatu | Gdy użytkownik prosi o inne zdjęcie |
| Ostatnie zaakceptowane zdjęcie | Rzeczywisty plik, pokazany strój i otoczenie | Gdy nowe zdjęcie zostaje zaakceptowane do dostarczenia |
To rekordy aplikacji, a nie specjalne pola API Qwen. Zamień przechowywany zasób na image_urls, a zamierzone zmiany wizualne zapisz w prompt. Nazwa postaci jest wygodną etykietą; endpoint obrazu nie przeszukuje po nazwie twojej bazy postaci.
Przechowuj rzeczywistą zaakceptowaną fotografię obok zamierzonej sceny. Jeśli poprzedni obraz przypadkiem pokazał niebieski kardigan, nie pozostawiaj po cichu zielonego w zapisanej scenie, pisząc w następnym prompcie „ten sam kardigan co wcześniej”. Odrzuć obraz albo uznaj rozbieżność i ją rozwiąż. Inaczej model otrzyma dwie sprzeczne definicje słowa „ten sam”.
Zapisuj fakty wizualne zamiast emocjonalnej prozy. „Zielony dzianinowy kardigan, kremowy top, niebieska sofa” pomaga stworzyć obraz. „Czuje bliskość z użytkownikiem i pamięta intymną rozmowę” nie określa ubrania, układu pokoju ani spojrzenia. Kontekst emocjonalny może wybrać wyraz twarzy, ale nie powinien przenosić całej prywatnej wymiany do żądania obrazu.
Ta sama struktura sprawdza się dla męskiego towarzysza lub konta dorosłej postaci tej samej płci. Zmień zatwierdzoną tożsamość i garderobę, a nie logikę. Nie buduj uniwersalnej funkcji na założeniu, że każdy użytkownik chce jednego rodzaju postaci.
Ustal, czy wiadomość faktycznie prosi o nowy obraz
„Świetnie wyglądasz na tym zdjęciu” to rozmowa, a nie polecenie zakupu kolejnego generowania. „Chciałbym cię zobaczyć” jest niejednoznaczne. „Wyślij kolejne zdjęcie w tym samym stroju” jest prośbą o obraz.
Na wczesnym etapie użyj widocznego przycisku zdjęcia i jasnych zwrotów proszących o fotografię. Jeśli interpretujesz również swobodny czat, klasyfikuj wiadomość użytkownika do trzech działań: stwórz zdjęcie, wykorzystaj znane zdjęcie lub kontynuuj rozmowę. Klasyfikacja odbywa się w produkcie, zanim powstanie prompt wizualny.
Kilka częstych wiadomości wymaga różnych rezultatów:
| Wiadomość użytkownika | Przydatne działanie |
|---|---|
| „Wyślij mi tamto jeszcze raz”. | Zwróć zaakceptowany plik, jeśli użytkownik nadal ma do niego dostęp |
| „Jeszcze jedno, trochę bliżej”. | Zachowaj osobę, strój i pokój; zmień kadr |
| „Pokaż mi strój, o którym mówiłaś”. | Ustal konkretny strój, a potem stwórz nowe zdjęcie |
| „Co założyłabyś na imprezę?” | Odpowiedz na pytanie; zaproponuj zdjęcie bez automatycznego generowania |
| „Nie, zachowaj zielony kardigan”. | Popraw wybór oczekującej sceny przed wysłaniem albo stwórz wyraźnie oznaczoną poprawkę, jeśli zadanie już wysłano |
Poprawia to doświadczenie i rachunek. Towarzysz wysyłający płatne obrazy za każdym razem, gdy ktoś go komplementuje, szybko staje się nieprzewidywalny. Widoczny wybór pozwala też zrozumieć, kiedy użytkownik zamawia nowe zdjęcie, a kiedy pobiera już posiadane.
Dla „tego stroju” sprawdź najpierw ostatnie decyzje dotyczące sceny, a potem ostatnie zaakceptowane zdjęcie. Jeśli pasują dwa ubrania, zadaj na czacie wąskie pytanie, np. „Zielony kardigan czy granatowa kurtka?”. Nie każ użytkownikowi powtarzać całej sceny. Wyjaśnienie jednego brakującego elementu jest lepsze niż wygenerowanie niewłaściwego i przepraszanie później.
Ustalaj scenę w stałej kolejności
Wybieraj tożsamość, strój, miejsce, wyraz twarzy, a następnie aparat. To zalecenie projektowe dla aplikacji, a nie specjalna kolejność wymagana przez model w payloadzie API.
Tożsamość jest pierwsza, ponieważ referencja musi należeć do wybranej postaci. Strój jest następny, ponieważ słowa „ten” i „ten sam” często zależą od wcześniejszych wyborów ubrania. Miejsce określa oczekiwania wobec otoczenia postaci. Wyraz twarzy powinien wynikać z bieżącej wymiany, a nie z trwałej reguły „zawsze się uśmiecha”. Aparat jest ostatni, ponieważ ciasne selfie i zdjęcie całego stroju wymagają pokazania różnej części sceny.
Dla prośby dotyczącej Niny ustal:
- Zatwierdzony portret Niny, zamiast ostatniego atrakcyjnego wyniku.
- Zielony kardigan i kremowy top, zamiast proponowanego stroju imprezowego.
- Mieszkanie obok niebieskiej sofy, ponieważ jeszcze nie wyszła.
- Lekki, swobodny uśmiech, ponieważ to przyjazna prośba o zdjęcie.
- Ujęcie aparatem telefonu od klatki piersiowej w górę, ponieważ użytkownik poprosił o selfie, a nie katalogowe zdjęcie stroju.
Jeśli użytkownik prosi o „pełne zdjęcie kardiganu”, zmień ujęcie i położenie dłoni. Nie zachowuj kadru selfie z nadzieją, że ubranie stanie się widoczne. Jeśli prosi o „zdjęcie, gdy tam dotrzesz”, zaplanuj je lub zaczekaj na przyszłą scenę zgodnie z zachowaniem produktu; nie przedstawiaj przyszłego miejsca jako obecnego pokoju postaci.
Krótkie podsumowanie sceny pod wskaźnikiem generowania ujawnia te wybory: „Nina · zielony kardigan · mieszkanie · bliższe selfie”. Użytkownicy mogą wychwycić błędne założenie przed nadejściem wyniku. To przydatniejsze niż ogólna animowana wiadomość twierdząca, że postać właśnie robi zdjęcie.
Napisz prompt selfie, który brzmi jak fotografia
Prześlij zatwierdzony portret tożsamości jako pierwszą referencję. Zacznij od takiego proponowanego promptu:
Użyj obrazu 1 dla tożsamości twarzy i ciemnych loków do ramion Niny, tej samej fikcyjnej dorosłej osoby w wieku 32 lat. Stwórz jedno swobodne zdjęcie aparatem telefonu od klatki piersiowej w górę w jej mieszkaniu nocą. Nina ma zielony dzianinowy kardigan na nieprześwitującym kremowym topie. Za nią widać niebieską sofę i ciepłą lampę stojącą. Jej twarz jest wyraźnie widoczna, oczy patrzą w obiektyw, usta są rozluźnione z lekkim uśmiechem. Naturalne światło we wnętrzu, nieco nieformalny kadr, realistyczna faktura skóry. Zachowaj twarz i włosy z obrazu 1. Bez drugiej osoby, tekstu, lustra i kolażu.
Użyj aspect_ratio: "3:4", resolution: "1k", background: "opaque", output_format: "png" i enable_prompt_expansion: false. Te kontrolki istnieją w bieżącym zadaniu edycji. Prompt przyjmuje do 5 000 znaków, a zadanie od jednej do dziesięciu referencji. Żaden z limitów nie oznacza, że każde selfie wymaga wypełnienia promptu lub przesłania dziesięciu zdjęć.
Bezpośrednie ujęcie aparatem telefonu nie wymaga widocznego telefonu w kadrze. Gdy prosisz postać o trzymanie telefonu przed twarzą, możesz zasłonić właśnie tę tożsamość, którą próbujesz zachować. W pierwszej implementacji pomiń lustro i dłoń z urządzeniem, dopóki nie staną się ważne dla zamówionego zdjęcia. Nieformalna fotografia może przekazać zamierzony styl aparatu bez dodawania obu elementów.
Nie łącz „swobodnego selfie” z „luksusową kampanią, nieskazitelną studyjną urodą, światłem editorial i reklamą mody”. Takie instrukcje ciągną obraz w stronę dopracowanej sesji. W oryginalnym wątku opinii o aplikacji towarzysza komentujący narzekał, że zdjęcia wyglądają jak profesjonalne reklamy. Deweloper odpowiedział, że zwykły styl aparatu telefonu jest ważny na czacie. Ta dyskusja wskazuje preferencję odbiorcy, a nie zmierzoną przewagę jakościową modelu.
Nadal możesz wybrać dopracowany portret, jeśli użytkownik o niego prosi. Chodzi o dopasowanie fotografii do rozmowy, zamiast stosowania tej samej upiększającej obróbki do wszystkiego.
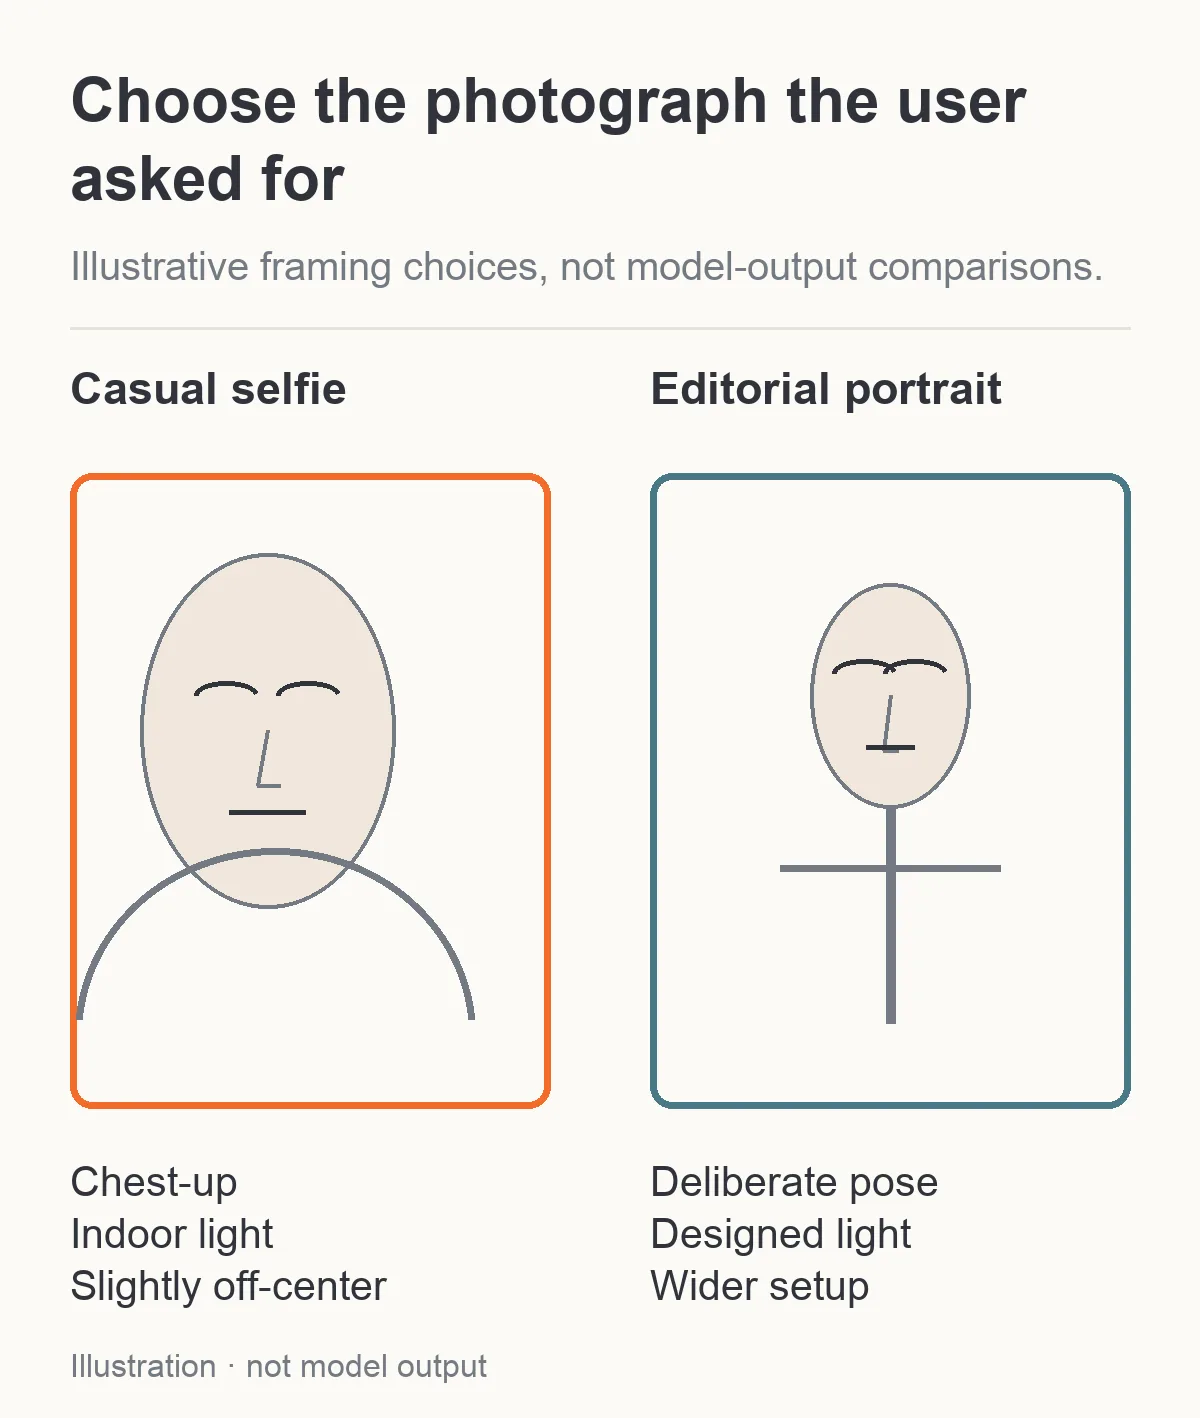
Ilustracja: instrukcje aparatu i światła zmieniają typ fotografii, zachowując referencję postaci.
Niech „jeszcze jedno” będzie kontrolowaną wariacją
Powtórna prośba zwykle wymaga niewielkiej różnicy. Nie potrzebuje nowej osoby, nowego pokoju i nowego kostiumu.
Zachowaj powyższe instrukcje tożsamości i sceny. Zastąp tylko instrukcję fotograficzną:
| Kolejna prośba | Zmiana promptu |
|---|---|
| „Trochę bliżej”. | Kadr głowy i ramion; zachowaj to samo spojrzenie i wyraz twarzy |
| „Spójrz w bok”. | Mały skręt głowy, wzrok tuż obok obiektywu; ramiona pozostają niemal na wprost |
| „Pokaż więcej kardiganu”. | Kadr od pasa w górę, widoczne rękawy i dolna krawędź kardiganu, rozluźnione ręce |
| „Mniej pozowane”. | Lekko niecentralna kompozycja, rozluźnione usta, ramiona na nierównej wysokości zamiast formalnej postawy |
Jeśli zwykłe przycięcie zaakceptowanego pliku już odpowiada na „bliżej”, użyj tego kadru. Zachowuje rzeczywistą twarz bez opłaty za generowanie. Sprawdź, czy źródło ma dość pikseli dla finalnego wyświetlania; maleńka twarz nie stanie się szczegółowym portretem przez samo powiększenie.
Gdy potrzebujesz innego wyrazu twarzy lub punktu widzenia, wróć do zatwierdzonego portretu. Zaakceptowaną scenę dodaj jako drugą referencję tylko wtedy, gdy jej pokój lub ubrania dostarczają przydatnych informacji wizualnych. Wyraźnie przypisz jej rolę: „Obraz 2 dostarcza zielony kardigan i mieszkanie; obraz 1 dostarcza twarz i włosy Niny”. Unikasz wtedy traktowania każdego szczegółu potencjalnie niedoskonałego późniejszego wyniku jako nowej definicji tożsamości.
Po stronie NSFW produktu dla dorosłych oddziel wybraną przez użytkownika kategorię sceny od słowa „kolejne”. Prośba o kolejny obraz powinna zachować zaakceptowany wybór treści, zamiast automatycznie go intensyfikować. Inna kategoria to nowa prośba kreatywna, z własnym zachowaniem modelu, ceną i uprawnieniami produktu.
Dodaj referencję pokoju tylko wtedy, gdy pokój musi się powtarzać
Tekst może wystarczyć, gdy mieszkanie jest tylko atmosferą tła. Stały wirtualny pokój wymaga więcej: niebieska sofa nie powinna przemieszczać się między każdą rozmową, a ta sama lampa zmieniać się w żyrandol.
Dodaj czystą referencję pustego pokoju jako obraz 2. Portret Niny pozostaw pierwszy, a potem napisz:
Obraz 1 dostarcza tożsamość twarzy i ciemne loki Niny. Obraz 2 dostarcza wyłącznie układ mieszkania, niebieską sofę i lampę stojącą. Nie przejmuj osoby, stroju ani twarzy z obrazu 2. Nina pozostaje w zielonym kardiganie i kremowym topie, blisko aparatu, z sofą za nią.
W bliskim selfie widać tylko część pokoju. Nie musisz wymagać każdej ściany, drzwi i półki na zdjęciu. Wybierz dwa charakterystyczne elementy, które rzeczywiście zmieszczą się za postacią. Jeśli użytkownik prosi o szerszą fotografię, wtedy pokaż więcej układu.
Oficjalne repozytorium modelu Qwen opisuje edycję z wieloma referencjami i edycje zachowujące tożsamość. Uzasadnia to próbę użycia osobnych źródeł postaci i pokoju; nie gwarantuje doskonałej ciągłości wizualnej w aplikacji. Sprawdzaj wynik, zwłaszcza gdy znacznie zmieniają się światło, kąt lub ubranie.
Traktuj wyraz twarzy jako małą instrukcję wizualną
„Zalotna”, „ciepła” i „tajemnicza” mogą dawać bardzo różne twarze. Użyj jednej lub dwóch widocznych wskazówek zamiast stosu emocjonalnych etykiet. Rozluźnione zamknięte usta, lekki uśmiech lub oczy patrzące tuż obok obiektywu mówią modelowi wyraźniej, co ma zawierać fotografia.
Dla przyjaznej wieczornej wiadomości spróbuj „lekki uśmiech, rozluźnione brwi, wzrok do obiektywu”. Dla zamyślonej odpowiedzi spróbuj „rozluźnione usta, spojrzenie lekko poza aparat”. Nie zamieniaj nieporozumienia na czacie w dramatyczny gniewny portret, chyba że użytkownik poprosił o takie zdjęcie. Wymiana tekstowa i wyraz twarzy nie muszą mechanicznie się powtarzać.
Oddziel makijaż, światło i wyraz twarzy od tożsamości. Uśmiech zmienia kształt policzków; światło boczne zmienia pozorną szerokość nosa. Porównuj twarz pod podobnym kątem, zanim uznasz ją za inną postać. Z drugiej strony nie tłumacz wyraźnie zmienionej linii włosów lub rozstawu oczu światłem tylko dlatego, że obraz jest atrakcyjny.
Właściwym celem jest rozpoznawalny i odpowiedni wygląd, a nie identyczna zamrożona mina w każdej wiadomości. Postać stale wysyłająca ten sam uśmiech może wydawać się mniej responsywna, nawet jeśli jej twarz jest stabilna.
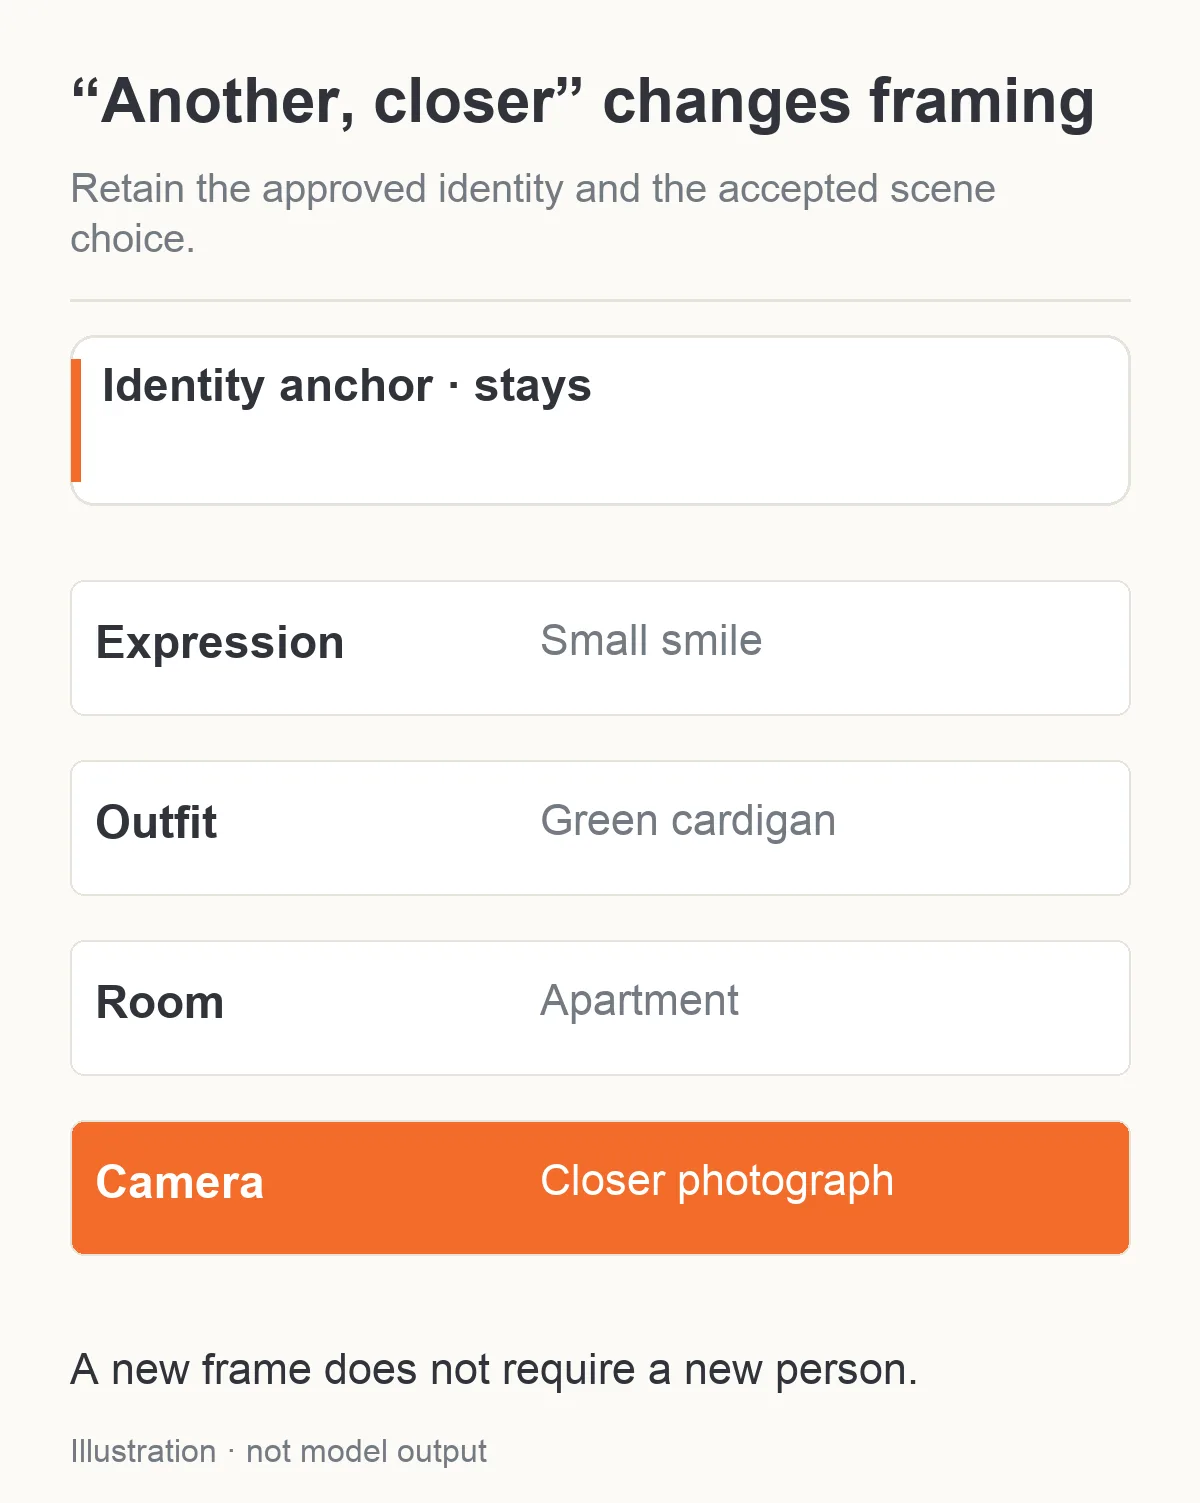
Ilustracja: kolejne bliższe zdjęcie zmienia kadr, zachowując zaakceptowaną scenę i postać.
Nie wplataj odrzuconego lub złagodzonego wyniku NSFW w fikcję rozmowy
Model czatu dla dorosłych i edytor obrazu to osobne wybory. Postać może odpowiadać w rozmowie dla dorosłych, podczas gdy wybrane zadanie obrazu odmawia stworzenia żądanego obrazu lub go zmienia. Nie traktuj udanej odpowiedzi czatu jako dowodu, że obraz ją zrealizuje.
Jeśli zwrócone zdjęcie jest łagodniejsze niż zamówione, nie ogłaszaj po cichu pełnej zgodności z prośbą. Daj uczciwy wybór: zaakceptować dostępną wersję, poprawić scenę albo użyć innego odpowiedniego zadania obrazu. Nie przechodź automatycznie na inny model i nie wydawaj więcej bez uzgodnionego w produkcie zakresu ponownych prób.
Oddziel też błędy wizualne od obsługi treści. Niewłaściwy kardigan to błąd sceny. Inna twarz to błąd tożsamości. Prośba niewykonalna przez wybrane zadanie to niedopasowanie zadania i treści. Wysłanie tego samego długiego promptu trzy razy więcej nie rozwiązuje wszystkich trzech problemów.
W początkowym zestawie postaci użyj fikcyjnych osób dorosłych i zatwierdzonych zasobów. Przesłane zdjęcie innej rzeczywistej osoby nie jest automatycznie zgodą na tworzenie jej obrazów jako dorosłej postaci. W produkcie z towarzyszami dla dorosłych jasno określ zatwierdzone zasoby tożsamości i osoby uprawnione do ich używania; wygenerowany czat nie powinien decydować o tych prawach.
Prompty SFW z artykułu przydają się do testowania tłumaczenia sceny na obraz bez generowania wrażliwych zdjęć. Nie ustalają zmierzonego wskaźnika akceptacji NSFW. Oceniając stronę dla dorosłych, używaj dowodów dla dokładnego zadania i kategorii sceny, które zamierzasz oferować, zamiast polegać na nazwie rodziny lub marketingu innej platformy.
Planuj budżet na zdjęcia, o które użytkownik rzeczywiście prosi
W podanej konfiguracji Qwen dziesięć selfie z jedną referencją kosztuje $0.36 za generowanie obrazów. Dziesięć z dwiema referencjami kosztuje $0.48. Jeśli dwa wyniki z jedną referencją wymagają świadomych nowych prób, dodają $0.072. Tokeny czatu, przechowywanie i inne usługi są oddzielne od tych kwot za obrazy.
Uzasadnia to konkretnie dobór referencji. Opis mieszkania słowami zamiast drugiego obrazu pokoju oszczędza $0.012 na żądanie w tej konfiguracji, ale oszczędność może nie mieć sensu, jeśli stały pokój jest kluczowy dla produktu. Dodawaj źródło, kiedy wnosi coś widocznego, zamiast dołączać je z przyzwyczajenia do każdego żądania.
Nie opisuj ponownej próby przy niższej rozdzielczości jako bezpłatnej. Użyj rzeczywistej wyceny wybranej konfiguracji. Zmiana rozdzielczości to nowy wybór generowania; nie zamienia poprzedniego pliku w ten sam obraz z dodatkowym detalem.
Prosta reguła produktu może obejmować jeden zamówiony obraz i jasno ograniczoną liczbę poprawek w wybranym przez użytkownika zakresie. Pobranie istniejącego zdjęcia powinno pobrać zasób, a nie ponownie wysłać oryginalny prompt. Jeśli użytkownik zmienia strój lub miejsce, pokaż to jako nowe zdjęcie, a nie naprawę dawnej prośby.
Napraw błąd na poziomie, który go wprowadził
| Co widzi użytkownik | Co sprawdzić najpierw | Przydatna następna zmiana |
|---|---|---|
| Nowe włosy po swobodnej rozmowie | Czy hipotetyczna rozmowa trafiła do stałego wyglądu? | Przywróć zatwierdzony rekord tożsamości; wymagaj świadomej zmiany wyglądu |
| Niewłaściwy strój | Który wybór ubrania wskazało słowo „ten”? | Ustal wskazane ubranie przed przepisaniem promptu |
| Prawidłowa twarz, przypadkowy pokój | Czy pokój był opisany tylko ogólnie? | Nazwij widoczne charakterystyczne elementy lub dodaj jedną referencję pustego pokoju |
| Reklama mody zamiast selfie | Czy prompt stylu dodał język studia lub kampanii? | Użyj zwykłego światła we wnętrzu i swobodnego kadru z telefonu |
| Inna twarz w późniejszych zdjęciach | Czy najnowszy wynik zastąpił punkt odniesienia? | Wróć do oryginalnego zatwierdzonego portretu |
| Dawna scena przychodzi po zmianie dokonanej przez użytkownika | Który zapis sceny wykorzystało zaakceptowane zadanie? | Oznacz lub wstrzymaj nieaktualny wynik; nie nazywaj go najnowszą prośbą |
Deweloper może sprawdzić cały przepływ trzema prośbami SFW: pierwsze selfie w mieszkaniu, „jeszcze jedno, trochę bliżej” i „ten sam kardigan, inny pokój”. Zanim zapłacisz za szerokie wdrożenie funkcji, sprawdź, czy mechanizm zachowuje właściwą tożsamość, zmienia tylko zamówione elementy i ujawnia niepewność. To błędy, które ten proces ma ograniczać.
Następny praktyczny krok to jeden zatwierdzony portret dorosłej postaci, jeden prosty pokój i jedna konkretna prośba o zdjęcie. Najpierw doprowadź tę fotografię do spójności, zanim dodasz automatyczne zmiany sceny, wiele osób lub bardziej rozbudowane wybory treści dla dorosłych. Selfie towarzysza działa, kiedy użytkownik rozpoznaje osobę i moment, o który prosił.