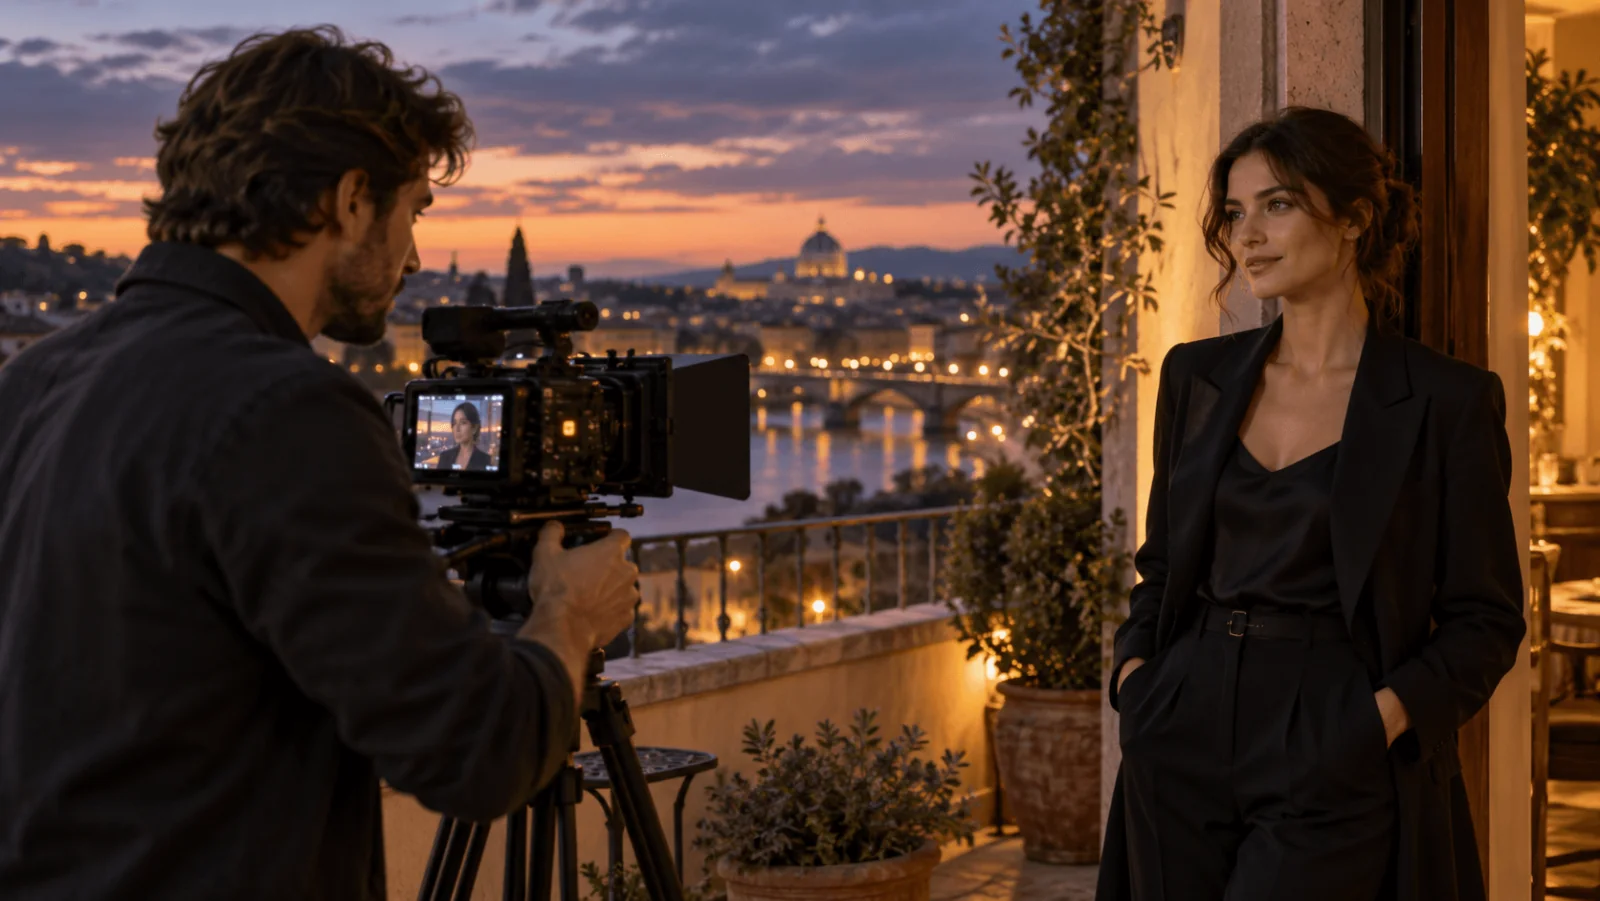
Zrób dwa ujęcia z jednego zatwierdzonego portretu: cichy, powolny najazd, a potem powolny ruch kamery w bok, który pokazuje otoczenie. Oba zacznij w MiniMax H3 obraz na wideo w 768p, pięć sekund, 0,185 $ za klip. Przejdź na Seedance 2.5, jeśli musisz wyłączyć ścieżkę dźwiękową albo potrzebujesz dłuższego materiału, a na LTX 2.5, jeśli materiał ma być dostarczony w 4K. Każde ujęcie dostaje jedną subtelną akcję, jeden powściągliwy ruch kamery i listę rzeczy, których zmieniać nie wolno.
Wybierz trasę
| Potrzeba | Trasa | Ustawienia początkowe | Pięć sekund |
|---|---|---|---|
| Najtańsza użyteczna wersja robocza | MiniMax H3 | resolution: "768p"; 4–15 s | 0,185 $ |
| Ścieżka dźwiękowa, którą można wyłączyć, albo klipy do 30 s | Seedance 2.5 | resolution: "720p", generate_audio: false; 4–30 s | 1,3865 $ |
| Dostawa w 4K do 20 s | LTX 2.5 | resolution: "4k"; 5–20 s | 1,50 $ |
Wszystkie ceny są za pięciosekundowy klip. LTX w 720p kosztuje 0,45 $, więc płać za 4K tylko wtedy, gdy wymaga tego dostawa. Seedance kosztuje tyle samo przy włączonym i wyłączonym dźwięku.
Trzy rzeczy, których tabela nie pokazuje:
- Dźwięk. H3 i LTX zawsze zwracają wygenerowaną ścieżkę dźwiękową i nie mają pola, żeby ją wyłączyć. Seedance to jedyna trasa z przełącznikiem
generate_audio. - Kształt kadru. Żaden z tych trzech nie pozwala wybrać proporcji obrazu na wideo. Wynik przyjmuje kształt obrazu źródłowego, więc przed wgraniem przytnij portret albo go rozszerz do docelowego formatu.
- Projekty z treściami dla dorosłych. Wszystkie trzy przyjmują fikcyjny obraz źródłowy z osobami dorosłymi. Kontrola wejścia Seedance może odrzucić zdjęcia prawdziwych, rozpoznawalnych osób (nic nie zostaje pobrane), więc używaj tam obrazów fikcyjnych albo z odpowiednimi prawami. Do bardziej wymagających zadań dla dorosłych są osobne trasy MiniMax H3 Spicy i Seedance 2.5 Spicy.
Wybierz źródło, które zostawia miejsce na ruch
Oba ujęcia zaczynają od tej samej zatwierdzonej nieruchomej klatki, więc twarz, ubranie i światło są na starcie identyczne; późniejsze kadry porównuj właśnie z nią. Wybierz taką, na której widać oczy, włosy mieszczą się w kadrze, a ramiona nie zlewają się z tłem. Zostaw pustą przestrzeń po stronie, w którą patrzy osoba: tam wzrok trafia w pierwszym ujęciu i tam kamera odsłania otoczenie w drugim.
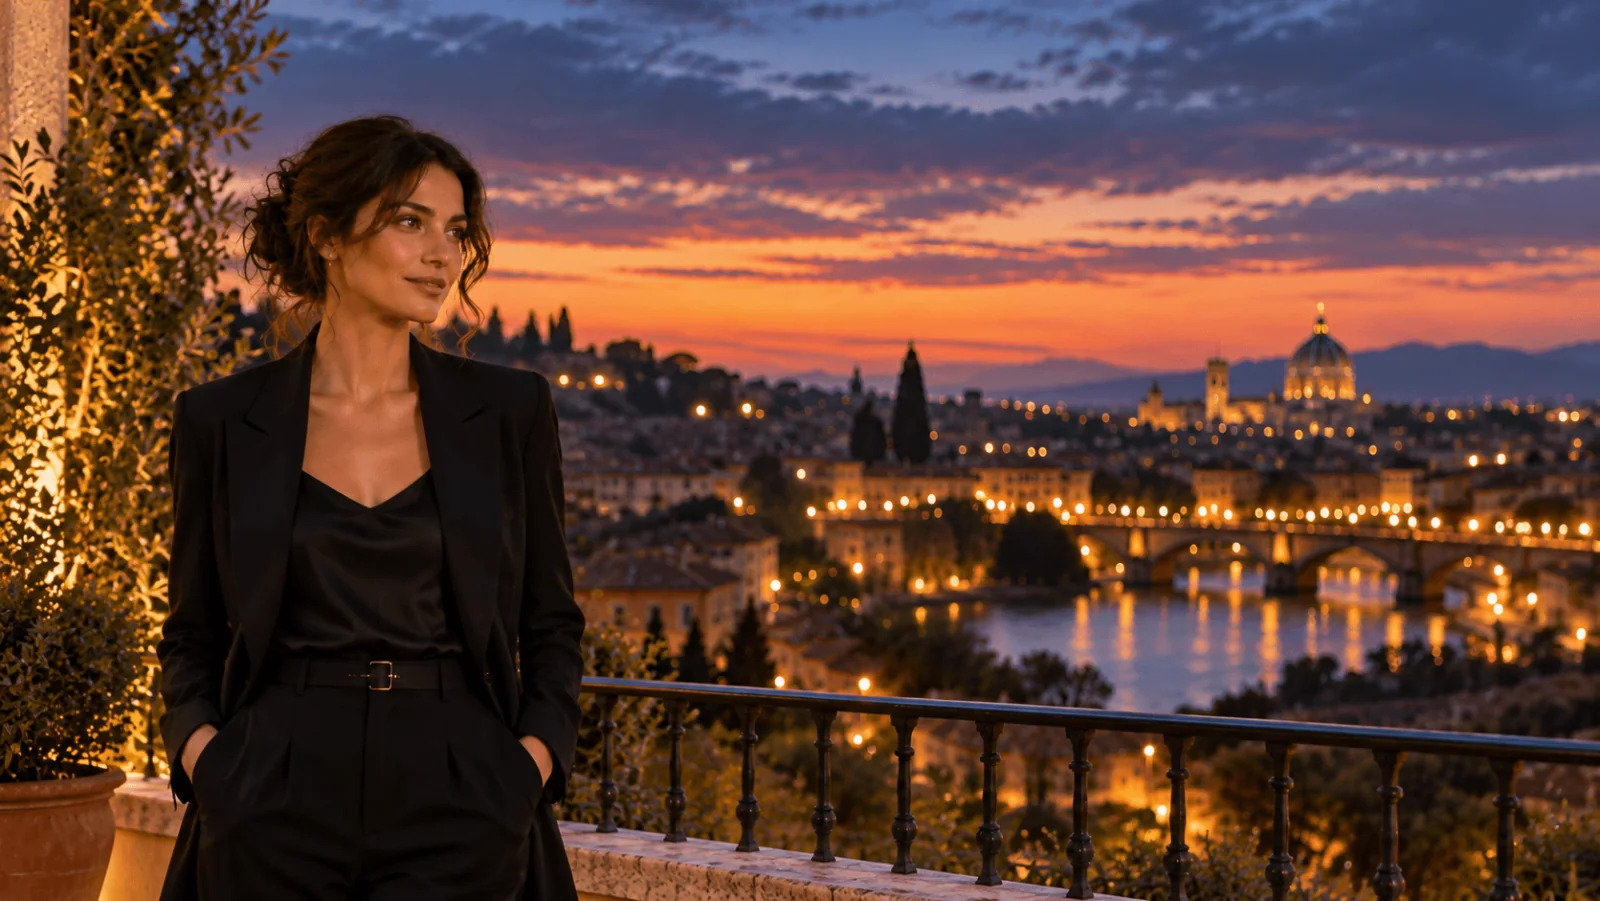
Naszym przykładem jest fikcyjna dorosła kobieta w czarnym żakiecie na satynowym topie, z rękami w kieszeniach, na tarasie nad rozświetlonym miastem nad rzeką o zmierzchu. Ciepłe światło pada na jej twarz z lewej, a ona patrzy w prawo, w pustą przestrzeń. Obraz zawiera już wszystko, czego potrzebuje wideo. Proszenie modelu o dodanie deszczu, zmianę płaszcza, obrót głowy i wymyślenie nowego miejsca w jednym klipie zamienia animację w przebudowę.
Rozmycie, podwojona biżuteria albo dłoń zlana z balustradą na nieruchomej klatce będą w ruchu tylko gorsze. Najpierw napraw nieruchomą klatkę. Trzymaj dłonie poza akcją; w tym źródle są w kieszeniach, więc nigdy nie muszą się ruszać.
Ujęcie pierwsze: cichy najazd
Dla prawdziwego zbliżenia przytnij przed wgraniem wersję tego samego zatwierdzonego zdjęcia od klatki piersi w górę, zgodnie z docelowymi proporcjami; sam najazd tylko ciaśniej kadruje ujęcie od bioder w górę. Opisuj wyłącznie ruch; zdjęcie już ustala, kto i gdzie jest. Każdy prompt nazywa jedną akcję osoby, jeden ruch kamery, co zostaje niezmienne i czego wykluczyć. Użyj tego promptu w MiniMax H3 z zatwierdzonym zdjęciem:
A restrained cinematic portrait of the adult woman in the supplied image. She remains in place, breathes naturally and blinks slowly, then makes one small eye movement toward the open space on screen right, followed by a subtle closed-mouth smile. Very slow camera push-in. Preserve her face, black blazer, hairstyle and the warm terrace light. No head turn, no walking, no new objects or text. No speech.
Wypróbuj w Playground
- Otwórz MiniMax H3 obraz na wideo z wpisanym promptem (albo otwórz stronę i wklej prompt w Prompt). Zostań w zakładce Playground, w widoku Form, i zaloguj się kontem z dodatnim saldem, aby uruchomić zadanie.
- Dodaj zatwierdzone zdjęcie w polu Input image.
- Ustaw Resolution na 768p, a Duration na 5.
- Uruchom zadanie, a potem powtórz je z promptem drugiego ujęcia na tym samym zdjęciu.
Najazd dodaje ruch, nie pokazując nowej strony twarzy. Jeśli oczy lub szczęka i tak się zmieniają, usuń go: poproś o unieruchomioną kamerę, oddech i jedno mrugnięcie.
Ujęcie drugie: powolny przesuw pokazujący otoczenie
Drugie ujęcie ma inne zadanie. Twarz zostaje spokojna, a kamera odsłania panoramę miasta. Balustrada na pierwszym planie, kobieta pośrodku i rozświetlone miasto za nią dają trzy warstwy, które przesuwają się względem siebie podczas ruchu w bok — i to sprawia, że materiał czyta się jako ruch kamery, a nie jako przybliżenie.
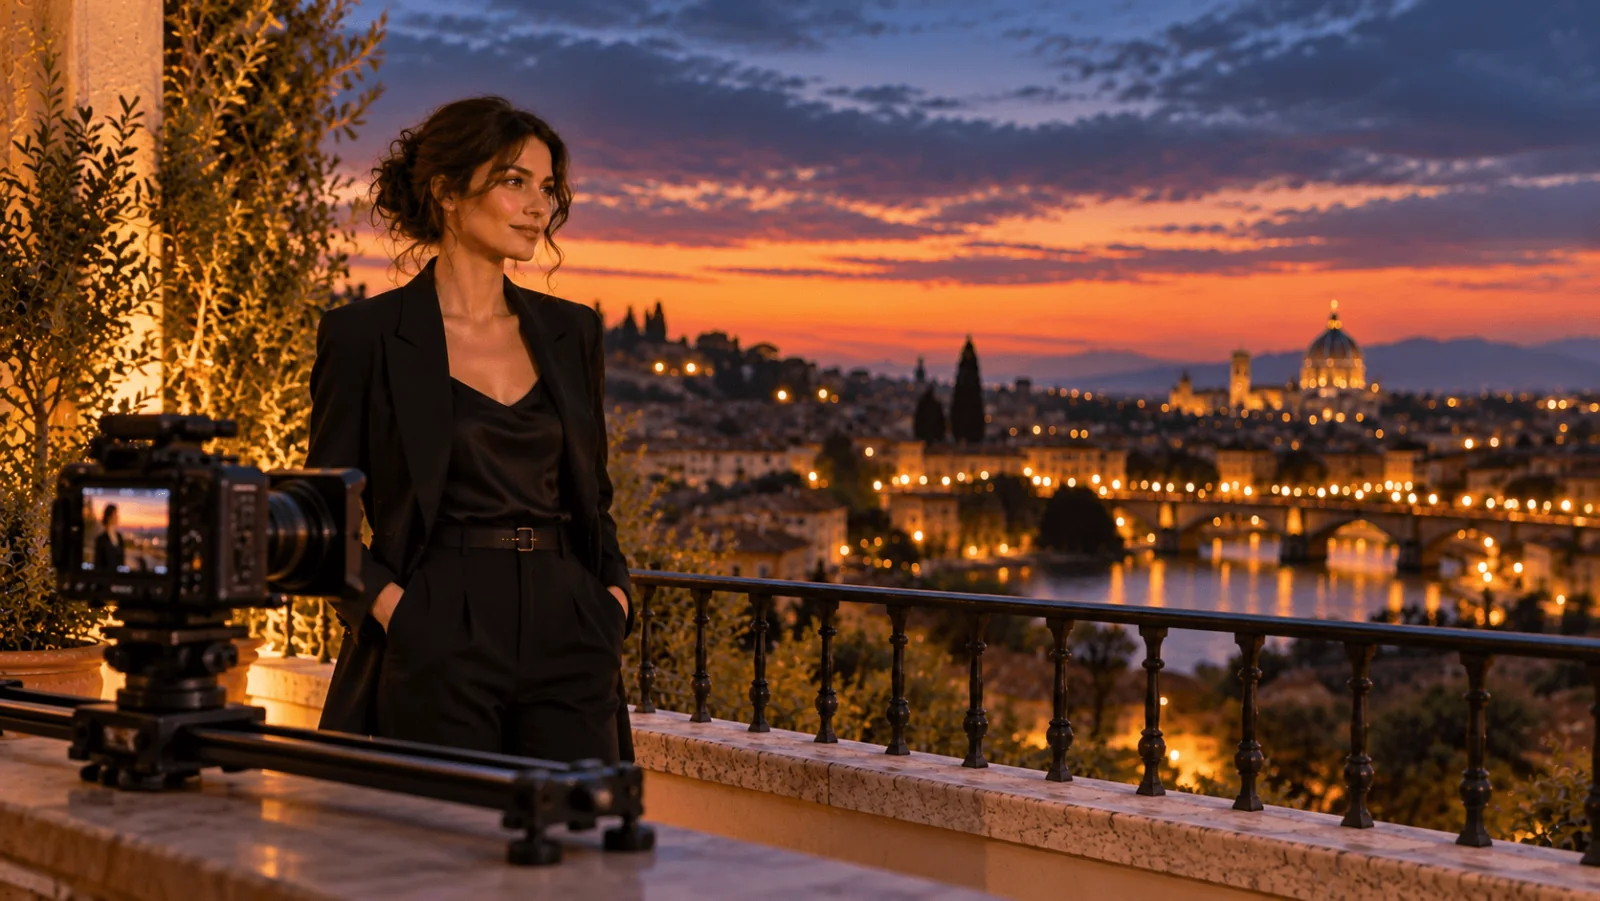
Użyj tego samego źródła i tych samych ustawień:
A medium portrait of the adult woman from the supplied image on the same dusk terrace. The camera slides slowly and steadily a short distance to the right along the railing, revealing more of the lit city on screen right. She stays in frame, holds her pose and shifts her gaze slightly toward the city lights. Keep her face, black blazer and hairstyle unchanged, and the warm light constant. No orbit, no walking, no speech, no text.
Nazwij to, co ruch odsłania, a nie tylko jego nazwę. Jeśli kierunek kamery dezorientuje model, uprość do zdania „obok jej prawego ramienia widać trochę więcej miasta”.
Nie proś z tego źródła o obrót kamery wokół postaci ani o pełny profil. Pokazuje ono ujęcie trzy-czwarte, a ruch w stronę drugiego policzka wymaga drugiego zatwierdzonego zdjęcia.
Wywołaj to z kodu
Zainstaluj Python SDK (pip install spicyapi), ustaw SPICY_API_KEY i uruchom pierwsze ujęcie z zatwierdzonego zdjęcia. Kosztuje 0,185 $:
import uuid

from spicyapi import SpicyClient, output_assets

client = SpicyClient()
still = client.upload_file("./approved-still.png")  # local file -> spicy:// address
task = client.create_task(
    model="minimax/h3/image-to-video",
    input_data={
        "image_url": still["uri"],
        "prompt": (
            "A restrained cinematic portrait of the adult woman in the supplied image. "
            "She remains in place, breathes naturally and blinks slowly, then makes one small "
            "eye movement toward the open space on screen right, followed by a subtle "
            "closed-mouth smile. Very slow camera push-in. Preserve her face, black blazer, "
            "hairstyle and the warm terrace light. No head turn, no walking, no new objects "
            "or text. No speech."
        ),
        "resolution": "768p",
        "duration_seconds": 5,
    },
    idempotency_key=str(uuid.uuid4()),  # new key per new request; reuse only to retry the same one
)
final = client.wait_for_terminal(task["taskId"])
print(output_assets(final)[0]["url"])
Do drugiego ujęcia podmień prompt na prompt przesuwu. Wgrywanie, oczekiwanie i błędy: referencja Python SDK.
Albo niech uruchomi to agent
Gdy klipy ma wygenerować asystent, oficjalne narzędzia pokazują cenę i pytają przed płatnym wywołaniem.
- CLI.
spicyapi files upload ./approved-still.png, potemspicyapi tasks create --model minimax/h3/image-to-video --input-file input.json --waitz otrzymanym adresemspicy://jakoimage_urlwinput.json.npx @spicyapi/clidziała bez instalacji; zobacz dokumentację CLI. - Serwer MCP. Dodaj serwer MCP i poproś o najazd na swoim zdjęciu. Asystent wgrywa plik przez
spicyapi_upload_file, wywołujespicyapi_task_create(zatrzymuje się na potwierdzenie ceny), a następniespicyapi_task_wait. - Skill.
npx skills add spicyapi-ai/spicy-skillinstaluje Agent Skill, dzięki czemu asystent programistyczny czyta aktualny schemat modelu zamiast zgadywać nazwy pól.
Sklej oba klipy
Postaw najazd pierwszy, przesuw drugi. Zakończ pierwsze ujęcie spojrzeniem w prawo kadru, a drugie zacznij z nią już patrzącą w tamtą stronę, żeby cięcie wypadło na tej samej osi wzroku. Wykorzystaj najczystsze dwie do trzech sekund każdego materiału, a nie całe pięć.
Zostaw jedną ścieżkę dźwiękową. Jeśli używasz H3 albo LTX, wycisz własny dźwięk klipów i podłóż pod niego jedną ścieżkę muzyczną albo atmosferę. W Seedance wyłącz wygenerowany dźwięk i zrób to samo. Jeśli chcesz osobną atmosferę dla każdego ujęcia, użyj Seedance z włączonym dźwiękiem generowanym i zdaniem w rodzaju „quiet distant street ambience, no speech”.
Wszystkie trzy trasy przyjmują też opcjonalną klatkę końcową. Pomaga, gdy klip ma trafić dokładnie na konkretny zatwierdzony obraz, ale im dłuższy klip, tym bardziej od niego odchodzi, więc w pierwszych wersjach roboczych pomiń ją.
Naprawiaj tylko to, co się nie udało
| Widoczny problem | Następny krok |
|---|---|
| Oczy lub szczęka zmieniają się przy najeździe | Wróć do pierwotnego zdjęcia; zastąp najazd unieruchomioną kamerą i jednym mrugnięciem. |
| Uśmiech pokazuje niestabilne zęby | Poproś o subtelny uśmiech z zamkniętymi ustami i usuń mowę. |
| Włosy pełzają po policzku | Usuń wiatr i ruch głowy; zostaw samo oddychanie. |
| Twarz wychodzi z kadru | Dodaj miejsce w źródle przed wygenerowaniem; model nie ma pola proporcji, żeby to naprawić. |
| Balustrada lub znaki wyginają się przy przesuwie | Spowolnij i skróć ruch albo wytnij znak ze źródła; napisy nie są zachowywane wiarygodnie. |
| Oba klipy różnią się jasnością lub barwą | Wygeneruj słabszy ponownie z tego samego zdjęcia; nie podmieniaj nowego źródła. |
| Jedna sekunda jest świetna, reszta odpływa | Wytnij wokół stabilnego odcinka i użyj go jako krótkiej wstawki. |
Cztery pięciosekundowe wersje robocze H3 kosztują 0,74 $, więc dwa ujęcia po cztery wersje to 1,48 $. Dwie stabilne sekundy z jednej wersji mogą już wystarczyć do cięcia. W Seedance 2.5 i LTX 2.5 ustaw seed i zmieniaj wyłącznie prompt, żeby widzieć, co zmieniła poprawka; nie gwarantuje to identycznego klipu. H3 nie ma ustawienia seed: zachowaj wygrywający prompt w tej postaci i wylosuj ponownie.