Wprowadzenie
FLUX.1 Dev LoRA Tekst na obraz tworzy jeden obraz z opisu tekstowego w FLUX.1 [dev] od Black Forest Labs, rectified flow transformerze z 12 miliardami parametrów, z maksymalnie trzema własnymi plikami LoRA. Wybierz dowolną z dziewięciu proporcji obrazu przy około jednym megapikselu, ustaw guidance i odbierz JPEG, PNG lub WebP w jednej stałej cenie. Platforma nie dodaje żadnego filtra treści do promptu, wag ani obrazu.
Wybierz tryb według materiału wyjściowego
| Co masz | Tryb |
|---|---|
| opis tekstowy i LoRA do FLUX | FLUX.1 Dev LoRA Tekst na obraz |
| obraz, któremu chcesz nadać nowy styl | FLUX.1 Dev LoRA Edycja obrazu |
Najważniejsze funkcje
Największa biblioteka LoRA wśród otwartych modeli obrazu
Hugging Face oferuje ponad tysiąc LoRA opartych na FLUX.1 [dev]: realizm, moda, filmowe looki, kreskówki, postaci i style bez filtra. Jeśli jakiś wygląd wpadł ci w oko, najpewniej jest to LoRA do FLUX, a tutaj działa ona jako zwykłe wywołanie API.
Regulowane guidance
Guidance określa, jak ściśle obraz trzyma się promptu, w zakresie od 0 do 20. Domyślne 3,5 pasuje do większości LoRA, a LoRA realizmu często wyglądają naturalniej nieco niżej.
Bez cenzury, z własnymi wagami
Wagi nigdy nie przechodzą weryfikacji, a wynik nigdy nie jest filtrowany. W naszych testach LoRA bez filtra zostały wyrenderowane, ale na najwyższym testowanym poziomie model we wszystkich trzech próbach powstrzymywał część sceny.
Parametry żądania
| Parametr | Wymagane | Uwaga |
|---|---|---|
prompt | Tak | Zacznij od frazy wyzwalającej LoRA, a potem opisz postać, otoczenie i światło pełnymi zdaniami. FLUX dobrze radzi sobie z długimi, konkretnymi promptami. od 1 znaków · do 5000 znaków |
aspect_ratio | Nie | Dziewięć opcji od 21:9 do 9:21, wszystkie przy około jednym megapikselu i wszystkie w tej samej cenie. |
loras | Nie | Do trzech wpisów {path, scale} wytrenowanych pod FLUX.1 [dev]; scale od 0 do 4, 1 jest neutralne. Mocne LoRA stylu mogą potrzebować nieco więcej niż 1. Domyślnie: |
guidance_scale | Nie | Jak ściśle trzymać się promptu, od 0 do 20. Domyślne 3,5 pasuje do większości LoRA; LoRA realizmu często wyglądają lepiej nieco niżej. |
steps | Nie | Liczba kroków odszumiania, od 1 do 50 (domyślnie 28). Więcej kroków oznacza dłuższe generowanie. |
output_format | Nie | Domyślnie JPEG; PNG lub WebP, jeśli ich potrzebujesz. Nie wpływa na cenę. |
seed | Nie | Utrzymuje porównywalność zestawu obrazów, gdy regulujesz guidance lub scale jednej LoRA. |
Cennik
$0.018 / obraz
Rozliczane za obraz w jednej stałej cenie dla każdej proporcji. Załadowanie LoRA nie generuje osobnej opłaty.
Zastosowania
Uruchom wypatrzoną LoRA
Wklej link do pobrania, ustaw scale, dodaj frazę wyzwalającą do promptu. Bez trenowania, bez hostingu i bez GPU: LoRA wypatrzona w serwisie z modelami staje się zwykłym wywołaniem API.
Kadry edytorialne i modowe
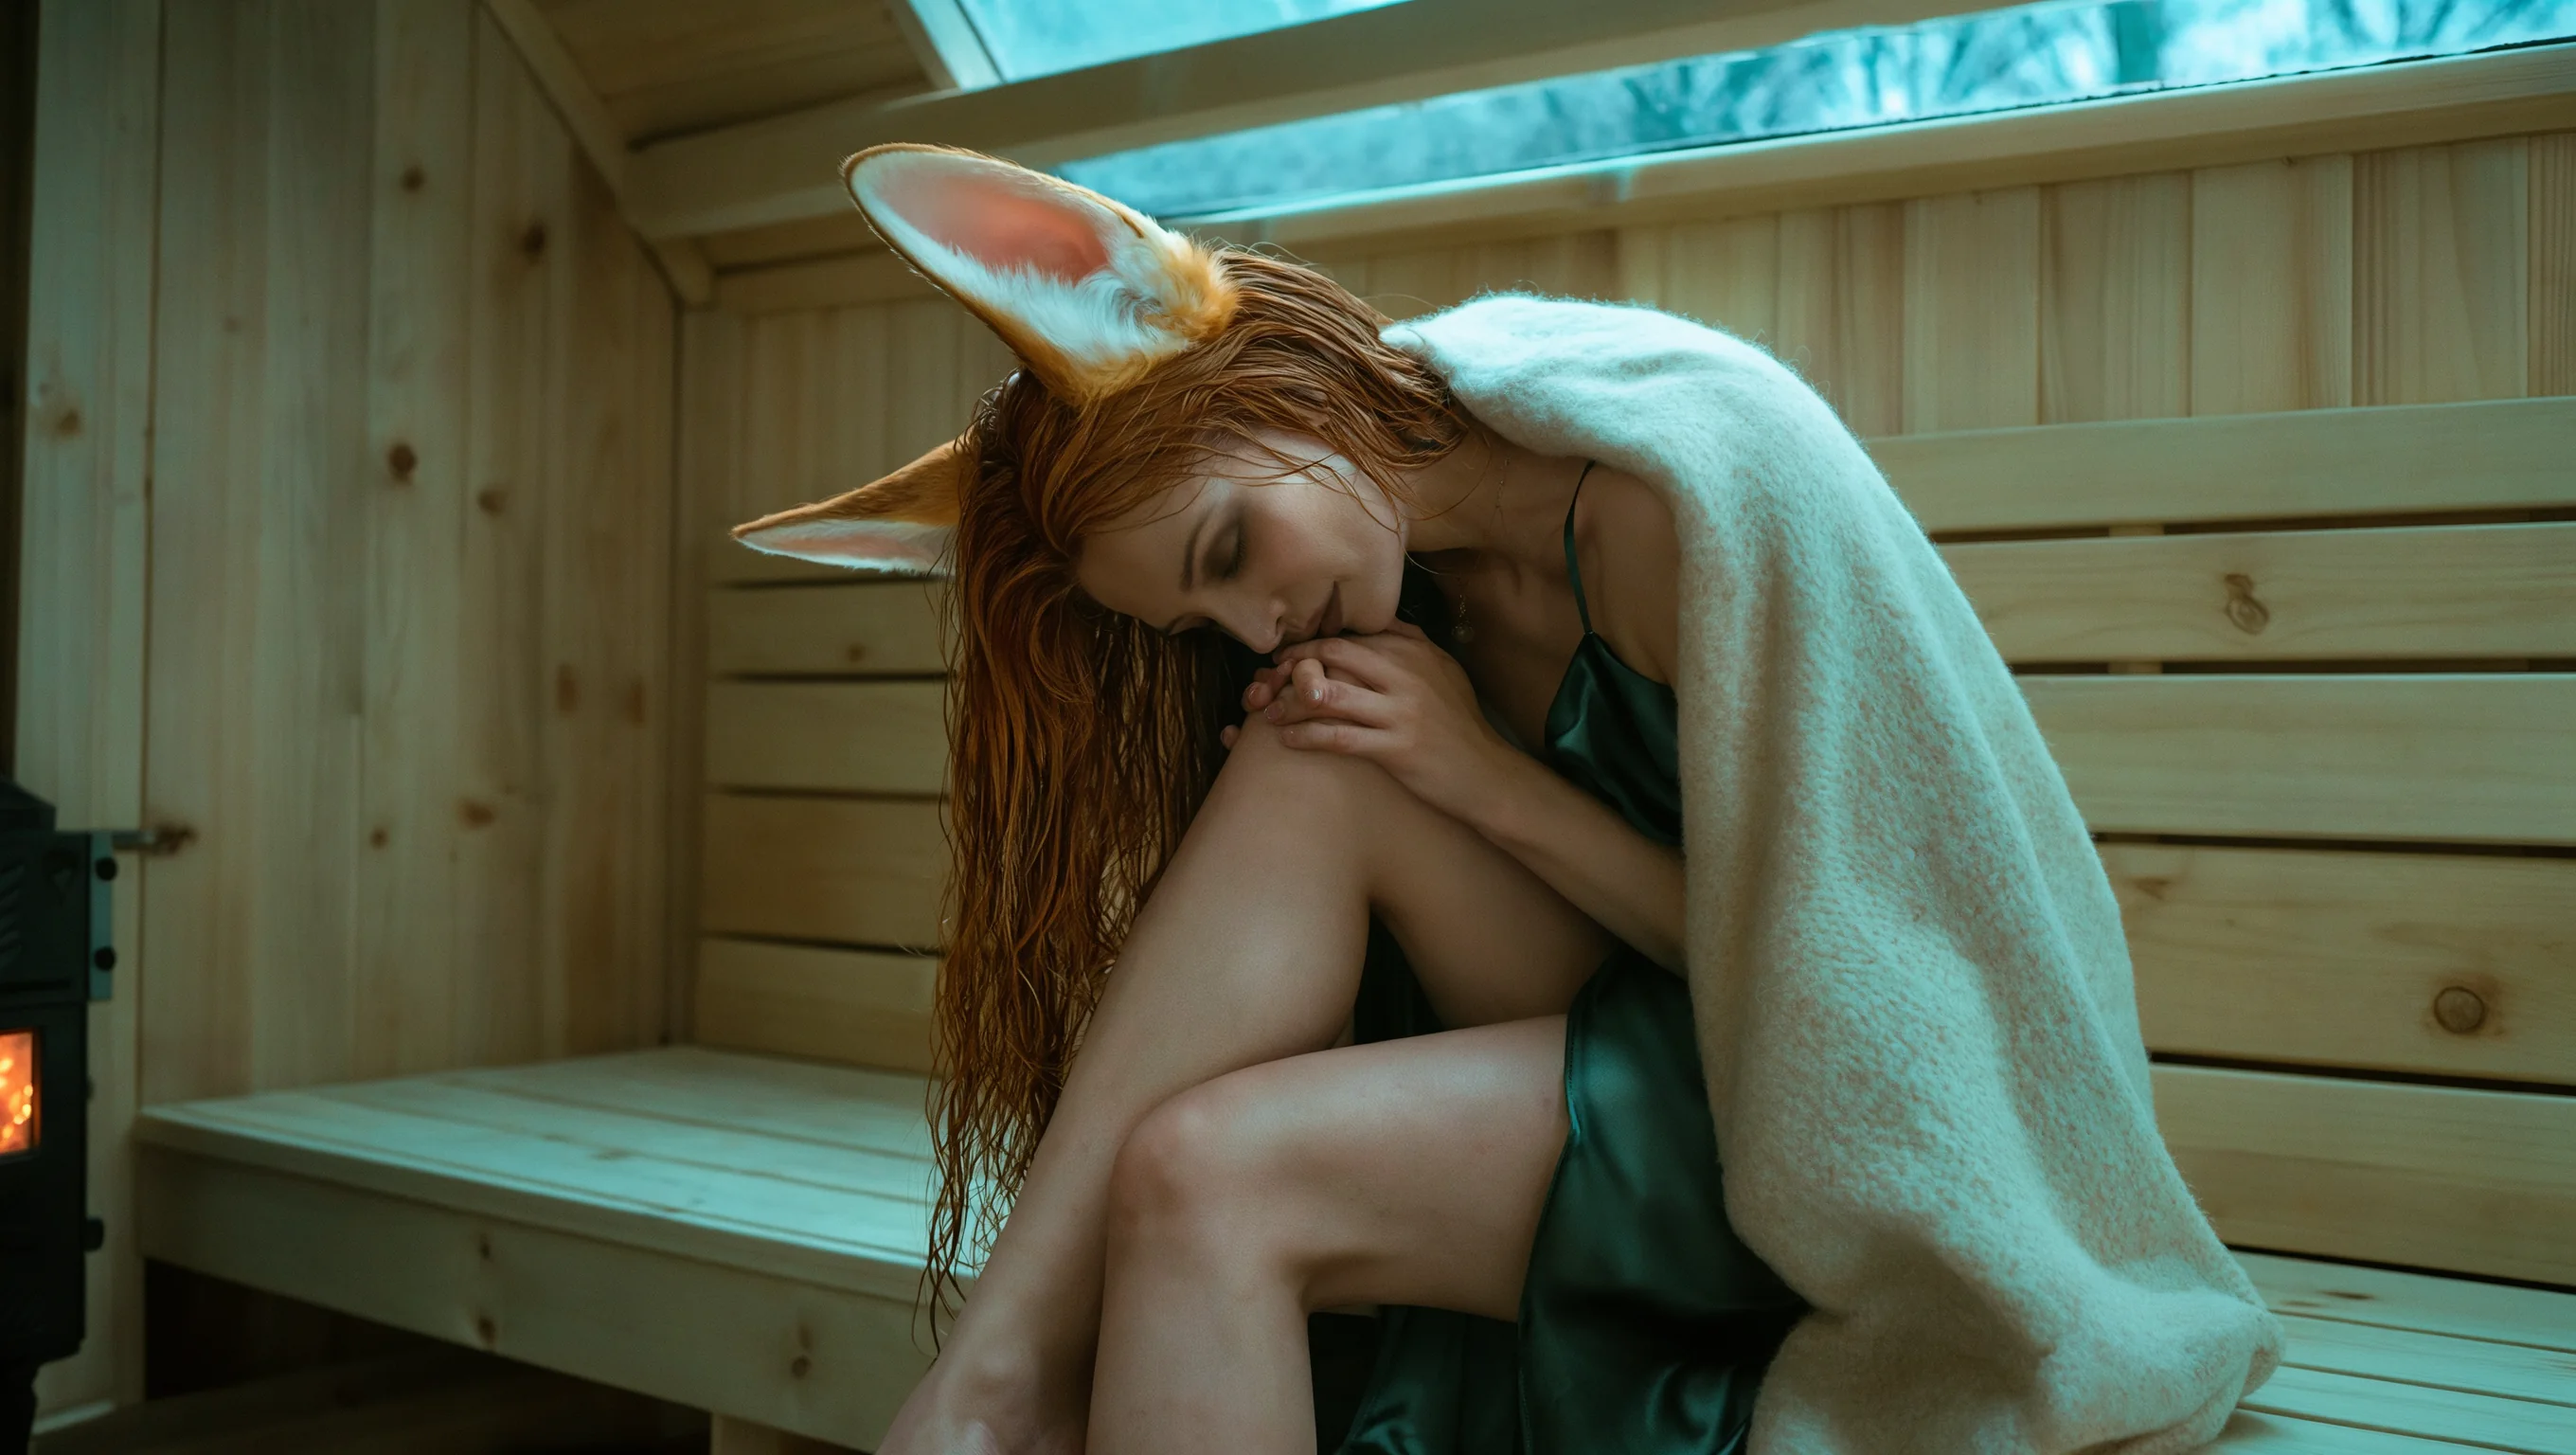
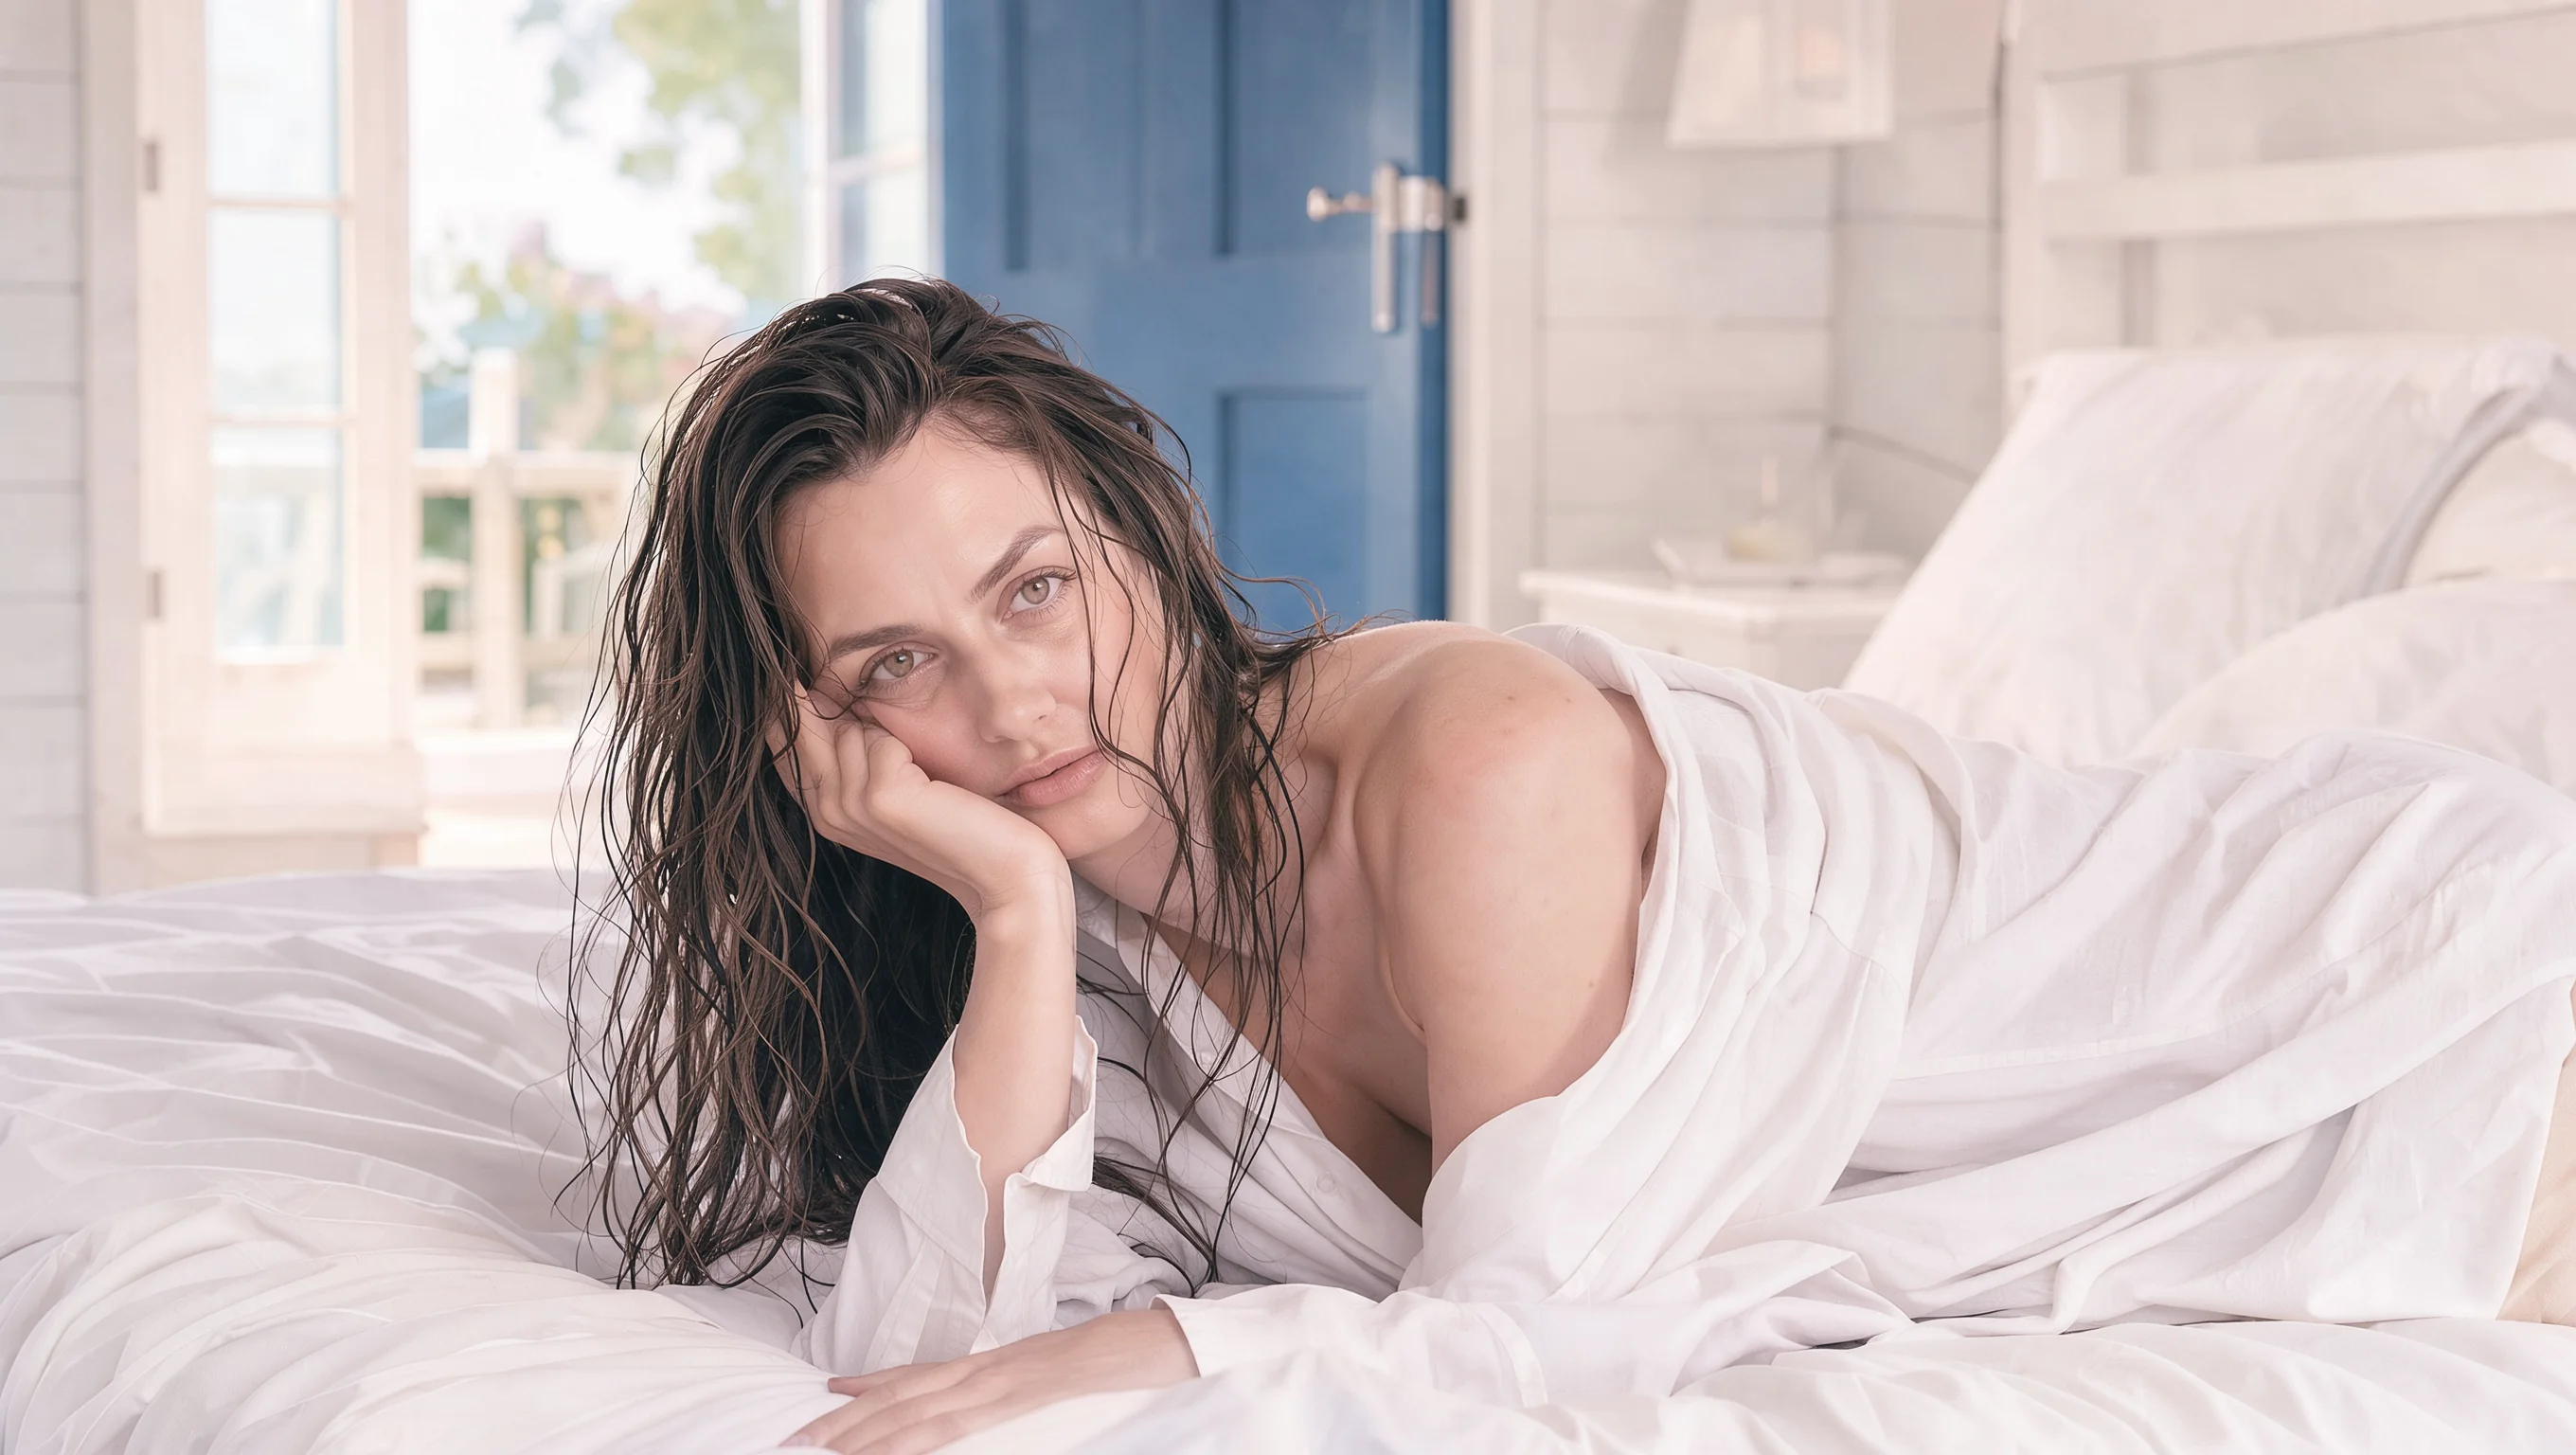
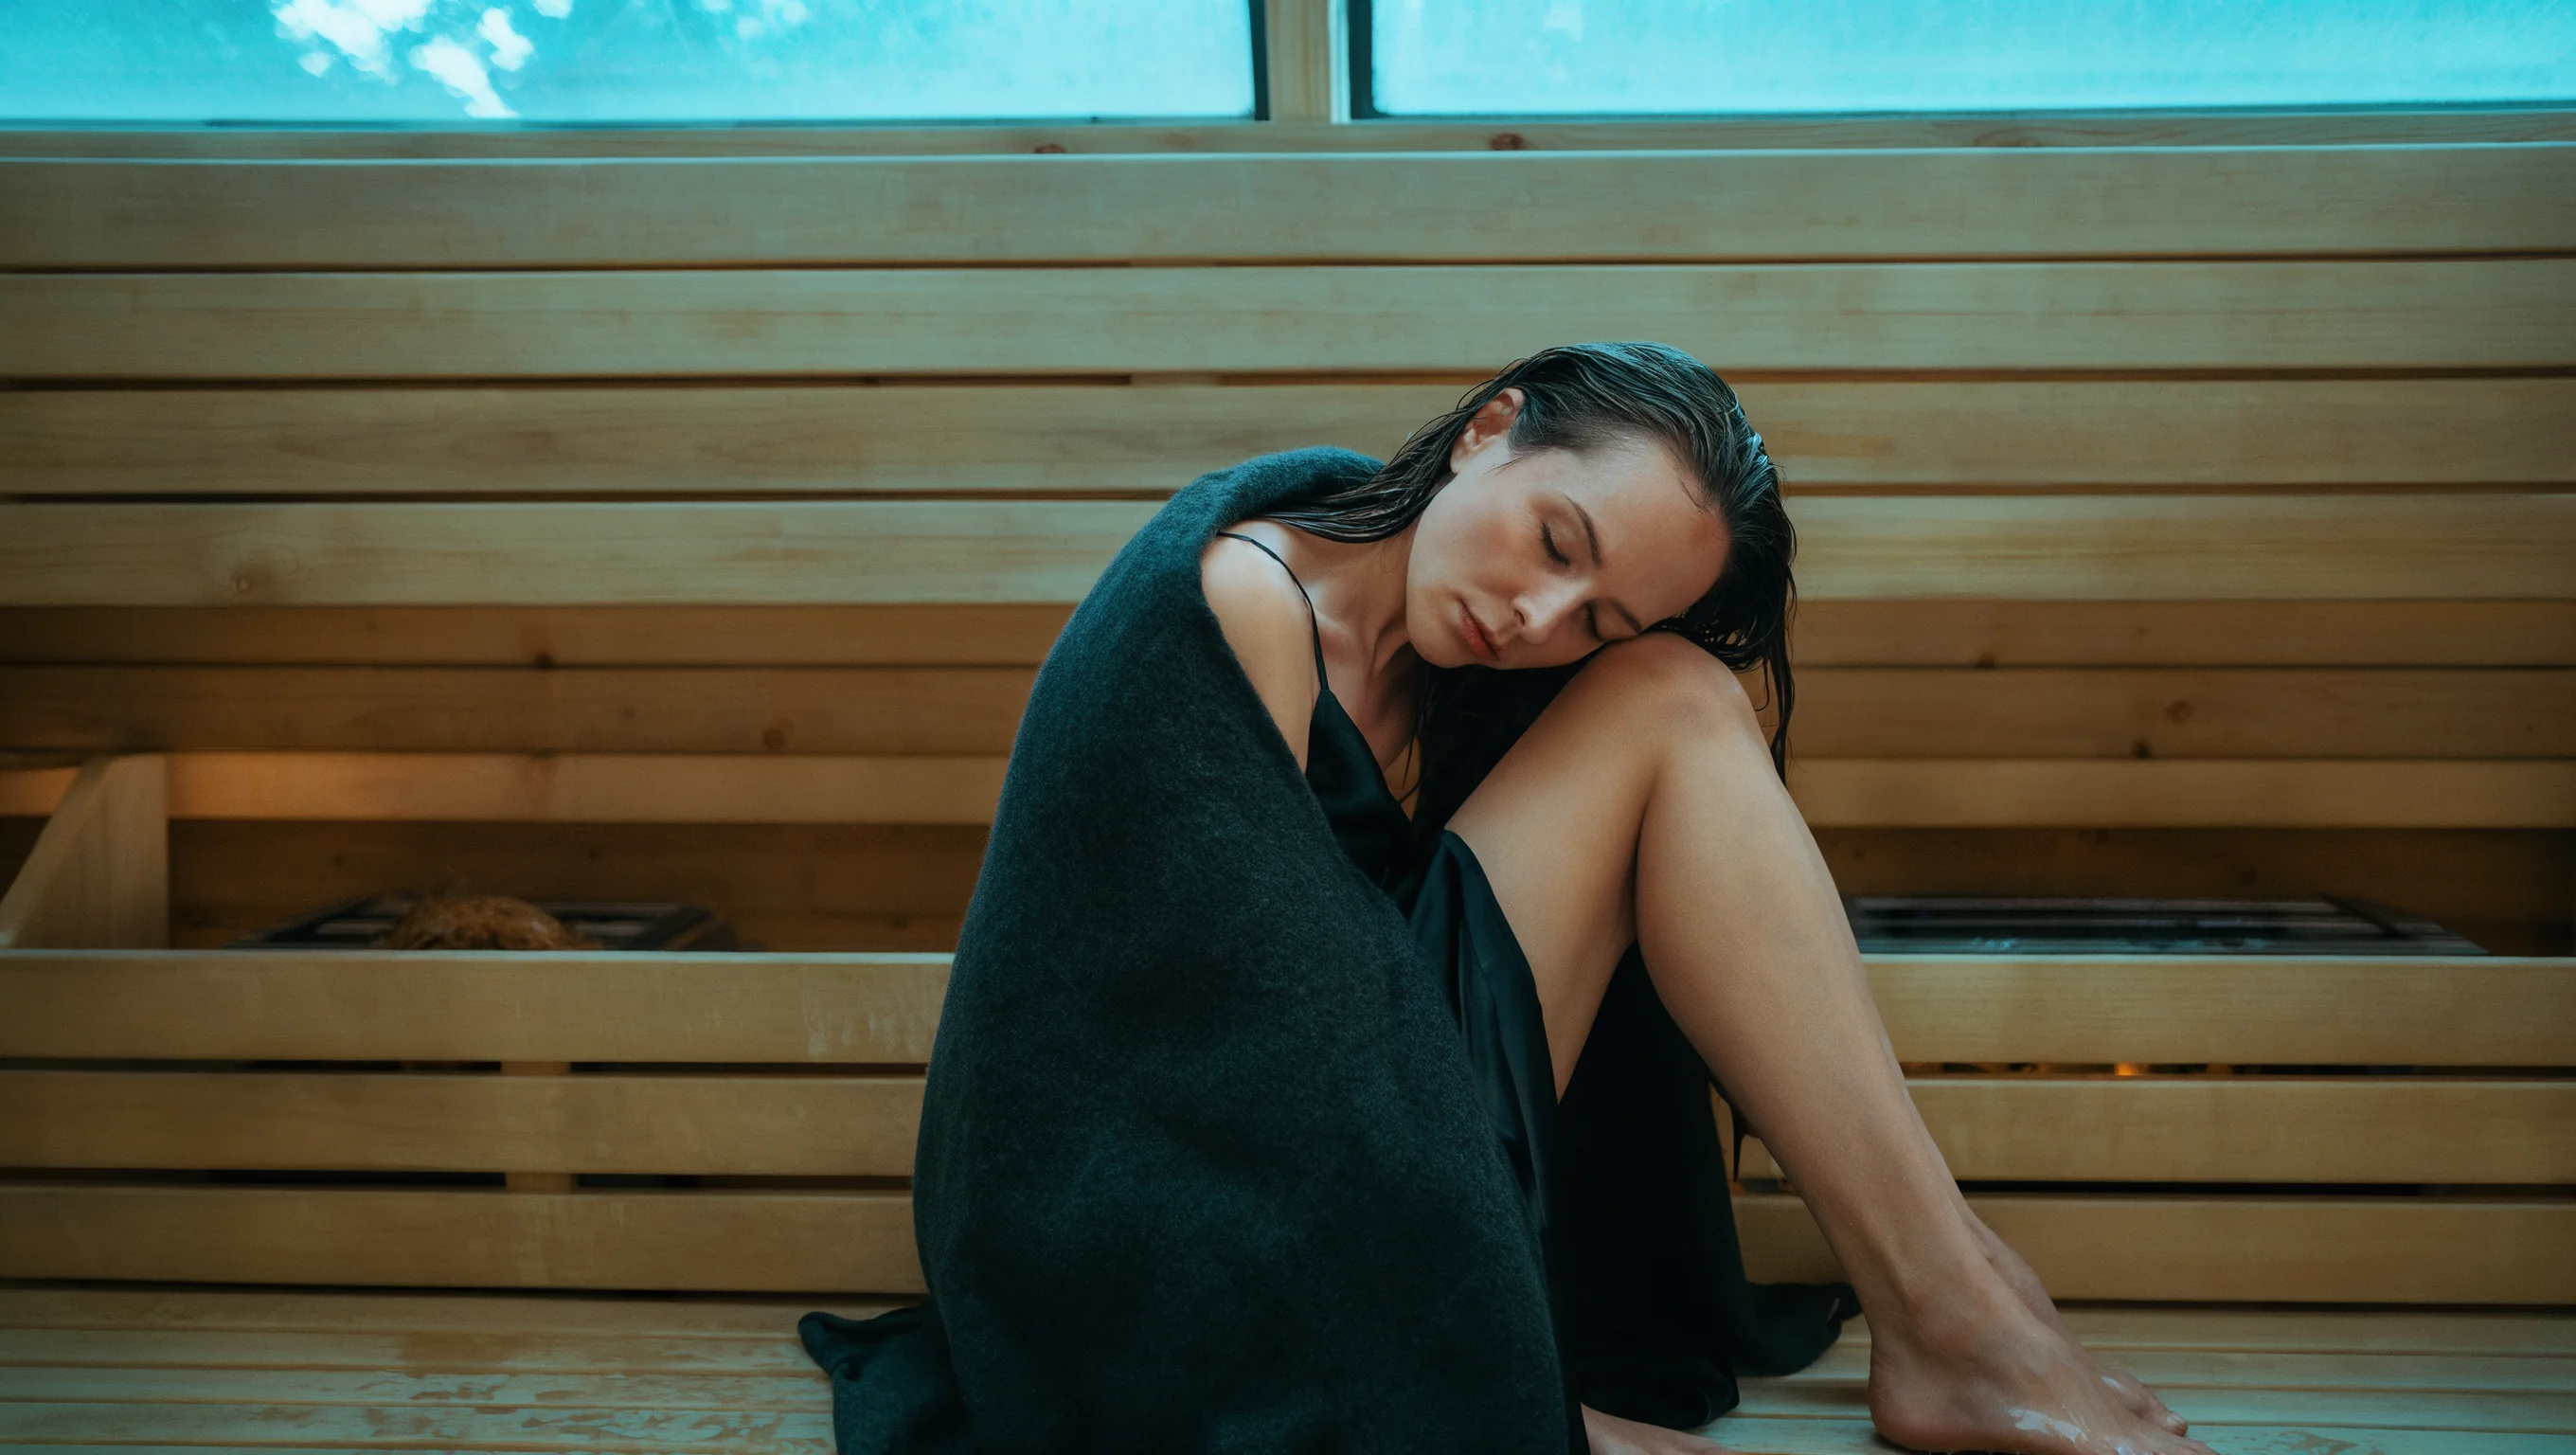
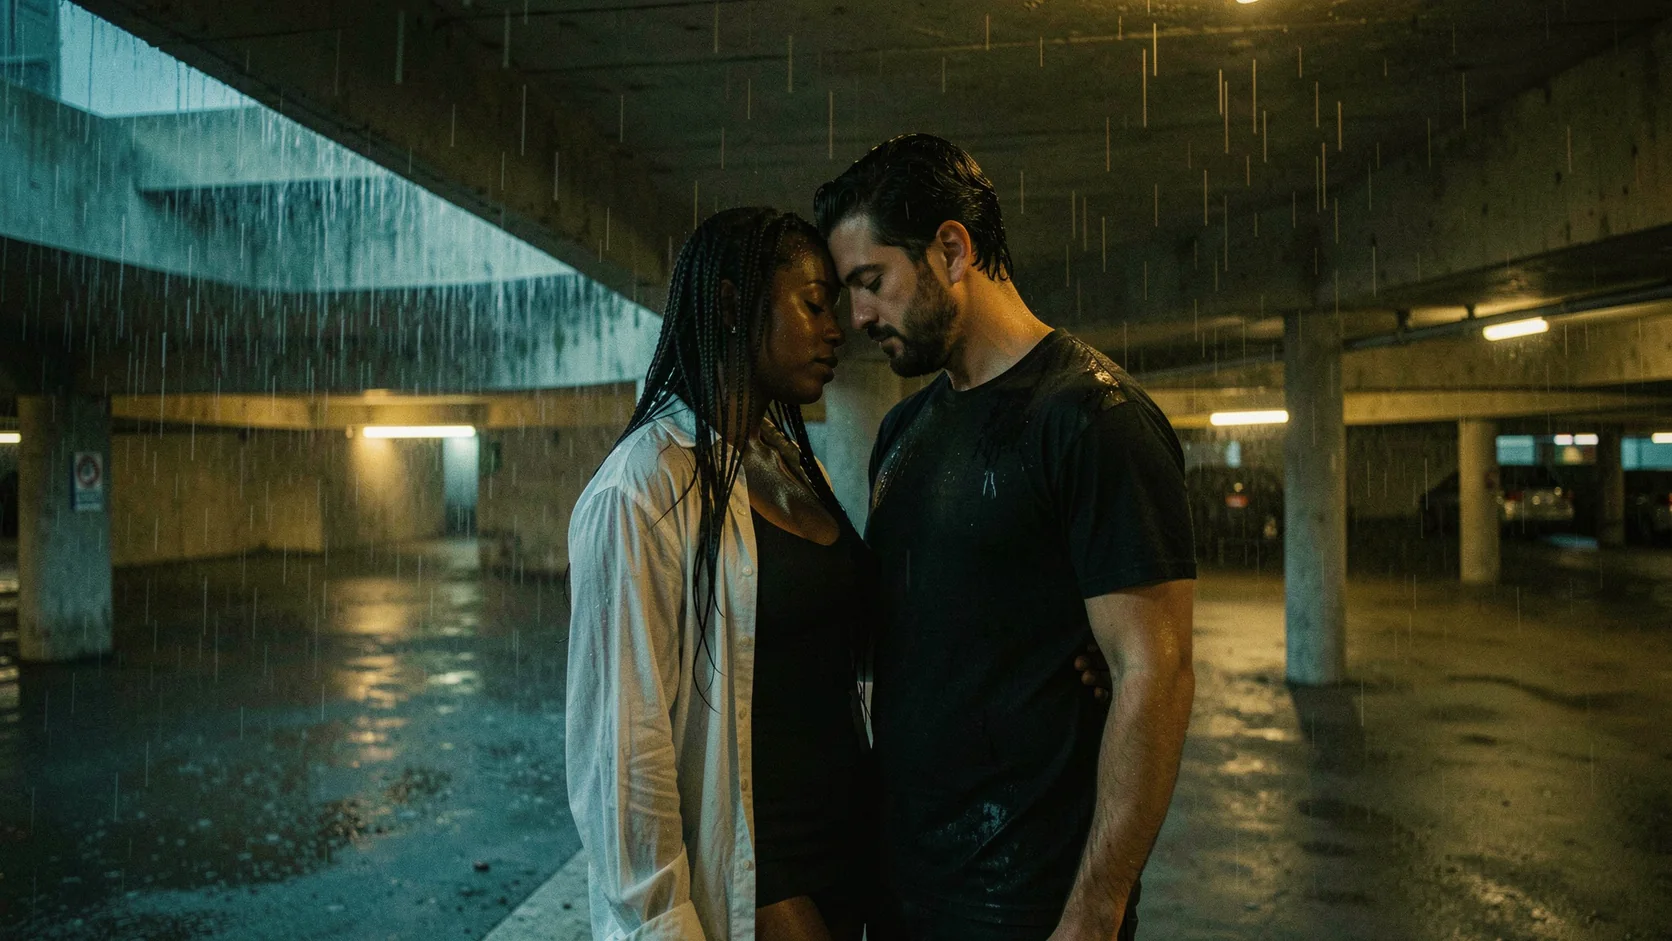
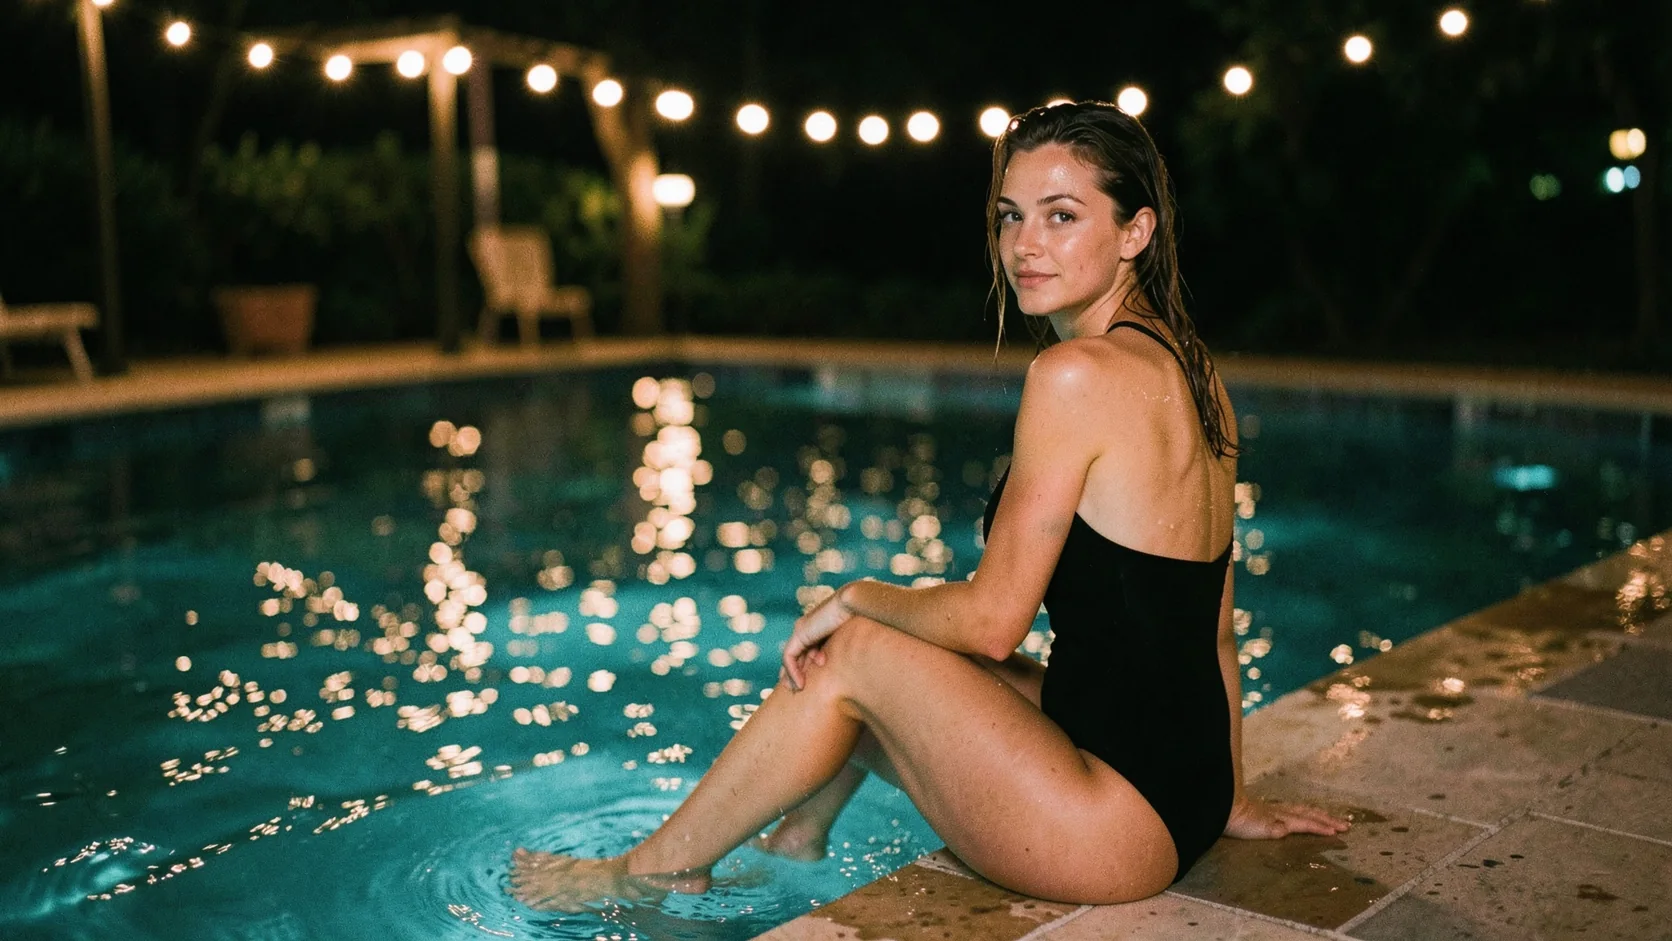
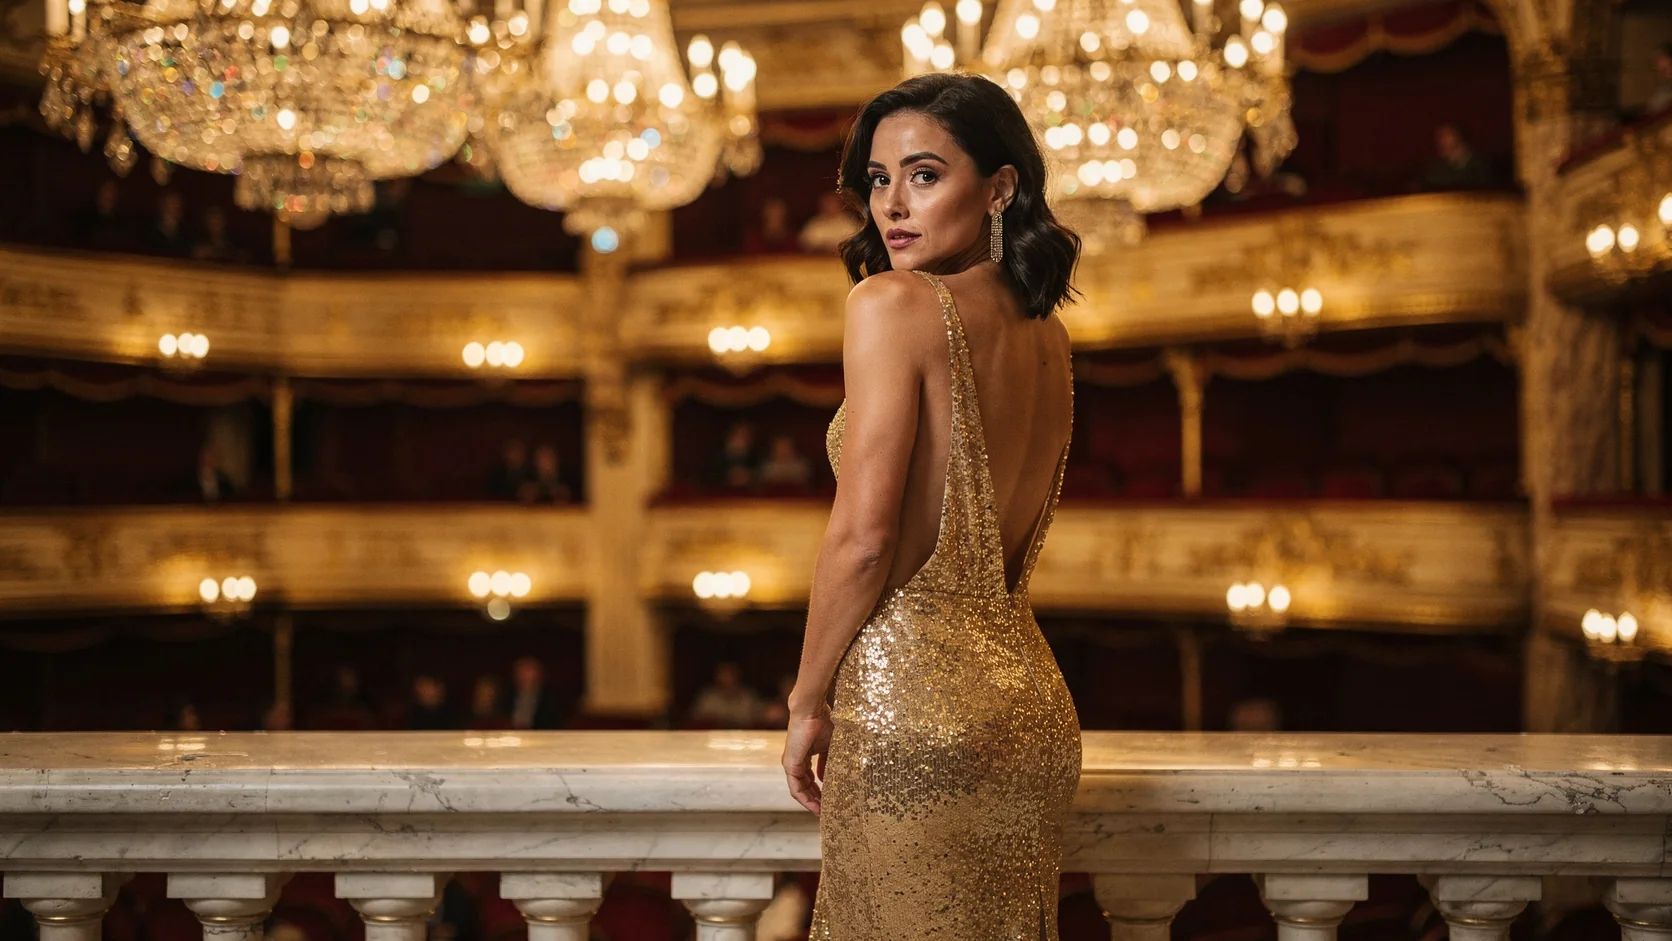
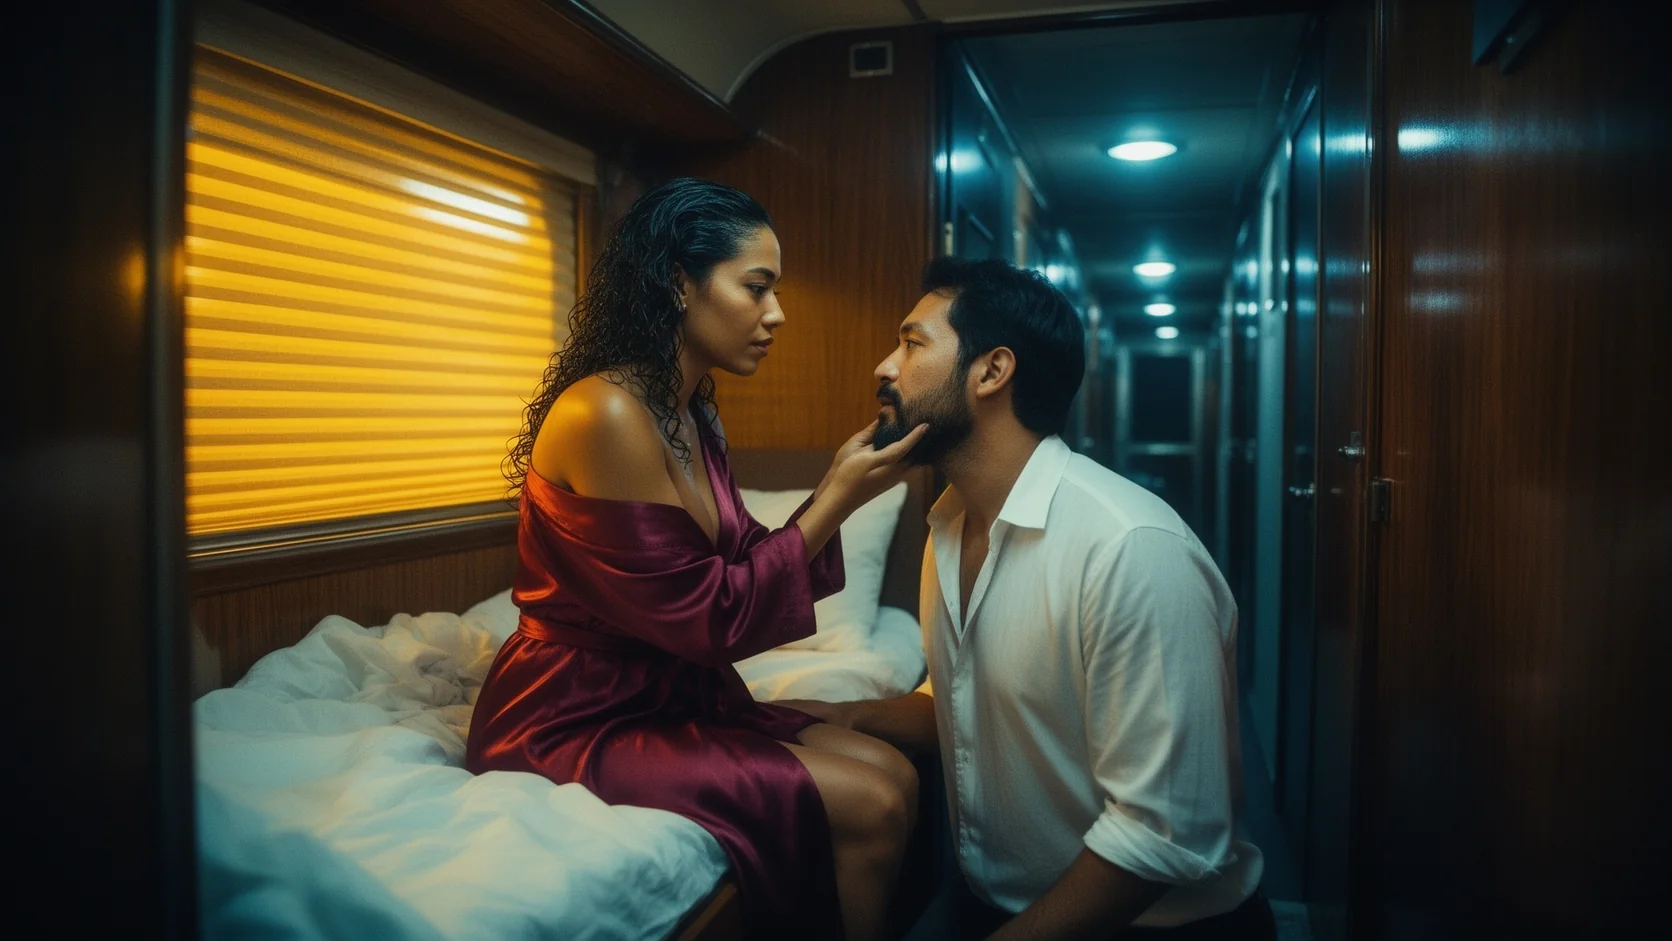
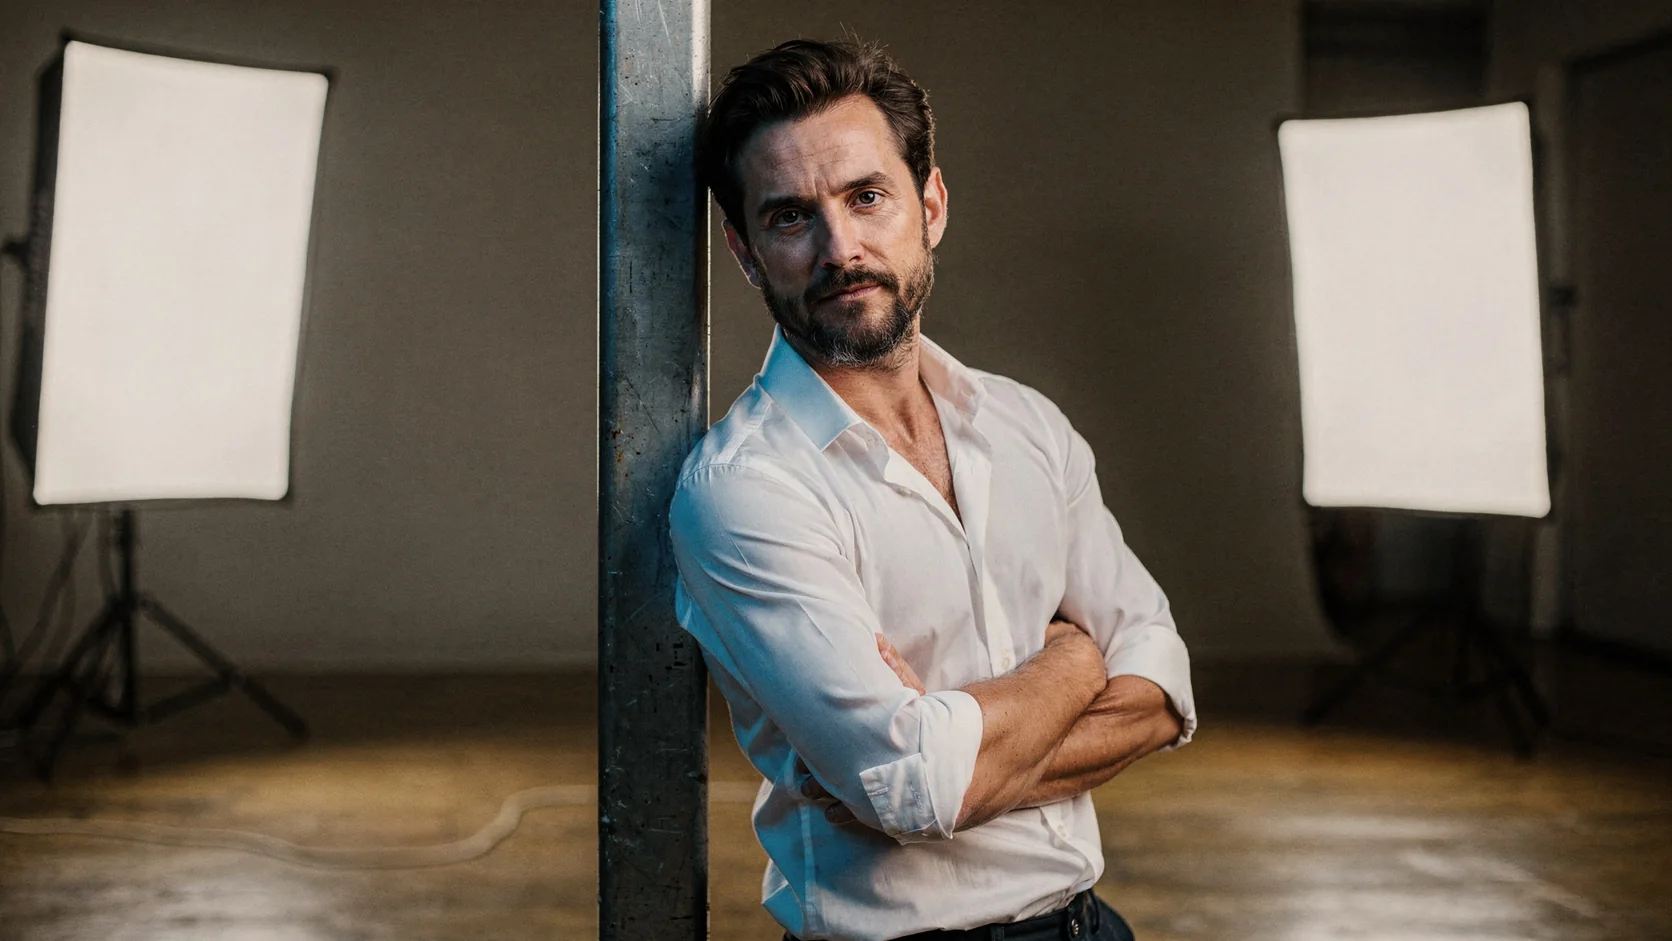
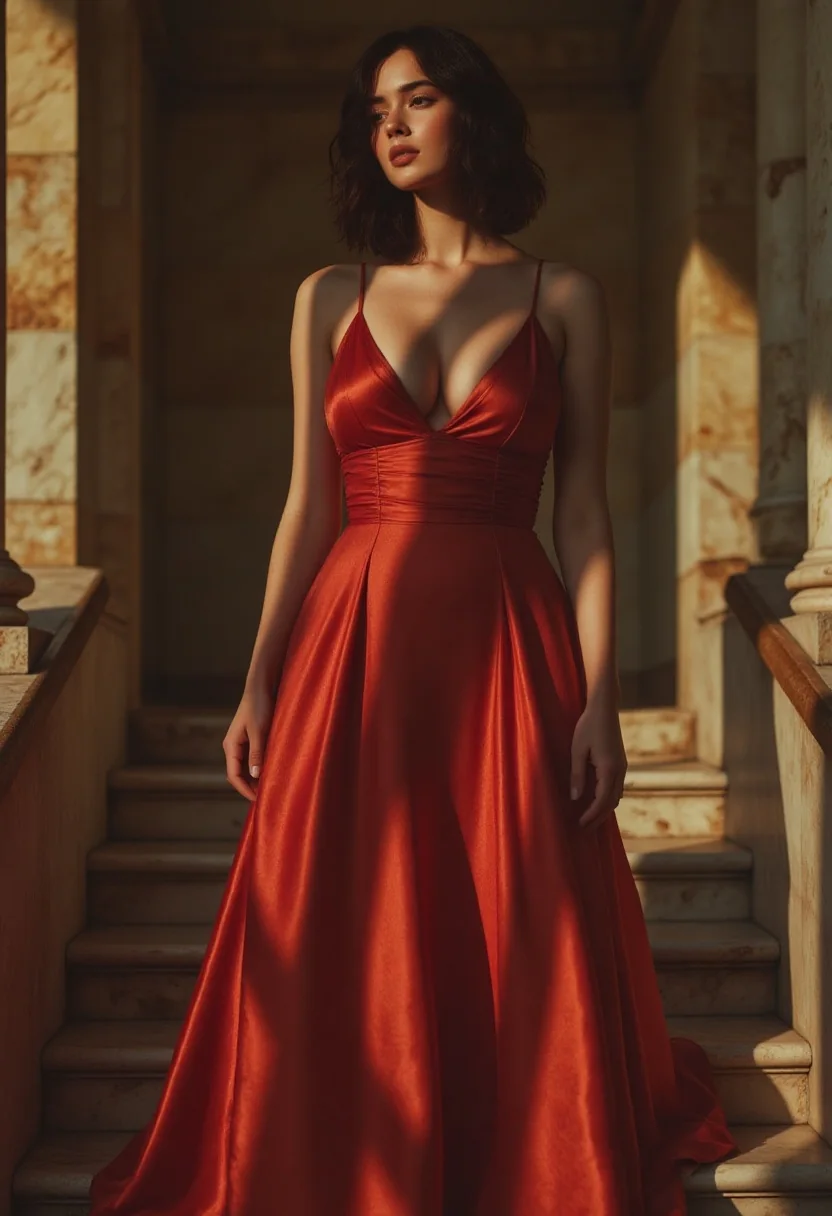
LoRA realizmu i w stylu magazynowym dają wiarygodne światło, tkaniny i skórę w sukniach, portretach i nocnych scenach, gotowe do moodboardów i szkiców kampanii.
Stylizowane serie
LoRA kreskówkowe i ilustracyjne utrzymują cały zestaw w jednym wyglądzie w dziewięciu proporcjach, od kwadratowych postów po szerokie banery.
Wskazówki
Najpierw wyzwalacz, potem pełne zdania
FLUX dobrze czyta długie prompty. Zacznij od frazy wyzwalającej z karty modelu LoRA, a potem opisz postać, otoczenie, ubranie i światło pełnymi zdaniami zamiast listy tagów.
Niższe guidance dla realizmu
Jeśli LoRA realizmu daje woskowy albo przeostrzony wygląd, obniż guidance z 3,5 w stronę 2,5 i porównaj z tym samym seedem. Wyższe guidance trzyma się promptu dosłowniej, ale kosztem naturalnej faktury.
Słabe style podnoś krok po kroku
Gdy styl jest ledwo widoczny, podnieś jego scale o 0,2. Nasz kreskówkowy przykład potrzebował 1,2. Przy wysokich wartościach scale dokładnie sprawdzaj twarze i dłonie; to one zniekształcają się jako pierwsze.
Bez tekstu na szyldach
FLUX ma skłonność do wpisywania słów na każdym szyldzie czy ekranie w kadrze, często z błędami. Pomijaj szyldy w prompcie, chyba że liczy się dokładne brzmienie napisu.
Szybki start z API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "black-forest-labs/flux-1-dev-lora/text-to-image",
  "input": {
    "aspect_ratio": "1:1",
    "output_format": "jpeg",
    "prompt": "A ceramic teapot on a linen cloth, soft window light, muted palette"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Uwierzytelnianie, pełny schemat, odpytywanie i obsługę błędów opisuje dokumentacja API.